ElevenAgent के ऑर्केस्ट्रेशन इंजन की गहराई से समझ
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
ElevenAgents रीयल-टाइम बातचीत के लिए खास तौर पर बनाए गए कम-लेटेंसी ऑर्केस्ट्रेशन इंजन से संचालित होते हैं, जो 100ms से कम ओवरहेड जोड़ता है। यह आर्किटेक्चर ElevenLabs के बेहतरीन रिसर्च को OpenAI, Google और Anthropic जैसे प्रमुख प्रदाताओं के फ्रंटियर LLMs के साथ-साथ ElevenLabs द्वारा होस्ट किए गए चुनिंदा ओपन-सोर्स मॉडल्स के साथ जोड़ता है। उत्तर पाइपलाइन के अलग-अलग चरणों में कई मॉडल्स इस्तेमाल करके, एजेंट यह सुनिश्चित करता है कि बातचीत तेज़ प्रतिक्रिया देने वाली और संदर्भ के प्रति जागरूक, दोनों हो। हर मॉडल की खूबियों का साथ में डायनामिक रूप से उपयोग करके, हम बुद्धिमत्ता, गति और लागत के संतुलन को बेहतर बनाते हुए, कई तरह के एंटरप्राइज़ कार्यों और संवाद परिदृश्यों में भरोसेमंद व स्केलेबल प्रदर्शन हासिल करते हैं।
इस लेख में, हम बताते हैं कि जटिल परिवेशों में काम करने के लिए एजेंट्स को जिन मुख्य क्षमताओं की ज़रूरत होती है, उन्हें देने के लिए ये मॉडल्स साथ मिलकर कैसे काम करते हैं—और खास तौर पर, कौन-सा मॉडल कौन-से टोकन्स और कब देखता है। इसके केंद्र में इंटरैक्शन के अलग-अलग बिंदुओं पर बातचीत के इतिहास का प्रबंधन है। स्वतंत्र और मल्टी-एजेंट, दोनों तरह के वर्कफ़्लो में ऑर्केस्ट्रेशन के लिए इसकी भूमिका स्पष्ट करने हेतु, हम फिर से देखेंगे कि बातचीत का इतिहास कैसे और कहाँ साझा किया जाता है।
स्वतंत्र एजेंट
हम स्वतंत्र एजेंट और उसके मुख्य घटकों को समझने से शुरुआत करते हैं। न्यूनतम उपयोगी एजेंट में एक सिस्टम प्रॉम्प्ट, कई टूल्स का एक्सेस और एक नॉलेज बेस होना उचित माना जा सकता है। जब आपके उपयोग के मामले में चरणों के एक सख्त क्रम को सत्यापित करने की सीमित ज़रूरत हो, या एजेंट्स के भीतर नॉलेज साइलो से बचना महत्वपूर्ण हो, तो आपको वर्कफ़्लो के बजाय स्वतंत्र एजेंट्स को प्राथमिकता देनी चाहिए। नॉलेज साइलो तब बनते हैं, जब कुछ टूल्स, दस्तावेज़ या ऐतिहासिक संदर्भ कुछ सब-एजेंट्स के लिए उपलब्ध होते हैं, लेकिन दूसरों के लिए नहीं। ये मल्टी-एजेंट वर्कफ़्लो में अंतर्निहित होते हैं और लचीलेपन व निश्चितता के बीच एक समझौता लाते हैं।
ElevenLabs के स्वतंत्र एजेंट्स के लिए यह समझना महत्वपूर्ण है कि वे कैसे:
- प्रभावी जनरेशन रिक्वेस्ट बनाते हैं
- प्रासंगिक दस्तावेज़ खोजते और शामिल करते हैं
- एजेंट के जवाबों को जानकारी देने के लिए टूल कॉल जनरेट और निष्पादित करते हैं
- मूल्यांकन और डेटा कलेक्शन के लिए परिणाम आउटपुट करते हैं
बातचीत का संदर्भ बनाना
किसी ग्राहक और ElevenLabs एजेंट के बीच बातचीत कई टर्न्स की एक श्रृंखला होती है, जिसमें हर टर्न दोनों पक्षों के बीच संदेशों का आदान-प्रदान होता है। एजेंट और यूज़र संदेशों की यह बारी-बारी वाली सूची हमारे बातचीत संदर्भ को बनाने का शुरुआती बिंदु है। हर टर्न के दौरान, अंतर्निहित LLM को ऐसी जनरेशन रिक्वेस्ट मिलती हैं जिनमें एजेंट और यूज़र के बारी-बारी वाले संदेशों की श्रृंखला पिछले टर्न से एक संदेश लंबी होती है। स्वाभाविक रूप से, इस संदेश श्रृंखला के पहले एजेंट के सिस्टम प्रॉम्प्ट का प्रतिनिधित्व करने वाला एक सिस्टम संदेश होता है।
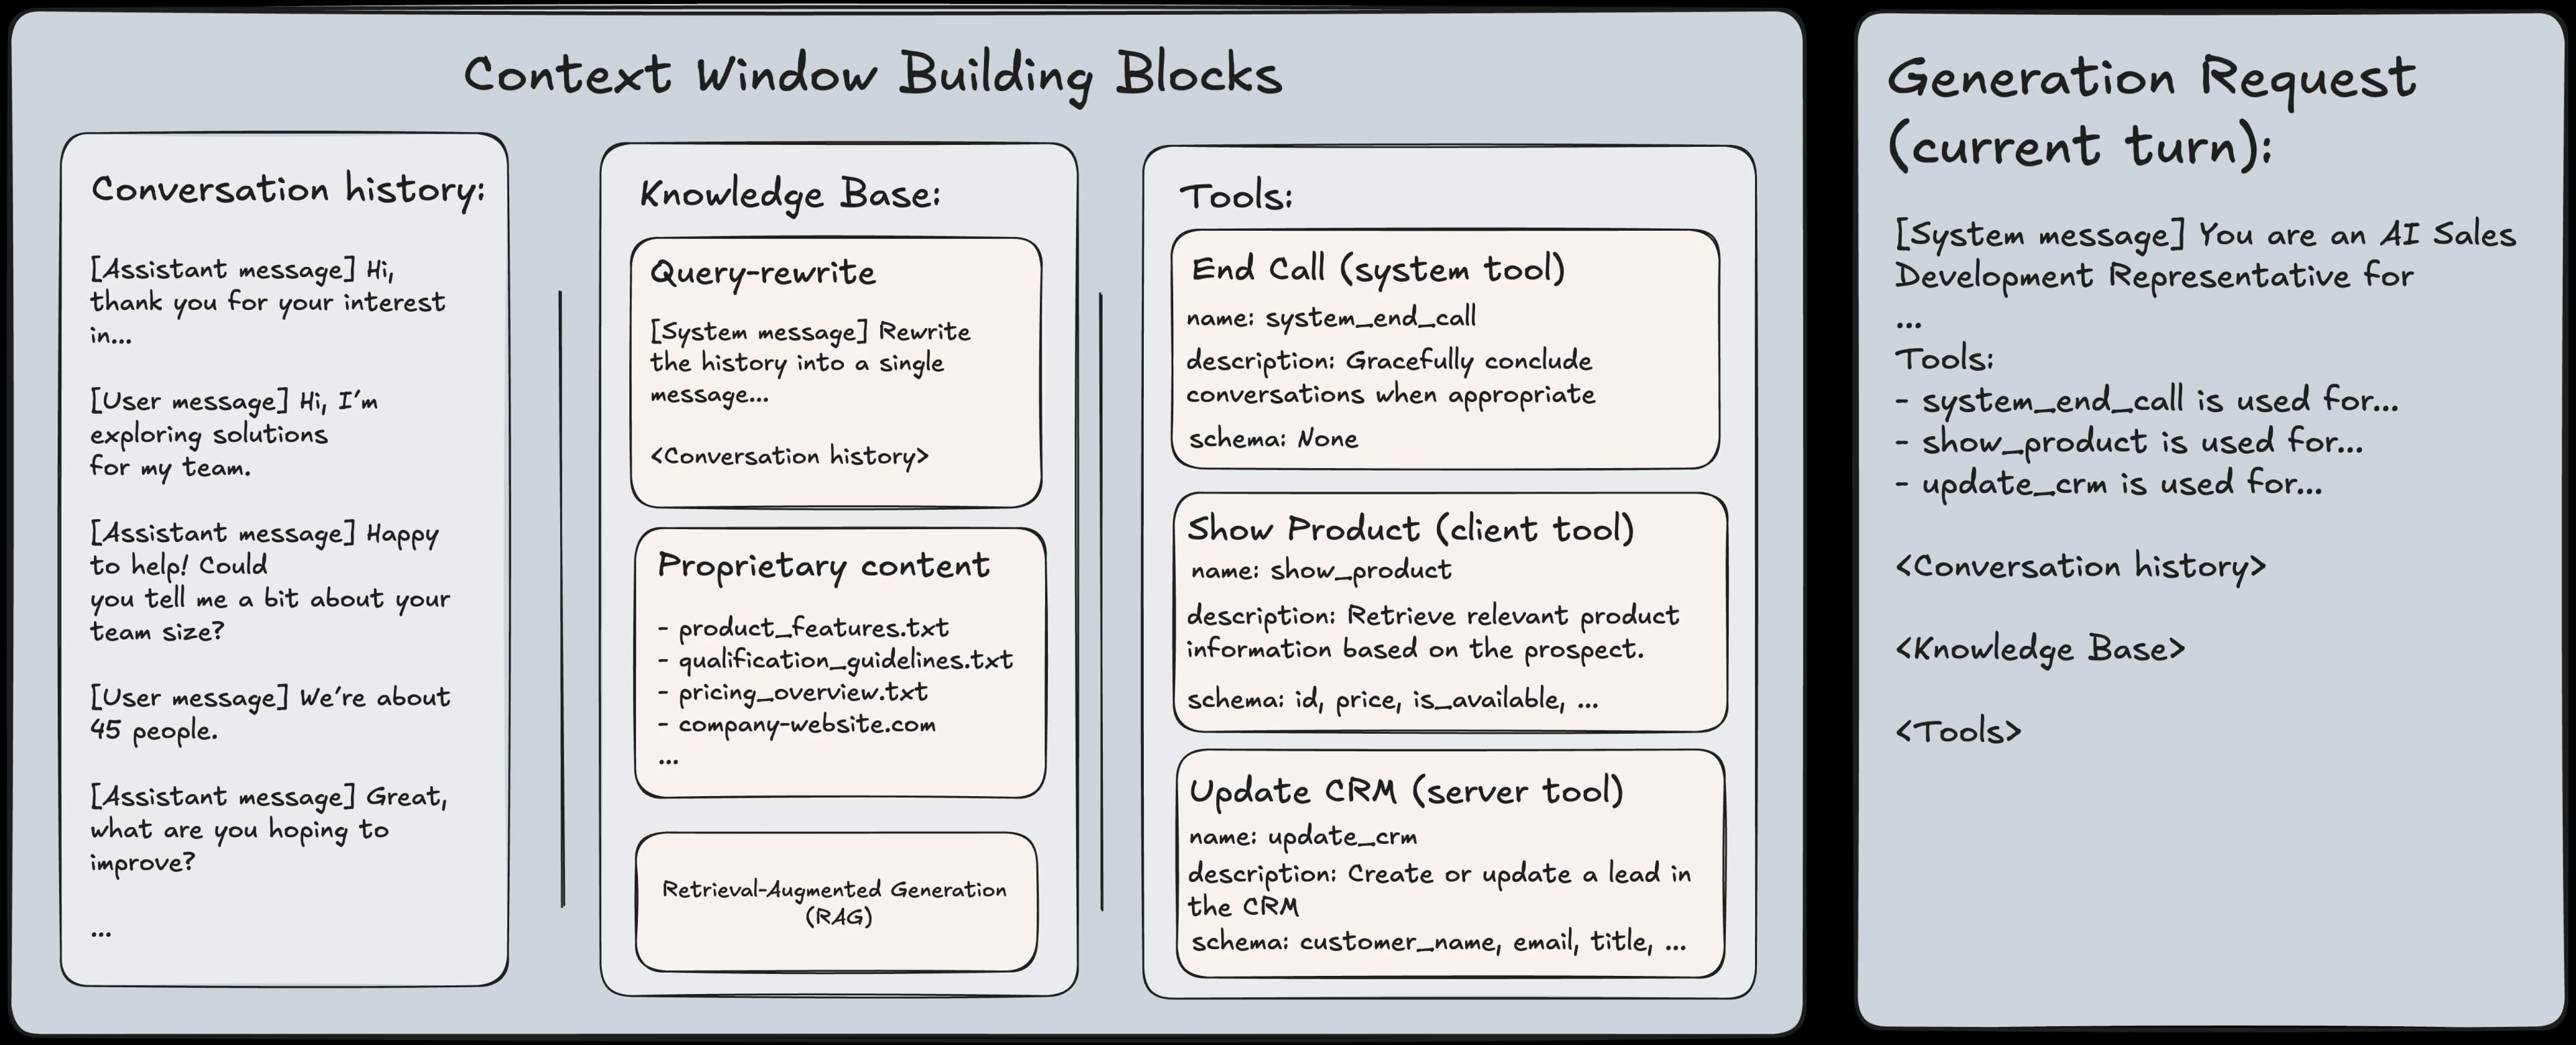
ElevenLabs ऑर्केस्ट्रेटर, यूज़र के बोलना खत्म करने का अनुमान लगाकर, महसूस होने वाली LLM लेटेंसी कम करता है। कुछ मामलों में, इससे एक ही टर्न के दौरान उसी बातचीत संदर्भ के साथ कई LLM जनरेशन रिक्वेस्ट हो सकती हैं। ऑर्केस्ट्रेशन एजेंट्स की प्रतिक्रिया गति को बेहतर बनाता है, लेकिन जवाब की गुणवत्ता उतनी ही इस बात पर निर्भर करती है कि नॉलेज तक कैसे पहुँचा जाता है। जैसे-जैसे ग्राहक आगे बढ़ते हैं, वे आम तौर पर अपने एजेंट्स के जवाबों को स्वामित्व वाले दस्तावेज़ों और सार्वजनिक सामग्री के संयोजन पर आधारित करना शुरू करते हैं। कई वर्षों से, रिट्रीवल-ऑगमेंटेड जनरेशन (RAG) इसके लिए मानक तरीका रहा है। ElevenAgents नॉलेज बेस एक ऑप्टिमाइज़्ड, मल्टी-मॉडल आर्किटेक्चर के साथ RAG को आगे बढ़ाते हैं, जिसका विवरण हमने एक पिछली पोस्ट में दिया है। इससे भरोसेमंद दस्तावेज़ रिट्रीवल संभव होता है, भले ही यूज़र का सबसे हालिया इनपुट फॉलो-अप हो, स्पष्टीकरण की स्वीकृति हो या उसमें स्पष्ट प्रश्न न हो।
हालाँकि, रिट्रीवल बाहरी सिस्टम्स के साथ एजेंट्स के इंटरैक्ट करने का सिर्फ़ एक तरीका है।
टूल्स से कार्रवाई करना और जानकारी पाना
ElevenLabs एजेंट्स एक लचीले टूल्स सिस्टम के ज़रिए बातचीत के बीच में वास्तविक दुनिया की कार्रवाइयाँ कर सकते हैं और लाइव जानकारी पा सकते हैं। यह क्षमता एक महत्वपूर्ण डिज़ाइन पहलू लाती है: हर सक्षम टूल, सीरियलाइज़्ड प्रॉम्प्ट का आकार बढ़ाता है, क्योंकि उसका नाम, विवरण और पैरामीटर स्कीमा सिस्टम प्रॉम्प्ट और बातचीत इतिहास के साथ शामिल होते हैं। जितने अधिक टूल्स जोड़े जाते हैं, टूल्स के सही क्रम को कॉल करने के लिए मॉडल पर तर्क करने का बोझ भी उतना बढ़ता है। Agent Builder में, टूल का विवरण बताता है कि टूल क्या करता है और वह कौन-से फ़ील्ड लौटाता है। भाषा मॉडल इसके उपयोग के संदर्भ को समझने के लिए इसी जानकारी का इस्तेमाल करता है। तय हो जाने के बाद, टूल को शुरू करने की खास शर्तें एजेंट के सिस्टम प्रॉम्प्ट में होती हैं। उदाहरण के लिए:
- के लिए टूल विवरण lookup_order: “ऑर्डर ID से ग्राहक के ऑर्डर की जानकारी प्राप्त करता है। ऑर्डर की स्थिति, खरीदी गई चीज़ें, शिपिंग पता और ट्रैकिंग नंबर लौटाता है।”
- सिस्टम प्रॉम्प्ट निर्देश: “ग्राहक की पहचान सत्यापित करने के बाद, उसके ऑर्डर की जानकारी पाने के लिए lookup_order टूल को कॉल करें।”
ज़िम्मेदारियों का यह विभाजन टूल परिभाषाओं को अलग-अलग एजेंट्स में दोबारा इस्तेमाल करने योग्य रखता है, साथ ही हर एजेंट के सिस्टम प्रॉम्प्ट को टूल कॉल करने का सटीक समय नियंत्रित करने देता है। ग्राहकों को ये सिस्टम प्रॉम्प्ट प्रभावी ढंग से डिज़ाइन करने में मदद के लिए, हम अपनी प्रॉम्प्टिंग गाइड में अधिक विस्तृत मार्गदर्शन देते हैं। इस फ़्रेमवर्क में मुख्य रूप से कई प्रकार के टूल्स परिभाषित किए जा सकते हैं:
- बाहरी APIs को कॉल करने वाले वेबहुक टूल्स।
- बातचीत websocket के ज़रिए इवेंट्स के रूप में टूल रिक्वेस्ट भेजने वाले क्लाइंट टूल्स।
- कॉल ट्रांसफ़र जैसी बिल्ट-इन कार्रवाइयों के लिए सिस्टम टूल्स।
- Model Context Protocol सर्वर्स से कनेक्ट होने वाले MCP टूल्स।
जब भी कोई एजेंट टूल इस्तेमाल करने का निर्णय लेता है, वह बातचीत से ज़रूरी जानकारी लेकर उसे चलाने की रिक्वेस्ट भेजता है। टूल के परिणाम लौटाने पर, वह परिणाम बातचीत में जोड़ दिया जाता है, ताकि मॉडल अपने अगले जवाब में उसका स्वाभाविक रूप से उल्लेख कर सके। ज़रूरत पड़ने पर, टूल का आउटपुट एजेंट की संग्रहीत जानकारी को डायनामिक वेरिएबल के रूप में भी अपडेट कर सकता है। यह संग्रहीत जानकारी, पहले से तय मैपिंग्स की मदद से टूल के जवाब से निकाले गए साधारण की-वैल्यू पेयर्स के रूप में रखी जाती है। सेट होने के बाद, ये वेरिएबल्स सिस्टम प्रॉम्प्ट, भविष्य के टूल पैरामीटर्स और वर्कफ़्लो शर्तों के ज़रिए एजेंट को वापस जानकारी दे सकते हैं। यह फ़ीडबैक लूप एजेंट्स को एक तरह की वर्किंग मेमोरी देता है, जो इंटरैक्शन के साथ विकसित होती है।
यह बताता है कि टूल्स एजेंट के तर्क में कैसे जुड़ते हैं, लेकिन उनके निष्पादन का समय भी कॉन्फ़िगर किया जा सकता है। टूल्स तीन निष्पादन मोड्स में से किसी एक में चल सकते हैं और हर मोड अलग बातचीत ज़रूरत के लिए उपयुक्त है। Immediate Mode में, LLM के रिक्वेस्ट करते ही टूल निष्पादित हो जाता है। यह तेज़ लुकअप्स के लिए डिफ़ॉल्ट है, जहाँ यूज़र लगभग तुरंत जवाब की उम्मीद करते हैं, जैसे ऑर्डर की स्थिति देखना। प्री-टूल स्पीच के साथ इस्तेमाल होने पर, एजेंट पहले “मैं आपके लिए यह देखता हूँ” जैसी संक्षिप्त स्वीकृति बनाता है और टूल के समानांतर चलने के दौरान उसे यूज़र को लौटाता है, जिससे ख़ामोशी कम होती है। धीमे टूल्स के लिए, प्लेटफ़ॉर्म अनुमानित प्रतीक्षा समय के अनुरूप इन फ़िलर संदेशों को अपने-आप बढ़ा देता है। इसके उलट, Post-Tool Speech Mode, एजेंट के बोलना समाप्त करने तक निष्पादन को टाल देता है। कॉल ट्रांसफ़र करने, सेशन समाप्त करने या भुगतान सबमिट करने जैसी वास्तविक दुनिया के परिणाम वाली कार्रवाइयों के लिए यह ज़रूरी है। यूज़र को “मैं अब आपको बिलिंग विभाग में ट्रांसफ़र करने जा रहा हूँ” जैसा पूरा संदर्भ सुनाई देता है और कार्रवाई होने से पहले उसे बीच में बोलने का अवसर मिलता है। Async Mode बातचीत को रोके बिना टूल को पूरी तरह बैकग्राउंड में चलाता है। यह मोड ईमेल भेजने, बाहरी वर्कफ़्लो ट्रिगर करने या डेटा लॉग करने जैसी फायर-एंड-फॉरगेट कार्रवाइयों के लिए सबसे उपयुक्त है, जहाँ एजेंट को अपने जवाब में परिणाम का उल्लेख करने की ज़रूरत नहीं होती।
निष्पादन और ऑर्केस्ट्रेशन लागू होने के बाद, अगला कदम प्रदर्शन को मापने का तरीका समझना है।
प्रदर्शन मापना
एजेंट के साथ कॉल पूरी होने के बाद, ग्राहक आगे के विश्लेषण और स्टोरेज के लिए कॉल से कुछ जानकारी निकालना चाह सकते हैं या यह तय करना चाह सकते हैं कि कॉल सफल रही या नहीं। यहीं डेटा कलेक्शन और मूल्यांकन मानदंड काम आते हैं। डेटा कलेक्शन आपको आगे के विश्लेषण और एकत्रीकरण के लिए कॉल ट्रांसक्रिप्ट से संरचित जानकारी निकालने देता है। ग्राहक अक्सर रिपोर्टिंग या एनरिचमेंट वर्कफ़्लो के लिए इन आउटपुट्स को अपने एंटरप्राइज़ डेटा लेकहाउस में एक्सपोर्ट करते हैं। उदाहरण के लिए, एक सेल्स डेवलपमेंट एजेंट बातचीत से संभावित ग्राहक की जानकारी अपने-आप निकालकर Customer Relationship Management (CRM) सिस्टम में लीड बना या अपडेट कर सकता है। दूसरी ओर, मूल्यांकन मानदंड तय करते हैं कि कोई कॉल सफल मानी जाएगी या नहीं। कॉन्फ़िगर किए गए सभी मानदंड पूरे होने पर, कॉल को सफल चिह्नित किया जाता है; अन्यथा इसे विफल के रूप में फ़्लैग किया जाता है। इससे तेज़ फ़ीडबैक मिलने के साथ-साथ यह सुनिश्चित होता है कि बातचीत गुणवत्ता और अखंडता के तय मानकों पर लगातार खरी उतरे। कॉल खत्म होने और पोस्ट-कॉल वेबहुक ट्रिगर होने के बाद, एजेंट किसी भी टूल निष्पादन और मेटाडेटा सहित अंतिम ट्रांसक्रिप्ट को सभी कॉन्फ़िगर किए गए डेटा कलेक्शन पॉइंट्स और मूल्यांकन मानदंडों के साथ LLM से प्रोसेस करता है। मॉडल इस संयुक्त प्रॉम्प्ट का उपयोग यह तय करने के लिए करता है कि हर मूल्यांकन मानदंड पूरा हुआ है या नहीं, और आगे के विश्लेषण के लिए बताए गए डेटा पॉइंट्स निकालने के लिए करता है। चूँकि LLM इन कॉन्फ़िगरेशन को अपने इनपुट प्रॉम्प्ट के हिस्से के रूप में सीधे समझता है, इसलिए उन्हें स्पष्ट और एकरूप ढंग से फ़ॉर्मैट करना ज़रूरी है, ताकि मॉडल उन्हें सही तरीके से समझ और लागू कर सके। इसलिए हम मूल्यांकन मानदंड और डेटा कलेक्शन विवरण लिखने के लिए ये सर्वोत्तम तरीके सुझाते हैं।
मूल्यांकन मानदंड
- हर मानदंड के लिए एक स्पष्ट लक्ष्य: एक मानदंड में कई लक्ष्यों से बेहतर एक वाक्य या छोटा बुलेट है।
- देखे जा सकने वाले और ट्रांसक्रिप्ट-आधारित: लक्ष्य को इस तरह लिखें कि ट्रांसक्रिप्ट से सफलता/विफलता तय हो सके (क्या कहा गया, एजेंट ने क्या किया, यूज़र ने क्या पूछा)। ऐसे लक्ष्यों से बचें जिनके लिए ऐसे बाहरी संदर्भ की ज़रूरत हो जो LLM के पास नहीं है।
- स्पष्ट सफलता/विफलता/अज्ञात परिणाम: LLM के पास पहले से यह संदर्भ होता है कि सफल चिह्नित करने के लिए लक्ष्य पूरा होना चाहिए, विफल चिह्नित करने के लिए वह पूरा नहीं होना चाहिए, और अज्ञात चिह्नित करने के लिए वह ट्रांसक्रिप्ट से तय न हो सके। इसलिए लक्ष्य ऐसा लिखा जाना चाहिए कि “पूरा हुआ” और “पूरा नहीं हुआ” स्पष्ट रूप से परिभाषित हों; अगर यह अस्पष्ट हुआ, तो मॉडल अज्ञात या गलत वर्गीकरण की ओर झुक सकता है
- इसे संक्षिप्त रखें: कभी-कभी कई मूल्यांकन मानदंड एक साथ भेजे जा सकते हैं। इसलिए लंबे मूल्यांकन मानदंड शोर बढ़ा सकते हैं और संभावित रूप से हैलुसिनेशन का कारण बन सकते हैं
- भाषा मायने रखती है: मूल्यांकन मानदंड पूरा हुआ या नहीं, इस बारे में LLM द्वारा दिया गया कोई भी तर्क उसी भाषा में होगा जिसमें मानदंड का विवरण है, इसलिए इसे ध्यान में रखना महत्वपूर्ण है
डेटा कलेक्शन
- ठीक-ठीक बताएँ कि क्या निकालना है: विवरण LLM के लिए मुख्य संकेत है। बताएँ कि फ़ील्ड का क्या मतलब है, उसे किस स्थिति में सेट करना है और अस्पष्ट होने पर क्या करना है (जैसे, “अगर ग्राहक ने कभी पसंदीदा तारीख नहीं बताई, तो null छोड़ें”)।
- अपेक्षित प्रकार से मेल रखें: LLM द्वारा दिया गया मान हमेशा डेटा कलेक्शन पॉइंट को असाइन किए गए डेटा प्रकार (जैसे boolean, string, integer आदि) से मेल खाएगा। इसलिए विवरण भी उसके अनुरूप होना चाहिए। उदाहरण के लिए, integer के लिए “माँगी गई चीज़ों की संख्या निकालें” और boolean के लिए “ग्राहक ऑफ़र के लिए सहमत था या नहीं—हाँ/नहीं” लिखा जा सकता है।
- जहाँ संभव हो, enums का उपयोग करें: string प्रकार के लिए, यदि मानों का सेट तय है, तो स्कीमा में enum इस्तेमाल करें; यह मॉडल को सीमित करता है और अमान्य आउटपुट्स कम करता है।
- हर आइटम के लिए एक एक्सट्रैक्शन लक्ष्य: एक आइटम के विवरण में कई असंबंधित तथ्यों को न भरें; उन्हें अलग-अलग आइटम्स में बाँटें, ताकि हर कॉल का एक स्पष्ट एक्सट्रैक्शन लक्ष्य हो।
- विवरण छोटे रखें: विवरण कुछ वाक्यों के हो सकते हैं; लंबे पैराग्राफ़ की ज़रूरत नहीं है। ट्रांसक्रिप्ट पहले ही यूज़र संदेश में है, इसलिए स्कीमा + छोटा विवरण काफ़ी है।
फ़िलहाल, इस मूल्यांकन और एक्सट्रैक्शन चरण के लिए इस्तेमाल होने वाला LLM तेज़ प्रोसेसिंग सुनिश्चित करने हेतु कम-लेटेंसी मॉडल पर तय है। निकट भविष्य में, हम ग्राहकों को अधिक लचीलापन देने के लिए विकल्प पेश करने की उम्मीद करते हैं।
अब हम उन उपयोग के मामलों पर ध्यान देते हैं जिनमें संरचित ऑर्केस्ट्रेशन, निश्चितता या कई संवाद भूमिकाओं में विशेषज्ञता की ज़रूरत होती है, जहाँ ग्राहक इसके बजाय वर्कफ़्लो का उपयोग कर सकते हैं।
वर्कफ़्लो
वर्कफ़्लो जटिल बातचीत प्रवाह डिज़ाइन करने के लिए एक विज़ुअल इंटरफ़ेस देते हैं। अंततः, यह स्वतंत्र एजेंट आइडेंटिफ़ायर के अंतर्गत कई सब-एजेंट्स, टूल्स और ट्रांसफ़र्स प्रबंधित करने के लिए ऑर्केस्ट्रेटर द्वारा इस्तेमाल किया जाने वाला लॉजिकल ऑब्जेक्ट बनाता है। वर्कफ़्लो, स्वतंत्र एजेंट्स के लिए पहले बताए गए तत्वों के अलावा कुछ अतिरिक्त घटक लाते हैं, जिनमें यह शामिल है कि:
- सिस्टम प्रॉम्प्ट्स और सब-एजेंट के संवाद लक्ष्य कैसे इंटरैक्ट करते हैं।
- ग्राफ़ में अलग-अलग ट्रांज़िशन पॉइंट्स से गुज़रना कैसे तय होता है।
विशेष संवाद लक्ष्य
वर्कफ़्लो, पूरे इंटरैक्शन में एक जैसा व्यवहार लागू करने के लिए स्वतंत्र एजेंट्स की कार्यक्षमता का दोबारा उपयोग करते हैं। इसमें बेस सिस्टम प्रॉम्प्ट, मुख्य टूल्स और ग्लोबल नॉलेज बेस जैसे साझा तत्व शामिल हैं, जो वर्कफ़्लो का कोई भी भाग सक्रिय होने पर हमेशा उपलब्ध होने चाहिए। व्यापक सिस्टम प्रॉम्प्ट आम तौर पर ग्लोबल संवाद संदर्भ, अपेक्षित टोन, सुरक्षा सीमाएँ और ब्रांड या पूरे प्रोडक्ट से जुड़े निर्देश तय करने के लिए ज़िम्मेदार होता है।
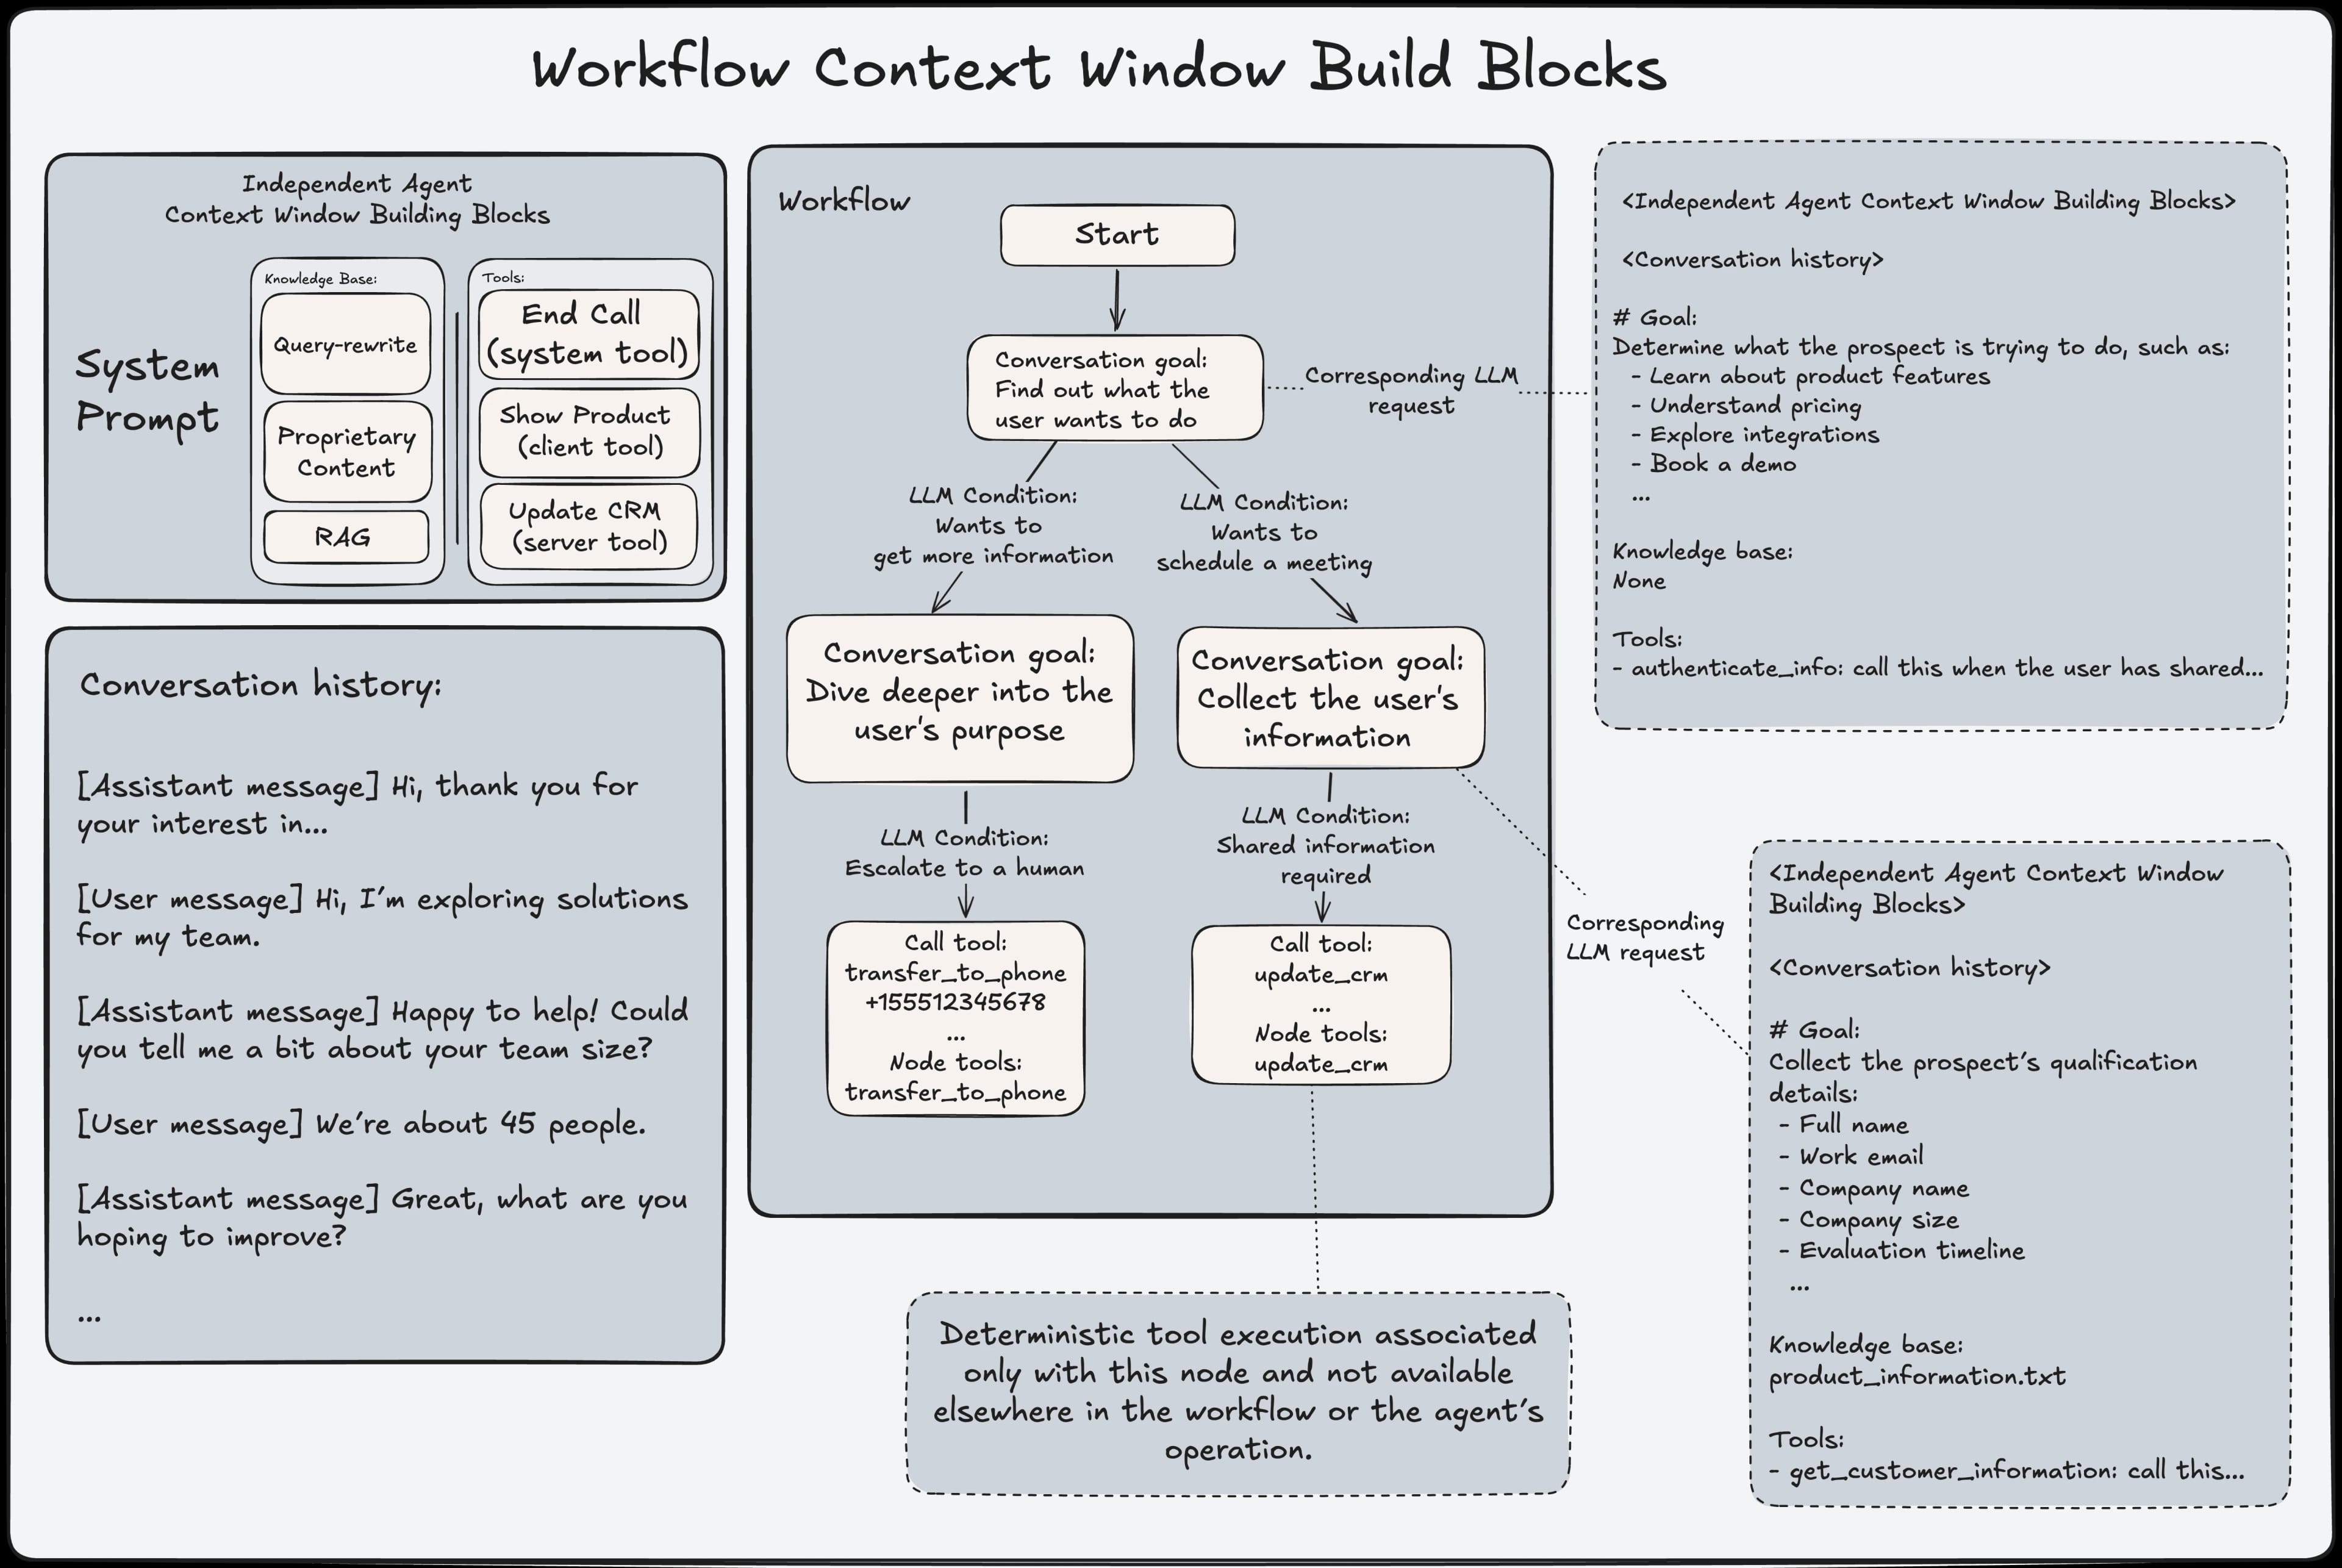
इस साझा आधार के ऊपर, वर्कफ़्लो निर्देशित ग्राफ़ में काम करने वाले विशेष सब-एजेंट्स पेश करते हैं। हर सब-एजेंट को सीमित दायरे का एक उद्देश्य दिया जाता है और वह बेस कॉन्फ़िगरेशन में केवल अपनी भूमिका से संबंधित अतिरिक्त प्रॉम्प्ट निर्देश, टूल्स और नॉलेज सोर्सेज जोड़ता है। पूरे संवाद सेटअप को फिर से परिभाषित करने के बजाय, सब-एजेंट्स प्रॉम्प्ट कंपोज़िशन और चुनिंदा संदर्भ विस्तार के ज़रिए अपने इरादे को बेस एजेंट पर जोड़ते हैं। निरंतरता बनाए रखने के लिए सब-एजेंट ट्रांज़िशन के दौरान बातचीत का इतिहास सुरक्षित रहता है, लेकिन हर सब-एजेंट सिस्टम के जानबूझकर सीमित दृश्य के साथ काम करता है। नॉलेज बेस और टूल्स चुनिंदा रूप से दिखाए जाते हैं, जिससे ज़िम्मेदारियों के बीच रिसाव रोकने वाले स्पष्ट साइलो बनते हैं। इस अलगाव को मज़बूत करने के लिए, ऑर्केस्ट्रेटर ऑब्जेक्ट को हर ट्रांज़िशन पर ऐसे फिर से बनाया जाता है मानो वह स्वतंत्र एजेंट हो। इससे यह सुनिश्चित होता है कि सक्रिय सब-एजेंट की प्रॉम्प्ट स्थिति, कॉन्फ़िगरेशन और उपलब्ध क्षमताएँ पूरी तरह निश्चित रहें। यह डिज़ाइन वर्कफ़्लो को स्थानीय विशेषज्ञता का समर्थन करते हुए ग्लोबल एकरूपता बनाए रखने देता है, जिससे अनुमानित व्यवहार, ज़िम्मेदारियों का स्पष्ट विभाजन और इंटरैक्शन के हर चरण में संदर्भ, नॉलेज व कार्रवाइयों के इस्तेमाल पर सटीक नियंत्रण मिलता है।
इस नियंत्रण को संभव बनाने वाली प्रमुख प्रक्रियाओं में से एक यह है कि सब-एजेंट्स के बीच ट्रांज़िशन कैसे नियंत्रित किए जाते हैं।
LLM शर्तों से वर्कफ़्लो ट्रांज़िशन चलाना
वर्कफ़्लो सब-एजेंट्स के एक निर्देशित ग्राफ़ से होकर आगे बढ़ते हैं, जहाँ नोड्स के बीच ट्रांज़िशन स्पष्ट शर्तों से नियंत्रित होते हैं। ये शर्तें तय करती हैं कि नियंत्रण कब एक सब-एजेंट से दूसरे को जाना चाहिए और वर्कफ़्लो को यूज़र इनपुट, टूल परिणामों व डायनामिक वेरिएबल्स के अनुसार प्रतिक्रिया देने देती हैं। ग्राफ़ शर्तें या तो निश्चित हो सकती हैं या LLM द्वारा मूल्यांकित। बिना शर्त ट्रांज़िशन, डायनामिक वेरिएबल एक्सप्रेशन-आधारित जाँच या टूल परिणाम शर्तों जैसी निश्चित शर्तें नियंत्रण प्रवाह के बारे में मज़बूत गारंटी देती हैं और वर्कफ़्लो में सख्त प्रगति लागू करने के लिए उपयुक्त होती हैं। इसके विपरीत, LLM-आधारित शर्तें प्राकृतिक भाषा के मानदंडों का अर्थपूर्ण मूल्यांकन संभव बनाती हैं, जैसे यूज़र इरादे का पता लगाना या यह पहचानना कि विशेष जानकारी दी गई है।
महत्वपूर्ण बात यह है कि LLM शर्तों का मूल्यांकन सक्रिय एजेंट के सिस्टम प्रॉम्प्ट के बाहर होता है और वे एजेंट के जनरेशन व्यवहार को प्रभावित नहीं करतीं। इसके बजाय, ऑर्केस्ट्रेटर मौजूदा बातचीत स्थिति के विरुद्ध समानांतर रूप से उनका मूल्यांकन करता है। यह अलगाव सुनिश्चित करता है कि ट्रांज़िशन लॉजिक एजेंट के प्रॉम्प्ट को दूषित न करे या जवाब जनरेट होने के तरीके को प्रभावित न करे, साथ ही वर्कफ़्लो को लचीले ग्राफ़ ट्रैवर्सल के लिए LLM तर्क का उपयोग करने देता है। निश्चित और LLM-मूल्यांकित शर्तों को मिलाकर, वर्कफ़्लो अनुमानितता और अनुकूलनशीलता दोनों हासिल कर सकते हैं—जहाँ सही होना महत्वपूर्ण है वहाँ निश्चित ट्रांज़िशन और जहाँ अर्थपूर्ण व्याख्या चाहिए वहाँ LLM-आधारित ट्रांज़िशन इस्तेमाल करके।
जब बातचीत किसी नए चरण में पहुँचती है, सिस्टम उस चरण के लिए खास तौर पर तैयार एजेंट का एक संस्करण सक्रिय करता है। हर चरण अपने केंद्रित निर्देशों और केवल अपनी ज़िम्मेदारी से संबंधित नॉलेज व टूल्स के एक्सेस के साथ काम करता है। उदाहरण के लिए, रिफ़ंड संभालने वाला चरण ऑनबोर्डिंग या ट्रायेज से असंबंधित संदर्भ पाए बिना रिफ़ंड नीतियों का उल्लेख कर सकता है। चरणों के बीच आगे बढ़ना स्पष्ट ट्रांज़िशन शर्तों से नियंत्रित होता है। ये शर्तें तय करती हैं कि ज़िम्मेदारी कब बदलनी चाहिए और बातचीत आगे बढ़ने के साथ रूटिंग निर्णय स्वाभाविक रूप से होने देती हैं। निरंतरता बनाए रखने के लिए, यूज़र का अनुभव ट्रांज़िशन के बीच सहज रहता है, जहाँ हर चरण हैंडऑफ़ की प्रक्रिया दिखाए बिना प्रासंगिक संवाद संदर्भ प्राप्त करता है। सुरक्षा उपाय गैर-उत्पादक रूटिंग चक्रों को रोकने के लिए ट्रांज़िशन पर भी नज़र रखते हैं, जिससे वर्कफ़्लो स्थिर और लक्ष्य-केंद्रित रहता है।
सुरक्षा और सिक्योरिटी
जिन मामलों में अधिक सुरक्षा और सिक्योरिटी नियंत्रणों की ज़रूरत हो, ग्राहक ऑर्केस्ट्रेटर के अतिरिक्त हिस्सों पर निर्भर कर सकते हैं।
गार्डरेल्स
ElevenLabs Agents एक कॉन्फ़िगर किए जा सकने वाले मॉडरेशन और एलाइनमेंट सिस्टम के ज़रिए सुरक्षा गार्डरेल्स लागू करते हैं, जो यूज़र और एजेंट संदेशों का रीयल-टाइम में मूल्यांकन करता है। आने वाली सामग्री को कई जोखिम श्रेणियों में वर्गीकृत किया जाता है, जिनमें यौन सामग्री, हिंसा, उत्पीड़न, घृणा और आत्म-हानि शामिल हैं; हर श्रेणी के लिए थ्रेशहोल्ड अलग से कॉन्फ़िगर किया जा सकता है। गार्डरेल ट्रिगर होने पर, बातचीत तुरंत समाप्त कर दी जाती है और क्लाइंट को विफलता का स्पष्ट कारण बताया जाता है। इससे केवल प्रॉम्प्ट-आधारित उपायों पर निर्भर हुए बिना असुरक्षित इंटरैक्शन को जल्दी और लगातार ब्लॉक किया जाता है। गार्डरेल्स एजेंट के प्रॉम्प्ट लॉजिक के बाहर काम करते हैं और एक भरोसेमंद एनफ़ोर्समेंट लेयर देते हैं, जिसे मॉडल व्यवहार या यूज़र इनपुट बायपास नहीं कर सकते। यह तरीका ग्राहकों को रनटाइम पर निश्चित एनफ़ोर्समेंट बनाए रखते हुए अपने डोमेन के अनुसार सुरक्षा संवेदनशीलता समायोजित करने देता है।
अनुपालक डेटा प्रबंधन
बोलने वाले लोग कभी-कभी एजेंट के साथ संवेदनशील जानकारी साझा कर सकते हैं, जिस पर स्टोरेज और प्रोसेसिंग की सख्त आवश्यकताएँ लागू होती हैं, जैसे HIPAA-अनुपालक हैंडलिंग की ज़रूरत वाला मेडिकल डेटा। ऐसे उपयोग के मामलों के लिए, हम एजेंट या वर्कस्पेस स्तर पर Zero Retention Mode (ZRM) देते हैं। इसे सक्षम करने पर, कॉल का सारा डेटा केवल मेमोरी में प्रोसेस होता है और कभी परसिस्टेंट स्टोरेज में नहीं लिखा जाता। कॉल और प्रोसेसिंग पूरी होने के बाद, ElevenLabs कोई जानकारी नहीं रखता। इसलिए, Agents Dashboard में ट्रांसक्रिप्ट, ऑडियो रिकॉर्डिंग और विश्लेषण आउटपुट उपलब्ध नहीं होते, और यह नीति ग्राहक-सामने वाले सिस्टम्स व आंतरिक लॉग्स दोनों पर लागू होती है। हालाँकि डेटा रखा नहीं जाता, कॉल के दौरान उसे प्रोसेस किया जाता है और कॉन्फ़िगर किए गए पोस्ट-कॉल वेबहुक्स को आउटपुट मिलेंगे, जिससे ग्राहक ज़रूरत पड़ने पर ट्रांसक्रिप्ट या विश्लेषण परिणाम अपने सिस्टम्स में स्टोर कर सकते हैं।
ZRM सक्रिय होने पर, हम उपलब्ध LLMs को ऐसे प्रदाताओं तक सीमित करके यह भी सुनिश्चित करते हैं कि सबप्रोसेसर्स डेटा न रखें, जिनकी संविदात्मक प्रतिबद्धताएँ ग्राहक डेटा पर ट्रेनिंग या उसके रिटेंशन को रोकती हैं; फ़िलहाल इसमें Google Gemini और Anthropic Claude के मॉडल्स शामिल हैं। जो ग्राहक ZRM के तहत कोई दूसरा LLM इस्तेमाल करना चाहते हैं, वे उस प्रदाता के साथ अपना समझौता करके और उसी समझौते में शामिल API keys से उसे कस्टम LLM के रूप में कॉन्फ़िगर करके ऐसा कर सकते हैं। चूँकि इससे डेटा हैंडलिंग हमारी मानक ट्रस्ट बाउंड्री के बाहर जाती है, इसे सक्षम करने से पहले हमारी Safety टीम को उपयोग के मामले की मैन्युअल समीक्षा और मंज़ूरी देनी होती है। जहाँ ZRM यह सुनिश्चित करता है कि ElevenLabs और इसके सबप्रोसेसर्स कॉल डेटा न रखें, वहीं ग्राहक यह सुनिश्चित करने के लिए ज़िम्मेदार रहते हैं कि उनके एजेंट द्वारा इस्तेमाल किए जाने वाले किसी भी बाहरी टूल या वेबहुक पर लागू रिटेंशन और नियामक आवश्यकताओं का पालन हो।
आगे की ओर
इस पोस्ट में, हमने देखा कि ElevenLabs Agents बड़े पैमाने पर भरोसेमंद, रीयल-टाइम अनुभव देने के लिए संवाद संदर्भ, टूल्स, मूल्यांकन और संरचित वर्कफ़्लो कैसे प्रबंधित करते हैं। जैसे-जैसे ग्राहक एजेंट्स को अधिक जटिल परिवेशों में तैनात करते हैं, हम अपने ऑर्केस्ट्रेशन इंजन का लचीलापन बढ़ाते रहते हैं—कॉन्फ़िगर किए जा सकने वाले मूल्यांकन मॉडल्स और बेहतर ट्रांज़िशन नियंत्रणों से लेकर चरणों में प्रॉम्प्ट कंपोज़िशन व टोकन उपयोग की गहरी ऑब्ज़र्वेबिलिटी तक।
हमारी Forward Deployed Engineering टीम ग्राहकों के साथ करीबी साझेदारी में काम कर रही है, ताकि ये क्षमताएँ वास्तविक दुनिया की तैनातियों के साथ कदम से कदम मिलाकर विकसित हों। Agents की अगली पीढ़ी, रीयल-टाइम बातचीत को संभव बनाने वाले कम-लेटेंसी प्रदर्शन से समझौता किए बिना, और भी अधिक पारदर्शिता, निश्चितता और अनुकूलनशीलता देगी।

