हमने RAG को 50% तेज़ कैसे बनाया
- लेखक
- Michal Korbela
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
RAG, बड़े नॉलेज बेस में LLM के जवाबों को आधार देकर AI एजेंट्स की सटीकता बढ़ाता है। पूरे नॉलेज बेस को LLM को भेजने के बजाय, RAG क्वेरी को एम्बेड करता है, सबसे प्रासंगिक जानकारी खोजता है और उसे मॉडल को कॉन्टेक्स्ट के रूप में देता है। हमारे सिस्टम में, हम पहले क्वेरी री-राइटिंग का चरण जोड़ते हैं, जो जानकारी खोजने से पहले संवाद की हिस्ट्री को एक सटीक, अपने-आप में पूरी क्वेरी में बदल देता है।
बहुत छोटे नॉलेज बेस के लिए, सब कुछ सीधे प्रॉम्प्ट में देना आसान हो सकता है। लेकिन नॉलेज बेस बड़ा होने पर, RAG मॉडल पर ज़्यादा भार डाले बिना जवाबों को सटीक रखने के लिए ज़रूरी हो जाता है।
कई सिस्टम RAG को एक बाहरी टूल की तरह इस्तेमाल करते हैं, लेकिन हमने इसे सीधे रिक्वेस्ट पाइपलाइन में बनाया है, ताकि यह हर क्वेरी पर चले। इससे सटीकता लगातार बनी रहती है, लेकिन लेटेंसी का जोखिम भी पैदा होता है।
क्वेरी री-राइटिंग ने हमें धीमा क्यों किया
ज़्यादातर यूज़र रिक्वेस्ट पहले की बातचीत का संदर्भ देती हैं, इसलिए सिस्टम को संवाद की हिस्ट्री को एक सटीक, अपने-आप में पूरी क्वेरी में बदलना होता है।
उदाहरण के लिए:
- अगर यूज़र पूछता है: “क्या हम अपने पीक ट्रैफ़िक पैटर्न के आधार पर उन लिमिट्स को कस्टमाइज़ कर सकते हैं?"
- सिस्टम इसे इस तरह री-राइट करता है: “क्या Enterprise प्लान की API रेट लिमिट्स को खास ट्रैफ़िक पैटर्न के लिए कस्टमाइज़ किया जा सकता है?”
री-राइटिंग, “उन लिमिट्स” जैसे अस्पष्ट संदर्भों को अपने-आप में पूरी क्वेरी में बदल देती है, जिन्हें रिट्रीवल सिस्टम इस्तेमाल कर सकते हैं। इससे कॉन्टेक्स्ट और अंतिम जवाब की सटीकता बेहतर होती है। लेकिन एक ही बाहरी तौर पर होस्ट किए गए LLM पर निर्भरता ने उसकी गति और अपटाइम पर कड़ी निर्भरता बना दी। अकेले इस चरण का RAG लेटेंसी में 80% से ज़्यादा हिस्सा था।
मॉडल रेसिंग से हमने इसे कैसे ठीक किया
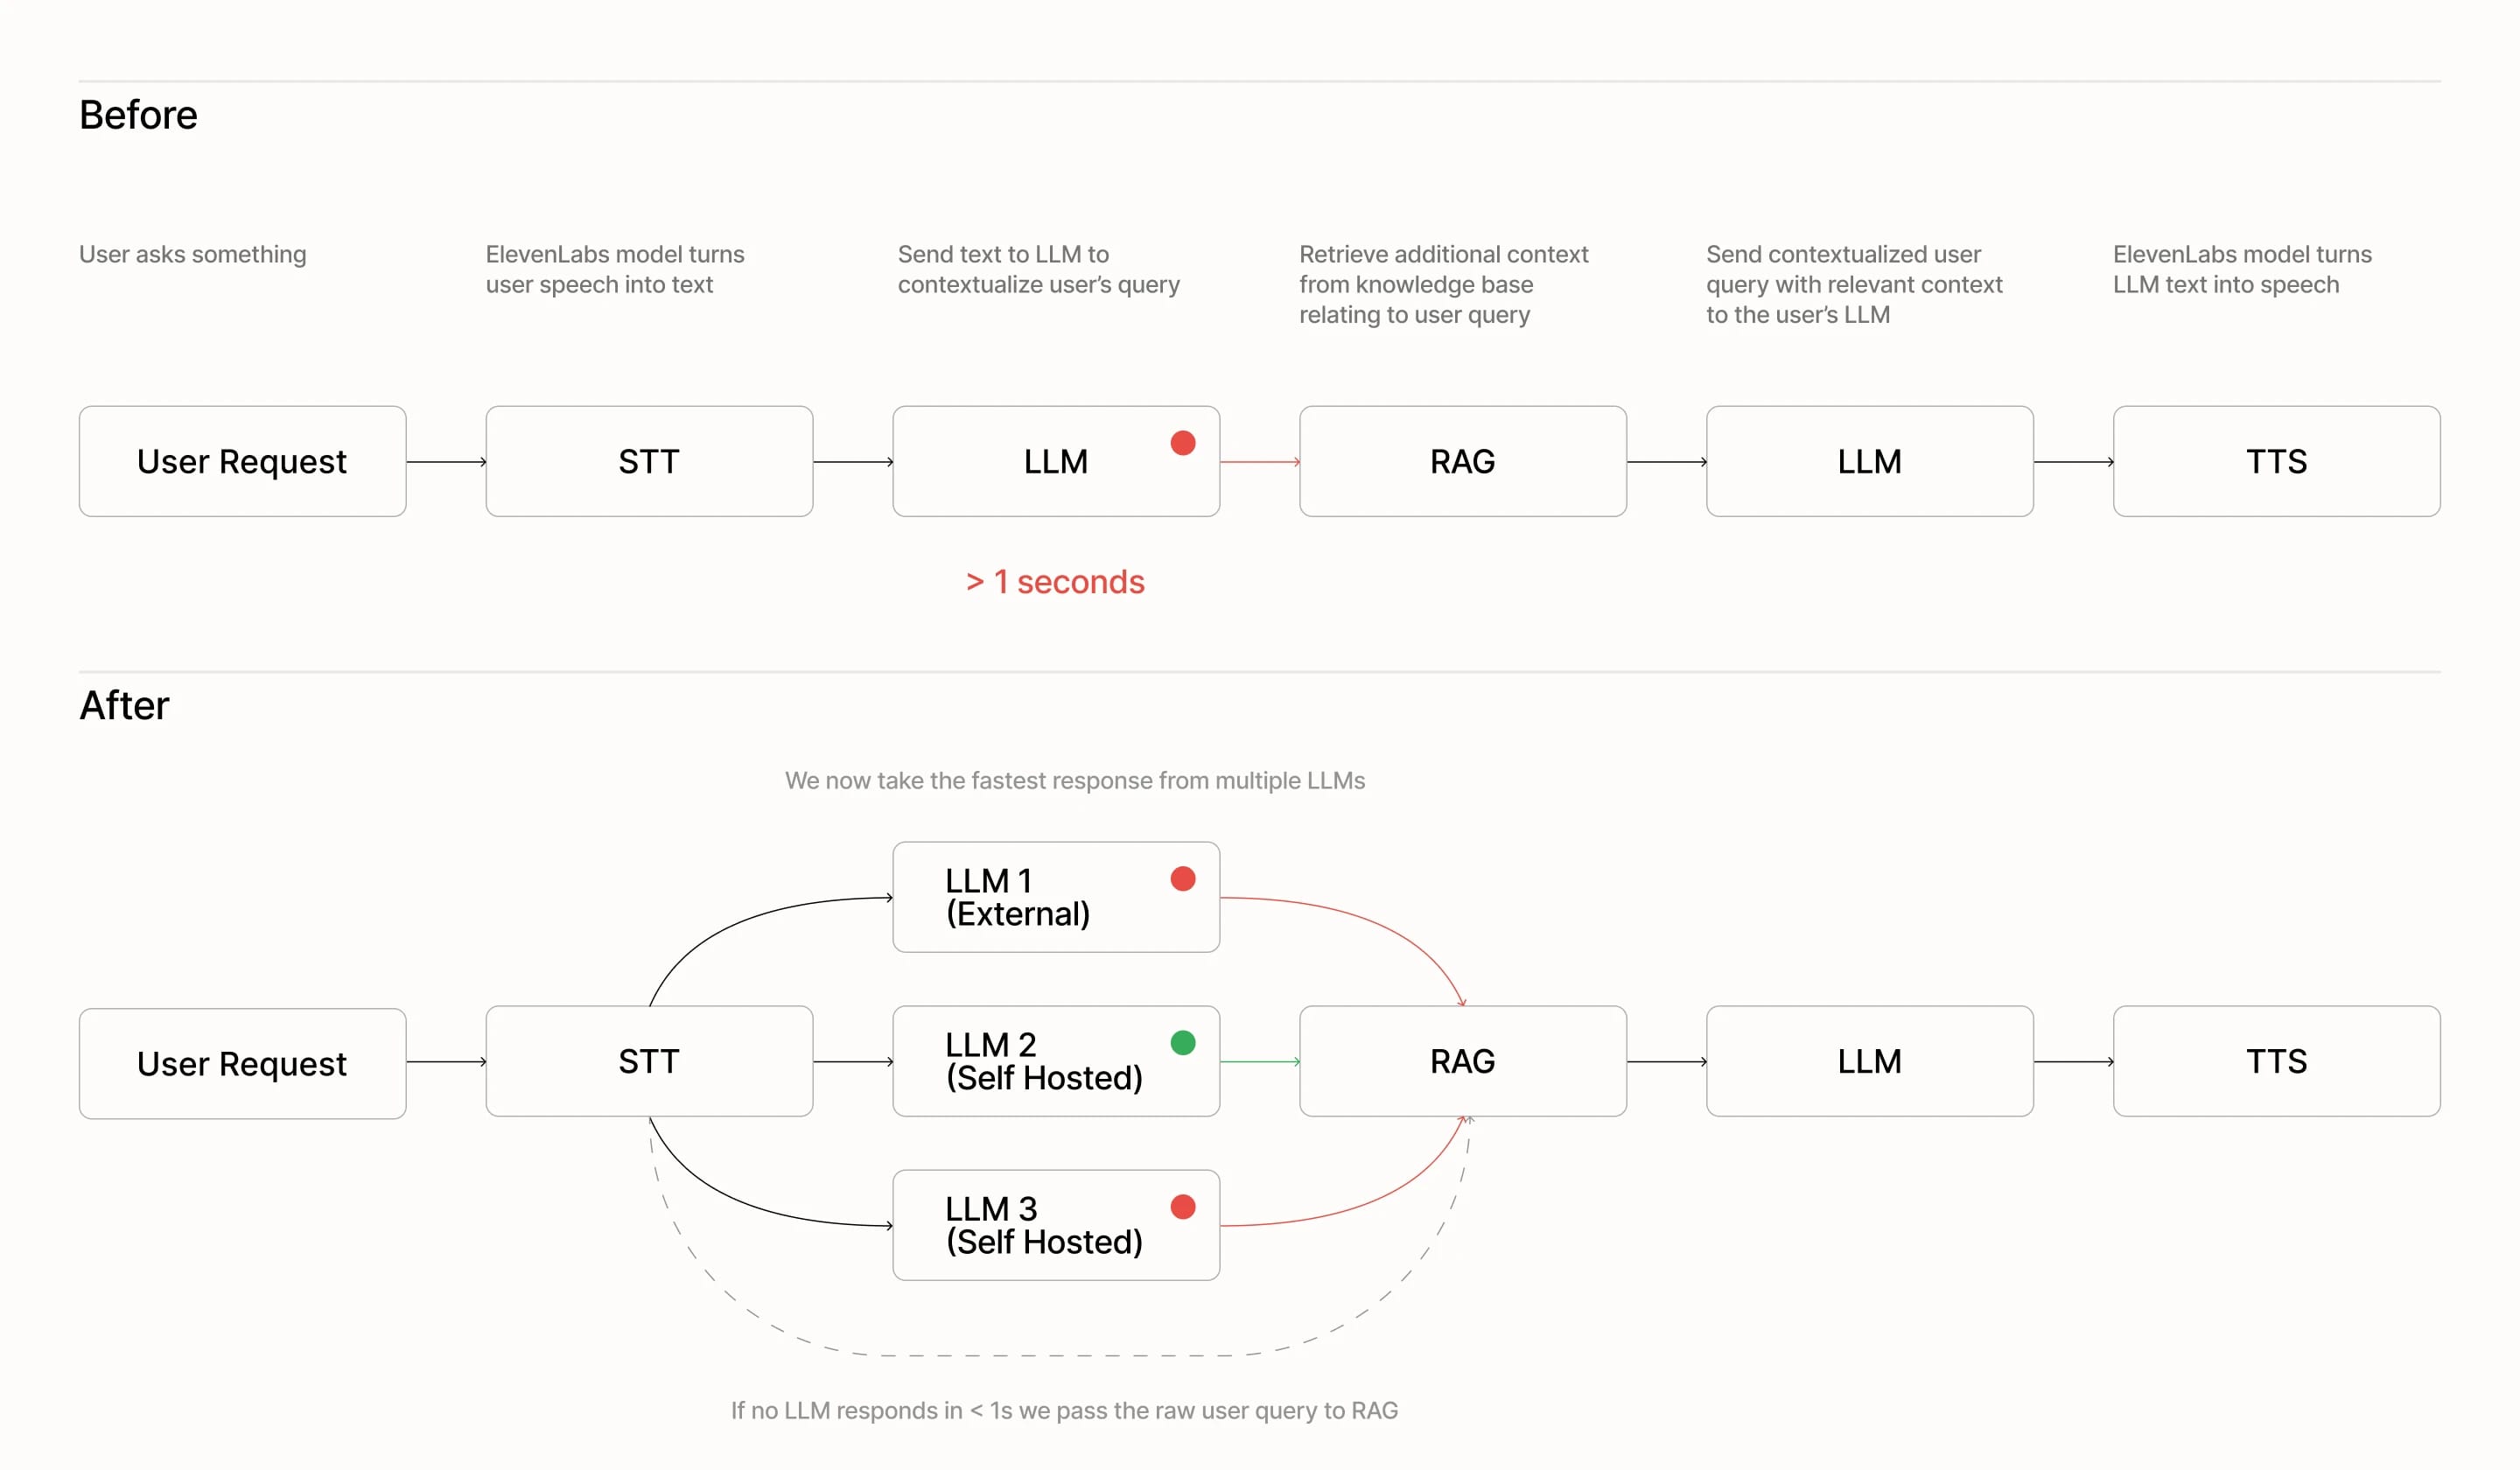
हमने क्वेरी री-राइटिंग को रेस की तरह चलाने के लिए फिर से डिज़ाइन किया:
- कई मॉडल्स समानांतर में. हर क्वेरी को एक साथ कई मॉडल्स को भेजा जाता है, जिनमें हमारे सेल्फ-होस्टेड Qwen 3-4B और 3-30B-A3B मॉडल्स शामिल हैं। पहला वैध जवाब चुन लिया जाता है।
- बातचीत को जारी रखने वाले फ़ॉलबैक. अगर एक सेकंड के भीतर कोई मॉडल जवाब नहीं देता, तो हम यूज़र के मूल मैसेज पर लौट आते हैं। यह कम सटीक हो सकता है, लेकिन रुकावटों से बचाता है और बातचीत की निरंतरता बनाए रखता है।
परफ़ॉर्मेंस पर असर
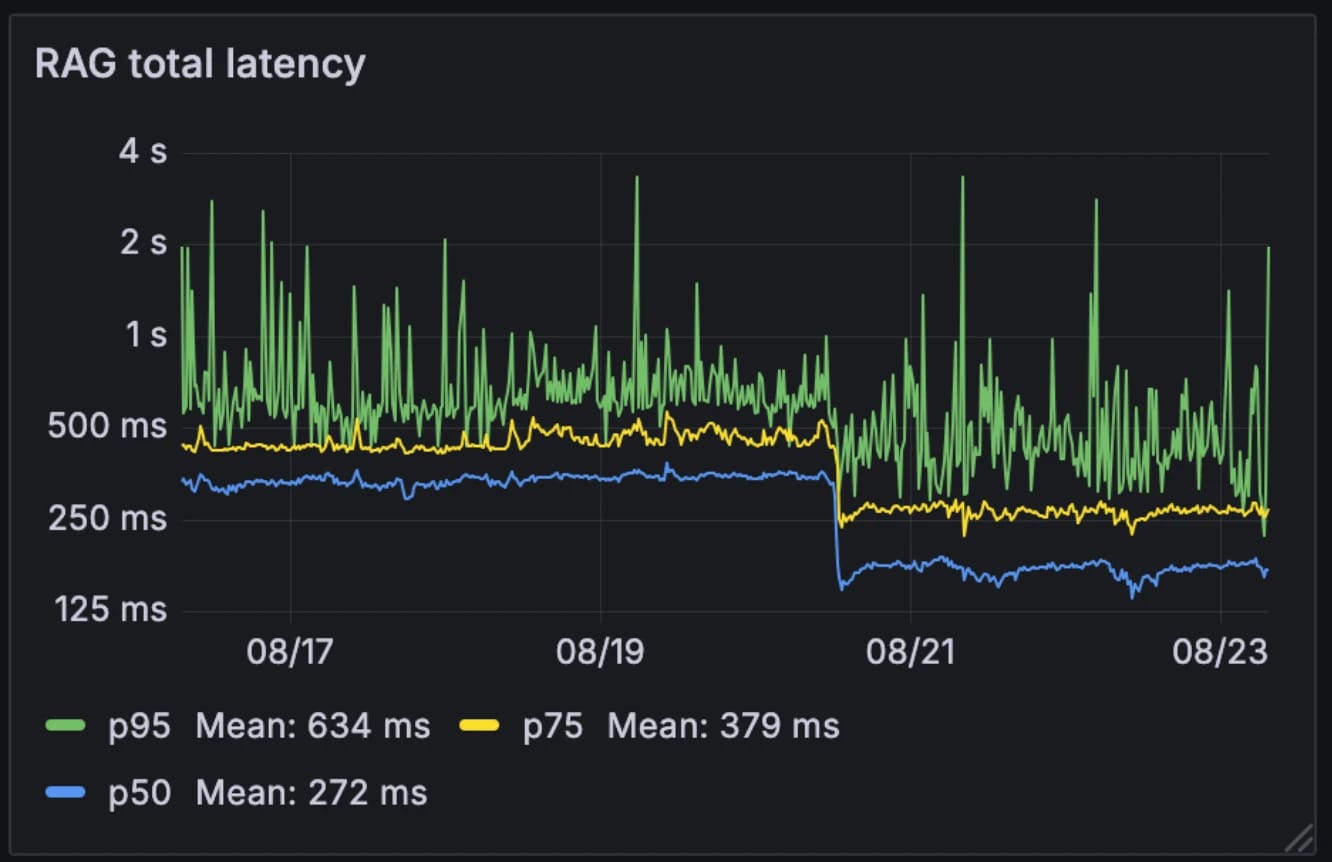
इस नई आर्किटेक्चर ने औसत RAG लेटेंसी को आधा कर दिया—326ms से 155ms तक। कई सिस्टम RAG को बाहरी टूल के रूप में चुनिंदा रूप से ट्रिगर करते हैं, लेकिन हम इसे हर क्वेरी पर चलाते हैं। औसत लेटेंसी 155ms तक आने के बाद, ऐसा करने का अतिरिक्त भार न के बराबर है।
पहले और बाद की लेटेंसी:
- औसत: 326ms → 155ms
- p75: 436ms → 250ms
- p95: 629ms → 426ms
इस आर्किटेक्चर ने सिस्टम को मॉडल्स की परफ़ॉर्मेंस में होने वाले बदलावों के प्रति ज़्यादा भरोसेमंद भी बनाया। बाहरी तौर पर होस्ट किए गए मॉडल्स, ज़्यादा मांग वाले घंटों में धीमे हो सकते हैं, जबकि हमारे आंतरिक मॉडल्स अपेक्षाकृत स्थिर रहते हैं। मॉडल्स को रेस में चलाने से यह बदलाव संतुलित हो जाता है और अलग-अलग मॉडल्स की अनिश्चित परफ़ॉर्मेंस, सिस्टम के अधिक स्थिर व्यवहार में बदल जाती है।
उदाहरण के लिए, पिछले महीने हमारे एक LLM प्रोवाइडर में आउटेज आने पर भी, हमारी सेल्फ-होस्टेड मॉडल्स पर बातचीत बिना किसी रुकावट के जारी रही। हम यह इन्फ्रास्ट्रक्चर पहले से ही दूसरी सेवाओं के लिए चलाते हैं, इसलिए अतिरिक्त कंप्यूट लागत न के बराबर है।
यह क्यों मायने रखता है
200ms से कम की RAG क्वेरी री-राइटिंग, कन्वर्सेशनल एजेंट्स की एक बड़ी बाधा को हटा देती है। नतीजा ऐसा सिस्टम है जो बड़े एंटरप्राइज़ नॉलेज बेस पर काम करते हुए भी कॉन्टेक्स्ट समझता है और रियल-टाइम रहता है। रिट्रीवल का अतिरिक्त भार लगभग न के बराबर होने से, कन्वर्सेशनल एजेंट्स परफ़ॉर्मेंस से समझौता किए बिना स्केल कर सकते हैं।