
Python स्पीच रिकग्निशन ट्यूटोरियल: ऑडियो फ़ाइल से ट्रांसक्रिप्ट तक
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
Python ऐप में स्पीच रिकग्निशन क्षमताएं जोड़ना पहले मुश्किल था। Python डेवलपर्स को ट्रांसक्रिप्शन प्रक्रिया के लिए खुद कोड लिखना पड़ता था, जिसमें ऑडियो प्रीप्रोसेसिंग, फीचर एक्सट्रैक्शन और मॉडल इंटीग्रेशन शामिल थे। साथ ही, इंजीनियरिंग टीमों को लो-लेवल ऑडियो हैंडलिंग, कमज़ोर ट्रांसक्रिप्शन क्वालिटी और बोले गए शब्दों व लाइव कैप्शन के बीच देरी जैसी चुनौतियों से जूझना पड़ता था।
ऑडियो मॉडल और स्पीच रिकग्निशन SDKs में हुई प्रगति ने इसे बदल दिया है।
इस Python स्पीच रिकग्निशन ट्यूटोरियल में, आप ElevenLabs के स्पीच टू टेक्स्ट ऑडियो मॉडल को अपने Python प्रोजेक्ट में इंटीग्रेट करके कमर्शियल उपयोग के लिए तैयार ट्रांसक्रिप्शन ऐप्स बनाना सीखेंगे।
सारांश
- कमर्शियल स्पीच टू टेक्स्ट मॉडल में स्पीकर डायरीकरण, शब्द-स्तरीय टाइमस्टैम्प और कीटर्म प्रॉम्प्टिंग जैसी सुविधाएं मिलती हैं, जो बुनियादी स्पीच रिकग्निशन मॉडल में नहीं होतीं।
- ElevenAPI, Scribe v2 और Scribe v2 Realtime के साथ आपके Python कोड में स्पीच रिकग्निशन क्षमताएं जोड़ता है।
- डेवलपर्स आधिकारिक API डॉक्यूमेंटेशन के आधार पर सटीक Python कोड जनरेट करने के लिए AI कोडिंग प्लेटफ़ॉर्म पर ElevenLabs स्किल्स इंस्टॉल कर सकते हैं।
- कमर्शियल डेवलपमेंट के लिए पेड प्लान लेने से पहले आप ElevenLabs API को मुफ़्त में आजमा सकते हैं।
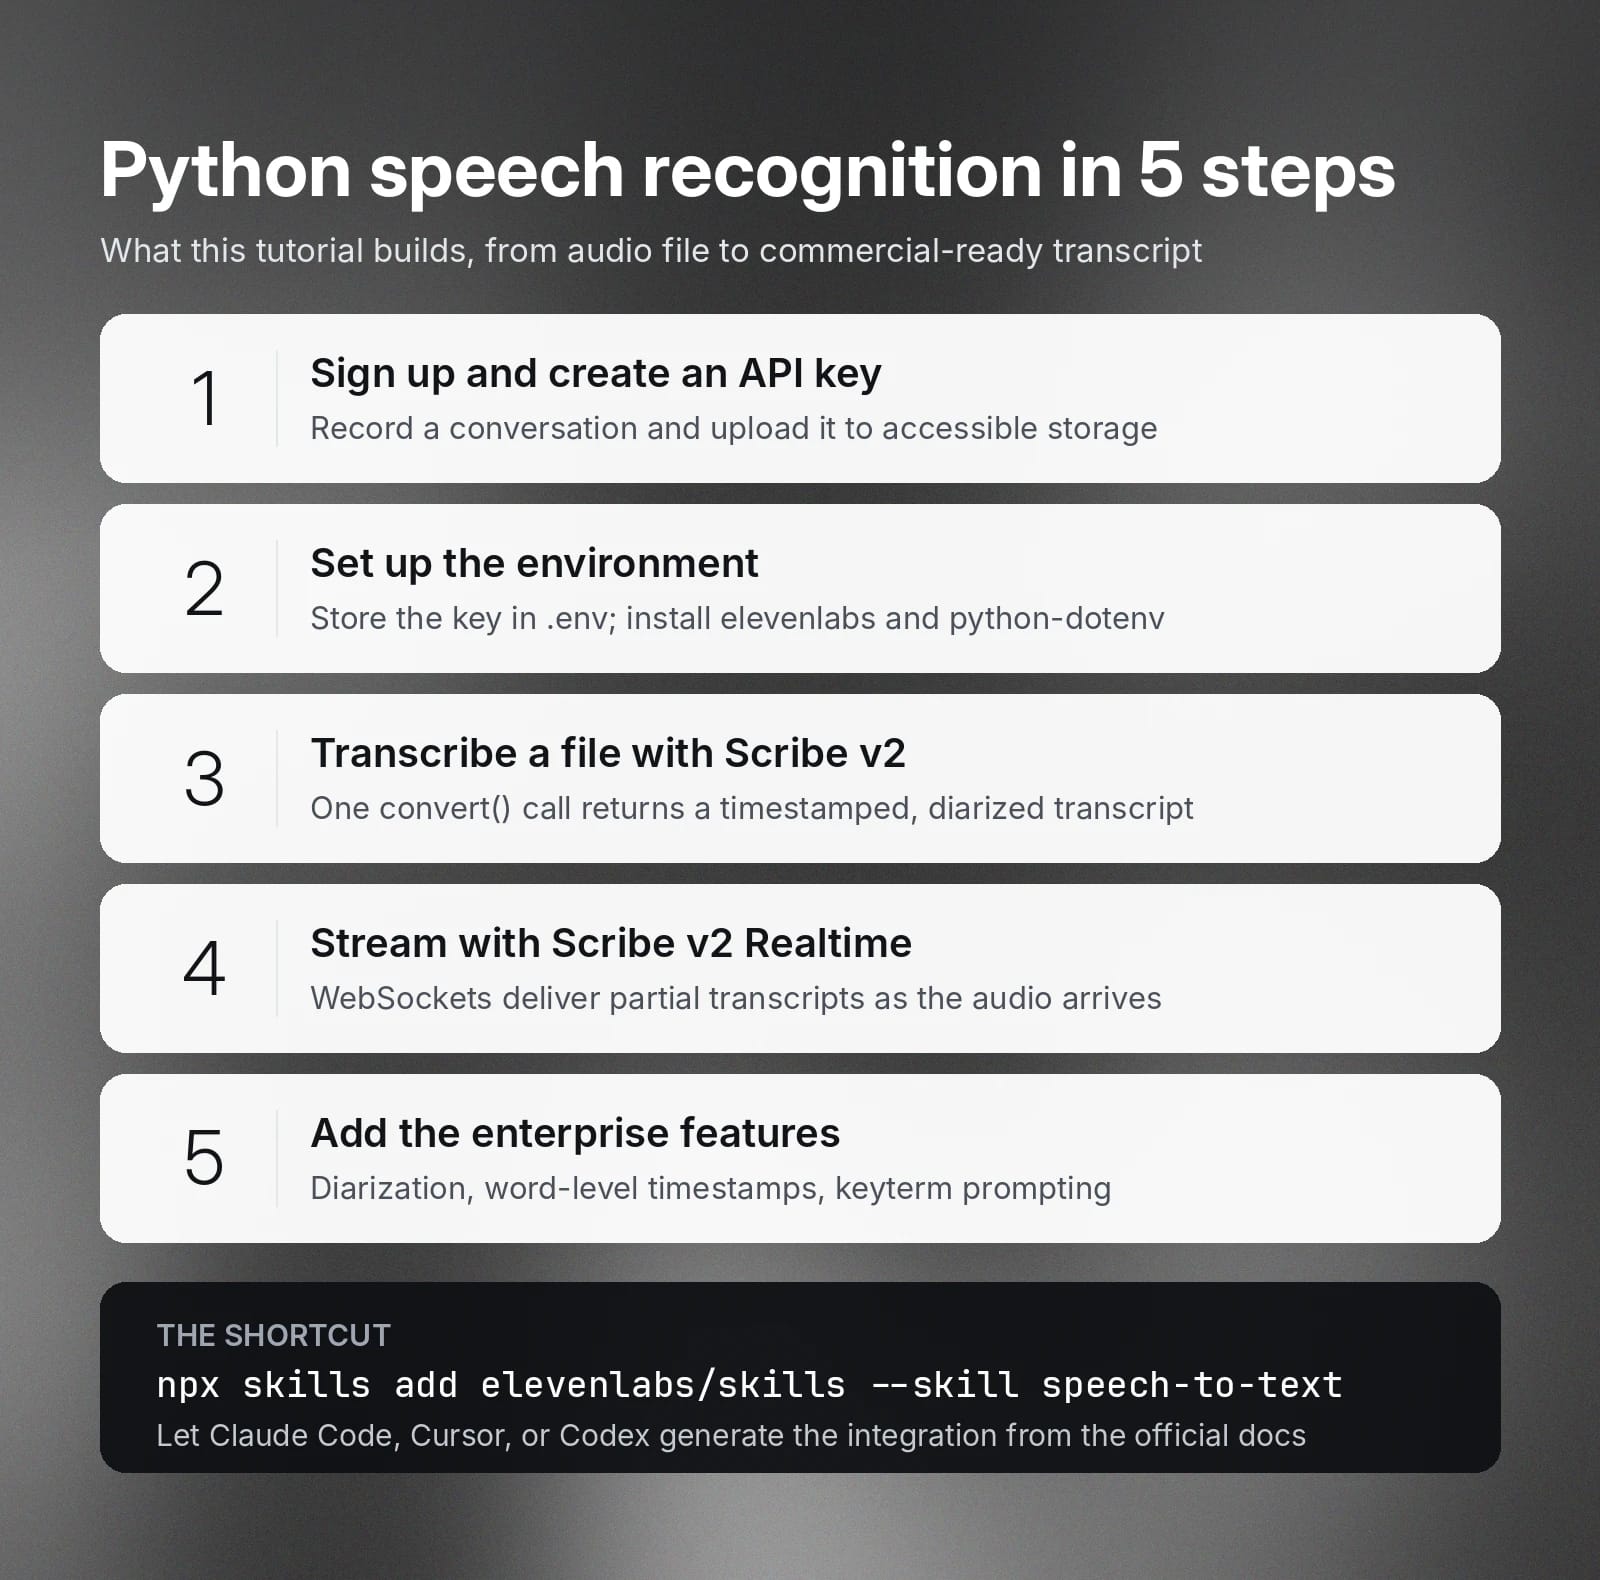
इस Python स्पीच रिकग्निशन ट्यूटोरियल में क्या शामिल है
इस ट्यूटोरियल में आवश्यक तैयारी, API इंटीग्रेशन और एडवांस्ड ट्रांसक्रिप्शन सुविधाएं शामिल हैं, जिनसे आप एंटरप्राइज़ उपयोग के लिए स्पीच रिकग्निशन Python ऐप बना सकते हैं।
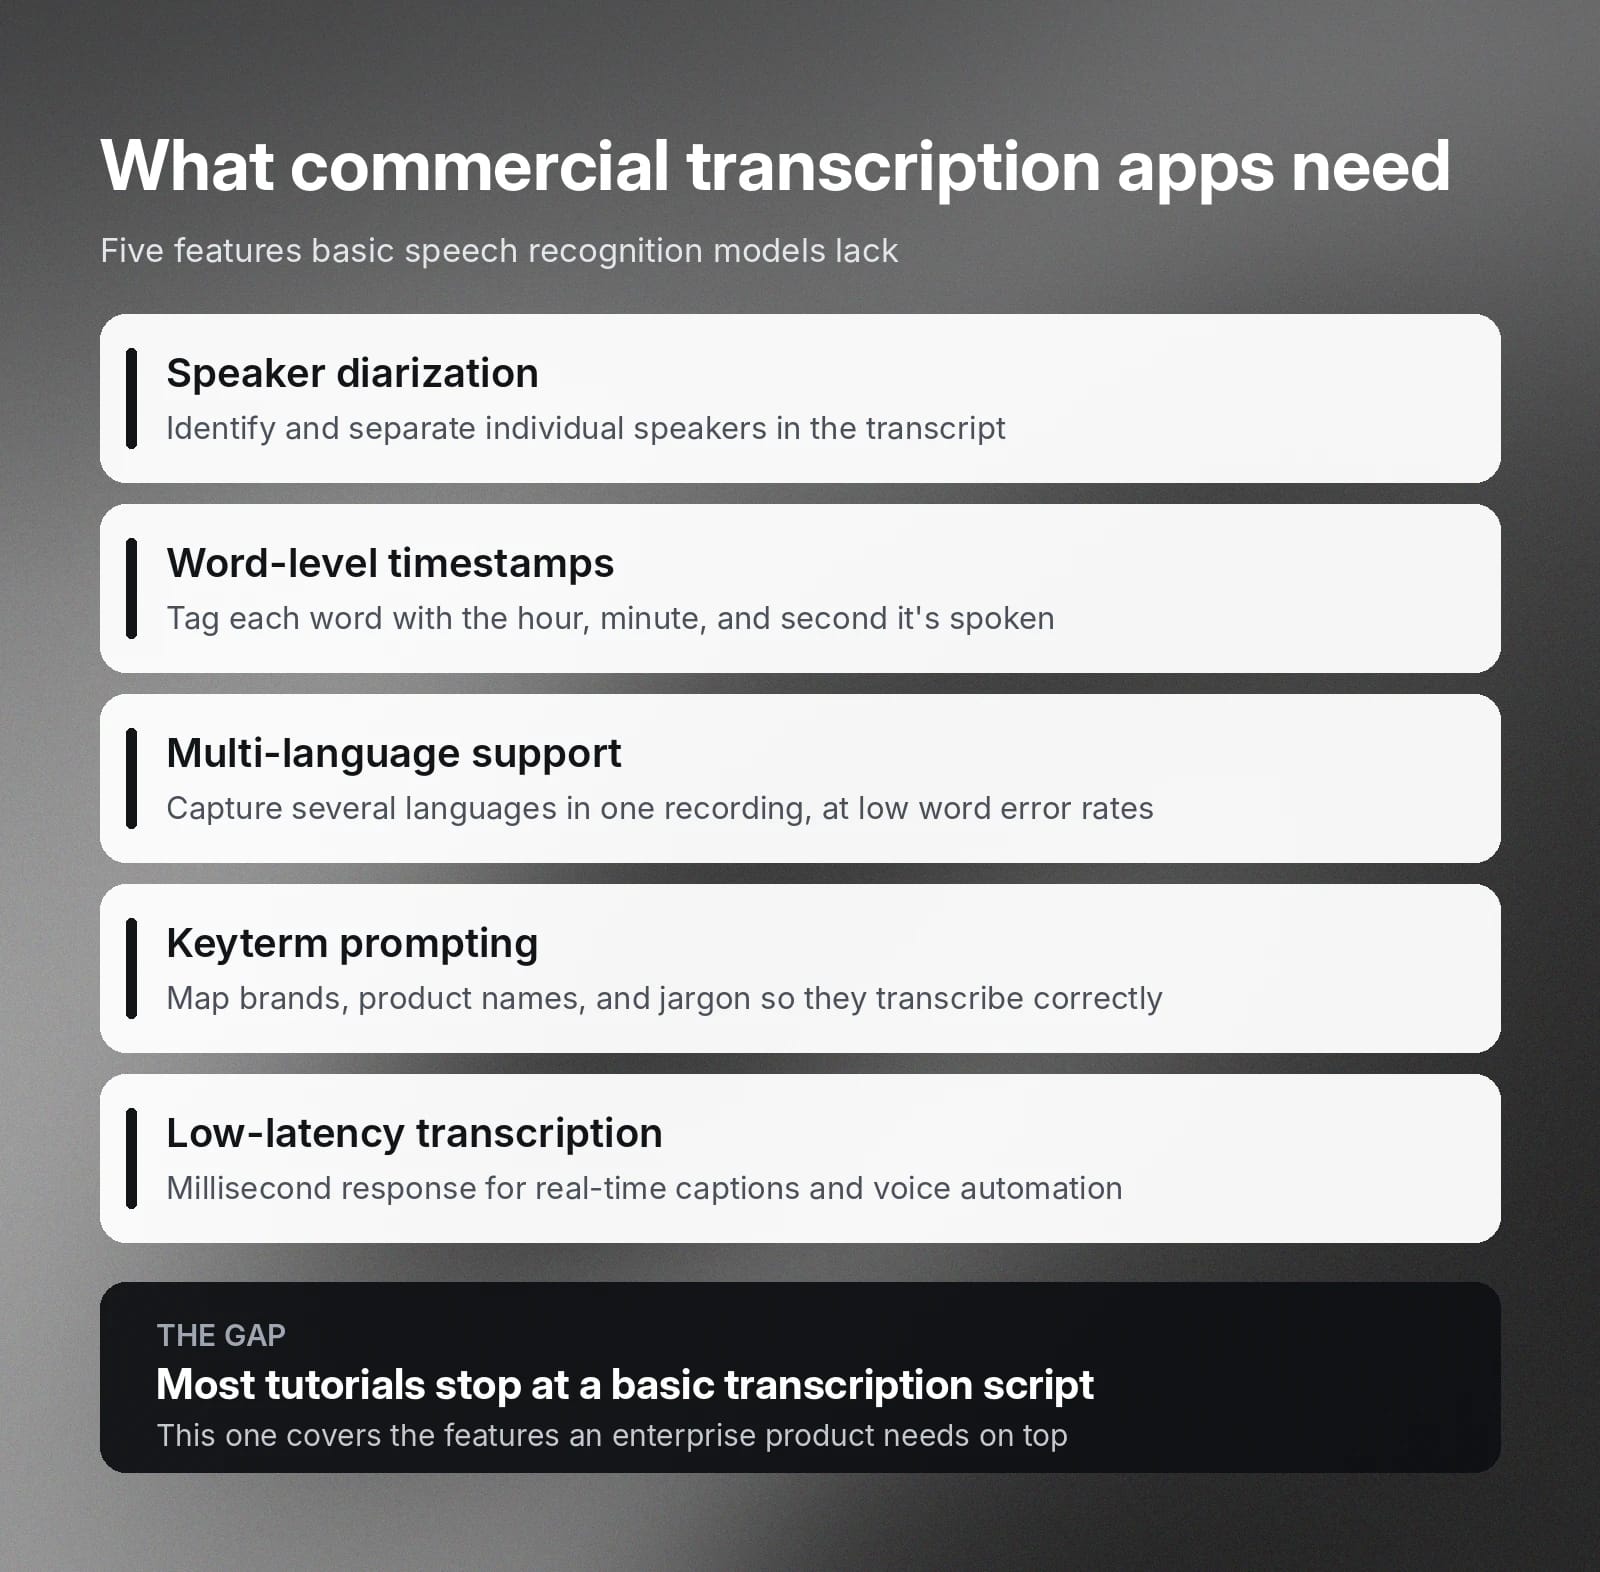
हाल के वर्षों में स्पीच रिकग्निशन काफी विकसित हुआ है, खासकर बड़े भाषा मॉडल और डीप लर्निंग न्यूरल नेटवर्क्स के कारण Python डेवलपर्स के ट्रांसक्रिप्शन SDKs इस्तेमाल करने का तरीका बदल गया है। कई ट्यूटोरियल बुनियादी ट्रांसक्रिप्शन ऐप्स बनाना बताते हैं, लेकिन कम ही ऐसे फीचर्स कवर करते हैं जिनकी कमर्शियल उपयोग के लिए तैयार प्रोडक्ट को ज़रूरत होती है।
इसी कमी को पूरा करने के लिए हमने यह ट्यूटोरियल लिखा है।
उदाहरण के लिए, कई एंटरप्राइज़ ट्रांसक्रिप्शन समाधानों में इन सुविधाओं की ज़रूरत होती है:
- स्पीकर डायरीकरण: ट्रांसक्रिप्ट में अलग-अलग वक्ताओं की पहचान करने और उन्हें अलग करने की क्षमता।
- टाइमस्टैम्प: हर शब्द को उसके बोले जाने के सापेक्ष घंटे, मिनट और सेकंड के साथ सटीक रूप से टैग करना।
- बहुभाषी सहायता: कम वर्ड एरर रेट के साथ एक ही रिकॉर्डिंग या लाइव स्ट्रीम में अलग-अलग भाषाओं के भाषण को कैप्चर करती है।
- कीटर्म प्रॉम्प्टिंग: गलत वर्तनी वाले ट्रांसक्रिप्शन से बचने के लिए ब्रांड, प्रोडक्ट नाम और तकनीकी शब्दों जैसे खास शब्दों को मैप करना।
- लो-लेटेंसी ट्रांसक्रिप्शन: मिलीसेकंड में मिलने वाला स्पीच-टू-टेक्स्ट रिस्पॉन्स, जो रियल-टाइम ट्रांसक्रिप्शन ऐप्स को चलाता है।
नोट: यह ट्यूटोरियल हॉबी या निजी प्रोजेक्ट्स के लिए सरल व्यक्तिगत स्क्रिप्ट बनाने से आगे जाता है। इसमें स्पीच टू टेक्स्ट API इंटीग्रेशन के ऊपर बनने वाला एप्लिकेशन लॉजिक शामिल नहीं है, क्योंकि यह हर बिज़नेस के लिए अलग होता है।
Python स्पीच रिकग्निशन इंटीग्रेशन के लिए आवश्यक तैयारी
हमने यह ट्यूटोरियल ElevenAPI के आधार पर तैयार किया है। यह ElevenLabs की प्रोडक्शन-ग्रेड API है, जो आपके कोड में वॉइस मॉडल के साथ काम करना आसान बनाती है। ElevenAPI के साथ आपको Scribe v2 और Scribe v2 Realtime का एक्सेस मिलता है, जो बैच और लाइव ट्रांसक्रिप्शन के लिए हमारे प्रमुख वॉइस मॉडल हैं।
ElevenLabs स्पीच टू टेक्स्ट मॉडल को सीधे एक्सेस करने के बजाय, आप API कॉल्स के ज़रिए ऑडियो रिकॉर्डिंग, लाइव स्ट्रीम और आर्ग्युमेंट्स भेजते हैं। फिर ऑडियो मॉडल ऑडियो डेटा को टेक्स्ट में बदल देता है। काम पूरा होने पर आपको कोड में या वेबहुक के ज़रिए ट्रांसक्रिप्ट मिलते हैं।
शुरू करने के लिए, ये तैयारी के चरण पूरे करें।
- ElevenLabs के लिए साइन अप करें।
- अपनी API key बनाएं।
- एक बातचीत रिकॉर्ड करें और उसे सार्वजनिक रूप से एक्सेस की जा सकने वाली स्टोरेज पर अपलोड करें।
तैयार होने पर अगले सेक्शन पर जाएं।
अपना एनवायरनमेंट सेट अप करना
ElevenLabs मॉडल के साथ इंटीग्रेट करने से पहले, अपनी ElevenLabs API key को सुरक्षित रखने के लिए Python एनवायरनमेंट सेट अप करें। सभी API keys की तरह, हम इसे .env फ़ाइल में एनवायरनमेंट वेरिएबल (मैनेज्ड सीक्रेट) के रूप में स्टोर करने की सलाह देते हैं।
API कॉल करते समय, आप एनवायरनमेंट वेरिएबल पास करते हैं। इससे पब्लिक नेटवर्क पर API रिक्वेस्ट करते समय API key गलती से एक्सपोज़ होने से बचती है।
इसके बाद, अपने Python एनवायरनमेंट में ElevenLabs SDK, elevenlabs, इंस्टॉल करने के लिए Bash कमांड चलाएं। SDK आपको कई वॉइस मॉडल का एक्सेस देता है। इस मामले में, आप Scribe v2 और Scribe v2 Realtime में से चुनते हैं।
आपको python-dotenv भी इंस्टॉल करना होगा, जिससे आपका Python कोड .env फ़ाइल में स्टोर एनवायरनमेंट वेरिएबल्स को एक्सेस कर सके।
अपनी पहली ट्रांसक्रिप्शन स्क्रिप्ट लिखना
Python एनवायरनमेंट सेट अप करने के बाद, आप ElevenLabs Scribe v2 से ऑडियो फ़ाइल ट्रांसक्राइब कर सकते हैं।
ElevenLabs Scribe v2 इंडस्ट्री-लीडिंग स्पीच रिकग्निशन मॉडल है, जिससे आप बड़े पैमाने पर ऑडियो फ़ाइलें ट्रांसक्राइब कर सकते हैं। ऑडियो रिकॉर्डिंग में काफ़ी बैकग्राउंड नॉइज़ होने पर भी यह फोनीम्स को बहुत सटीकता से पहचानता है। ऑडियो ट्रांसक्राइब करने के लिए, आप रिकॉर्डिंग को ElevenLabs API के ज़रिए मॉडल पर भेजते हैं और पूरा ट्रांसक्रिप्ट पाते हैं।
नीचे एक Python कोड स्निपेट है, जो ऑडियो फ़ाइल को टाइमस्टैम्प और डायरीकरण वाले ट्रांसक्रिप्ट में बदलता है।
कोड उन ज़रूरी लाइब्रेरीज़ को लोड करता है जो आवश्यक फ़ंक्शन देती हैं। यह आपके घोषित किए गए एनवायरनमेंट वेरिएबल्स को भी प्रोग्राम के एनवायरनमेंट में लोड करता है।
फिर यह एनवायरनमेंट वेरिएबल में स्टोर API key का इस्तेमाल करके ElevenLabs क्लाइंट बनाता है। इसके बाद, यह ऑडियो फ़ाइल डाउनलोड करके उसे बाइनरी डेटा में बदलता है।
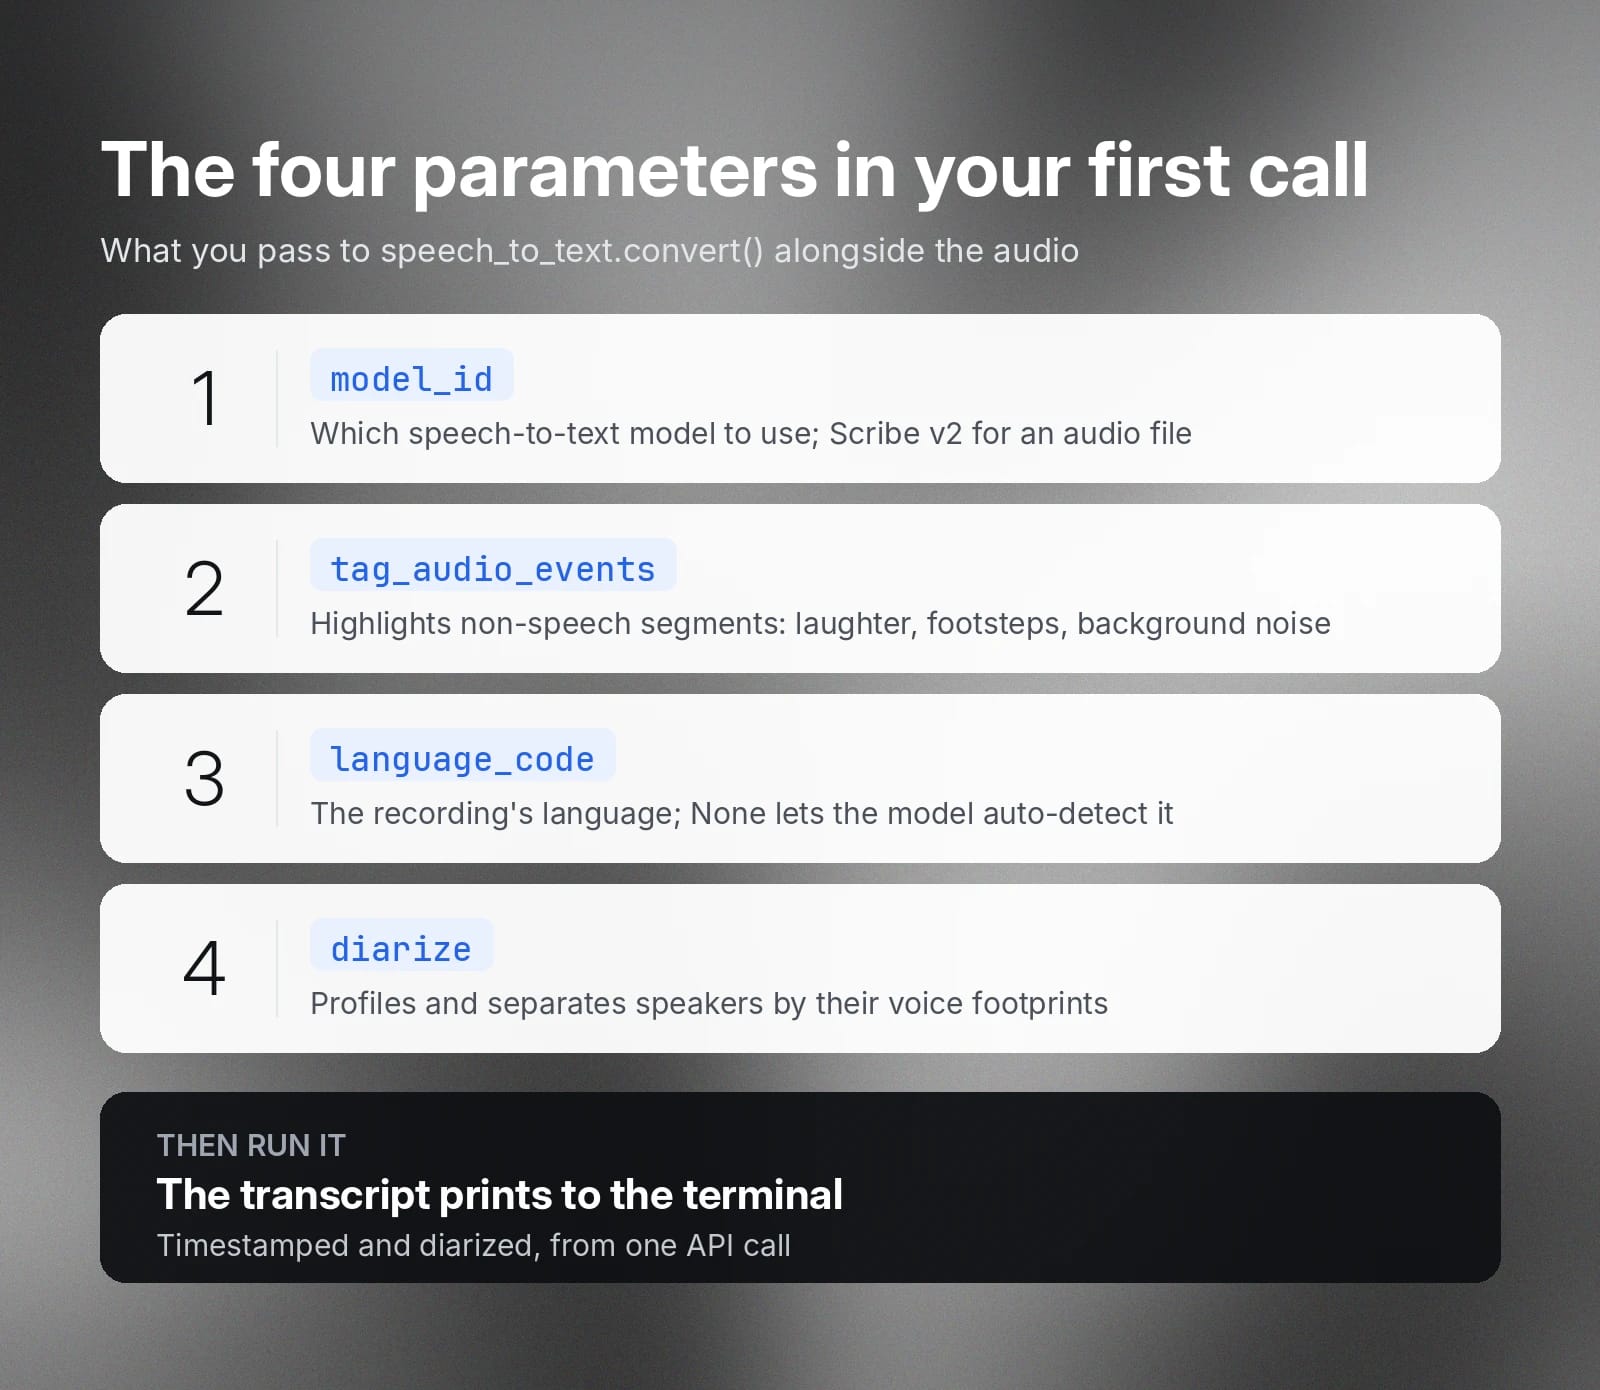
रॉ ऑडियो डेटा मिलने के बाद, आप उसे कई पैरामीटर्स के साथ ElevenLabs API पर भेजते हैं।
- model_id उस स्पीच-टू-टेक्स्ट मॉडल को बताता है जिसका आप उपयोग करना चाहते हैं। चूंकि आप ऑडियो फ़ाइल भेज रहे हैं, इसलिए Scribe v2 सबसे अच्छा विकल्प है।
- tag_audio_events आपको हंसी, कदमों की आवाज़ और दूसरे बैकग्राउंड नॉइज़ जैसे गैर-भाषण सेगमेंट हाइलाइट करने देता है।
- language_code रिकॉर्डिंग फ़ाइल में मौजूद बातचीत की भाषा बताता है। इसे None पर सेट करने पर मॉडल भाषा को अपने-आप पहचान लेगा।
- diarize बताता है कि आप मॉडल से अलग-अलग वक्ताओं की वॉइस प्रोफ़ाइल के आधार पर उनकी पहचान और उन्हें अलग करना चाहते हैं या नहीं।
अंत में, कोड चलाएं और आपको टर्मिनल में ट्रांसक्राइब किया गया ऑडियो दिखेगा।
Python में स्ट्रीमिंग स्पीच रिकग्निशन
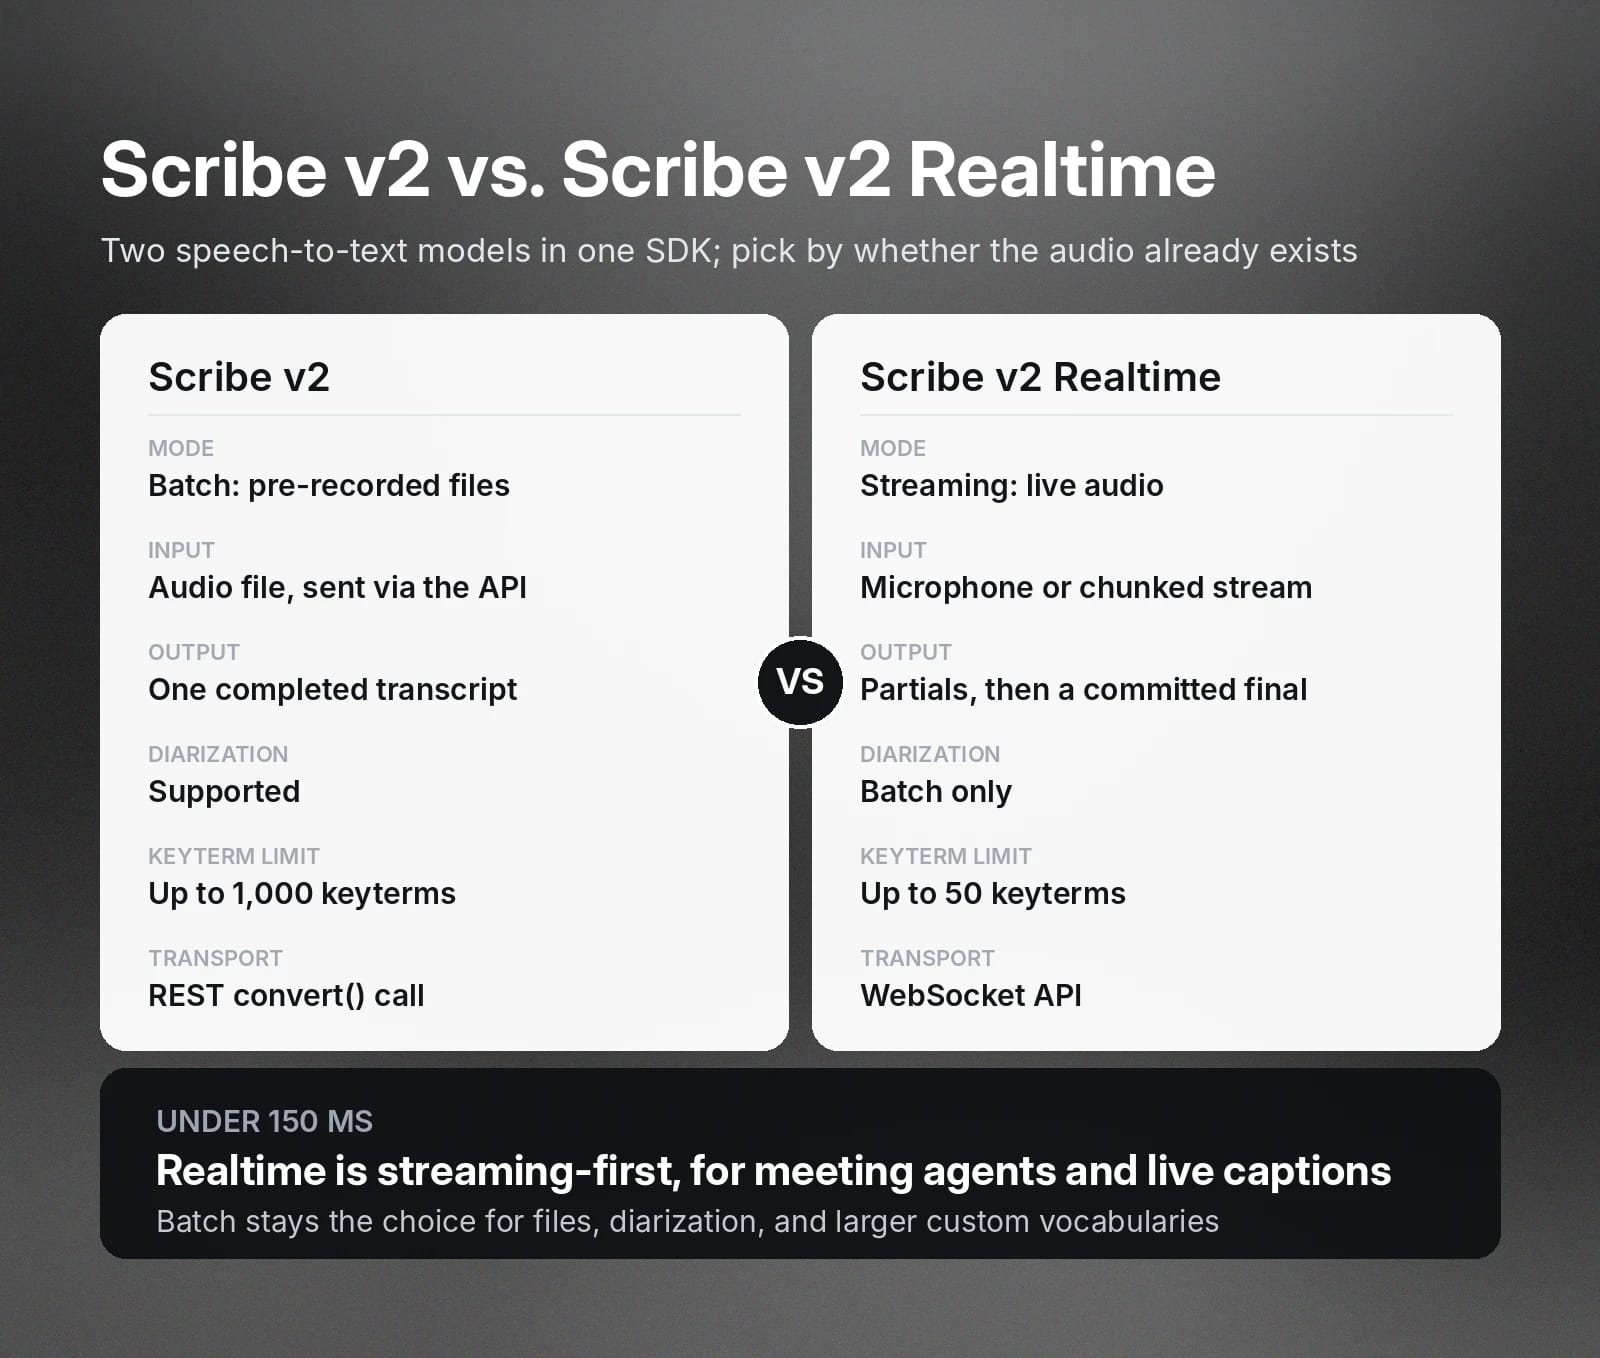
ऊपर दिया उदाहरण बैच ट्रांसक्रिप्शन को कवर करता है, जो पहले से रिकॉर्ड की गई फ़ाइलों के लिए उपयुक्त है। लेकिन ElevenLabs ऐसी APIs भी देता है जिनसे आप स्ट्रीमिंग स्पीच रिकग्निशन बना सकते हैं। बैच प्रोसेसिंग के विपरीत, यह मोड बातचीत के दौरान ही रियल टाइम में स्पीच रिकग्निशन चलाकर ट्रांसक्रिप्ट जनरेट करता है।
इसके लिए, आप WebSocket API का उपयोग करके अपने Python कोड को Scribe v2 Realtime मॉडल से कनेक्ट करते हैं।
Scribe v2 Realtime की स्ट्रीमिंग-फर्स्ट आर्किटेक्चर में ट्रांसक्रिप्शन लेटेंसी 150ms से कम है। आप Scribe v2 Realtime का उपयोग मीटिंग एजेंट्स, एक्सेसिबिलिटी टूल्स और वॉइस-एक्टिवेटेड ऑटोमेशन जैसे ऐप्लिकेशन बनाने के लिए करते हैं। ऑडियो स्ट्रीम प्रोसेस करते समय मॉडल आंशिक ट्रांसक्रिप्ट लौटाता है। कोड द्वारा किसी ऑडियो सेगमेंट को ऑटोमैटिक या मैन्युअल रूप से कमिट करने पर ही यह अंतिम ट्रांसक्रिप्ट लौटाता है।
आपके ऑडियो सोर्स और ऐप्लिकेशन के प्रकार के अनुसार, आप स्पीच रिकग्निशन को ElevenLabs API के साथ सर्वर-साइड या क्लाइंट-साइड पर इंटीग्रेट करते हैं।
- क्लाइंट-साइड स्ट्रीमिंग से आप सीधे माइक्रोफ़ोन से या मैन्युअल रूप से चंक की गई ऑडियो स्ट्रीम के ज़रिए स्ट्रीम कर सकते हैं।
- सर्वर-साइड स्ट्रीमिंग URL या ऑडियो सोर्स से ऑडियो डेटा को वॉइस मॉडल तक पहुंचाती है।
क्लाइंट-साइड और सर्वर-साइड, दोनों स्ट्रीमिंग आपको असिंक्रोनस वर्कफ़्लो इस्तेमाल करने देते हैं। API को लगातार पोल करने के बजाय, नतीजे संभालने के लिए WebSockets का उपयोग करें। अपने कोड में आपको ऐसे हैंडलर्स बनाने होंगे जो आंशिक और अंतिम ट्रांसक्रिप्ट पाएं।
आगे बढ़ें: डायरीकरण, टाइमस्टैम्प और कस्टम शब्दावली
इसके अलावा ऑटोमैटिक स्पीच रिकग्निशन, ElevenLabs स्पीच टू टेक्स्ट मॉडल डायरीकरण, टाइमस्टैम्प और कस्टम शब्दावली को सपोर्ट करते हैं।
- डायरीकरण: सिर्फ़ बैच ट्रांसक्रिप्शन स्पीकर डायरीकरण को सपोर्ट करता है। diarize आर्ग्युमेंट सेट करके आप डायरीकरण सक्षम कर सकते हैं। हालांकि, बैच ट्रांसक्रिप्शन का एक मोड, मल्टी-चैनल ट्रांसक्रिप्शन, डायरीकरण को सपोर्ट नहीं करता।
- टाइमस्टैम्प: बैच ट्रांसक्रिप्शन करते समय, आप शब्द या कैरेक्टर-स्तरीय टाइमस्टैम्प में से चुन सकते हैं। इसके लिए convert मेथड का उपयोग करते समय timestamps_granularity पैरामीटर सेट करें।
- कस्टम शब्दावली: दोनों रियल-टाइम और बैच ट्रांसक्रिप्शन कीटर्म प्रॉम्प्टिंग को सपोर्ट करते हैं। यह सुविधा मॉडल को आपकी सूची में शामिल खास कीटर्म्स ट्रांसक्राइब करने के लिए प्राथमिकता देती है। Scribe v2 Realtime अधिकतम 50 कीटर्म्स सपोर्ट करता है, जबकि Scribe v2 1,000 कीटर्म्स सपोर्ट करता है।
AI कोडिंग असिस्टेंट्स में ElevenLabs स्किल का उपयोग
AI कोडिंग असिस्टेंट्स डेवलपमेंट को तेज़ बनाते हैं। अगर आप Claude Code, Cursor, Codex या ऐसे ही AI कोडिंग टूल्स इस्तेमाल कर रहे हैं, तो आप कोडिंग एनवायरनमेंट में ElevenLabs स्किल्स जोड़ सकते हैं।
आपको बस अपने प्लेटफ़ॉर्म के टर्मिनल में यह कमांड चलानी है:
AI कोडिंग एजेंट स्पीच-टू-टेक्स्ट स्किल को ElevenLabs के GitHub रेपो से डाउनलोड करके लोकल स्किल डायरेक्टरी में इंस्टॉल करेगा। इससे आप पूरा API इंटीग्रेशन शुरू से लिखने के बजाय ElevenLabs के आधिकारिक डॉक्यूमेंटेशन के आधार पर स्पीच रिकग्निशन के लिए Python कोड अपने-आप जनरेट कर सकते हैं।
इंस्टॉल होने के बाद, आप बस बातचीत के अंदाज़ में उसका काम बताकर स्पीच रिकग्निशन Python कोड जनरेट कर सकते हैं। विवरण के आधार पर, कोडिंग असिस्टेंट सही मॉडल और पैरामीटर्स के साथ स्पीच-टू-टेक्स्ट स्किल इस्तेमाल करके अपने-आप कोड जनरेट करता है।
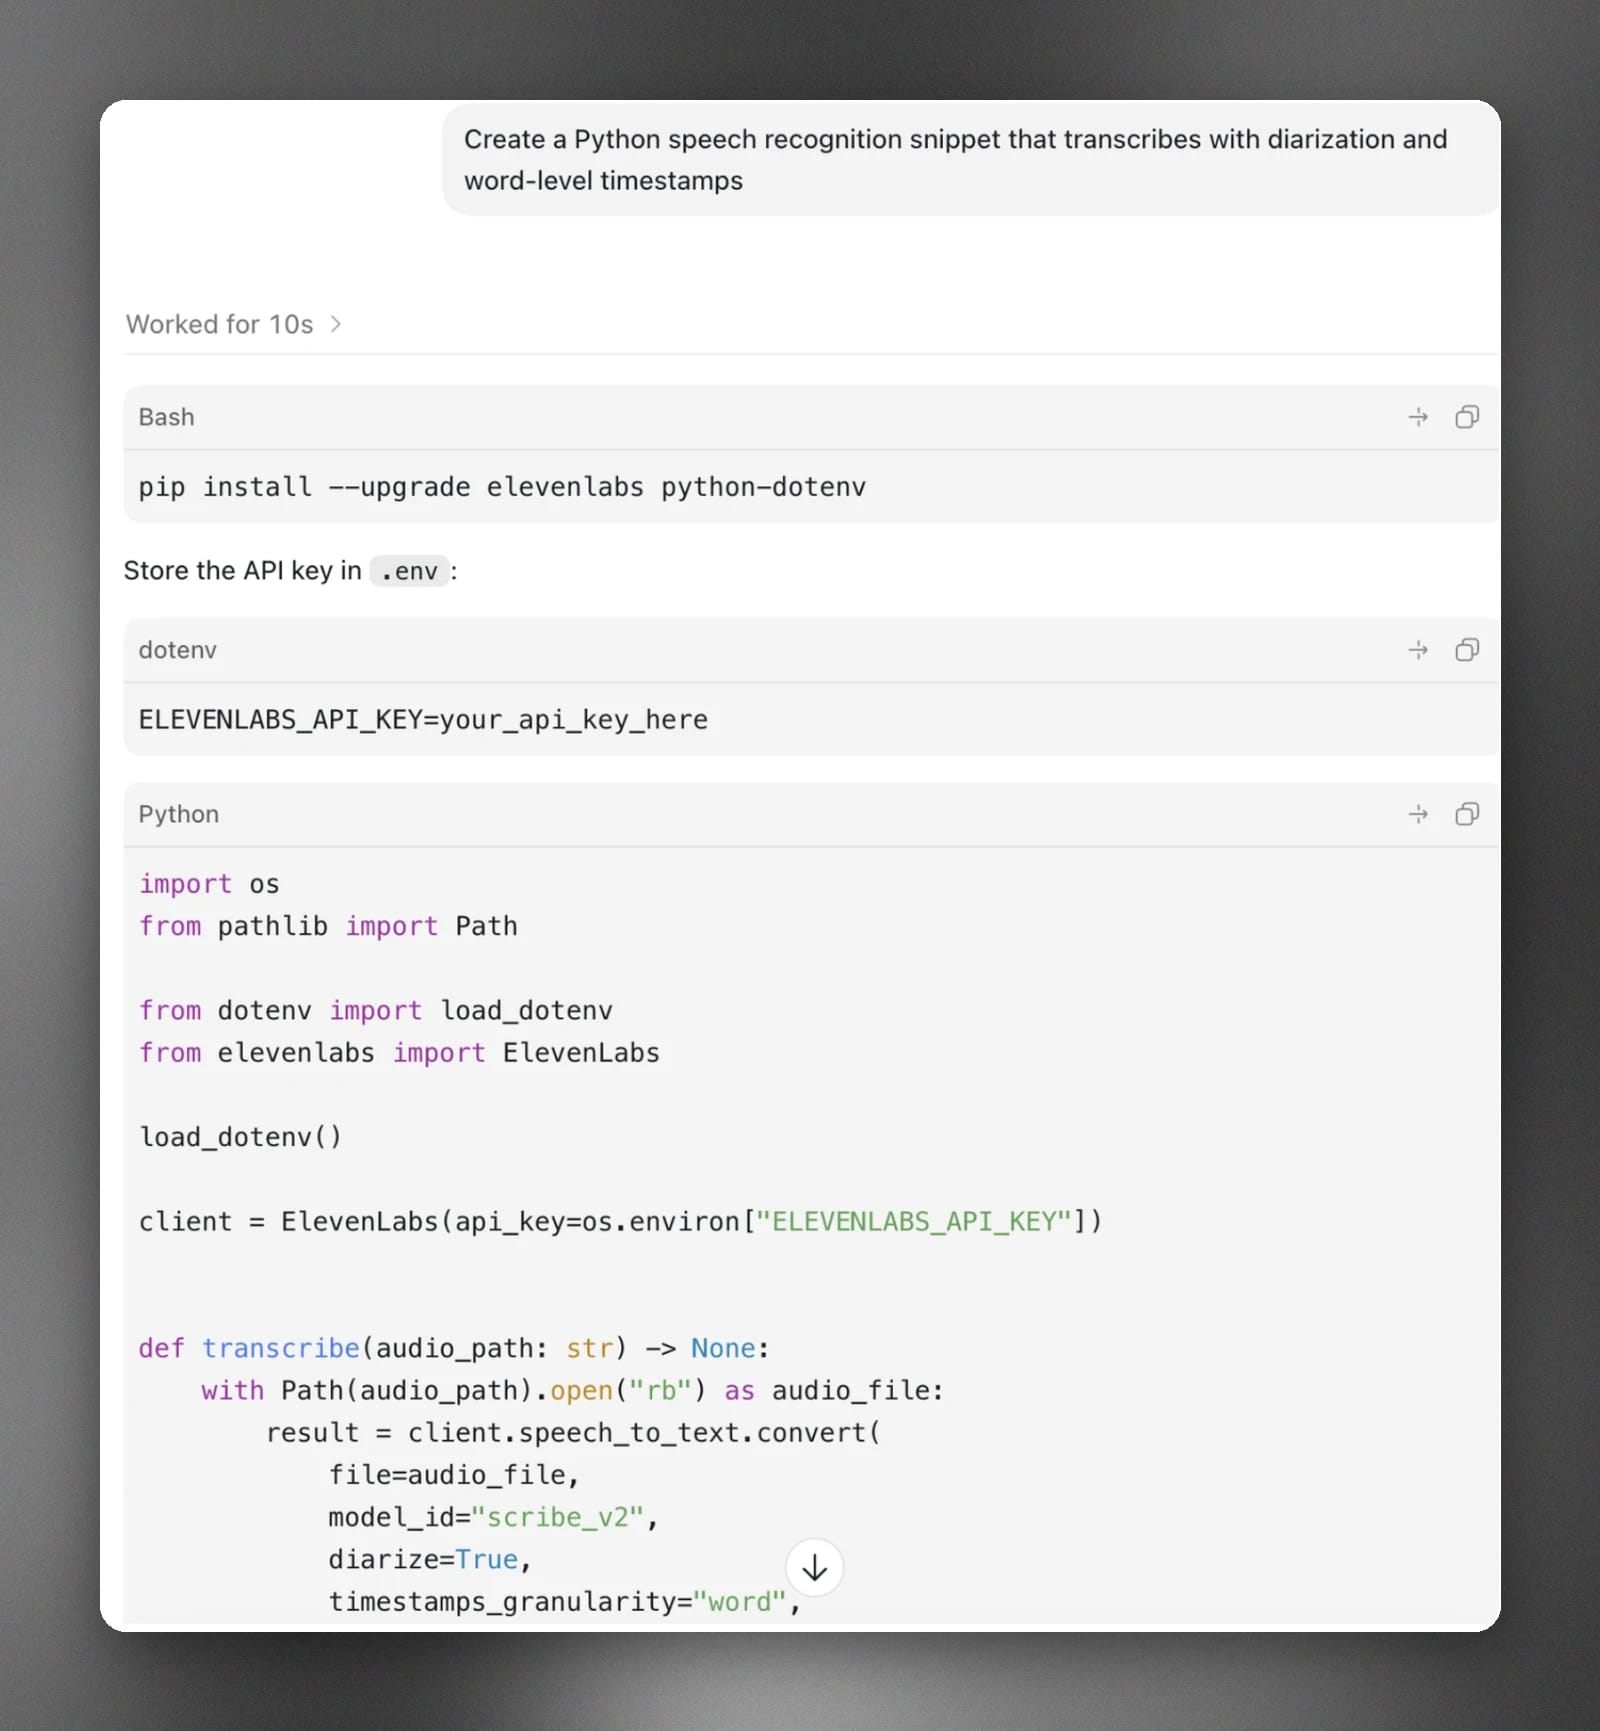
उदाहरण के लिए, अगर आप Codex में “डायरीकरण और शब्द-स्तरीय टाइमस्टैम्प के साथ ट्रांसक्राइब करने वाला Python स्पीच रिकग्निशन स्निपेट बनाएं” टाइप करते हैं, तो आपको नीचे दिए गए जैसा एक स्निपेट मिलेगा।
स्पीच रिकग्निशन के लिए ElevenAPI के साथ शुरुआत करें
ElevenAPI आपको Python में स्पीच रिकग्निशन ऐप्स बनाने के लिए एडवांस्ड स्पीच टू टेक्स्ट मॉडल का एक्सेस देता है।
ElevenAPI का उपयोग करके, आप शुरू से इंटीग्रेशन कोड लिखने से बचते हैं, जिससे प्रोडक्ट इनोवेशन में देरी होती है। इसके बजाय, आप ऐसे SDKs इस्तेमाल करते हैं जो कीटर्म प्रॉम्प्टिंग, डायरीकरण और टाइमस्टैम्प जैसी कमर्शियल-ग्रेड ज़रूरतें पूरी करने वाली स्पीच टू टेक्स्ट सेवाएं देते हैं।
अपनी ElevenLabs API key अभी पाएं और हमारी आधिकारिक डॉक्यूमेंटेशन में जानें कि API कैसे काम करती है।
अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।


