ऑडियो टैग्स क्या हैं? भावनात्मक TTS की पूरी गाइड
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
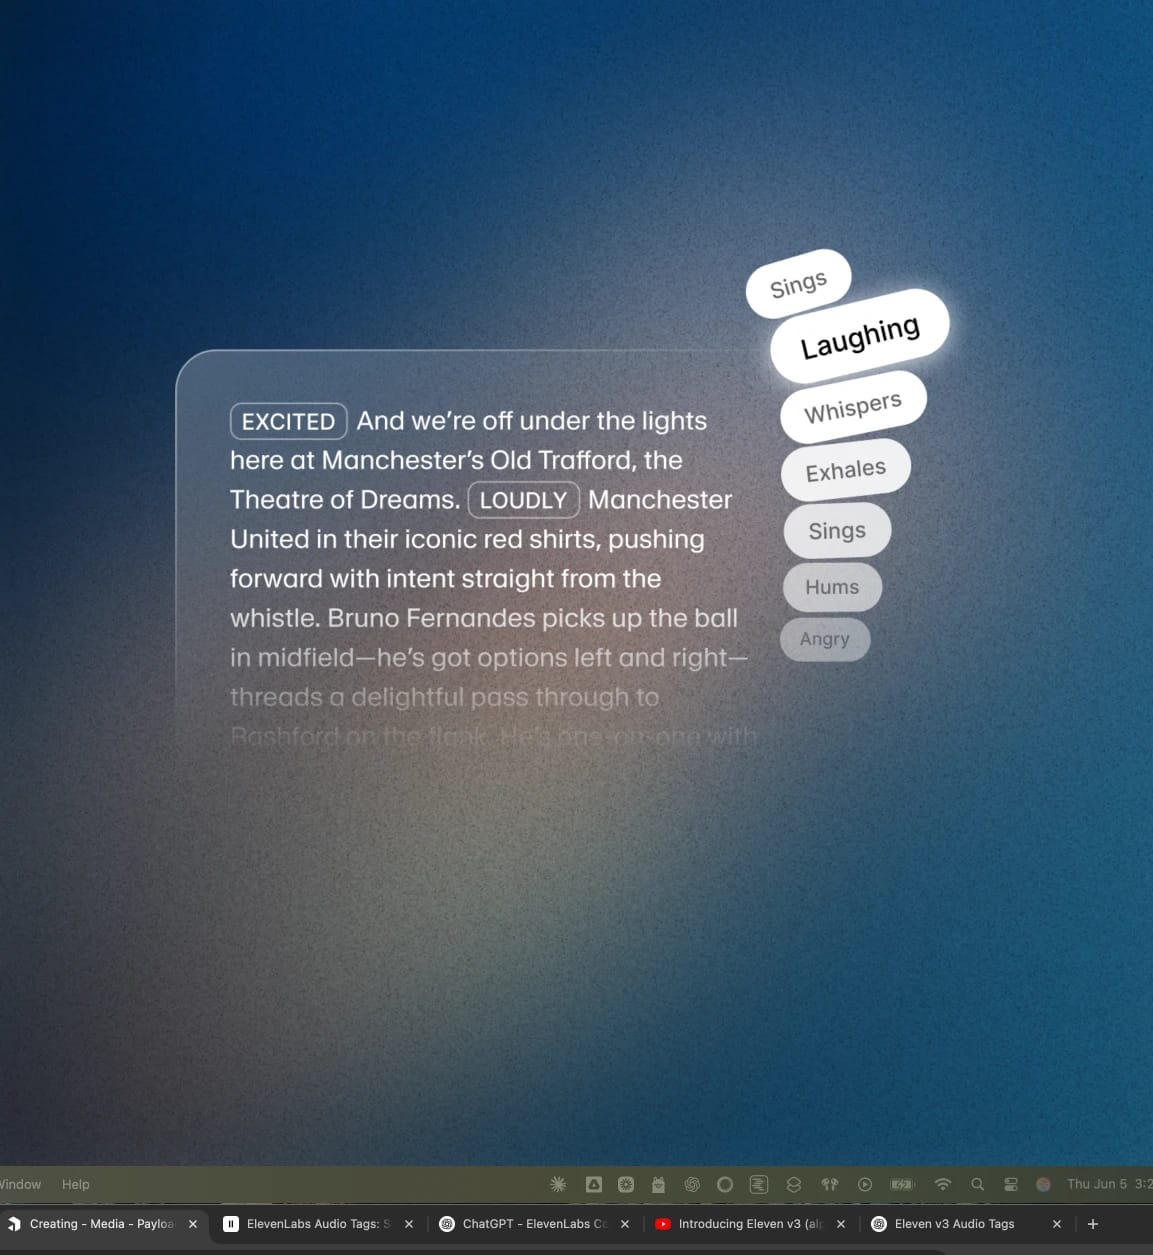
Audio Tags, जैसे [laughs], [gasps], [excited] और [worried], वर्गाकार ब्रैकेट में दिए गए प्राकृतिक भाषा के संकेत हैं। Eleven v3 इन्हें बोलने वाले शब्दों के बजाय परफ़ॉर्मेंस निर्देश के रूप में पढ़ता है। टेक्स्ट टू स्पीच मॉडल के लिए स्क्रिप्ट लिखते समय इन Audio Tags को जोड़कर आप अपनी लिखी बात की भावनात्मक डिलीवरी को बारीकी से नियंत्रित कर सकते हैं।
Eleven v3 मार्च 2026 में सार्वजनिक रूप से उपलब्ध हुआ। v3 से पहले, टेक्स्ट टू स्पीच मॉडल से कोई खास भावनात्मक परफ़ॉर्मेंस पाने के लिए कंटेंट को बार-बार जनरेट करना पड़ता था और बस उम्मीद करनी पड़ती थी कि परिणाम अच्छा आएगा। Audio Tags इस अंदाज़े को खत्म करते हैं और भावनात्मक टेक्स्ट टू स्पीच परफ़ॉर्मेंस पर आपको पूरा नियंत्रण देते हैं।
इस गाइड में जानें कि Audio Tags क्या हैं, कैसे काम करते हैं, टैग की कौन-कौन सी कैटेगरी उपलब्ध हैं और SSML (Speech Synthesis Markup Language) से इनकी तुलना कैसे होती है। हम आम इस्तेमाल के तरीकों को भी कवर करेंगे, जिनमें से हर एक की अपनी अलग गाइड है।
संक्षेप में
- Audio Tags, जैसे [shouts] या [excited], ब्रैकेट में दिए गए संकेत हैं जो Eleven v3 में TTS के भीतर भावना, गति, डिलीवरी और टोन को निर्देशित करते हैं।
- Eleven v3 SSML को सपोर्ट नहीं करता, बल्कि अधिक स्वाभाविक लेखन अनुभव के लिए Audio Tags का इस्तेमाल करता है।
- टैग कई कैटेगरी में आते हैं, जैसे भावनाएं, डिलीवरी और गति, मानवीय प्रतिक्रियाएं, एक्सेंट और साउंड इफेक्ट्स।
- आपके टेक्स्ट में विराम चिह्न और कैपिटलाइज़ेशन से आप AI वॉइस परफ़ॉर्मेंस की गति तय कर सकते हैं।
- आप ElevenLabs पर UI या API के ज़रिए Audio Tags इस्तेमाल कर सकते हैं।
Audio Tags कैसे काम करते हैं?
Audio Tags आपके ट्रांसक्रिप्ट में इनलाइन होते हैं और वर्गाकार ब्रैकेट में लिखे जाते हैं। जब भी आप डिलीवरी बदलना चाहें, जैसे सामान्य से [worried] करना हो, बस एक ऑडियो टैग जोड़ें।
आप एक ही वाक्य में एक से ज़्यादा टैग भी इस्तेमाल कर सकते हैं और अधिक परतदार परफ़ॉर्मेंस के लिए उन्हें जोड़ सकते हैं, जैसे [tired] दिन बहुत लंबा रहा… [upset] मैं और कितने दिन सह सकता हूँ?
Eleven v3 की आर्किटेक्चर मॉडल को पुराने मॉडलों की तुलना में संदर्भ को अधिक गहराई से पढ़ने देती है। इससे वह अलग पैरामीटर या सेटिंग के बिना भावनात्मक संकेतों, टोन में बदलाव, स्पीकर ट्रांज़िशन और संदर्भ संकेतों को समझ पाता है। बस मॉडल को बताएं कि उस पल के लिए क्या चाहिए, और वह लाइन को ठीक आपकी योजना के अनुसार पेश करेगा।
Eleven v3 सिर्फ टैग और स्क्रिप्ट की संरचना से ही सहज लगने वाले मल्टी-स्पीकर संवाद भी संभालता है, जिनमें रुकावटें, मूड में बदलाव और असली बातचीत की स्वाभाविक आगे-पीछे की बातचीत शामिल होती है।
Audio Tags बनाम SSML
अगर आपने दूसरे TTS सिस्टम के साथ काम किया है, तो शायद आपने Speech Synthesis Markup Language के बारे में सुना होगा। Amazon Polly और Microsoft Azure Speech जैसे प्लेटफ़ॉर्म TTS स्क्रिप्ट को अतिरिक्त संदर्भ देने के लिए <break> या <emphasis> जैसे SSML टैग इस्तेमाल करते हैं।
Eleven v3 SSML break टैग या बाकी SSML टैग सेट को सपोर्ट नहीं करता। इसके बजाय, Audio Tags, विराम चिह्न और टेक्स्ट की संरचना ही यह भूमिका निभाते हैं और डिलीवरी पर बारीक नियंत्रण देते हैं।
नीचे दी गई टेबल से आप आम SSML टैग को उनके Eleven v3 विकल्पों से मैप कर सकते हैं।
लेखक के नज़रिए से, किसी लाइन में [whispers] जोड़ना prosody रेट कॉन्फ़िगर करने से कहीं आसान है।
v3 में Audio Tags की कैटेगरी: Audio Tags से परफ़ॉर्मेंस निर्देशित करें
रियल टाइम में डिलीवरी बदलने के लिए आप अपनी स्क्रिप्ट में कहीं भी Audio Tags लगा सकते हैं। आप स्क्रिप्ट में, या एक ही वाक्य में भी, टैग के कॉम्बिनेशन इस्तेमाल कर सकते हैं।
टैग इन मुख्य कैटेगरी में आते हैं।
भावनाएं
ये टैग वॉइस का भावनात्मक टोन सेट करने में मदद करते हैं, चाहे वह उदास, तीव्र या उत्साहपूर्ण हो। उदाहरण के लिए, आप [sad], [angry], [happily] और [sorrowful] में से एक या इनके कॉम्बिनेशन का इस्तेमाल कर सकते हैं।
डिलीवरी और गति
इनका संबंध टोन और परफ़ॉर्मेंस से अधिक है। जिन दृश्यों में संयम या दमदार असर चाहिए, उनमें वॉल्यूम और ऊर्जा बदलने के लिए आप इन टैग का इस्तेमाल कर सकते हैं। उदाहरणों में [whispers], [shouts] और [softly] जैसे टैग शामिल हैं।
मानवीय प्रतिक्रियाएं
सच्ची प्राकृतिक बातचीत में प्रतिक्रियाएं शामिल होती हैं। उदाहरण के लिए, आप बोलने में स्वाभाविक, बिना स्क्रिप्ट वाले पल जोड़कर उसे वास्तविक बना सकते हैं। [laughs], [clears throat] और [sighs] जैसे टैग TTS मॉडल को मानवीय भावनाएं पेश करने में मदद करते हैं।
अलग-अलग ऑडियो टैग कैटेगरी के अन्य उदाहरण:
- एक्सेंट और कैरेक्टर वॉइस: एक्सेंट टैग मॉडल बदले बिना वॉइस को किसी खास क्षेत्र या व्यक्तित्व में बदल देते हैं, जैसे [French accent], [British accent] या [pirate voice]। इनसे एक वॉइस को एक तय परफ़ॉर्मेंस की जगह कई किरदारों वाली लचीली कास्ट में बदलें।
- साउंड इफेक्ट्स: साउंड इफेक्ट टैग जनरेशन में सीधे गैर-वाणी ऑडियो जोड़ते हैं, जैसे [gunshot], [explosion] और [clapping]। ये इमर्सिव ऑडियो, गेम्स और नाटकीय नैरेशन के लिए अच्छे हैं, जहां सीन को सिर्फ वॉइस से ज़्यादा की ज़रूरत होती है। विकल्प के तौर पर ElevenCreative AI साउंड इफेक्ट जनरेटर इस्तेमाल करें।
टैग आपको काफ़ी नियंत्रण देते हैं, लेकिन आप लय और ज़ोर तय करने के लिए विराम चिह्न भी इस्तेमाल कर सकते हैं। उदाहरण के लिए, स्वाभाविक विराम के लिए इलिप्सिस जोड़ें या प्राकृतिक सांस लेने का पैटर्न बनाने के लिए कॉमा लगाएं। ज़ोर देने के लिए किसी शब्द को सभी कैपिटल अक्षरों में लिखें: “मुझे यह अभी चाहिए।”
Audio Tags से आप क्या कर सकते हैं?
Audio Tags आसान तरीके से स्क्रिप्ट की भावनात्मक जटिलता को खोलते हैं। स्वाभाविक रूप से लिखें और लिखते हुए टैग जोड़ें।
Audio Tags के साथ भावनात्मक TTS के कुछ इस्तेमाल के तरीकों पर एक नज़र डालें।
AI ऑडियो में परिस्थितिजन्य समझ
[whisper] या [shouting] जैसे टैग Eleven v3 को उस पल के हिसाब से प्रतिक्रिया देने देते हैं। चेतावनी को नरम बनाने से लेकर सस्पेंस के लिए लंबा विराम रखने तक, आप अपनी स्क्रिप्ट में डायनामिक परिस्थितिजन्य समझ बना सकते हैं।
विस्तृत जानकारी के लिए हमारी AI ऑडियो में परिस्थितिजन्य समझ गाइड देखें।
स्पीच में कैरेक्टर परफ़ॉर्मेंस निर्देशित करना
कई किरदारों वाली स्क्रिप्ट बनाते समय, आप साफ़ दिखाना चाहेंगे कि हर वॉइस कैसे अलग है। [sarcastically] से उनकी पर्सनैलिटी में बदलाव करने से लेकर [British accent] से उनके बोलने का तरीका तय करने तक, हमारे TTS इंजन से आप भावनाओं की पूरी रेंज कैप्चर कर सकते हैं।
इसके बारे में और जानें: AI स्पीच में कैरेक्टर परफ़ॉर्मेंस निर्देशित करना।
स्पीच में भावनात्मक संदर्भ व्यक्त करना
Audio Tags से आप किसी लाइन के आगे बढ़ने के साथ उसकी भावनात्मक डिलीवरी को आकार दे सकते हैं। पूरे भाषण में भावनाएं गढ़ते हुए आप उस पल चरम पर पहुंच सकते हैं, जहां आप अपने किरदार को उसकी पूरी क्षमता पर देखना चाहते हैं। [awe], [booming] और [big laugh] जैसे टैग आपकी AI वॉइस परफ़ॉर्मेंस में भावनाओं की पूरी रेंज बनाने में मदद करते हैं।
इसके इस्तेमाल के बारे में और पढ़ें: AI स्पीच में भावनात्मक संदर्भ।
मल्टी-कैरेक्टर संवाद को जीवंत बनाना
मल्टी-कैरेक्टर संवाद परफ़ॉर्मेंस बनाते समय, समृद्ध किरदारों वाली बातचीत तैयार करने के लिए आप हर लाइन की शुरुआत एक ऑडियो टैग से कर सकते हैं।
इसे उदाहरण के रूप में देखें: टॉम: [coughing] [beginning to speak] माफ़ कीजिए, आज मेरी तबीयत थोड़ी खराब है— एमा: [interrupting] —बीमार? टॉम, तुम्हें पता है मुझे खांसी कितनी नापसंद है! टॉम: [surprised] बस हल्की-सी खांसी है, कुछ गंभीर नहीं। तुम्हें कैसा लगेगा अगर— एमा: [overlapping] [annoyed] —मुझे लगता है तुम्हें घर जाना चाहिए।
जानें कि Eleven v3 पर मल्टी-कैरेक्टर संवाद से और क्या कर सकते हैं।
AI स्पीच के लिए सटीक डिलीवरी नियंत्रण
आप Audio Tags या विराम चिह्नों के ज़रिए Eleven v3 में स्पीच की गति नियंत्रित कर सकते हैं। [pause], [rushed] या [drawn out] जैसे टैग आपको सटीकता के साथ लाइन को आकार देने देते हैं। या फिर, अपने TTS परफ़ॉर्मेंस में स्वाभाविक रूप से भावना जोड़ने के लिए इलिप्सिस, पूर्ण विराम और विस्मयादिबोधक चिह्न लगाएं।
हमने Eleven v3 पर सटीक डिलीवरी नियंत्रण पर एक विस्तृत गाइड लिखी है।
भावनात्मक TTS API पर उपलब्ध है
Audio Tags टेक्स्ट टू स्पीच API के ज़रिए भी ठीक उसी तरह काम करते हैं जैसे ElevenLabs UI में। टैग को स्क्रिप्ट टेक्स्ट के साथ इनलाइन लिखें और API जनरेट किए गए ऑडियो में टैग की गई परफ़ॉर्मेंस लौटाएगा—ऑडियोबुक पाइपलाइन से लेकर विज्ञापन वॉइसओवर तक।
इसके बारे में और जानें: Eleven v3 या सेल्स टीम से संपर्क करें और आज ही शुरू करें।