SSML टैग समझें: टेक्स्ट टू स्पीच में विराम, उच्चारण और गति को कैसे नियंत्रित करें
- लेखक
- Jack Limebear
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
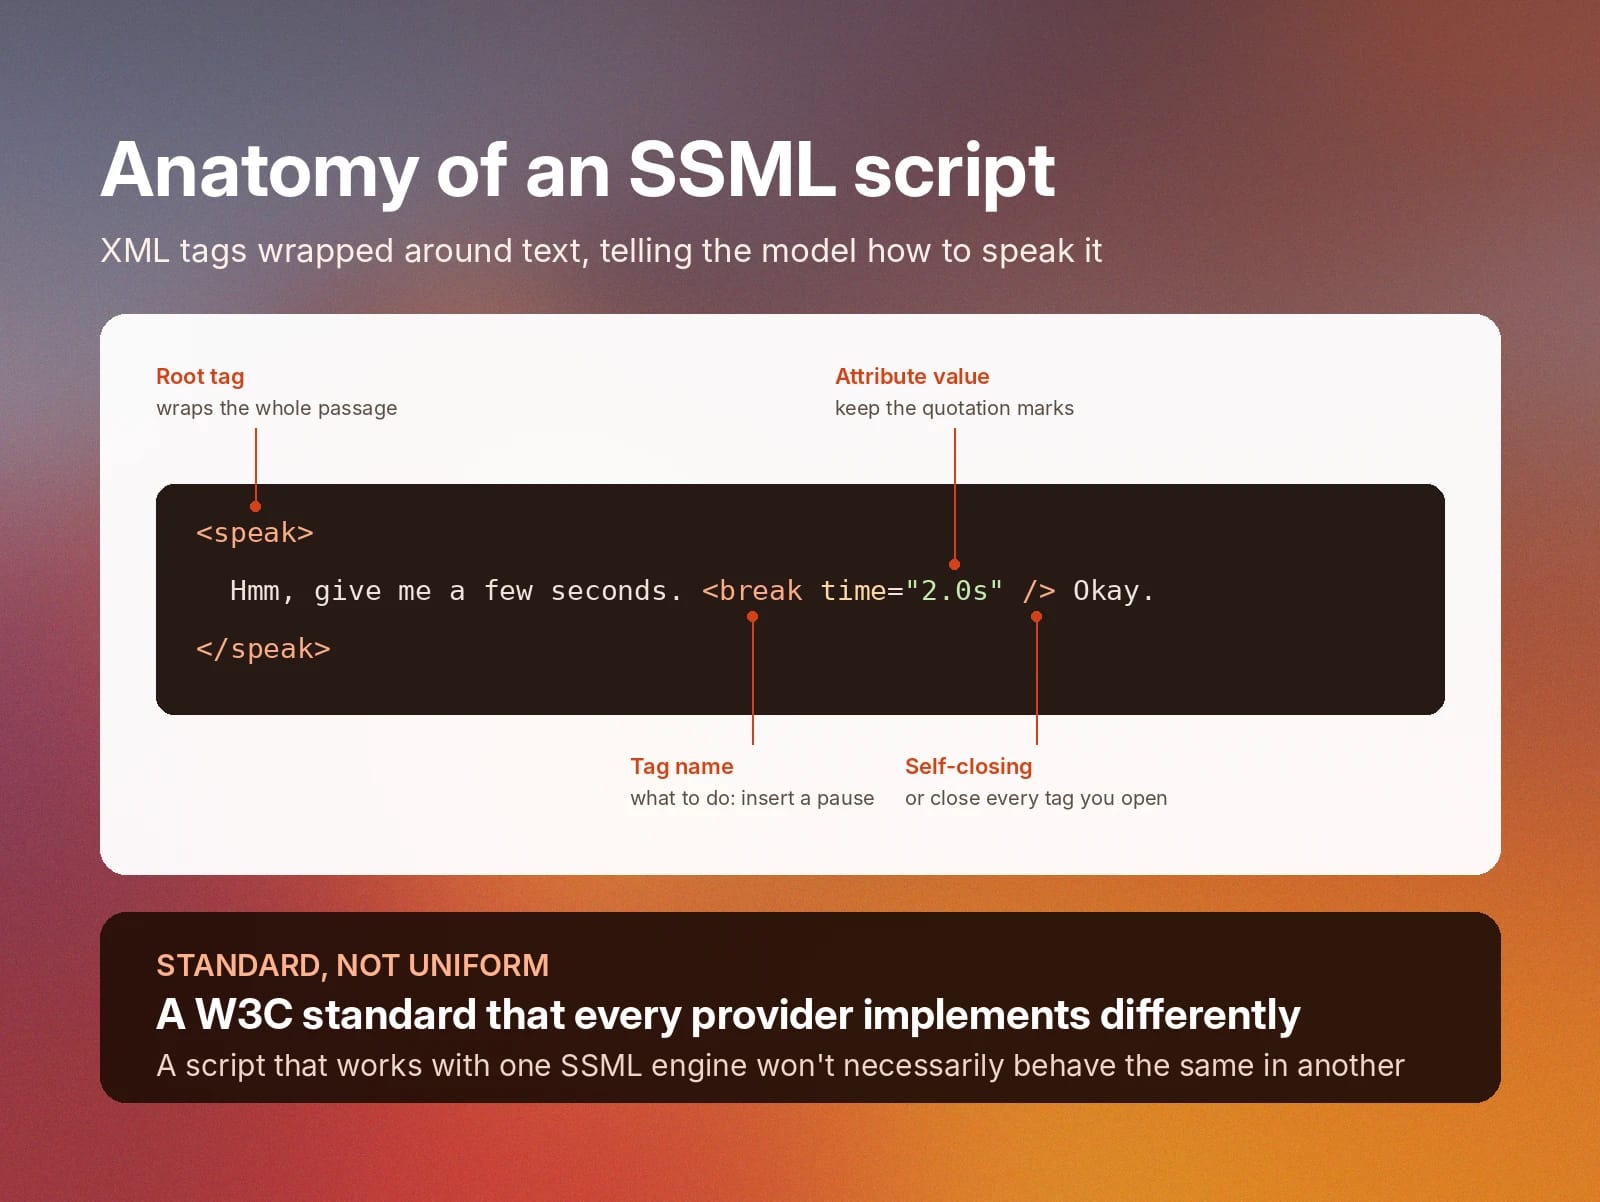
स्पीच सिंथेसिस मार्कअप लैंग्वेज (SSML) एक XML-आधारित मार्कअप भाषा है, जो टेक्स्ट को टैग में लपेटकर टेक्स्ट टू स्पीच मॉडल को बताती है कि उसे कैसे बोलना है—कहाँ रुकना है, किसी शब्द का उच्चारण कैसे करना है और किस वाक्यांश पर ज़ोर देना है।
आप पहले से जो बहुत-सी AI स्पीच सुनते हैं, उसके पीछे नियंत्रण की यही परत होती है। पुष्टि नंबर दोहराने वाला इंटरैक्टिव वॉइस रिस्पॉन्स (IVR) सिस्टम और अध्याय के अंत में रुकने वाला AI ऑडियोबुक नैरेटर, दोनों ही इसके किसी न किसी रूप पर निर्भर हैं। अगर आपने AI-जनरेटेड स्पीच को कस्टमाइज़ किया है, तो आपने शायद SSML देखा होगा।
SSML दो दशकों से ज़्यादा समय से TTS टेक्नोलॉजी का हिस्सा है और कई प्रोवाइडर आज भी TTS देने के लिए इसका इस्तेमाल करते हैं। यह गाइड बताती है कि SSML क्या है और ElevenLabs के मॉडल लाइनअप में इसका ठीक-ठीक कहाँ उपयोग होता है, साथ ही बेहतर ऑडियो टैग सिस्टम के बारे में भी, जिसका उपयोग Eleven v3 और Eleven v4 बेहतरीन प्राकृतिक लगने वाला टेक्स्ट टू स्पीच देने के लिए करते हैं।
ऑडियो टैग के साथ Eleven v4 को काम करते देखें
Eleven v4 देखेंसारांश
- SSML एक W3C-आधारित मार्कअप भाषा है, जिसका इस्तेमाल सिंथेसाइज़्ड स्पीच में आवाज़ के विराम, ज़ोर, उच्चारण और गति को नियंत्रित करने के लिए होता है।
- Eleven v3 और Eleven v4 को छोड़कर, ElevenLabs मॉडल 3 सेकंड तक के विराम के लिए SSML <break> टैग को सपोर्ट करते हैं।
- Eleven Flash v2 और Eleven Turbo v2 कस्टम अंग्रेज़ी उच्चारण के लिए <फोनिम> टैग को सपोर्ट करते हैं।
- Eleven v3 और Eleven v4 SSML को बिल्कुल सपोर्ट नहीं करते। इसके बजाय, वे ऑडियो टैग का उपयोग करते हैं, जो सिंथेसाइज़्ड स्पीच के प्रवाह को नियंत्रित करने के लिए [whispering] और [sighs] जैसे ब्रैकेट में लिखे प्राकृतिक भाषा के निर्देश हैं।
- WebSocket API enable_ssml_parsing पैरामीटर के ज़रिए SSML पार्सिंग को नियंत्रित करता है और अतिरिक्त लेटेंसी से बचने के लिए SSML टैग को पूरे संदेशों के रूप में भेजता है।
- <prosody>, <say-as>, <sub>, <lang>, <voice> और <audio> जैसे टैग ElevenLabs मॉडल सपोर्ट नहीं करते, लेकिन हर एक का विकल्प है: वॉइस सेटिंग्स, टेक्स्ट नॉर्मलाइज़ेशन, उच्चारण डिक्शनरी, मल्टीलिंगुअल मॉडल, अलग वॉइसेज़ और साउंड इफेक्ट्स।
SSML क्या है?
SSML एक मार्कअप भाषा है, जिससे आप लिखे हुए टेक्स्ट में ऐसे निर्देश जोड़ सकते हैं कि सिंथेसिस इंजन उसे कैसे बोले। वर्ल्ड वाइड वेब कंसोर्टियम (W3C) ने इसे सादे टेक्स्ट टू स्पीच मॉडल से आगे बढ़ने के लिए एक मानक के रूप में विकसित किया। SSML सादे टेक्स्ट को समझने वाले मॉडल पर निर्भर रहने के बजाय, किसी अंश के उच्चारण के लिए स्पष्ट, मशीन-रीडेबल निर्देश देता है।
SSML किसी एक प्रोवाइडर तक सीमित कोई खास मार्कअप नहीं है। Amazon Polly और Microsoft Azure Speech दोनों <break> और <emphasis> जैसे SSML टैग को अपने मुख्य नियंत्रण तंत्र के रूप में इस्तेमाल करते हैं। ज़्यादातर क्लाउड टेक्स्ट टू स्पीच प्लेटफ़ॉर्म मानक के किसी न किसी संस्करण को स्वीकार करते हैं। जनरेटिव वॉइस मॉडल आने से बहुत पहले से SSML स्पीच को एनोटेट करने का डिफ़ॉल्ट तरीका रहा है।
SSML एक बुनियादी मानक बना हुआ है, जबकि आधुनिक जनरेटिव वॉइस टेक्नोलॉजी के साथ नए, मॉडल-विशिष्ट नियंत्रण विकसित होते रहते हैं। SSML के पीछे मौजूद यह वेंडर-न्यूट्रल स्पेसिफिकेशन प्रोवाइडरों को सामान्य कोर टैग लागू करने देता है। फिर प्रोवाइडर इन कोर टैग के ऊपर अपने एक्सटेंशन और सीमाएँ जोड़ सकते हैं।
आम SSML टैग और उनका काम
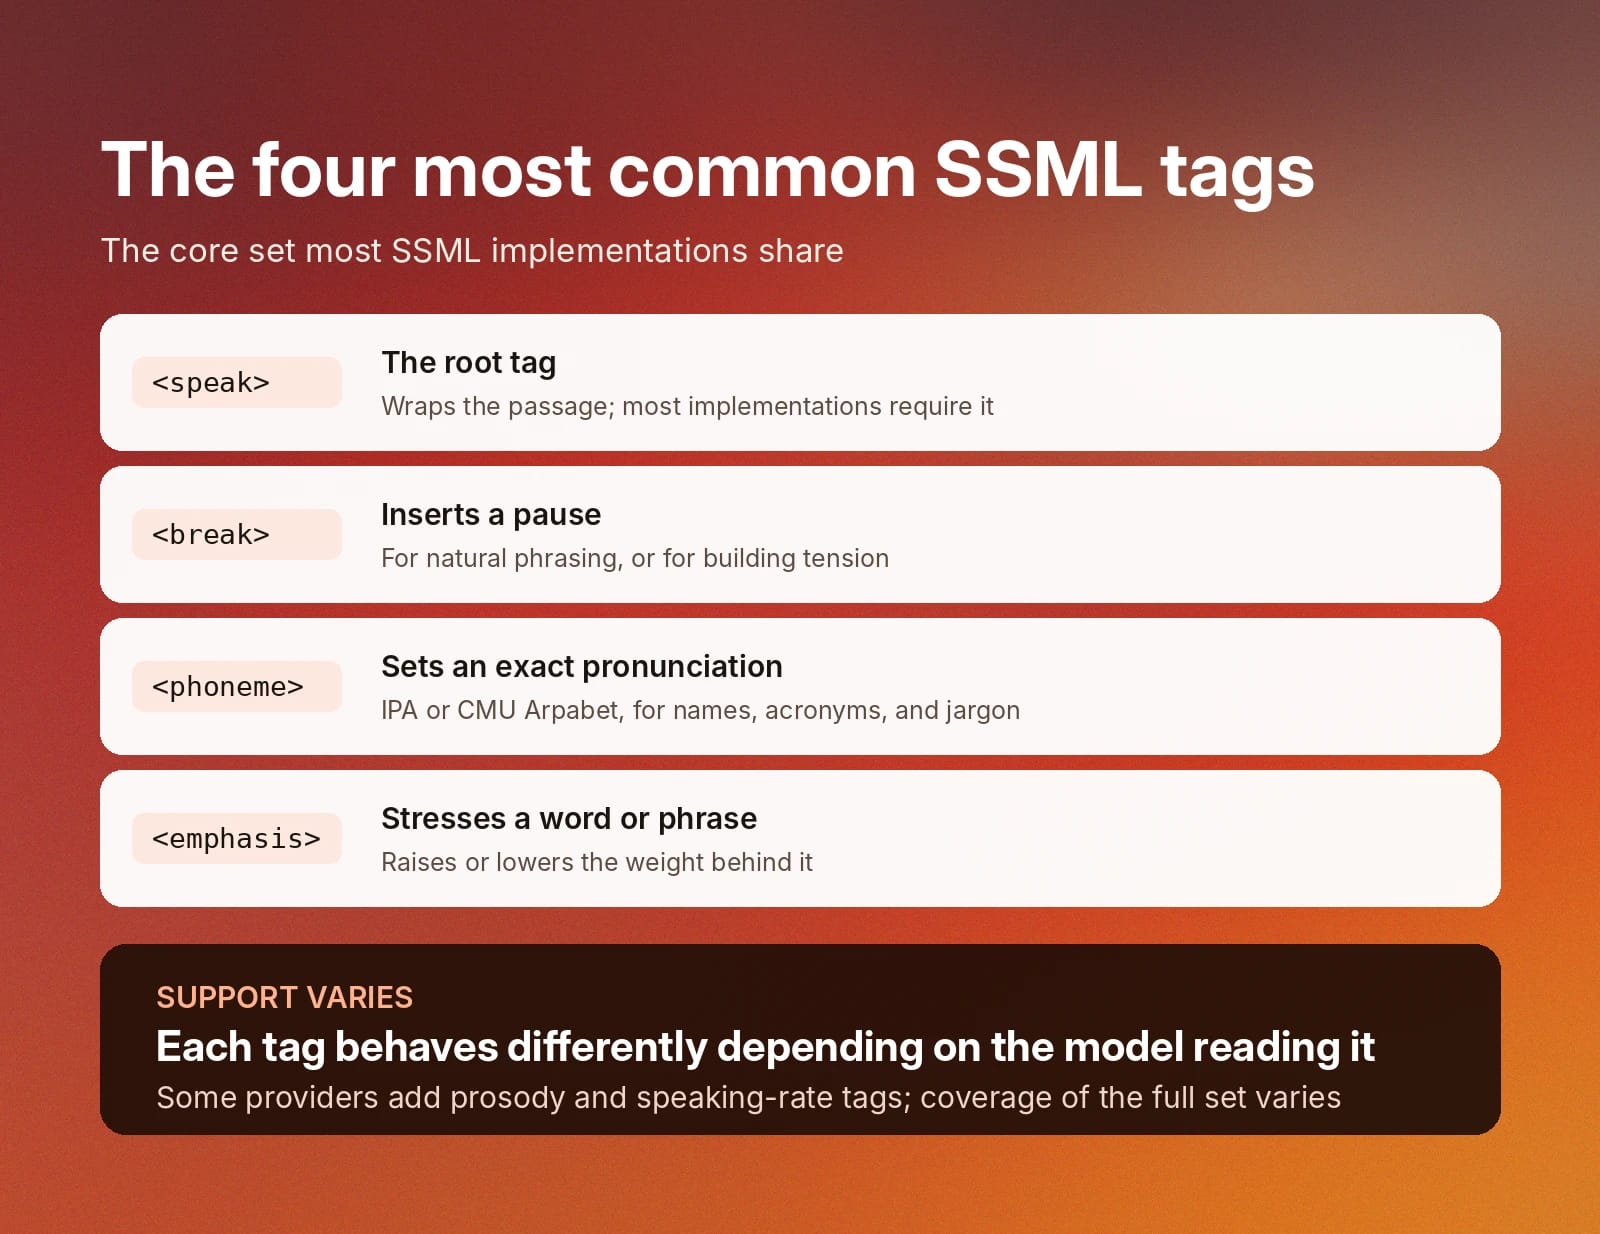
सिंथेसाइज़्ड स्पीच को नियंत्रित करते समय ज़्यादातर लोग जिन टैग को खोजते हैं, SSML इम्प्लीमेंटेशन में उनका एक मुख्य सेट होता है।
ये आम SSML टैग हैं:
- <speak>: यह रूट टैग है, जो पूरे अंश को एक साथ लपेटता है। ज़्यादातर इम्प्लीमेंटेशन को इसके अंदर के कंटेंट को SSML के रूप में पहचानने के लिए इसकी ज़रूरत होती है।
- <break>: तय अवधि का विराम डालता है। यह वाक्यांशों या वाक्यों के बीच प्राकृतिक लय बनाने या लेखन में तनाव पैदा करने में उपयोगी है।
- <phoneme>: IPA या CMU Arpabet जैसी ध्वन्यात्मक वर्णमाला से किसी शब्द का सटीक उच्चारण तय करता है। यह संक्षिप्ताक्षरों, नामों या तकनीकी शब्दों के लिए उपयोगी है।
- <emphasis>: किसी शब्द या वाक्यांश पर ज़ोर देता है, ठीक वैसे जैसे वक्ता स्वाभाविक रूप से उसके अर्थ के भार को बढ़ाता या घटाता है।
ये चारों टैग उन्हें पढ़ने वाले TTS मॉडल के आधार पर अलग तरह से काम करते हैं। कुछ प्रोवाइडर प्रोसोडी या बोलने की गति के लिए अतिरिक्त टैग भी सपोर्ट करते हैं। किसी एक TTS प्रोवाइडर के लिए लिखा गया स्क्रिप्ट दूसरे के साथ वैसा काम नहीं करेगा, भले ही दोनों SSML सपोर्ट का दावा करें, क्योंकि पूरे टैग सेट का कवरेज अलग-अलग होता है।
सबसे ज़्यादा फर्क इस बात में होता है कि कोई टेक्स्ट टू स्पीच मॉडल वास्तव में किन टैग को प्रोसेस करता है। यहीं ElevenLabs का इम्प्लीमेंटेशन खास बनता है।
ElevenLabs के साथ SSML का उपयोग
ElevenLabs में SSML सपोर्ट पूरी तरह एक-जैसा नहीं है। यह इस बात पर निर्भर करता है कि ऑडियो जनरेट करने के लिए आप कौन-सा मॉडल चुनते हैं। <break> सबसे व्यापक रूप से सपोर्ट होने वाला एलिमेंट है, जबकि <phoneme> सीमित मॉडल सेट पर उपलब्ध है।
पुराने ElevenLabs TTS मॉडल, जैसे Multilingual v2, तीन सेकंड तक के विराम के लिए <break> टैग को सपोर्ट करते हैं। उदाहरण के लिए, कोई AI एजेंट कह सकता है, "रुकिए, मुझे सोचने दीजिए," फिर "ठीक है, मुझे पता है कि कैसे मदद करनी है।" जारी रखने से पहले सुनाई देने वाला विराम बनाने के लिए <break time="2.0s" /> इस्तेमाल कर सकता है। यह कई वर्कफ़्लो में सबसे आम टैग है, क्योंकि इससे बातचीत अधिक स्वाभाविक लगती है।
SSML टैग इस्तेमाल करते समय, एक बार में कुछ ही टैग तक सीमित रहना बेहतर है। एक वाक्य या पैराग्राफ में बहुत सारे टैग इस्तेमाल करने से मॉडल की गति अप्रत्याशित रूप से बदल सकती है या कई तरह के ऑडियो आर्टिफ़ैक्ट आ सकते हैं। अलग-अलग वॉइसेज़ विराम को भी अलग ढंग से संभालती हैं, खासकर वे वॉइसेज़ जिन्हें "uh" या "um" जैसे फ़िलर वाक्यांशों वाले सैंपल पर ट्रेन किया गया हो।
ElevenLabs के साथ व्यवहार में SSML
ElevenLabs के Flash v2 और Turbo v2 मॉडल इसे एक कदम आगे ले जाते हैं और कस्टम उच्चारण के लिए <phoneme> टैग भी सपोर्ट करते हैं, लेकिन केवल अंग्रेज़ी में। इससे phoneme टैग नाम, संक्षिप्ताक्षर, तकनीकी शब्द या व्यवसाय से जुड़े अन्य शब्दों के मॉडल द्वारा किए गए उच्चारण को सुधारने में उपयोगी है। यह तभी लागू होता है जब स्क्रिप्ट इन दोनों में से किसी मॉडल पर चले।
इसके उलट, Eleven v3 और Eleven v4 इस पैटर्न से पूरी तरह अलग हैं। वे डिलीवरी नियंत्रण के लिए ऑडियो टैग इस्तेमाल करते हैं। इसके अलावा, Eleven v4 में नेटिव इनलाइन IPA सपोर्ट है, जिससे फ़ॉरवर्ड स्लैश में रखे IPA सिंबल आपके टेक्स्ट में सीधे पढ़े जा सकते हैं। नीचे हम बताएँगे कि break टैग और डिलीवरी नियंत्रण की जगह क्या इस्तेमाल करें।
उच्चारण डिक्शनरी और टेक्स्ट नॉर्मलाइज़ेशन सहित ElevenLabs के टेक्स्ट टू स्पीच नियंत्रणों की पूरी जानकारी के लिए बेस्ट प्रैक्टिस गाइड देखें।
ElevenLabs के साथ SSML कोड उदाहरण
नीचे दिए उदाहरण स्क्रिप्ट और API कॉल में SSML दिखाते हैं। याद रखें कि <break> Eleven v4 और Eleven v3 को छोड़कर हर मॉडल पर काम करता है, और <phoneme> केवल Flash v2 और Turbo v2 पर काम करता है (केवल अंग्रेज़ी)।
विराम के साथ एक बुनियादी SSML स्क्रिप्ट
टेक्स्ट और टैग को <speak> ब्लॉक में रखें और एट्रिब्यूट वैल्यू के चारों ओर उद्धरण चिह्न बनाए रखें:
विराम और ElevenAPI के ज़रिए SSML phoneme टैग के बारे में और जानकारी पाएँ।
<phoneme> से उच्चारण सुधारें
किसी शब्द को ठीक कैसे सुनाई देना चाहिए, यह बताने के लिए IPA या CMU Arpabet इस्तेमाल करें। यहाँ "Siobhan" नाम को IPA से गाइड किया गया है, जबकि "Madison" को CMU Arpabet से दर्शाया गया है:
Python में SSML के साथ स्पीच जनरेट करें
यह कॉल break टैग वाली स्क्रिप्ट उस मॉडल को भेजती है जो इसे सपोर्ट करता है:
JavaScript में SSML के साथ स्पीच जनरेट करें
नीचे SSML के साथ स्पीच जनरेट करने का ऐसा ही उदाहरण है, लेकिन JavaScript में लिखा गया है।
SSML और WebSocket API
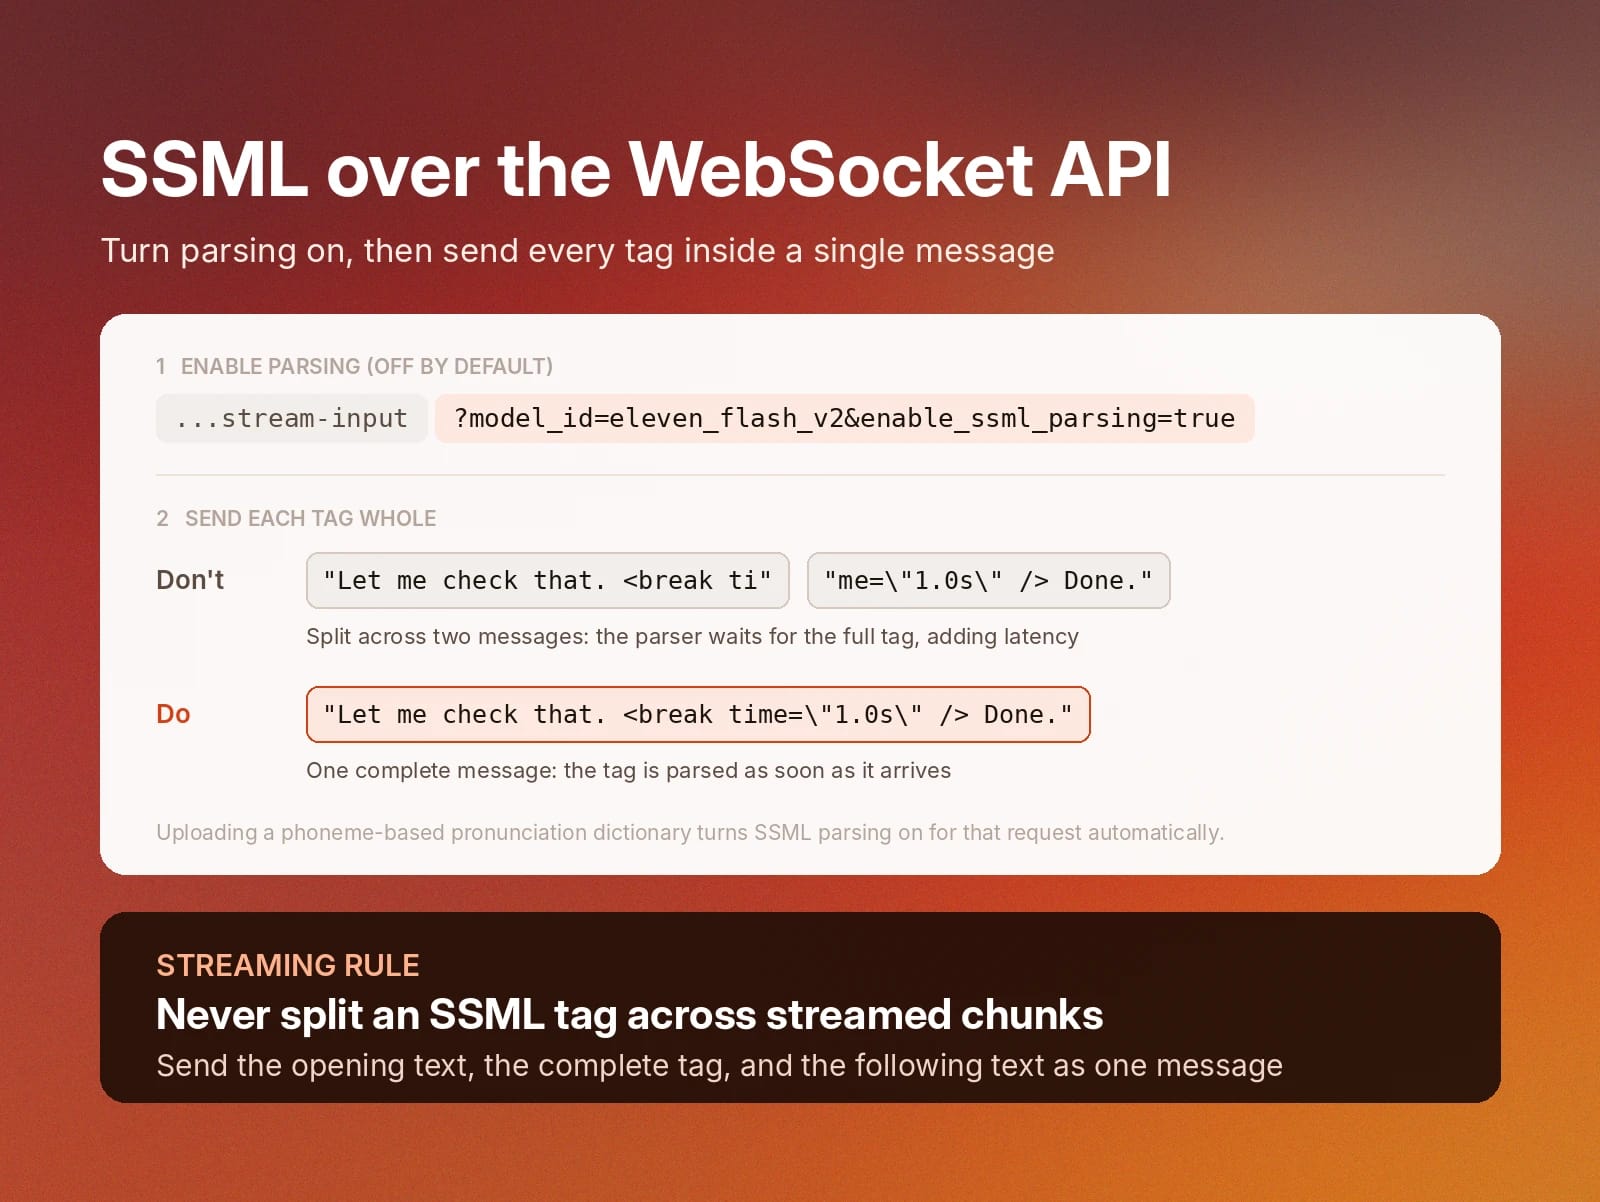
सामान्य HTTP रिक्वेस्ट के बजाय ElevenLabs के WebSocket API से ऑडियो स्ट्रीम करने के लिए SSML पार्सिंग को स्पष्ट रूप से सक्षम करना ज़रूरी है। यह डिफ़ॉल्ट रूप से बंद रहती है और enable_ssml_parsing पैरामीटर से नियंत्रित की जा सकती है।
बेहतरीन नतीजों के लिए हर SSML टैग को एक पूरी तरह से स्वायत्त संदेश के रूप में भेजने की सलाह दी जाती है, बजाय उसे कई स्ट्रीम किए गए चंक्स में बाँटने के। संदेश के बीच में टैग को बाँटने से लेटेंसी बढ़ती है, क्योंकि पार्सर को कार्रवाई से पहले पूरा टैग चाहिए।
फोनिम-आधारित उच्चारण डिक्शनरी अपलोड करने से रिक्वेस्ट के लिए SSML पार्सिंग अपने-आप सक्षम हो जाती है, भले ही enable_ssml_parsing पैरामीटर खास तौर पर सेट न किया गया हो। WebSocket API के लिए उपलब्ध पूरे पैरामीटर विवरण और संदेश फ़ॉर्मैटिंग के लिए रियल-टाइम में ऑडियो जनरेट करने वाली यह डॉक्यूमेंटेशन गाइड देखें।
नीचे का उदाहरण कनेक्शन URL में SSML पार्सिंग चालू करता है और पूरे break टैग को एक ही संदेश में भेजता है:
वे SSML टैग जिन्हें ElevenLabs सपोर्ट नहीं करता और उनके विकल्प
वे SSML टैग जिन्हें ElevenLabs सपोर्ट नहीं करता और उनके विकल्प
अगर आप पुराने ElevenLabs मॉडल के साथ काम कर रहे हैं, तो यह जानना उपयोगी हो सकता है कि कौन-से SSML टैग सपोर्ट होते हैं। उपलब्ध बेहतर विकल्पों के कारण, पुराने ElevenLabs मॉडल अब केवल <break> और <phoneme> प्रोसेस करते हैं; बाकी SSML टैग्स को अन्य तरीकों से संभाला जाता है।
W3C स्पेसिफ़िकेशन के अन्य SSML टैग, जिनके बारे में आप जानते होंगे, मार्कअप के रूप में नहीं पढ़े जाते, इसलिए हर एक के लिए अलग तरीका चाहिए। ElevenLabs में दूसरे SSML टैग्स की जगह यह इस्तेमाल करें:
SSML टैग
यह क्या करता है
इसके बजाय क्या इस्तेमाल करें
<prosody>
पिच, बोलने की गति और आवाज़ का वॉल्यूम सेट करता है
स्पीड और स्टेबिलिटी वॉइस सेटिंग्स। Eleven v3 और Eleven v4 में [slowly] या [rushed] जैसे डिलीवरी ऑडियो टैग्स
<emphasis>
किसी शब्द या वाक्यांश पर ज़ोर देता है
ज़ोर देने के लिए कैपिटलाइज़ेशन या विराम चिह्न। Eleven v3 और Eleven v4 में [shouts] जैसे टैग्स
<say-as>
नंबर, तारीख और संक्षिप्ताक्षर कैसे पढ़े जाएं, यह नियंत्रित करता है
टेक्स्ट नॉर्मलाइज़ेशन, वैल्यू को शब्दों में लिखना या उच्चारण डिक्शनरी नियम
<sub>
लिखे हुए शब्द के बोले जाने वाले रूप को बदलता है
उच्चारण डिक्शनरी का एलियस नियम
<lang>
किसी वाक्यांश की भाषा बदलता है
बहुभाषी मॉडल, जिसमें वाक्यांश लक्ष्य भाषा में लिखा हो
<voice>
स्क्रिप्ट के बीच में स्पीकर बदलता है
हर वॉइस के लिए अलग जनरेशन या Eleven v3 और Eleven v4 में मल्टी-स्पीकर डायलॉग
<audio>
रिकॉर्ड की गई ऑडियो फ़ाइल या ध्वनि जोड़ता है
Eleven v3 और v4 पर साउंड इफेक्ट ऑडियो टैग्स, ElevenLabs का साउंड इफेक्ट्स टूल, या जनरेशन के बाद ऑडियो मिक्स करना
प्रोसोडी: SSML के साथ पिच, बोलने की गति और वॉल्यूम
प्रोसोडी: SSML के साथ पिच, बोलने की गति और वॉल्यूम
स्क्रिप्ट में गति बदलने के लिए टेक्स्ट को अलग-अलग जनरेशन में बांटें या वाक्यों के बीच <break> टैग जोड़ें। Eleven v3 और v4 पर ऊपर दिए गए टेबल के ऑडियो टैग्स, जैसे [slowly], [rushed] और [whispers], सीधे लाइन में लिखें।
स्क्रिप्ट के भीतर गति बदलने के लिए टेक्स्ट को अलग-अलग जनरेशन में बाँटें या वाक्यों के बीच <break> टैग जोड़ें। Eleven v3 और v4 पर, ऊपर तालिका में दिए गए [slowly], [rushed] और [whispers] जैसे ऑडियो टैग को सीधे लाइन में रखें।
उच्चारण: SSML के साथ <phoneme>, <say-as> और <sub>
ये मुख्य तरीके हैं जिनका आप उपयोग कर सकते हैं:
- ऊपर दिए उदाहरण की तरह, Flash v2 या Turbo v2 पर एक बार के सुधार के लिए <phoneme> का उपयोग करें।
- कई स्क्रिप्ट में बार-बार आने वाले शब्दों के लिए उच्चारण डिक्शनरी इस्तेमाल करें। डिक्शनरी में फोनिम नियम और <sub> की तरह काम करने वाले एलियस नियम हो सकते हैं, जैसे "UN" को "United Nations" पर मैप करना।
- <say-as> जिन चीज़ों को संभालता है, जैसे नंबर, तारीख, मुद्रा और फ़ोन नंबर, उनके लिए टेक्स्ट नॉर्मलाइज़ेशन पर भरोसा करें, जो लिखी हुई वैल्यू को बोले गए शब्दों में बदलता है। जब किसी वैल्यू को बिल्कुल एक ही तरीके से पढ़ना हो, जैसे पुष्टि नंबर, तो उसे शब्दों में लिखें या स्क्रिप्ट में अंकों के बीच स्पेस दें।
भाषा और लोकेल
भाषा और लोकेल
Flash v2 और Turbo v2 केवल अंग्रेज़ी के लिए हैं, इसलिए कई भाषाएं मिलाने वाली स्क्रिप्ट को Multilingual v2 जैसे बहुभाषी मॉडल की ज़रूरत होती है, Flash v2.5, Eleven v3 या Eleven v4। Eleven v4 और v3, [French accent] जैसे एक्सेंट टैग और IPA ट्रांसक्रिप्शन को 70+ भाषाओं में भी सपोर्ट करते हैं।
Flash v2 और Turbo v2 केवल अंग्रेज़ी के लिए हैं, इसलिए कई भाषाएँ मिलाने वाली स्क्रिप्ट के लिए Multilingual v2 जैसा मल्टीलिंगुअल मॉडल चाहिए,
ऑडियो और साउंड इफेक्ट्स
भाषण के भीतर ही ध्वनि जोड़ने के लिए बस [applause] या [door slamming] जैसा साउंड इफेक्ट टैग लिखें और देखें कि Eleven v4 और Eleven v3 उसे कैसे जीवंत करते हैं। लंबे या अधिक बारीक साउंड डिज़ाइन के लिए साउंड इफेक्ट जनरेट करें और उसे अपने एडिटर या प्रोडक्शन वर्कफ़्लो में वॉइस ट्रैक के साथ मिक्स करें।
स्पीच में ही ध्वनि जोड़ने के लिए, बस [applause] या [door slamming] जैसा साउंड इफेक्ट टैग लिखें और देखें कि Eleven v4 और Eleven v3 उसे कैसे जीवंत बनाते हैं। अधिक लंबे या बारीक साउंड डिज़ाइन के लिए
ElevenLabs के साथ SSML की बेस्ट प्रैक्टिस
लेकिन ElevenLabs में SSML के साथ काम करते समय शुरुआत के लिए ये कुछ सुझाव हैं:
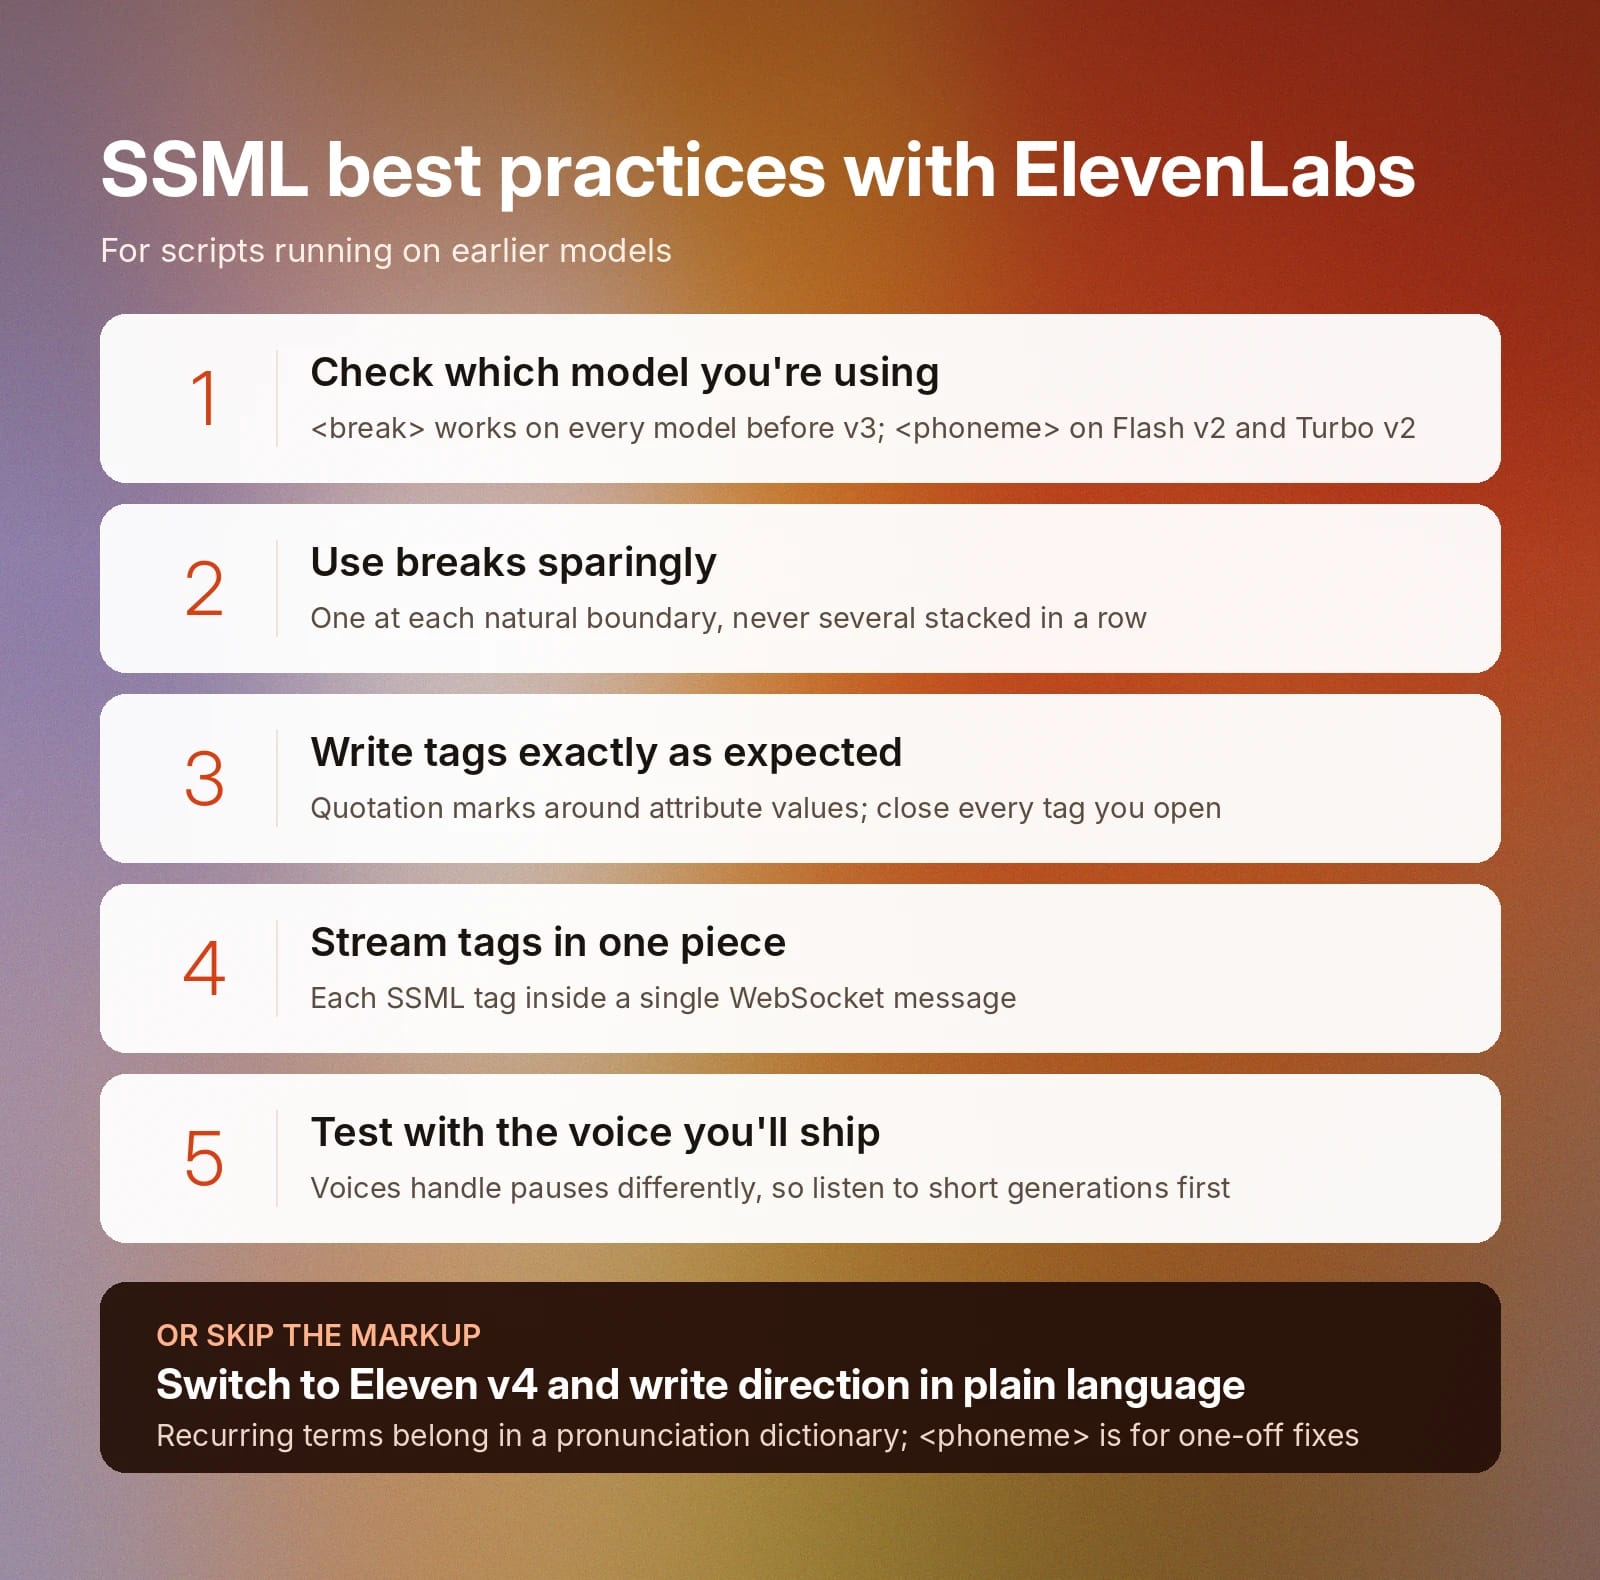
- देखें कि आप कौन-सा मॉडल इस्तेमाल कर रहे हैं: <break> Eleven v3 को छोड़कर हर मॉडल पर काम करता है, <phoneme> केवल Flash v2 और Turbo v2 पर काम करता है, और ऑडियो टैग्स केवल नए मॉडलों, जैसे Eleven v4 और Eleven v3, पर काम करते हैं।
- विराम सीमित रूप से इस्तेमाल करें: एक के बाद एक कई लगाने के बजाय, हर प्राकृतिक सीमा पर एक लगाएं।
- SSML टैग सही तरीके से लिखें: एट्रिब्यूट वैल्यू के चारों ओर उद्धरण चिह्न रखें, उदाहरण के लिए <break time="2.0s" />, और खोले गए हर टैग को बंद करें।
- टैग्स को एक ही भाग में स्ट्रीम करें: हर SSML टैग को एक ही WebSocket मैसेज में भेजें।
- उसी वॉइस के साथ टेस्ट करें जिसे आप रिलीज़ करेंगे: वॉइसेज़ विराम को अलग-अलग ढंग से संभालती हैं, इसलिए पूरी स्क्रिप्ट चलाने से पहले छोटी जनरेशन सुनें। ElevenLabs की हमारी वॉइस लाइब्रेरी में 17,500 से अधिक वॉइसेज़ हैं।
SSML की इन सर्वोत्तम प्रथाओं के अलावा, बार-बार आने वाले शब्दों के लिए उच्चारण डिक्शनरी इस्तेमाल करना अच्छा विचार है। एक बार के सुधार के लिए <phoneme> सबसे अच्छा विकल्प है।
SSML के मुख्य उपयोग क्या हैं?
SSML के मुख्य उपयोग क्या हैं?प्रोसोडी का भाव जोड़ने का उपयोगी टूल है।
यहां कुछ SSML उपयोग के मामले हैं, जहां यह मानक उपयोगी साबित होता है:
- इंटरैक्टिव वॉइस रिस्पॉन्स (IVR) सिस्टम: तब उपयोगी, जब कोई IVR सिस्टम प्रॉम्प्ट और मेनू के बीच रुकना चाहता हो या नंबर साफ़ तौर पर पढ़ना चाहता हो।
- कन्वर्सेशनल एजेंट्स: जवाब से पहले छोटा विराम जोड़ना, ताकि बातचीत स्वाभाविक लगे।
- ऑडियोबुक्स और लंबे-फ़ॉर्म का नैरेशन: अध्याय के अंत और दृश्यों के बीच विराम देकर किसी क्षण के खत्म होने से पहले और बाद का स्पष्ट अंतर दिखाना।
- ई-लर्निंग और प्रशिक्षण: प्रोडक्ट नामों, तकनीकी शब्दों, संक्षिप्ताक्षरों और बिज़नेस-विशिष्ट शब्दों का उच्चारण ठीक करना।
- नोटिफ़िकेशन और अलर्ट: तारीख, समय और रेफ़रेंस कोड कैसे पढ़े जाएं, इसे नियंत्रित करना।
SSML के कई उपयोग हैं, लेकिन ऑडियो टैग्स इस्तेमाल करके आप अपनी स्क्रिप्ट में अक्सर जटिल SSML टैग याद रखने और जोड़ने की जरूरत के बिना ये सभी काम कर सकते हैं। Eleven v4 और Eleven v3 ने ऑडियो टैग सिस्टम बनाया है, ताकि यूज़र्स SSML की परेशानी के बिना अपने AI-जनरेटेड स्पीच आउटपुट पर पूरा नियंत्रण पा सकें।
हालाँकि SSML के कई उपयोग हैं, पर ऑडियो टैग के साथ आप जटिल SSML टैग याद रखे और स्क्रिप्ट में डाले बिना ही ये सभी काम कर सकते हैं। Eleven v4 और Eleven v3 ने ऑडियो टैग सिस्टम बनाया है, ताकि यूज़र्स SSML की झंझट के बिना अपने AI-जनरेटेड स्पीच आउटपुट पर पूरा नियंत्रण पा सकें।
Eleven v4 SSML के बजाय ऑडियो टैग क्यों इस्तेमाल करता है
- भावनाएं या एहसास, जैसे [sad] या [excited]
- डिलीवरी और गति, जैसे [whispers] या [rushed]
- मानवीय प्रतिक्रियाएं, जैसे [sighs] या [laughs]
- एक्सेंट और कैरेक्टर वॉइसेज़, जैसे [French accent]
- साउंड इफेक्ट्स, जैसे [applause] या [door shutting]
इस डिज़ाइन का कारण यह है कि यह मॉडल बातचीत में कॉन्टेक्स्ट को कैसे पढ़ता है। Eleven v4 आर्किटेक्चर पुराने मॉडलों की तुलना में कॉन्टेक्स्ट को अधिक गहराई से पढ़ता है, जिससे वह अलग पैरामीटर या सेटिंग्स के बिना भावनात्मक संकेतों, टोन बदलावों, स्पीकर ट्रांज़िशन और प्रासंगिक संकेतों को समझ सकता है।
SSML टेक्स्ट में एक निश्चित जगह पर खास निर्देश देता है, जिससे डिलीवरी कठोर और अस्वाभाविक लग सकती है। उच्च गुणवत्ता वाले अंतर्निहित मॉडलों के बावजूद, AI टेक्स्ट के रोबोटिक सुनाई देने के मुख्य कारणों में SSML एक है।
[whisper] जैसा संकेत Eleven v4 को व्याख्यात्मक निर्देश देता है, जो आसपास की पूरी लाइन में लागू होता है और उसके आस-पास की हर चीज़ की प्रोसोडी से आकार लेता है।
ज़्यादातर SSML एलिमेंट्स का सीधा v4 विकल्प है:
SSML टैग
यह क्या करता है
Eleven v4 विकल्प
<break time="1s">
विराम जोड़ता है
[pause], एलिप्सिस या लाइन ब्रेक
<prosody rate="slow">
भाषण धीमा करता है
[drawn out] या [slowly]
<prosody rate="fast">
भाषण तेज़ करता है
[rushed]
<emphasis>
किसी खास शब्द पर ज़ोर देता है
[shouts] या शब्द को कैपिटलाइज़ करना
<prosody pitch="high">
पिच ऊंची करता है
[excited] जैसे भावनात्मक टैग्स
<prosody pitch="low">
पिच नीची करता है
[sorrowful] जैसे भावनात्मक टैग्स
उच्चारण भी इसी विकल्प पैटर्न का पालन करता है। Eleven v4 में 90+ भाषाओं के ट्रांसक्रिप्शन के साथ IPA नेटिव सपोर्ट के रूप में शामिल है। इससे टीमें सीधे टेक्स्ट में फॉरवर्ड स्लैश के भीतर ट्रांसक्रिप्शन जोड़कर, XML टैग्स के बिना उच्चारण नियंत्रित कर सकती हैं।
उच्चारण के लिए भी यही विकल्प पैटर्न है। Eleven v4 में 90+ भाषाओं के ट्रांसक्रिप्शन के साथ नेटिव IPA सपोर्ट शामिल है। इससे टीमें टेक्स्ट में सीधे फ़ॉरवर्ड स्लैश के भीतर ट्रांसक्रिप्शन जोड़कर, XML टैग के बिना उच्चारण नियंत्रित कर सकती हैं।
ElevenCreative पर प्राकृतिक लगने वाली स्पीच शुरू करें
देखें कि ऑडियो टैग्स Eleven v4 के साथ तैयार ऑडियो में कैसे बदलते हैं या मुफ़्त अकाउंट बनाएं और आज अपनी स्क्रिप्ट पर SSML और ऑडियो टैग्स आज़माएं।
अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।