
वॉइस एजेंट मूल्यांकन फ्रेमवर्क: 6 मुख्य स्तंभों की पूरी जानकारी
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
वॉइस एजेंट्स को लगभग एक साथ चलने वाले कई टूल्स का तालमेल बिठाना होता है। इसमें रीयल-टाइम स्पीच टू टेक्स्ट (STT) से ग्राहक की बात रिकॉर्ड करना, लार्ज लैंग्वेज मॉडल (LLM) से संदर्भ समझकर जवाब तैयार करना, और फिर टेक्स्ट टू स्पीच (TTS) सॉफ़्टवेयर से ऑडियो फ़ाइल बनाना शामिल है।
इतने सारे हिस्सों के साथ, आप वॉइस एजेंट की परफ़ॉर्मेंस का सटीक मूल्यांकन कैसे करेंगे?
इस लेख में, हम वॉइस एजेंट मूल्यांकन के लिए छह स्तंभों वाला एक फ्रेमवर्क पेश करेंगे, जो बताएगा कि एजेंट की सफलता आंकते समय क्या मापना चाहिए। हम यह भी जानेंगे कि अलग-अलग उद्योग इन स्तंभों को अलग महत्व क्यों देते हैं और मूल्यांकन में किन आम गलतियों से बचना चाहिए।
सारांश
- वॉइस एजेंट मूल्यांकन के छह मुख्य स्तंभ हैं: TTS वॉइस क्वालिटी, बातचीत की गुणवत्ता, टूल उपयोग और टास्क पूरा करना, इंटेलिजेंस, अनुपालन और सुरक्षा, और विश्वसनीयता।
- प्रोडक्शन के लिए सबसे अहम लक्ष्य हैं: 4.3 का MOS, 85% से अधिक का TSR और 500ms से कम का टाइम-टू-फर्स्ट-ऑडियो।
- अलग-अलग उद्योग हर स्तंभ को अलग महत्व देंगे और कुछ डिप्लॉयमेंट किसी एक स्तंभ को दूसरों से अधिक प्राथमिकता देंगे।
- टेस्टिंग की आम गलतियों में सिर्फ साफ़ ऑडियो का मूल्यांकन करना और P99 लेटेंसी स्पाइक्स को नज़रअंदाज़ करना शामिल है।
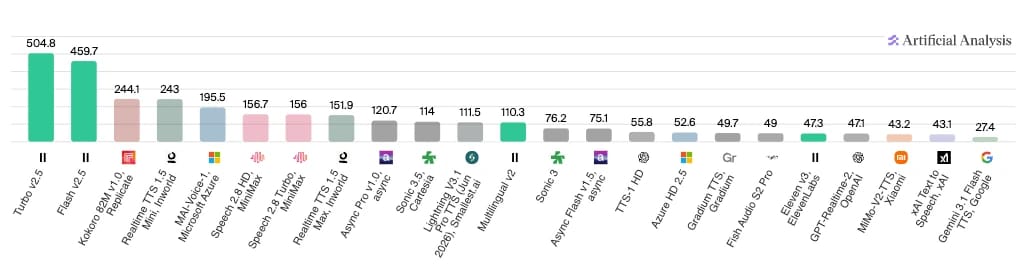
- ElevenLabs सबसे अहम मेट्रिक्स में आगे है: Scribe v2 की WER 2.2% के साथ क्षेत्र में सबसे कम है (Artificial Analysis, जून 2026), Flash v2.5 और Turbo v2.5 स्पीड के लिए शीर्ष मॉडल हैं (Artificial Analysis, जून 2026), और ElevenAgents लगभग 75ms की मॉडल इन्फ़रेंस लेटेंसी देते हैं।
वॉइस एजेंट मूल्यांकन फ्रेमवर्क क्या है?
AI वॉइस एजेंट मूल्यांकन फ्रेमवर्क एक व्यवस्थित प्रणाली है, जिससे आप कई आयामों में परफ़ॉर्मेंस की जांच कर सकते हैं। एक व्यापक फ्रेमवर्क में ऑडियो फिडेलिटी और बातचीत के प्रवाह से लेकर नियामकीय अनुपालन तक का आकलन करने के लिए मेट्रिक्स शामिल होते हैं।
टेक्स्ट चैटबॉट के विपरीत, वॉइस एजेंट हर इंटरैक्शन को कम से कम तीन तकनीकी लेयर्स से गुजारता है: ऑटोमैटिक स्पीच रिकग्निशन (ASR), जो यूज़र के शब्दों को टेक्स्ट में बदलता है; जवाब तैयार करने वाला LLM; और उस जवाब को फिर से ऑडियो में बदलने वाला TTS सिस्टम। इनमें से कोई भी सिस्टम फेल होने पर पूरा अनुभव खराब हो जाता है।
यही जटिलता बताती है कि व्यवसायों को प्रोवाइडर चुनने और डिप्लॉय करने से पहले वॉइस एजेंट्स का मूल्यांकन क्यों करना चाहिए। अतिरिक्त लेटेंसी या गलत जवाबों के वास्तविक परिणाम हो सकते हैं, जैसे ग्राहकों का चले जाना या सबसे खराब स्थिति में नियामकीय जुर्माने और प्रतिष्ठा को नुकसान।
वॉइस एजेंट्स के मूल्यांकन का फ्रेमवर्क बेंचमार्किंग और मापने योग्य डेटा से तय करता है कि एजेंट किसी खास उपयोग के लिए उपयुक्त है या नहीं। व्यवसाय के नज़रिए से, अलग-अलग वॉइस मॉडल्स का मूल्यांकन करने से आप अपने ग्राहकों के लिए सबसे अच्छा मॉडल चुन सकते हैं।
वॉइस एजेंट मूल्यांकन के छह स्तंभ जिनका आपको आकलन करना चाहिए
हालांकि AI एजेंट बनाना और डिप्लॉय करना पहले से कहीं आसान है, लेकिन अंदर चलने वाली प्रक्रियाएं काफ़ी जटिल हैं। यूज़र को सुनने, उसकी ज़रूरत समझने, वह जानकारी LLM को देने और फिर ऑडियो जवाब बनाने के लिए कई कॉम्पोनेंट्स साथ काम करते हैं, जिससे बहुत से काम लगभग एक साथ होते हैं।
सबसे अच्छे वॉइस एजेंट के साथ काम करने के लिए व्यवसायों को तुलना के लिए एक कठोर फ्रेमवर्क चाहिए।
अगर आप टेस्टिंग के नतीजे देखना चाहते हैं, तो Artificial Analysis अलग-अलग कॉम्पोनेंट्स के आधार पर कई एजेंट तुलनाएं देता है। नीचे आप मॉडल-टू-मॉडल स्पीड तुलना के नतीजे देख सकते हैं, जिसमें ElevenLabs Turbo v2.5 और Flash v2.5 प्रति सेकंड प्रोसेस किए गए कैरेक्टर्स में बड़े अंतर से आगे हैं।
जो डेवलपर्स या व्यवसाय अपने खुद के प्रयोग करना चाहते हैं, उनके लिए AI एजेंट असेसमेंट फ्रेमवर्क के ये छह स्तंभ उपयोगी हैं:
- TTS वॉइस क्वालिटी: सिंथेसाइज़्ड स्पीच अंतिम यूज़र्स को कितनी स्वाभाविक, स्पष्ट और अभिव्यक्तिपूर्ण लगती है। क्षेत्र के शीर्ष मॉडल, जैसे Eleven v4, 70 से अधिक भाषाओं में मानवीय और भावनात्मक डिलीवरी देते हैं।
- बातचीत की गुणवत्ता: क्या मॉडल मानवीय बोली समझता है, उसका अर्थ निकालता है और कई टर्न्स में संदर्भ के अनुसार तुरंत जवाब देता है?
- टूल उपयोग: AI एजेंट उपलब्ध संसाधनों का उपयोग करके, मानवीय हस्तक्षेप के बिना, कितनी हद तक टास्क पूरे करता है।
- इंटेलिजेंस: मॉडल कितनी अच्छी तरह तर्क करता है, नए इनपुट्स संभालता है और गलत या हैलुसिनेटेड जवाब देने से बचता है।
- अनुपालन और सुरक्षा: सभी क्षमताओं के साथ, AI वॉइस एजेंट्स को सक्रिय गार्डरेल्स सहित सभी नियामकीय और अनुपालन आवश्यकताओं का पालन करना चाहिए।
- विश्वसनीयता: कुल अपटाइम और लोड के दौरान लगातार परफ़ॉर्मेंस जैसे कॉम्पोनेंट्स से तय होता है कि कन्वर्सेशनल AI एजेंट मांग के साथ स्केल कर सकता है या नहीं।
हालांकि ये सभी स्तंभ स्वतंत्र हैं, लेकिन यूज़र को उच्च-गुणवत्ता का अंतिम अनुभव देने के लिए ये आपस में जुड़े हैं। उदाहरण के लिए, अगर मॉडल की वॉइस क्वालिटी बेहतर हो जाए लेकिन लेटेंसी अधिक रहे, तो स्पीच आने से पहले ग्राहक को अटपटा इंतज़ार करना पड़ेगा।
आइए, वॉइस AI मूल्यांकन के इन सभी स्तंभों को विस्तार से समझते हैं।
TTS वॉइस क्वालिटी
हम वॉइस क्वालिटी से शुरू कर रहे हैं, क्योंकि AI कन्वर्सेशनल एजेंट के साथ बातचीत में इंसान संभवतः सबसे पहले इसी पर ध्यान देता है। अगर आवाज़ रोबोटिक या अजीब लगे, तो एजेंट के साथ उसका अनुभव काफी खराब होगा।
International Telecommunication Union Telecommunication Standard Sector (ITU-T) द्वारा तय किए गए शुरुआती असेसमेंट मेट्रिक्स में से एक Mean Opinion Score (MOS) है। MOS का पैमाना 1-5 होता है, जिसमें 1 अनुपयोगी और 5 उत्कृष्ट है। यह एक सब्जेक्टिव माप है, जिसमें इंसानी श्रोता शामिल होते हैं और कॉल के बाद उनसे फ़ीडबैक लिया जाता है।
इस पैमाने पर MOS 3.5 से कम होना, खासकर आज के मानकों के हिसाब से, काफी कमजोर है और इससे ग्राहक संतुष्टि प्रभावित हो सकती है।
MOS भले ही मानव-केंद्रित मेट्रिक है, लेकिन इसमें कई तकनीकी आवश्यकताएं योगदान देती हैं:
- पिच की स्थिरता और जिटर: पिच और जिटर दो भाषाई तत्व हैं, जिन्हें सुनते समय इंसान स्वाभाविक रूप से पहचानते हैं। “पिच” का अर्थ बोलते समय बदलते उतार-चढ़ाव से है, जैसे सवाल पूछते समय आवाज़ का स्वाभाविक रूप से ऊंचा होना। जिटर तब होता है जब वॉइस मॉडल की पिच की समझ बदलती रहती है, जिससे वह पूरे वाक्य में सुसंगत प्रोसोडी बनाए नहीं रख पाता। जिटर के लिए इंडस्ट्री बेसलाइन 30ms है।
- भावनात्मक अभिव्यक्ति: आवाज़ स्पष्ट और सटीक हो, फिर भी अगर उसका टोन वाक्य के अपेक्षित भाव से मेल नहीं खाता, तो वह गलत लगती है। सटीक टोनल संकेतों के बिना, इंसानी श्रोताओं का AI कन्वर्सेशनल एजेंट्स से जुड़ाव कम होगा और वे उन्हें कम रेटिंग देंगे। ElevenAgents लगभग इंसानों जैसी अभिव्यक्ति देता है, ताकि हर जवाब के पीछे भावनात्मक इरादा स्पष्ट रहे।
- बैकग्राउंड नॉइज़: वॉइस एजेंट्स में बैकग्राउंड नॉइज़ के दो अलग आयाम होते हैं जिनका मूल्यांकन किया जाना चाहिए। आउटपुट में, एजेंट की आवाज़ को अधिक स्वाभाविक बनाने के लिए जवाबों में हल्का परिवेशी शोर जोड़ा जाता है। इनपुट में, STT लेयर पर बैकग्राउंड नॉइज़ फ़िल्टरिंग एक वैकल्पिक टॉगल है, जो सटीकता बेहतर करता है। एजेंट का मूल्यांकन करते समय दोनों जांचें: देखें कि परिवेशी शोर स्वाभाविक लगता है या नहीं, और नॉइज़ फ़िल्टर चालू व बंद करके STT की सटीकता आंकें।
MOS की गणना करते समय आपका लक्ष्य 4.3-4.5 होना चाहिए, जो इन सभी श्रवण श्रेणियों में उच्च स्कोर दिखाता है। इंसानी पैनल की ज़रूरत के बिना बड़े स्तर पर MOS का अनुमान लगाने के लिए आप UTMOS और NISQA जैसे टूल्स का उपयोग कर सकते हैं।
बातचीत की गुणवत्ता
बातचीत की गुणवत्ता, वॉइस क्वालिटी और टास्क पूरा होने के बीच का एक संयुक्त स्तंभ है। इसका उद्देश्य मापना है कि वॉइस एजेंट यूज़र की ज़रूरतों को कितने प्रभावी ढंग से समझता है, संदर्भ के अनुसार उन्हें बीच में रोकता है और कई टर्न्स वाली बातचीत को पूरा होने तक ले जाता है।
यहां मुख्य मेट्रिक इंटेंट क्लासिफिकेशन एक्यूरेसी है, जिसका सामान्य स्कोर 85% से 92% के बीच होता है और शीर्ष परफ़ॉर्मर 96% से ऊपर पहुंचते हैं। 85% भले ही अधिक लगे, लेकिन इसका मतलब अब भी है कि आने वाले कुल ट्रैफ़िक का 15% गलत वर्गीकृत होकर गलत संसाधनों तक पहुंच रहा है।
उच्च इंटेंट क्लासिफिकेशन एक्यूरेसी में योगदान देने वाले तकनीकी तत्व हैं:
- टर्न-टेकिंग: टर्न-टेकिंग तय करता है कि वॉइस एजेंट बातचीत के स्वाभाविक प्रवाह को कितनी अच्छी तरह संभालता है। इसमें यह आंका जाता है कि एजेंट कब सुने, जवाब दे या अधिक इनपुट का इंतज़ार करे। इसमें बार्ज-इन्स संभालना भी शामिल है, जहां मॉडल चल रहे जवाब को हटाकर नए इनपुट के आधार पर नया जवाब बनाता है। ElevenLabs मल्टी-कॉन्टेक्स्ट वेबसॉकेट का उपयोग करके इन सहज रुकावटों को आसानी से संभालता है।
- लेटेंसी: लेटेंसी उस एंड-टू-एंड देरी को बताती है जो यूज़र के वाक्य पूरा करने और एजेंट द्वारा ऑडियो जवाब शुरू करने के बीच होती है। प्रोडक्शन-ग्रेड वॉइस एजेंट्स का टाइम-टू-फर्स्ट-ऑडियो 500ms से कम होना चाहिए; 300ms से कम और बेहतर है। ElevenLabs Flash मॉडल्स लगभग 75ms का इंडस्ट्री-लीडिंग मॉडल इन्फ़रेंस समय देते हैं, जिससे आप इस श्रेणी में बेहतर प्रदर्शन कर सकते हैं।
- फ़ॉलबैक रेट: फ़ॉलबैक रेट यह मापता है कि AI एजेंट यूज़र को कितनी बार समझने में विफल रहता है और स्पष्टीकरण या दोहराने के लिए कहता है। यह मुख्य रूप से STT की सटीकता का परिणाम है, क्योंकि स्पीच रिकग्निशन लेयर ग्राहक की बात गलत सुनती या प्रस्तुत करती है, तो LLM को खराब इनपुट मिलता है। फ़ॉलबैक रेट की गणना का फ़ॉर्मूला है: फ़ॉलबैक रेट (%) = (फ़ॉलबैक्स की संख्या / इंटरैक्शंस की कुल संख्या) * 100।
Artificial Analysis के स्पीच टू टेक्स्ट मॉडल मूल्यांकन में ElevenLabs Scribe V2 की WER 2.2% के साथ सबसे कम है
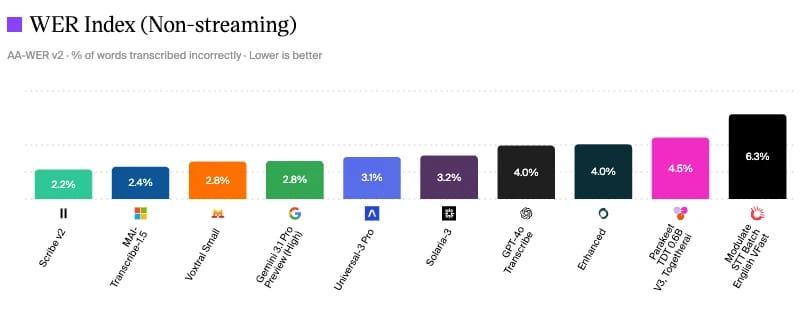
Artificial Analysis स्पीच टू टेक्स्ट मॉडल्स का मूल्यांकन
बातचीत की गुणवत्ता मापने का एक तरीका अलग-अलग कॉम्पोनेंट्स के लिए इंडस्ट्री बेंचमार्किंग मानकों को देखना है। जैसा कि आप देख सकते हैं, ElevenLabs का Scribe v2 जून 2026 तक 2.2% के साथ सबसे कम Word Error Rate रखता है। इसका मतलब है कम गलत सुनाई देना, कम फ़ॉलबैक्स और अधिक सटीक इंटेंट क्लासिफिकेशन।
व्यवसायों को यह भी लग सकता है कि बातचीत की गुणवत्ता उस वर्कफ़्लो पर निर्भर करती है जिसमें वॉइस एजेंट काम करता है। उदाहरण के लिए, कस्टमर सर्विस में एस्केलेशन हैंडऑफ़ क्वालिटी या FAQ रिज़ॉल्यूशन भी महत्वपूर्ण हो सकते हैं।
टूल उपयोग और टास्क पूरा करना
जहां गुणवत्ता मापती है कि बातचीत का अनुभव कैसा था, वहीं टास्क कंप्लीशन मापता है कि क्या उसका परिणाम सफल रहा। एंटरप्राइज़ को वॉइस एजेंट मूल्यांकन फ्रेमवर्क के इस हिस्से पर ध्यान देना चाहिए, क्योंकि यह सीधे व्यावसायिक नतीजों से जुड़ा है।
टूल उपयोग का एक माप स्लॉट-फिल एक्यूरेसी है, जो तय करता है कि AI एजेंट्स ग्राहक जानकारी से फ़ॉर्म भरने जैसे सामान्य टास्क कितनी अच्छी तरह पूरे कर सकते हैं। उच्च स्लॉट-फिल एक्यूरेसी दिखाती है कि एजेंट जानकारी खोए बिना बातचीत से कार्रवाई की ओर आसानी से बढ़ सकता है।
Task Success Rate (TSR) प्रतिशत-आधारित माप है कि एजेंट ने कितने एंड-टू-एंड टास्क सफलतापूर्वक पूरे किए। इसमें सफलता एजेंट की किसी अनुरोध को समझने और मदद के लिए सही कनेक्टेड टूल्स (APIs, डेटाबेस, Retrieval-Augmented Generation (RAG), और आंतरिक नॉलेज बेस) का उपयोग करने की क्षमता पर आधारित होती है।
TSR का फ़ॉर्मूला है:
TSR = (पूरी तरह पूरे किए गए टास्क / प्रयास किए गए कुल टास्क) x 100
प्रोडक्शन-रेडी वॉइस एजेंट्स का लक्ष्य 85% से अधिक TSR होना चाहिए और टूल कॉल एक्यूरेसी व टूल कॉल विश्वसनीयता की निगरानी करनी चाहिए। TSR में गिरावट से बचने के लिए किसी भी प्रॉम्प्ट या कनेक्टेड मॉडल बदलाव पर रिग्रेशन टेस्ट ज़रूर करें। छोटा-सा बदलाव भी TSR पर बड़ा असर डाल सकता है।
इंटेलिजेंस
इंटेलिजेंस वॉइस एजेंट की तर्क करने और उच्च-स्तरीय क्षमताओं को दर्शाती है। यही स्तंभ वॉइस-आधारित IVR (Interactive Voice Response) और वॉइस AI एजेंट के बीच अंतर स्पष्ट करता है।
यहां मूल्यांकन करने के लिए मुख्य आयाम हैं:
- हैलुसिनेशन जोखिम: हैलुसिनेशन में एजेंट ऐसी जानकारी देता है जो गलत होती है या कंपनी दस्तावेज़ों से मेल नहीं खाती। वॉइस AI में यह विशेष रूप से नुकसानदेह है, क्योंकि इसे आत्मविश्वास के साथ पेश किया जा सकता है। हालिया अध्ययन बताते हैं कि आम हैलुसिनेशन वॉइस एजेंट्स के प्रति ग्राहक संतुष्टि को काफी नुकसान पहुंचाता है।
- स्कोप से बाहर के मामलों को संभालना:इंटेलिजेंट एजेंट समझते हैं कि कोई सवाल उनके संदर्भ डोमेन से बाहर है और उचित जवाब दे सकते हैं। जवाब गढ़ने के बजाय, वे मना करते हैं या बातचीत को संदर्भ के अनुरूप क्षेत्र में वापस ले जाते हैं।
- संदर्भ बनाए रखना: क्या एजेंट कई टर्न्स में पहले बताए गए एंटिटीज़ और किए गए वादों को ट्रैक कर सकता है? इस क्षमता के बिना, ग्राहकों को खुद को दोहराना पड़ सकता है या विरोधाभासी जवाब मिल सकते हैं।
- तर्क और मल्टी-स्टेप लॉजिक: क्या एजेंट कई टर्न्स में कंडीशनल लॉजिक संभाल सकता है या निष्कर्षों की श्रृंखला बना सकता है? खासकर अधिक तकनीकी उपयोगों में, जैसे वित्तीय सेवाएं, पहले से तय संदर्भ में तर्क करने की क्षमता सफलता के लिए आवश्यक है।
इन आयामों और कॉम्पोनेंट्स के लिए कई थर्ड-पार्टी बेंचमार्क मौजूद हैं। उदाहरण के लिए, Stanford का Holistic Evaluation of Language Models (HELM) अलग-अलग श्रेणियों में LLM परफ़ॉर्मेंस का बेंचमार्क करता है। हैलुसिनेशन के लिए, TruthfulQA यह मजबूत विश्लेषण देता है कि जवाबों में गलत उत्तर कितनी बार आते हैं।
ElevenAgents का एक फ़ायदा यह है कि कुछ वॉइस प्लेटफ़ॉर्म्स के विपरीत, जो आपको एक ही अंतर्निहित मॉडल तक सीमित रखते हैं, आप LLM लेयर को पूरी तरह बदल सकते हैं। व्यवहार में, इसका मतलब है कि आप अपने खास उपयोग के लिए रीजनिंग बेंचमार्क्स में आगे रहने वाला कोई भी मॉडल जोड़ सकते हैं।
अनुपालन और सुरक्षा
हानिकारक या नीति-विरोधी आउटपुट को रोकने के लिए व्यवसायों को सक्रिय गार्डरेल्स लागू करने चाहिए। सिस्टम-लेवल प्रॉम्प्ट निर्देशों के विपरीत, जिन्हें बदला या बायपास किया जा सकता है, स्वतंत्र गार्डरेल जांच मॉडल के बाहर अलग लेयर के रूप में चलती हैं। ये यूज़र तक पहुंचने से पहले आउटपुट का मूल्यांकन करती हैं और बातचीत खतरनाक दिशा में जाने पर उसे रोक देती हैं।
ऑडिटेबिलिटी भी एक संबंधित आवश्यकता है। प्रोडक्शन एजेंट्स को निर्णयों और आउटपुट्स के विस्तृत लॉग ऐसे फ़ॉर्मेट में रखने चाहिए, जो बाद में समीक्षा में मदद करे। खासकर अत्यधिक विनियमित उद्योगों में, बाद में अनुपालन साबित करना उतना ही महत्वपूर्ण है जितना शुरुआत में उसे हासिल करना।
आपके व्यवसाय को किन सटीक नियमों का पालन करना है, यह उद्योग पर निर्भर करेगा। सबसे आम लागू फ्रेमवर्क्स हैं:
- HIPAA: अमेरिका के हेल्थकेयर संदर्भों में संरक्षित स्वास्थ्य डेटा के लिए।
- PCI-DSS: पेमेंट कार्ड डेटा संभालने वाले किसी भी एजेंट के लिए।
- GDPR: EU और EU में ग्राहकों वाले व्यवसायों के लिए डेटा प्राइवेसी दायित्व।
अपने अनुपालन स्तर का मूल्यांकन करने वाले व्यवसायों के लिए, ElevenLabs के पास AICPA SOC Type II और GDPR अनुपालन है, साथ ही AIUC-1 सर्टिफ़िकेशन भी है। AIUC-1 विशेष रूप से AI एजेंट्स के लिए बनाया गया सुरक्षा मानक है।
विश्वसनीयता
विश्वसनीयता हमारे वॉइस एजेंट मूल्यांकन फ्रेमवर्क का अंतिम स्तंभ है, जो यह देखता है कि एजेंट रीयल-टाइम में लगातार डिलीवर कर सकता है या नहीं।
वॉइस एजेंट का आकलन करते समय, इन विशेषताओं को देखें:
- अपटाइम: किसी भी ग्राहक-सामना करने वाले डिप्लॉयमेंट को आउटेज से बचने के लिए 99.9% अपटाइम चाहिए। हमेशा सक्रिय रहने वाले उपयोगों, जैसे इनबाउंड सपोर्ट, में विश्वसनीय अपटाइम एक बड़ा कारक है।
- सहज डिग्रेडेशन: वॉइस एजेंट्स की अंतर्निहित जटिलता के कारण, यदि कोई कॉम्पोनेंट फेल होने लगे, तो एजेंट को उस डिग्रेडेशन को सहजता से संभालना चाहिए। व्यवहार में इसका मतलब है त्रुटियों के साथ या बढ़े हुए दबाव में चलते रहने के बजाय कॉल को इंसान तक भेजना।
- लोड के दौरान परफ़ॉर्मेंस:लाइव होने से पहले लोड टेस्टिंग में आपकी अपेक्षित पीक कॉन्करेंसी का कम से कम 2x सिम्युलेट करना चाहिए। भारी दबाव में टेस्टिंग ऐसी लेटेंसी वृद्धि या परफ़ॉर्मेंस गिरावट पहचान सकती है जो केवल बड़े स्तर पर दिखती है।
दूसरे सभी मानदंड पूरे करने वाला उच्च-गुणवत्ता मॉडल भी बेकार हो सकता है, अगर वह ग्राहक मांग के साथ स्केल नहीं कर सकता। ElevenAgents पर 1,000,000 प्रमुख क्रिएटर्स और एंटरप्राइज़ भरोसा करते हैं, जो परफ़ॉर्मेंस बेंचमार्क्स से समझौता किए बिना एंटरप्राइज़ स्तर पर डिप्लॉयमेंट देने की प्लेटफ़ॉर्म क्षमता दिखाता है।
वॉइस एजेंट्स के लिए MOS कैसे मापें (स्टेप-बाय-स्टेप)
अगर आपका व्यवसाय MOS को मैन्युअली मापना चाहता है, तो आपको बड़े समूह में इंसानी श्रोताओं और वास्तविक बातचीतों से ऑडियो क्लिप्स के चयन की ज़रूरत होगी। यह एक व्यवस्थित प्रक्रिया है, जिसमें फ़ीडबैक इकट्ठा करना, उसका औसत निकालना और फिर डेटा की व्याख्या करना शामिल है।
व्यवहार में वॉइस एजेंट्स के लिए MOS इस तरह मापें:
- अपना टेस्ट सेट तैयार करें: अपने एजेंट के ऑडियो आउटपुट्स का प्रतिनिधि नमूना चुनें, जिसमें अलग-अलग बातचीतों की कम से कम 100 क्लिप्स हों।
- रेटिंग सेशन चलाएं: अपने इंसानी श्रोताओं से संचार अनुभव की गुणवत्ता के आधार पर हर क्लिप को 1-5 के पैमाने पर रेट करने को कहें।
- रेटिंग्स को एकत्र करें और स्कोर निकालें:हर क्लिप की रेटिंग का औसत निकालें, फिर सभी सैंपल क्लिप्स का औसत निकालकर ओवरऑल MOS बनाएं। 4.3 या अधिक का MOS बताता है कि आपका वॉइस एजेंट प्रोडक्शन के लिए तैयार है।
मैन्युअल रूप से मेहनत लगने के बावजूद, यह प्रक्रिया आपके चुने हुए वॉइस एजेंट के लिए ठोस MOS देगी। अगर आप टेस्ट को बड़े स्तर पर चलाना चाहते हैं, तो इंसानी श्रोताओं की जगह NISQA जैसे ऑटोमेटेड टूल्स इस्तेमाल कर सकते हैं, जो प्रोग्रामेटिक रूप से MOS स्कोर का अनुमान लगाते हैं। समय के साथ MOS की लगातार निगरानी के लिए आप इन सिस्टम्स को अपनी सक्रिय पाइपलाइन्स में जोड़ सकते हैं।
AI बनाम मानव टेस्टिंग बेंचमार्क्स: FCR, AHT और CSAT
समय के साथ बार-बार MOS की गणना करने से मॉडल में सुधार या गिरावट दिखती है, लेकिन मानव परफ़ॉर्मेंस के साथ बेंचमार्किंग करके आप अतिरिक्त संदर्भ जोड़ सकते हैं। समान भूमिकाओं में इंसान वास्तव में क्या हासिल करते हैं, यह देखने से पता चलेगा कि आपका वॉइस एजेंट आदर्श स्तर के कितना करीब प्रदर्शन कर रहा है।
AI बनाम मानव टेस्टिंग बेंचमार्क्स के लिए इन कुछ मेट्रिक्स पर विचार करें।
AI एजेंट्स को मानव FCR और CSAT की बराबरी करने के साथ AHT में काफी सुधार करना चाहिए। इसका कारण यह है कि AI एजेंट्स आमतौर पर मानव एजेंट्स की तुलना में अधिक सामान्य बातचीत संभालते हैं। कई व्यवसाय ऐसा वर्कफ़्लो अपनाते हैं जहां AI एजेंट पहले जवाब देते हैं और केवल वे कॉल्स मानव एजेंट्स को भेजते हैं जो स्वायत्त रूप से संभालने के लिए बहुत जटिल हों।
AI तुलना एग्रीगेटर Poe के 2025 डेटा से पता चलता है कि ElevenLabs ने अनुरोध पूरे करने की सबसे मजबूत समग्र क्षमता बनाए रखी, जिसने आने वाले सभी अनुरोधों में से 74.4% पूरे किए। इस सफलता से उपयोग तेज़ी से बढ़ा है और समय के साथ AI मॉडल्स को भेजे गए संदेशों में Eleven v3 और v2.5-Turbo की हिस्सेदारी 60% से अधिक रही है।
बेहतर अनुभव के लिए, हमारे सबसे भावनात्मक TTS मॉडल Eleven v4 का उपयोग करें।
समय के साथ AI मॉडल्स को भेजे गए संदेश, Poe वॉइस एजेंट मूल्यांकन फ्रेमवर्क में ElevenLabs सबसे आगे
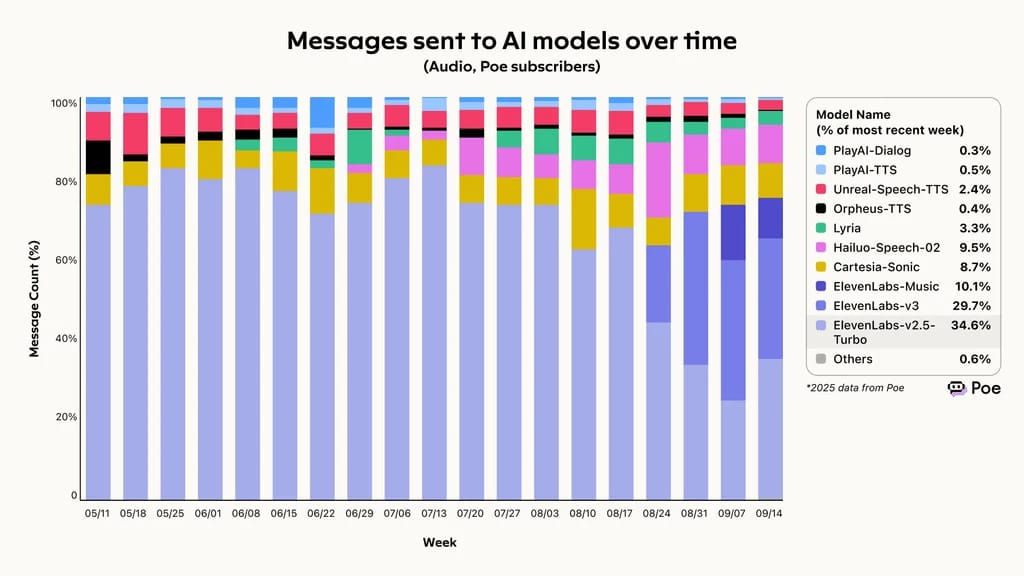
Poe द्वारा बेंचमार्क किए गए, समय के साथ AI मॉडल्स को भेजे गए संदेश
वॉइस एजेंट टेस्टिंग की आम गलतियां
वॉइस एजेंट मूल्यांकन फ्रेमवर्क अपनाते समय, सबसे अनुकूल परिस्थितियों के लिए टेस्ट करना आकर्षक लग सकता है। लेकिन आपके वॉइस AI सिस्टम्स के साथ ग्राहकों का रोज़मर्रा का अनुभव आदर्श परिस्थितियों से नहीं आएगा।
वॉइस एजेंट टेस्टिंग की तीन आम गलतियां और उन्हें ठीक करने के तरीके यहां दिए गए हैं:
- सबसे आसान रास्ते की टेस्टिंग: खासकर MOS के लिए ऑडियो क्लिप्स चुनते समय, एज केस उपयोगों को ज़रूर शामिल करें। बैकग्राउंड नॉइज़ या अलग उच्चारण वाली स्पीच की क्लिप्स वास्तविक जीवन में बेहद आम हैं, इसलिए केवल ‘क्लीन’ ऑडियो फ़ाइल्स पर टेस्ट करने से MOS गलत तरीके से कैलिब्रेट होगा।
- रिज़ॉल्यूशन से अधिक कंटेनमेंट को प्राथमिकता देना: यूज़र्स को अपने एजेंट सिस्टम में बनाए रखने के लिए मॉडल्स को ऑप्टिमाइज़ करने से नतीजे सुधारे बिना कंटेनमेंट रेट बढ़ जाती है। अगर उच्च कंटेनमेंट रेट के बावजूद FCR कम है, तो एजेंट यूज़र्स को निराशाजनक चक्र में घुमा रहा है। यूज़र्स की इच्छा होने पर उन्हें मानव एजेंट्स से बात करने देने की व्यवस्था रखें।
- लेटेंसी परसेंटाइल्स को नज़रअंदाज़ करना: SLAs अक्सर P95 स्तर के आधार पर लेटेंसी तय करते हैं। आपके अधिकतर ग्राहकों को लगातार अनुभव देने के लिए यह मेट्रिक महत्वपूर्ण है, लेकिन यह न भूलें कि अंतिम 5% भी असली ग्राहक हैं। बड़े स्तर पर, रोज़ाना 10,000 कॉल्स संभालने वाले सिस्टम के 5% का मतलब अब भी 500 लोग हैं जिन्हें धीमी बातचीत मिलती है। सिर्फ मीडियन या P95 नहीं, बल्कि P99 को अपना मुख्य SLA लक्ष्य बनाएं।
इन बातों को ध्यान में रखकर, आप आदर्श औसतों पर निर्भर रहने के बजाय निष्पक्ष और प्रतिनिधि बेसलाइन्स बना सकते हैं।
उपयोग-विशिष्ट मूल्यांकन के पक्ष में तर्क
हालांकि इस फ्रेमवर्क के छह स्तंभ उन क्षेत्रों का मार्गदर्शन देते हैं जिन्हें आपको देखना चाहिए, हर स्तंभ का महत्व आपके उद्योग पर निर्भर करेगा। उदाहरण के लिए, वित्तीय सेवा उद्योग का कोई व्यवसाय अनुपालन और टूल उपयोग को प्राथमिकता दे सकता है, जबकि कोई उपभोक्ता ब्रांड TTS वॉइस क्वालिटी को अपना मार्गदर्शक सिद्धांत मानेगा।
यहां उपयोग-विशिष्ट मूल्यांकन के दो उदाहरण हैं और यह कि वे हर स्तंभ का संतुलन कैसे बदल सकते हैं।
कस्टमर सपोर्ट
कॉल सेंटर्स जैसे कुछ उद्योगों में, First Call Resolution (FCR) जैसे अन्य टास्क-कंप्लीशन मेट्रिक्स बातचीत का महत्वपूर्ण हिस्सा होते हैं। मानवीय हस्तक्षेप के बिना इनकमिंग कॉल को सफलतापूर्वक संभालना मानव कस्टमर सर्विस एजेंट्स पर पड़ने वाली मांग को काफी कम करता है। McKinsey का अनुमान है कि वॉइस एजेंट्स इस्तेमाल करने वाले कॉल सेंटर्स इंटरैक्शन वॉल्यूम को 50% तक घटा सकते हैं।
टास्क सक्सेस रेट जितना महत्वपूर्ण न होते हुए भी, यहां कंटेनमेंट रेट एक और आयाम है। कंटेनमेंट रेट वह मेट्रिक है जो कॉल की कुल अवधि को देखता है। अगर कंटेनमेंट रेट बहुत अधिक है, लेकिन FCR कम है, तो आपके एजेंट ग्राहक को समाधान दिए बिना कॉल पर रोके रख रहे हैं। व्यवहार में, यह ग्राहक के लिए बार-बार उसी जगह लौटने वाला निराशाजनक अनुभव हो सकता है।
ट्रैक करने के लिए अन्य मेट्रिक्स में AHT शामिल है, जिसमें AI एजेंट्स का लक्ष्य सामान्य समस्याओं को जल्दी हल करना है। इस वजह से कस्टमर सपोर्ट क्षेत्र अन्य क्षेत्रों की तुलना में बातचीत की गुणवत्ता, खासकर टर्न-टेकिंग और फ़ॉलबैक रेट, को प्राथमिकता देगा।
हेल्थकेयर
हेल्थकेयर एक अत्यधिक विनियमित क्षेत्र है, जहां कड़ी अनुपालन आवश्यकताएं वॉइस एजेंट का संचालन बेहद संवेदनशील बना देती हैं। अनुपालन मुख्य चिंता है, जिससे फ्रेमवर्क के सुरक्षा स्तंभ का महत्व बहुत बढ़ जाता है और यह इंटेलिजेंस से भी ऊपर आ सकता है।
हेल्थकेयर चैटबॉट्स को अपॉइंटमेंट शेड्यूलिंग, टेलीहेल्थ एक्सेस पाथवेज़, लक्षणों की ट्रायेज और बीमा संबंधी सवाल संभालने होते हैं। इन सभी के लिए उच्च स्तर की इंटेलिजेंस और टूल उपयोग चाहिए, जो फिर दिखाता है कि उद्योग या भूमिका-विशिष्ट मांगें तय करती हैं कि कौन-सा स्तंभ सबसे महत्वपूर्ण है।
आपका व्यवसाय किसी भी क्षेत्र में हो, वॉइस एजेंट मूल्यांकन के मूल स्तंभों को समझना और संतुलित ढंग से लागू करना आपके लिए सबसे अच्छे एजेंट्स खोजने में मदद करेगा।
उच्च परफ़ॉर्मेंस और कम लेटेंसी के लिए ElevenAgents के साथ बनाएं
जिस प्लेटफ़ॉर्म पर आप निर्माण करते हैं, वह सीधे प्रभावित करता है कि आपके वॉइस एजेंट्स वास्तविक वर्कफ़्लोज़ में कैसा प्रदर्शन करते हैं। खासकर ग्राहकों से बातचीत करते समय, आपको भरोसा होना चाहिए कि आपका एजेंट हर श्रेणी में बेहतरीन प्रदर्शन करेगा।
ElevenAgents को प्रोडक्शन वॉइस डिप्लॉयमेंट्स के लिए बनाया गया है, जिसमें Eleven v4 के ज़रिए इंडस्ट्री-लीडिंग TTS, Scribe v2 के ज़रिए रीयल-टाइम STT और एजेंट ऑर्केस्ट्रेशन लेयर शामिल है, जिसे एंटरप्राइज़ स्केल के लिए डिज़ाइन किया गया है। हर कॉम्पोनेंट इस फ्रेमवर्क में तय बेंचमार्क्स के अनुसार परफ़ॉर्म करने के लिए बनाया गया है, ताकि आप ग्राहकों को उच्च-गुणवत्ता अनुभव दे सकें।
चाहे आप विकल्पों पर विचार कर रहे हों या निर्माण शुरू करने के लिए तैयार हों, ElevenLabs के पास आपके लिए एक रास्ता है। ElevenAgents प्लेटफ़ॉर्म देखें कि यह आपके उपयोग के मामले से कैसे मेल खाता है, या साइन अप करें और आज ही बनाना शुरू करें।
वॉइस एजेंट मूल्यांकन के बारे में FAQs

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।


