
कॉन्टेक्स्ट विंडो क्या है? हर LLM यूज़र को क्या जानना चाहिए
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
कॉन्टेक्स्ट विंडो वह जानकारी की मात्रा है जिसे एक बड़ा भाषा मॉडल (LLM) एक ही अनुरोध में प्रोसेस कर सकता है। टोकन में मापी जाने वाली इसमें आपका प्रॉम्प्ट, बातचीत का इतिहास, सिस्टम निर्देश, प्राप्त दस्तावेज़, टूल के नतीजे और मॉडल का जनरेट किया गया जवाब शामिल हो सकता है।
बड़ी कॉन्टेक्स्ट विंडो मॉडल को एक ही अनुरोध में ज़्यादा जानकारी के साथ काम करने देती है। उदाहरण के लिए, किसी बग की जांच कर रहा कोडिंग एजेंट हर चीज़ को अलग-अलग विश्लेषित करने और अनुरोधों के बीच उपयोगी संदर्भ खोने के बजाय, संबंधित सोर्स फ़ाइलों, दस्तावेज़ों, टेस्ट नतीजों और हाल के कोड बदलावों पर एक साथ काम कर सकता है।
हालांकि, बड़ी कॉन्टेक्स्ट विंडो परफेक्ट मेमोरी जैसी नहीं होती। लंबे प्रॉम्प्ट के लिए ज़्यादा कंप्यूटेशन चाहिए, वे ज़्यादा टोकन इस्तेमाल करते हैं और मॉडल के लिए यह पहचानना मुश्किल बना सकते हैं कि कौन-सी जानकारी वास्तव में मायने रखती है। लंबे कॉन्टेक्स्ट वाले मॉडलों पर शोध, जिसमें Lost in the Middle अध्ययन और NVIDIA का RULER बेंचमार्क शामिल हैं, ने बार-बार पाया है कि कॉन्टेक्स्ट बढ़ने पर मॉडल उपलब्ध जानकारी का कम उपयोग करते हैं, खासकर तब जब प्रासंगिक जानकारी कम उपयोगी सामग्री के बीच दब गई हो।
इस लेख में बताया गया है कि कॉन्टेक्स्ट विंडो कैसे काम करती हैं, इन्हें कैसे मापा जाता है, भर जाने पर क्या होता है और डेवलपर इन्हें प्रभावी ढंग से कैसे मैनेज कर सकते हैं।
सारांश
- कॉन्टेक्स्ट विंडो वह कुल टोकन बजट है जिसका LLM एक अनुरोध के लिए उपयोग करता है। इसमें यूज़र प्रॉम्प्ट, बातचीत का इतिहास, प्राप्त सामग्री और आउटपुट शामिल होते हैं।
- बड़ी कॉन्टेक्स्ट विंडो लंबे दस्तावेज़ों, कोडबेस और बातचीत को संभव बनाती हैं, लेकिन यह गारंटी नहीं देतीं कि मॉडल उनके हर हिस्से का अच्छी तरह इस्तेमाल करेगा।
- मॉडल लंबे प्रॉम्प्ट के बीच से जानकारी सबसे कम भरोसेमंद तरीके से निकालते हैं—यह पैटर्न Lost in the Middle अध्ययन और RULER बेंचमार्क में दर्ज है।
- प्रभावी कॉन्टेक्स्ट मैनेजमेंट (रिट्रीवल, समरीकरण, कैशिंग) आमतौर पर भेजे जाने वाले टोकन की संख्या बस बढ़ाने से बेहतर है।
- सबसे अच्छी कॉन्टेक्स्ट रणनीति वही है जो आपके वास्तविक वर्कलोड के अनुकूल हो, न कि वह जो सबसे बड़ी बताई गई कॉन्टेक्स्ट विंडो इस्तेमाल करती हो।
AI मॉडल में कॉन्टेक्स्ट विंडो क्या होती है?
कॉन्टेक्स्ट विंडो मॉडल का सक्रिय कार्यक्षेत्र होती है, जहाँ मौजूदा अनुरोध से जुड़ी हर चीज़ मॉडल के जवाब जनरेट करने से पहले एक साथ आती है।
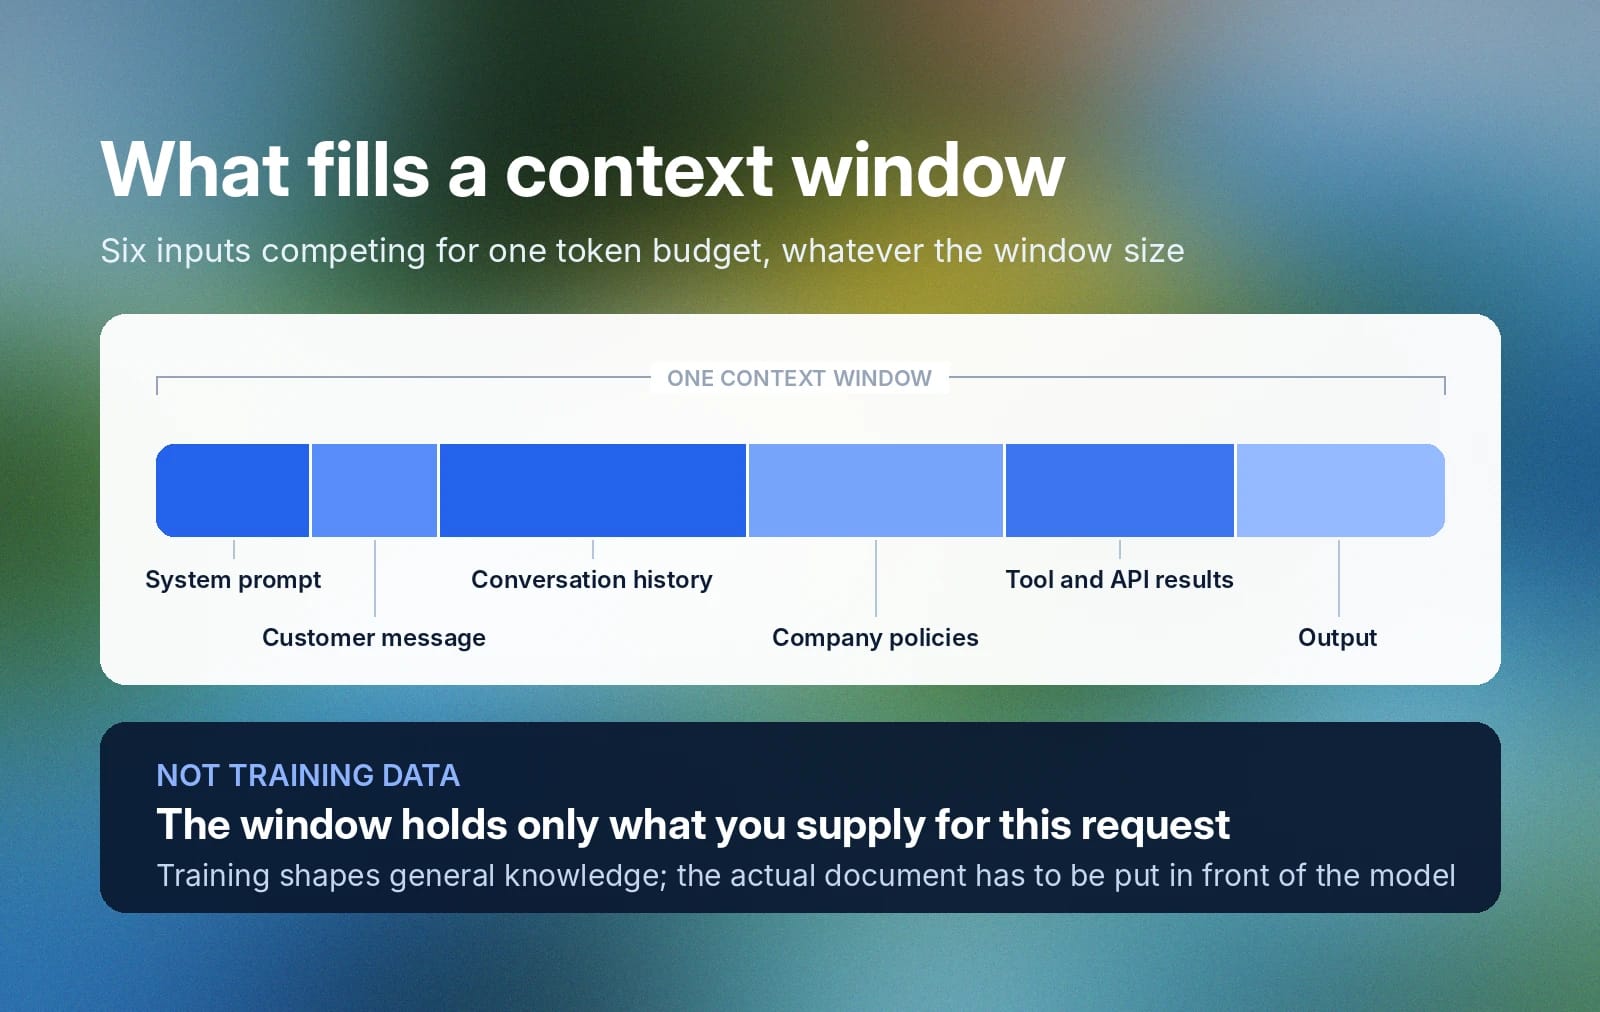
एक AI एजेंट की कल्पना करें, जो कस्टमर सपोर्ट बातचीत का सारांश बनाता है और समाधान सुझाता है। यह अच्छी तरह करने के लिए मॉडल को इन चीज़ों को प्रोसेस करना होता है:
- सिस्टम प्रॉम्प्ट
- ग्राहक का संदेश
- बातचीत का इतिहास
- कंपनी की नीतियाँ
- टूल और API के नतीजे
- आउटपुट
विंडो कितनी भी बड़ी हो, ये सभी चीज़ें उसी कॉन्टेक्स्ट विंडो में जगह के लिए प्रतिस्पर्धा करती हैं।
कॉन्टेक्स्ट विंडो में ट्रेनिंग डेटा शामिल नहीं होता। ट्रेनिंग जानकारी को मॉडल के पैरामीटर्स में स्थायी रूप से शामिल कर देती है, जिससे यह तय होता है कि मॉडल सामान्य रूप से क्या “जानता” है। इसके विपरीत, कॉन्टेक्स्ट विंडो में सिर्फ मौजूदा काम के लिए दी गई जानकारी होती है।
व्यवहार में यह अंतर अहम है: अगर किसी एप्लिकेशन को किसी खास नीति, ग्राहक रिकॉर्ड या तकनीकी दस्तावेज़ पर मॉडल से तर्क करवाना है, तो सिर्फ इसलिए वह जानकारी उपलब्ध नहीं हो जाती कि मॉडल को मिलती-जुलती सामग्री पर ट्रेन किया गया था। आम तौर पर उस जानकारी को प्रॉम्प्ट में सीधे या रिट्रीवल अथवा टूल सिस्टम के ज़रिए मॉडल के कार्यशील कॉन्टेक्स्ट में लाना पड़ता है, वरना मॉडल सामने मौजूद वास्तविक दस्तावेज़ के बजाय सामान्य ज्ञान के आधार पर तर्क करेगा।
टोकनाइज़ेशन और कॉन्टेक्स्ट विंडो: डेटा कैसे प्रोसेस होता है
किसी LLM के टेक्स्ट प्रोसेस करने से पहले, टोकनाइज़र उसे टोकन नाम की छोटी इकाइयों में बाँटता है। एक टोकन पूरा शब्द, शब्द का हिस्सा, विराम चिह्न या टेक्स्ट का कोई दूसरा छोटा भाग हो सकता है।
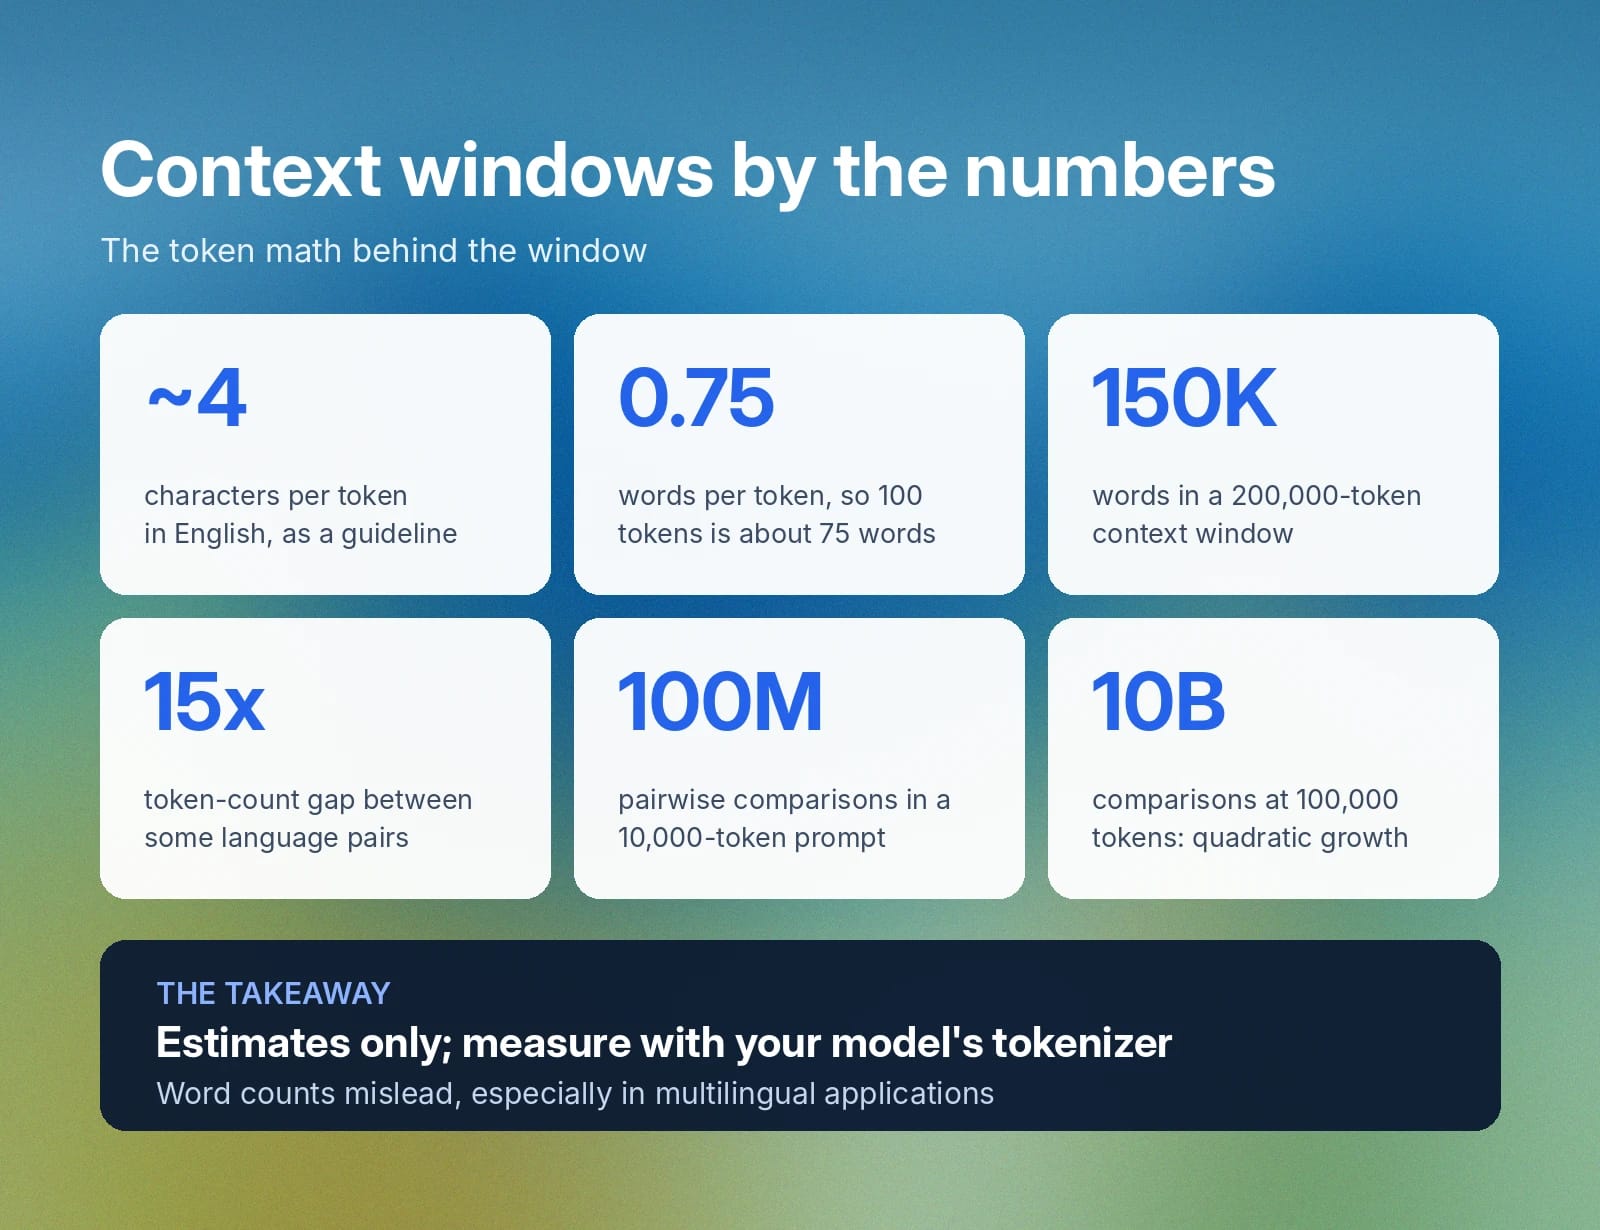
अंग्रेज़ी में एक उपयोगी अनुमान यह है कि एक टोकन लगभग चार अक्षरों या किसी शब्द के लगभग तीन-चौथाई हिस्से के बराबर होता है। इस अनुमान से 100 टोकन लगभग 75 शब्दों के बराबर होते हैं। हालांकि, यह सिर्फ एक अनुमान है। “Context windows affect application performance.” वाक्यांश को लें। टोकनाइज़र इसे ज़रूरी नहीं कि पाँच पूरे शब्दों के रूप में दिखाए; टोकनाइज़र के आधार पर एक या ज़्यादा शब्द कई सबवर्ड टोकन में बँट सकते हैं।
टोकनाइज़ेशन भाषाओं के बीच भी काफी अलग होता है। समान अर्थ और दिखाई देने वाली समान लंबाई वाले दो वाक्य, भाषा और टोकनाइज़र के आधार पर बहुत अलग संख्या में टोकन ले सकते हैं। टोकनाइज़र निष्पक्षता पर शोध में पाया गया है कि बहुभाषी सहायता के लिए बनाए गए टोकनाइज़र के साथ भी, समान टेक्स्ट के लिए कुछ भाषा जोड़ों की टोकनाइज़्ड लंबाई में 15 गुना तक का अंतर हो सकता है। बहुभाषी एप्लिकेशन बनाने वाले डेवलपर्स को शब्दों की गिनती से अनुमान लगाने के बजाय अपने मॉडल के वास्तविक टोकनाइज़र से टोकन उपयोग मापना चाहिए।
200,000-टोकन की कॉन्टेक्स्ट विंडो बहुत बड़ी लग सकती है, लेकिन बातचीत का इतिहास, प्राप्त दस्तावेज़, टूल जवाब और सिस्टम निर्देश लगातार जोड़ने वाला एप्लिकेशन अपेक्षा से जल्दी इस सीमा तक पहुँच सकता है। इसलिए प्रोडक्शन एप्लिकेशन अक्सर टोकन उपयोग की निगरानी करते हैं और सबसे प्रासंगिक जानकारी को सक्रिय कॉन्टेक्स्ट में रखने के लिए समरीकरण, हिस्ट्री प्रूनिंग, रिट्रीवल फ़िल्टरिंग और प्रॉम्प्ट कंप्रेशन जैसी तकनीकें इस्तेमाल करते हैं।
भाषा मॉडलों में कॉन्टेक्स्ट विंडो कैसे काम करती है?
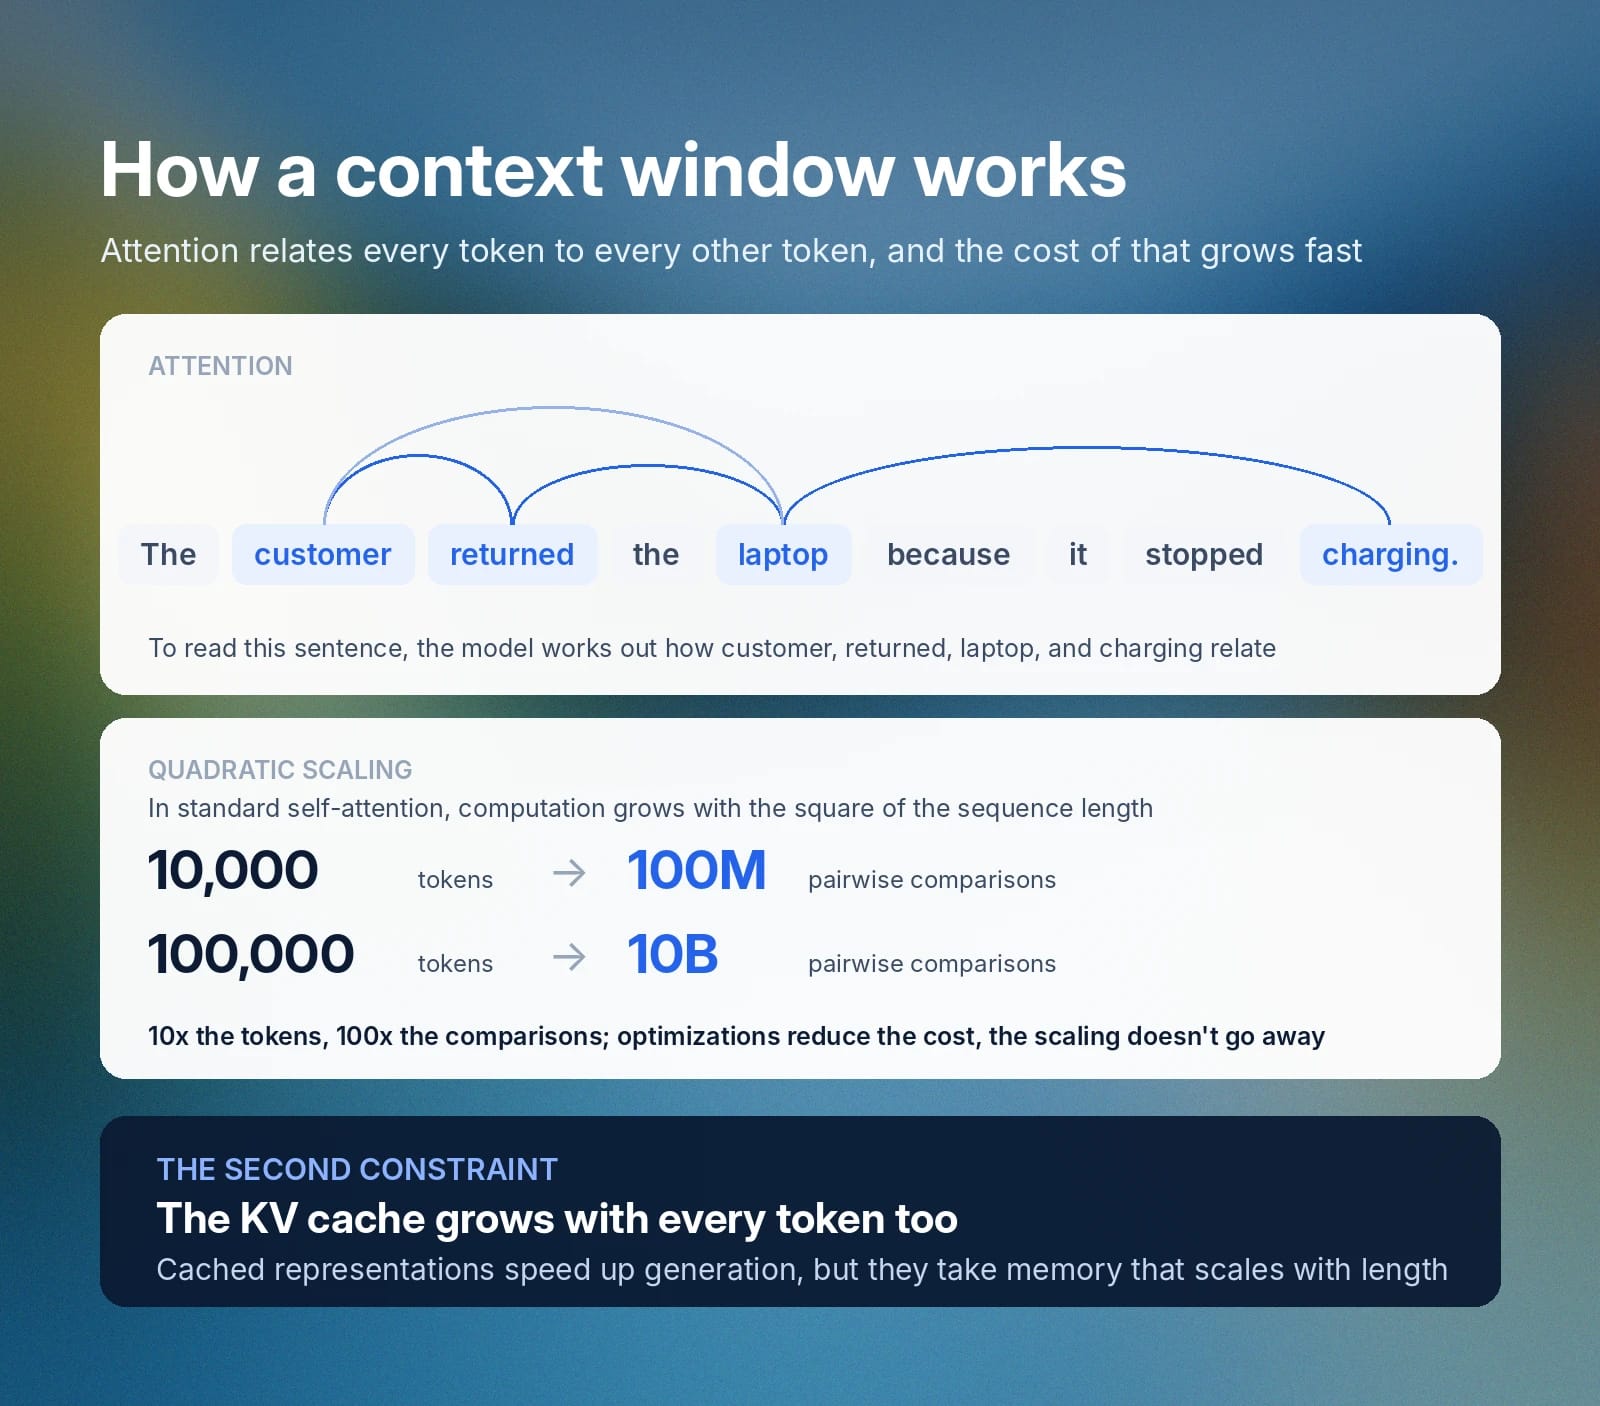
कॉन्टेक्स्ट विंडो ट्रांसफ़ॉर्मर आर्किटेक्चर के अटेंशन मैकेनिज़्म से काम करती है, जो मॉडल के जवाब देने से पहले इनपुट के हर टोकन का दूसरे सभी टोकनों से संबंध तय करता है।
वाक्य लें: "ग्राहक ने लैपटॉप वापस कर दिया क्योंकि उसने चार्ज होना बंद कर दिया था।" इसे सही समझने के लिए मॉडल को यह पता लगाना होता है कि ग्राहक, लैपटॉप, वापस किया और चार्ज होना आपस में कैसे जुड़े हैं। सीक्वेंस जितना लंबा होता है, इन संबंधों की संख्या उतनी तेज़ी से बढ़ती है।
मानक सेल्फ-अटेंशन में आवश्यक कंप्यूटेशन सीक्वेंस की लंबाई के वर्ग के लगभग अनुपात में बढ़ता है। उदाहरण के लिए, 10,000-टोकन के प्रॉम्प्ट के लिए लगभग 100 मिलियन जोड़ी तुलनाएँ चाहिए होती हैं, जबकि 100,000-टोकन के प्रॉम्प्ट के लिए लगभग 10 बिलियन। आधुनिक मॉडल व्यवहार में इस लागत को घटाने के लिए कई आर्किटेक्चरल और इन्फ्रास्ट्रक्चर ऑप्टिमाइज़ेशन इस्तेमाल करते हैं, लेकिन स्केलिंग की मूल समस्या खत्म नहीं होती।
लंबी बातचीत एक दूसरी सीमा जोड़ती है: की-वैल्यू, या KV, कैश। जनरेशन के दौरान मॉडल हर नए टोकन के लिए पुराने टोकनों की मध्यवर्ती प्रस्तुतियों को दोबारा कंप्यूट करने के बजाय बनाए रखते हैं, जिससे इन्फ़रेंस काफी तेज़ हो जाता है। हालांकि, कैश खुद मेमोरी लेता है और सीक्वेंस के लंबा होने के साथ बढ़ता है।
AI मॉडलों में अधिकतम कॉन्टेक्स्ट लंबाई और इसका महत्व
मॉडल की अधिकतम कॉन्टेक्स्ट लंबाई तय करती है कि वह एक अनुरोध में कितनी जानकारी स्वीकार और प्रोसेस कर सकता है। हालांकि, मॉडल बड़ी कॉन्टेक्स्ट विंडो का प्रभावी ढंग से उपयोग करता है या नहीं, यह अलग सवाल है।
लंबी कॉन्टेक्स्ट विंडो ऐसे उपयोग के मामले संभव बनाती हैं जो पुराने LLM के साथ कठिन या अव्यावहारिक थे। डेवलपर मॉडल को पूरा कोड रिपॉज़िटरी, लंबा कानूनी दस्तावेज़, शोध-पत्र, मीटिंग ट्रांसक्रिप्ट या बातचीत का बड़ा इतिहास दे सकते हैं, बिना सामग्री को पहले कुछ हज़ार टोकन में घटाए।
यह इसलिए अहम है क्योंकि मूल कॉन्टेक्स्ट का ज़्यादा हिस्सा बनाए रखने से मॉडल की सवालों का सटीक जवाब देने, जानकारी के दूर-दराज़ हिस्सों के बीच संबंध पहचानने और पूरे दस्तावेज़ पर निर्भर काम करने की क्षमता बेहतर हो सकती है। उदाहरण के लिए, कोडिंग असिस्टेंट को यह समझने के लिए कई फ़ाइलें देखनी पड़ सकती हैं कि कोई फ़ंक्शन कैसे कॉल होता है, जबकि कानूनी-दस्तावेज़ असिस्टेंट को एक सेक्शन की परिभाषाओं की तुलना दस्तावेज़ में बहुत बाद में बताई गई बाध्यताओं से करनी पड़ सकती है।
हालांकि, बड़ी कॉन्टेक्स्ट विंडो अपने-आप बेहतर नतीजे नहीं देती। बहुत लंबे इनपुट लागत और लेटेंसी बढ़ा सकते हैं, और मॉडल बड़े कॉन्टेक्स्ट के बीच दबाई गई जानकारी पर कम ध्यान दे सकते हैं। इसलिए डेवलपर्स को प्रासंगिक जानकारी चुनकर शामिल करनी चाहिए, लंबे इनपुट को स्पष्ट रूप से व्यवस्थित करना चाहिए और ज़रूरत के अनुसार रिट्रीवल, समरीकरण और कॉन्टेक्स्ट प्रूनिंग जैसी तकनीकें इस्तेमाल करनी चाहिए।
मॉडल के अनुसार कॉन्टेक्स्ट विंडो आकारों की तुलना
आज के प्रमुख मॉडल परिवारों में कॉन्टेक्स्ट विंडो कुछ लाख टोकन से लेकर 10 मिलियन तक बहुत अलग हैं। मौजूदा फ़्लैगशिप मॉडल की तुलना यह है:
मॉडल | कॉन्टेक्स्ट विंडो | नोट्स |
10 मिलियन टोकन | Meta का ओपन-वेट मॉडल; लिखे जाने तक सार्वजनिक रूप से उपलब्ध सबसे बड़ी विंडो | |
1.05 मिलियन टोकन | कोडिंग और एजेंटिक रीजनिंग के लिए OpenAI का मौजूदा फ़्लैगशिप मॉडल | |
1 मिलियन टोकन | लंबे दस्तावेज़ और मल्टी-फ़ाइल विश्लेषण के लिए Google का मौजूदा Pro-टियर मॉडल | |
1 मिलियन टोकन | Anthropic का मौजूदा Sonnet-टियर मॉडल; यह विंडो Claude API में डिफ़ॉल्ट रूप से लागू होती है |
प्रदाता नए मॉडल जारी करते और सीमाएँ बढ़ाते रहते हैं, इसलिए बताई गई सीमाएँ तेज़ी से बदलती हैं। इस तरह की किसी तालिका को स्थायी रैंकिंग के बजाय एक समय का स्नैपशॉट मानें। मॉडल चुनने में कॉन्टेक्स्ट आकार सिर्फ एक कारक है। यह अकेले रीजनिंग की गुणवत्ता, आउटपुट सीमाओं, लेटेंसी या लागत के बारे में कुछ नहीं बताता।
छोटी और बड़ी कॉन्टेक्स्ट विंडो के प्रभाव
छोटी कॉन्टेक्स्ट विंडो डेवलपर्स को चुनिंदा होने के लिए मजबूर करती है। लंबे दस्तावेज़ों को हिस्सों में बाँटा जाता है, पुराने बातचीत इतिहास का सारांश बनाया जाता है और बाहरी ज्ञान तभी प्राप्त किया जाता है जब उसकी वास्तव में ज़रूरत हो।
बड़ी कॉन्टेक्स्ट विंडो इनमें से कुछ सीमाएँ हटा देती है। आप ज़्यादा उदाहरण दे सकते हैं, बातचीत का ज़्यादा इतिहास रख सकते हैं या हर चीज़ को पहले अलग-अलग हिस्सों में बाँटे बिना दस्तावेज़ों के बड़े सेट का विश्लेषण कर सकते हैं।
हालांकि, बड़ी विंडो एक अलग समस्या लाती है: अटेंशन डाइल्यूशन। जब प्रॉम्प्ट में बहुत अधिक जानकारी होती है, तो मॉडल के लिए यह पहचानना मुश्किल हो सकता है कि मौजूदा अनुरोध के लिए कौन-सी जानकारी सबसे प्रासंगिक है। अहम निर्देश या सबूत कम प्रासंगिक सामग्री में दब सकते हैं, जिससे अधूरे, असंगत या कम सटीक जवाबों का जोखिम बढ़ता है।
मॉडल बीच में क्यों खो जाते हैं
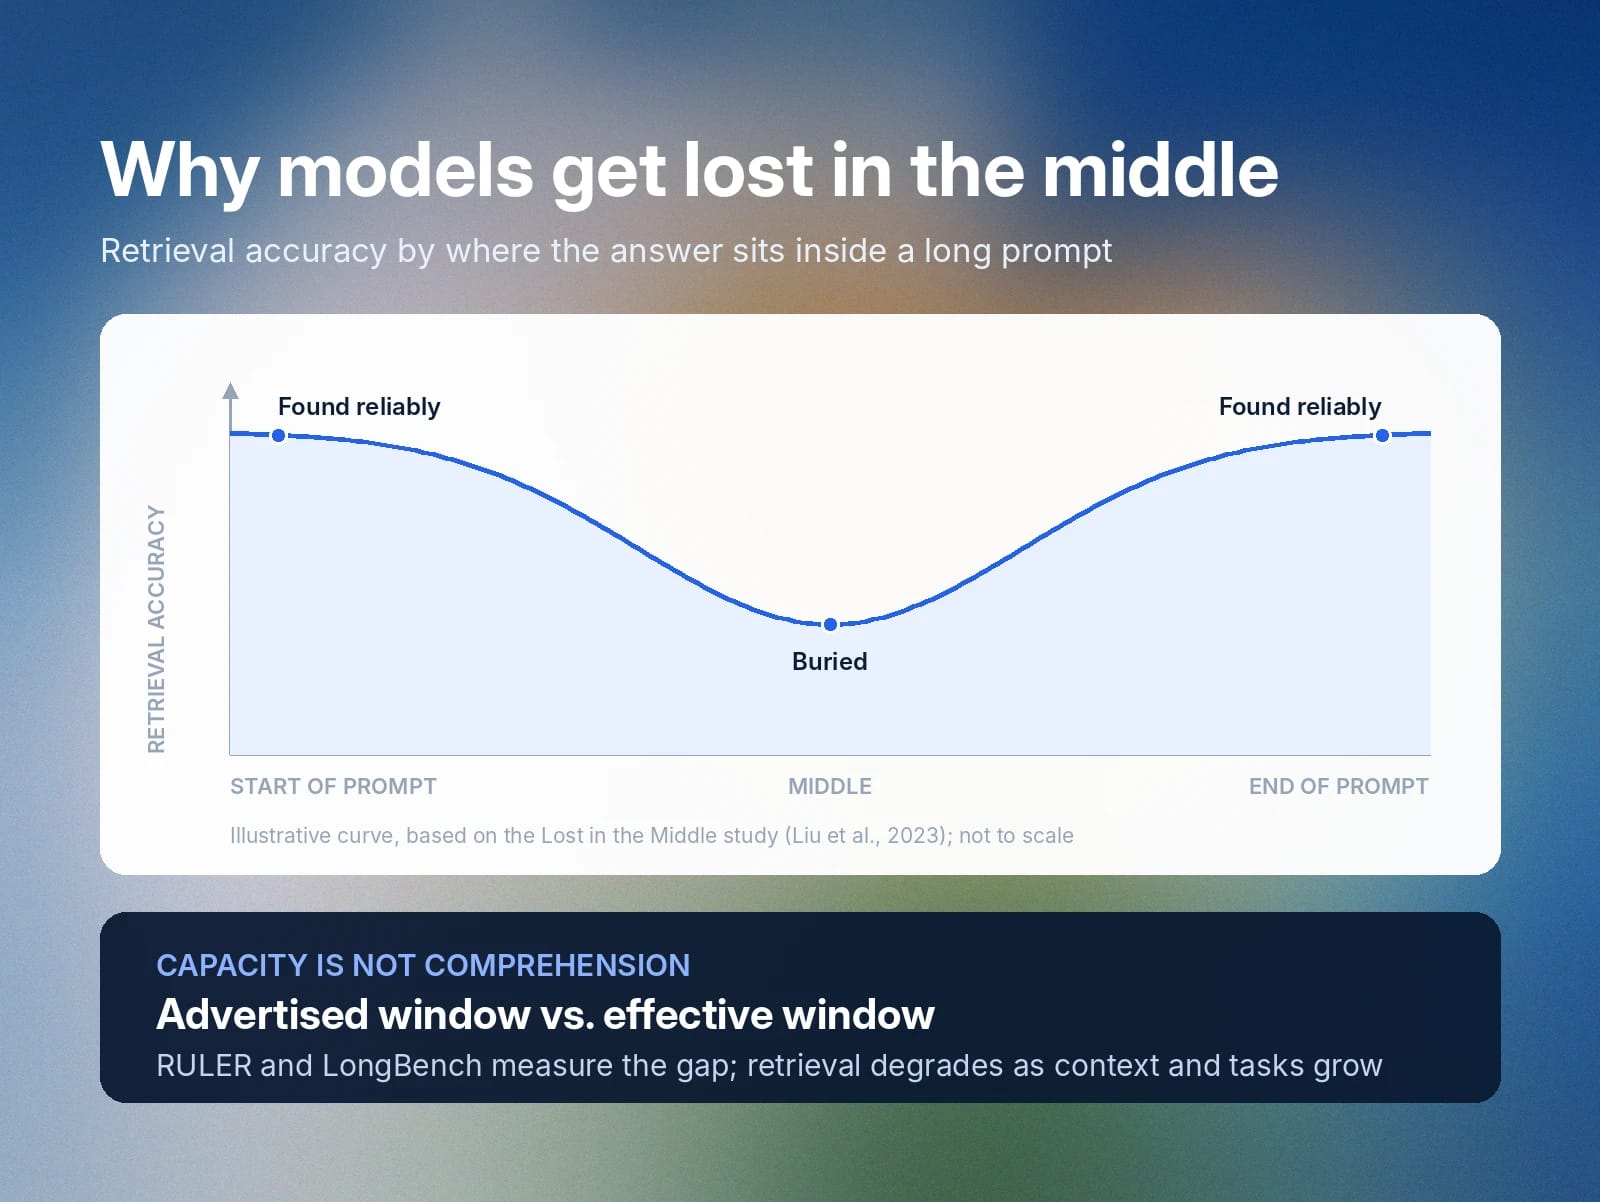
मॉडल जानकारी को तब सबसे अच्छी तरह प्राप्त करते हैं जब वह लंबे प्रॉम्प्ट की शुरुआत या अंत के पास हो, और तब सबसे खराब जब वह बीच में दब गई हो। प्रभावशाली Lost in the Middle अध्ययन ने लंबे प्रॉम्प्ट में सवाल के जवाब को अलग-अलग स्थानों पर रखकर और मॉडल उसे कितनी बार ढूँढते हैं यह मापकर सीधे इसकी जांच की। सटीकता कॉन्टेक्स्ट की शुरुआत और अंत में लगातार सबसे मजबूत तथा बीच में सबसे कमज़ोर थी।
इसका मतलब है कि मॉडल तकनीकी रूप से दस्तावेज़ स्वीकार कर सकता है, पर उसके हर हिस्से का भरोसेमंद ढंग से उपयोग नहीं कर सकता। किसी LLM को 100 सपोर्ट दस्तावेज़ भेजें क्योंकि उनमें से एक में ग्राहक के सवाल का जवाब है, तो बड़ी कॉन्टेक्स्ट विंडो सभी 100 को समायोजित कर सकती है। लेकिन मॉडल को फिर भी 99 अप्रासंगिक अंशों में से एक प्रासंगिक अंश चुनना होगा, और लंबी विंडो इसकी गारंटी नहीं देती।
इसलिए मॉडल की बताई गई कॉन्टेक्स्ट विंडो और किसी खास वर्कलोड के लिए उसकी प्रभावी कॉन्टेक्स्ट विंडो में अंतर करना उपयोगी है। RULER और LongBench जैसे बेंचमार्क इस अंतर को मापने की कोशिश करते हैं। RULER ने पाया कि साधारण रिट्रीवल टेस्ट में लगभग परफेक्ट स्कोर करने वाले मॉडल भी कॉन्टेक्स्ट की लंबाई और काम की जटिलता बढ़ने पर कमजोर होते गए। LongBench दस्तावेज़ प्रश्नोत्तरी, मल्टी-डॉक्यूमेंट रीजनिंग, समरीकरण, फ्यू-शॉट लर्निंग और कोड कंप्लीशन सहित व्यापक कार्यों का मूल्यांकन करता है।
लंबा कॉन्टेक्स्ट फिर भी वास्तविक मूल्य जोड़ता है। क्षमता और समझ अलग-अलग गुण हैं, और किसी कार्य के लिए मॉडल चुनते समय दोनों मायने रखते हैं।
कॉन्टेक्स्ट सीमाओं का प्रबंधन: डेवलपर्स के लिए सर्वोत्तम तरीके
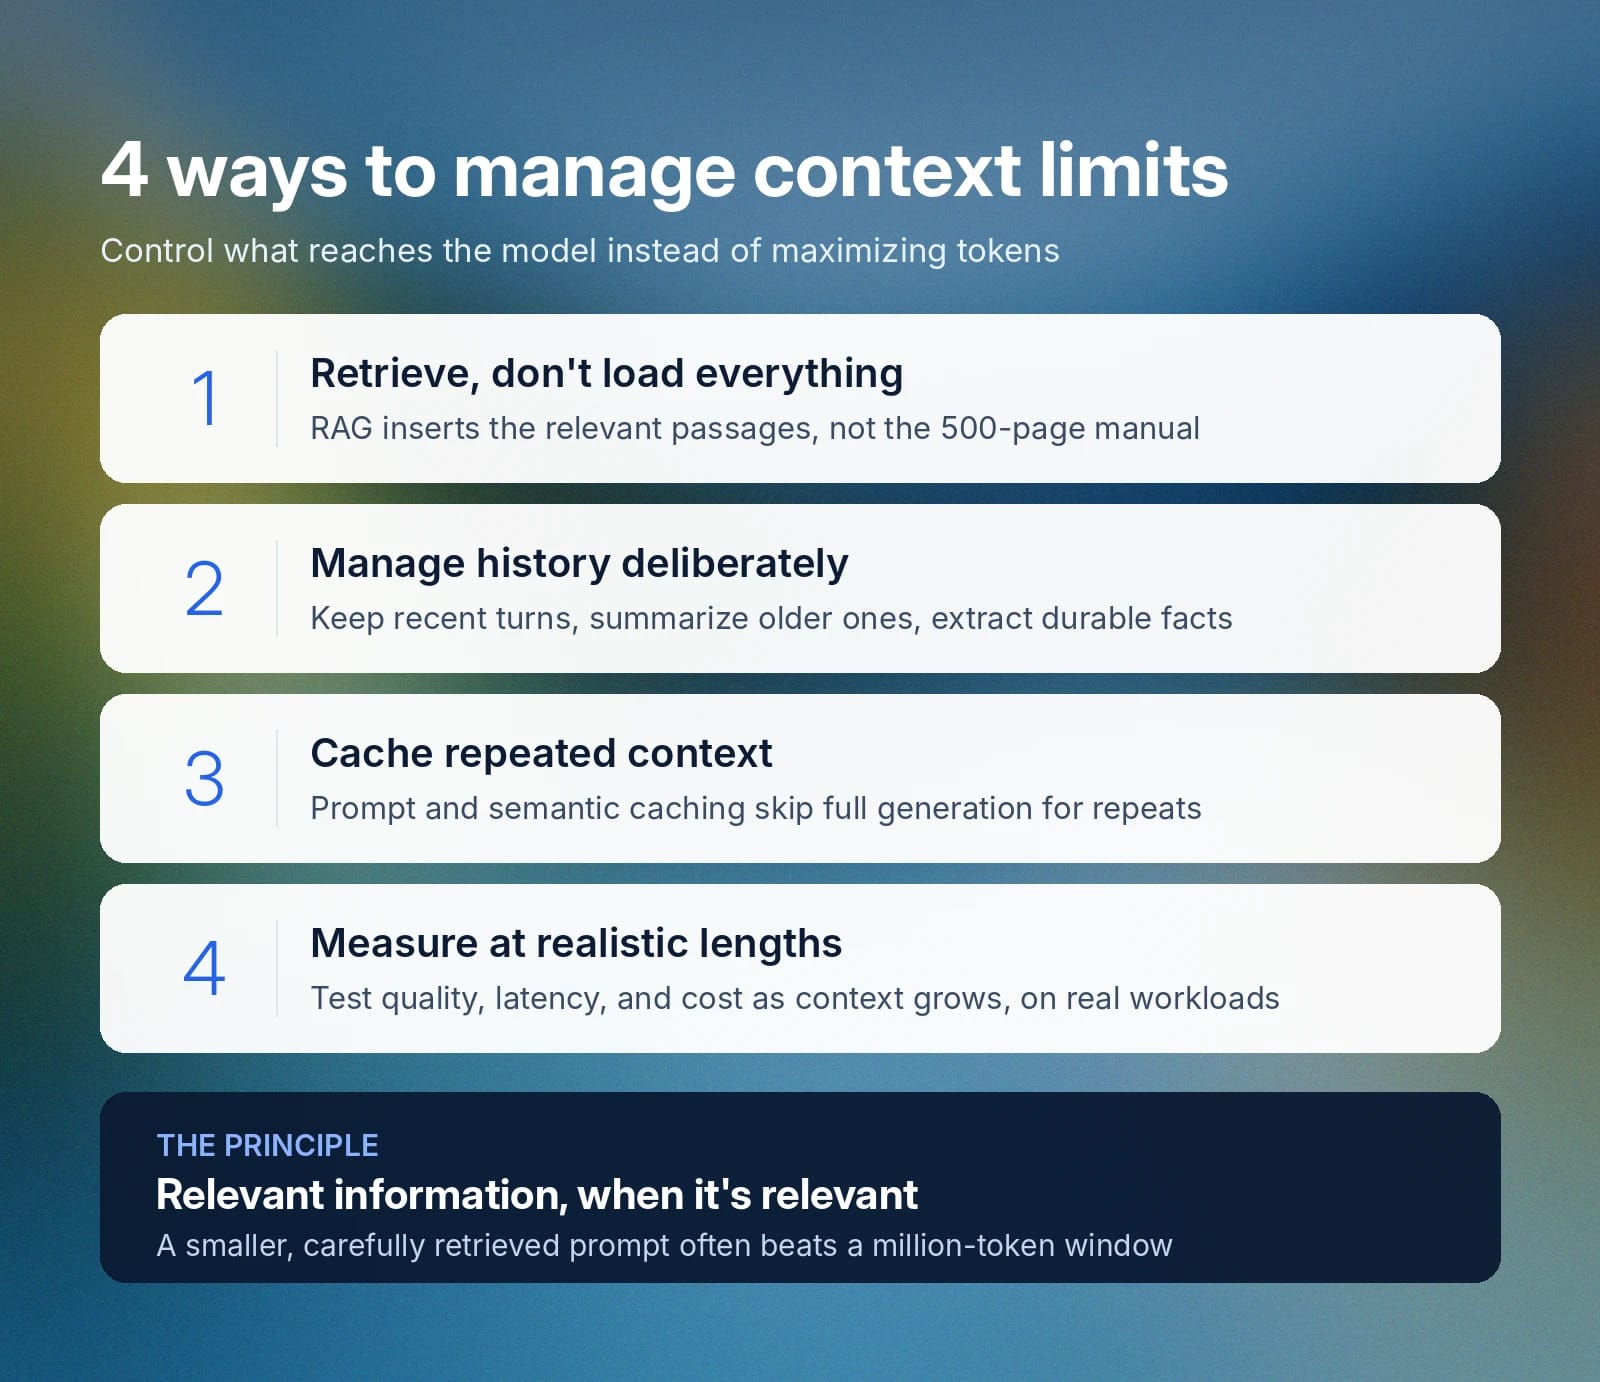
अच्छे कॉन्टेक्स्ट मैनेजमेंट का मतलब है मॉडल तक पहुँचने वाली जानकारी को नियंत्रित करना: हर अनुरोध में टोकन की संख्या बढ़ाने की कोशिश करने के बजाय, काम से जुड़ी जानकारी तब देना जब वह प्रासंगिक हो। ये तरीके डेवलपर्स को गैर-ज़रूरी कॉन्टेक्स्ट घटाने, जवाब की गुणवत्ता सुधारने और लागत व लेटेंसी नियंत्रित करने में मदद कर सकते हैं।
1. सब कुछ लोड करने के बजाय प्रासंगिक जानकारी प्राप्त करें
रिट्रीवल-ऑगमेंटेड जनरेशन, या RAG, एप्लिकेशन को बाहरी नॉलेज बेस में खोजकर सिर्फ प्रासंगिक अंश मॉडल के कॉन्टेक्स्ट में डालने देता है। हर सपोर्ट अनुरोध में 500 पेज का पूरा मैनुअल डालने के बजाय, एप्लिकेशन ग्राहक के असल सवाल के सबसे नज़दीकी कुछ अंश प्राप्त करता है।
इससे टोकन उपयोग घटता है और मॉडल को यह बहुत स्पष्ट संकेत मिलता है कि क्या मायने रखता है। रिट्रीवल की गुणवत्ता फिर भी अहम है: प्रोडक्शन RAG सिस्टम आम तौर पर दस्तावेज़ों को सावधानी से चंक करके, कई संभावित अंश प्राप्त करके, उन्हें फिर से रैंक करके और अंतिम प्रॉम्प्ट बनाने से पहले अप्रासंगिक चीज़ों को फ़िल्टर करके नतीजे बेहतर करते हैं। उदाहरण के लिए, ElevenLabs ने अपनी RAG पाइपलाइन को फिर से बनाया ताकि क्वेरी री-राइटिंग और समानांतर मॉडल कॉल जोड़े जा सकें और मीडियन रिट्रीवल लेटेंसी आधी हो सके।
2. बातचीत के इतिहास को सोच-समझकर मैनेज करें
कन्वर्सेशनल एप्लिकेशन जल्दी कॉन्टेक्स्ट जमा करते हैं। हर पिछले संदेश को अनिश्चितकाल तक जोड़ते रहना टोकन बर्बाद करता है और बाद के टर्न में अप्रासंगिक विवरण ला सकता है।
एप्लिकेशन सबसे नए टर्न रखते हैं, पुराने संवादों का सारांश बनाते हैं, स्थायी तथ्यों को स्ट्रक्चर्ड मेमोरी में निकालते हैं और पुराने विवरणों को तभी प्राप्त करते हैं जब वे फिर से प्रासंगिक हों। इससे शॉर्ट-टर्म बातचीत कॉन्टेक्स्ट, जिसकी मॉडल को तुरंत ज़रूरत है, और लंबे समय की एप्लिकेशन मेमोरी, जिसे बाद में वापस लाया जा सकता है, के बीच उपयोगी अंतर बनता है।
3. कॉन्टेक्स्ट दोहराने पर कैशिंग इस्तेमाल करें
कई एप्लिकेशन बार-बार वही बड़े निर्देश भेजते हैं या ऐसे सवालों के जवाब देते हैं जो पहले संभाले गए सवालों से अर्थ के लिहाज़ से मिलते-जुलते हैं। कैशिंग इस ओवरहेड को घटाती है।
प्रॉम्प्ट या कॉन्टेक्स्ट कैशिंग दोहराए गए इनपुट का अधिक कुशलता से दोबारा उपयोग करने देती है, और सेमांटिक कैशिंग एक कदम आगे जाकर पहचानती है कि कोई नया सवाल सिस्टम द्वारा पहले जवाब दिए गए सवाल के लगभग समान अर्थ रखता है। "आपकी रिटर्न पॉलिसी क्या है?" और "किसी आइटम को वापस करने के लिए मेरे पास कितना समय है?" अलग स्ट्रिंग हैं, जिन्हें सेमांटिक कैश एक ही सवाल मान सकता है। इससे पूरी जनरेशन कॉल की ज़रूरत नहीं पड़ती और लेटेंसी व टोकन लागत, दोनों घटते हैं।
4. वास्तविक कॉन्टेक्स्ट लंबाइयों पर प्रदर्शन मापें
कॉन्टेक्स्ट रणनीति सिर्फ मॉडल प्रदाता की बताई गई टोकन सीमा के आधार पर न चुनें। प्रोडक्शन के प्रतिनिधि वर्कलोड टेस्ट करें और कॉन्टेक्स्ट लंबाई बढ़ने पर जवाब की गुणवत्ता, रिट्रीवल सटीकता, लेटेंसी, टोकन उपयोग, लागत और विफलता दर मापें।
ज़्यादा कॉन्टेक्स्ट देने, कम अंश प्राप्त करने, बातचीत का इतिहास सारांशित करने या रिट्रीवल को समरीकरण के साथ मिलाने जैसी रणनीतियों की तुलना करें। एक मिलियन टोकन वाली कॉन्टेक्स्ट विंडो का मॉडल तकनीकी रूप से आपके एप्लिकेशन को सपोर्ट कर सकता है, जबकि छोटा और सावधानी से प्राप्त किया गया प्रॉम्प्ट कम लागत पर तेज़ और अधिक सटीक नतीजे दे सकता है।
स्केलेबल भाषा समाधानों के लिए ElevenAgents के साथ शुरू करें
कॉन्टेक्स्ट मैनेजमेंट कन्वर्सेशनल एजेंटों में सबसे अहम है, क्योंकि उन्हें मौजूदा कथन को पिछले टर्न, व्यावसायिक निर्देशों, ग्राहक जानकारी, नॉलेज बेस सामग्री और टूल नतीजों के साथ मिलाना होता है, साथ ही इतनी तेज़ी से जवाब देना होता है कि बातचीत स्वाभाविक लगे।
ElevenAgents इन हिस्सों को AI वॉइस एजेंट बनाने और डिप्लॉय करने के लिए एक प्लेटफ़ॉर्म पर लाता है। इसका ऑर्केस्ट्रेशन इंजन स्पीच रिकग्निशन, एक LLM और टेक्स्ट टू स्पीच को समन्वित करता है, जबकि डेवलपर प्रॉम्प्ट, नॉलेज बेस, टूल, वर्कफ़्लो और आधारभूत भाषा मॉडल कॉन्फ़िगर करते हैं। अभिव्यक्तिपूर्ण डिलीवरी, जिसमें कोई एजेंट आवाज़ में भावनात्मक कॉन्टेक्स्ट व्यक्त करता है, उसी कॉन्टेक्स्ट पर निर्भर करती है जो सबसे पहले एजेंट के कहने की बात तय करता है।
खास तौर पर नॉलेज मैनेजमेंट के लिए, ElevenAgents फुल-कॉन्टेक्स्ट दस्तावेज़ों और RAG को सपोर्ट करता है, जिसे सीधे प्लेटफ़ॉर्म पर कॉन्फ़िगर किया जा सकता है। छोटे दस्तावेज़ सीधे एजेंट के प्रॉम्प्ट में जाते हैं, इसलिए उनकी सामग्री बातचीत के दौरान उपलब्ध रहती है। बड़े नॉलेज बेस को इसके बजाय इंडेक्स किया जाता है, जहाँ RAG हर क्वेरी के लिए प्रासंगिक अंश प्राप्त करता है, बजाय सब कुछ एक साथ कॉन्टेक्स्ट विंडो में लोड करने के।
आज ही ElevenAgents के लिए साइन अप करके शुरू करें या हमारी टीम से बात करें और अपने डिप्लॉयमेंट विकल्पों के बारे में जानें।
कॉन्टेक्स्ट विंडो FAQ

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।

