
RAG क्या है? Retrieval-Augmented Generation कैसे काम करता है
- लेखक
- Jack Limebear
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
AI मॉडल अपने प्रशिक्षण के दौरान सीखी जानकारी के आधार पर जवाब देते हैं। इसका मतलब है कि उन्हें किसी कंपनी की नीतियों, प्रोडक्ट्स या प्रशिक्षण के बाद बनाई गई दूसरी जानकारी का अपने-आप पता नहीं होता। RAG (रिट्रीवल-ऑगमेंटेड जेनरेशन) जवाब देने से पहले प्रासंगिक बाहरी जानकारी खोजकर मॉडल को देता है, जिससे यह समस्या हल होती है।
RAG, AI के जवाबों को किसी व्यवसाय के वास्तविक दस्तावेज़ों पर आधारित बनाता है। एक ग्राहक सहायता एजेंट RAG का इस्तेमाल करके जवाब देने से पहले मौजूदा रिटर्न पॉलिसी या प्रोडक्ट स्पेसिफिकेशन देख सकता है, जिससे हैलुसिनेशन का जोखिम कम होता है।
इस गाइड में बताया गया है कि AI में RAG का क्या मतलब है, रिट्रीवल और जेनरेशन साथ मिलकर कैसे काम करते हैं, और RAG अकेले LLM से कैसे अलग है। हम RAG की सीमाओं, जनरेटिव AI एप्लिकेशन में इसके प्रभावी इस्तेमाल और AI एजेंट्स में RAG के ज़रिए नॉलेज रिट्रीवल को भी कवर करेंगे।
सारांश
- RAG, रिट्रीवल सिस्टम को जनरेटिव मॉडल के साथ जोड़ता है, ताकि मॉडल अपने प्रशिक्षण डेटा से बाहर की जानकारी भी इस्तेमाल कर सके।
- RAG जिस नॉलेज को रिट्रीव करता है, वह मॉडल के बाहर रहती है, इसलिए उसे बिना दोबारा प्रशिक्षण दिए अपडेट किया जा सकता है।
- जब नॉलेज बेस इतना बड़ा हो कि सीधे मॉडल के कॉन्टेक्स्ट में न समा सके, तो ElevenAgents अपने-आप RAG इस्तेमाल करता है। इससे बड़े और जटिल नॉलेज बेस पर सटीकता से समझौता किए बिना जवाब तेज़ रहते हैं।
AI में RAG क्या है?
RAG एक सिस्टम आर्किटेक्चर है, जो LLM को ब्रांड गाइडलाइंस, प्रोडक्ट मैनुअल, नॉलेज बेस लेखों या आंतरिक डेटाबेस जैसी बाहरी जानकारी देने के लिए बनाया गया है। इससे AI व्यवसाय-विशिष्ट जानकारी के साथ काम कर पाता है, इसलिए उसके जवाब मौजूदा नीतियों, निजी जानकारी और कंपनी के उन विवरणों को दिखा सकते हैं जिन पर मॉडल को कभी प्रशिक्षित नहीं किया गया था।
एक LLM एक समय में सीमित मात्रा में ही जानकारी पर विचार कर सकता है, जिसे उसकी कॉन्टेक्स्ट विंडो कहा जाता है। एक बड़ा संगठनात्मक नॉलेज बेस जल्दी ही उस सीमा से बड़ा हो सकता है। इसलिए RAG जानकारी को LLM के बाहर रखता है और मौजूदा सवाल के लिए ज़रूरी अंश ही रिट्रीव करता है।
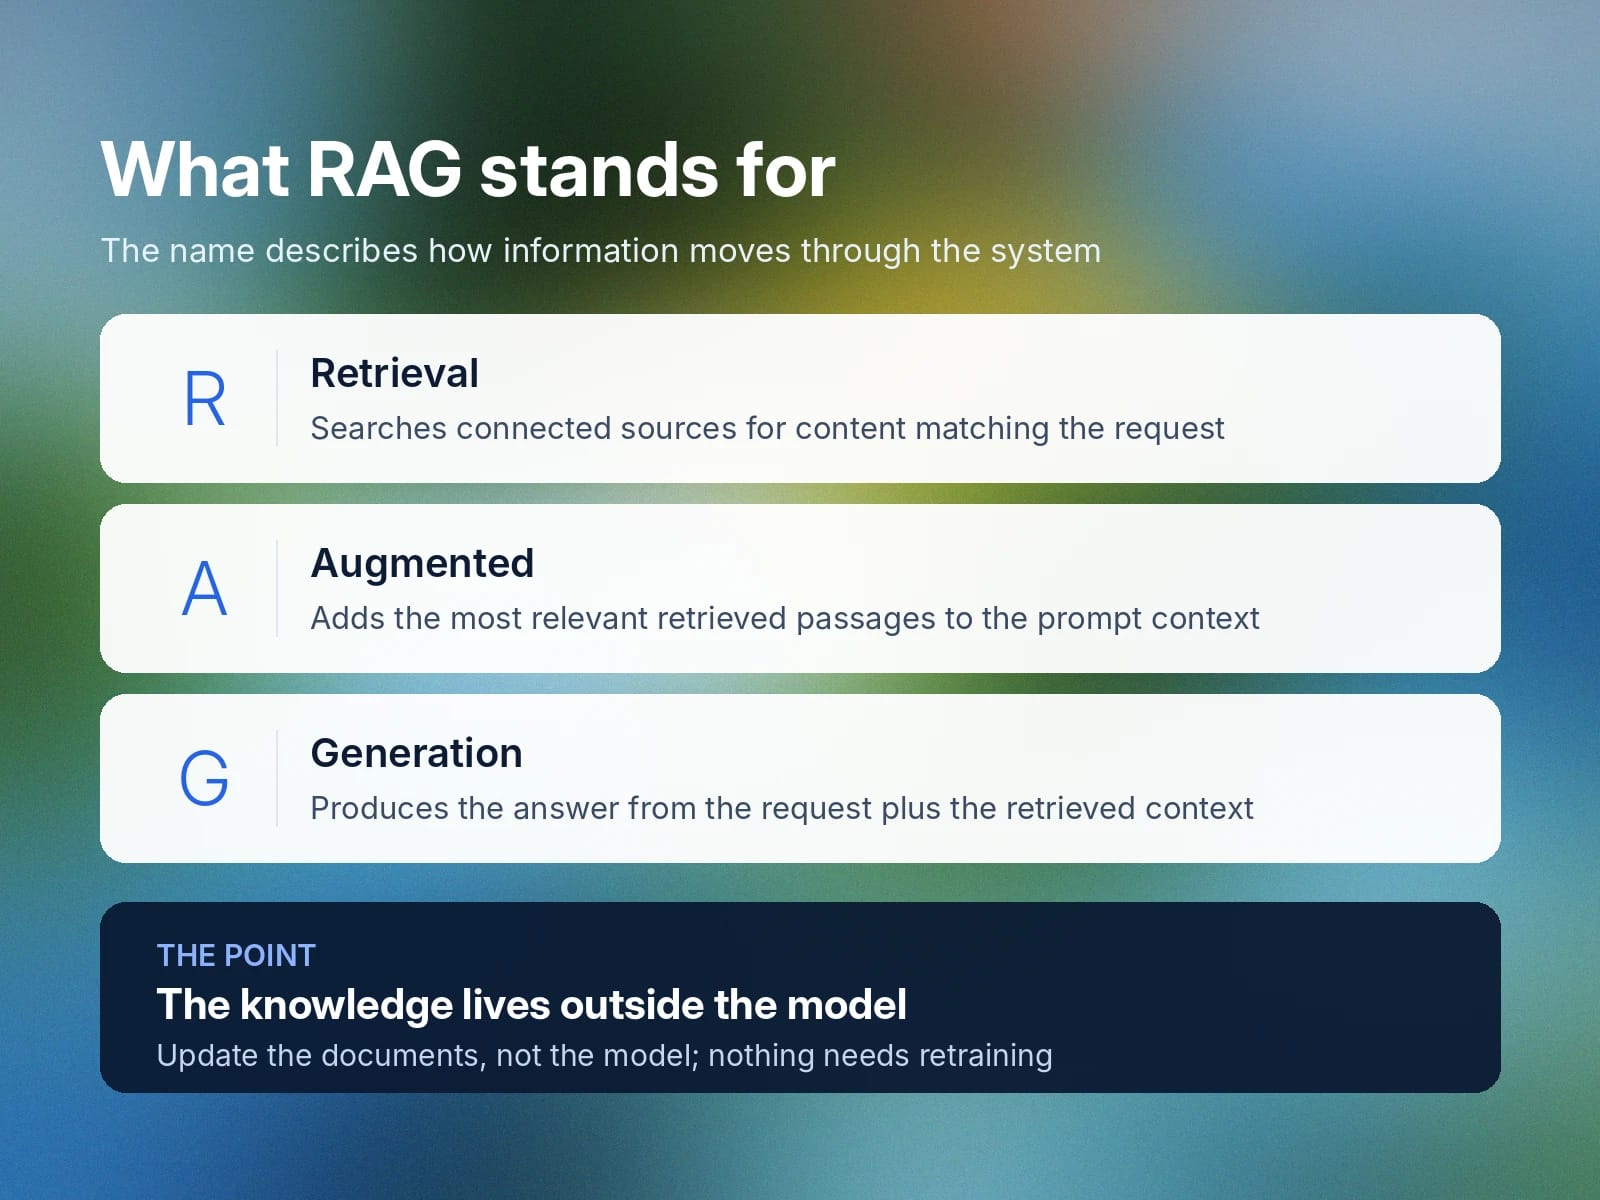
इस नाम से पता चलता है कि जानकारी सिस्टम में कैसे आगे बढ़ती है:
- रिट्रीवल: यूज़र के अनुरोध से मेल खाने वाली सामग्री के लिए जुड़े स्रोतों, जैसे पॉलिसी दस्तावेज़, हेल्प डेस्क लॉग या इन्वेंट्री फ़ाइलों, में खोज करता है।
- ऑगमेंटेड: सबसे प्रासंगिक रिट्रीव किए गए अंशों को प्रॉम्प्ट कॉन्टेक्स्ट में जोड़ता है।
- जेनरेशन: जवाब तैयार करने के लिए यूज़र के अनुरोध और रिट्रीव किए गए कॉन्टेक्स्ट का इस्तेमाल करता है।
RAG, जवाब बनाते समय LLM को इस्तेमाल के लिए प्रासंगिक सामग्री देकर ग्राउंडिंग को भी सपोर्ट करता है। ग्राउंडिंग का मतलब है AI के जवाब को किसी खास स्रोत जानकारी से जोड़ना। उदाहरण के लिए, अगर कोई ग्राहक वारंटी पॉलिसी के बारे में पूछता है, तो RAG सिस्टम कंपनी के दस्तावेज़ों से संबंधित शर्तें रिट्रीव करता है और जवाब देने के लिए उन्हें LLM को देता है।
रिट्रीवल-ऑगमेंटेड जेनरेशन कैसे काम करता है?
RAG सिस्टम बाहरी नॉलेज को खोज के लिए तैयार करता है, यूज़र के सवाल से सबसे प्रासंगिक जानकारी रिट्रीव करता है और जवाब जनरेट करने से पहले उस जानकारी को कॉन्टेक्स्ट के रूप में LLM को देता है।
RAG इम्प्लीमेंटेशन की जटिलता अलग-अलग होती है। बुनियादी RAG में सीधी रिट्रीव-एंड-जनरेट प्रक्रिया होती है, जबकि उन्नत तरीकों में क्वेरी री-राइटिंग, फ़िल्टरिंग, री-रैंकिंग या दूसरी रिट्रीवल तकनीकें जोड़ी जा सकती हैं।
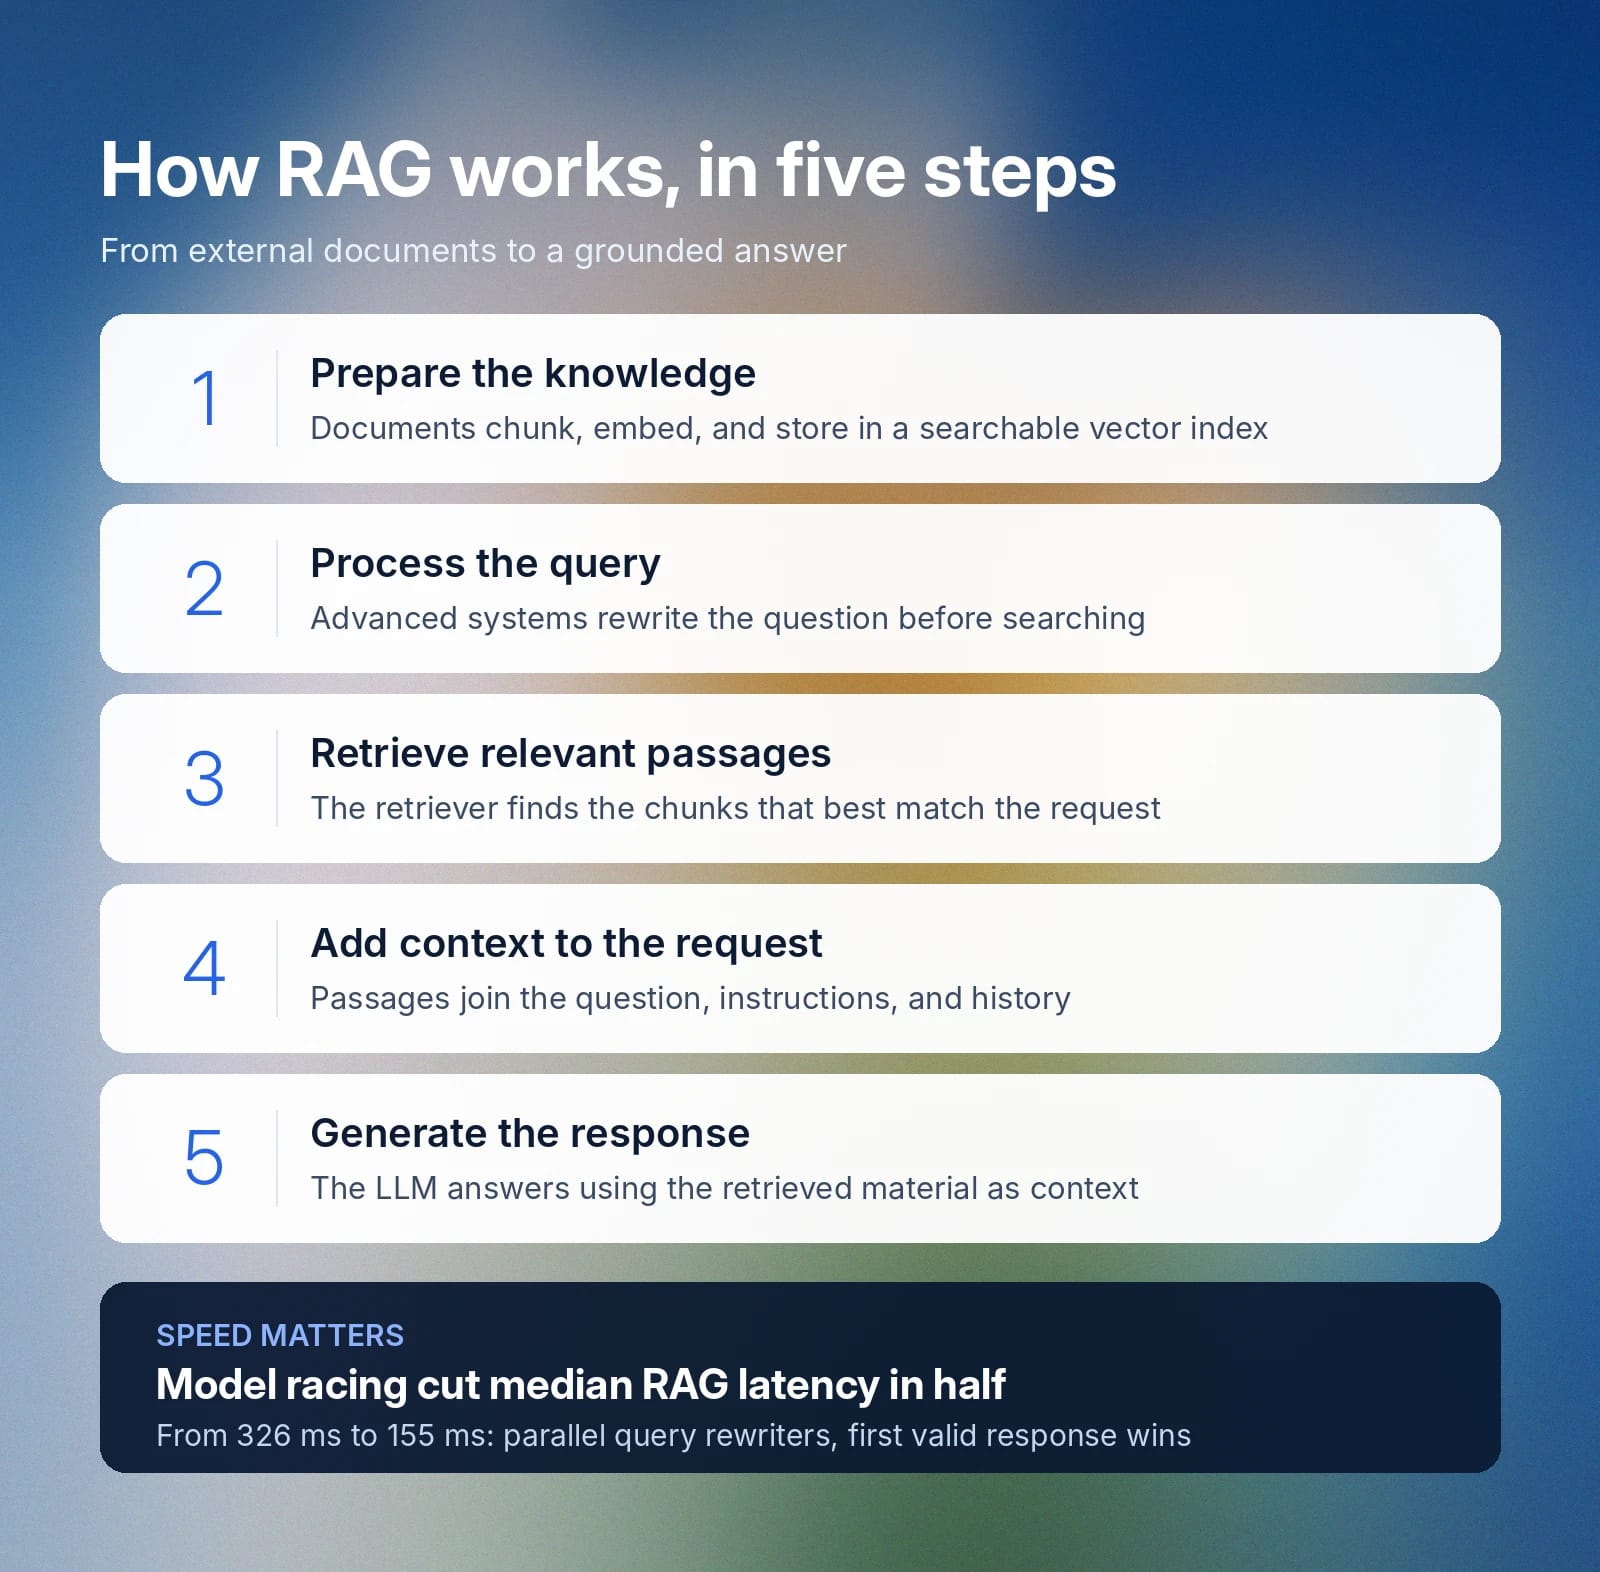
RAG प्रक्रिया आमतौर पर पाँच चरणों में होती है:
- नॉलेज तैयार करें: दस्तावेज़ों को छोटे अंशों में बाँटा जाता है (इसे “चंकिंग” कहते हैं), एम्बेडिंग्स नाम के गणितीय रूपों में बदला जाता है और खोजे जा सकने वाले इंडेक्स या वेक्टर डेटाबेस में स्टोर किया जाता है।
- क्वेरी प्रोसेस करें: सिस्टम यूज़र के सवाल को समझता है और अधिक उन्नत RAG सिस्टम में खोज से पहले उसे फिर से लिखता या बेहतर बनाता है।
- प्रासंगिक अंश रिट्रीव करें: रिट्रीवर, अनुरोध से सबसे अच्छी तरह मेल खाने वाले टेक्स्ट चंक्स के लिए इंडेक्स किए गए नॉलेज बेस में खोज करता है।
- मॉडल के अनुरोध में कॉन्टेक्स्ट जोड़ें: चुने गए अंश यूज़र के सवाल, प्रासंगिक निर्देशों और बातचीत के इतिहास के साथ LLM को भेजे जाते हैं।
- जवाब जनरेट करें: LLM रिट्रीव की गई सामग्री को अपने कॉन्टेक्स्ट के हिस्से के रूप में इस्तेमाल करके जवाब तैयार करता है।
कई RAG सिस्टम बाहरी टूल के रूप में चुनिंदा तौर पर रिट्रीवल ट्रिगर करते हैं। ElevenAgents टीम्स को एजेंट सेटिंग्स में सीधे किसी नॉलेज बेस के लिए RAG सक्षम करने देता है। बातचीत के फॉलो-अप में सिस्टम पिछले संवाद और अस्पष्ट संदर्भों को सटीक, स्वतंत्र सर्च क्वेरी में बदलने के लिए क्वेरी री-राइटिंग का इस्तेमाल करता है।
समय पर जवाब सुनिश्चित करने के लिए ElevenLabs ने एक मॉडल रेसिंग आर्किटेक्चर भी विकसित किया है, जो हर क्वेरी को समानांतर रूप से कई री-राइटिंग मॉडल्स के पास भेजता है और पहला वैध जवाब इस्तेमाल करता है। इस तरीके ने औसत RAG लेटेंसी को आधा कर दिया, 326 ms से 155 ms तक। इससे रिट्रीवल इतना तेज़ रहता है कि बड़ा नॉलेज बेस ट्रिगर होने पर भी बातचीत का स्वाभाविक प्रवाह बना रहता है।
LLM और RAG मॉडल्स में क्या अंतर है?
LLM ऐसा मॉडल है जो भाषा को समझता और जनरेट करता है। RAG, LLM के आसपास की एक आर्किटेक्चर है, जो एप्लिकेशन को ज़रूरत होने पर बाहरी जानकारी रिट्रीव करती है।
LLM को RAG के साथ जोड़ने पर ये बदलाव होते हैं:
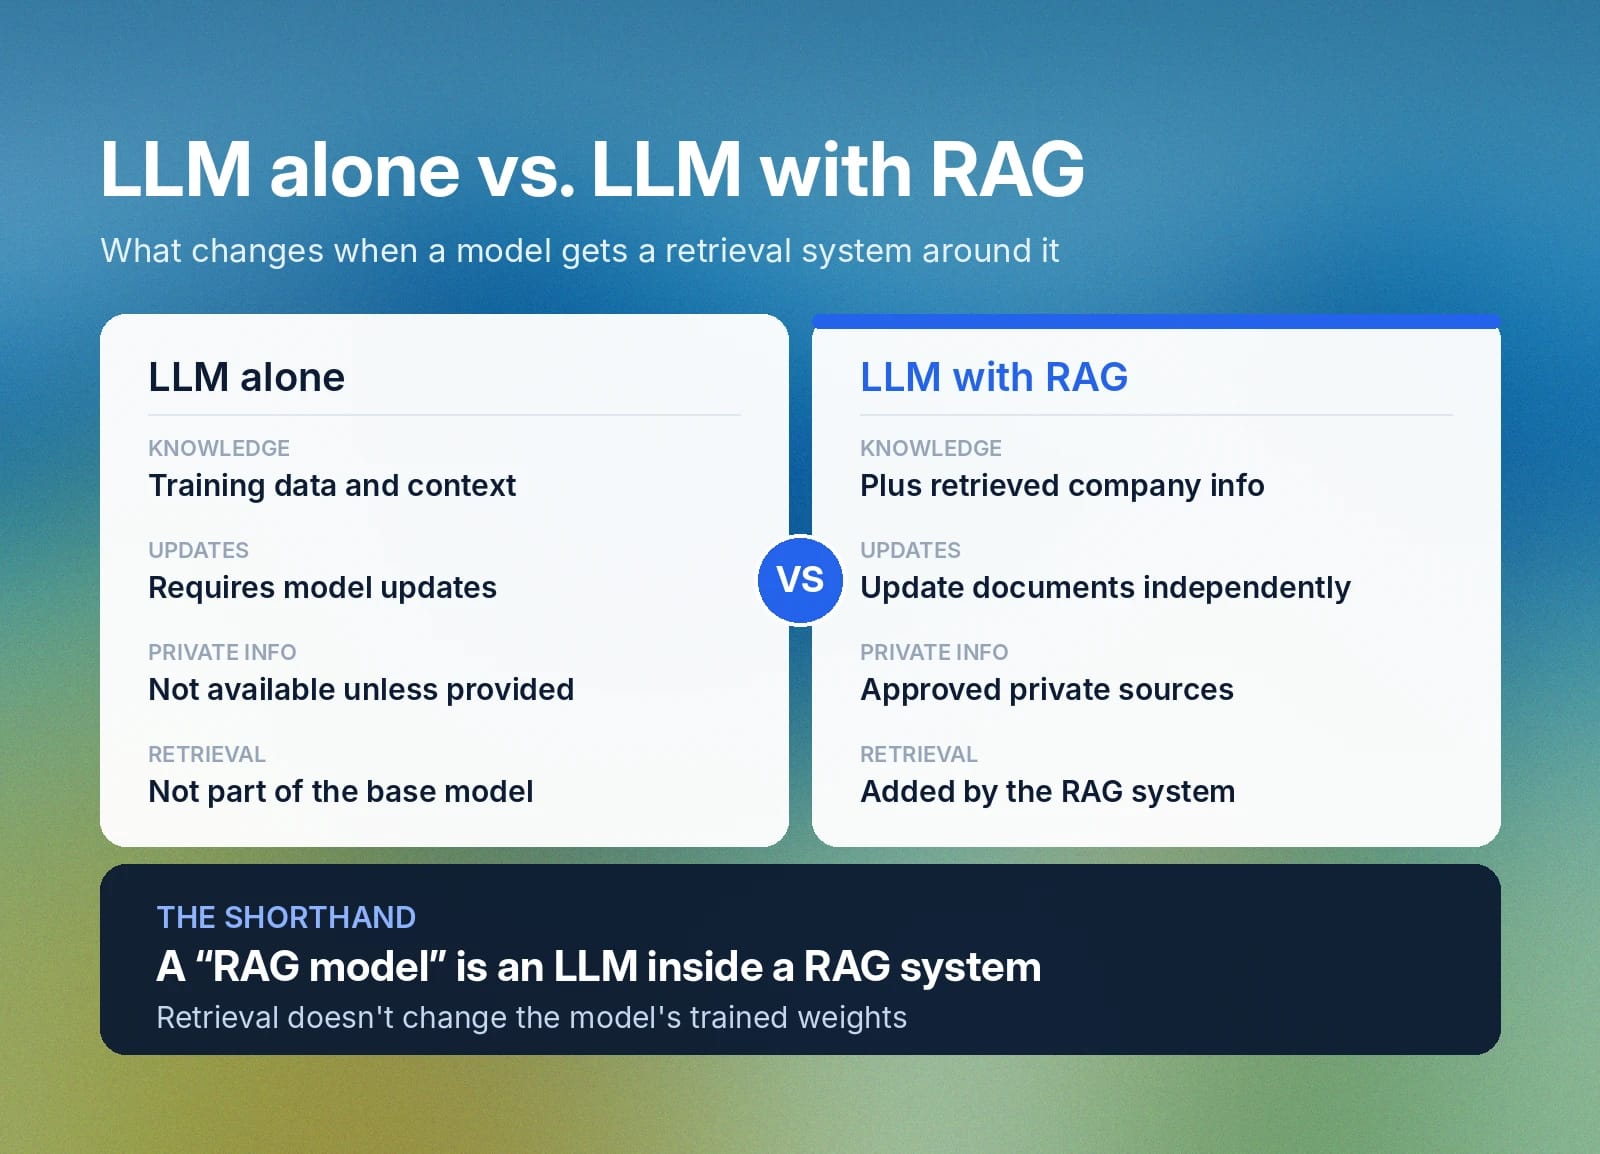
विशेषता | केवल LLM | RAG के साथ इस्तेमाल किया गया LLM |
नॉलेज | प्रशिक्षण डेटा और मौजूदा कॉन्टेक्स्ट | प्रशिक्षण डेटा, मौजूदा कॉन्टेक्स्ट और रिट्रीव की गई कंपनी जानकारी, जैसे नीतियाँ, प्रोडक्ट दस्तावेज़ या नॉलेज बेस सामग्री |
अपडेट | नई जानकारी कॉन्टेक्स्ट में या मॉडल अपडेट के ज़रिए देनी होगी | बाहरी नॉलेज को मॉडल से अलग अपडेट किया जा सकता है |
निजी जानकारी | दिए बिना उपलब्ध नहीं | स्वीकृत निजी स्रोतों से रिट्रीव कर सकता है |
रिट्रीवल | बेस मॉडल का हिस्सा नहीं | आसपास के RAG सिस्टम द्वारा जोड़ा जाता है |
“RAG मॉडल” का इस्तेमाल कभी-कभी RAG सिस्टम में इस्तेमाल होने वाले LLM के संक्षिप्त नाम के रूप में किया जाता है। उदाहरण के लिए, कोई कंपनी कह सकती है कि वह ग्राहक सहायता के लिए “RAG मॉडल” इस्तेमाल करती है, जबकि असल सेटअप में जवाब जनरेट करने से पहले प्रासंगिक सहायता केंद्र या पॉलिसी सामग्री रिट्रीव करने वाला LLM होता है।
वास्तविक एप्लिकेशन में RAG मॉडल्स की सीमाएँ
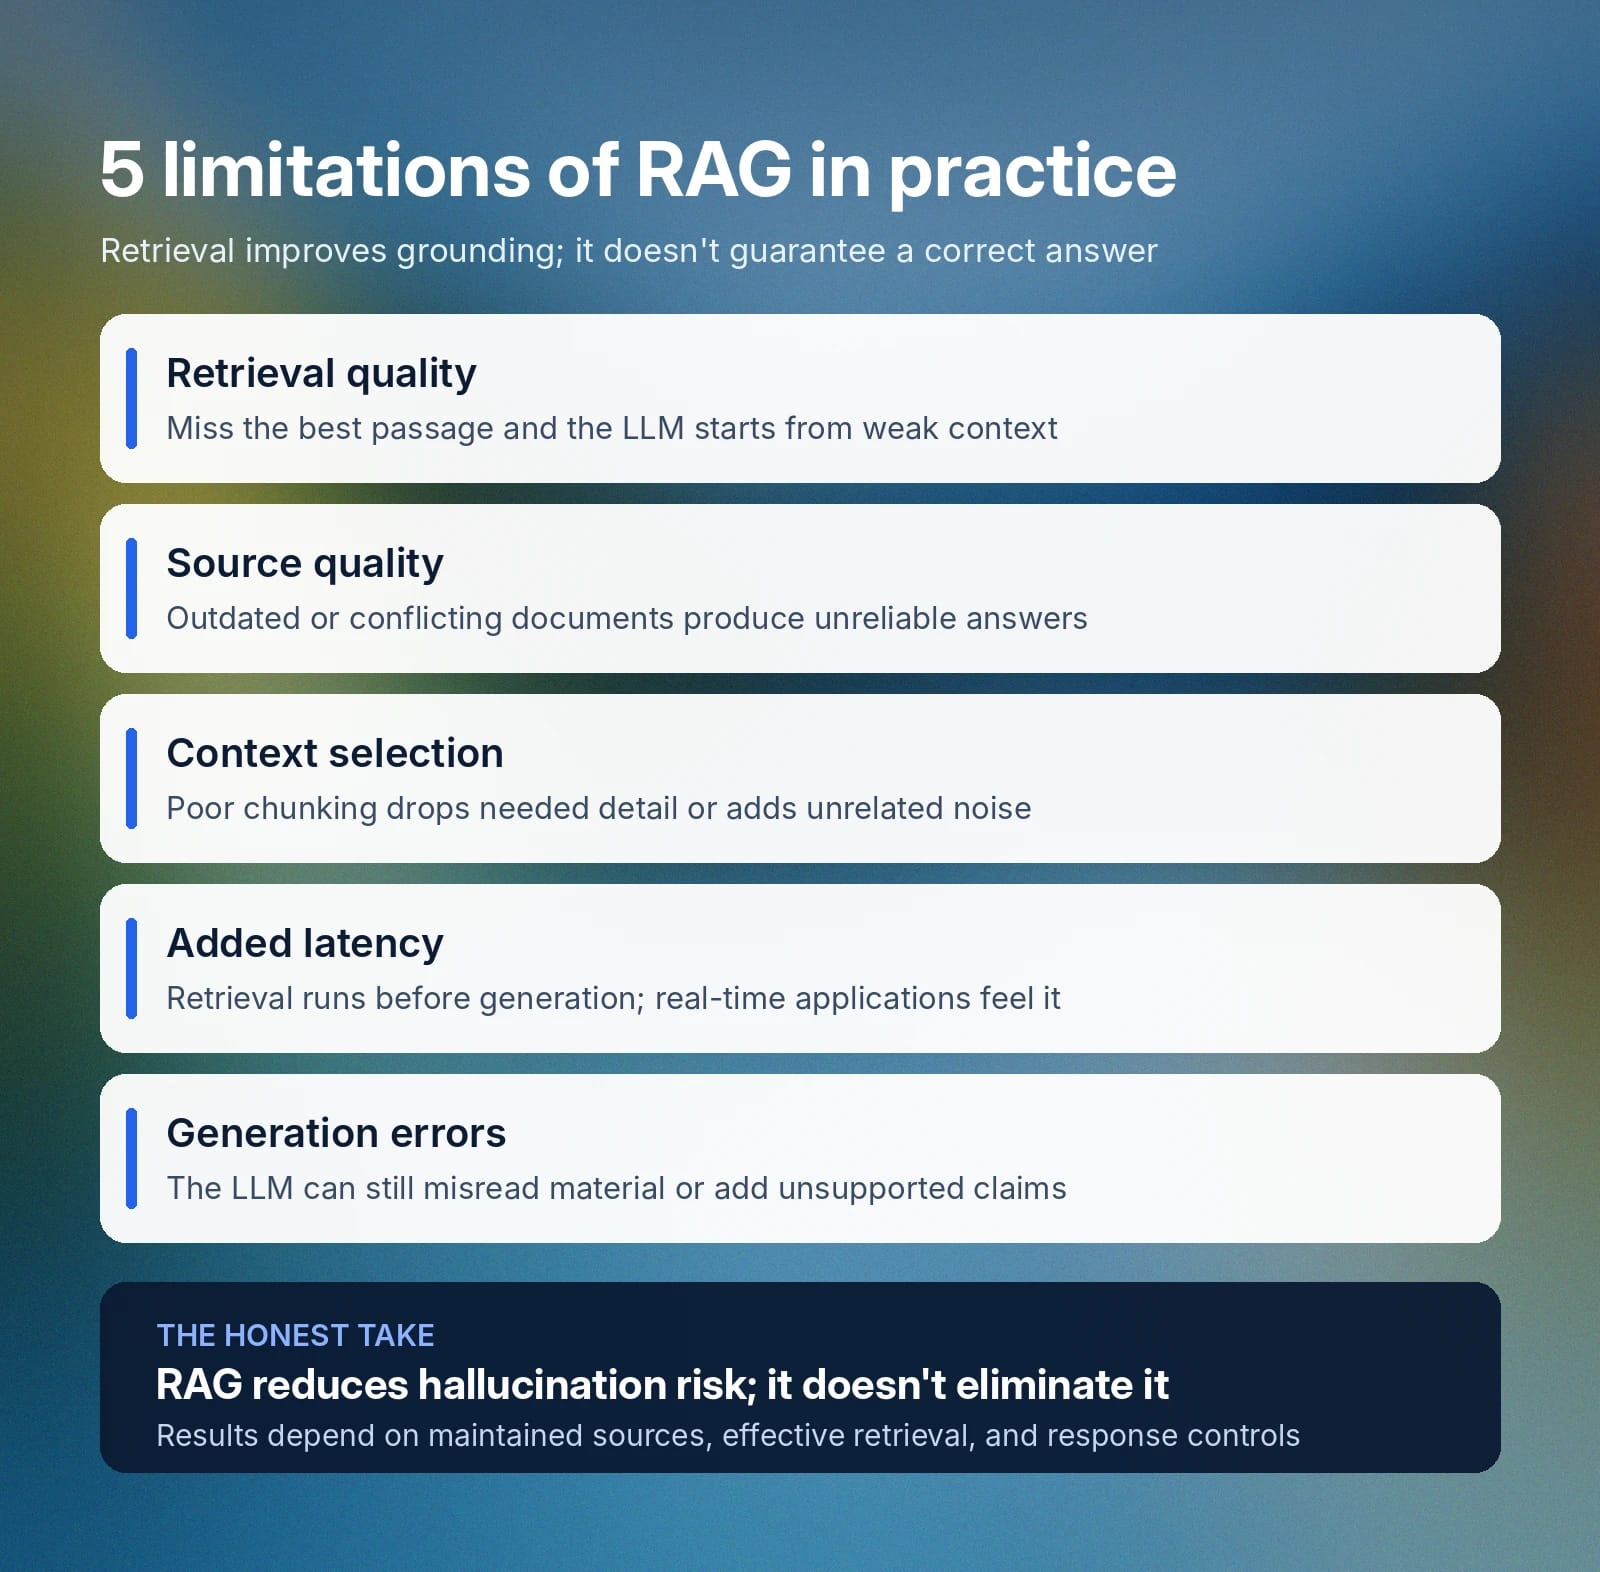
RAG, LLM के बाहर स्टोर की गई प्रासंगिक व्यावसायिक जानकारी तक पहुँच बेहतर बनाता है, लेकिन रिट्रीवल की अपनी सीमाएँ हैं और यह सही जवाब की गारंटी नहीं देता। मुख्य सीमाएँ सिस्टम द्वारा रिट्रीव की गई जानकारी, मॉडल को भेजी गई जानकारी और मॉडल के जवाब में दिखती हैं:
- रिट्रीवल की गुणवत्ता: अगर सिस्टम सबसे प्रासंगिक अंश को छोड़ देता है, तो LLM अधूरे या कमज़ोर कॉन्टेक्स्ट से शुरू करता है। खराब ढंग से लिखी गई क्वेरी, कमज़ोर सेमेंटिक मैच या अस्पष्ट शब्दावली रिट्रीवल को गलत दिशा में ले जा सकती है।
- स्रोत की गुणवत्ता: पुराने, विरोधाभासी या अधूरे दस्तावेज़ अविश्वसनीय जवाब दे सकते हैं।
- कॉन्टेक्स्ट चयन: खराब चंकिंग या रिट्रीवल विकल्प ज़रूरी विवरण हटा सकते हैं या असंबंधित जानकारी जोड़ सकते हैं।
- अतिरिक्त लेटेंसी: जेनरेशन से पहले रिट्रीवल और क्वेरी प्रोसेसिंग होती है, जिससे रियल-टाइम एप्लिकेशन में जवाब धीमे हो सकते हैं।
- जेनरेशन त्रुटियाँ: LLM रिट्रीव की गई जानकारी को फिर भी गलत समझ सकता है या बिना आधार वाले दावे जोड़ सकता है।
RAG हैलुसिनेशन का जोखिम कम कर सकता है, लेकिन इसे पूरी तरह खत्म नहीं करता। सटीक नतीजे अब भी अच्छी तरह बनाए रखे गए स्रोतों, प्रभावी रिट्रीवल और अंतिम जवाब पर नियंत्रण पर निर्भर करते हैं।
जनरेटिव AI में RAG: व्यावहारिक उपयोग और फायदे
RAG तब सबसे उपयोगी होता है, जब किसी AI एप्लिकेशन को ऐसी जानकारी चाहिए जो बार-बार बदलती है, संगठन की है या इतनी बड़ी है कि हर मॉडल अनुरोध में शामिल नहीं की जा सकती।
यहाँ RAG सबसे ज़्यादा फर्क पैदा करता है:
बार-बार अपडेट होने वाली जानकारी के साथ बने रहना
RAG टीम्स को AI के जवाबों को मौजूदा प्रोडक्ट विवरण, कीमतों, नीतियों और इन्वेंट्री के अनुरूप रखने में मदद करता है। टीम्स स्रोत जानकारी को अलग से अपडेट कर सकती हैं और सवाल पूछे जाने पर RAG उसका प्रासंगिक संस्करण रिट्रीव करता है। उदाहरण के लिए, एक लीड क्वालिफिकेशन एजेंट इनबाउंड कॉलर को क्वालिफाई करते समय नवीनतम कीमतों या प्लान की जानकारी रिट्रीव कर सकता है।
निजी या विशेष नॉलेज का इस्तेमाल
कुछ नॉलेज सार्वजनिक होने के बजाय निजी या विशेष होती है, जैसे आंतरिक नीतियाँ, तकनीकी दस्तावेज़ या किसी खास टीम के लिए बनी सहायता सामग्री। RAG, केवल सार्वजनिक रूप से उपलब्ध या मॉडल में शामिल जानकारी पर निर्भर रहने के बजाय, एजेंट को इन स्रोतों से सीधे रिट्रीव करने देता है।
उदाहरण के लिए, एक आंतरिक IT या HR हेल्पडेस्क एजेंट कर्मचारी लाभों से जुड़े सवालों के जवाब देने के लिए HR-विशिष्ट नॉलेज बेस से रिट्रीव कर सकता है, बजाय ऐसे सार्वजनिक दस्तावेज़ खोजने के जिनमें यह जानकारी नहीं होगी।
बड़े नॉलेज बेस में खोज
RAG तब मदद करता है जब किसी कंपनी के पास LLM द्वारा एक अनुरोध में विचार की जा सकने वाली जानकारी से कहीं अधिक दस्तावेज़ हों। यह पूरा संग्रह मॉडल को भेजने के बजाय, सिर्फ मौजूदा सवाल से प्रासंगिक अंश रिट्रीव करता है। सेल्स के मामले में, तकनीकी असिस्टेंट कॉल के दौरान प्रासंगिक आवश्यकताएँ खोजने के लिए प्रोडक्ट मैनुअल में खोज कर सकता है।
उन्नत RAG समाधानों के लिए ElevenAgents के साथ शुरुआत करें
ElevenAgents टीम्स को कनेक्टेड नॉलेज स्रोतों के साथ RAG इस्तेमाल करने वाले AI वॉइस और चैट एजेंट बनाने का तरीका देता है—चाहे नो-कोड वेब प्लेटफ़ॉर्म से या उन टीम्स के लिए API से जो एजेंट्स को सीधे अपने प्रोडक्ट्स में एम्बेड करना चाहती हैं।
RAG-सक्षम एजेंट्स के लिए टीम्स नॉलेज बेस में दस्तावेज़, URLs या टेक्स्ट जोड़ सकती हैं और हर क्वेरी के लिए सिर्फ प्रासंगिक जानकारी रिट्रीव कर सकती हैं।
ElevenLabs ने रियल-टाइम बातचीत के लिए रिट्रीवल को भी ऑप्टिमाइज़ किया है और अपने ElevenAgents आर्किटेक्चर में औसत RAG लेटेंसी को 326 ms से घटाकर 155 ms कर दिया है। ElevenAgents के साथ बनाने वाली टीम्स को ये रिट्रीवल क्षमताएँ तुरंत मिलती हैं, चाहे वे डैशबोर्ड से एजेंट कॉन्फ़िगर करें या API के ज़रिए उस पर निर्माण करें।
बनाना शुरू करें ElevenAgents के साथ या हमारी टीम से संपर्क करें और अपने एप्लिकेशन के लिए सही सेटअप पर चर्चा करें।


