
Résumé du webinaire : Donnez une voix humaine à votre chatbot textuel
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Les agents conversationnels font désormais partie intégrante des logiciels d’entreprise. La plupart des entreprises en ont un ou en développent un. Elles sont moins nombreuses à avoir anticipé ce qui se passe lorsqu’un utilisateur préfère simplement parler.
La voix transforme l’interaction bien au-delà du simple confort. Les utilisateurs expriment leur frustration, leur urgence et leur confusion par leur ton, des signaux que le texte efface entièrement. Un client qui écrit « ma commande n’est pas arrivée » et un client qui le dit avec une anxiété perceptible n’envoient pas les mêmes signaux, et l’agent qui ne peut lire que la transcription ne dispose que de la moitié des informations.
La question que se posent aujourd’hui la plupart des équipes n’est pas de savoir s’il faut ajouter la voix, mais comment le faire sans reconstruire tout ce qui fonctionne déjà.
Lors de l’atelier en direct : donnez à votre chatbot textuel une voix humaine, Paul Asjes (Developer Experience), Bhargavi Bhatt (Customer Experience) et Fergal Burnett (Product Marketing, ElevenAPI) ont présenté les réalités techniques de l’ajout de la voix à un agent existant, ainsi que le fonctionnement concret d’une intégration opérationnelle.
Pourquoi développer avec la voix est plus complexe qu’il n’y paraît
L’un des principaux défis est la gestion des tours de parole. Les humains savent quand quelqu’un a fini de parler grâce à l’intonation, au rythme et au contexte. Or, la détection d’activité vocale (l’approche standard) ne détecte que le silence.
Le résultat est souvent un système qui considère chaque pause comme une invitation à parler : il interrompt, coupe la parole en pleine phrase et traite les hésitations naturelles comme des phrases terminées.
Il fonctionne techniquement, mais échoue sur le plan conversationnel.
Le contexte constitue l’autre moitié du problème. Transmettre l’historique de la conversation à un LLM à chaque tour est nécessaire, mais insuffisant. Les mêmes mots prennent un sens différent selon la façon dont ils sont prononcés : « ça va » dit avec soulagement et « ça va » dit avec frustration produisent la même transcription, mais pas la même interaction. Un système vocal qui ignore cette dimension paraîtra toujours légèrement décalé, quelle que soit la qualité de ses modèles.
Il y a aussi la charge d’ingénierie. Les équipes qui gèrent leur propre orchestration vocale doivent continuellement maintenir la logique de prise de parole, la gestion des interruptions et l’analyse de la latence. Ce n’est pas une implémentation ponctuelle.
Comment ajouter la voix à un agent existant
L’approche la plus simple repose sur une architecture à deux WebSocket.
- Une connexion est établie entre le client et l’API ElevenLabs, et une autre entre votre serveur et l’API ElevenLabs
- L’utilisateur parle dans son microphone, l’audio est envoyé à l’API ElevenLabs, où il est transcrit puis transmis à votre serveur
- Votre serveur transmet au LLM l’intégralité de l’historique de conversation reçu de l’API ElevenLabs, puis la réponse diffusée en continu est renvoyée pour la synthèse audio
- Cela peut commencer avant que le LLM ait fini de générer, ce qui maintient une faible latence jusqu’au premier octet
Le principal point d’intégration est la méthode onTranscript , qui se déclenche à la fin de chaque tour et transmet l’historique complet de la conversation au LLM.
Une contextualUpdate au début de la session reprend tout ce qui s’est passé dans la partie textuelle de la conversation avant que l’utilisateur ne passe à la voix. C’est ce qui permet à un même agent de fonctionner dans les deux modalités sans perdre le contexte.
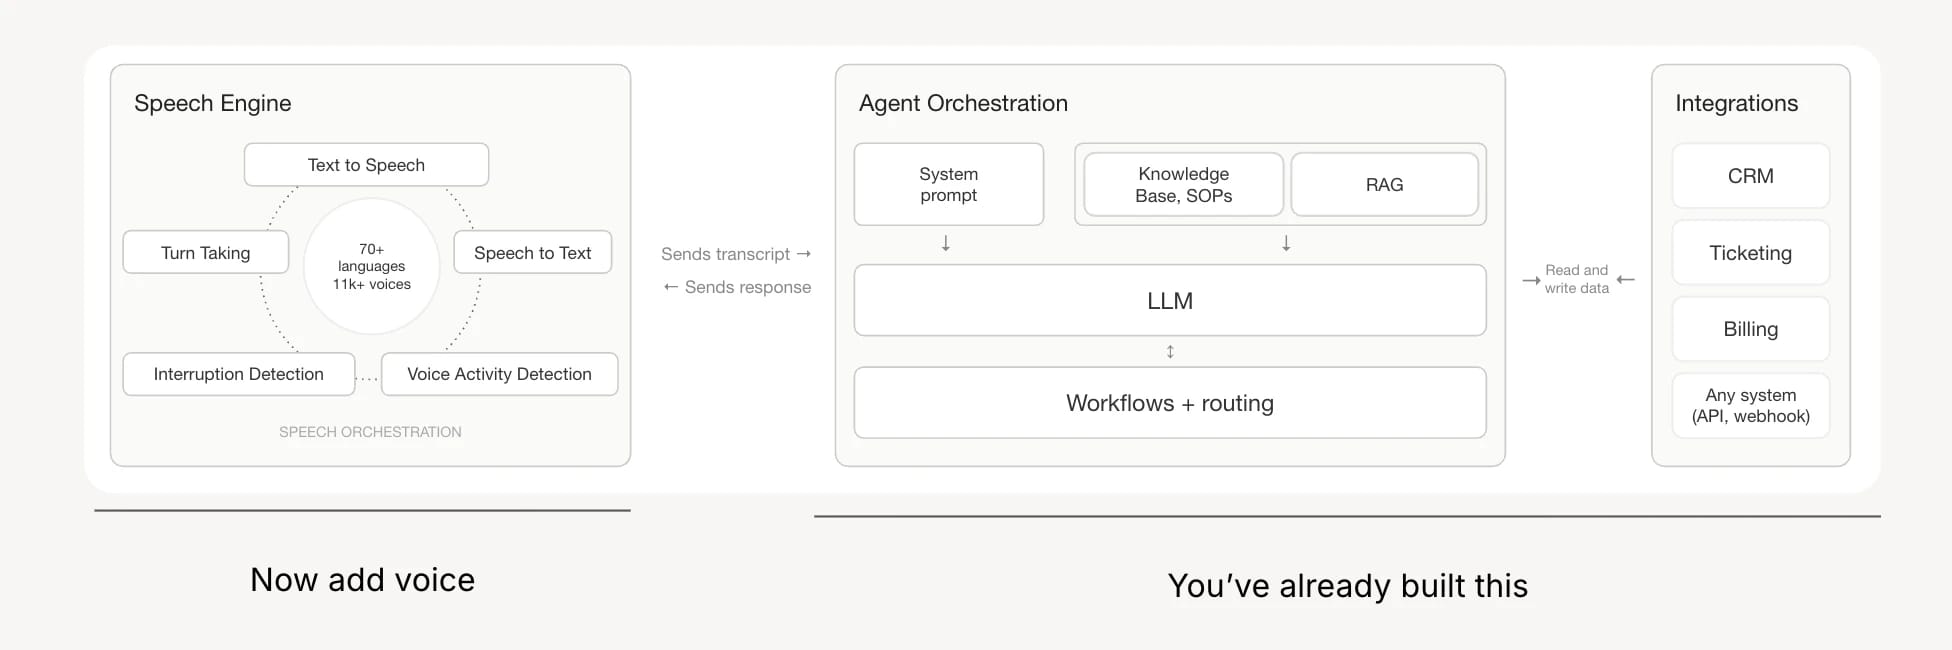
Quelques éléments à garder à l’esprit lors du développement :
- Le choix du LLM compte davantage pour la voix que pour le chat. Les modèles de raisonnement approfondi introduisent des pauses perçues comme des hésitations artificielles dans l’audio, même si la qualité de réponse est supérieure. Pour la voix en temps réel, les modèles plus rapides offrent presque toujours une meilleure qualité perçue.
- Privilégiez WebRTC aux WebSocket pour l’audio. WebRTC intègre l’annulation de l’écho et du bruit, particulièrement importante sur mobile ou dans les environnements bruyants. Utiliser des WebSocket pour transporter l’audio implique de gérer cela vous-même.
- Ne demandez pas aux utilisateurs de choisir une langue. Cela rompt la fluidité de la conversation. Détecter la langue dès les premières secondes de parole et la verrouiller est une meilleure approche, qui permet aussi de changer de langue naturellement sans aucune action de l’utilisateur.
- Dissociez votre modèle de gestion des tours de parole de votre LLM. Utiliser le LLM pour déterminer quand un utilisateur a fini de parler augmente la latence et les coûts à chaque tour. Un modèle dédié à la gestion des tours de parole le fait plus vite et plus précisément, et mérite d’être traité comme un composant distinct de l’architecture.
Quelle infrastructure gérer vous-même
La bonne réponse dépend de l’existant. Si vous disposez d’un agent conversationnel opérationnel, lui ajouter une couche vocale, tout en conservant votre LLM, votre orchestration et votre logique métier, est généralement l’option la plus rapide et la moins risquée.
Vous ne reconstruisez rien. Vous ajoutez une interface audio à un système qui fonctionne déjà.
Si vos besoins s’étendent à la téléphonie, à la gestion des canaux de déploiement, aux tests intégrés et aux analyses, il peut être pertinent de déléguer une plus grande partie de la pile à une plateforme d’agents vocaux. Les deux approches ne s’excluent pas : les équipes peuvent commencer par une couche vocale légère, puis ajouter les capacités de la plateforme à mesure que le cas d’usage évolue.
Démo : ajouter la voix à un chatbot existant
Cette démo présente un utilisateur déjà en conversation avec un chatbot textuel de planification de voyages, qui demande des recommandations de quartiers et de restaurants pour un voyage au Japon.
Ce que nous avons présenté :
- Le chatbot a été enrichi d’une couche vocale, sans aucune modification de l’agent sous-jacent.
- L’utilisateur est passé de la saisie au dialogue vocal en pleine conversation, et l’agent a conservé l’intégralité du contexte dans les deux modalités.
- L’utilisateur a parlé en néerlandais ; l’agent a détecté automatiquement le changement de langue
- Lorsque l’agent a été interrompu et invité à repasser à l’anglais au milieu d’une phrase, il l’a fait, puis a terminé sa réponse avec un léger accent néerlandais, sans y avoir été invité.
- Tout au long de la conversation, la détection des interruptions a permis à l’utilisateur de parler naturellement par-dessus l’agent, sans que celui-ci ne termine son tour.
Pourquoi c’est important :
La démo ne présentait pas un agent vocal conçu spécifiquement à cette fin. Elle présentait un agent textuel déjà opérationnel, auquel une couche vocale a été ajoutée. La gestion du contexte, la détection de la langue et le comportement face aux interruptions provenaient tous de cette couche vocale, l’agent textuel sous-jacent n’avait pas changé.
Regarder la session complète
Regardez le webinaire complet ici.
Paul fait partie de l’équipe Developer Growth chez ElevenLabs à Valence, en Espagne. Il travaille comme ingénieur expérience développeur, spécialisé dans l’accompagnement et les outils pour la plateforme. Avant ElevenLabs, il a dirigé les relations développeurs chez Stripe, travaillé sur la DX chez WorkOS, et passé plusieurs années à créer des applications web full-stack et des outils pour développeurs.




