
Qu’est-ce qu’une base de données vectorielle ? Comment la recherche par IA trouve le sens
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
Une base de données vectorielle est un système de stockage qui permet aux modèles IA d’interroger et de récupérer des données non structurées selon leur similarité sémantique. Elle aide l’IA à générer des réponses à partir de connaissances qui vont au-delà de ses données d’entraînement.
Les bases de données vectorielles stockent les informations dans un format que les grands modèles de langage peuvent traiter facilement. Elles fournissent aux modèles IA des informations supplémentaires pour générer des réponses pertinentes et précises.
Ce guide explique ce qu’est une base de données vectorielle, son fonctionnement, ses cas d’usage courants, ses types, des exemples et sa comparaison avec les bases de données relationnelles et orientées graphe.
En résumé
- Une base de données vectorielle stocke des représentations de caractéristiques apprises sous forme d’embeddings vectoriels dans un espace multidimensionnel.
- Contrairement aux bases de données traditionnelles qui reposent sur la correspondance de mots-clés, les bases de données vectorielles récupèrent des données sémantiquement similaires lors d’une requête.
- Une base de données vectorielle stocke des documents internes qui aident l’IA vocale et le service client à fournir des réponses tenant compte du contexte grâce à un système RAG.
- Les applications telles que les chatbots, les moteurs de recherche IA et l’IA conversationnelle bénéficient de la recherche sémantique et des types de données non structurées pris en charge par les bases de données vectorielles.
- Les bases de données vectorielles diffèrent des bases de données orientées graphe. Ces dernières relient des entités associées afin de prendre en charge les requêtes à sauts multiples au moyen d’algorithmes de parcours de graphe, tandis que les bases de données vectorielles conviennent aux requêtes simples nécessitant un contexte supplémentaire.
Qu’est-ce qu’une base de données vectorielle et que stocke-t-elle ?
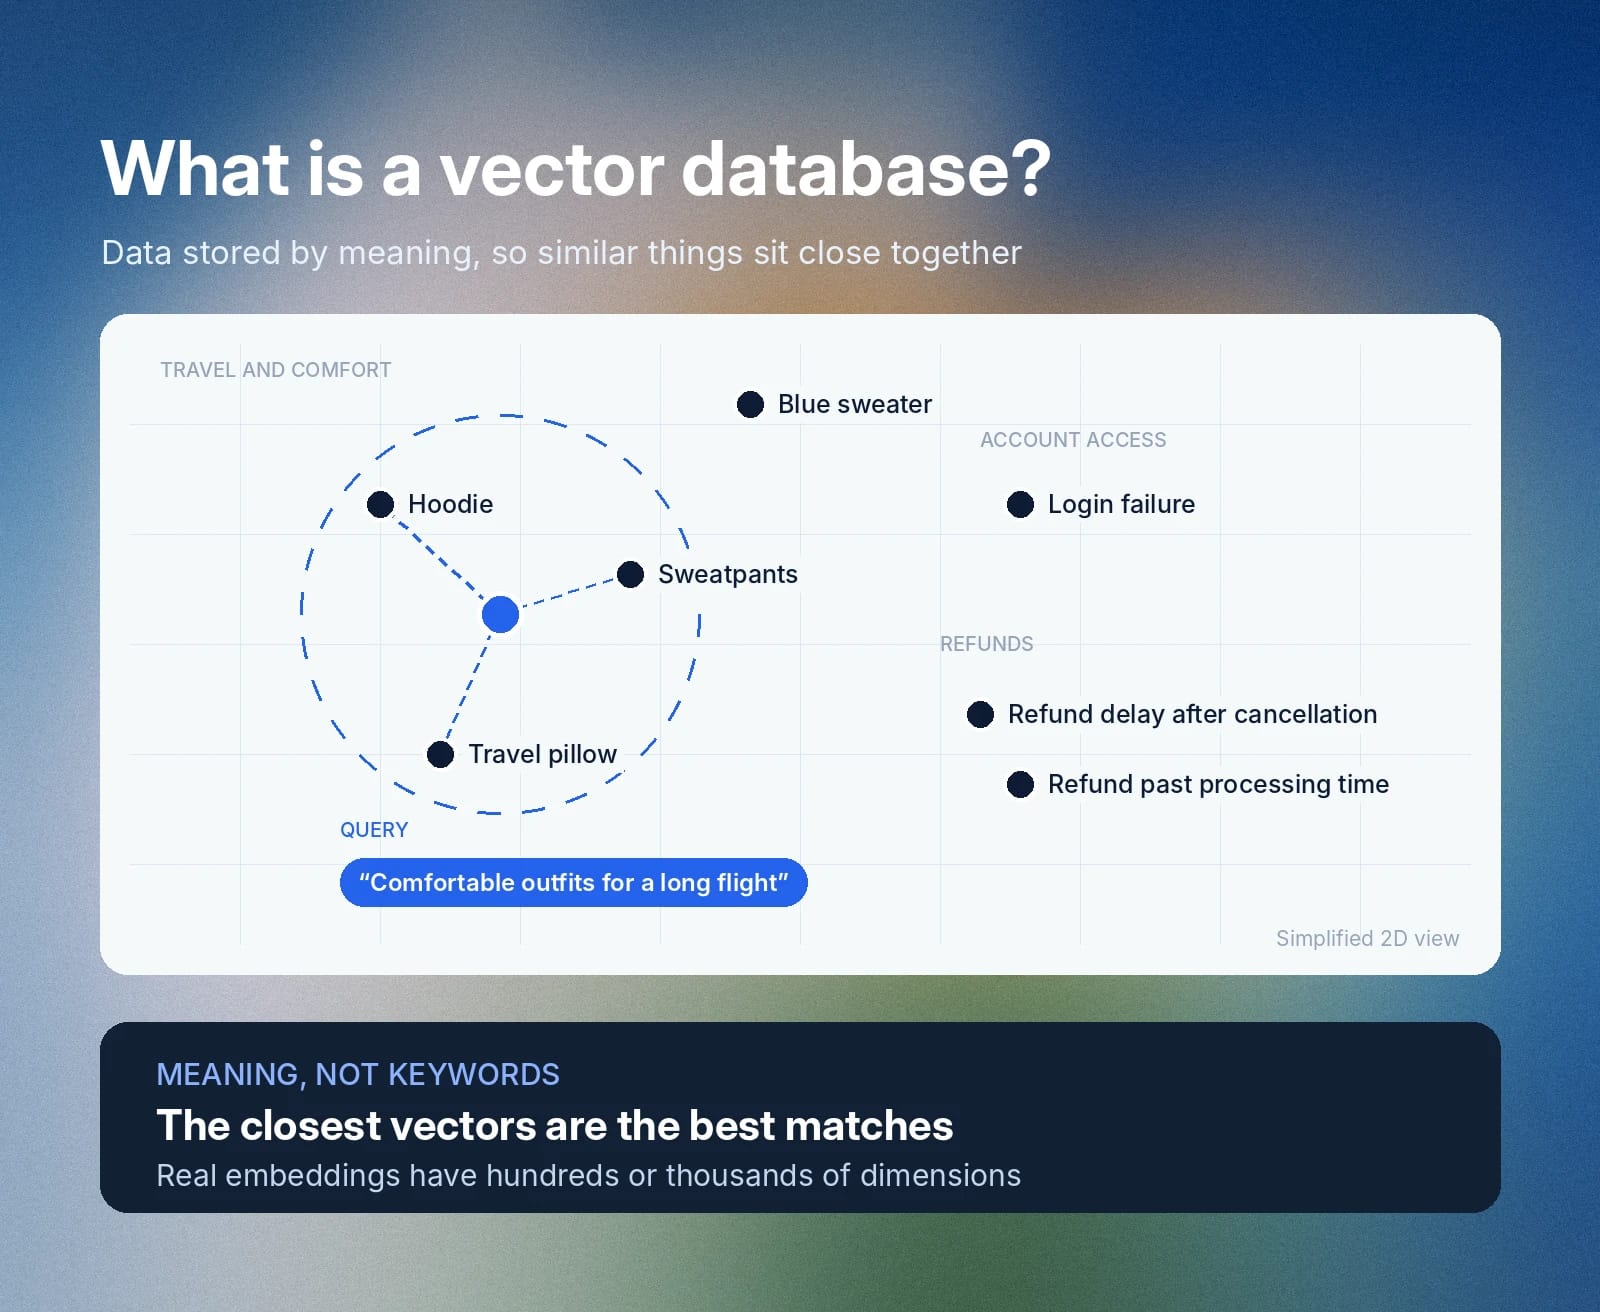
Une base de données vectorielle stocke les données sous forme de représentations numériques appelées embeddings, ce qui permet une recherche sémantique à faible latence pour les modèles IA. Contrairement à une base de données traditionnelle, qui stocke les informations dans des lignes et des colonnes, une base de données vectorielle regroupe les embeddings dans un espace multidimensionnel selon leurs similitudes sémantiques.
En IA, le terme « dimension » décrit les caractéristiques apprises d’un objet spécifique. Par exemple, vous pouvez considérer qu’un chien possède des dimensions telles que la couleur de son pelage et sa race. En pratique, les dimensions individuelles d’un embedding appris correspondent rarement à une caractéristique lisible unique.
Les applications d’IA générative, en particulier celles qui se connectent à une source de connaissances externe, utilisent une base de données vectorielle pour accélérer la récupération d’informations. Au lieu de rechercher une correspondance directe de mots-clés dans une base de données traditionnelle, le système de récupération trouve les embeddings les plus similaires dans la base de données vectorielle.
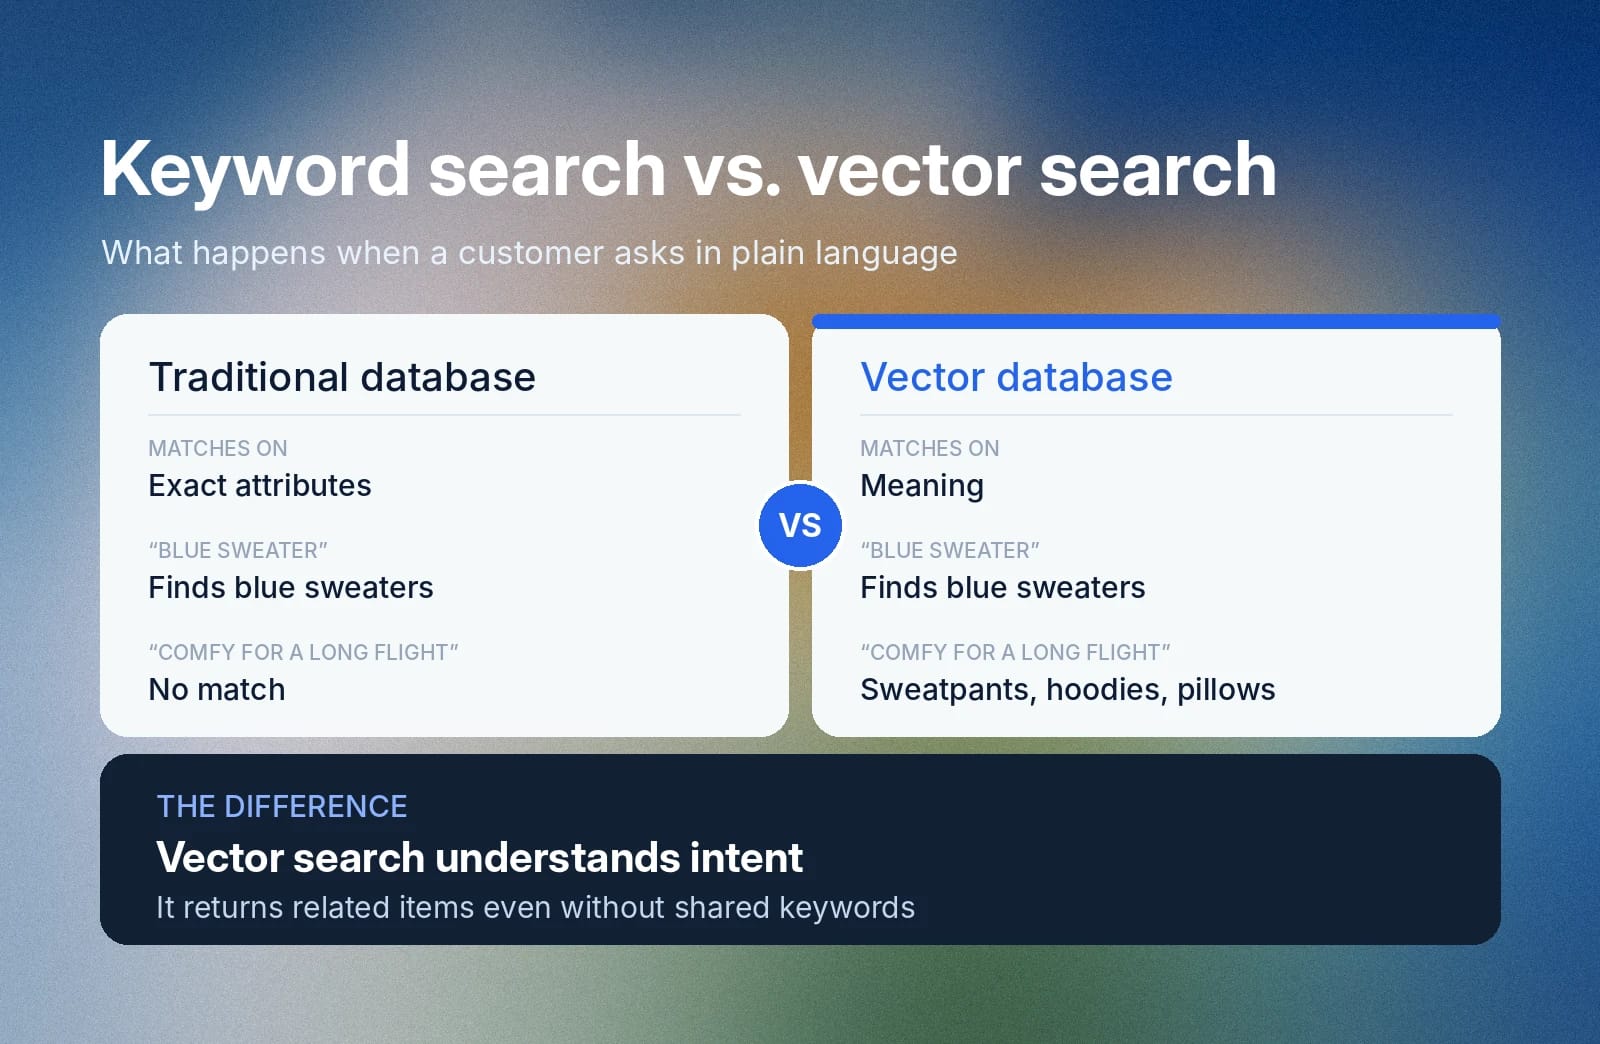
Imaginons qu’un client vous appelle et vous demande de lui recommander un « pull bleu ». Avec une base de données traditionnelle, vous cherchez des produits correspondant aux attributs « bleu » et « pull ». En revanche, si le client souhaite « des tenues confortables pour un long vol », une base de données traditionnelle ne pourrait pas fournir de réponse.
Une base de données vectorielle, elle, saisit le sens sémantique de la demande. En l’associant à l’espace vectoriel, le système renvoie des articles comme des pantalons de survêtement, des sweats à capuche et des coussins de voyage, dont les représentations de caractéristiques sont étroitement liées. Cette capacité à faire correspondre le sens distingue une base de données vectorielle d’une base traditionnelle.
Embeddings vectoriels : transformer la voix, le texte et les images en nombres
Les embeddings vectoriels sont des tableaux de nombres qui représentent des données non structurées, comme du texte, des images et des vidéos, afin que les modèles IA puissent les traiter facilement.
Un vecteur est la représentation mathématique de nombres répartis sur différentes dimensions. Cependant, un vecteur ne restitue pas le contexte, la structure ni le sens d’un jeu de données spécifique.
Par exemple, une liste de nombres à virgule flottante [0.82, 0.14, 0.67] est un vecteur, mais sa signification est déterminée par le modèle d’embedding.
Les embeddings capturent les qualités des données et les stockent sous forme de vecteur dans un espace multidimensionnel. Ils donnent du sens à ce qui ne serait autrement qu’une liste de nombres. Chaque nombre du vecteur représente une dimension de la représentation apprise.
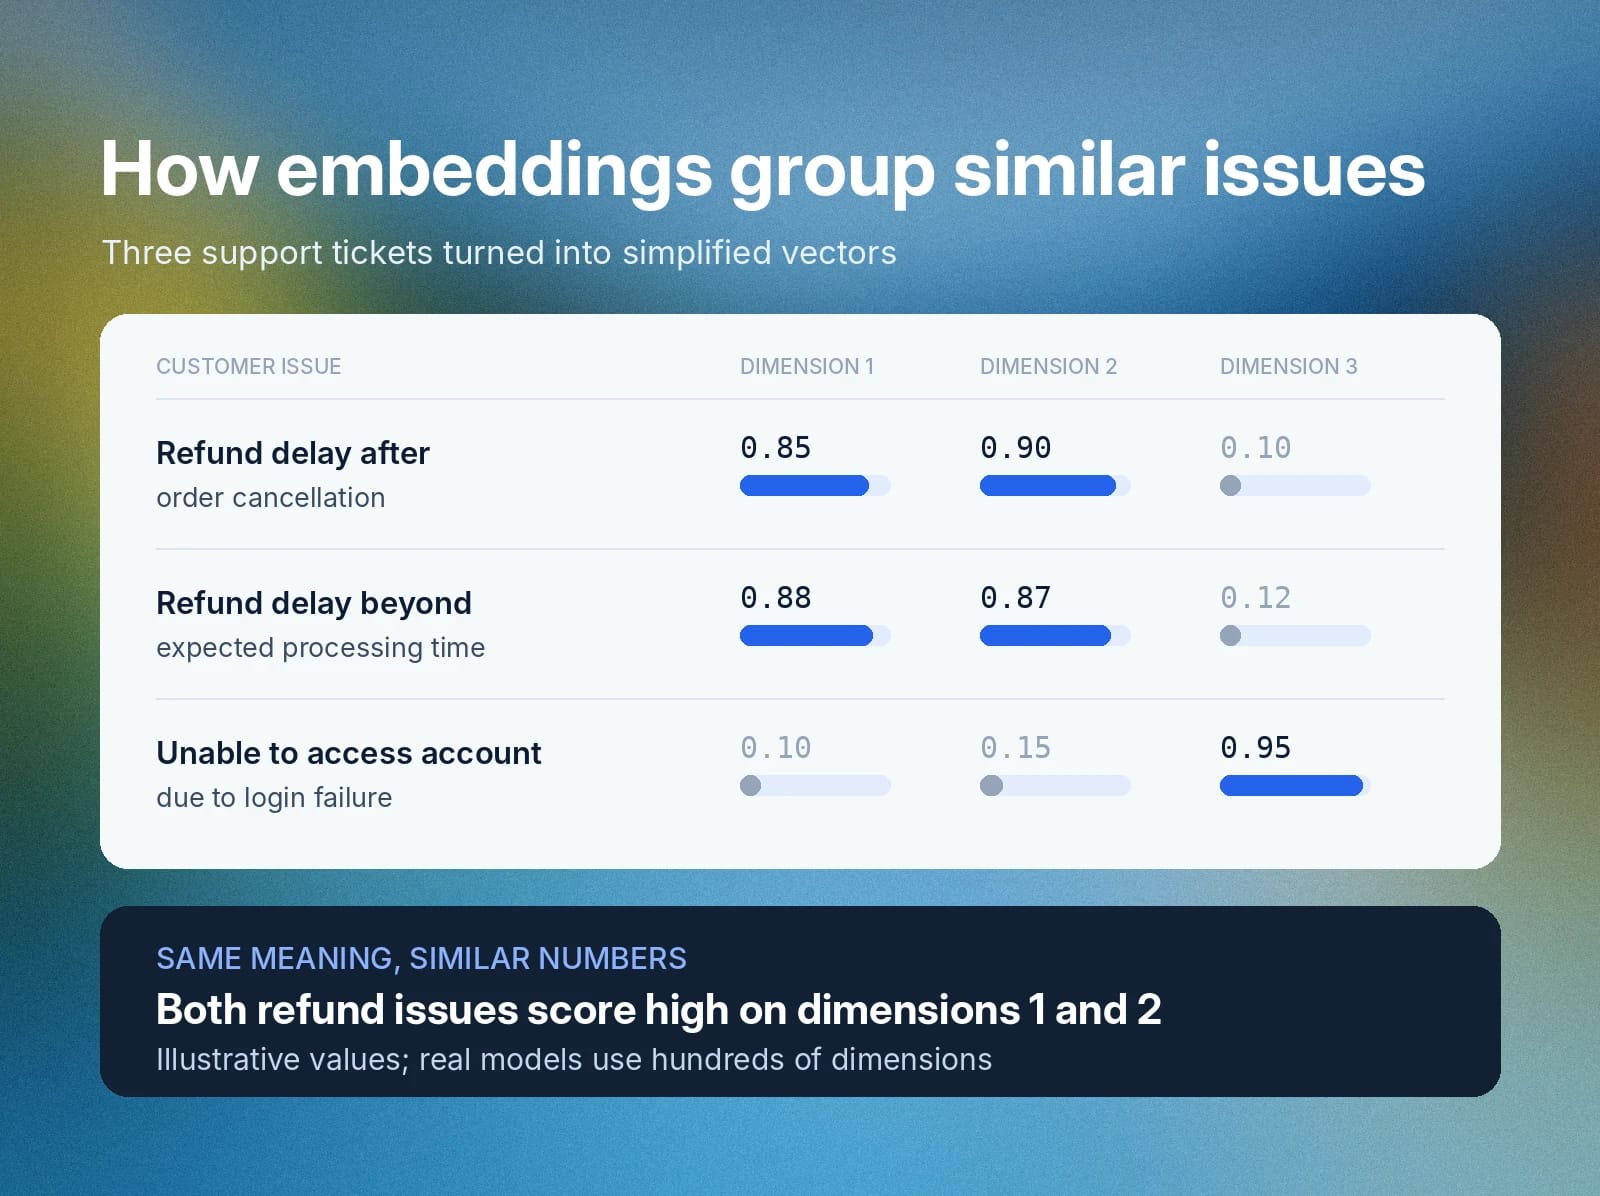
Imaginons que vous souhaitiez stocker des dossiers clients dans une base de données vectorielle. À l’aide d’un modèle d’embedding, vous convertissez les types de tickets en embeddings ayant des valeurs distinctes selon les dimensions. Les valeurs ci-dessous sont simplifiées à des fins d’illustration.
Problème client
Embeddings
Retard de remboursement après l’annulation d’une commande
[0.85, 0.90, 0.10]
Retard de remboursement au-delà du délai de traitement prévu
[0.88, 0.87, 0.12]
Impossible d’accéder au compte en raison d’un échec de connexion
[0.10, 0.15, 0.95]
Les deux problèmes de remboursement, malgré des causes différentes, présentent des nombres plus élevés dans les première et deuxième dimensions, tandis que le problème de connexion affiche son nombre le plus élevé dans la troisième. Les modèles d’embedding produisent généralement des centaines ou des milliers de dimensions, c’est pourquoi les bases de données vectorielles sont conçues pour les comparer rapidement.
Comment fonctionnent les bases de données vectorielles ?
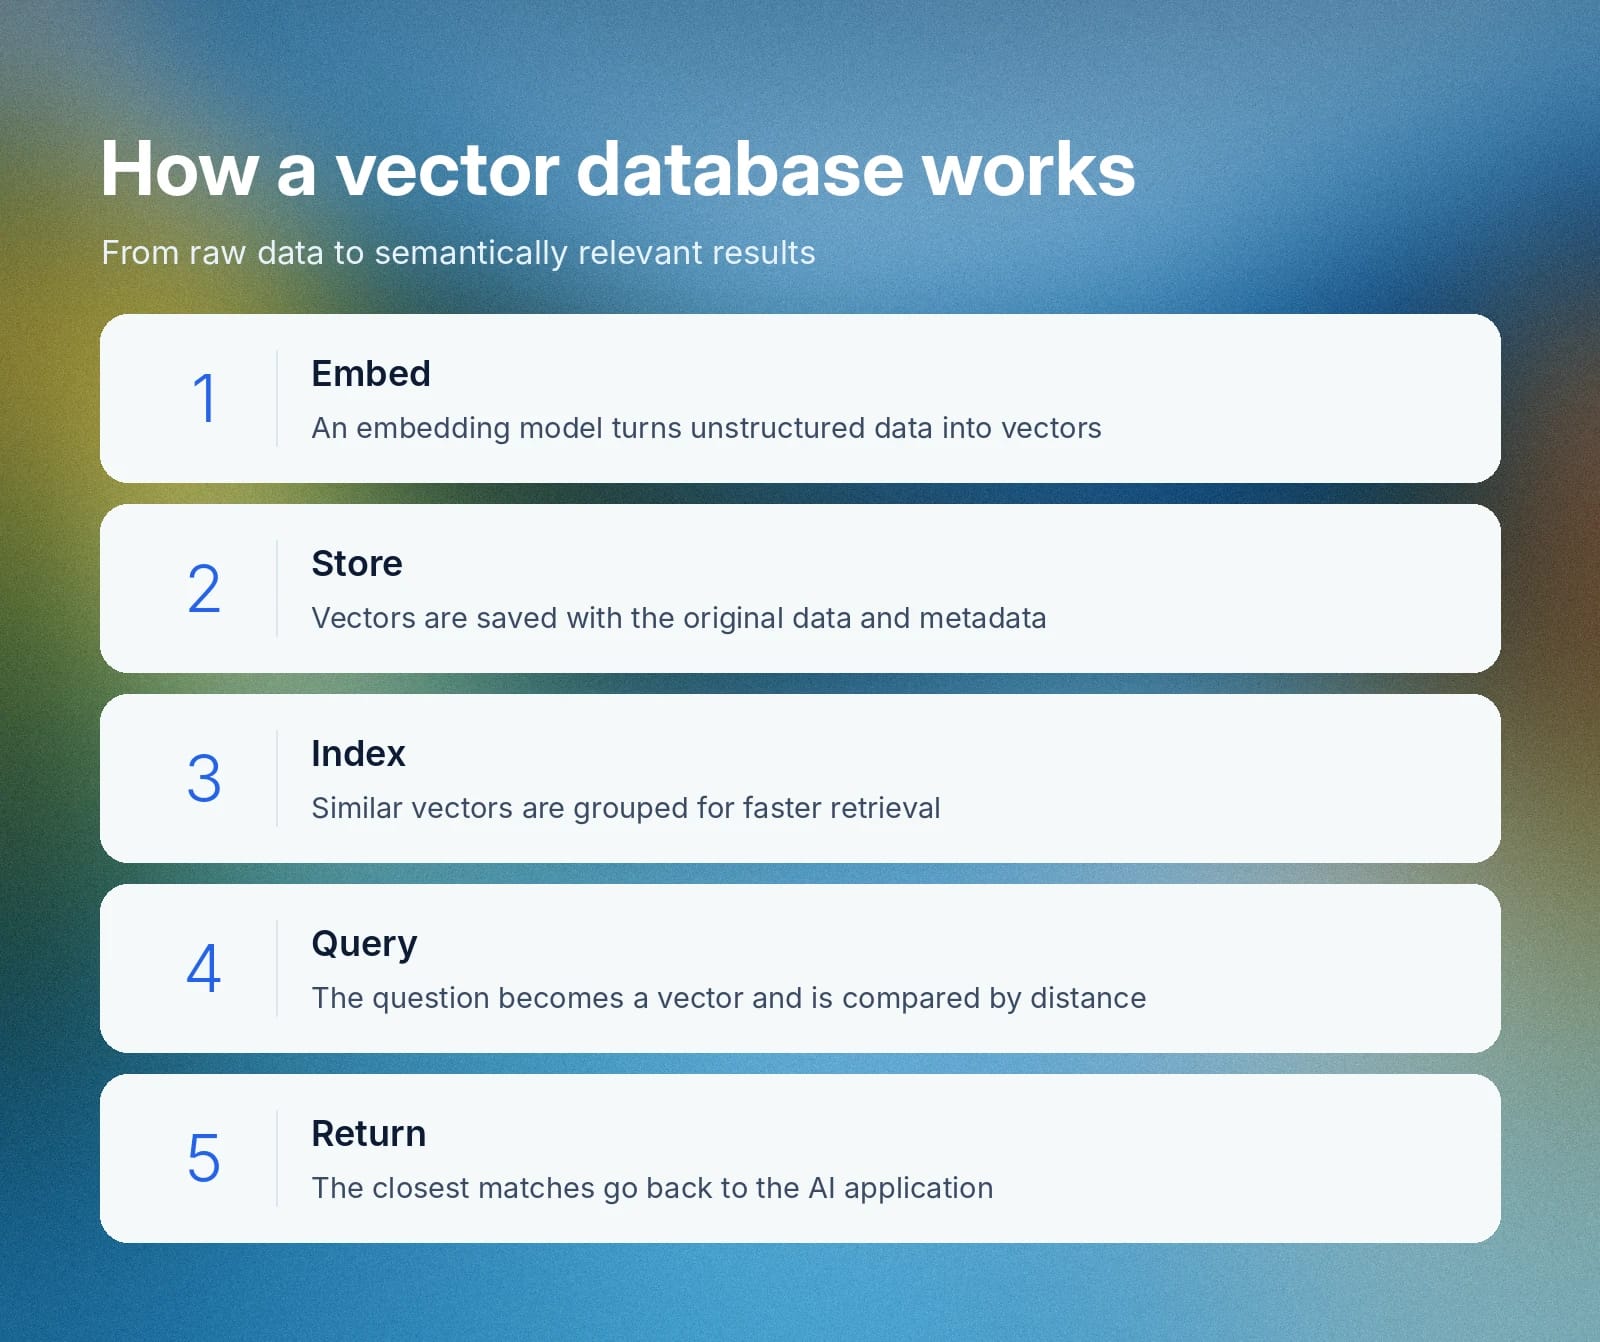
Les bases de données vectorielles transforment les données non structurées en embeddings, les stockent dans un espace multidimensionnel et facilitent la recherche de similarité sémantique. Dans une certaine mesure, les embeddings étroitement liés présentent une distance plus faible dans l’espace vectoriel.
Lorsqu’elle reçoit une requête, la base de données vectorielle utilise des algorithmes de plus proches voisins approximatifs (ANN) pour récupérer les embeddings les plus similaires sans analyser l’intégralité de la base de données.
Voici les étapes de configuration et de récupération d’informations dans une base de données vectorielle.
Stockage des embeddings
Tout d’abord, un modèle d’embedding convertit les données non structurées en embeddings. Chaque embedding représente des caractéristiques porteuses du sens sémantique de l’objet réel. Le système stocke ensuite les embeddings, accompagnés des données originales et des métadonnées, dans la base de données vectorielle.
Comme les embeddings de sens similaire sont proches les uns des autres dans l’espace vectoriel, la base de données peut récupérer des correspondances pertinentes en mesurant la distance entre les vecteurs.
Indexation pour une récupération plus rapide
L’indexation est un processus qui organise les embeddings vectoriels afin d’améliorer l’efficacité de la récupération. Les bases de données vectorielles utilisent plusieurs techniques d’indexation pour regrouper les embeddings étroitement liés. Par exemple, une base de données vectorielle peut utiliser une structure de liste, de graphe ou d’arbre, selon les exigences de récupération.
Outre l’indexation, la base de données vectorielle peut compresser les données à l’aide d’une technique appelée quantification de produit. La quantification de produit compresse les embeddings en codes compacts, ce qui économise de la mémoire au prix d’une légère perte de précision de recherche.
Interrogation de données sémantiquement pertinentes
Lorsqu’elle reçoit une requête, la base de données vectorielle la transforme en embedding. Elle compare ensuite l’embedding de la requête à ceux stockés dans la base de données multidimensionnelle à l’aide de techniques telles que la similarité cosinus, le produit scalaire et la distance euclidienne.
Selon les résultats, la base de données vectorielle renvoie les embeddings dont le score de similarité sémantique est le plus proche, que les applications d’IA générative utilisent pour enrichir leurs réponses. Ensemble, le stockage, l’indexation et l’interrogation permettent à la base de données de renvoyer rapidement des résultats pertinents.
Comment la recherche vectorielle et la recherche de similarité renvoient des résultats pertinents
La recherche de similarité est une vaste catégorie de systèmes de mise en correspondance d’informations. Elle comprend les approches par mots-clés qui correspondent aux mots exacts d’une requête, ainsi que la recherche vectorielle, qui s’appuie sur le sens.
La recherche vectorielle utilise une base de données vectorielle pour renvoyer des réponses sémantiquement liées. Au lieu d’effectuer une recherche exacte par mots-clés, elle compare la distance entre la requête et les réponses candidates pour sélectionner le résultat le plus approprié.
La base de données vectorielle utilise souvent des métadonnées pour préfiltrer les embeddings avant d’effectuer une recherche de similarité. Par exemple, elle restreint la recherche en filtrant les embeddings sur une période donnée. La récupération est ainsi plus rapide.
Cas d’usage des bases de données vectorielles pour l’IA vocale et le service client
Les bases de données vectorielles aident les équipes du service client à déployer une IA vocale et des chatbots capables de répondre avec une connaissance précise des produits. Dans un système de service client propulsé par l’IA, la base de données vectorielle stocke des bases de connaissances propriétaires telles que les guides des produits, les politiques de l’entreprise et les dossiers clients.
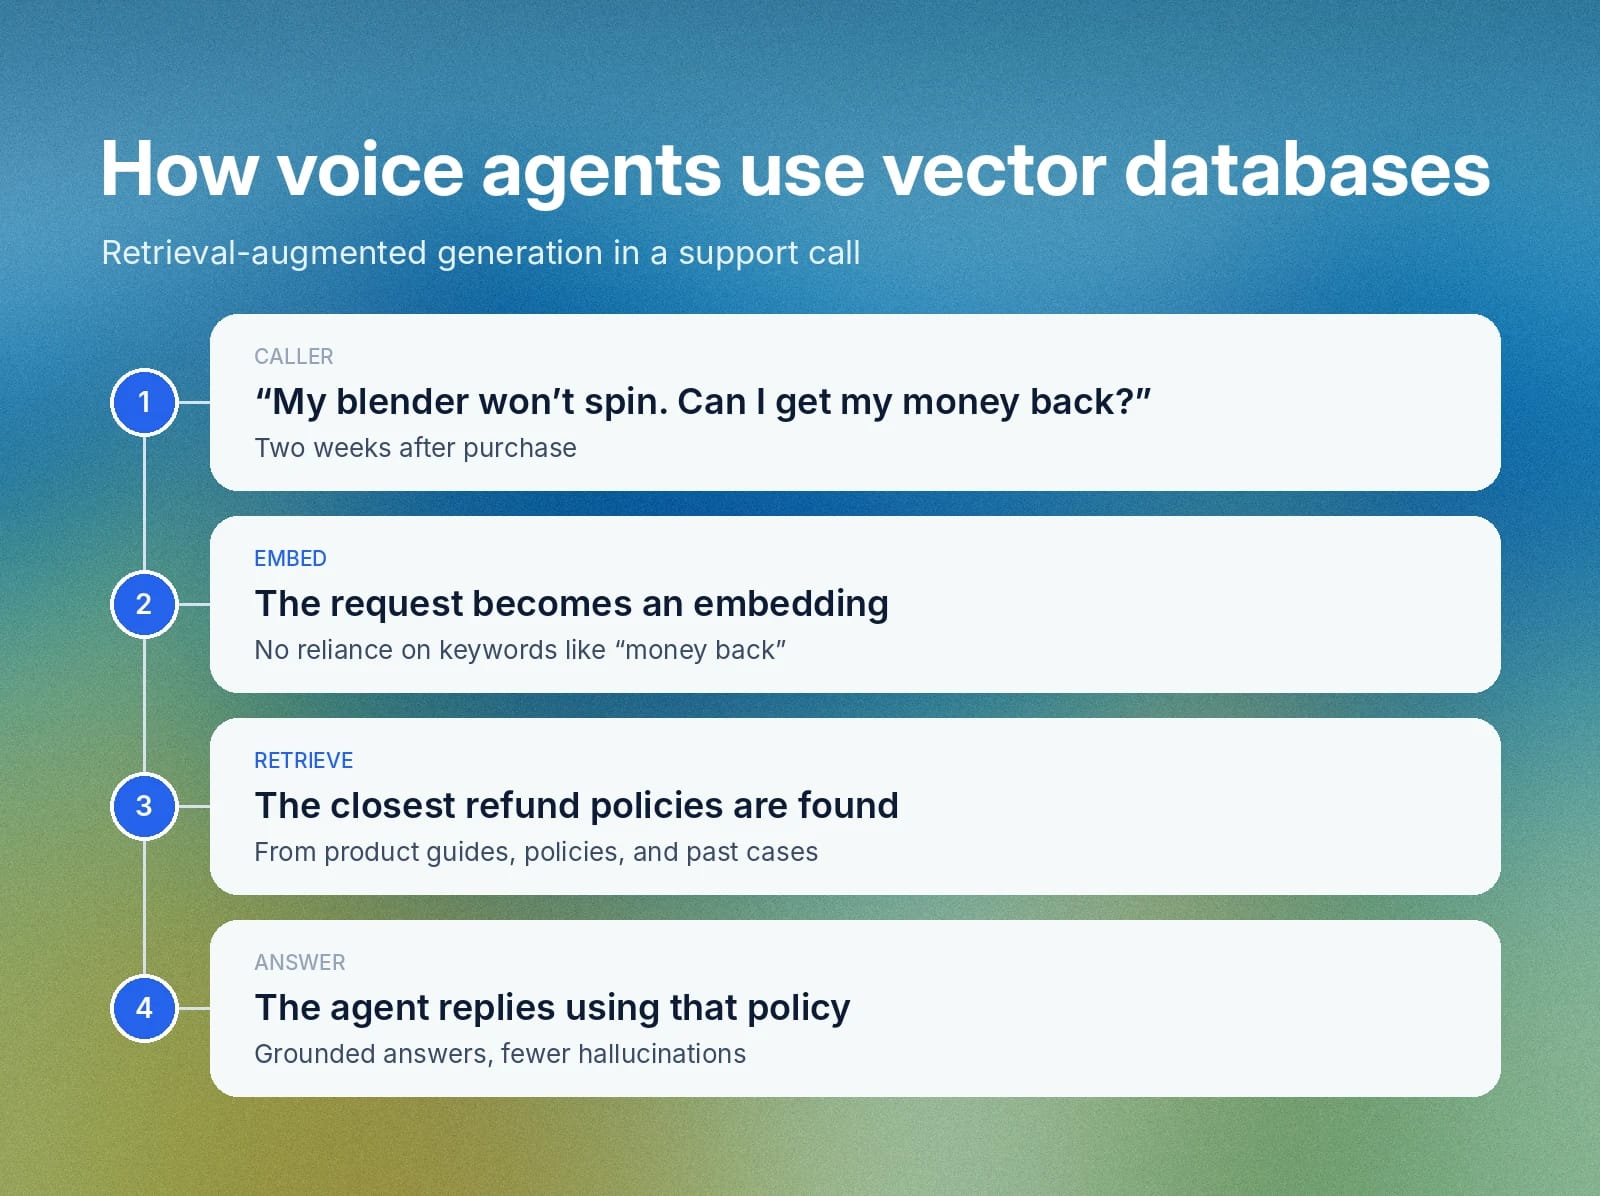
L’agent IA se connecte à la base de données vectorielle à l’aide d’un système de génération augmentée par récupération (RAG).
Lorsqu’un agent vocal IA reçoit une requête, il vérifie s’il dispose de suffisamment d’informations pour répondre au client. S’il lui manque des données récentes ou suffisantes, le RAG récupère des données sémantiquement correspondantes pour enrichir la réponse.
Imaginons qu’un agent vocal reçoive la réclamation suivante : « Mon blender ne tourne plus après deux semaines. Puis-je être remboursé ? » Au lieu de rechercher des mots-clés exacts comme « ne tourne plus » et « remboursé », le RAG transforme la demande en embedding. Il récupère ensuite les politiques de remboursement dont le sens est le plus proche.
En récupérant des documents internes pertinents, un système RAG soutenu par une base de données vectorielle aide à réduire les hallucinations des agents vocaux, sans toutefois les éliminer. Au lieu de deviner, les agents IA comme les intervenants humains peuvent s’appuyer sur des documents internes pour résoudre les demandes des clients.
Base de données vectorielle et base de données relationnelle : principales différences
Une base de données relationnelle utilise des lignes et des colonnes, ainsi qu’un schéma fixe, pour stocker ses données. Une base de données vectorielle utilise plutôt des embeddings, qui représentent des données non structurées.
Les bases de données relationnelles conviennent aux correspondances exactes et aux requêtes structurées, par exemple pour trouver toutes les commandes passées à une date donnée. Les bases de données vectorielles, elles, récupèrent les embeddings stockés dont le sens est le plus proche d’une requête, ce qui est plus efficace pour les questions formulées en langage naturel.
Dans la plupart des cas, les équipes utiliseront les deux, car chacune a son rôle dans le traitement des données.
Base de données vectorielle et base de données orientée graphe : quand utiliser chacune
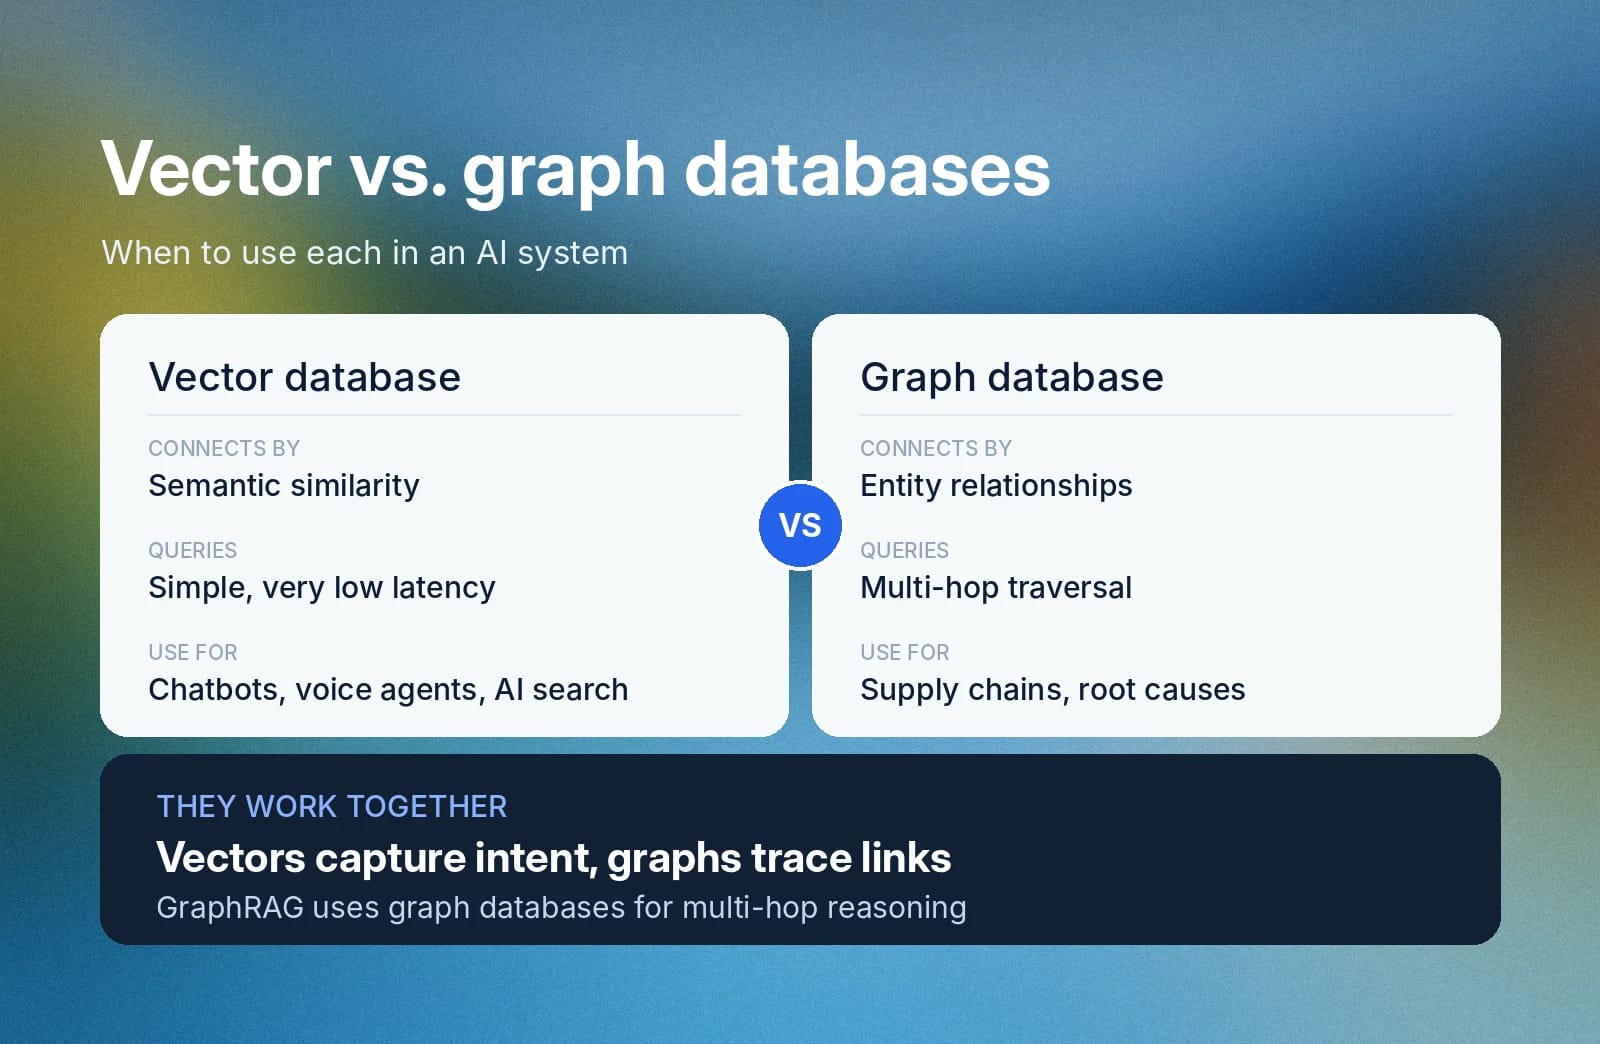
Les bases de données orientées graphe utilisent des graphes de connaissances pour connecter différentes entités d’une manière qui reflète leur hiérarchie et leurs relations. Les systèmes IA tels que GraphRAG utilisent des bases de données orientées graphe pour répondre aux requêtes nécessitant un raisonnement à sauts multiples.
Lorsque vous interrogez une base de données orientée graphe, elle trouve le point de départ et utilise un algorithme de parcours de graphe pour trouver les entités associées. Par exemple, les noms des clients peuvent être reliés successivement aux dates de renouvellement et aux tickets d’assistance.
Les bases de données vectorielles, elles, stockent des données non structurées sous forme de représentations numériques fondées sur leur sens sémantique. Elles permettent aux systèmes RAG d’effectuer une mise en correspondance simple des requêtes à très faible latence. Par exemple, une base de données vectorielle fait ressortir la politique de remboursement lorsqu’elle traite « Je souhaite un remboursement ».
Les bases de données vectorielles et orientées graphe sont toutes deux utiles aux systèmes IA. Vous pouvez les utiliser ensemble :
- Utilisez une base de données vectorielle pour alimenter un chatbot, un agent vocal ou un moteur de recherche IA qui doit comprendre l’intention exprimée en langage humain.
- Utilisez une base de données orientée graphe pour résoudre des problèmes d’interdépendance, comme le suivi des chaînes d’approvisionnement, la recommandation de produits pertinents ou l’analyse des causes profondes.
Quels types de bases de données vectorielles sont disponibles ?
En général, il existe deux types de bases de données vectorielles, différenciés par leur architecture.
- Base de données vectorielle autonome : ces bases de données indépendantes, conçues à cet effet, prennent en charge des recherches de similarité multidimensionnelles à faible latence. De nombreuses applications d’IA générative se connectent à des bases de données vectorielles autonomes pour faire évoluer des charges de travail de requêtes importantes.
- Extension de base de données vectorielle : les bases de données existantes peuvent introduire des capacités de recherche vectorielle pour permettre une récupération fondée sur la sémantique par les modèles IA. Ces bases conservent leur architecture d’origine, comme un schéma SQL basé sur des lignes, tout en prenant en charge les types de données vectorielles.
Le choix dépend principalement de votre besoin : un système dédié à des charges de requêtes importantes, ou un élément de recherche sémantique dans une base de données que vous utilisez déjà.
Exemples de bases de données vectorielles
Voici deux exemples de bases de données vectorielles :
- Bases de données vectorielles autonomes : Pinecone est un service géré de base de données vectorielle. Milvus, Weaviate, Qdrant et Chroma sont des bases de données vectorielles open source.
- Extensions de base de données vectorielle : pgvector ajoute la recherche de similarité vectorielle à PostgreSQL, et MongoDB Atlas Vector Search l’ajoute à MongoDB.
Le choix dépend de votre échelle et du niveau d’infrastructure que vous souhaitez gérer.
Essayez ElevenAgents dès aujourd’hui pour des agents vocaux prêts pour la récupération d’informations
ElevenAgents permet aux agents vocaux de récupérer des informations dans votre propre base de connaissances afin de fournir des réponses conversationnelles tenant compte du contexte. Grâce au RAG, l’agent récupère le contenu le plus sémantiquement similaire parmi les documents, URL ou textes que vous ajoutez à la base de connaissances. Vous pouvez définir la récupération « À la demande », afin que l’agent ne consulte la base de connaissances que lorsqu’il estime en avoir besoin.
La mise en œuvre du RAG augmente naturellement la latence de génération des réponses. Toutefois, grâce à nos avancées techniques, nous avons réduit la latence médiane du RAG d’ElevenAgents de 326 ms à 155 ms.
Essayez ElevenAgents dès aujourd’hui et découvrez comment configurer votre base de connaissances ici.
Questions fréquentes

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.


