Résoudre les problèmes de précision du text to speech
- Rédigé par
- Jack Limebear
- Publié
ÉcouterÉcouter cet article
Bien qu’ils soient entraînés sur d’immenses jeux de données vocales et puissent produire régulièrement un audio haute fidélité, la plupart des modèles de text to speech (TTS) peuvent encore mal prononcer certains mots ou rencontrer d’autres problèmes d’élocution. Les erreurs de prononciation surviennent lorsqu’un moteur TTS rencontre des mots ou des expressions qui ne figurent pas dans les données vocales sur lesquelles il a été entraîné. C’est le plus souvent le cas avec le jargon sectoriel, les noms de marque ou les noms propres.
Les moteurs TTS peuvent aussi produire une élocution précipitée, hachée ou robotique lorsque les passages sont longs ou ponctués pour la lecture plutôt que structurés pour être dits à voix haute.
Vous pouvez également rencontrer quelques problèmes techniques courants lors de la connexion de vos applications à des moteurs TTS via une API.
Dans cet article, nous examinons ces trois catégories de problèmes et les solutions courantes pour les résoudre.
En résumé
- Les défaillances du text to speech relèvent généralement de trois catégories : les erreurs de prononciation, un rythme ou une cadence peu naturels, et les erreurs techniques d’exécution de l’API.
- Pour corriger efficacement les erreurs de prononciation, utilisez des dictionnaires Pronunciation Lexicon Specification (PLS) conformes à la norme W3C ou ajustez chaque cas avec des balises phonétiques intégrées à vos scripts.
- Vous pouvez améliorer le naturel de votre rendu vocal en formatant et en ponctuant correctement votre script. Un texte conçu pour être dit diffère souvent d’un texte destiné uniquement à être lu.
- Vous pouvez diagnostiquer les défaillances de l’API grâce aux codes d’état HTTP standards.
- Tester dès le départ, de manière isolée, la prononciation des noms de marque, des noms propres et des expressions inédites peut vous éviter un dépannage conséquent par la suite.
Pourquoi le text to speech ne fonctionne-t-il pas ?
Les problèmes de text to speech se répartissent globalement en trois catégories.
Types de problèmes TTS
Erreurs de prononciation
Le modèle TTS lit mal des mots ou expressions inconnus, par exemple votre nom de marque, du jargon sectoriel, des acronymes ou des homographes.
Élocution et cadence peu naturelles
La parole produite est monotone, marque des pauses à des endroits inhabituels ou parcourt trop vite des passages qui nécessitent un débit plus lent.
Échecs d’intégration et d’API
Votre application ne génère pas de parole pour une ou plusieurs raisons techniques, comme des identifiants vocaux manquants, des limites de charge ou des clés API invalides.
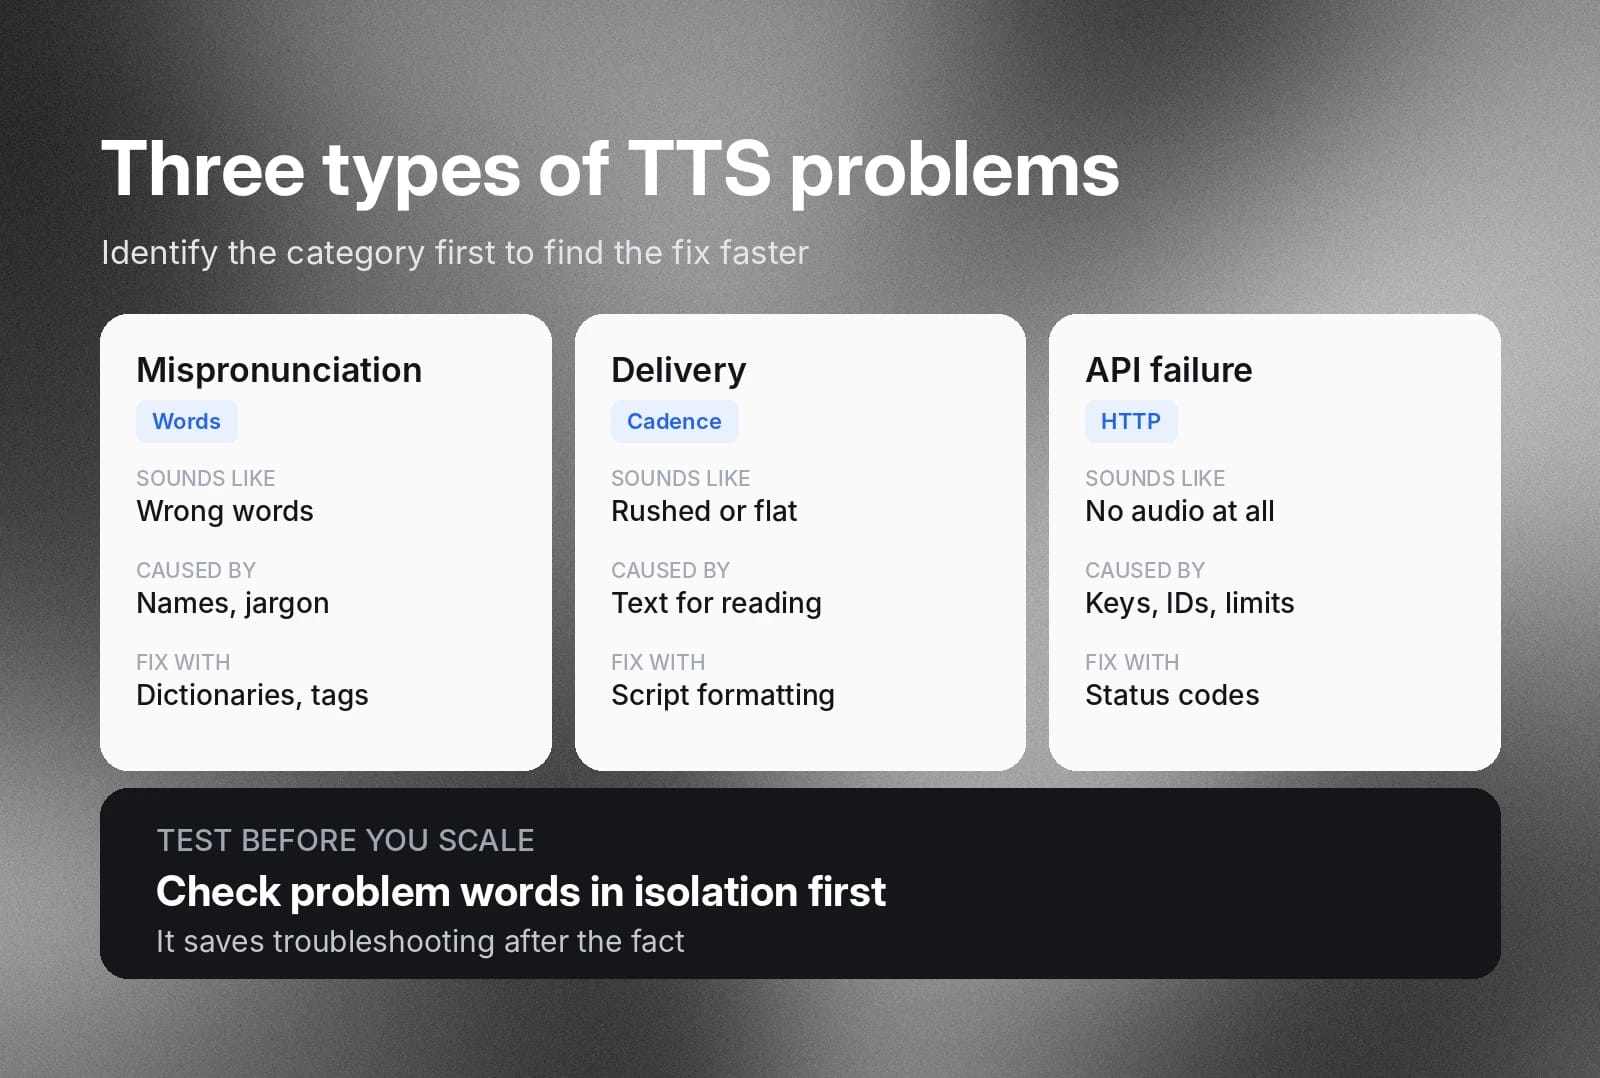
Ce guide détaille chacun de ces trois problèmes afin que vous sachiez précisément à quel enjeu de qualité du rendu ou à quel problème technique vous faites face. Les comprendre vous aidera à identifier plus vite la bonne solution.
Résoudre les problèmes de précision du text to speech : erreurs de prononciation et élocution peu naturelle
Les ingénieurs entraînent les modèles vocaux neuronaux modernes sur d’immenses jeux de données vocales. Ils peuvent générer une parole naturelle à partir d’un nombre presque illimité de combinaisons de mots. Toutefois, aucun jeu de données d’entraînement n’est universel. Il y aura toujours des prononciations marginales, des mots obscurs ou des noms propres que le modèle ne prononcera pas correctement.
Cela reste rare, mais toute personne qui utilise régulièrement des modèles TTS doit savoir comment y remédier. Il est d’abord important de comprendre pourquoi ces erreurs de prononciation se produisent.
Causes fréquentes des erreurs d’élocution
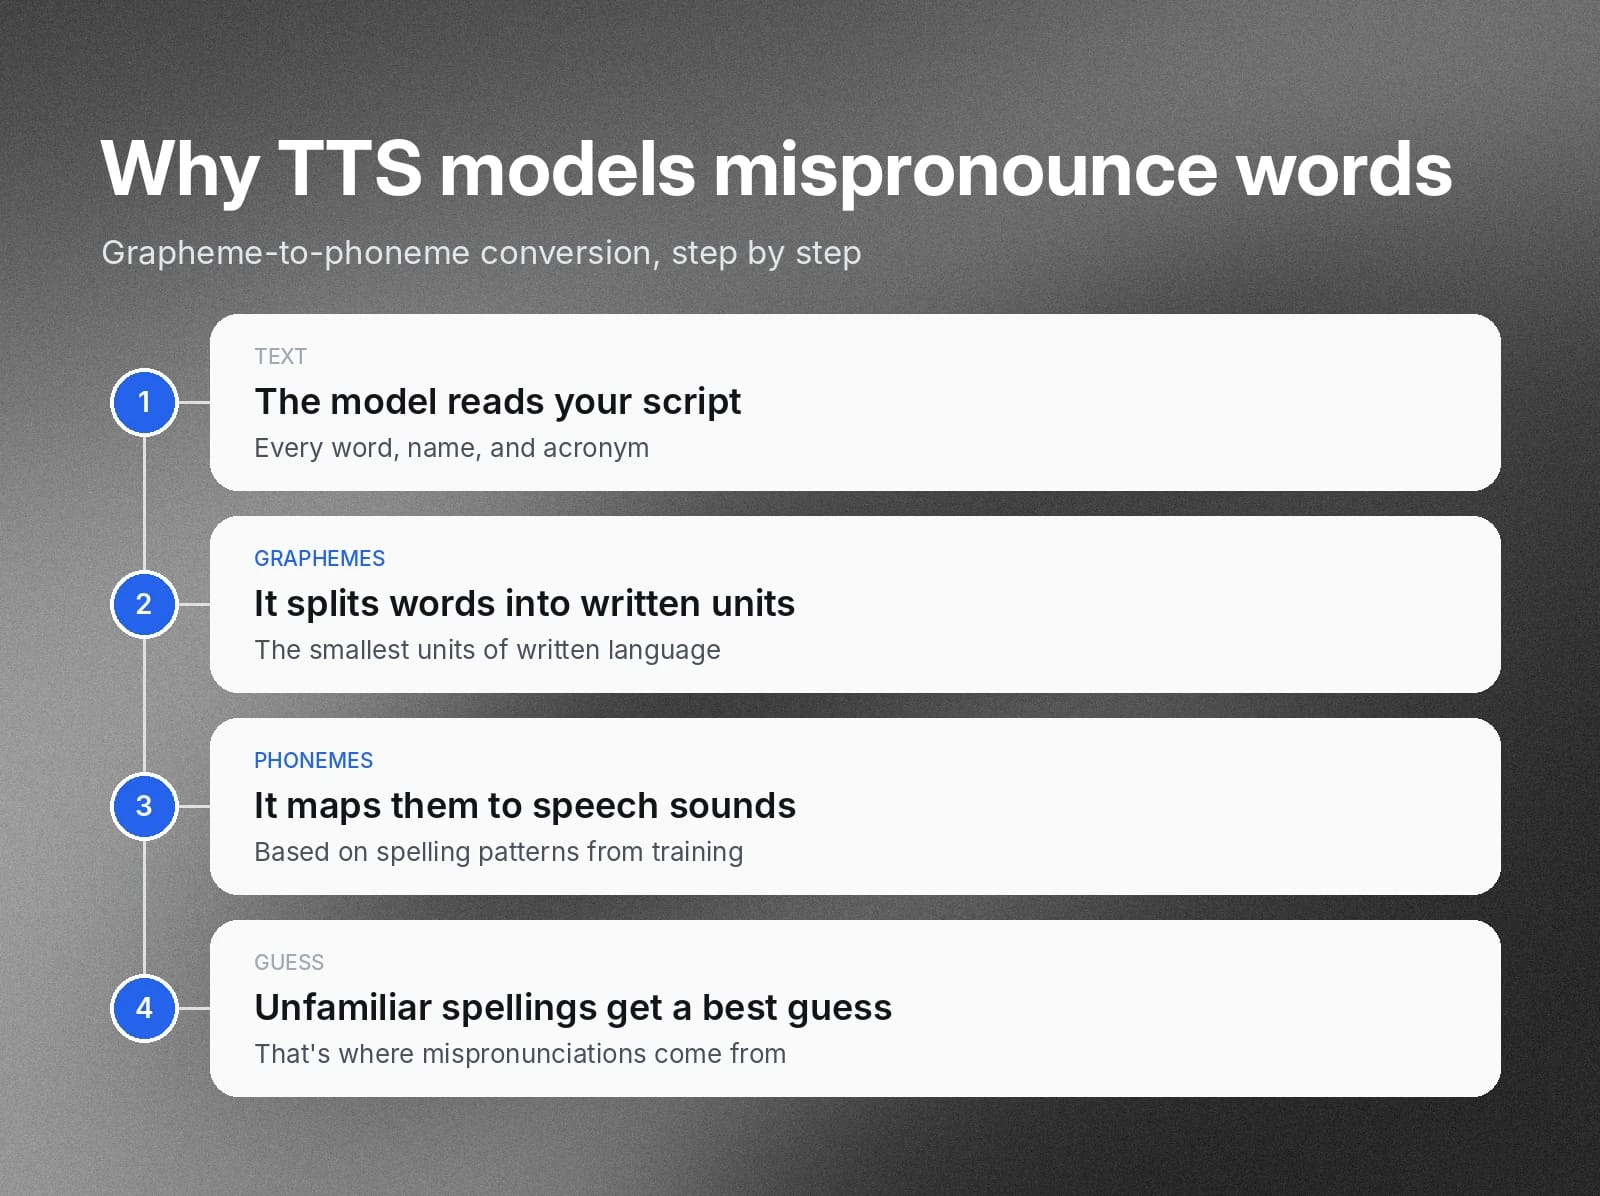
Les modèles de synthèse vocale convertissent le texte en parole grâce à un processus appelé conversion graphème-phonème (G2P). Les phonèmes sont les plus petites unités sonores de la parole. Les graphèmes sont les plus petites unités de la langue écrite, généralement une lettre, qui représentent un phonème.
Lorsque le texte saisi ne correspond pas aux schémas orthographiques rencontrés par les modèles dans les données d’entraînement, ils estiment au mieux la prononciation phonétique. Cela peut parfois entraîner des erreurs de prononciation.
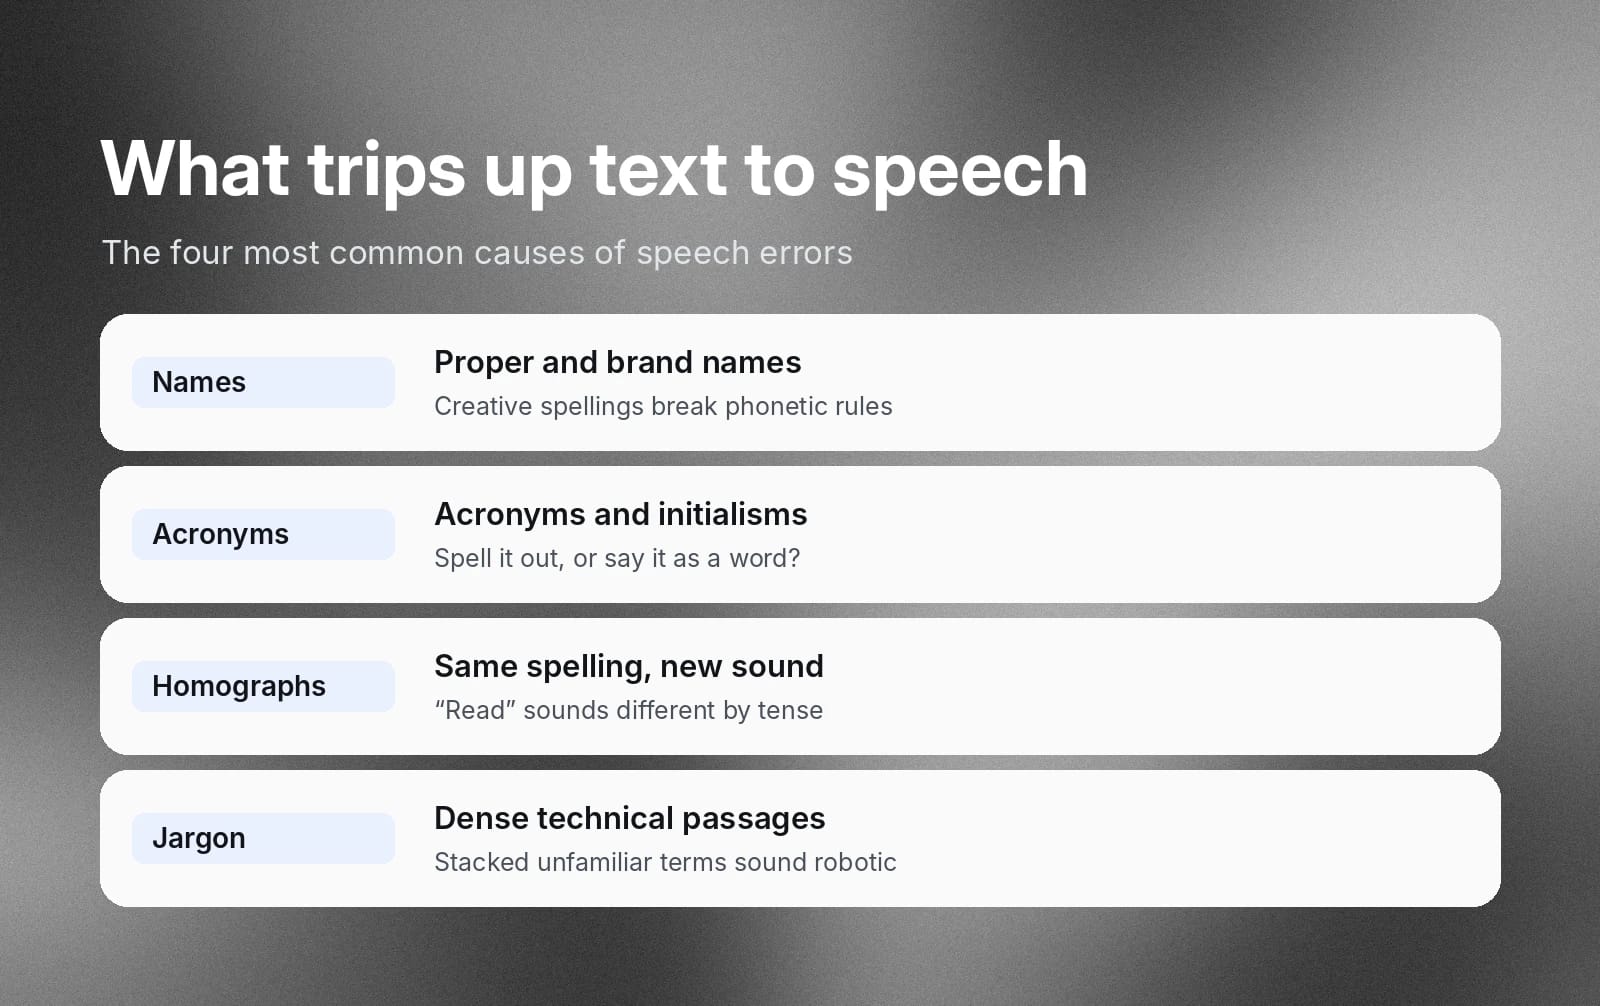
Noms propres et noms de marque
Les entreprises utilisent souvent des orthographes créatives pour leurs noms de marque. Elles attirent l’œil, mais déconcertent aussi fréquemment les modèles de synthèse vocale. Il en va de même pour les prénoms et noms de famille originaux, pour la même raison.
Lorsqu’un modèle rencontre un nom inconnu, il tente d’appliquer les règles phonétiques de base qu’il a apprises. La parole générée peut alors être très éloignée de ce que vous souhaitez.
Acronymes et sigles
Prenez l’acronyme NASA. Imaginez que vous ne l’ayez jamais vu, comme pourrait le faire un modèle vocal. Le prononcez-vous « N.A.S.A. » ou « nasa » ? Qu’en est-il d’une API logicielle ? Est-ce « A.P.I. » ou « api » ? Et si votre entreprise commercialise un tout nouvel outil logiciel avec un nouvel acronyme ? Vous pouvez être sûr qu’il ne figure pas dans les données d’entraînement d’un modèle vocal. Le modèle devra donc deviner la prononciation souhaitée, à moins que vous ne lui fournissiez des instructions personnalisées.
Homographes
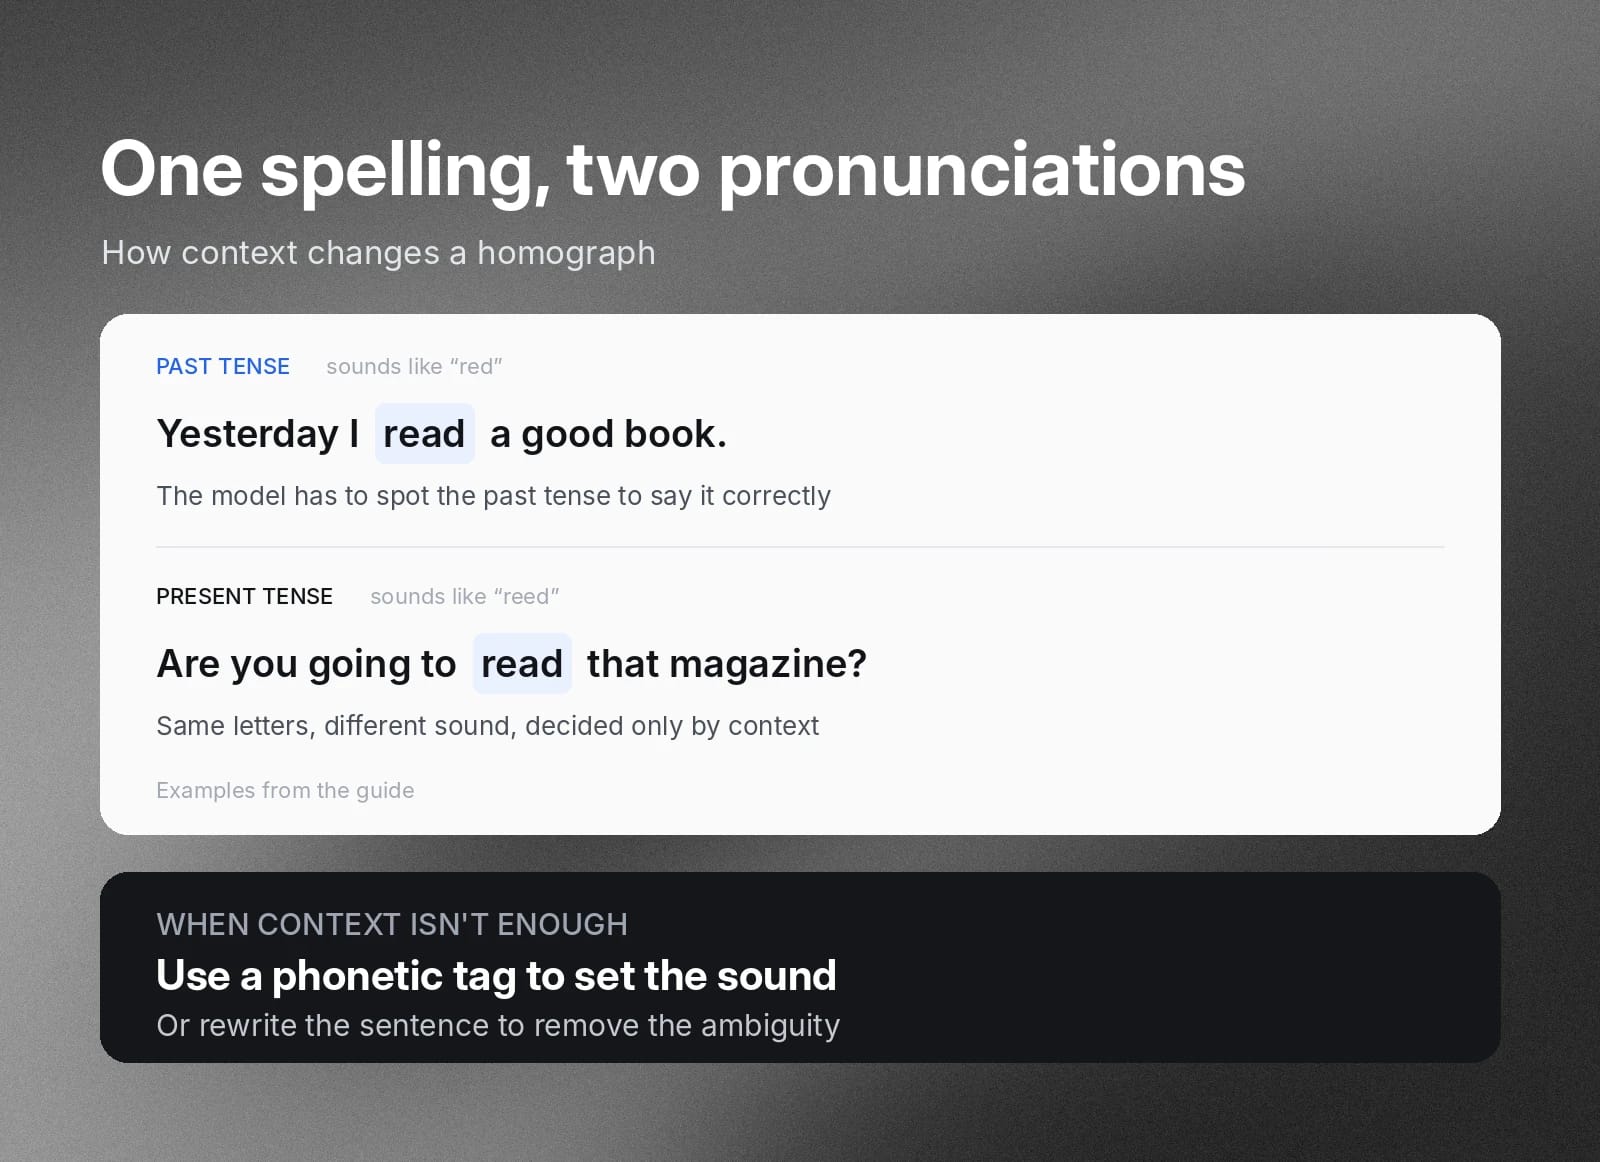
Les homographes sont des mots qui partagent la même orthographe, mais dont la prononciation diffère selon le contexte. Par exemple, le mot anglais « read » s’écrit de la même façon, mais se prononce différemment au passé et au présent.
- « Hier, j’ai lu un bon livre. »
- « Vas-tu lire ce magazine ? »
Un modèle vocal doit disposer d’une compréhension suffisante du contexte pour prononcer les homographes comme vous le souhaitez.
Schémas d’accentuation peu naturels
De longues phrases remplies de jargon technique peuvent rapidement cumuler des mots obscurs, des prononciations spécifiques et des acronymes. Une erreur à peine perceptible isolément peut vite contribuer à une parole plate et robotique, tandis que le modèle tente d’analyser de nombreux mots et tournures inconnus.
Deux moyens de contrôler la prononciation vocale
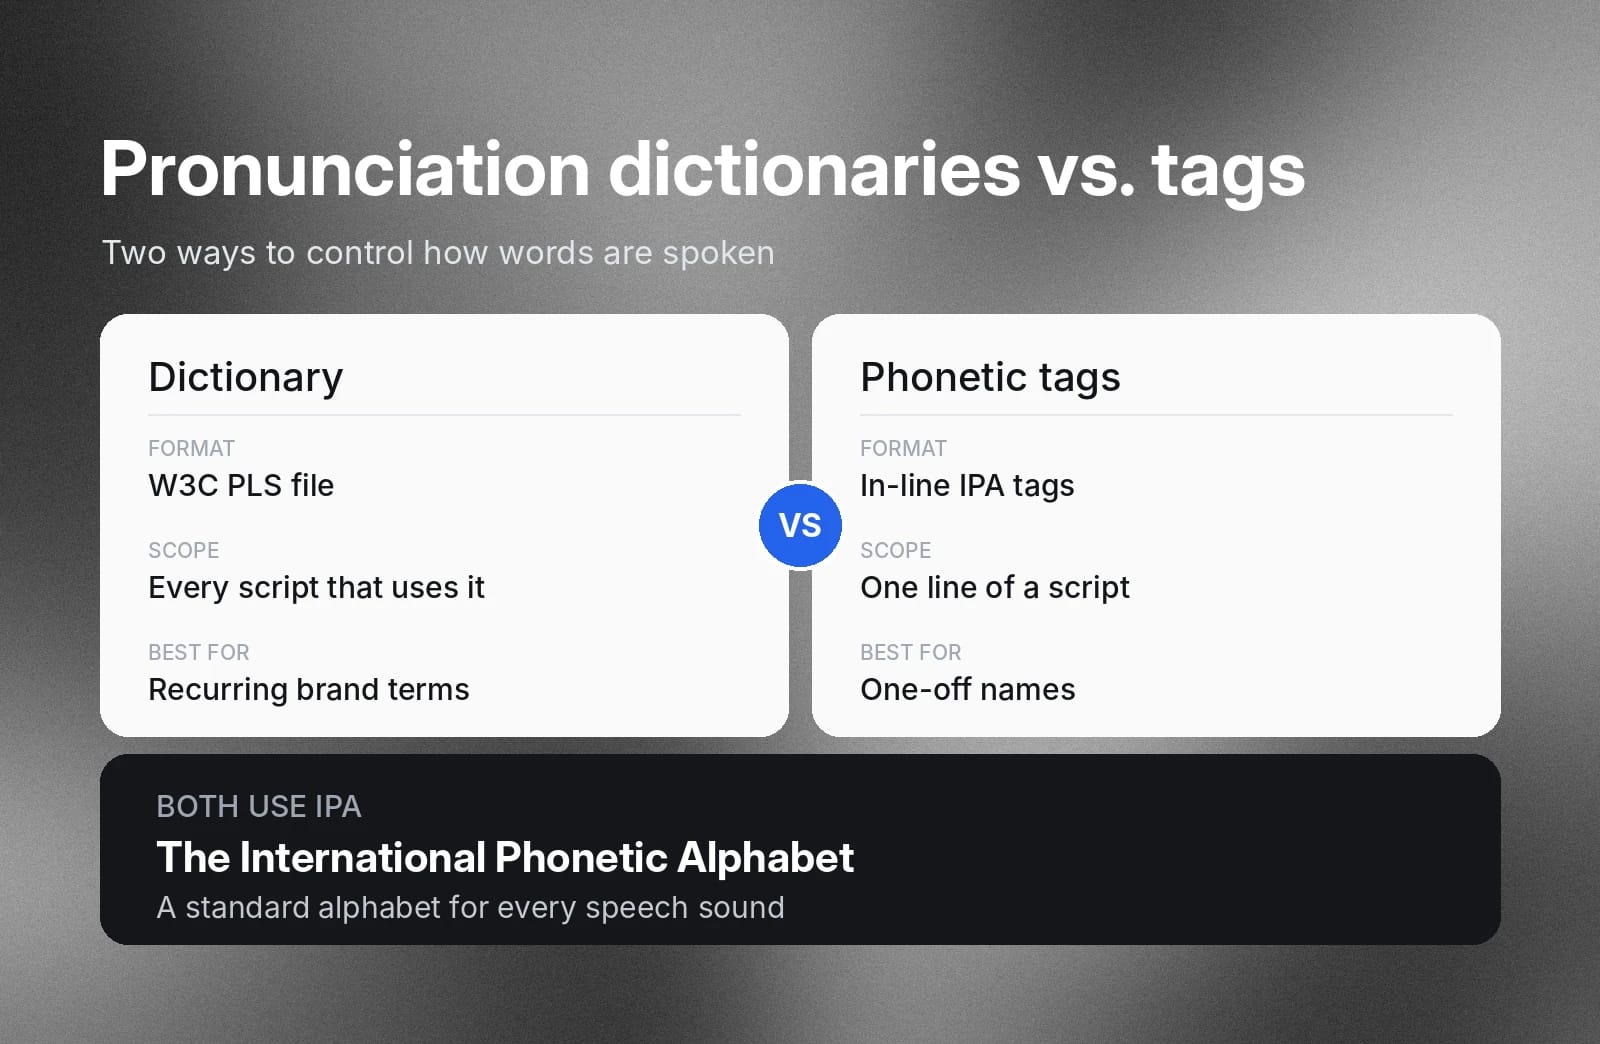
Vous n’avez pas besoin de réécrire entièrement vos scripts pour éviter ces situations. Les modèles neuronaux de synthèse vocale modernes intègrent deux outils pour les corriger efficacement, au cas par cas : les dictionnaires de prononciation et les balises phonétiques dans les scripts.
Dictionnaires de prononciation pour le text to speech
Les dictionnaires sont particulièrement adaptés lorsque vous disposez d’un ensemble de prononciations personnalisées qui reviennent régulièrement dans vos projets TTS. C’est par exemple le cas si votre entreprise vend des dispositifs médicaux et que vos scripts contiennent régulièrement des termes techniques, des procédures médicales et d’autres contenus propres à votre domaine.
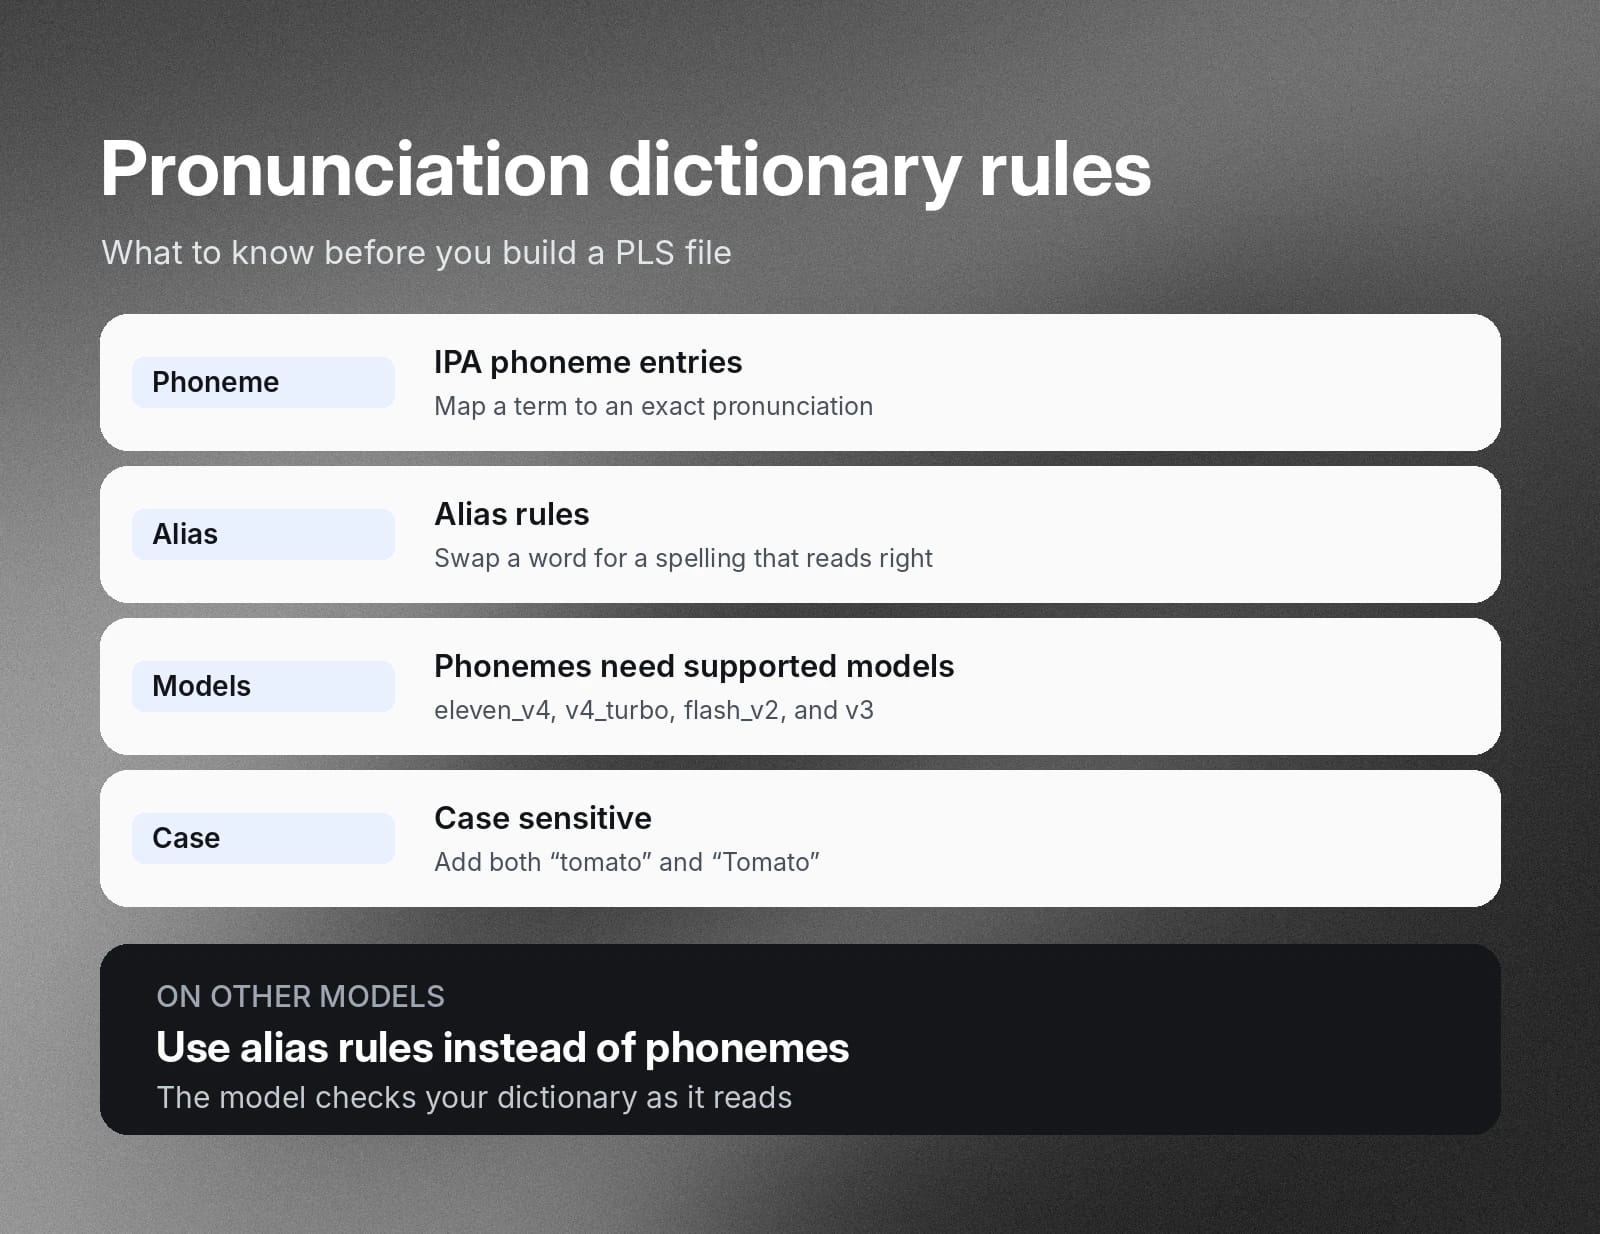
Le format Pronunciation Lexicon Specification (PLS), conforme à la norme W3C, permet d’associer ces termes à des prononciations phonétiques spécifiques à l’aide de la notation de l’Alphabet phonétique international (API). L’Alphabet phonétique international est un alphabet normalisé qui répertorie tous les sons possibles de la parole. Le modèle vocal consulte votre dictionnaire lorsqu’il lit le script et utilise les prononciations indiquées chaque fois qu’il rencontre un mot de votre dictionnaire. Les entrées de phonèmes fonctionnent uniquement avec les modèles eleven_v4, eleven_v4_turbo, eleven_flash_v2 et eleven_v3. Sur les autres modèles, utilisez plutôt des règles d’alias. Les fichiers PLS sont sensibles à la casse : ajoutez donc « tomato » et « Tomato » si vous avez besoin des deux.
Balises phonétiques dans les scripts
Les balises phonétiques sont généralement le meilleur choix lorsque vous devez ajuster des lignes individuelles dans un script. Au lieu de générer un dictionnaire, utilisez des balises phonétiques intégrées qui indiquent au modèle vocal comment prononcer un mot selon l’API.
Par exemple, imaginons que vous écriviez le script d’un podcast et souhaitiez mentionner une experte du secteur deux ou trois fois. Au lieu de l’ajouter à votre dictionnaire de prononciation d’entreprise, balisez simplement son nom avec la prononciation correcte lorsque vous l’utilisez dans le script.
Rédigez et formatez des scripts qui sonnent naturellement à l’oral
Les dictionnaires et les balises sont utiles pour gérer les problèmes liés à des mots individuels dans le rendu vocal, mais ils ne corrigent pas l’élocution, la cadence et la dynamique globale de la parole. Lors de la rédaction d’un script, gardez à l’esprit qu’il sera prononcé à voix haute. Vos choix de mots, vos tournures et votre ponctuation doivent souvent différer de ceux d’un texte simplement destiné à être lu.
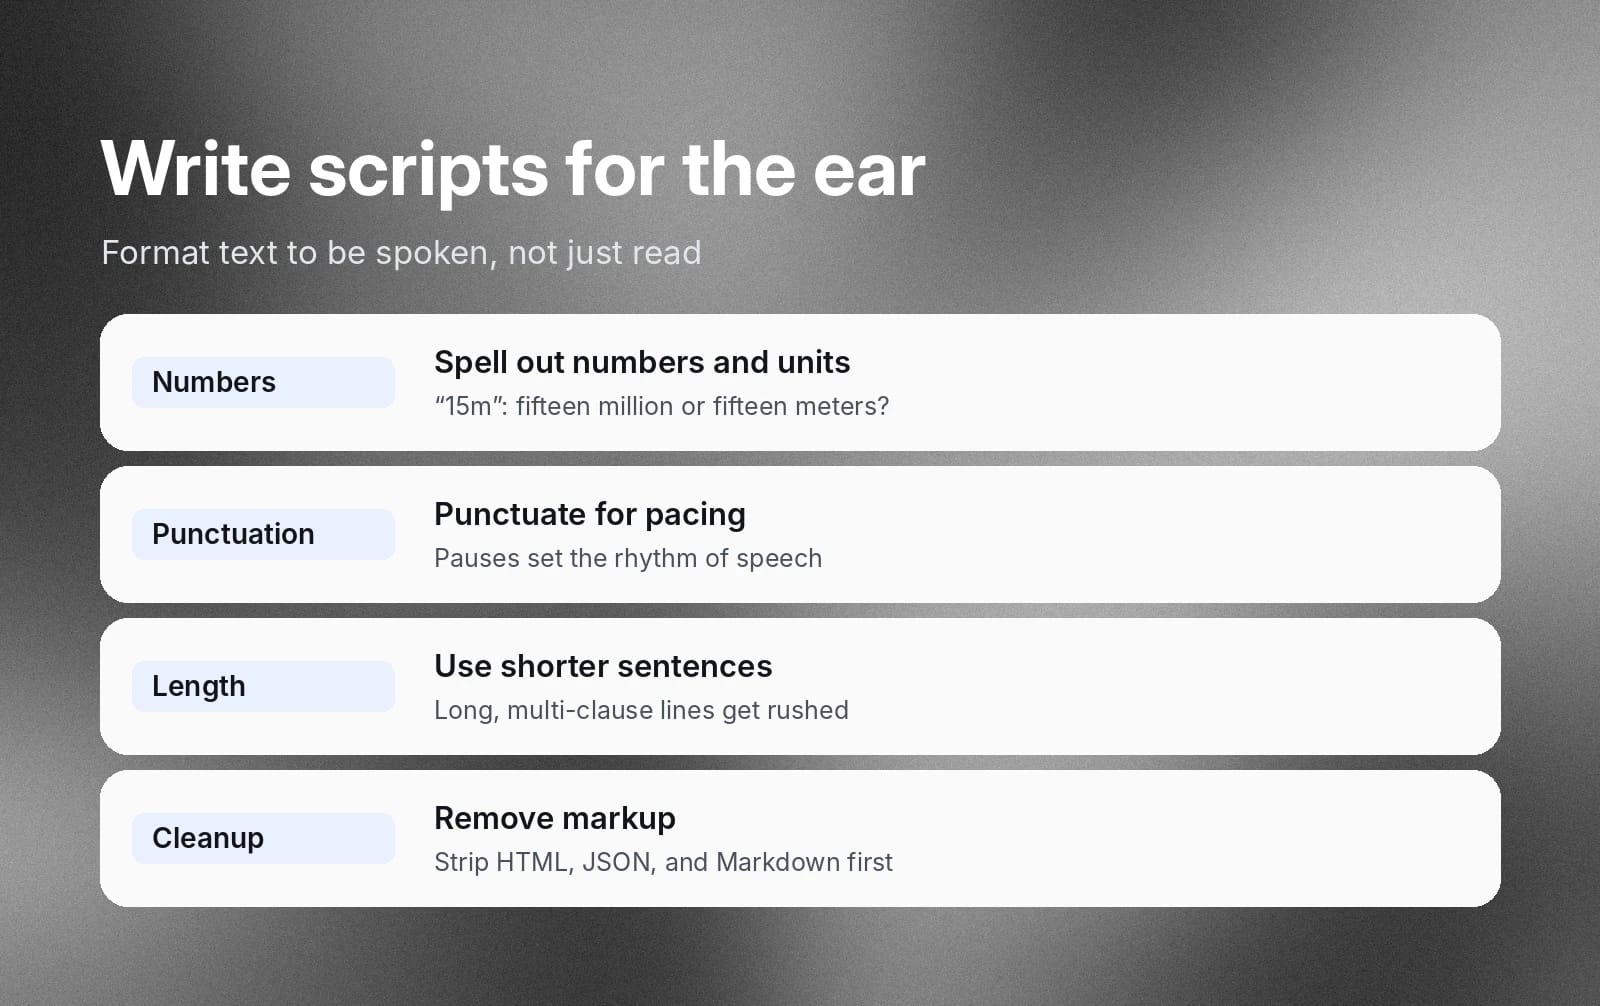
Écrivez pour l’oreille, pas pour l’œil
Abordez la rédaction de votre script comme un discours : « Comment souhaitez-vous qu’il soit prononcé ? Où faut-il faire une pause pour produire un effet dramatique ? Où faut-il accélérer ? » Ces questions s’appliquent autant à un script destiné à des modèles neuronaux de synthèse vocale avancés qu’à un script écrit pour une personne.
Écrivez les nombres, les devises et les dates en toutes lettres
Ne laissez aucune ambiguïté dans vos scripts. Les modèles neuronaux de synthèse vocale comprennent bien le contexte, mais offrent les meilleurs résultats lorsqu’ils n’ont pas à deviner. Les abréviations et les raccourcis sont des éléments sur lesquels ils risquent de buter.
Par exemple, un script peut indiquer : « Vous recherchez un chiffre proche de 15 m. » L’auteur souhaite-t-il que le moteur TTS dise « quinze millions » ou « quinze mètres » ? Écrivez-le en toutes lettres afin que le modèle n’ait pas à deviner selon le contexte.
Utilisez une ponctuation classique pour contrôler le rythme
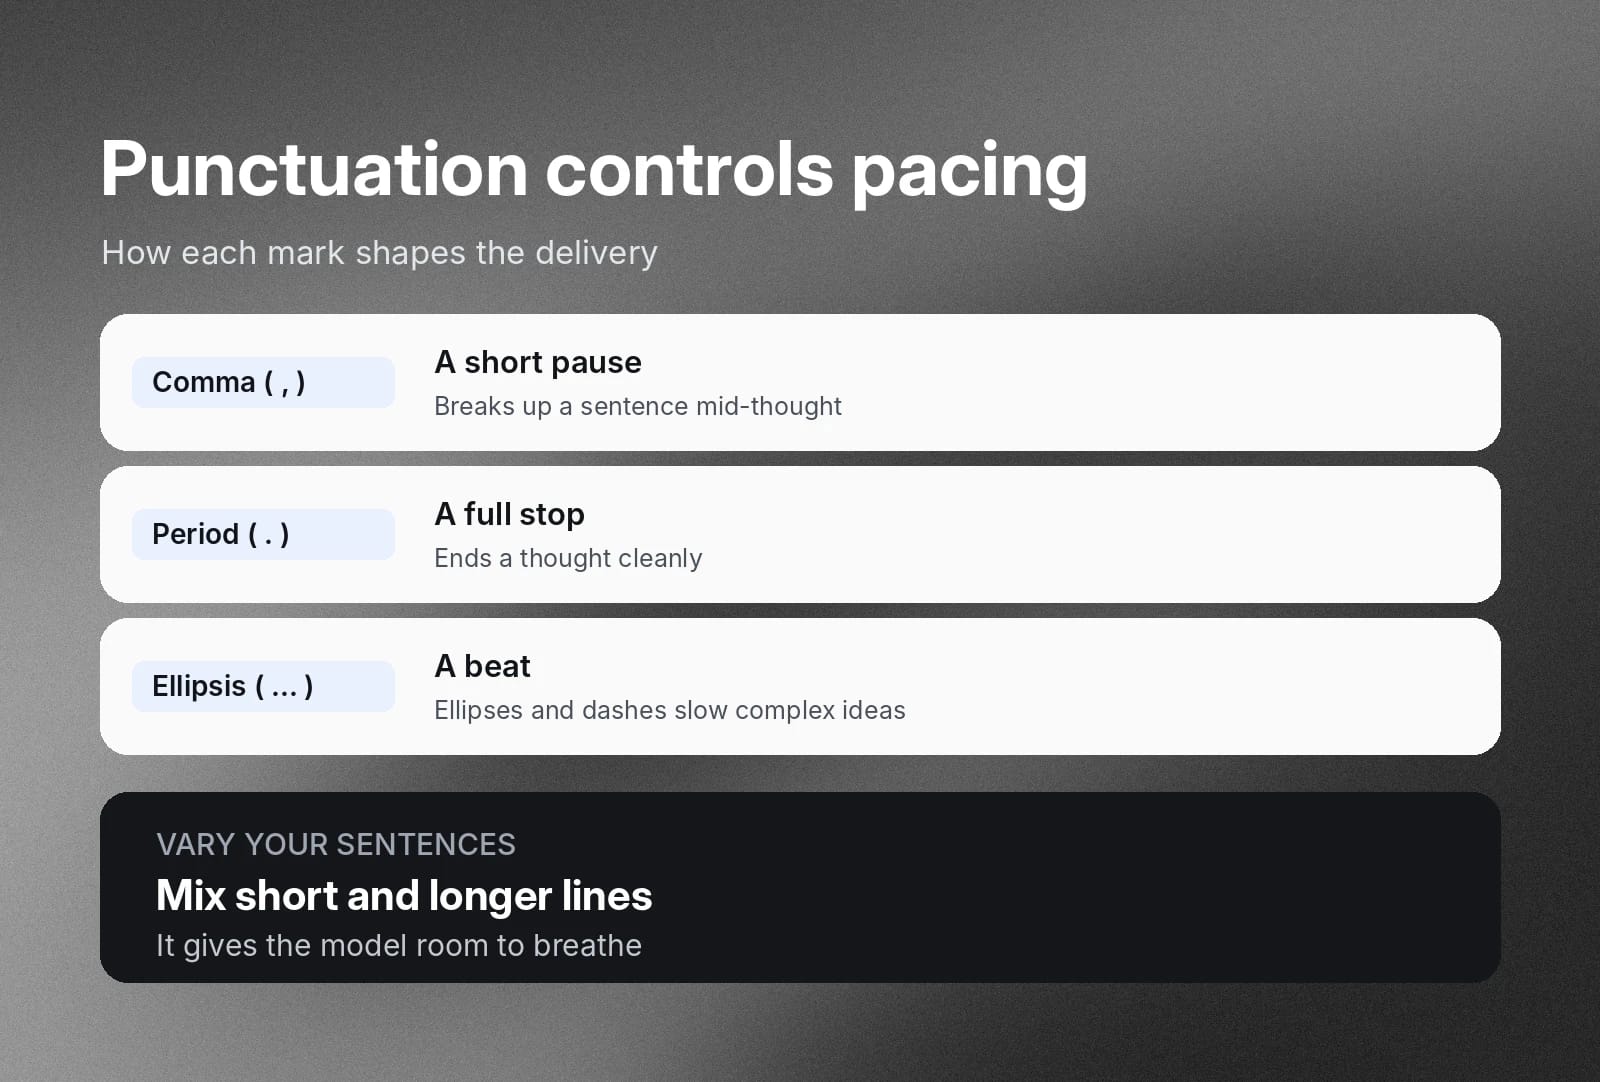
La ponctuation joue un rôle important dans un texte écrit, mais elle compte encore davantage en synthèse vocale. Elle contrôle le rythme. Elle représente différents types de pauses qui permettent de décomposer des idées complexes ou simplement de maintenir une cadence naturelle, plus agréable à écouter.
- Utilisez des virgules pour de courtes pauses au milieu d’une phrase.
- Utilisez des points pour marquer l’arrêt complet d’une idée.
- Utilisez des points de suspension et reformulez vos phrases pour marquer une pause au sein d’idées complexes, afin que votre modèle ne paraisse pas précipité.
Les phrases courtes sont préférables
Les modèles risquent davantage de buter sur des phrases longues, conditionnelles et à multiples propositions, ou de les prononcer trop vite. Scindez-les en énoncés plus courts, de longueurs variées. Le modèle dispose ainsi de davantage d’espace pour respirer et ne se précipite pas lorsqu’il cherche la bonne cadence pour de longues phrases sans fin.
Supprimez les artefacts de mise en forme et de Markdown
Si vous synthétisez une parole extraite d’un système de gestion de contenu ou d’un autre système d’entreprise, elle peut contenir du HTML, du JSON, du Markdown ou d’autres éléments de mise en forme. Supprimez-les et utilisez du texte brut pour obtenir une parole plus naturelle. Les modèles vocaux peuvent avoir du mal à savoir s’ils doivent ignorer ces balises, les lire littéralement ou les intégrer au contexte de leur rendu.
Retrouvez une analyse plus détaillée des erreurs de prononciation et d’autres problèmes dans le guide de dépannage ElevenLabs.
Résoudre les erreurs courantes de l’API ElevenLabs
Les équipes qui produisent de l’audio vocal à grande échelle connectent généralement leurs applications à un modèle de synthèse vocale via une API. Cela rend la production globalement plus efficace, mais ajoute une couche technique à gérer en plus du rendu vocal du modèle.
Le guide des codes d’erreur de l’API ElevenLabs détaille les codes de réponse. Voici toutefois les quatre codes d’état HTTP les plus fréquents lors du dépannage des intégrations de text to speech, ainsi que les moyens d’y remédier.
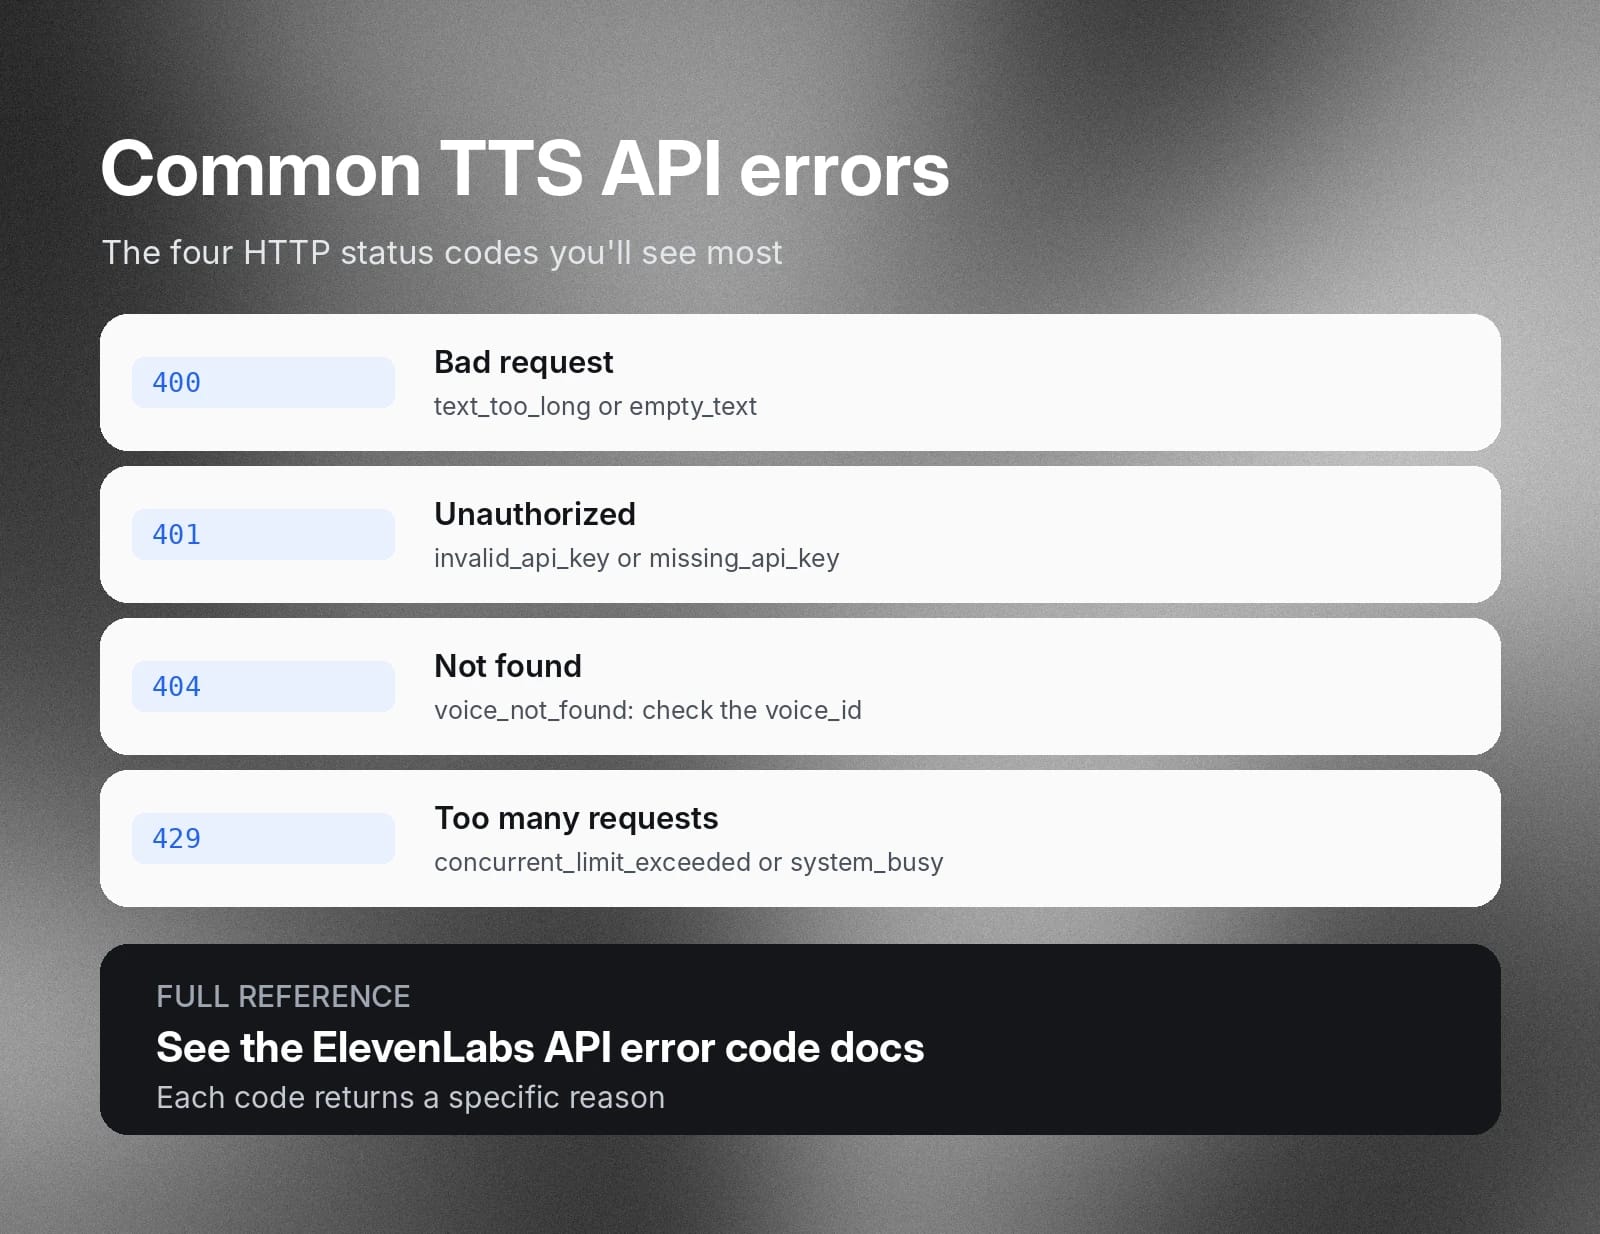
400 Bad Request (erreurs de charge utile)
Une réponse avec le code d’état 400 d’une API de modèle vocal signifie que votre application a envoyé des données que le modèle ne pouvait pas traiter. Dans les flux de travail TTS, cela est généralement dû au dépassement de limites de caractères ou à l’envoi accidentel d’entrées vides.
Limite de caractères dépassée (text_too_long)
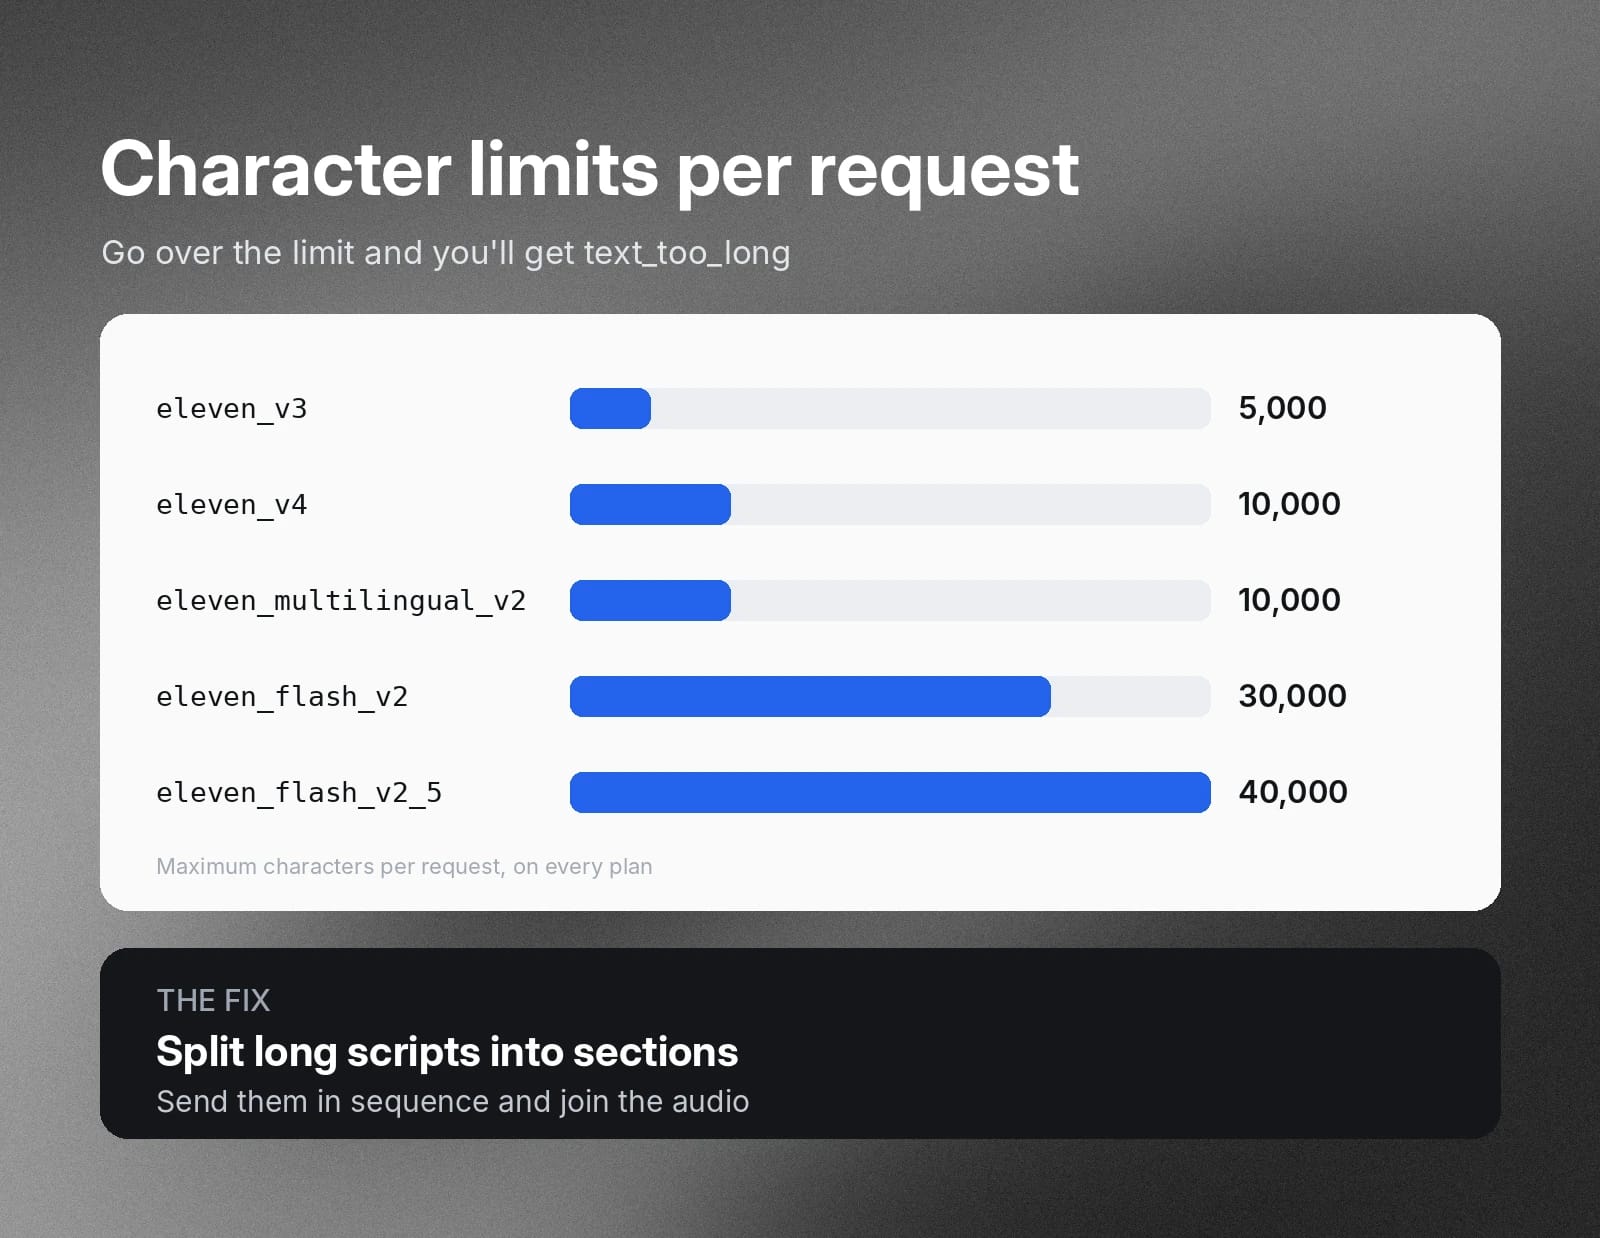
Chaque requête TTS envoyée est soumise à une limite de caractères définie par le modèle. Si vous envoyez plus de texte que la limite autorisée par le modèle, le serveur TTS renvoie cette erreur. Les limites par requête sont de 10 000 caractères pour eleven_v4 et eleven_multilingual_v2, de 5 000 pour eleven_v3, de 30 000 pour eleven_flash_v2 et de 40 000 pour eleven_flash_v2_5, quel que soit le forfait. Pour résoudre ce problème, divisez les scripts plus longs en plusieurs sections que le modèle peut traiter successivement.
Texte saisi vide
Un moteur TTS rejettera toute charge utile contenant des chaînes vides (empty_text). Intégrez des étapes de nettoyage à votre pipeline d’entrée pour supprimer les lignes vides afin que le serveur ne rejette pas une charge utile par ailleurs exploitable.
401 Unauthorized (problèmes d’authentification)
Un code d’erreur 401 signifie que la passerelle API a rejeté vos identifiants et que votre charge utile n’a pas été transmise au modèle. Cela se produit en cas de problème avec la clé API.
Clé API non valide
Votre requête au serveur du modèle doit inclure une xi-api-key valide. Dans le cas contraire, le serveur renvoie une erreur 401. Vérifiez que votre clé est bien présente dans la requête et qu’elle n’a pas été révoquée, n’a pas expiré ou n’a pas été tronquée dans les en-têtes lors du déploiement. L’API renvoie invalid_api_key si la clé est incorrecte et missing_api_key lorsqu’aucune clé n’est envoyée.
404 Not Found (identifiants vocaux non concordants)
Vous recevez une erreur 404 lorsque le point de terminaison ne trouve pas la ressource TTS indiquée dans la requête URL. Cela peut se produire si vous envoyez un mauvais paramètre voice_id ou si celui-ci est absent de l’URL de la requête. Assurez-vous d’avoir obtenu le bon voice_id. Vérifiez qu’il est bien présent dans les paramètres de chemin et qu’il ne contient pas de faute de frappe. L’API renvoie voice_not_found lorsque l’identifiant vocal n’existe pas.
429 Too Many Requests
Cette erreur a deux causes distinctes : vous avez atteint votre limite de requêtes simultanées pour votre niveau de service, ou la plateforme TTS limite les requêtes pour gérer un pic de trafic.
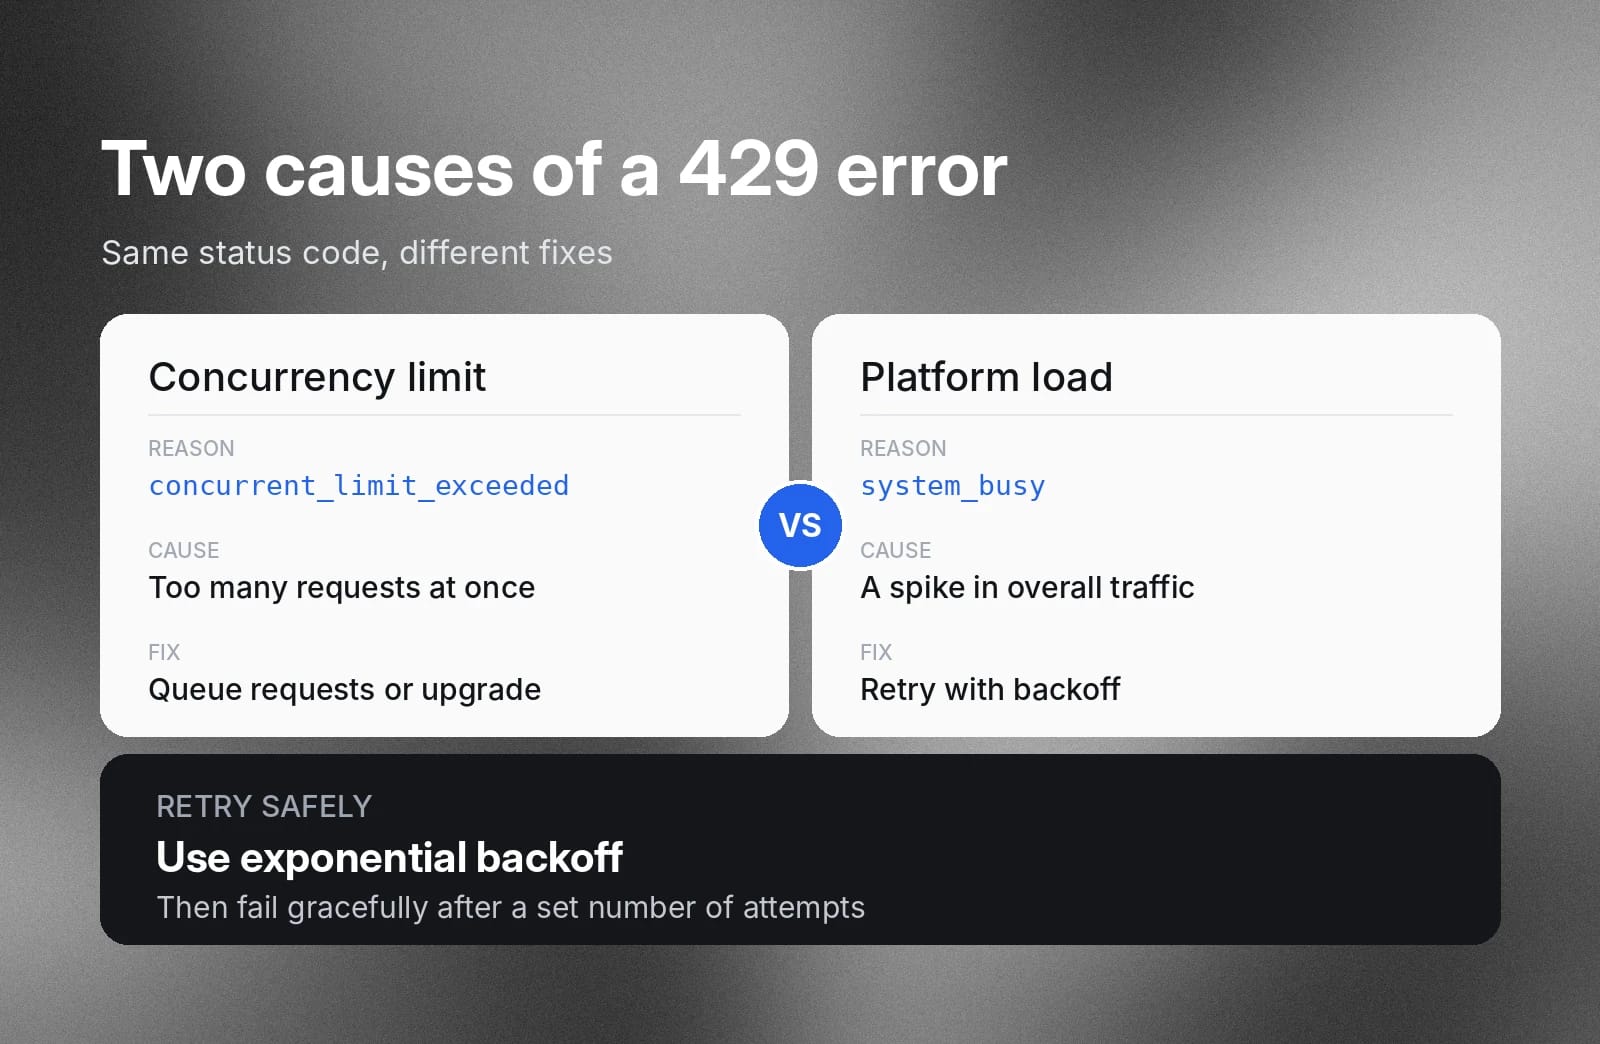
Limites de requêtes simultanées (concurrent_limit_exceeded)
Chaque niveau d’abonnement à un moteur TTS définit un nombre fixe de requêtes simultanées que vous pouvez envoyer. Si vos applications dépassent cette limite, le serveur renvoie ce type d’erreur 429.
Concevez une couche de mise en file d’attente asynchrone avec un service tel que Redis pour réguler vos charges utiles sortantes afin qu’elles ne dépassent pas les limites de votre niveau de service. Vous pouvez aussi évaluer la pertinence économique d’un abonnement à un niveau supérieur.
Pics de charge de la plateforme (system_busy)
En cas de forte charge, un serveur TTS peut limiter les requêtes entrantes afin de maintenir ses performances. Intégrez une logique de nouvelle tentative automatisée au client API de votre application. Assurez-vous qu’il peut réessayer avec un délai exponentiel, puis échouer proprement après un nombre maximal de tentatives.
Testez les voix, les langues et les paramètres avant de publier
Un test rapide dans une application web ne constitue généralement pas un contrôle qualité suffisant pour des charges utiles TTS à grande échelle. Le coût de mauvaises exécutions peut vite s’accumuler. Testez votre script au cours d’une série d’itérations contrôlées avant de l’envoyer. Cette préparation en amont vous aidera à produire plus efficacement un audio vocal de la meilleure qualité.
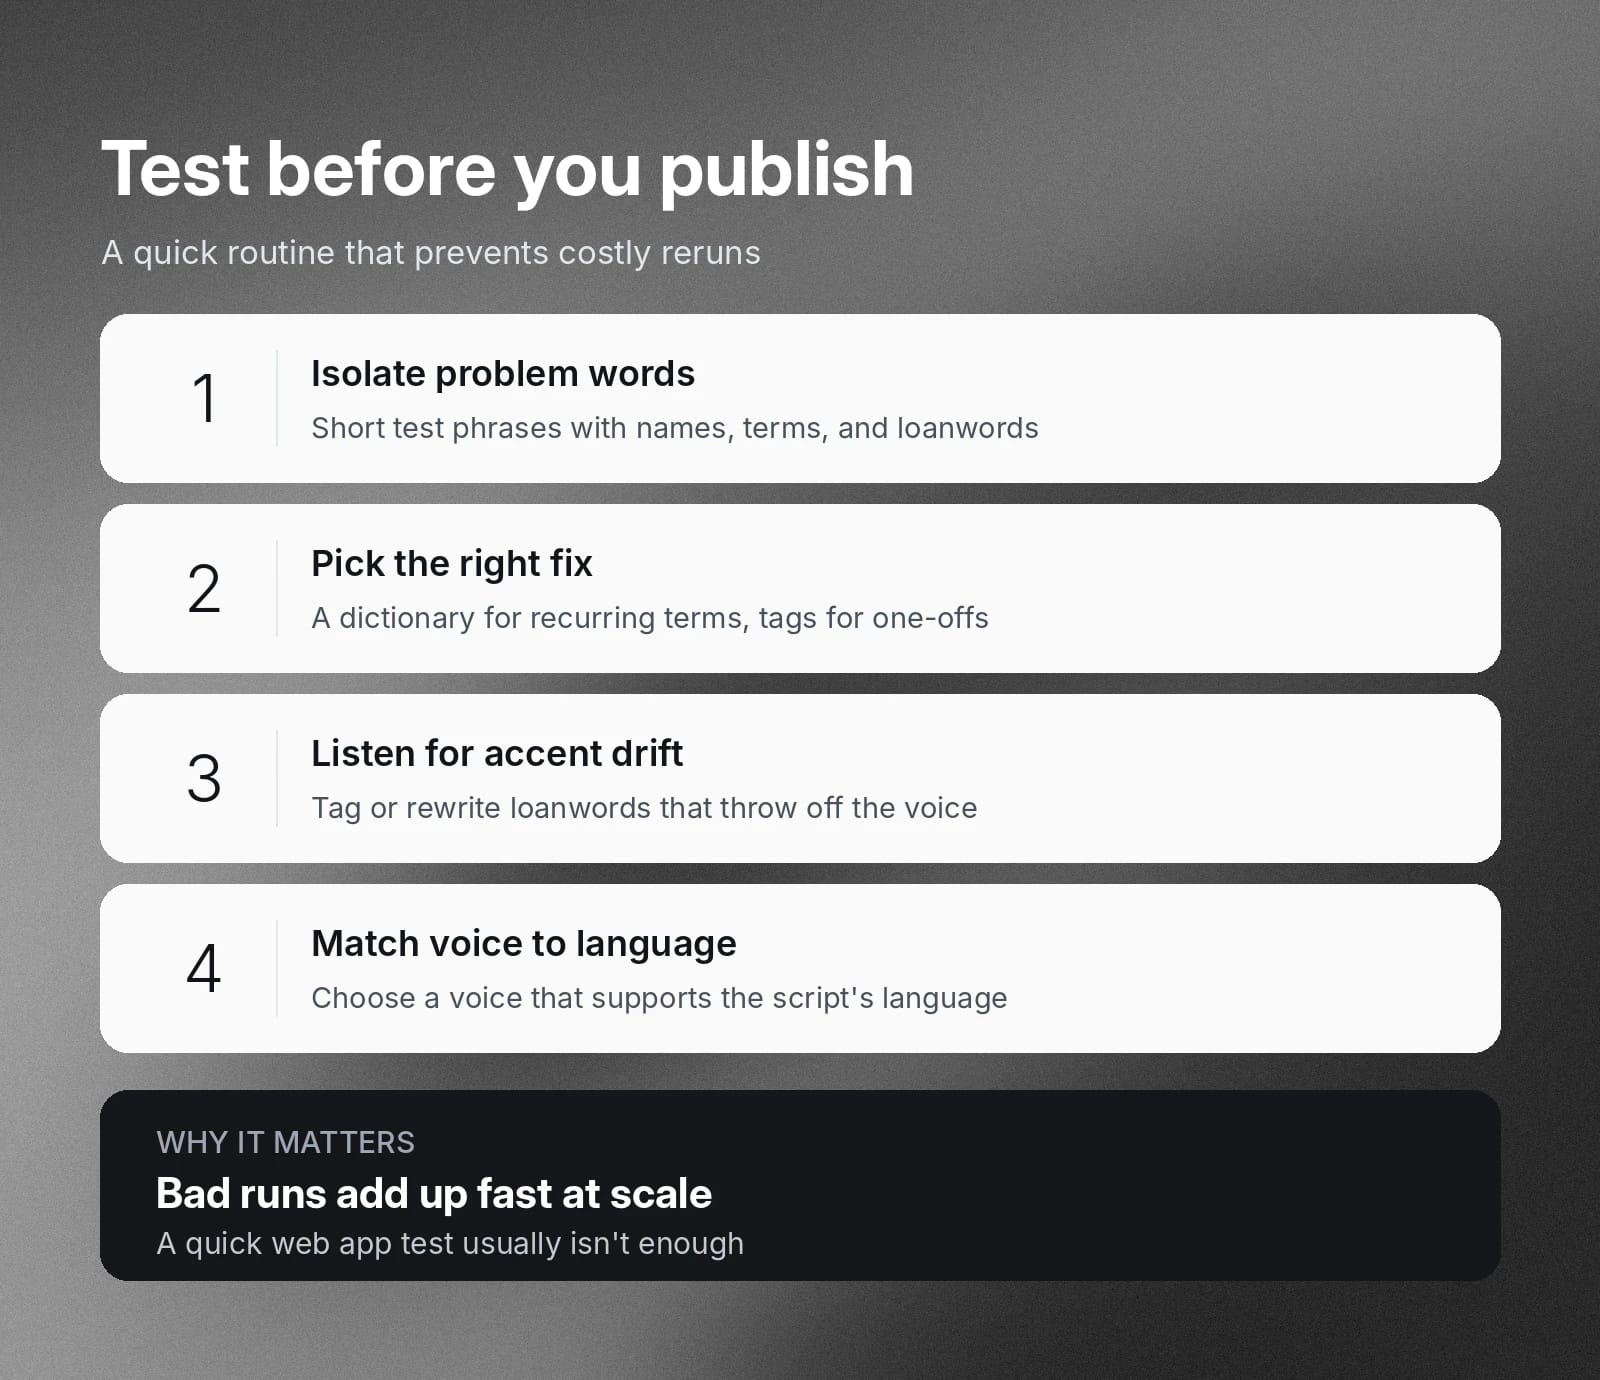
Testez les mots problématiques de manière isolée
Vos problèmes concerneront généralement des passages précis ou seulement certains mots ou noms, plutôt qu’un problème généralisé. Créez des phrases de test de cinq à dix mots contenant vos noms de marque, termes techniques ou expressions en langue étrangère. Selon les rendus obtenus, déterminez si vous souhaitez utiliser un dictionnaire de prononciation ou uniquement des balises phonétiques pour chacun d’eux.
Identifiez une possible dérive de langue ou d’accent
Les modèles vocaux peuvent occasionnellement adopter une cadence étrange ou lente au milieu d’une phrase. Cela se produit souvent lorsque le modèle doit deviner comment prononcer un passage différent de ce qu’il a rencontré lors de son entraînement.
- Mots empruntés : un texte contenant des emprunts obscurs à une langue étrangère peut perturber l’association des graphèmes par le modèle et donner à toute la parole qui suit un accent inhabituel. Utilisez des balises phonétiques sur le mot emprunté ou reformulez.
- Parole peu naturelle dans une langue autre que l’anglais : un modèle optimisé pour l’anglais peut bégayer ou sembler robotique lorsqu’il lit un script traduit. Sélectionnez un profil vocal qui prend également en charge la langue maternelle.
Essayez ElevenAPI dès aujourd’hui pour un rendu vocal plus fiable
Lorsque vous savez ce qu’il faut surveiller, vous générez plus rapidement du contenu vocal de qualité avec moins de difficultés. Identifiez comment gérer les problèmes de rendu et les problèmes techniques d’API susceptibles de bloquer la production.
Découvrez comment générer un contenu TTS précis et de haute qualité avec ElevenAPI ou obtenez votre clé API dès aujourd’hui.
Questions fréquentes sur les problèmes de text to speech

Jack Limebear fait partie de l’équipe Growth, où il rédige et conçoit des contenus pour le blog et les pages d’analyses. Avant de rejoindre ElevenLabs, il a passé plus de dix ans à piloter la stratégie de contenu pour des organisations allant de start-ups SaaS en forte croissance à des entreprises du Fortune 500. Il est titulaire d’un master en littérature anglaise de l’Université de Cambridge.