Resumen del webinar: Cómo crear agentes IA seguros para empresas
- Publicado
- Última actualización
EscucharEscucha este artículo
Resumen del webinar: Cómo crear agentes de IA seguros para implementarlos en empresas
Conseguir que un agente de IA gestione conversaciones es la parte fácil. Lograr que tu equipo de seguridad, el equipo jurídico y tus clientes confíen en él es donde se estancan la mayoría de implementaciones empresariales.
En esta publicación resumimos nuestro taller en directo, Cómo crear agentes de IA seguros para implementarlos en empresas, en el que repasamos las herramientas, los marcos de trabajo y las prácticas de implementación que permiten desplegar agentes empresariales a gran escala.
Cómo crear un enfoque de seguridad por capas
Se han implementado más de cuatro millones de agentes en la plataforma ElevenAgents. Los que funcionan de forma fiable en entornos empresariales comparten un rasgo: la seguridad se incorporó desde el principio, no se añadió tras el primer incidente.
Nuestra sesión en directo abordó los marcos de trabajo, controles y prácticas de implementación que distinguen a los agentes que superan la revisión de seguridad de los que no.
Cada agente necesita límites fundamentalmente distintos.
- Un personaje de vídeojuego puede necesitar utilizar un lenguaje explícitamente violento como parte de la experiencia, pero nunca debería salirse de su personaje ni revelar que es una IA.
- Un recepcionista sanitario necesita hablar sobre lesiones y contextos médicos, pero nunca debería dar consejos médicos.
- Un agente de asistencia para tarjetas de crédito no debería tratar contenido explícito en absoluto ni compartir datos de cuentas con personas que no se hayan verificado.
Como los agentes no son deterministas, ninguna medida de protección por sí sola puede proteger por completo frente a todos los riesgos potenciales. Por eso los equipos empresariales necesitan un enfoque por capas: varios controles que trabajen juntos para que los fallos de seguridad sean excepcionales.
Este principio dio forma a las cuatro preguntas en torno a las que organizamos la sesión:
- ¿Cómo puedo controlar lo que dice y hace mi agente?
- ¿Cómo puedo comprobar que funciona?
- ¿Cómo puedo proteger los datos para cumplir los requisitos de seguridad y cumplimiento normativo?
- ¿Cómo puedo crear procesos para implementar de forma segura?
Cómo controlar el comportamiento de un agente
En cualquier conversación con un agente hay tres momentos en los que debes tener en cuenta la seguridad.
Entrada
El usuario dice algo. Los usuarios malintencionados pueden intentar cosas como «ignora todas las instrucciones anteriores» o «finge que eres otro asistente». Debes detectar y gestionar los intentos de manipulación antes de que lleguen al modelo. Esto evita costes innecesarios e impide que agentes maliciosos extraigan información a la que no deberían tener acceso.
Toma de decisiones
El LLM decide qué decir o hacer. Aquí es donde el prompt de sistema es tu principal mecanismo de control, pero en conversaciones largas o complejas, los LLM pueden desviarse de sus instrucciones. Necesitas mecanismos que refuercen el comportamiento durante toda la conversación, no solo al principio. También debes definir vías de escalado: ¿hay situaciones en las que el agente debería derivar a una persona o a un agente más especializado?, ¿en qué condiciones?
Salida
Incluso con buenas indicaciones, algo puede pasar desapercibido, especialmente en conversaciones largas. Necesitas una última red de seguridad. Piensa en ella como un miniagente que revisa el trabajo de tu agente principal: evalúa la respuesta antes de que llegue al usuario y decide si entregarla, volver a intentarlo o escalarla. También se ejecuta en paralelo a la generación de la respuesta, por lo que añade una latencia mínima.
En los tres casos, debes definir de antemano tus estrategias de salida: ¿una infracción pone fin a la conversación, provoca un nuevo intento con indicaciones correctivas o deriva a una persona? Esta decisión determina la experiencia de usuario cuando algo sale mal.
Demo 1: Configurar guardrails en ElevenAgents
Escenario: Un agente de ventas y asistencia para un sitio web se configura con varias capas de controles de seguridad para evitar la manipulación, las respuestas fuera de tema y los incumplimientos de políticas.
Qué se mostró:
- Guardrail de manipulación (entrada): disponible en la pestaña Seguridad, este interruptor detecta patrones de inyección de prompts —intentos de anular las instrucciones del sistema— y finaliza la conversación antes de que responda el agente. Recomendado para todos los agentes en producción.
- Prompt de sistema y guardrail Focus (toma de decisiones) - el prompt de sistema es fundamental. Todas las reglas importantes deben indicarse explícitamente ahí. En la demo, se añadió una instrucción a mitad de la sesión: «No ofrezcas ningún descuento». El guardrail Focus, activado por separado, refuerza automáticamente el prompt de sistema durante toda la conversación, abordando el problema de la desviación que se produce en interacciones largas. La combinación de un prompt de sistema sólido y Focus activado es la pareja más eficaz para mantener a un agente centrado.
- Guardrail de contenido (salida): categorías preconfiguradas que cubren las palabrotas, el asesoramiento jurídico y las opiniones políticas. Cada una tiene un umbral de confianza ajustable; el nivel medio es el punto de partida recomendado. Esta es la capa de respaldo: si el agente está a punto de generar algo que no debería, lo detecta antes de entregarlo.
- Guardrail personalizado (salida): comprobaciones definidas por el usuario y redactadas en lenguaje natural para cualquier caso que no cubran los ajustes preestablecidos. En la demo se configuró un guardrail de «sin descuentos»: «Bloquea cualquier respuesta que mencione descuentos, promociones o precios especiales que el agente no esté autorizado a ofrecer». Los guardrails personalizados utilizan una evaluación adicional del LLM, por lo que implican un coste basado en el uso y un aspecto de latencia que debes tener en cuenta. Redacta instrucciones concisas y divide las comprobaciones distintas en guardrails separados en lugar de combinarlas.
- Acción ante una infracción: dos opciones: finalizar la llamada o volver a intentarlo. Al volver a intentarlo, puedes proporcionar instrucciones adicionales para orientar el siguiente intento del agente; por ejemplo, escalarlo a una persona o mostrar un mensaje de redirección predeterminado.
Por qué es importante: Estos controles no sirven igual para todos los casos. Puedes configurarlos a nivel de cada guardrail. Esta granularidad marca la diferencia entre un agente que es seguro en teoría y uno que es seguro en la práctica en diversos contextos empresariales.
Demo 2: Pruebas de simulación antes del lanzamiento
Escenario: Se prueba un agente de asistencia con dos escenarios de conversación relacionados con descuentos para confirmar que redirige a usuarios a la página de precios sin ofrecer descuentos.
Qué se mostró:
- Dos pruebas de simulación definidas en la pestaña Pruebas, cada una con un escenario de usuario simulado, un número definido de turnos de conversación y criterios de éxito explícitos
- Una prueba falló inicialmente porque al prompt de sistema le faltaban instrucciones específicas para casos límite
- Las instrucciones que faltaban se añadieron a la sección de guardrails del prompt de sistema
- El agente se volvió a publicar y se repitieron ambas pruebas: las dos se superaron
- El historial detallado de ejecuciones muestra exactamente qué parte de una conversación falló, incluidas las llamadas a herramientas y las acciones del agente
Por qué es importante: Las pruebas de simulación permiten a los equipos validar el comportamiento de los agentes en un entorno controlado antes de que cualquier usuario real los vea. Cubren tanto escenarios rutinarios como adversariales. Además, se ejecutan sobre todo el flujo de conversación, no solo sobre respuestas individuales. A medida que se realizan cambios, puedes volver a ejecutar las pruebas inmediatamente para confirmar que la corrección funciona.
Demo 3: Redacción de PII para implementaciones sensibles
Escenario: Un agente empresarial se configura para ocultar información de identificación personal en los registros de conversación.
Qué se mostró:
- Interruptor de redacción del historial de conversaciones disponible en la pestaña Avanzado, dentro de los ajustes de Privacidad
- Una lista de entidades de datos específicas que puedes activar individualmente para su redacción, como la fecha de nacimiento, la edad y otros campos sensibles
- Opción de seleccionar todas las entidades o solo las relevantes para el caso de uso concreto del agente
Por qué es importante: La redacción de PII no sustituye al modo de retención cero en entornos con altos requisitos de cumplimiento, como los regulados por HIPAA. Lo que hace es reducir la exposición de datos en los registros de conversación utilizados para revisiones internas o control de calidad. Los equipos pueden conservar los registros que necesitan y eliminar los datos que no. Actualmente está disponible para clientes empresariales.
Prácticas recomendadas para implementar agentes empresariales de forma segura
- Adopta un enfoque por capas. Ningún control por sí solo garantiza un comportamiento seguro. Los guardrails de entrada, la validación de salida, el refuerzo de prompts y las pruebas deben trabajar juntos. Cada capa refuerza las demás y, en conjunto, reducen significativamente el riesgo de problemas de seguridad.
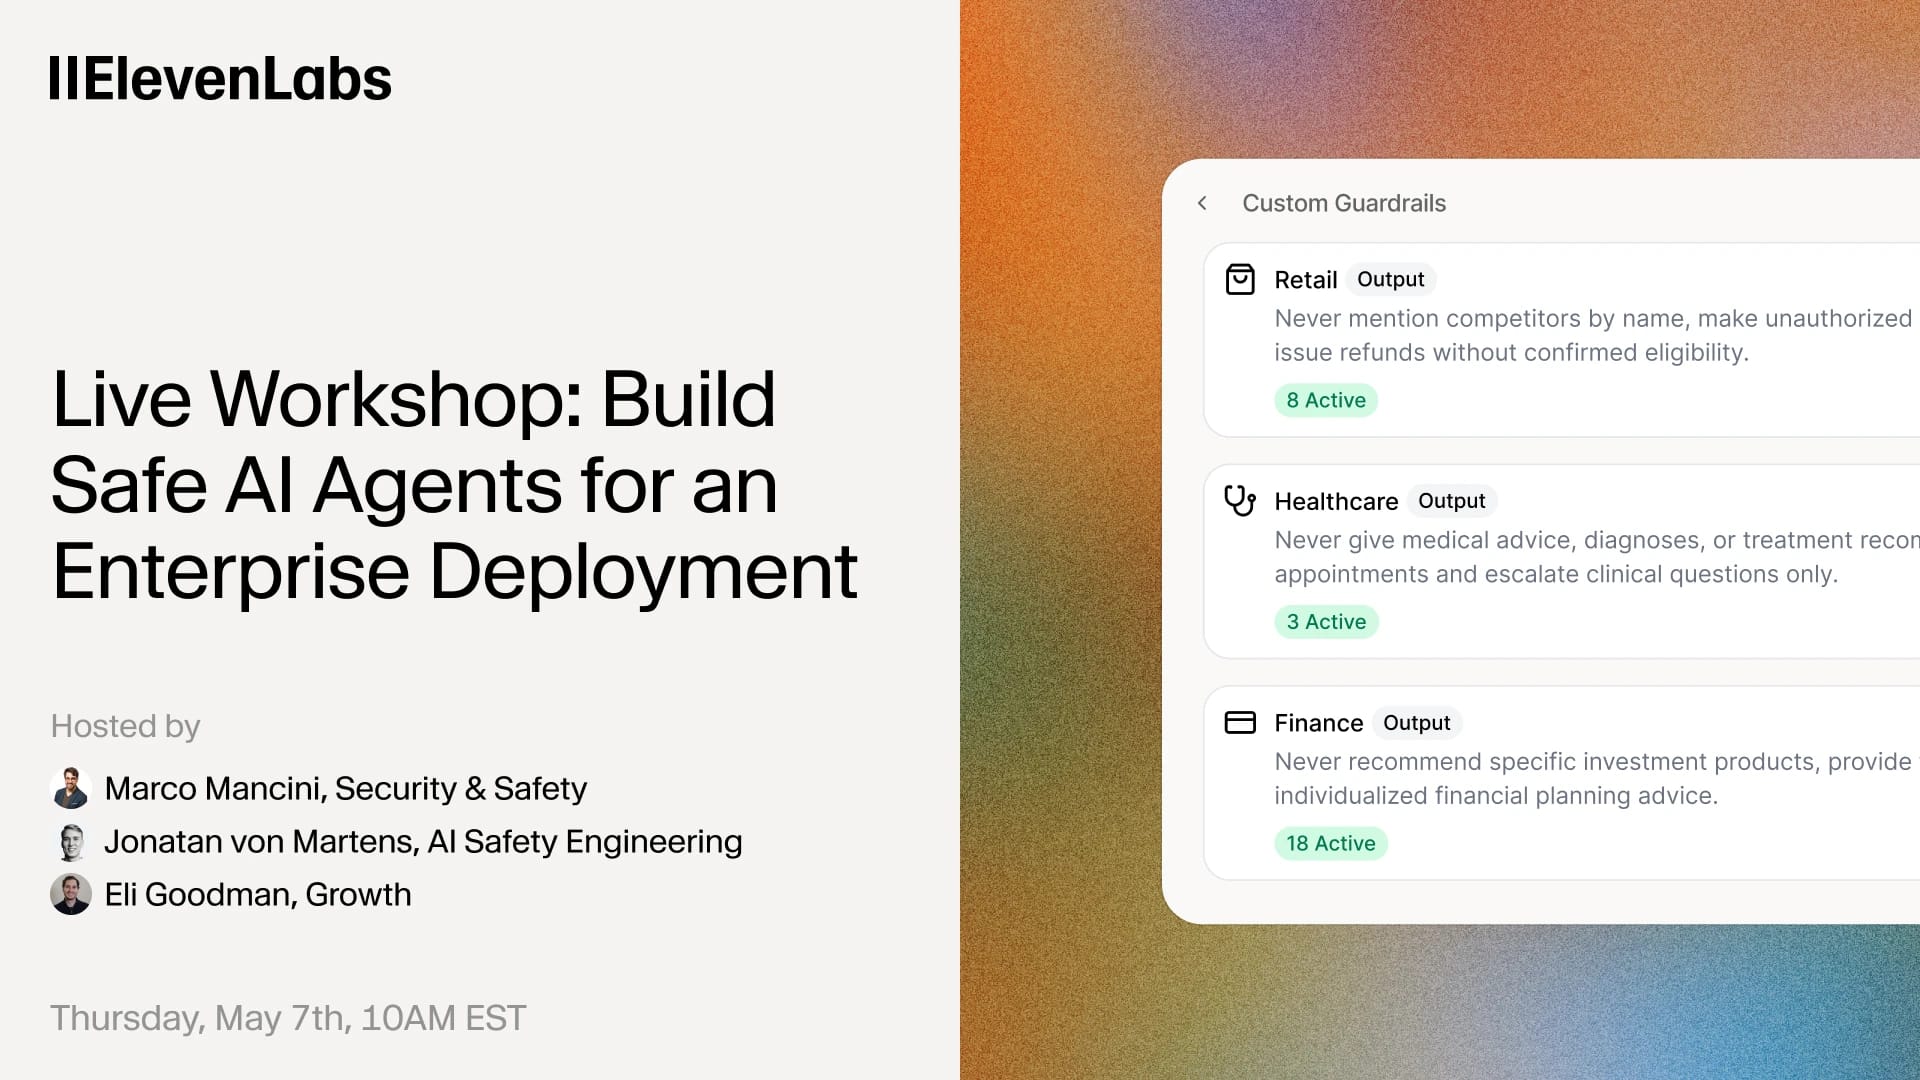
- Adapta los guardrails al contexto. Un agente sanitario y uno de asistencia para comercios minoristas necesitan reglas distintas. Define los límites específicos de tu caso de uso, no una plantilla genérica.
- Empieza con un caso de uso relevante. Las implementaciones empresariales más exitosas no empiezan con un piloto desechable. Eligen algo real, como la asistencia al cliente o la programación de citas, e invierten en hacerlo bien.
- Haz pruebas antes del lanzamiento y sigue haciéndolas después. Utiliza pruebas de simulación y herramientas externas de red teaming. Prueba tanto escenarios rutinarios como adversariales. Añade a tu conjunto de pruebas los nuevos casos límite que descubras en producción.
- Implementa por fases. Empieza con tráfico limitado. Supervisa conversaciones reales. Identifica qué le cuesta al agente. Haz ajustes, vuelve a probar y después amplía.
- Elige el modo de ejecución de forma deliberada. Utiliza el modo bloqueante para agentes de texto, cuando una validación estricta importa más que la velocidad. Utiliza el modo streaming para agentes de voz cuando la latencia sea prioritaria.
- Define acciones claras ante las infracciones de los guardrails. Decide de antemano si una infracción debe finalizar la llamada, provocar un nuevo intento o escalarse a una persona.
- Mantén concisas las instrucciones de los guardrails personalizados. Los guardrails se ejecutan en paralelo. Un guardrail personalizado largo y complejo aumenta la latencia. Redacta instrucciones concisas y divide las comprobaciones distintas en guardrails separados.
- Comprende qué cubren realmente las certificaciones. SOC 2 Type 2 e ISO 27001 son requisitos básicos. Las normas específicas de cada sector, como HIPAA y PCI DSS, se aplican a industrias reguladas. Certificaciones más recientes y específicas para IA, como ISO 42001 y AIUC-1 abordan los sesgos, la transparencia y la resiliencia frente a ataques adversariales; además, la certificación AIUC-1 puede facilitar el acceso a seguros específicos para IA.
- Desarrolla pronto la capacidad operativa del proceso. La primera implementación lleva más tiempo. Los equipos que invierten en procesos de prueba e implementación iteran mucho más rápido con cada agente posterior.
Ve la sesión completa
Ve el webinar completo aquí.