Nuestro marco de seguridad por capas para agentes IA
- Escrito por
- Louise Meyer-Schoenherr
- Publicado
- Última actualización
EscucharEscucha este artículo
A medida que los agentes de IA asumen tareas de alto impacto, los equipos necesitan confiar en que sus agentes se comportarán de forma segura y predecible.
En ElevenAgents utilizamos una arquitectura de seguridad por capas, con guardrails en cada fase de la conversación, pruebas adversariales antes del lanzamiento, supervisión en producción, protección de datos y validación independiente.
Aunque ningún sistema no determinista puede proteger frente a todos los riesgos, este completo marco de seguridad permite a las principales empresas y administraciones públicas que desarrollan con ElevenAgents diseñar agentes que fallen en pocas ocasiones, se recuperen con soltura y cumplan unos altos estándares de seguridad.
Protección en cada fase de la conversación
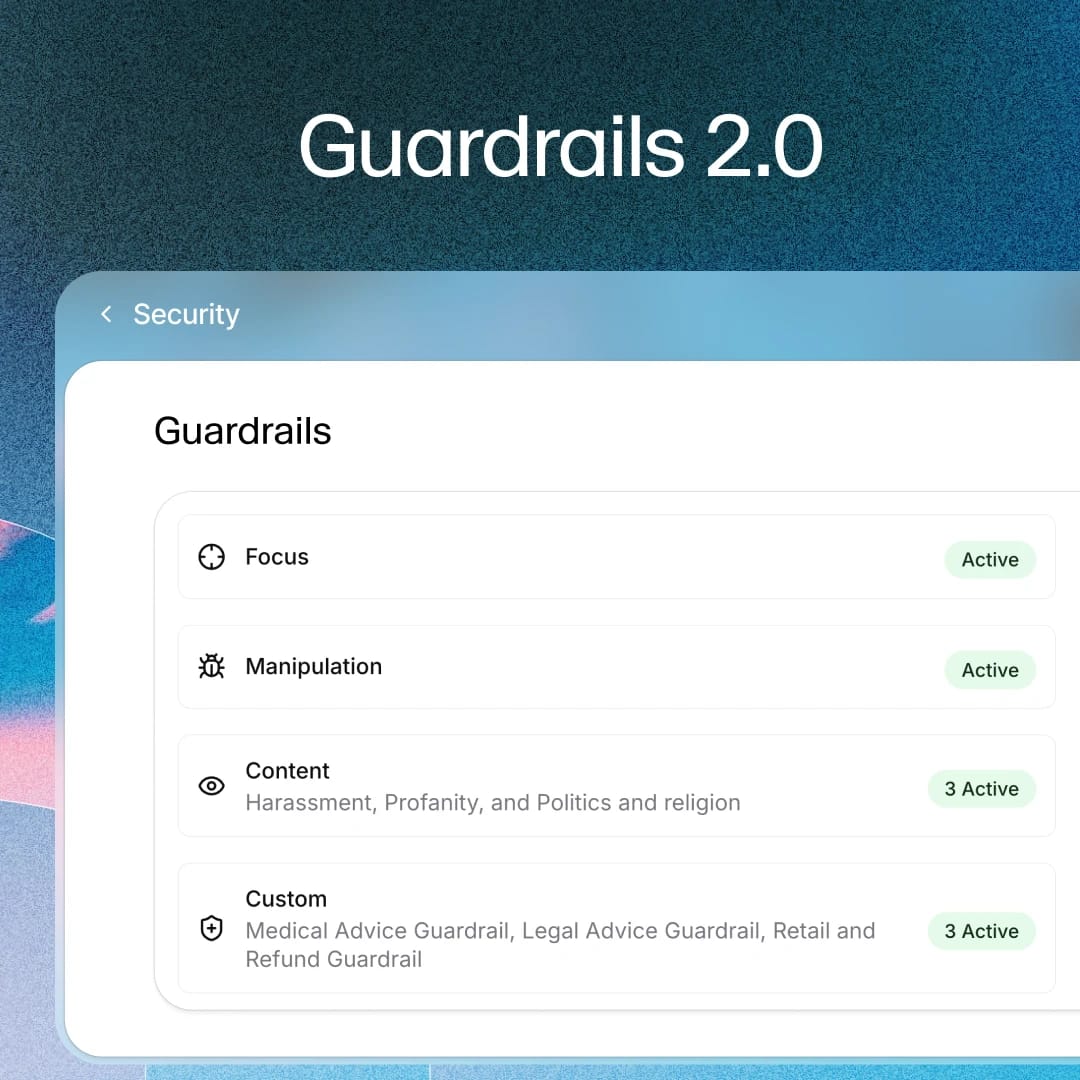
Puedes activar y configurar fácilmente controles que protegen las tres fases de cada interacción. Esta es la base de Guardrails 2.0 en ElevenAgents.
Entrada - Comprobaciones en tiempo real de lo que envía el usuario.
- Guardrails de manipulación analizan de forma independiente las entradas del usuario y pueden finalizar conversaciones que muestren señales de inyección de prompts.
Decisión - Cómo se guía al agente y se mantiene en el rumbo mientras decide qué hacer.
- Los prompts de sistema deben incluir instrucciones explícitas para el agente, como evitar temas inapropiados, definir cómo se presenta el agente y limitar su alcance.
- Los workflows y procedimientos pueden restringir las acciones más sensibles mediante llamadas a herramientas, por ejemplo verificando la identidad de quien llama antes de compartir cualquier detalle de la cuenta.
- El guardrail Focus refuerza las instrucciones de sistema existentes y mitiga las desviaciones, algo especialmente importante en interacciones largas o complejas.
Salida - Los validadores independientes se ejecutan en paralelo a la generación de respuestas y añaden una latencia mínima. Puedes activarlos para bloquear respuestas que incluyan contenido sensible o incumplan tus políticas.
- Guardrails de contenido detectan categorías sensibles con umbrales para cada categoría.
- Guardrails personalizados aplican reglas específicas de cada ámbito redactadas en lenguaje natural, evaluadas individualmente por un modelo ligero.
- Estrategias de salida te permiten definir qué ocurre cuando se activa un guardrail, como finalizar la llamada, transferirla a una persona o volver a generar la respuesta con instrucciones correctivas.
Pruebas exhaustivas antes del lanzamiento
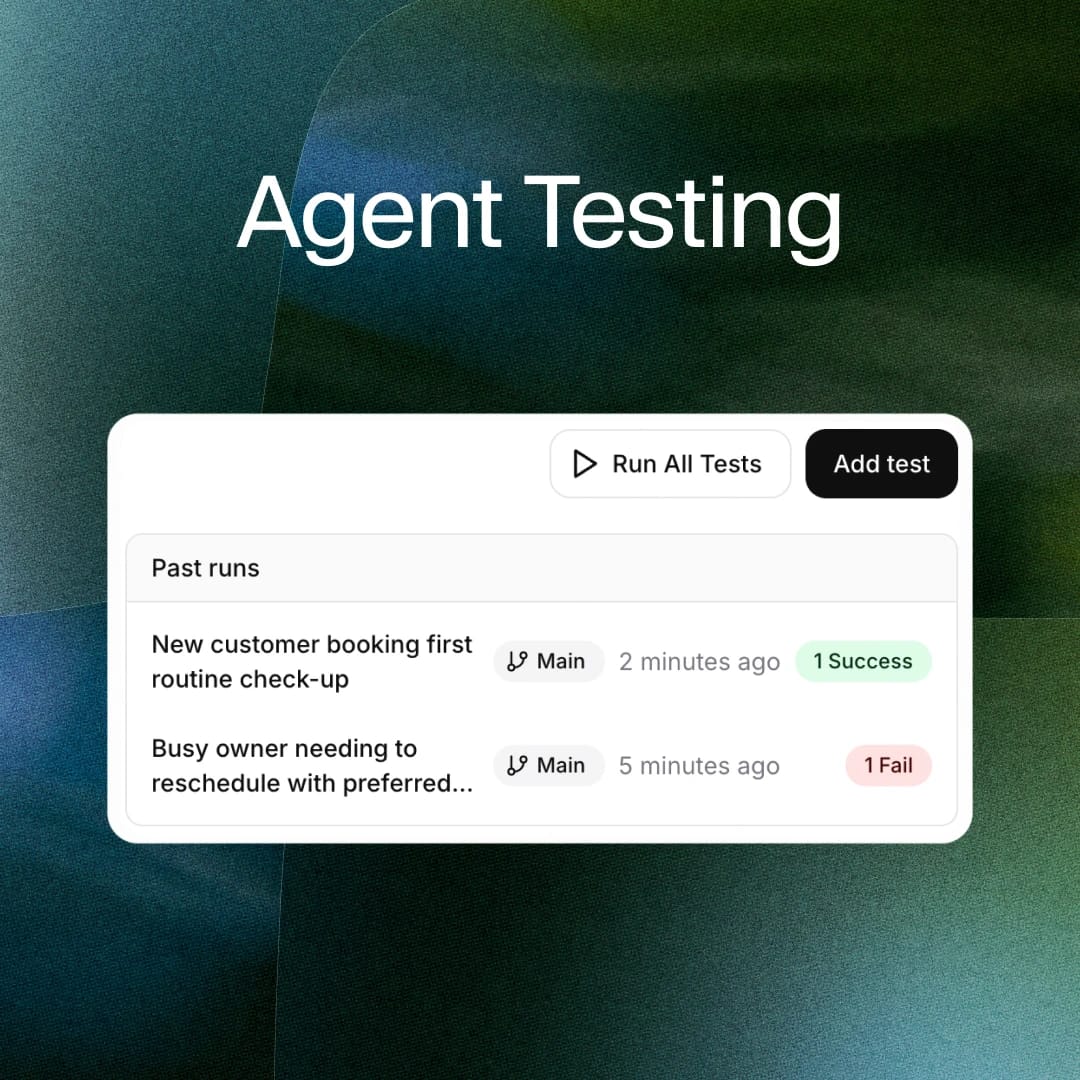
ElevenAgents ofrece funciones de prueba exhaustivas para que quienes desarrollan en la plataforma puedan detectar y solucionar problemas antes de poner en marcha un agente o un cambio de configuración.
Las simulaciones te permiten ejecutar una conversación completa de varios turnos con un usuario simulado antes de cualquier interacción real. Tú defines el escenario y el simulador lleva la conversación hasta su resolución, incluidas llamadas a herramientas reales o simuladas. Como controlas al usuario simulado, puedes hacer que sea hostil o manipulador, de modo que el mismo mecanismo que valida los recorridos habituales también pone a prueba los adversariales.
Varias funcionalidades amplían esta cobertura:
- Ejecuciones repetidas ejecutan una prueba muchas veces y agrupan los fallos por motivo para detectar patrones de error y casos límite.
- Pruebas de siguiente respuesta e invocación de herramientas comprueban respuestas individuales y acciones críticas.
- Pruebas específicas por canal verifican que un agente funcione como se espera en cada canal en el que se publica, ya que sus respuestas se pueden adaptar por canal (por ejemplo, ser conciso en una llamada y detallado por correo electrónico).
- Red-teaming mediante la API. También puedes ejecutar pruebas mediante la API con SDK de red-teaming.
Evaluar y mejorar agentes después del lanzamiento
Al desplegar tus agentes, las evaluaciones se ejecutan de forma continua en conversaciones reales. Con un enfoque de LLM como juez, cada llamada se puede evaluar automáticamente según los criterios que establezcas. Puedes revisar los resultados de las conversaciones en paneles y rastrear problemas con registros detallados que incluyen transcripciones consultables, fuentes, llamadas a herramientas y activaciones de guardrails.
Puedes incorporar fácilmente a la suite de pruebas cualquier problema detectado en producción. Cuando se propone un cambio, puedes usar Experimentos para dirigir una parte del tráfico real a una variante y medir resultados reales antes de aplicarlo de forma generalizada.
Recomendamos desplegar por fases. Dirige una parte limitada del tráfico a tu agente, evalúa esas conversaciones y, cuando hayas comprobado que funciona como se espera, amplíalo a más casos de uso, canales o regiones.
Proteger datos sensibles
Los agentes pueden gestionar datos de pago, información sanitaria e identificadores personales, por lo que es importante tener en cuenta qué datos se almacenan, dónde se almacenan y durante cuánto tiempo.
Ofrecemos distintos mecanismos para que clientes protejan sus datos:
- Zero Retention Mode se puede activar para servicios aptos y garantiza que determinados tipos de datos no se conserven; está diseñado para entornos normativos exigentes.
- Redacción del historial de conversaciones elimina las entidades sensibles después de una llamada y las sustituye por marcadores de posición en el texto y pitidos en el audio, incluso por tipos de entidad individuales.
- Retención configurable adapta los periodos de almacenamiento a tus requisitos normativos.
- Residencia de datos mantiene el procesamiento dentro de la jurisdicción requerida.
- Despliegues privados (VPC) aíslan el entorno para cargas de trabajo altamente sensibles.
- Cifrado protege los datos en tránsito y en reposo.
Medidas de seguridad de la plataforma y validación externa
Todo lo anterior se apoya en nuestras medidas de seguridad de la plataforma, un programa integral que abarca la procedencia del contenido, la detección de abusos, la aplicación de restricciones de uso y el red-teaming de modelos. A través de nuestro Programa de colaboración en seguridad, también trabajamos con empresas a la vanguardia de la seguridad de la IA y contribuimos a sus productos y a los estándares emergentes del sector.
También sometemos nuestro enfoque a escrutinio independiente, incluido el cumplimiento de estándares generales de seguridad y privacidad como SOC 2 Type II, ISO 27001 y el RGPD, junto con certificaciones específicas del sector y del caso de uso como PCI DSS Level 1 para el procesamiento de pagos e HIPAA para la atención sanitaria en Estados Unidos. Consulta nuestro centro de confianza para obtener más información.
También cumplimos estándares más recientes y nativos de IA, como ISO 42001, que regula los sistemas de gestión de IA, y AIUC-1 que exige que los agentes de IA superen simulaciones adversariales trimestrales realizadas por evaluadores independientes. Las mismas capacidades que sustentan AIUC-1 también dan acceso a algunas de las primeras pólizas de seguro para agentes del sector.
Para despliegues grandes o complejos, nuestros Forward Deployed Engineers colaboran con tu equipo para diseñar e implementar tu estrategia de agentes, incluida la configuración, los guardrails, las pruebas, la supervisión y la estrategia de despliegue.
Conclusión
Nuestro enfoque de seguridad en ElevenAgents se basa en capas, y cada elemento refuerza a los demás:
- Configuración del agente: Prompts de sistema, workflows y procedimientos que determinan el comportamiento y restringen las acciones más sensibles mediante llamadas a herramientas.
- Guardrails: Comprobaciones independientes en cada fase: detección de manipulación en la entrada, Focus en la decisión y validadores de contenido y personalizados en la salida, con estrategias de salida configurables.
- Pruebas: Simulaciones adversariales, ejecuciones repetidas, pruebas específicas por canal y red-teaming antes del lanzamiento.
- Supervisión: Despliegue por fases, seguido de evaluación continua, registros y transcripciones consultables, y un ciclo de retroalimentación posterior al lanzamiento.
- Protección de datos: Redacción, Zero Retention Mode, retención configurable, residencia de datos, despliegues privados (VPC) y cifrado.
- Validación externa: Certificaciones, pruebas adversariales independientes de AIUC-1, seguros para agentes, red-teaming y apoyo de expertos.