Como funciona a tecnologia Text to Speech: do texto à voz natural
- Escrito por
- Jack Limebear
- Publicado
OuvirOuça este artigo
A tecnologia Text to Speech (TTS) transforma palavras escritas em áudio falado. Primeiro, o sistema entende o que o texto diz e como ele deve soar; depois, um modelo de IA gera o áudio.
Inicialmente, um mecanismo de TTS normaliza a entrada de texto e a converte em tokens matemáticos e representações vetoriais que um sistema computacional consegue manipular. Em seguida, o modelo transforma essas construções matemáticas em representações digitais de som e, por fim, em saída de áudio.
Neste artigo, vamos explorar como funcionam diferentes ferramentas de Text to Speech e como a geração mais recente de síntese de fala neural com IA generativa oferece a fala mais natural até agora.
Resumo
- Sistemas de Text to Speech convertem palavras escritas em áudio em duas etapas. Primeiro, convertem o texto em tokens, ou representações matemáticas da linguagem. Depois, convertem esses tokens em uma representação acústica emitida como som.
- Os mais recentes mecanismos neurais de TTS usam modelos de IA para produzir uma fala natural. Equipes de negócios os utilizam para criar conteúdo, gerar legendas e operar agentes de atendimento ao cliente.
- Dicionários de pronúncia e marcação fonética são duas formas de ajustar a saída de TTS para que soe o mais natural possível e garantir a pronúncia correta de jargões técnicos e nomes.
- Uma API de Text to Speech permite conectar aplicações empresariais à geração de voz de alta qualidade.
O que é TTS? Como funciona a tecnologia Text to Speech
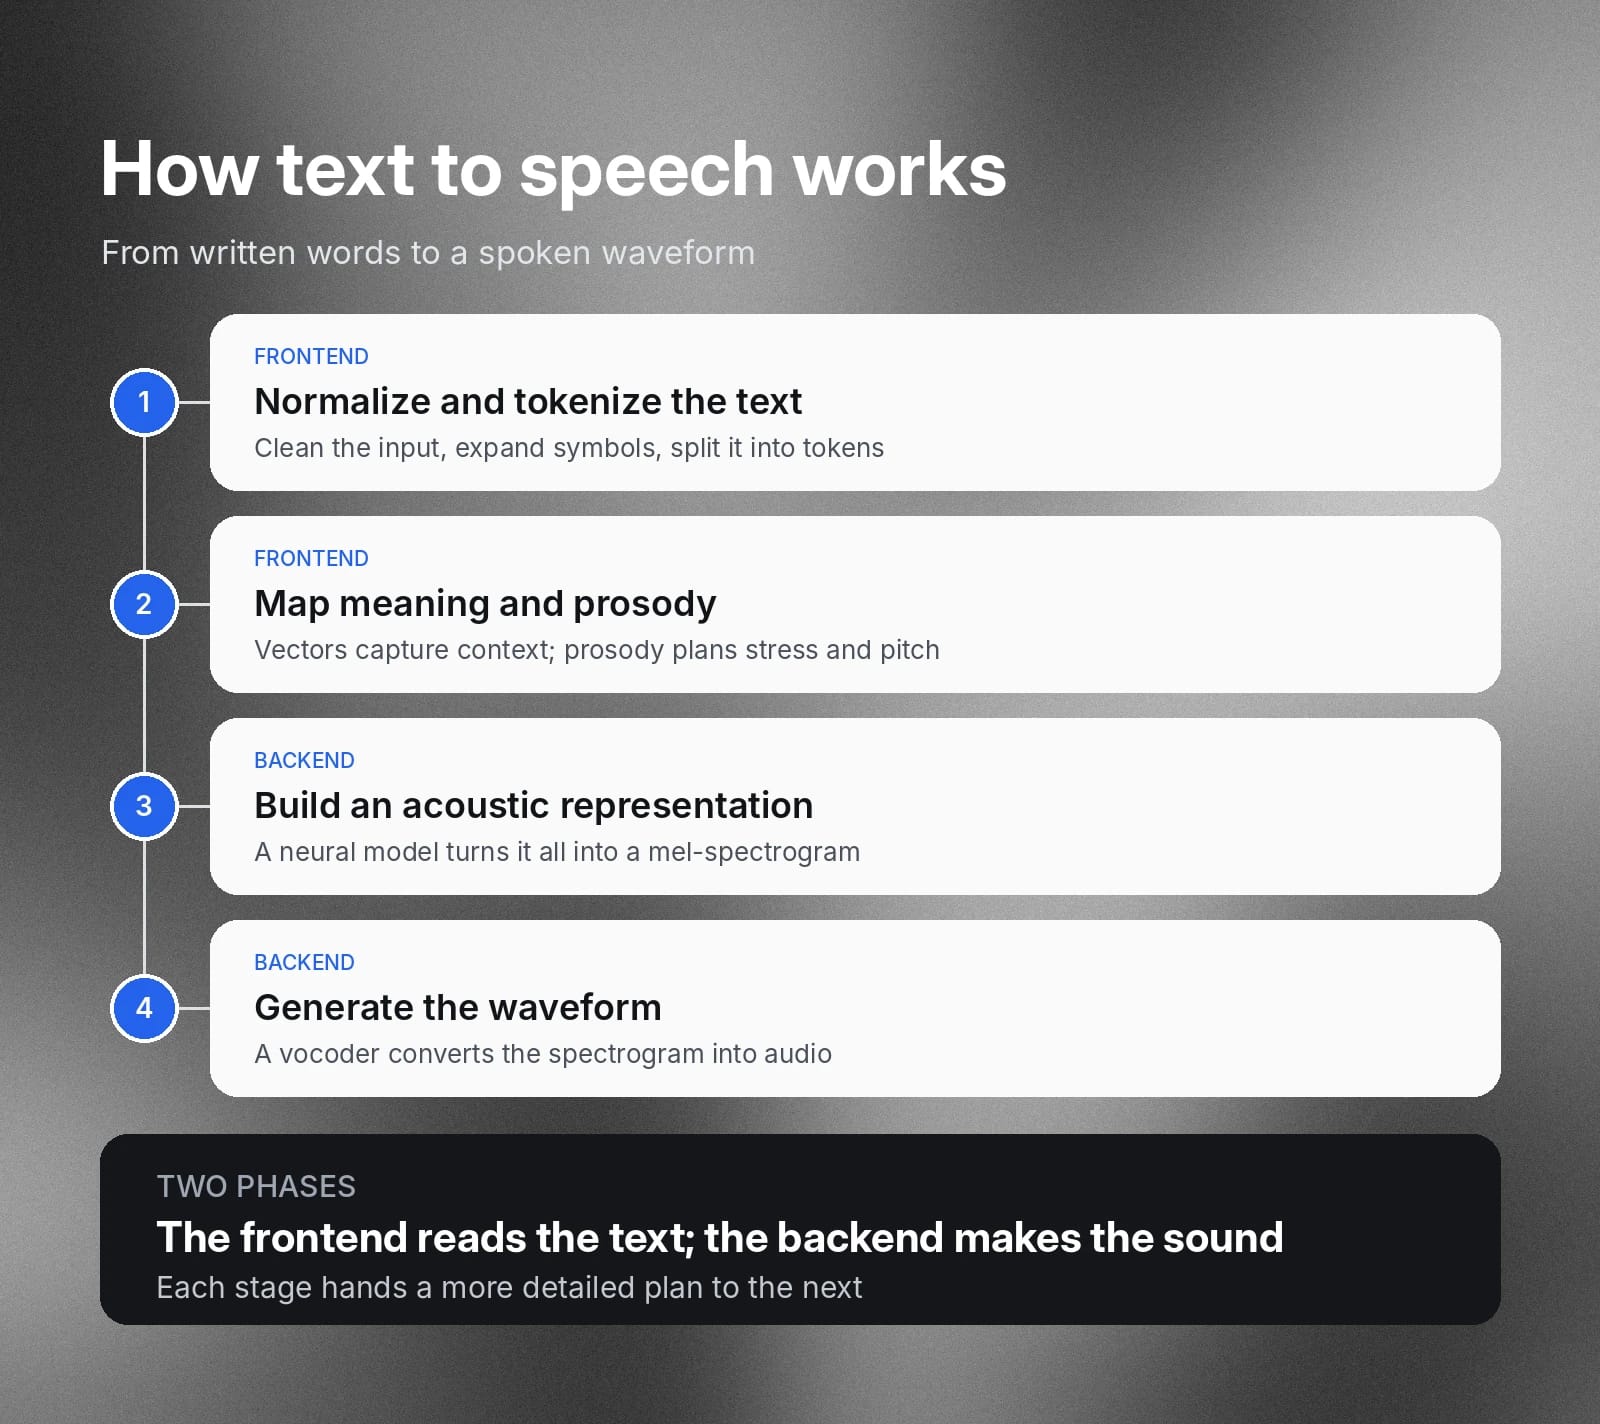
O Text to Speech funciona analisando o texto escrito, definindo como cada palavra deve soar e usando um modelo neural e um vocoder para gerar o áudio falado.
Em linhas gerais, o TTS se divide em duas fases:
- Frontend: o sistema converte o texto em uma forma matemática com a qual o mecanismo de TTS pode trabalhar.
- Backend: o sistema recebe a saída da primeira fase e a transforma em formas de onda que modelam a fala.
Vamos detalhar os componentes de como o TTS funciona.
Normalização de texto e análise linguística
A primeira etapa de um processo de TTS é o processamento de linguagem natural (PLN): limpar, tokenizar e desambiguar a entrada de texto bruto. Ele divide o texto em tokens, unidades individuais da linguagem escrita que um mecanismo de TTS consegue manipular. Um token pode ser uma palavra inteira, uma unidade de “subpalavra” ou um sinal de pontuação.
Os textos costumam conter símbolos além de palavras completas, como abreviações e números. Um mecanismo de TTS também precisa definir como falar esses itens. Por exemplo, o mecanismo lê “$11” e converte esse texto nos sons de “onze dólares”.
Significado semântico e prosódia
Prosódia é a altura e o ritmo da fala, que fazem o TTS soar natural. Ao processar o texto, o mecanismo também gera uma camada de informações prosódicas que mapeia mudanças de ênfase e entonação no texto para torná-lo mais natural.
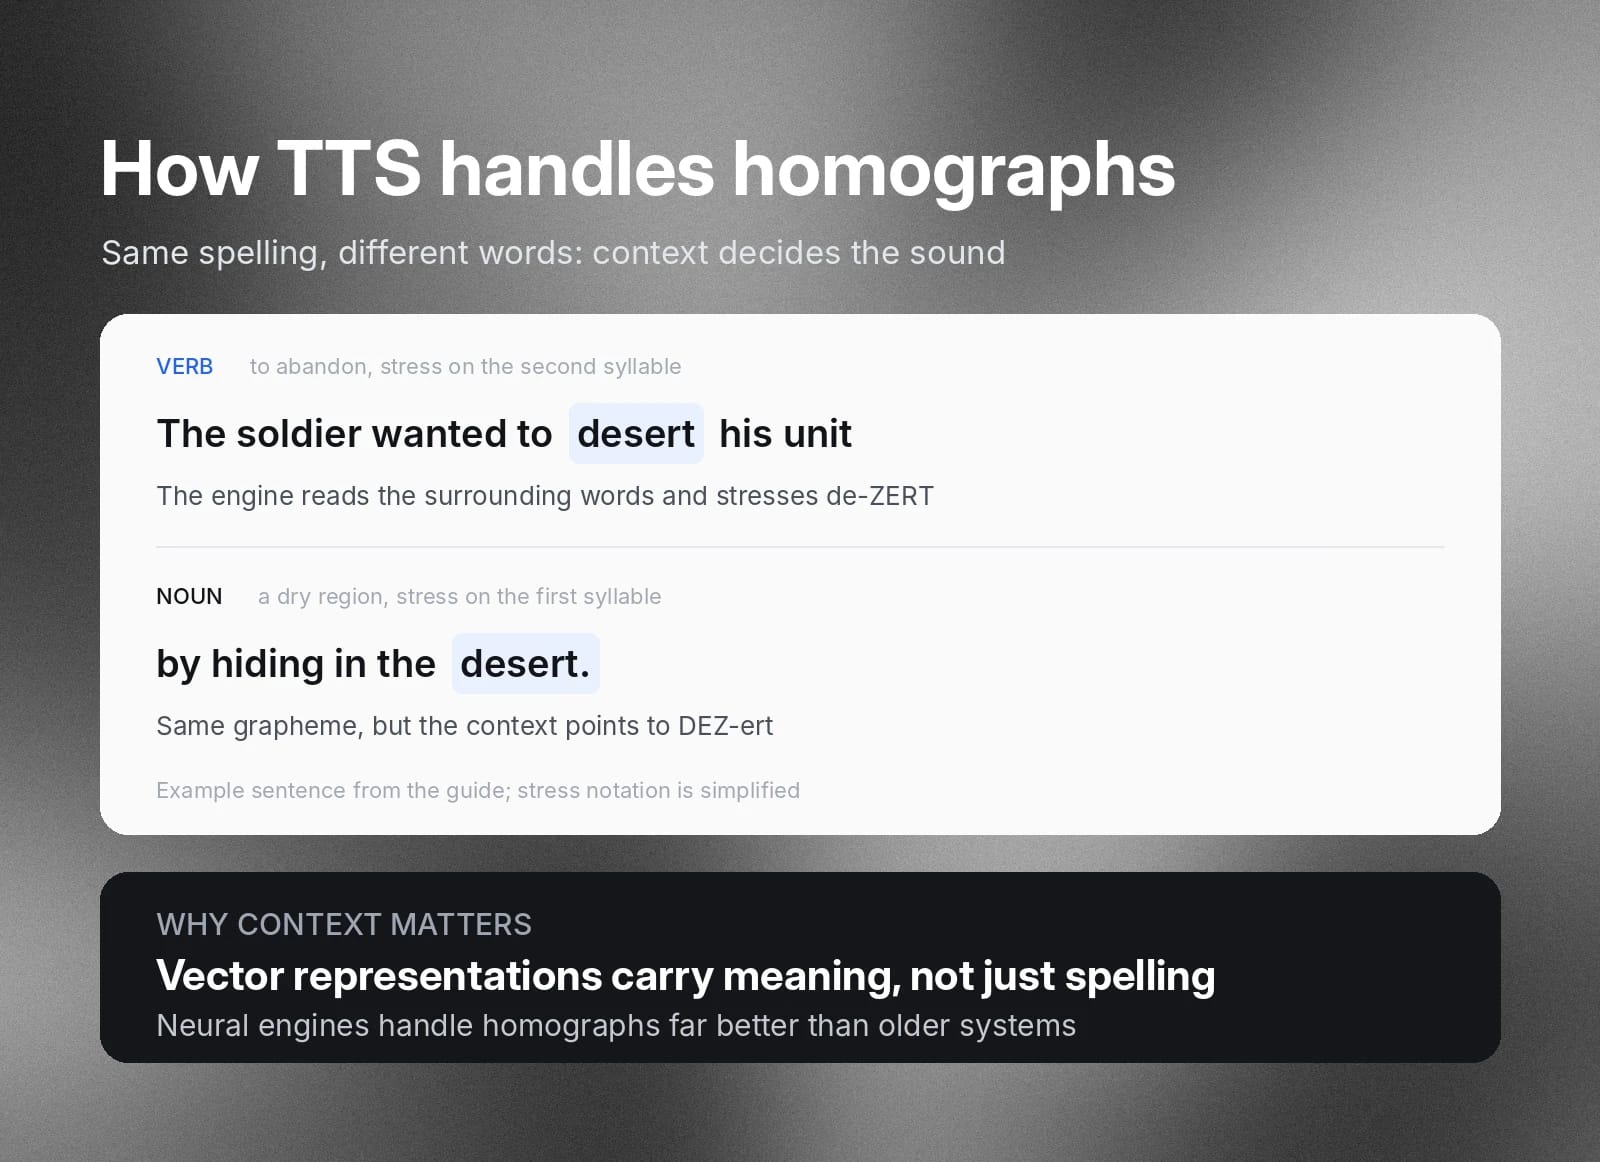
Um mecanismo de TTS também precisa adaptar a pronúncia do texto em fala conforme o contexto. Ele reúne essas informações na forma de representações vetoriais, dados numéricos que mapeiam a similaridade semântica entre palavras e frases. Pense nisso como um gráfico X-Y, no qual uma linha é traçada por diversos pontos, mas em muito mais de duas dimensões.
Um exemplo específico são os homógrafos. Homógrafos, ou palavras diferentes escritas da mesma forma, às vezes precisam ser pronunciados de modos distintos. O mecanismo de TTS precisa identificar a entonação e a ênfase a usar em cada uma ao falar. Por exemplo, como pronunciar o grafema “desert” na frase "The soldier wanted to desert his unit by hiding in the desert.”
Veja o Eleven v4 dar vida a este exemplo.
Modelagem acústica e síntese de forma de onda (fala)
O mecanismo de TTS recebe as informações tokenizadas e os vetores contextuais, que agora são todos dados numéricos, e os converte em uma representação acústica, como um espectrograma mel. Isso inclui diferentes frequências, níveis de energia e sons que o cérebro interpreta como emoção. Muitos sistemas diferentes já foram usados para executar essa função, mas hoje os modelos neurais estão entre os mais eficazes.
A etapa final usa um vocoder para converter esses espectrogramas em áudio que ouvintes humanos reconhecem como fala. Esse processo é chamado de geração de forma de onda.
Como o TTS funciona na prática: um exemplo
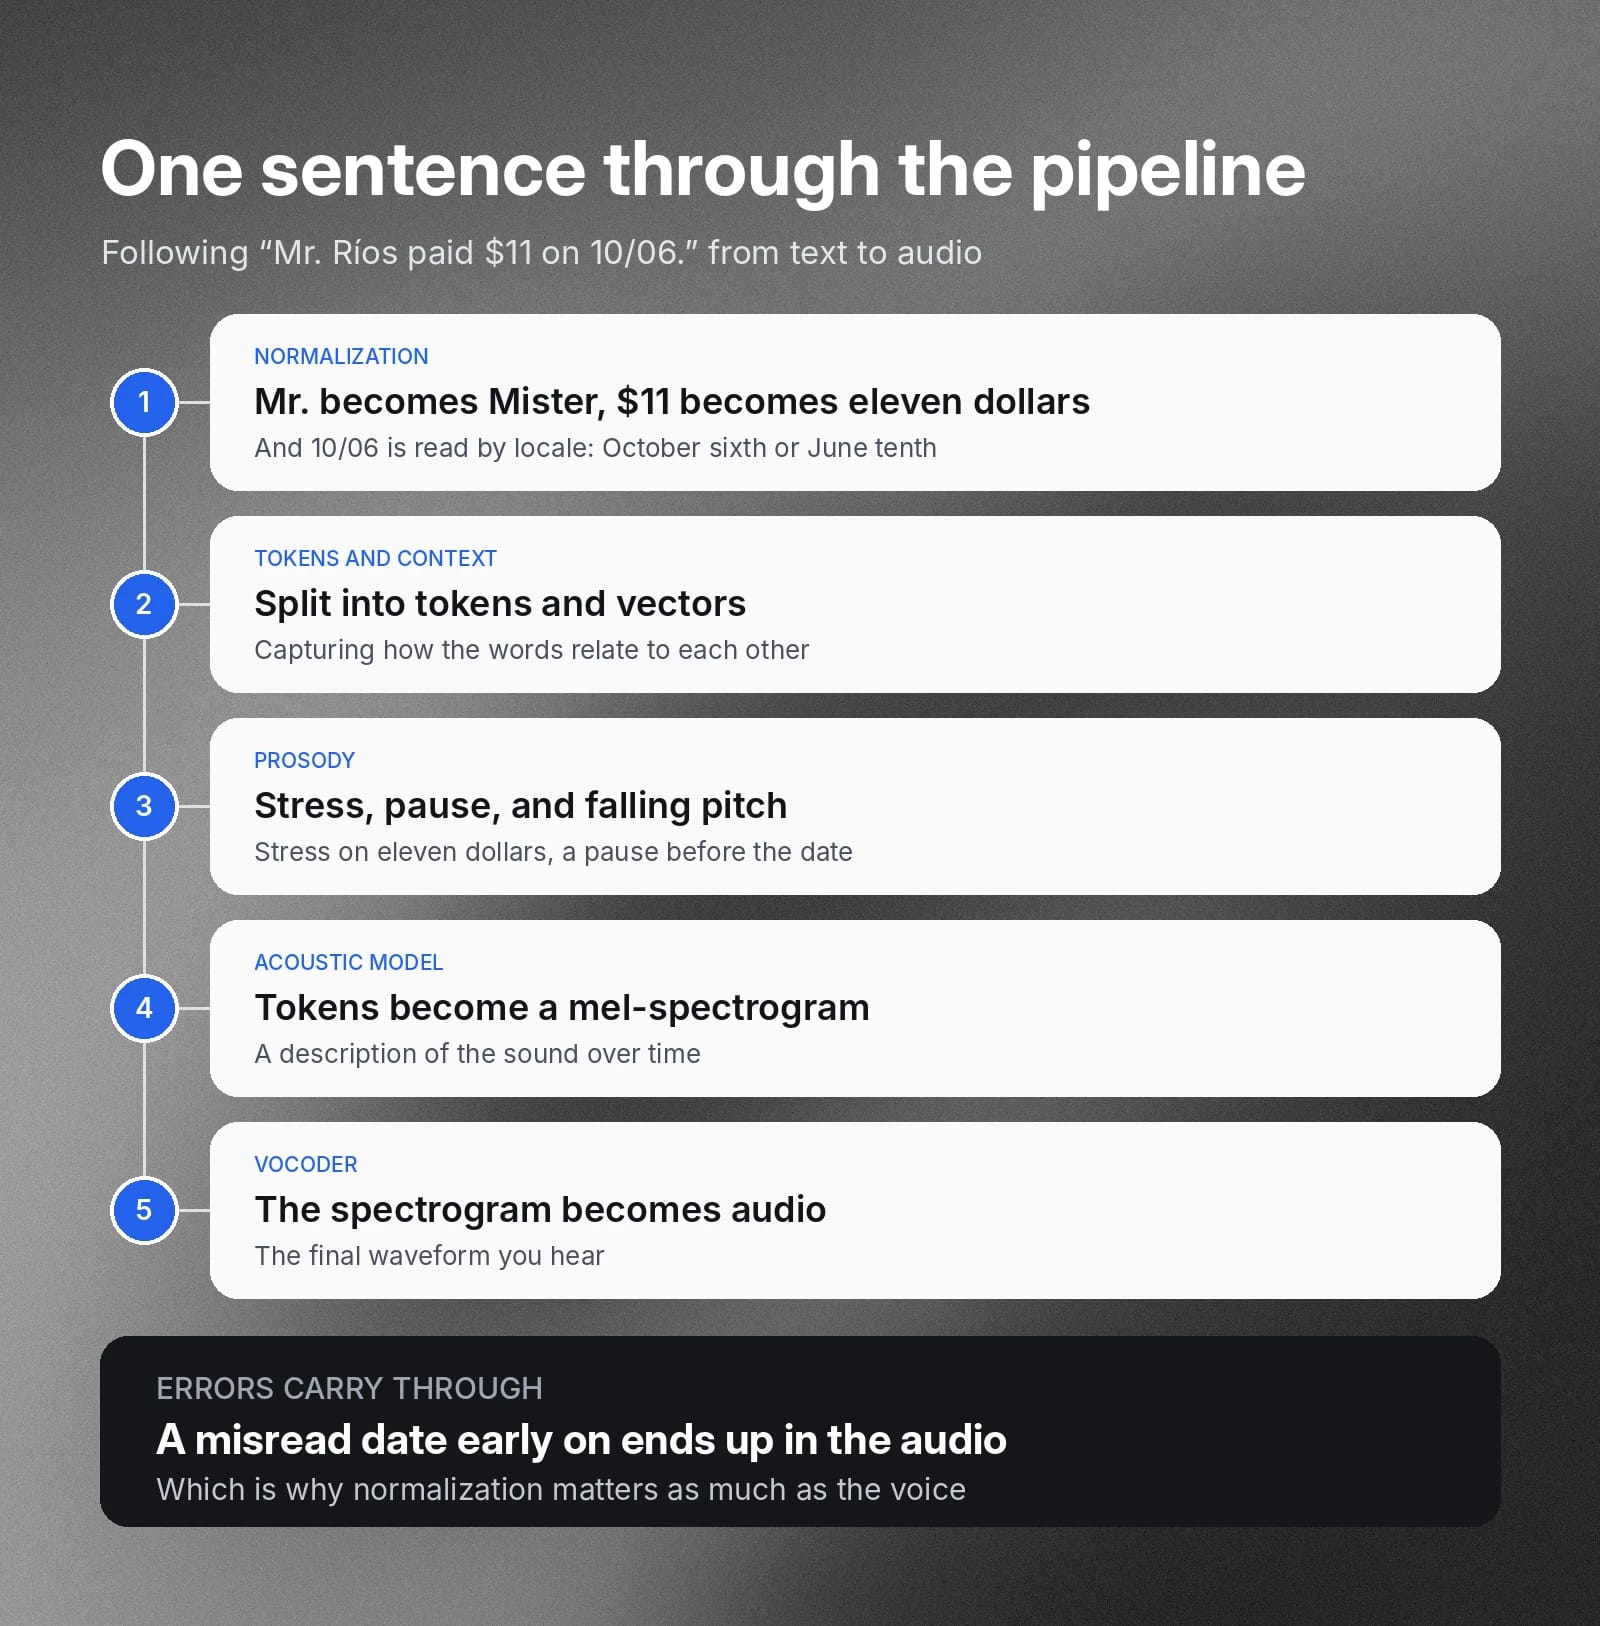
A forma mais fácil de ver como as etapas do TTS se encaixam é acompanhar uma única frase pelo processo.
Considere o texto “Mr. Ríos paid $11 on 10/06.”
- Normalização: o mecanismo expande “Mr.” para “Mister”, lê “$11” como “onze dólares” e decide se “10/06” significa “seis de outubro” ou “dez de junho”, conforme a localidade e o contexto.
- Tokenização e contexto: o texto limpo é dividido em tokens e convertido em vetores que capturam como as palavras se relacionam entre si.
- Prosódia: o mecanismo enfatiza “onze dólares”, acrescenta uma breve pausa antes da data e reduz a altura da voz no fim da frase.
- Modelo acústico: o modelo neural transforma os tokens e o plano de prosódia em um espectrograma mel que descreve o som ao longo do tempo.
- Vocoder: o vocoder converte o espectrograma na forma de onda de áudio final que você ouve.
Cada etapa passa um plano mais detalhado para a próxima. Por isso, erros no início do processo, como interpretar uma data incorretamente, seguem até o áudio final.
Por que o Text to Speech neural soa mais humano?
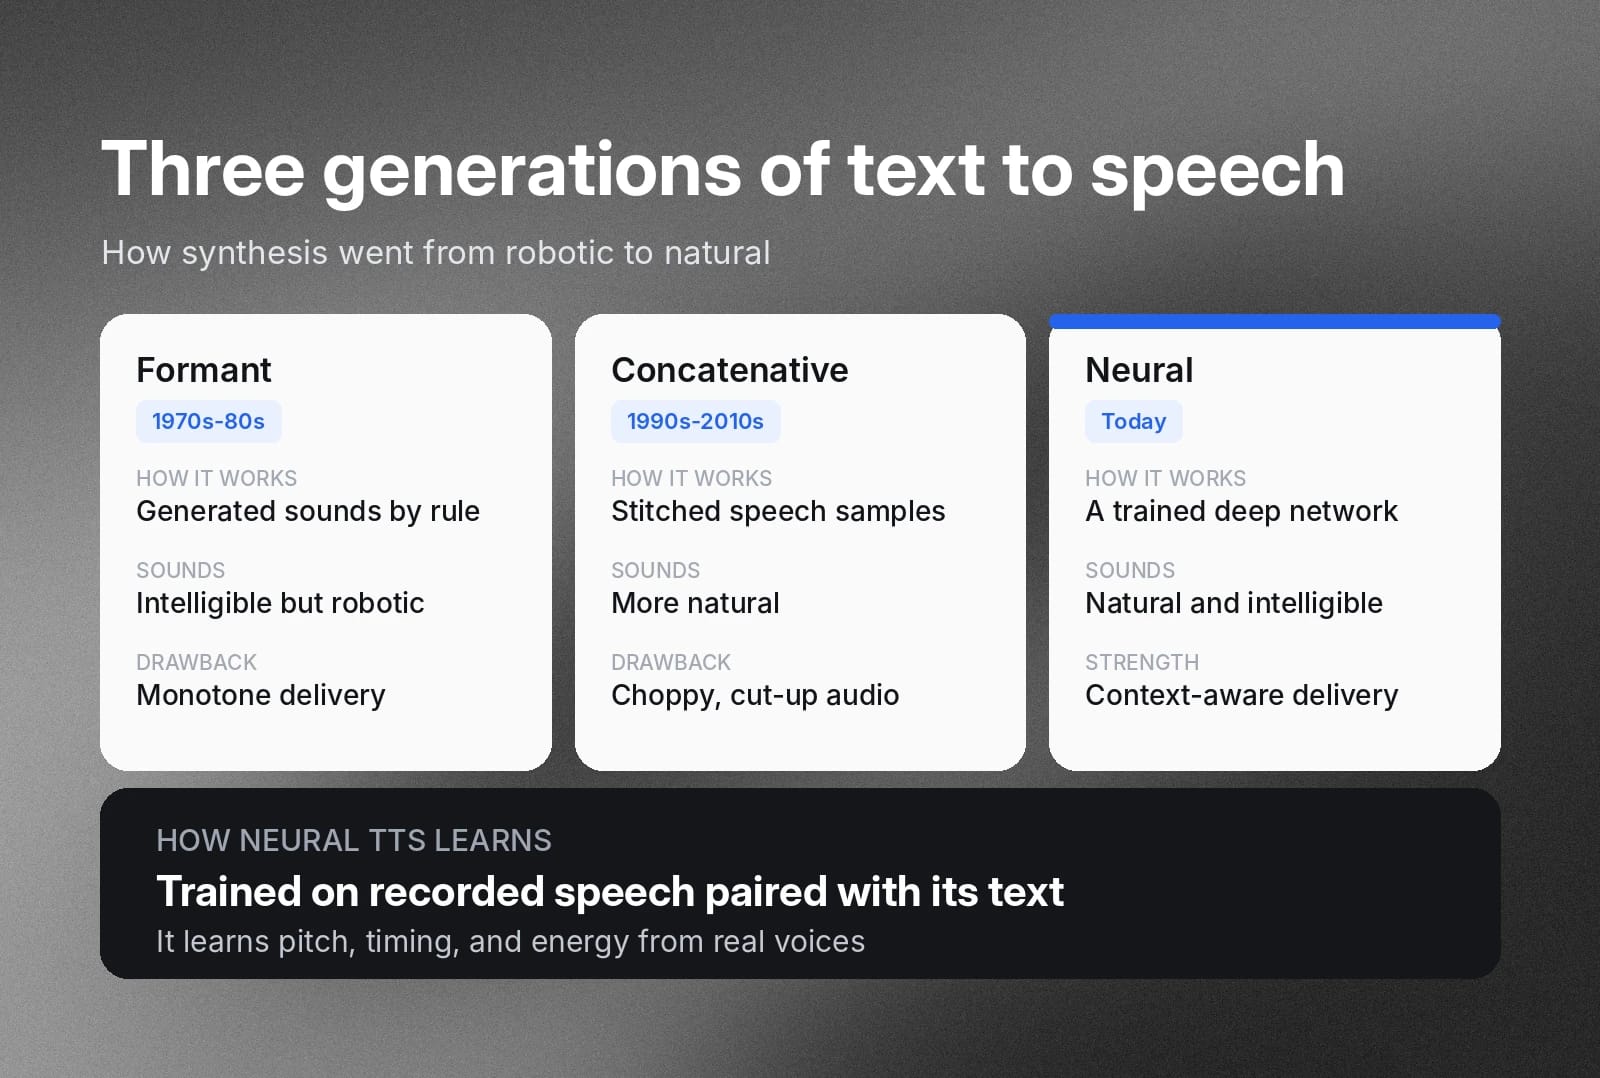
A síntese de fala neural se destaca por produzir uma fala natural e inteligível, as duas qualidades que engenheiros usam para avaliar mecanismos de TTS. O TTS neural funciona treinando uma rede neural profunda (DNN) para produzir fala a partir de uma entrada de texto. A DNN é treinada com grandes volumes de fala gravada associada ao texto correspondente.
Mecanismos de síntese de fala neural são apenas a mais recente evolução do TTS de nível empresarial. Duas gerações anteriores de tecnologia de síntese comercial vieram antes deles.
A síntese por formantes foi o modo dominante nas décadas de 1970 e 1980. Em vez de usar amostras de fala humana na saída em tempo de execução, ela gerava sons sintéticos que modelavam a fala. Era inteligível, mas monótona e com som robótico.
A síntese concatenativa predominou dos anos 1990 aos anos 2010 e soava mais natural que os sistemas anteriores por formantes. Em vez de gerar tons com base em regras matemáticas, esses sistemas uniam, ou concatenavam, pequenas amostras de fala humana. Eles usavam tabelas de consulta linguística para associar o texto normalizado a sons e, então, produziam pequenas unidades de áudio de fala concatenado extraídas de uma enorme biblioteca, ou “corpus”. Embora soe mais natural que a fala de um mecanismo por formantes, a concatenação ainda pode deixar a fala entrecortada.
Qual é a diferença entre um gerador de voz IA e Text to Speech?
“Gerador de voz IA” é um termo frequentemente usado no marketing para descrever uma ampla variedade de tecnologias de voz, incluindo Text to Speech. Text to Speech se refere especificamente a sistemas que recebem texto escrito como entrada, modelam sua semântica e prosódia e produzem formas de onda de áudio.
Os geradores de voz IA formam um ecossistema completo de tecnologias de voz interligadas, incluindo TTS e outros sistemas generativos para design de voz, clonagem de voz e transferência de estilo de voz. Embora seja frequentemente usado como sinônimo de Text to Speech no marketing, gerador de voz IA é melhor entendido como um termo para a categoria mais ampla de ferramentas generativas de voz, da qual o TTS faz parte.
Como usar Text to Speech para conteúdo, acessibilidade e suporte
Os modelos de Text to Speech se tornaram parte central de workflows no mundo todo, tanto em contextos pessoais quanto comerciais.
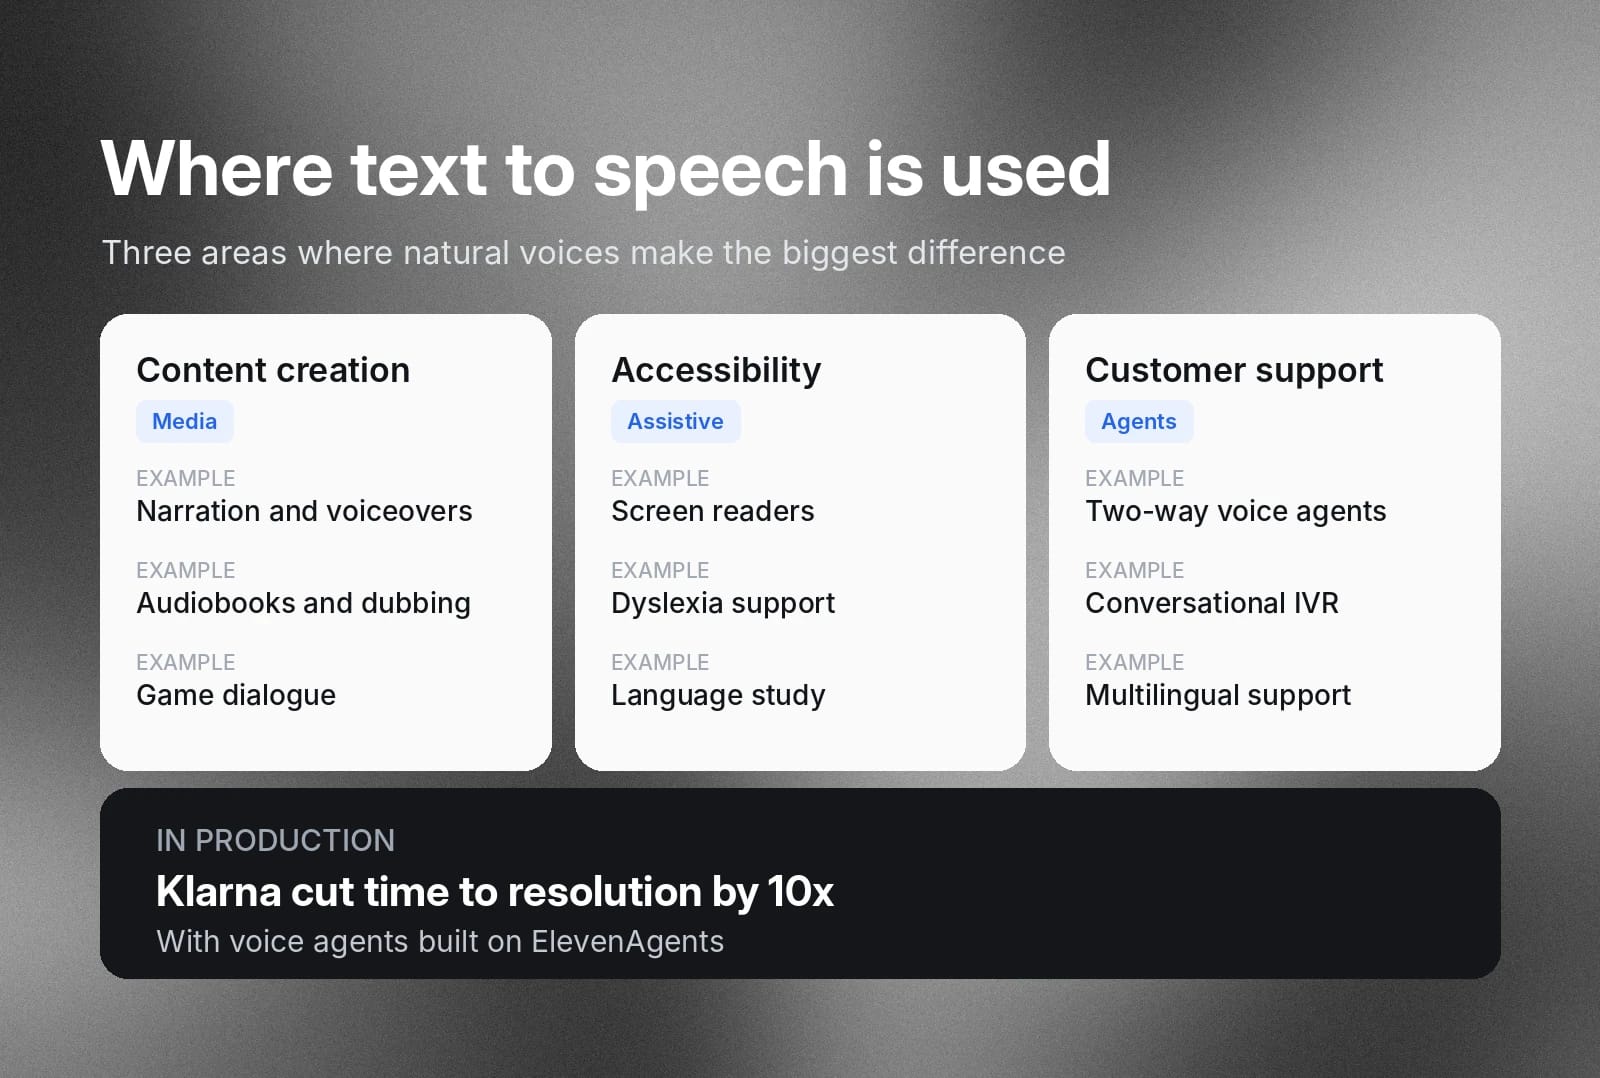
Estes são alguns dos principais casos de uso de Text to Speech.
Criação de conteúdo
Ferramentas de Text to Speech podem ajudar a reduzir os custos da produção de mídia em larga escala e o tempo gasto no estúdio com narração e ajustes de pós-produção.
Alguns exemplos de uso incluem:
- Narração
- Locuções
- Dublagem
- Produção de audiolivros
- Diálogos de jogos
Por exemplo, a TAP usou o TTS da ElevenLabs para ampliar conteúdos educacionais em escolas de toda a Índia.
Acessibilidade
Text to Speech é uma das tecnologias assistivas mais usadas, pois permite que as pessoas consumam conteúdo escrito por meio da escuta. A fala natural melhora o engajamento dos ouvintes e reduz a fadiga mental ao ouvir materiais longos.
Usos comuns de acessibilidade com TTS incluem:
- Leitores de tela: leem páginas inteiras em voz alta com um leitor de tela e TTS.
- Dislexia e apoio à alfabetização: reduzem o esforço da leitura ao acompanhar as sessões de leitura com uma voz de TTS.
- Baixa visão e cegueira: leitores de tela leem em voz alta elementos da interface e o conteúdo da página, para que as pessoas possam navegar em softwares e sites sem ver a tela.
- Diferenças cognitivas e de atenção: ouvir o texto pode reduzir o esforço de ler documentos longos e facilitar a concentração.
- Aprendizagem e estudo de idiomas: estudantes ouvem a pronúncia correta de vocabulário novo e podem ouvir livros didáticos durante o deslocamento ou os estudos.
Leitores de tela são ferramentas completas de acessibilidade que descrevem tudo o que há em uma tela, incluindo botões e menus. Ferramentas de leitura em voz alta se concentram em falar o conteúdo em si, geralmente com destaque que acompanha o texto, e se beneficiam de vozes mais naturais porque as pessoas as usam por períodos longos.
Atendimento ao cliente
A síntese de fala neural pode proporcionar uma experiência de alta qualidade ao cliente quando combinada a um LLM capaz de interações agênticas. Plataformas como ElevenAgents combinam a camada de voz com reconhecimento de fala, um LLM e ferramentas conectadas que permitem que um agente entenda o que quem liga precisa e responda com uma voz natural.
Agentes criados com ElevenAgents funcionam por telefone, web, WhatsApp, e-mail e SMS, permitindo que os clientes continuem uma conversa entre canais sem precisar repetir informações. Alguns exemplos de uso incluem:
- Agentes de voz IA bidirecionais: conduzem conversas ao vivo respondendo a perguntas de uma base de conhecimento ou encaminhando clientes para fluxos específicos, como reembolsos ou compras.
- Sistemas de resposta de voz interativa (IVR): substituem árvores de menu ultrapassadas como “Pressione 3 para vendas” por conversas em que seus clientes podem falar naturalmente.
- Suporte multilíngue: atende clientes no próprio idioma a partir de uma única configuração de agente.
A Klarna, por exemplo, reduziu o tempo de resolução em 10x com ElevenAgents
Como os mecanismos de Text to Speech controlam a pronúncia?
Mecanismos modernos de síntese de fala neural podem gerar uma fala muito natural, mas sempre haverá casos específicos em algo tão amplo, profundo e dinâmico quanto a linguagem humana. Talvez você queira manter sotaques, gírias ou pronúncias regionais na fala gerada. Você pode estar produzindo áudio para um setor que tem pronúncias próprias para termos técnicos. Ou talvez simplesmente queira que o nome da sua marca seja pronunciado de uma forma muito específica e consistente.
Dicionários de pronúncia e substituições de fonemas
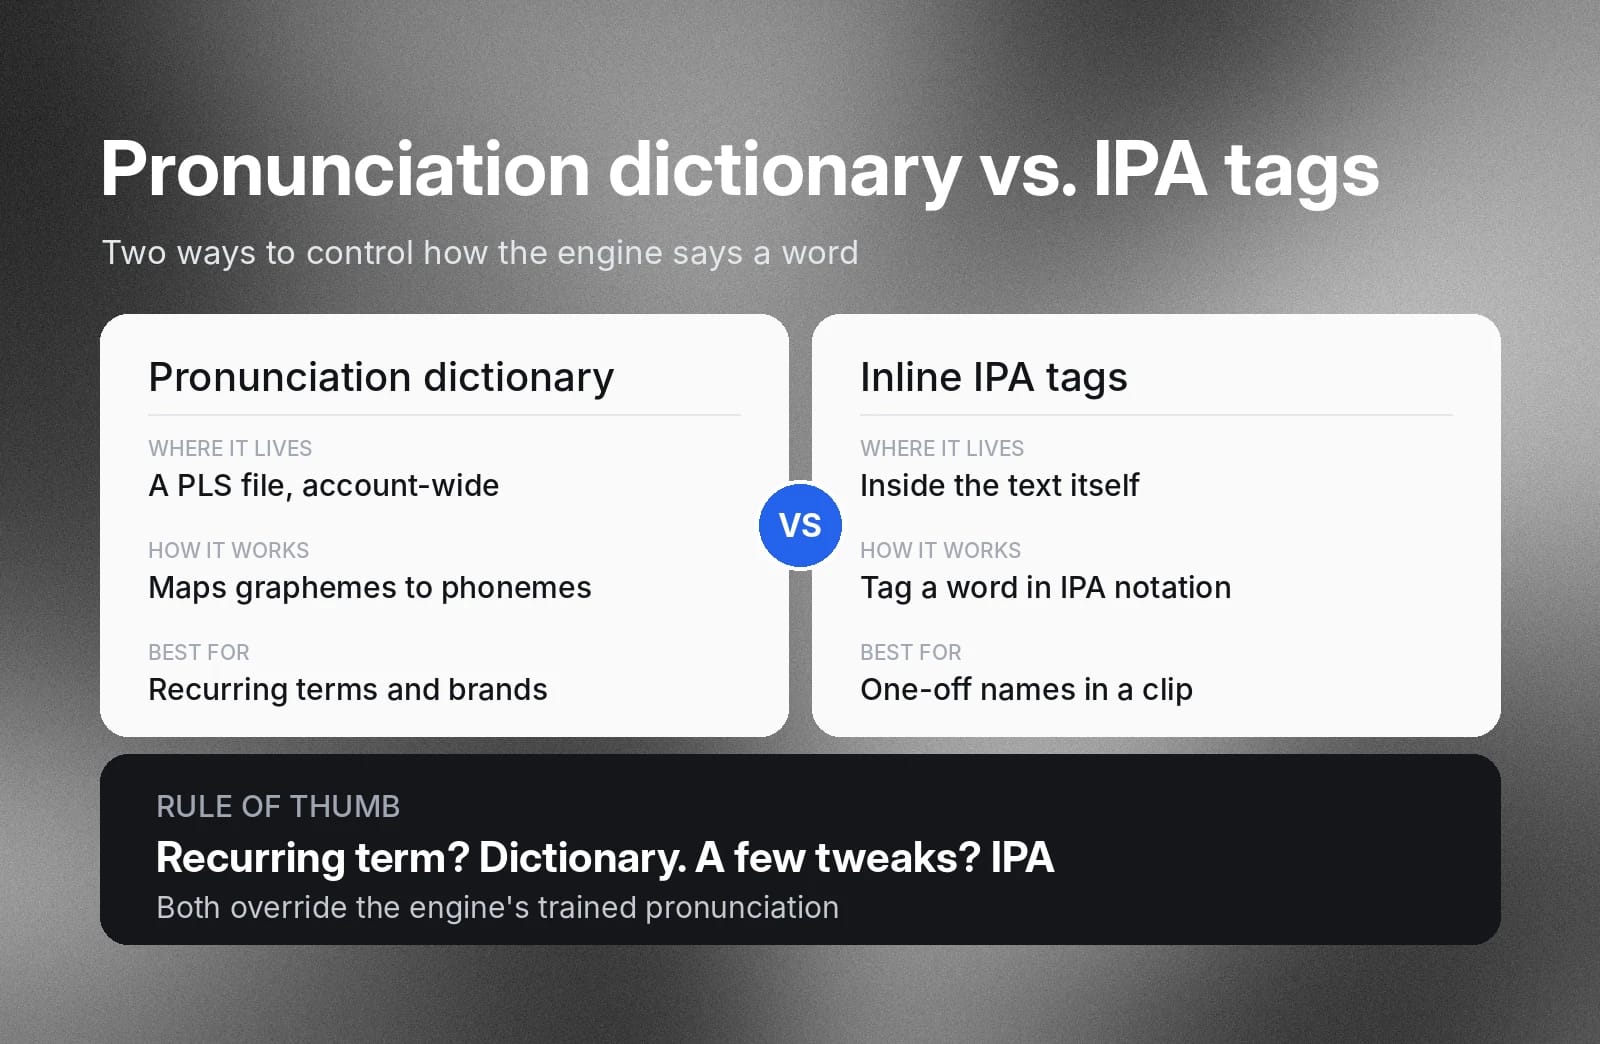
A ElevenAPI da ElevenLabs inclui um dicionário de pronúncia que permite personalizar como o mecanismo fala. Você cria um dicionário em um arquivo Pronunciation Lexicon Specification (PLS), padrão W3C, que mapeia grafemas (símbolos no texto) para fonemas (palavras faladas divididas em sons). Quando o mecanismo de TTS encontra um dos grafemas listados, ele substitui a pronúncia aprendida e usa a pronúncia fonética do dicionário.
Você pode aprender a criar um dicionário de pronúncia na ElevenAPI na documentação Como usar dicionários de pronúncia.
IPA nativo e prompts fonéticos
Alguns modelos de TTS também reconhecem tags de pronúncia em linha incorporadas diretamente na entrada de texto. Assim, em vez de criar um dicionário para toda a conta, se você quiser apenas ajustar pronúncias em um ou dois clipes de áudio, poderá marcar as palavras no texto usando a notação IPA padrão. Por exemplo, se você estiver gravando um audiolivro e quiser que o nome de um personagem fictício seja pronunciado de uma forma específica.
Desafios comuns de Text to Speech e como resolvê-los
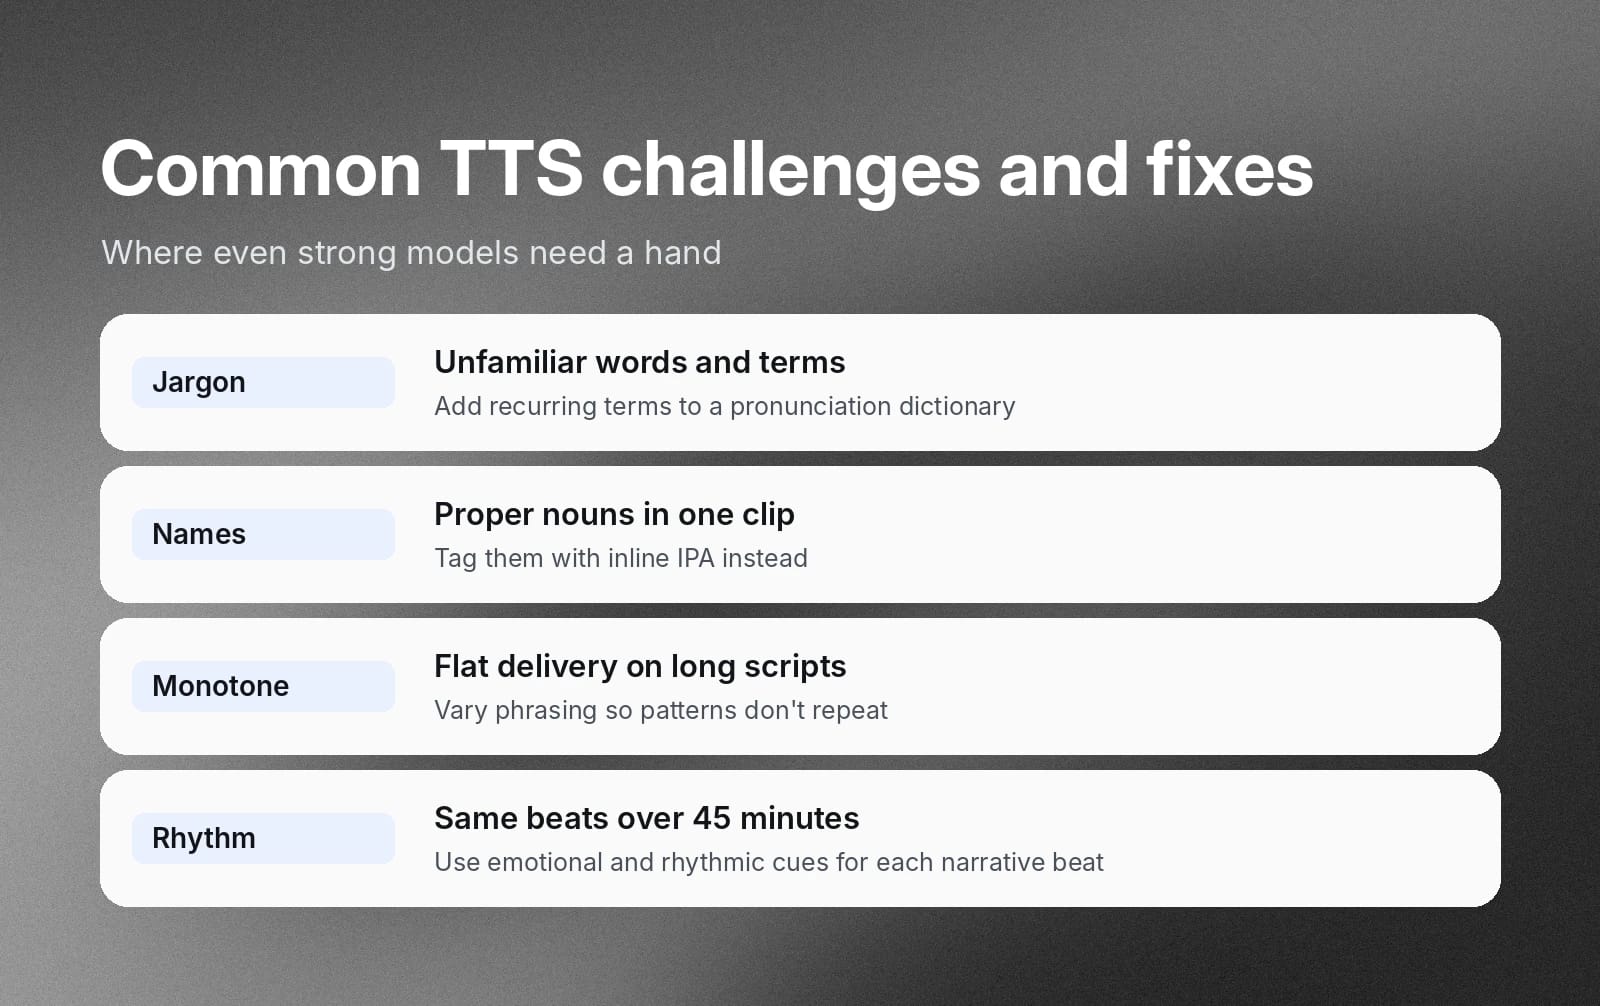
Mesmo os modelos de TTS mais avançados podem ter dificuldade com as nuances da linguagem humana. Dois dos problemas mais comuns são pronunciar incorretamente palavras novas e produzir uma fala monótona. Veja como resolvê-los.
Pronúncias incorretas de palavras desconhecidas, jargões e nomes próprios
Mecanismos de TTS usam algoritmos para prever como o texto normalizado deve ser pronunciado com base em como os grafemas são mapeados para fonemas nos dados de treinamento. Eles fazem a melhor previsão possível com base no texto e no contexto que processaram. Mas, como discutimos na seção anterior, haverá muitos casos específicos em que você vai querer que algo seja pronunciado de uma forma muito determinada.
Dicionários de pronúncia ou tags IPA específicas serão suas melhores ferramentas para esses casos. Se você tiver um termo recorrente que deseja pronunciar de modo consistente, um dicionário é a melhor solução. Se quiser fazer ajustes específicos em apenas alguns termos, use tags IPA fonéticas.
Entonação monótona
Esses problemas são mais comuns ao processar roteiros longos, nos quais as mesmas palavras ou frases são repetidas diversas vezes. A fala sintetizada por um mecanismo pode soar muito bem em trechos de 10 segundos, mas ouvir a mesma pronúncia mecânica e os mesmos padrões rítmicos durante uma aula de 45 minutos logo se torna cansativo.
Varie as construções usadas nos roteiros e use tags fonéticas com critério para alterar periodicamente as pronúncias. Use sinais emocionais e rítmicos para tornar a saída de fala mais dinâmica, com variações de altura acompanhando diferentes momentos da narrativa.
Crie experiências de voz natural com uma API de Text to Speech
Ferramentas web leves podem ser ótimas para produzir pequenos clipes de áudio, mas não escalam bem para necessidades empresariais maiores. Se você precisa gerenciar milhares de interações de clientes por minuto ou gerar conteúdo de áudio longo e de alta qualidade, precisará de ferramentas de TTS mais robustas.
Uma API de Text to Speech como a ElevenAPI permite conectar seu software diretamente a modelos de síntese de fala neural. Você pode usar solicitações REST ou WebSockets persistentes para gerar áudio sob demanda para agentes ou outras finalidades em escala.
Como funciona uma solicitação de API de Text to Speech
Embora os modelos sejam complexos, o fluxo para desenvolvedores é fácil de entender e começar a usar.
Com a ElevenAPI, você pode integrar Text to Speech às suas aplicações em minutos:
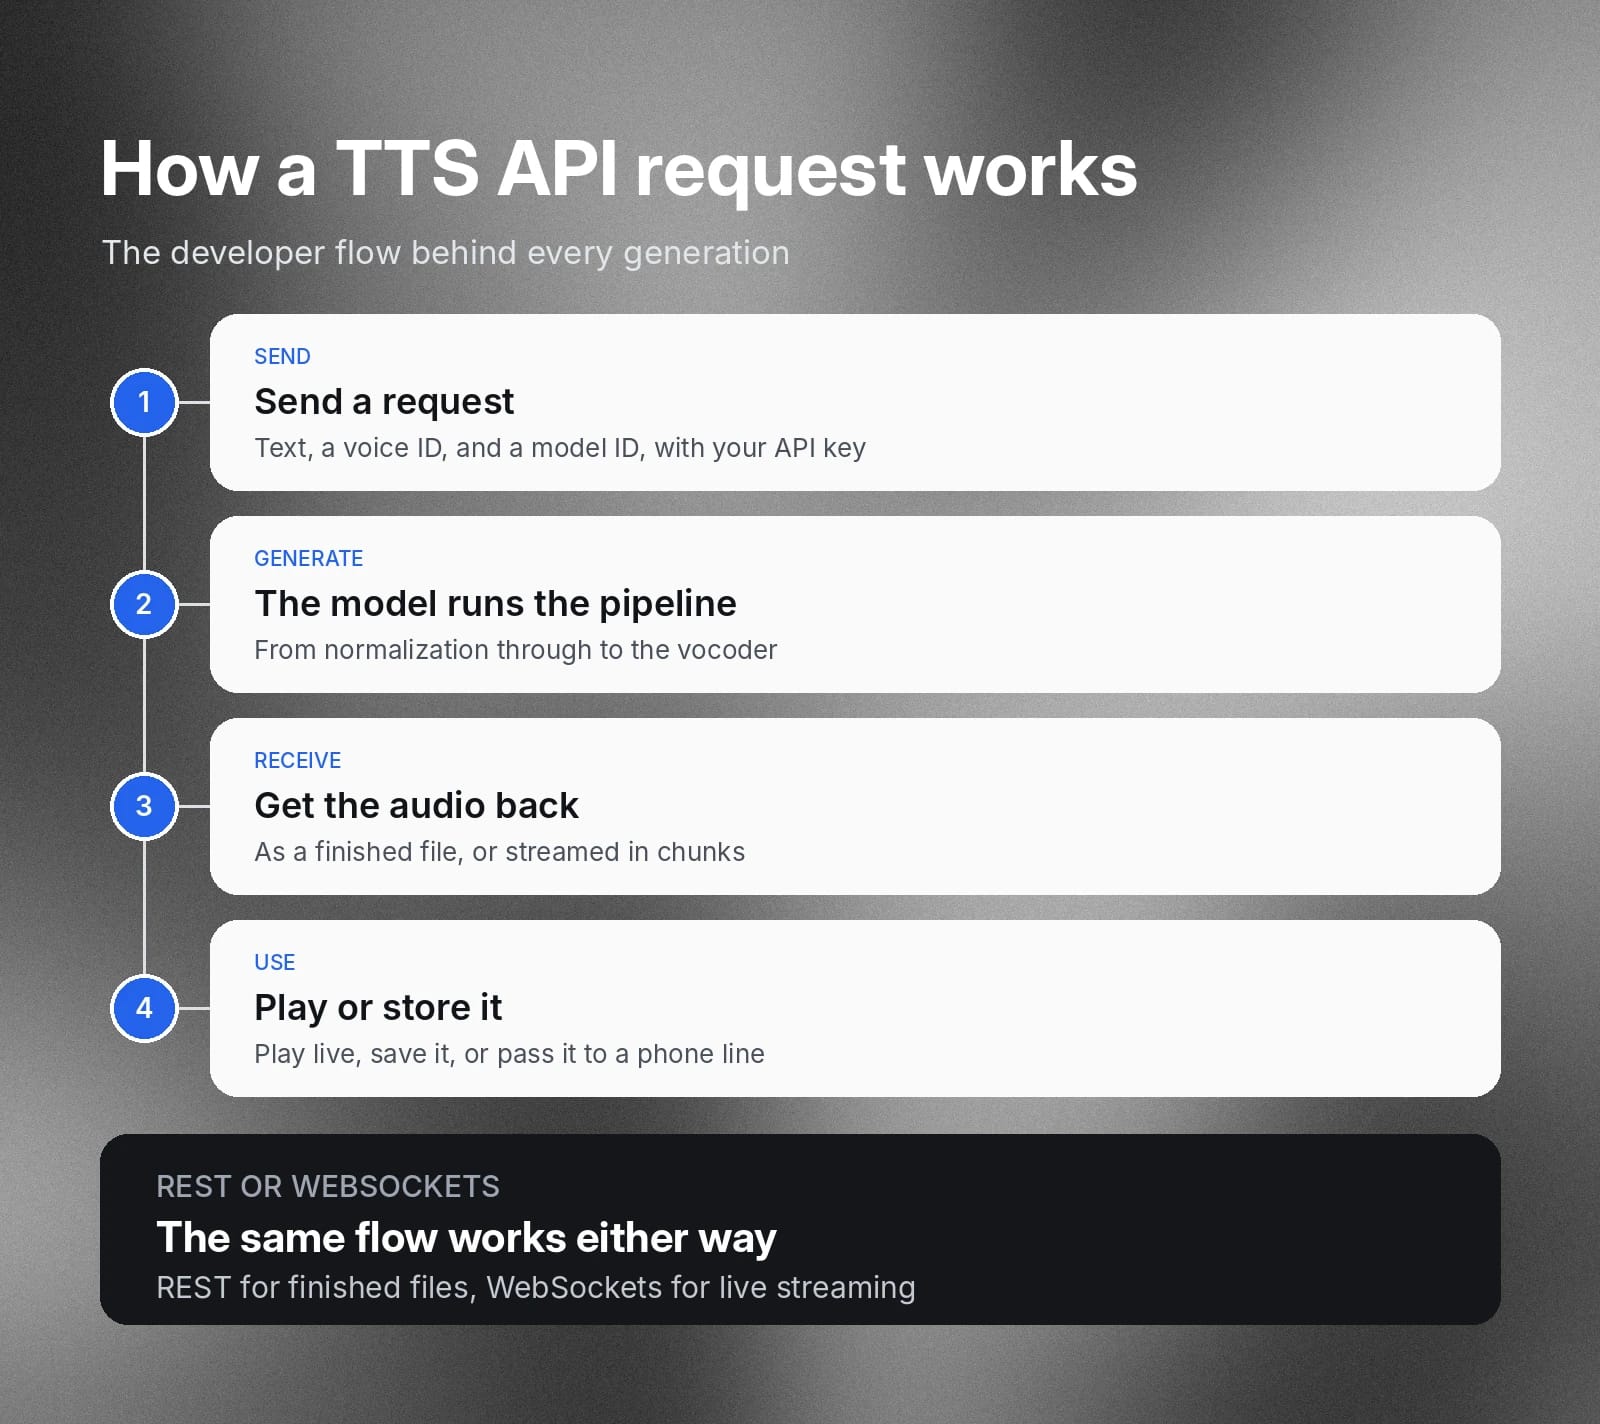
- Envie uma solicitação: sua aplicação envia o texto, um ID de voz e um ID de modelo à API com sua chave de API.
- Gere: o modelo executa o processo descrito acima, da normalização ao vocoder.
- Receba o áudio: a API retorna o arquivo de áudio finalizado ou o transmite em partes para que a reprodução possa começar antes que a geração termine.
- Reproduza ou armazene: sua aplicação reproduz o áudio ao vivo, salva-o ou o encaminha a outro sistema, como uma linha telefônica.
O mesmo fluxo se aplica usando REST para arquivos finalizados ou WebSockets para streaming ao vivo, e os SDKs descritos abaixo encapsulam essas chamadas para você.
Considerações de arquitetura para desenvolvedores
Dependendo do seu caso de uso, talvez seja necessário equilibrar velocidade de processamento, fidelidade de áudio, latência e protocolos de rede, além de recursos de integração.
Latência vs. fidelidade
Para que agentes conversacionais soem naturais, o ideal é buscar aproximadamente 100 ms até o primeiro áudio, o que significa minimizar a latência na rede e até o mecanismo de TTS. O ponto aqui é a qualidade do áudio que a arquitetura do seu agente consegue entregar dentro dessa restrição.
Por outro lado, a latência importa menos quando você produz áudio longo, como um podcast ou uma aula. Em vez de minimizar a latência, você vai querer maximizar uma saída de alta fidelidade.
Protocolos de streaming
Os protocolos usados na conexão com sua API também podem afetar a latência e o desempenho. WebSockets permitem um verdadeiro streaming de áudio bidirecional, ou seja, você pode processar trechos de texto por vez em vez de esperar a renderização de todo o conteúdo. A reprodução pode começar nos primeiros trechos enquanto o mecanismo de TTS ainda processa os seguintes.
SDKs
APIs de Text to Speech de nível empresarial, como a ElevenAPI, oferecem kits de desenvolvimento de software (SDKs) completos para Python e TypeScript/JavaScript, além de APIs REST, para ajudar você a criar uma nova arquitetura rapidamente. Use-os para reduzir o esforço de integração da sua equipe de desenvolvimento.
Comece a usar a ElevenAPI para Text to Speech
A síntese natural de TTS de um modelo de fala líder produz a saída de áudio de alta qualidade de que seus agentes e produções de áudio precisam para manter os ouvintes engajados. Quer você esteja buscando um agente conversacional de alta qualidade para apoiar workflows de atendimento ao cliente ou queira incluir TTS na sua aplicação, a ElevenLabs tem uma solução.
Comece hoje mesmo a produzir seu próprio áudio de alta fidelidade com a ElevenAPI, ou saiba mais sobre ElevenAgents.
Perguntas frequentes

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.