Corrija problemas de precisão de Speech to Text com um workflow mais inteligente
- Escrito por
- Jack Limebear
- Publicado
- Última atualização
OuvirOuça este artigo
A precisão de Speech to Text (STT) depende de três fatores: a qualidade do áudio, como as pessoas falam e as palavras que usam. Ruídos e compressão intensa removem detalhes de uma gravação, e até modelos avançados têm dificuldade com vozes sobrepostas ou jargões desconhecidos. Este guia mostra de onde vem cada problema de STT e como corrigi-lo.
Erros de transcrição raramente ficam restritos à transcrição. Um nome de medicamento ouvido incorretamente em uma anotação clínica ou um número de conta errado em um registro de chamadas se propaga para todos os sistemas que usam esse texto, da busca e análise a agentes de IA que agem com base no que foi dito. Baixa precisão também aumenta o tempo de revisão, pois alguém precisa encontrar e corrigir os erros manualmente.
A boa notícia é que a maioria dos problemas de precisão de STT pode ser corrigida. Muitas dessas correções exigem apenas pequenos ajustes nas configurações ou nos setups de gravação existentes, o que significa que você pode resolver o problema sem alterar as configurações do modelo.
Você também pode encontrar este tema como precisão de reconhecimento de fala, precisão de ASR ou precisão de transcrição. Speech to Text, reconhecimento de fala e reconhecimento automático de fala (ASR) descrevem o mesmo processo de converter áudio falado em texto escrito. As correções deste guia se aplicam independentemente do termo que você usar.
Resumo
- A precisão de Speech to Text depende da qualidade do áudio de entrada, da dinâmica dos falantes e de questões lexicais e contextuais.
- Para corrigir um problema de precisão, descubra em qual ponto do pipeline — entrada, processamento ou saída — você pode fazer uma alteração.
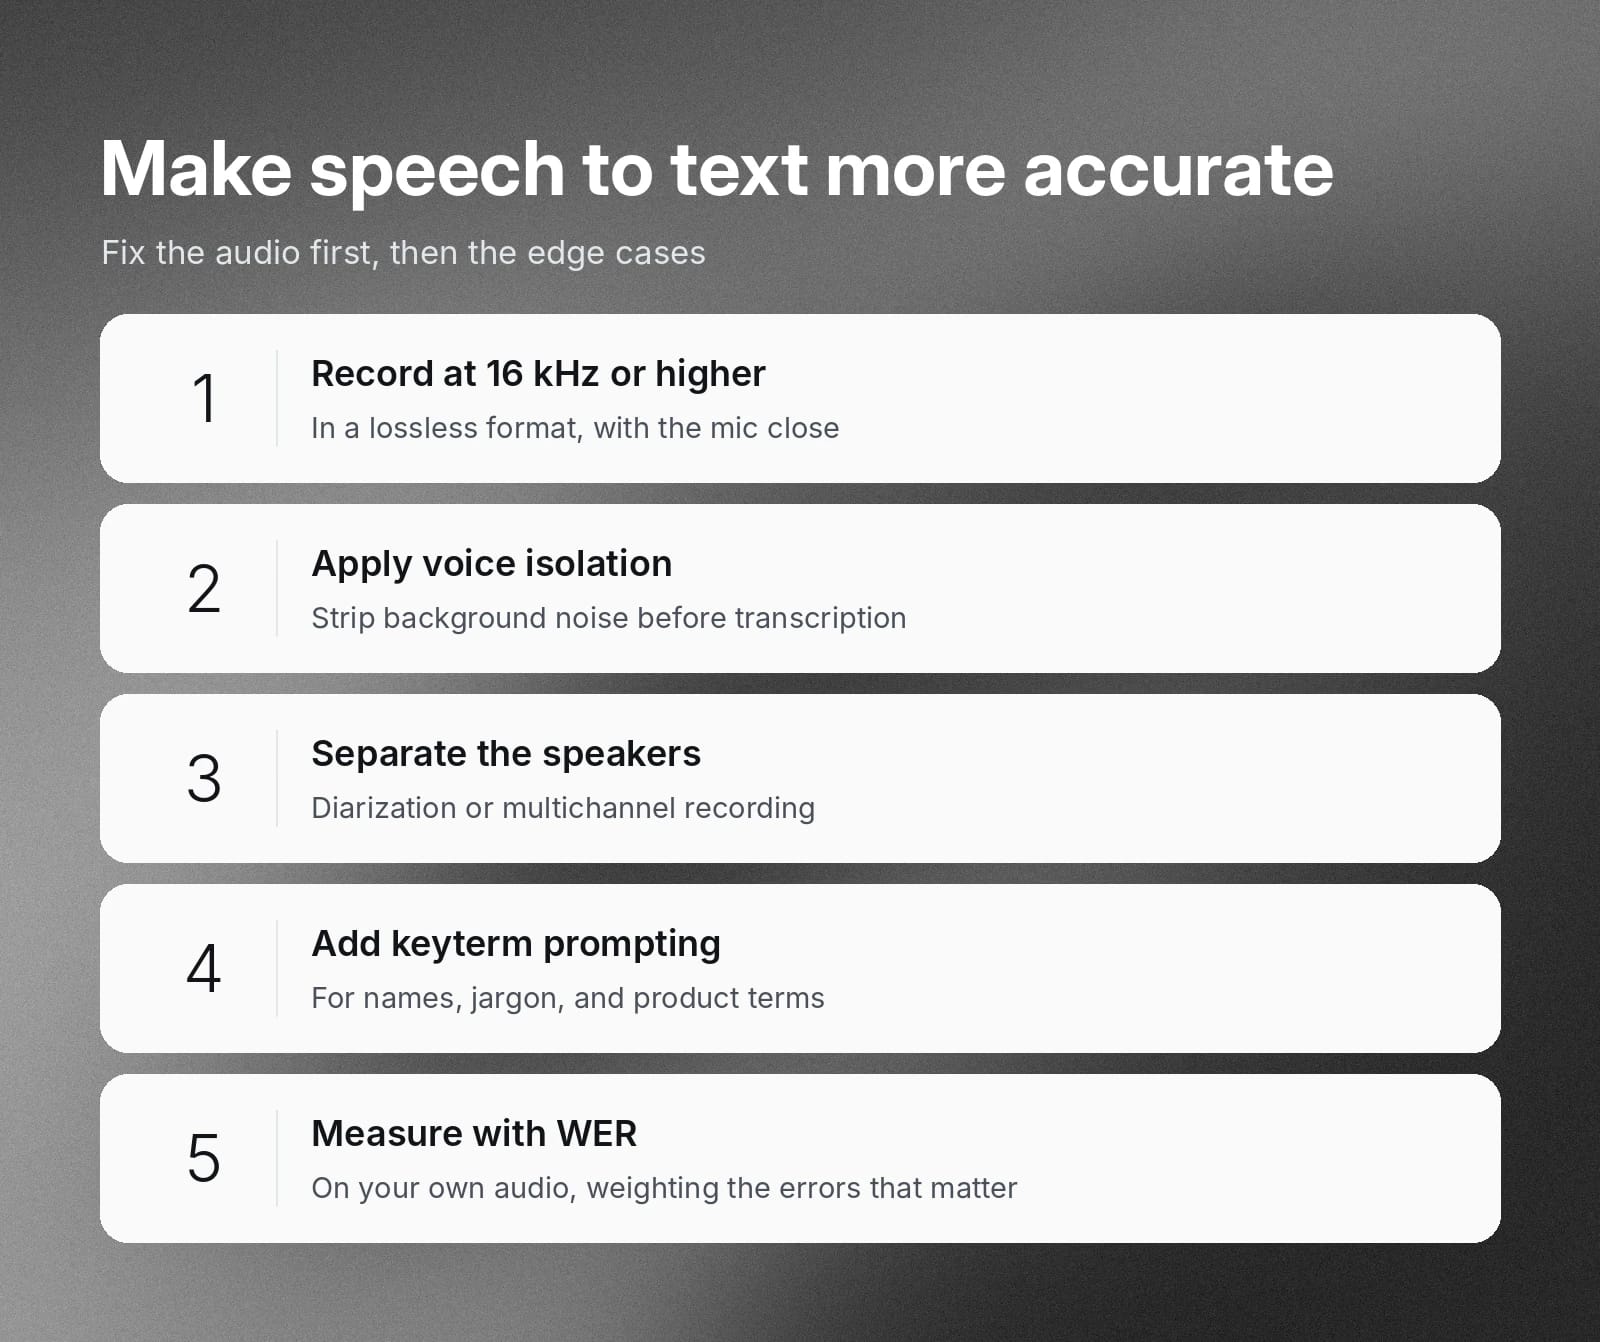
- Grave em 16 kHz ou mais, use formatos sem perdas e posicione os microfones de 10 a 15 cm do falante.
- Use isolamento de voz, diarização ou gravação multicanal e keyterm prompting para lidar com ruído, falantes sobrepostos e vocabulário especializado.
- Meça a precisão com a taxa de erro de palavras (WER) e verifique quais erros são mais importantes para seu caso de uso.
O que causa problemas de precisão em Speech to Text?
Imagine que alguém peça para você transcrever uma gravação de áudio de um professor com sotaque forte descrevendo física teórica complexa, feita em um restaurante lotado, com música de fundo e conversas ao redor. Sistemas computacionais digitais não são naturalmente adaptados à variabilidade acústica. É preciso treinamento e ajuste consideráveis para fazer o STT funcionar bem e, embora as ferramentas modernas de IA sejam muito eficazes, vários problemas ainda podem afetar o resultado. Mas, ao entendê-los, você pode resolvê-los nos seus workflows de transcrição.
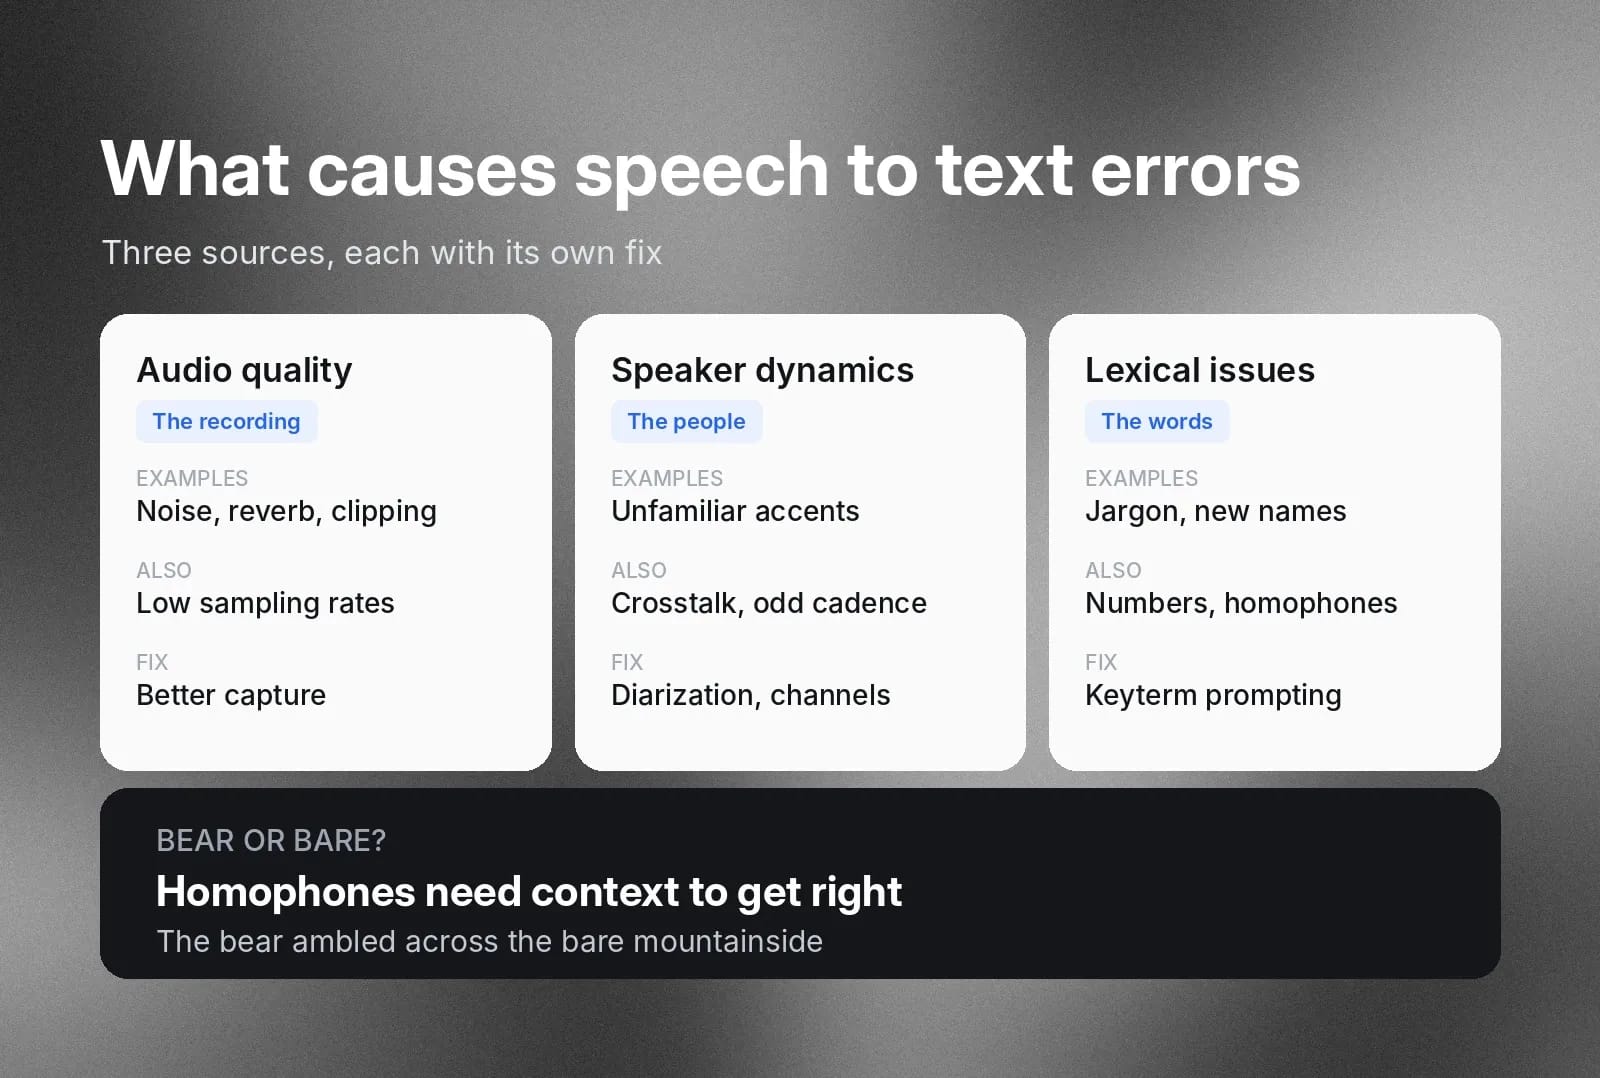
Há três principais causas de conversões imprecisas de Speech to Text:
- Problemas na qualidade do áudio de entrada
- Dinâmica dos falantes
- Questões lexicais e contextuais
Cada causa exige uma correção diferente, abordada nas seções a seguir.
Problemas de qualidade do áudio
Primeiro, a própria gravação de áudio pode apresentar problemas. Problemas no microfone podem fazer a fala ficar distorcida ou cortada. Reverberação causada pela acústica do ambiente, uma baixa relação sinal-ruído (SNR) na gravação ou uma baixa taxa de amostragem também podem remover informações fonéticas importantes das gravações.
Dinâmica dos falantes
Um único falante com sotaque neutro, falando em um ambiente silencioso, será relativamente fácil de transcrever. Mas esse raramente é o tipo de gravação que queremos transcrever. Sotaques desconhecidos e um ritmo de fala entrecortado ou simplesmente não tradicional podem confundir um modelo de STT treinado com fala padronizada. Conversas cruzadas ou falantes sobrepostos também podem prejudicar a capacidade de um modelo de interpretar corretamente o que está sendo dito.
Questões lexicais e contextuais
Por fim, o conteúdo da fala também pode desafiar alguns modelos de STT. Jargões do setor e nomes de produtos novos podem não estar entre os termos que um modelo de STT encontrou durante o treinamento. Como ele seleciona a saída estatisticamente mais provável, uma fala desconhecida pode não ser uma previsão prioritária. Expressões numéricas ou matemáticas, ou falas que normalmente seriam escritas com números, também podem não ser transcritas com clareza.
Homófonos são palavras que soam iguais, mas têm grafias diferentes. Um modelo de STT precisa entender o contexto o suficiente para diferenciá-las. Por exemplo, em inglês, “the bear ambled across the bare mountainside”. O modelo precisaria saber que o animal se escreve “bear” e que o adjetivo para uma superfície sem cobertura se escreve “bare”.
Como corrigir problemas de precisão de Speech to Text, do áudio à saída
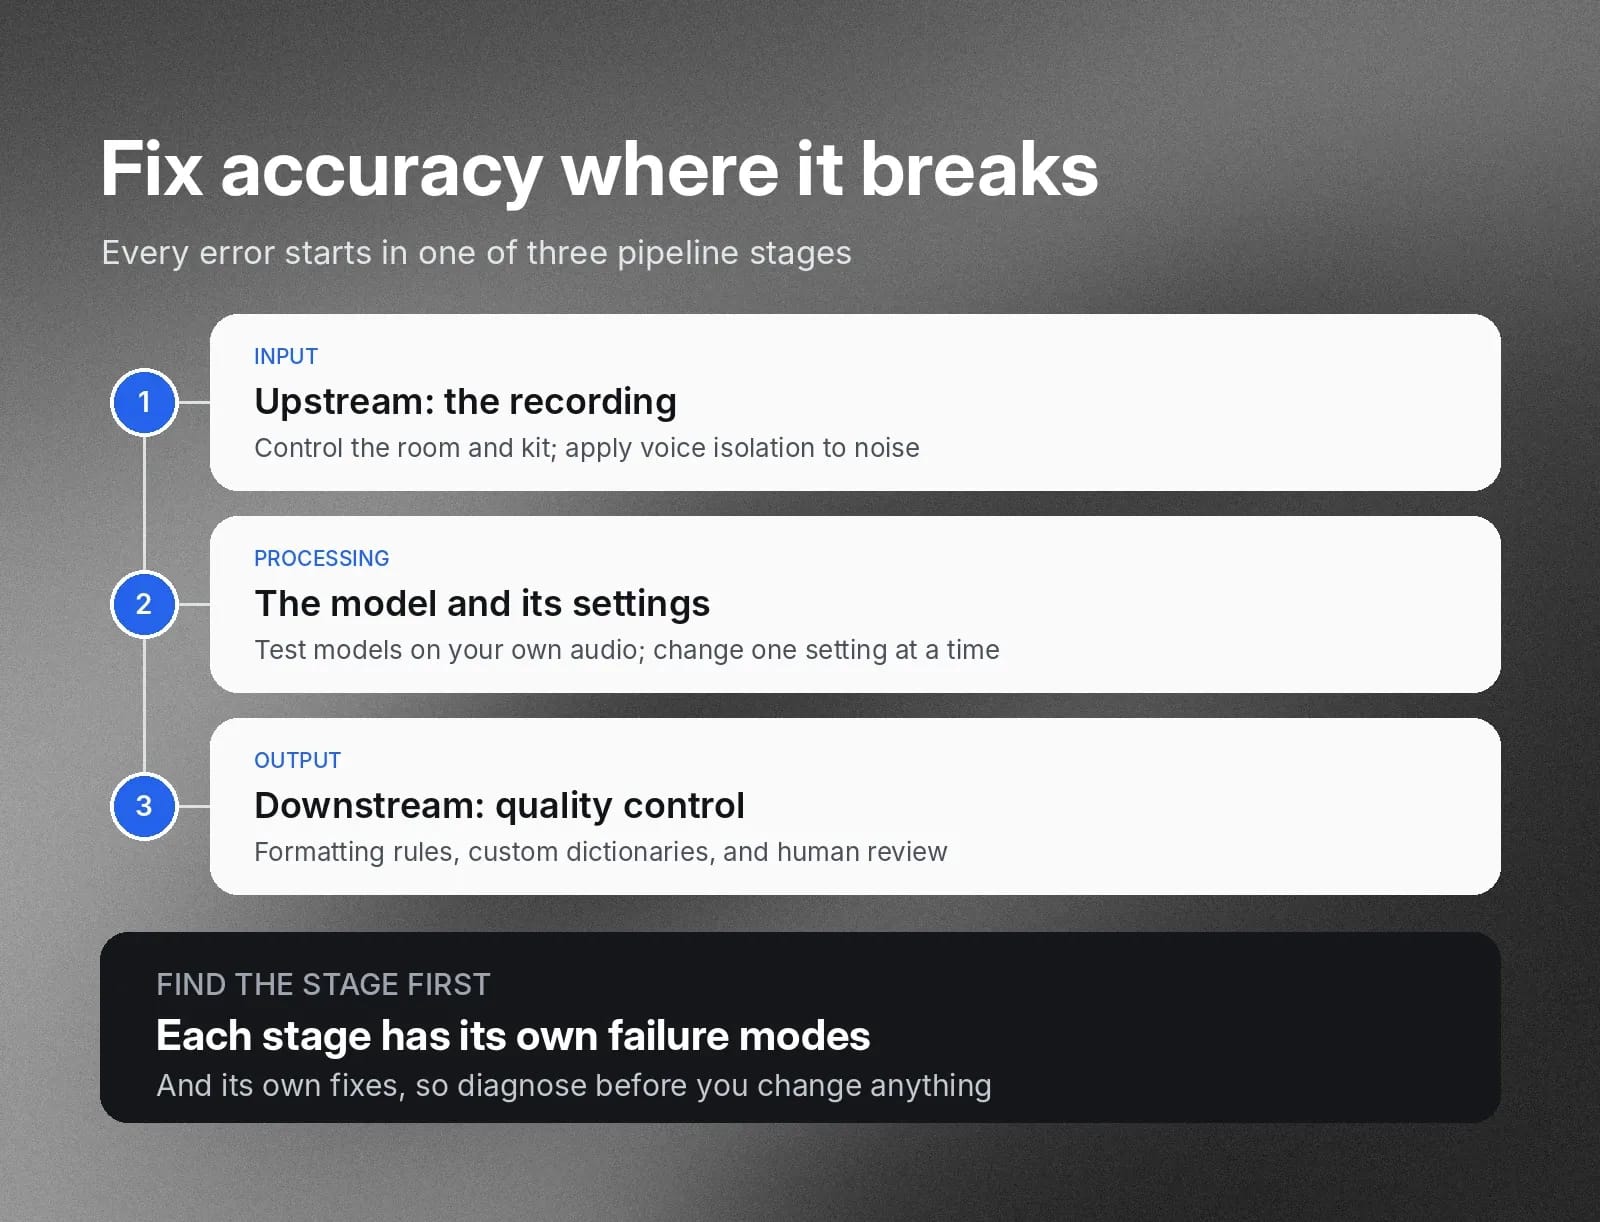
O processamento de Speech to Text ocorre em uma série de etapas bem definidas. Para corrigir um problema de precisão, você precisa identificar onde, nesse pipeline, pode fazer uma alteração. Em linhas gerais, o processo de STT se divide em:
- Entrada
- Processamento
- Saída
Cada etapa tem seus próprios modos de falha e suas próprias correções.
Problemas de precisão na entrada
Pode haver problemas no ambiente em que você está gravando. Problemas comuns incluem ruído de fundo ou ecos. O equipamento de gravação também pode ser a causa se estiver com defeito.
Corrigir problemas nessa etapa normalmente envolve identificar o que os está causando e resolvê-lo. Por exemplo, se você sabe que a ferramenta de STT tem dificuldade com ruídos altos, é uma boa ideia realizar conversas em um ambiente sobre o qual você tenha mais controle.
Para qualquer ruído que não puder evitar, aplique isolamento de voz antes que o áudio chegue ao modelo.
Problemas de precisão no processamento
A forma como você configura sua API para um mecanismo de STT pode afetar o processamento. A estrutura do prompt e o modelo escolhido também podem afetar a qualidade e o número de imprecisões.
Corrigir problemas nessa etapa significa testar sua configuração com seus próprios áudios. Execute as mesmas gravações de amostra em cada modelo candidato, compare suas taxas de erro de palavras e altere uma configuração por vez para refinar o resultado.
Se um modelo continua errando um tipo de fala, como uma chamada ruidosa ou determinado sotaque regional, teste modelos diferentes quanto à precisão no ambiente exato em que você vai usá-los.
Problemas de precisão na saída
Esta é sua camada de controle de qualidade, em que processos especializados limpam erros e ambiguidades de transcrição que seu mecanismo principal pode ter deixado passar. Pipelines de STT usam regularmente correspondência de padrões baseada em regras para padronizar a formatação — por exemplo, mudar “dez dólares” para “$10.00” — em um processo chamado normalização inversa de texto (ITN). Mas, se um falante usar um desses termos de forma não padronizada ou pronunciá-lo incorretamente, uma ferramenta rígida de localizar e substituir não conseguirá identificá-lo.
Também há a questão de um humano no circuito (HITL) verificar a qualidade da saída. Caso contrário, imprecisões podem chegar ao resultado de produção. Como em qualquer atividade feita por uma pessoa, existe a possibilidade de erro humano.
Nesta etapa, corrigir problemas significa identificar os erros que seus mecanismos principais deixam para trás. Você pode comparar transcrições com uma amostra de referência para descobrir quais erros se repetem e, em seguida, adicionar regras específicas ou um dicionário personalizado para esses termos. Especialmente em transcrições de alto risco, sempre inclua uma etapa de revisão humana.
Como melhorar a precisão do reconhecimento de fala com áudio melhor
Melhorar a qualidade do áudio durante a gravação pode reduzir muitos problemas de precisão posteriores. Use uma taxa de amostragem mais alta, aplique pouca ou nenhuma compressão e mantenha o ambiente de gravação o mais claro possível.
Qualidade da amostragem
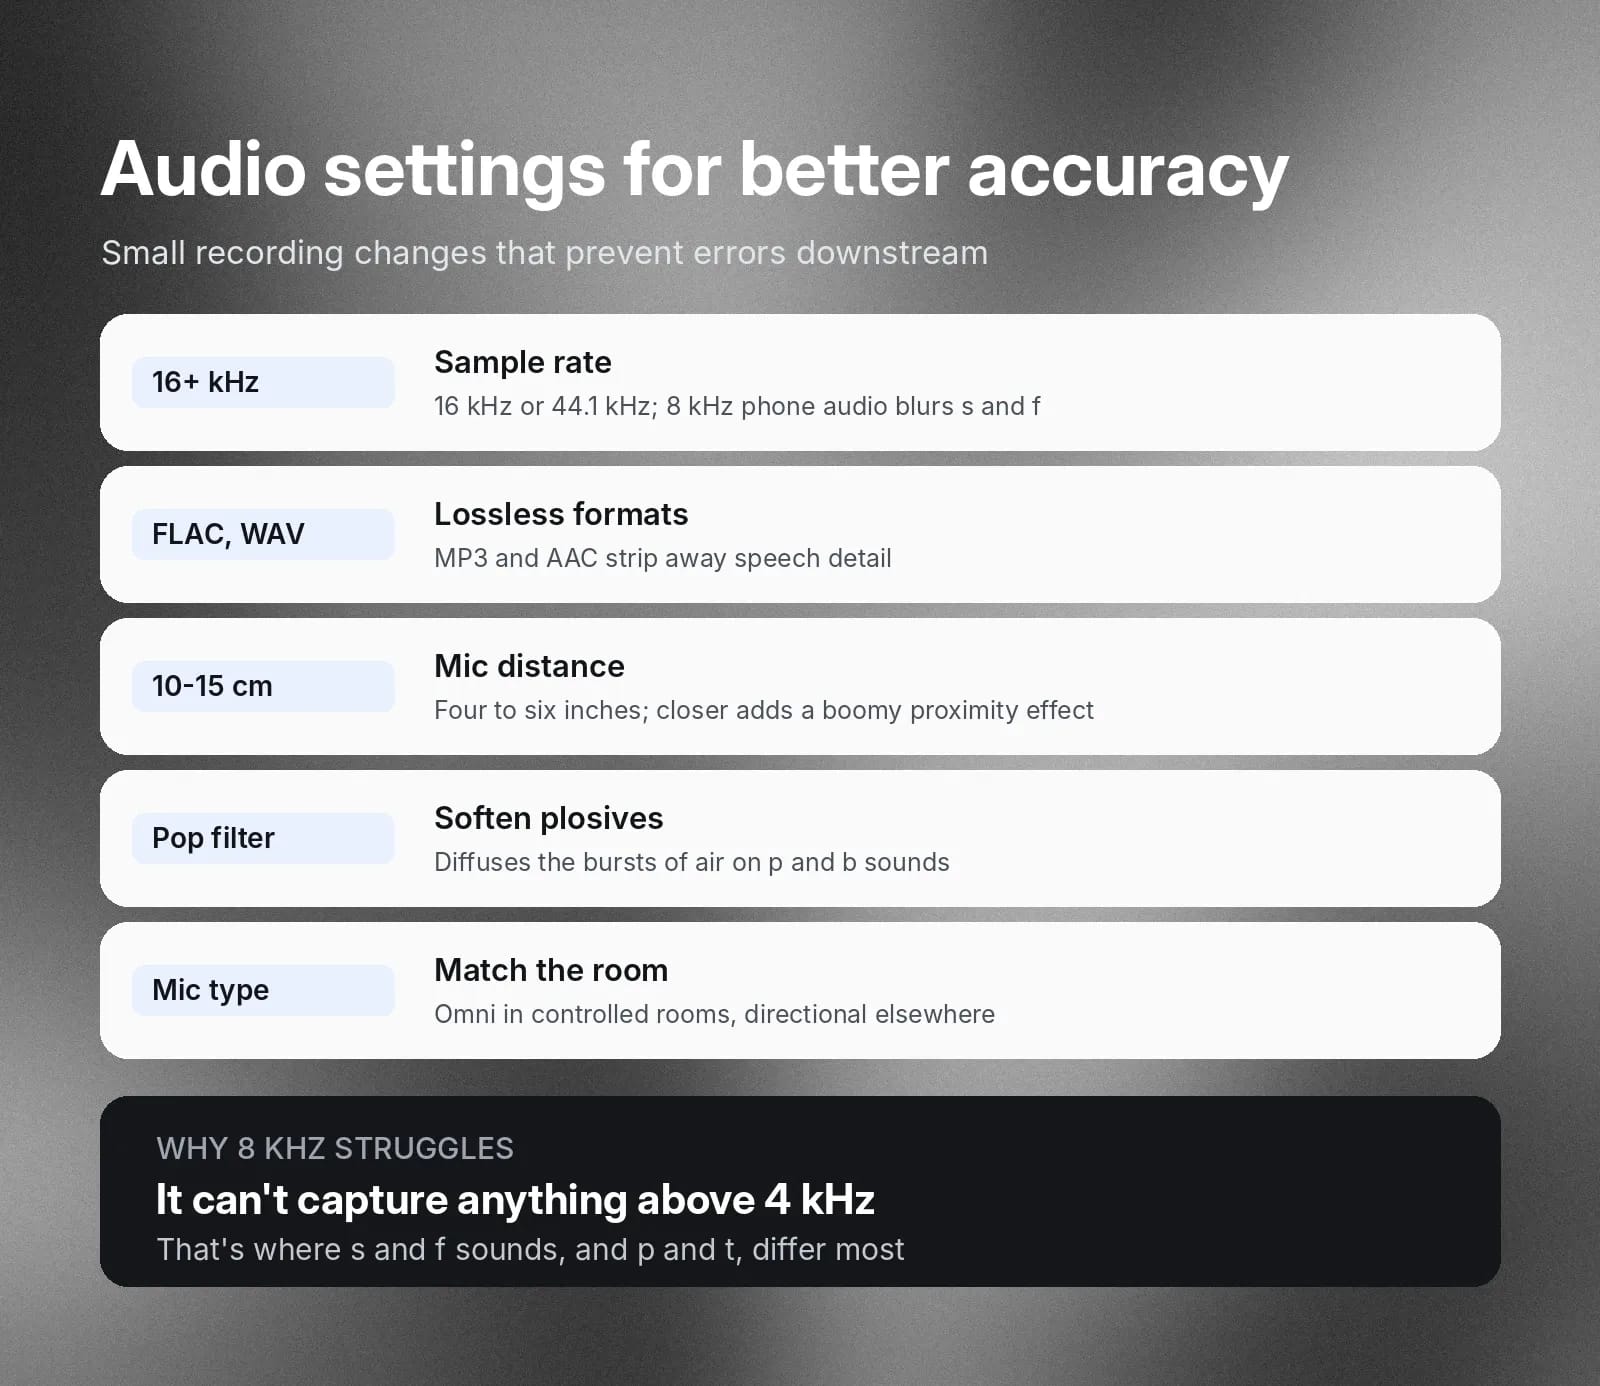
Use áudio de 16 kHz ou 44,1 kHz para gravação. A amostragem legada de áudio telefônico de 8 kHz ou inferior pode ser difícil de interpretar para modelos de STT. Para os modelos, o som fica abafado e distorcido, e eles não podem pedir que os falantes repitam como uma pessoa faria em uma chamada.
Uma taxa de amostragem só consegue reproduzir frequências de até metade dessa taxa. Isso é chamado de frequência de Nyquist do sistema. Com apenas 8 kHz, tudo acima de 4 kHz seria cortado, tornando especialmente difícil para um modelo de STT diferenciar fricativas (sons de “s” e “f”) e oclusivas (sons de “p” e “t”).
Compressão
Gravar em formatos com perdas, como MP3 e AAC, também pode eliminar nuances da fala. Há menos sinal para o modelo processar. Prefira formatos sem perdas ou não compactados, como FLAC ou PCM WAV.
Ambiente de gravação
Siga as práticas recomendadas de engenharia de áudio para o uso de microfones. Microfones omnidirecionais funcionam melhor em ambientes controlados. Caso contrário, microfones direcionais são melhores para isolar a fala. Posicione os microfones de 10 a 15 cm da boca do falante e evite que os falantes se aproximem, pois isso cria um efeito de proximidade e deixa a gravação turva devido ao reforço das frequências baixas.
Sempre que possível, use também um filtro anti-puff no microfone. Esses filtros dispersam as rajadas de ar geradas ao pronunciar consoantes oclusivas, como os sons de “p” e “b”.
Reduza o ruído de fundo para melhorar o reconhecimento de fala
Como observado na seção anterior, use gravação com microfone próximo sempre que possível, idealmente de 10 a 15 cm da boca do falante. Evite ruído branco e ruído de fundo que possam deixar as gravações turvas. Fontes comuns que você talvez não perceba sem experiência em gravações externas incluem o zumbido de sistemas de climatização, cliques de teclado e ruído geral da rua. Todos eles podem dificultar a capacidade de um modelo de STT de interpretar a fala.
No entanto, muitas vezes não é possível evitar o ruído de fundo. Nesse caso, aplique isolamento de voz como uma etapa de pré-processamento antes de enviar o áudio a um modelo de STT. O isolamento de voz usa algoritmos de software ou um modelo neural especializado e leve para filtrar o áudio de fundo de gravações de fala.
Lide com sotaques, falantes sobrepostos e vocabulário especializado
Modelos multilíngues modernos são treinados com conjuntos de fala diversos, mas seus níveis de precisão ainda variam ao trabalhar com áudio do mundo real. Faça seus próprios benchmarks em modelos diferentes usando amostras de áudio dos seus públicos relevantes. Se você tiver chamadas históricas de atendimento que possa usar, execute-as pela transcrição, especialmente as que apresentam os sotaques, ritmos e padrões de fala que você quer transcrever no mundo real.
Verifique se há erros nas saídas e identifique padrões relevantes. O modelo tem dificuldade com gírias usadas por faixas etárias mais jovens? Ele tropeça em algum sotaque regional específico que você encontra com frequência?
Lide com falantes sobrepostos
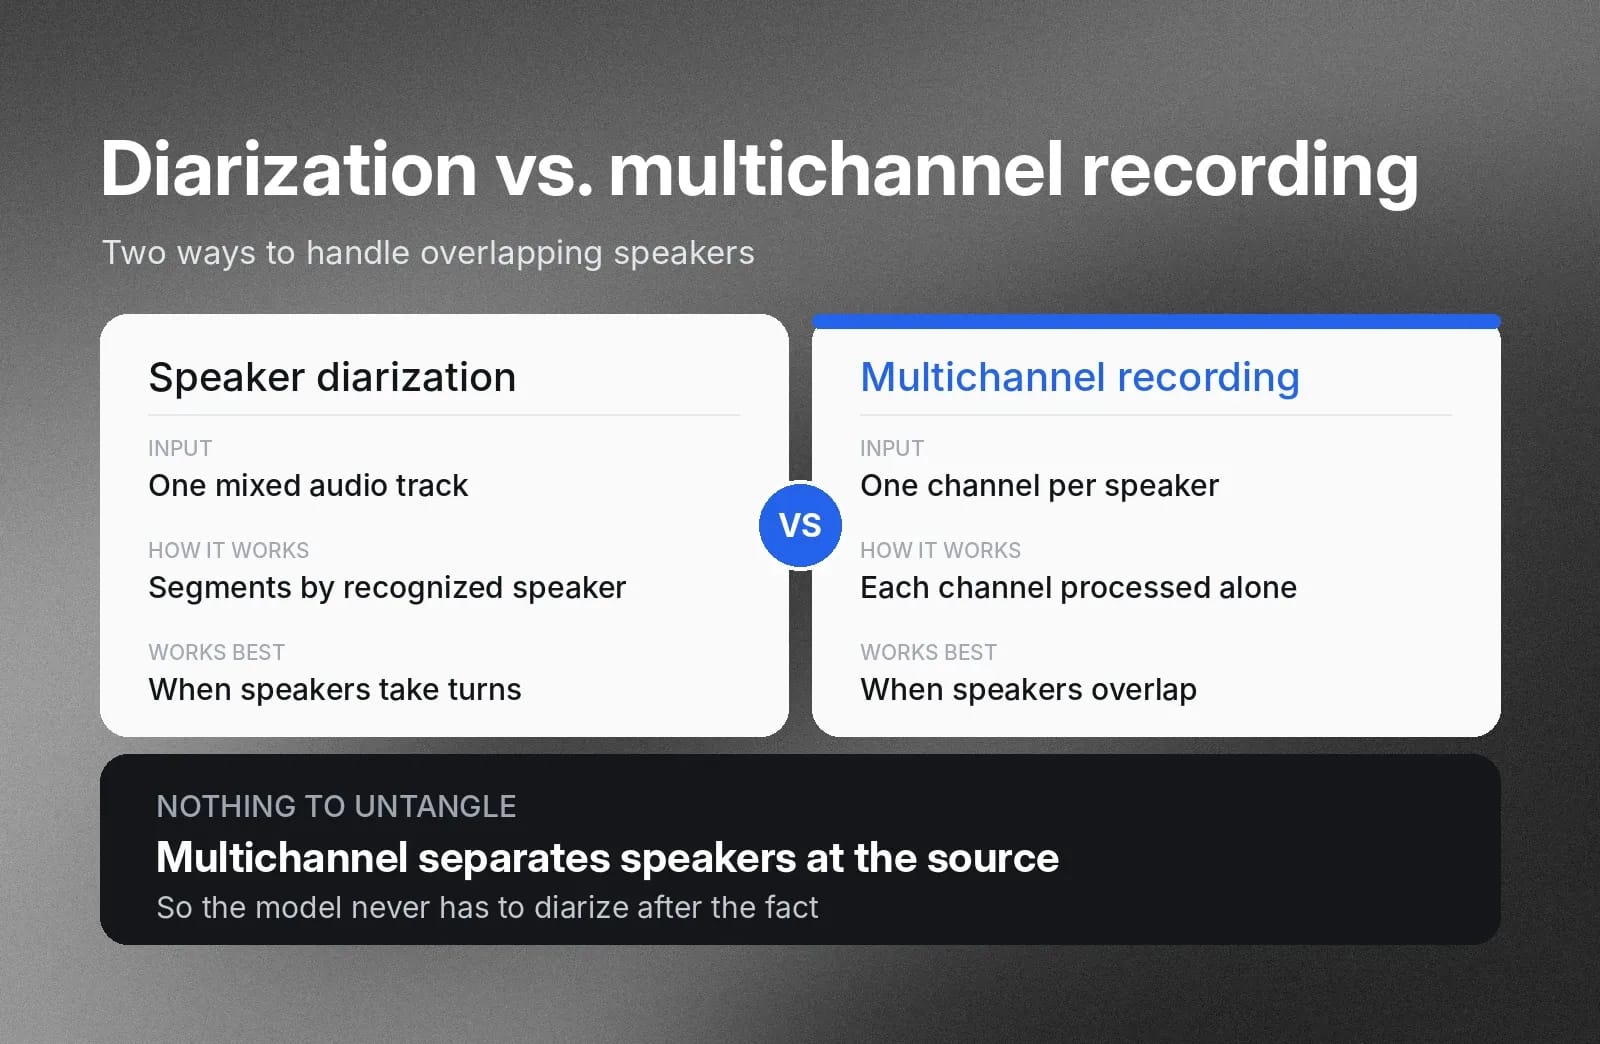
Suas duas principais ferramentas para transcrever com precisão falas sobrepostas são a diarização e a gravação multicanal. Um processo de diarização recebe uma entrada de áudio bruta e a segmenta por falantes identificados individualmente. Ele funciona bem quando os falantes se alternam claramente.
Em vez de misturar todos os fluxos de voz em uma única faixa de áudio, a gravação multicanal nativa permite manter cada falante em um canal separado, que o modelo de STT pode identificar e processar de forma independente. Cada falante já fica separado nativamente na gravação, então não há nada para um modelo de fala diarizar posteriormente.
Keyterm prompting cria viés positivo
Nomes de marcas, novos nomes de produtos, jargões do setor e outros termos únicos muitas vezes não são transcritos com precisão se não estavam nos dados de treinamento de um modelo de STT. Keyterm prompting é o processo de fornecer a um modelo de STT grafias específicas que você quer que ele priorize. Em geral, não são prompts de substituição direta; você apenas direciona o modelo a selecionar a grafia personalizada desejada com base no contexto.
Transcreva números, IDs e nomes de medicamentos com precisão
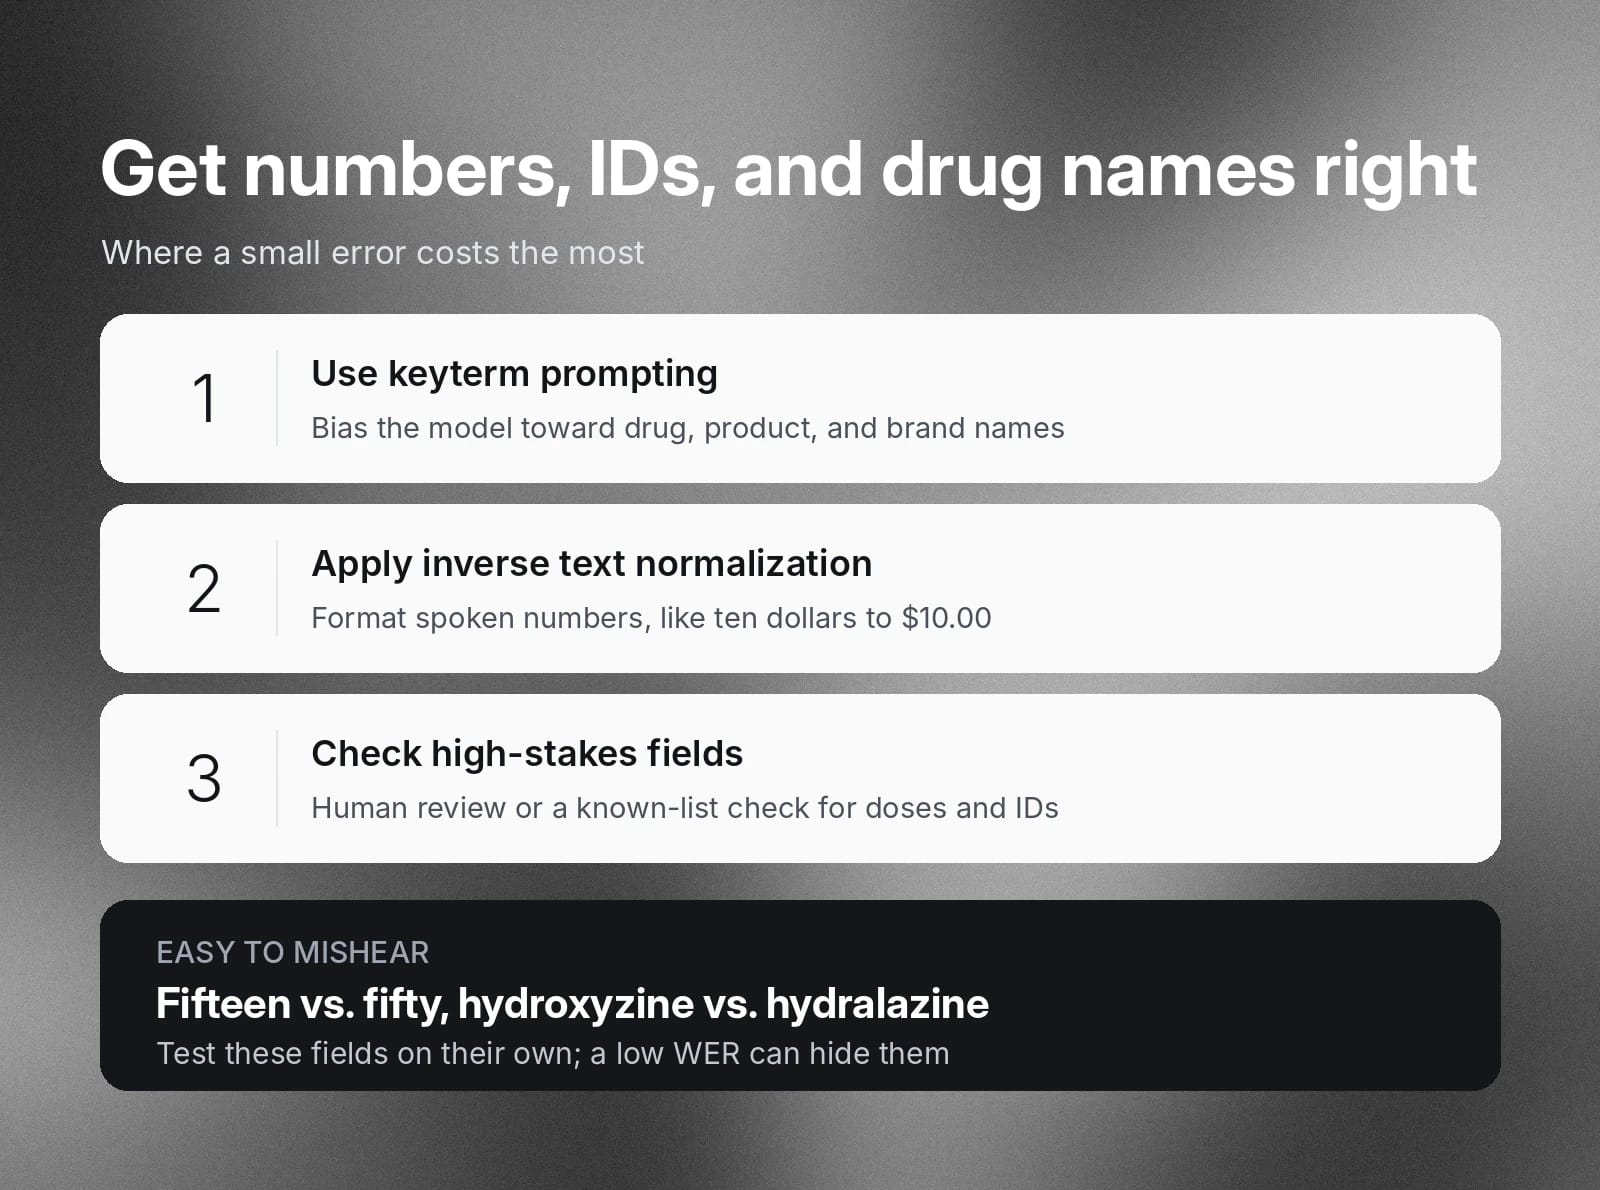
Números, IDs de contas, CEPs e nomes de medicamentos são casos em que um pequeno erro tem o maior custo. Um modelo pode ouvir “quinze” como “cinquenta” ou confundir dois nomes de medicamentos que diferem por uma sílaba, como hidroxizina e hidralazina.
Três etapas ajudam:
- Use keyterm prompting: Direcione o modelo às grafias de nomes de medicamentos, produtos e outros termos que você espera encontrar.
- Aplique a normalização inversa de texto (ITN): Formate números falados de forma consistente, por exemplo, mudando “dez dólares” para “$10.00”.
- Inclua uma verificação para campos de alto risco: Use revisão humana ou uma verificação automatizada em relação a uma lista conhecida para campos como dosagens de medicamentos e números de conta.
Teste esses campos separadamente, pois uma WER geral baixa pode esconder erros justamente nas palavras que mais importam.
Meça a qualidade com a taxa de erro de palavras no reconhecimento de fala
A taxa de erro de palavras (WER) é uma métrica útil para avaliar a precisão de um mecanismo de STT. Você pode comparar a WER entre diferentes testes de modelo para entender sua precisão relativa.
Veja como a WER é calculada:
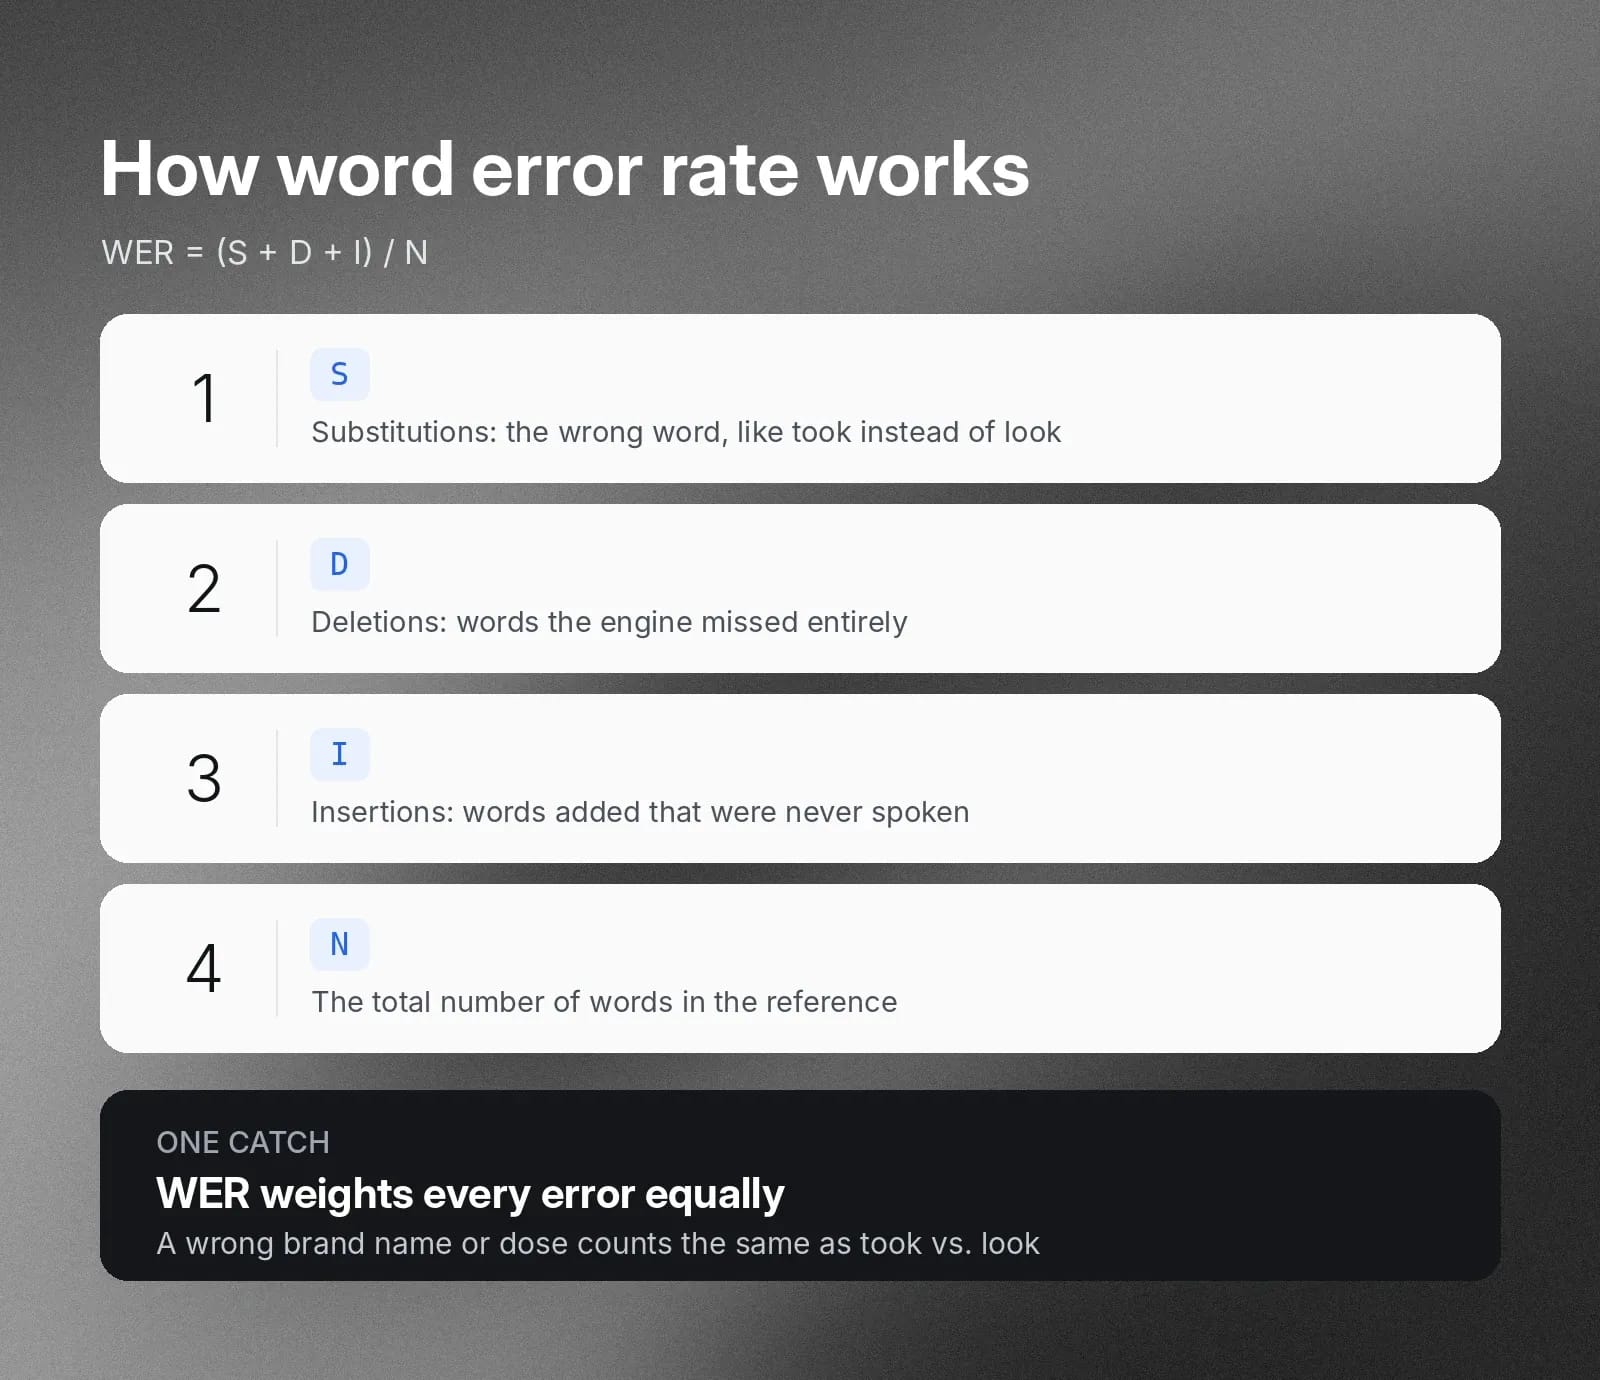
WER = (S + D + I) / N
- Substituições (S): em uma transcrição, o número de vezes que o mecanismo de STT produz a palavra errada, por exemplo, “took” em vez de “look”.
- Omissões (D): o número de palavras que ele deixou de identificar completamente.
- Inserções (I): o número de palavras que ele adicionou e que nunca foram ditas.
- Total de palavras de referência (N): o número total de palavras na entrada de fala de amostra.
É importante observar que a WER atribui o mesmo peso a todos os erros. Por exemplo, substituir “took” por “look” tem o mesmo peso que reconhecer incorretamente o nome da sua marca ou um dado importante, como o tamanho de uma dose de medicamento. Verifique as WERs de modelos diferentes.
O que é considerado uma boa taxa de erro de palavras?
Não existe uma única WER considerada boa, pois a meta adequada depende do seu áudio e do seu caso de uso. Áudio limpo com um único falante produz taxas de erro muito menores do que chamadas ruidosas com falantes sobrepostos. Compare modelos nas suas próprias gravações em vez de se basear em um número de destaque.
Como referência para áudio especializado, o Scribe v2 Medical está entre os modelos com melhor desempenho em benchmarks públicos de ASR na área médica. Consulte os resultados atuais dos benchmarks para ver os números mais recentes.
Os resultados de benchmarks mudam à medida que novos modelos são lançados. Consulte os resultados atuais antes de comparar.
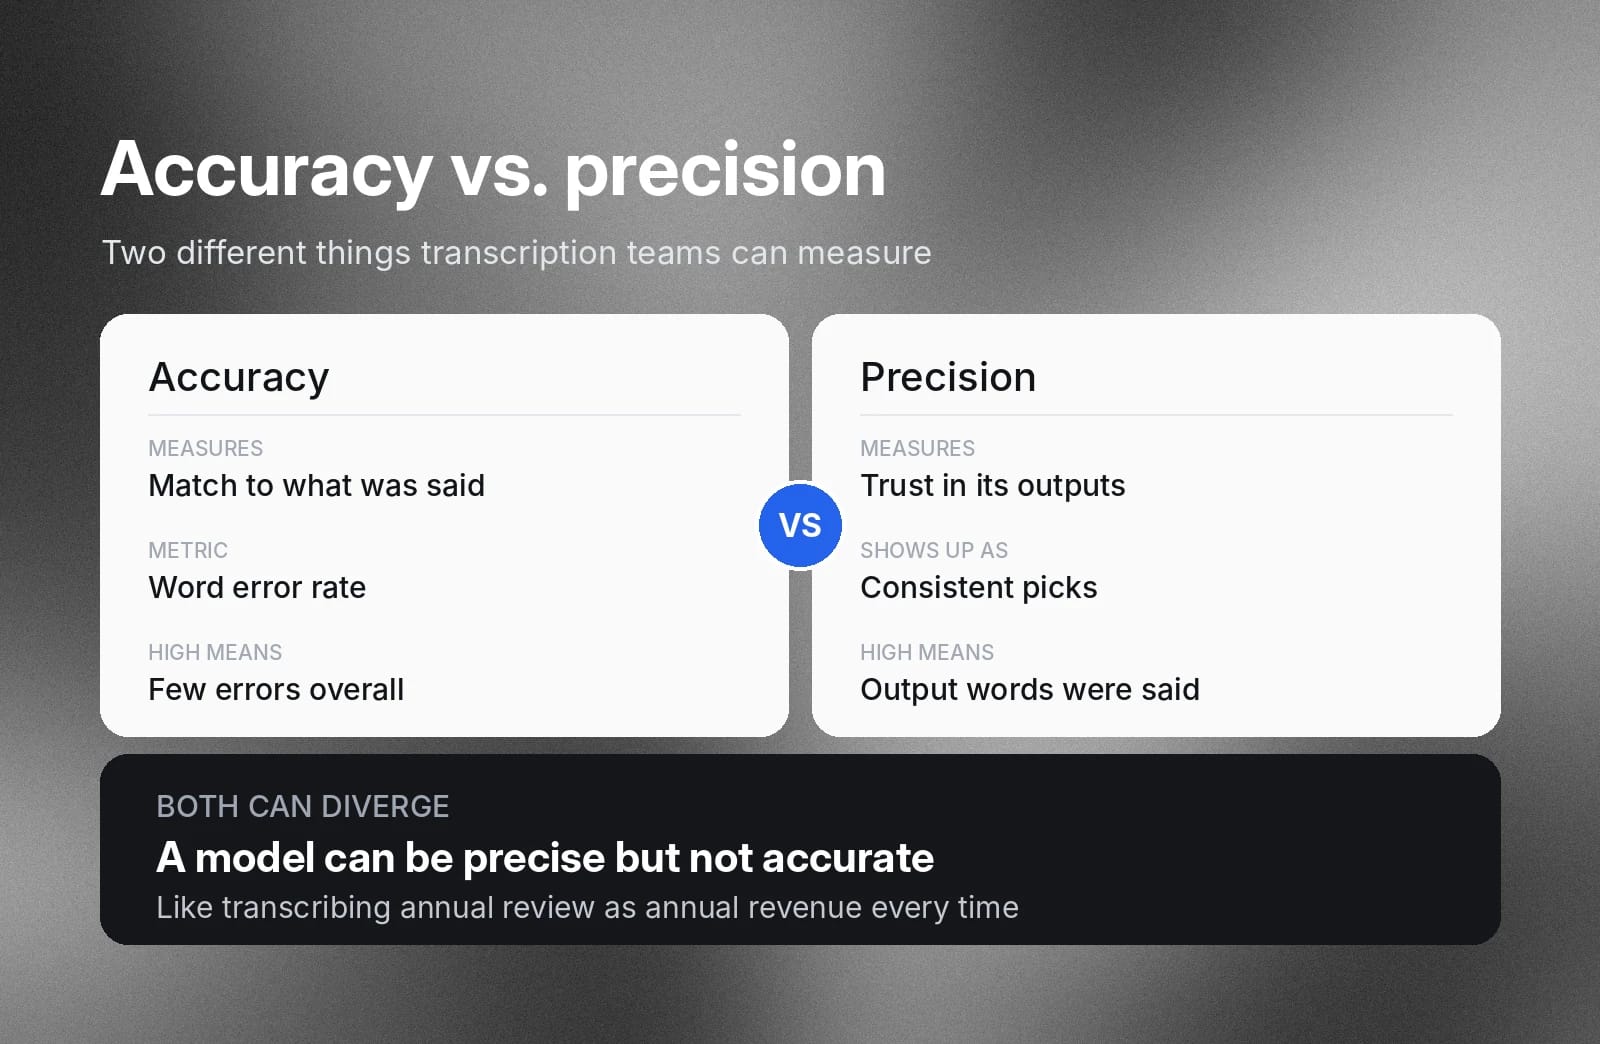
Exatidão vs. precisão: o que equipes de transcrição devem medir
Exatidão é o quanto a saída da transcrição corresponde à entrada falada que representa a “verdade de referência”. A taxa de erro de palavras mede a exatidão.
Precisão é o grau de confiabilidade das previsões positivas do modelo de STT. Um modelo altamente preciso selecionará a mesma palavra para falas complexas em várias execuções. Se o modelo produzir uma palavra, você pode confiar que essa palavra estava presente na fala. Mas um modelo altamente preciso ainda pode ter baixa exatidão, ou seja, pode omitir muitas palavras.
Comece a usar a ElevenAPI para transcrições mais precisas
A ElevenAPI dá acesso ao Scribe v2, o modelo de Speech to Text da ElevenLabs, além de recursos que resolvem os problemas de precisão deste guia: keyterm prompting para nomes e jargões, transcrição multicanal para falantes sobrepostos e diarização de falantes.
Se quiser transcrever sem usar a API, você também pode acessar o ElevenCreateive STT.
Comece hoje a gerar Speech to Text de alta qualidade com a ElevenAPI ou saiba mais sobre os recursos de Speech to Text da ElevenAPI.
Perguntas frequentes sobre a precisão de Speech to Text

Jack Limebear faz parte do time de Growth, atuando como redator e estrategista de conteúdo no blog e nas páginas de insights. Antes da ElevenLabs, ele passou mais de dez anos liderando estratégias de conteúdo em organizações que vão de startups SaaS em rápido crescimento a empresas da Fortune 500. Ele é mestre em Literatura Inglesa pela Universidade de Cambridge.