AIアバタージェネレーター
最高の音声に、顔を
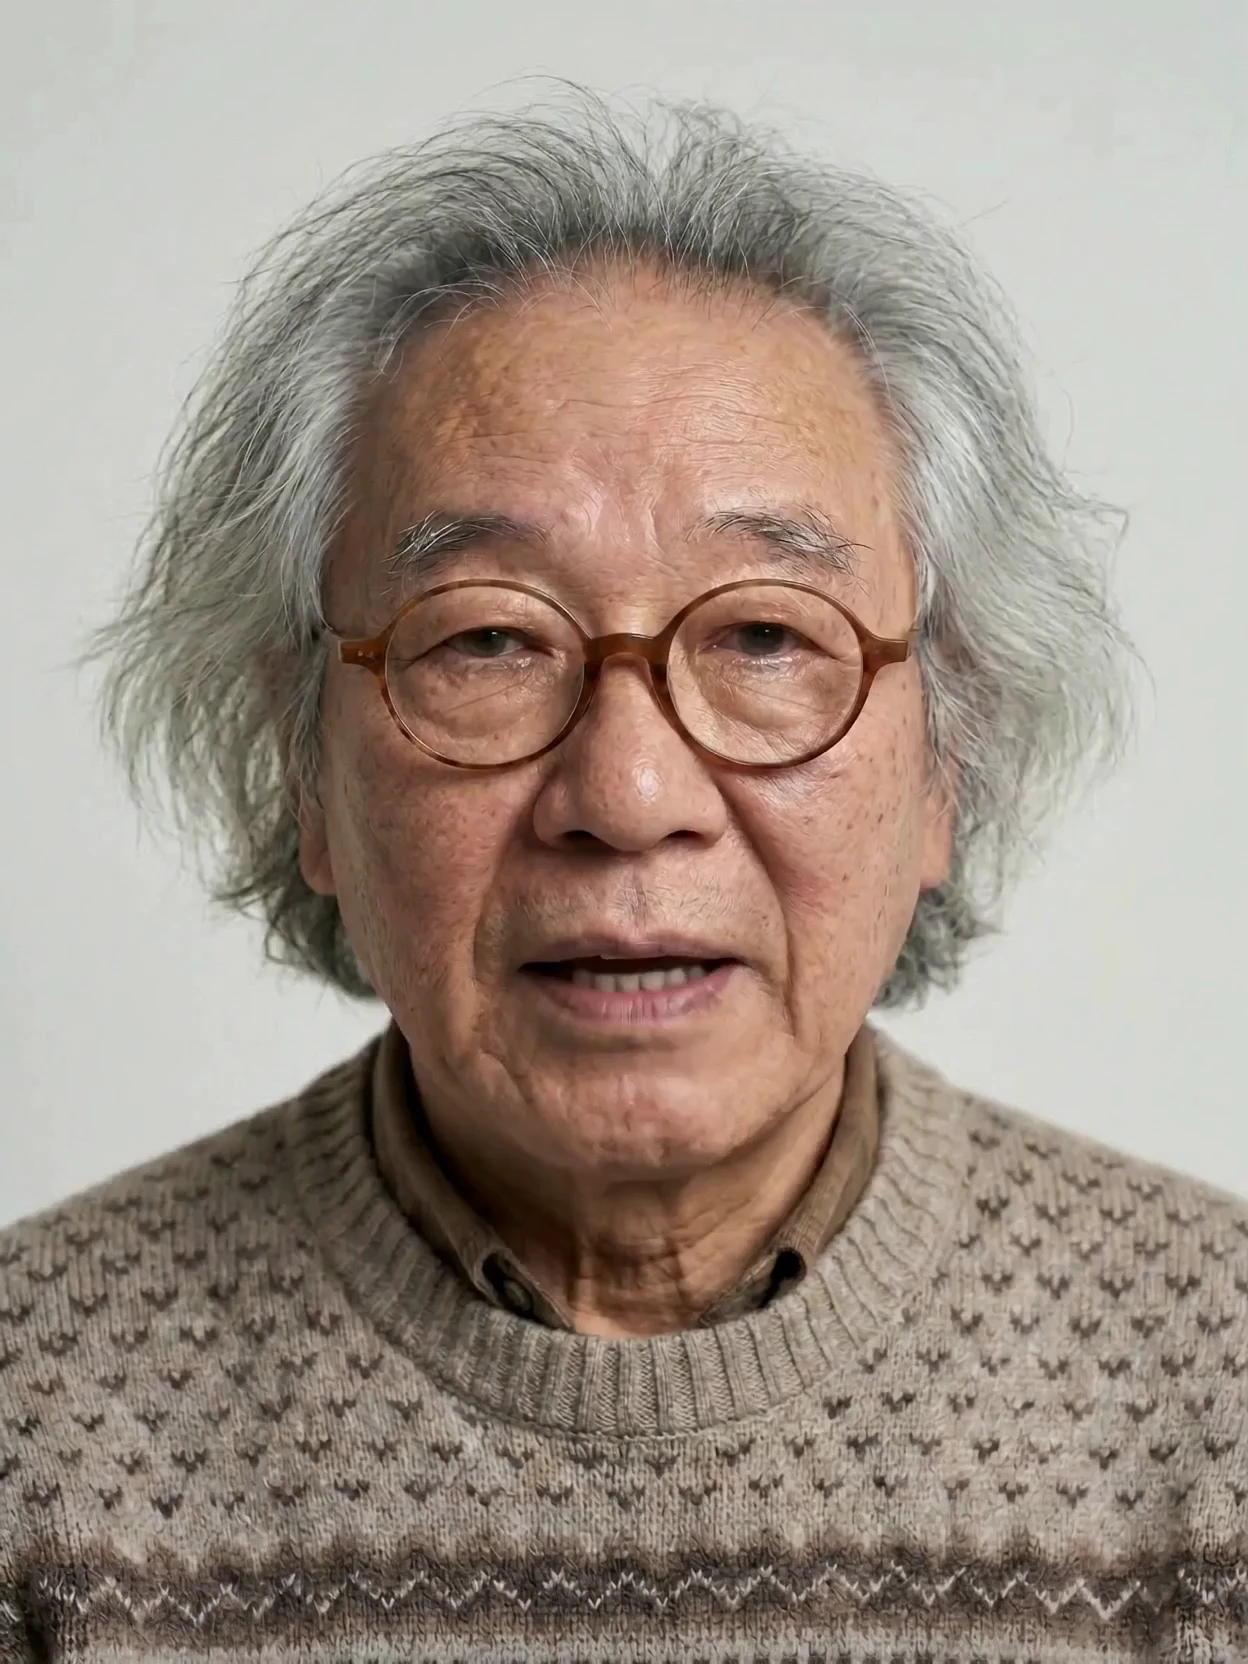
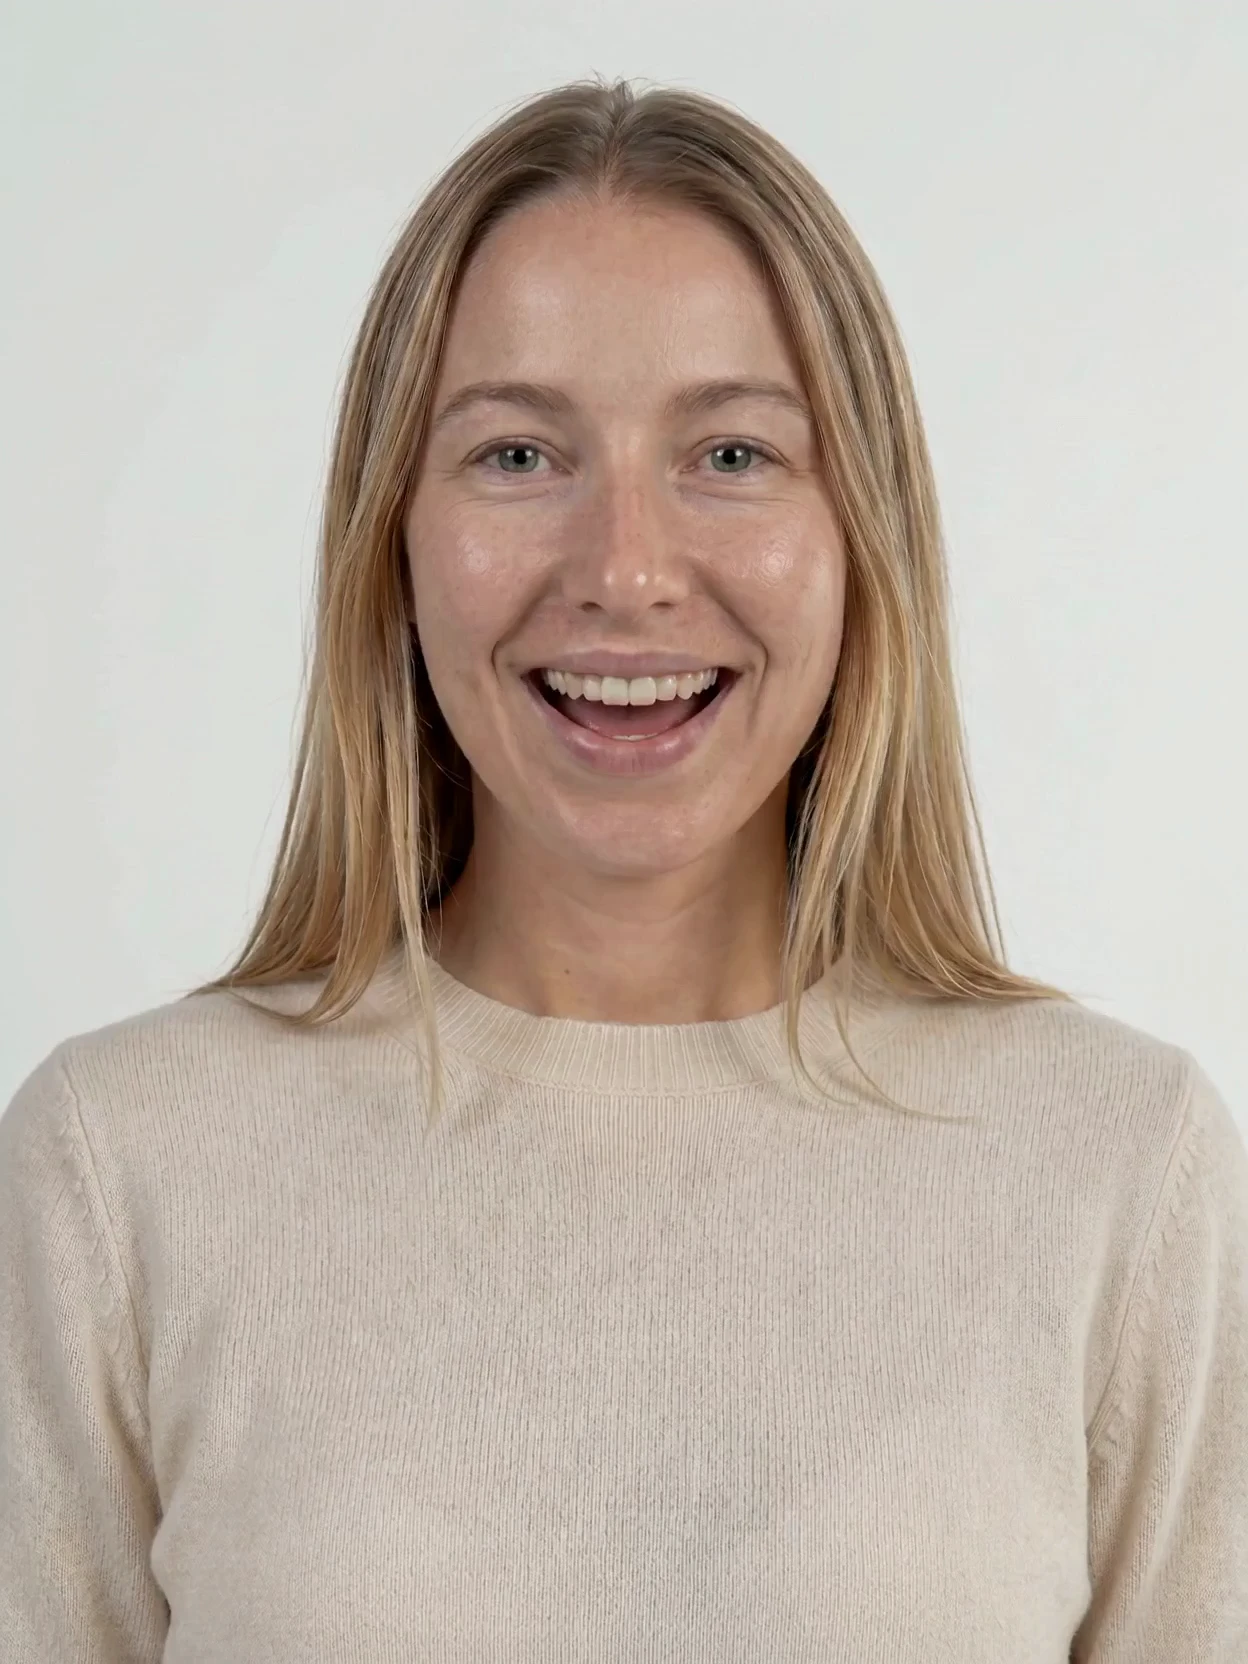
スクリプト、音声、アバターから、スタジオ品質のトーキングビデオを作成。すべてを1か所でまとめて生成できます。
仕組み
スクリプトから完成したビデオまで、すべて1か所で。ツールを行き来したり、引き継いだりする必要はありません。
1
Write your script
まずは言葉から。スクリプトを入力するか、貼り付けます。
2
Pick a voice and avatar
クローンした声を含むライブラリ内の任意の音声を選び、任意のアバターと組み合わせます。
3
Generate
音声とリップシンクビデオを、1ステップでまとめて生成します。
理想のアバターを見つける
AIアバタージェネレーターなら、あらゆるスタイルの顔を集めたライブラリを利用できます。話している様子をプレビューしたり、顔と声をクローンして自分だけのアバターを作成したりできます。
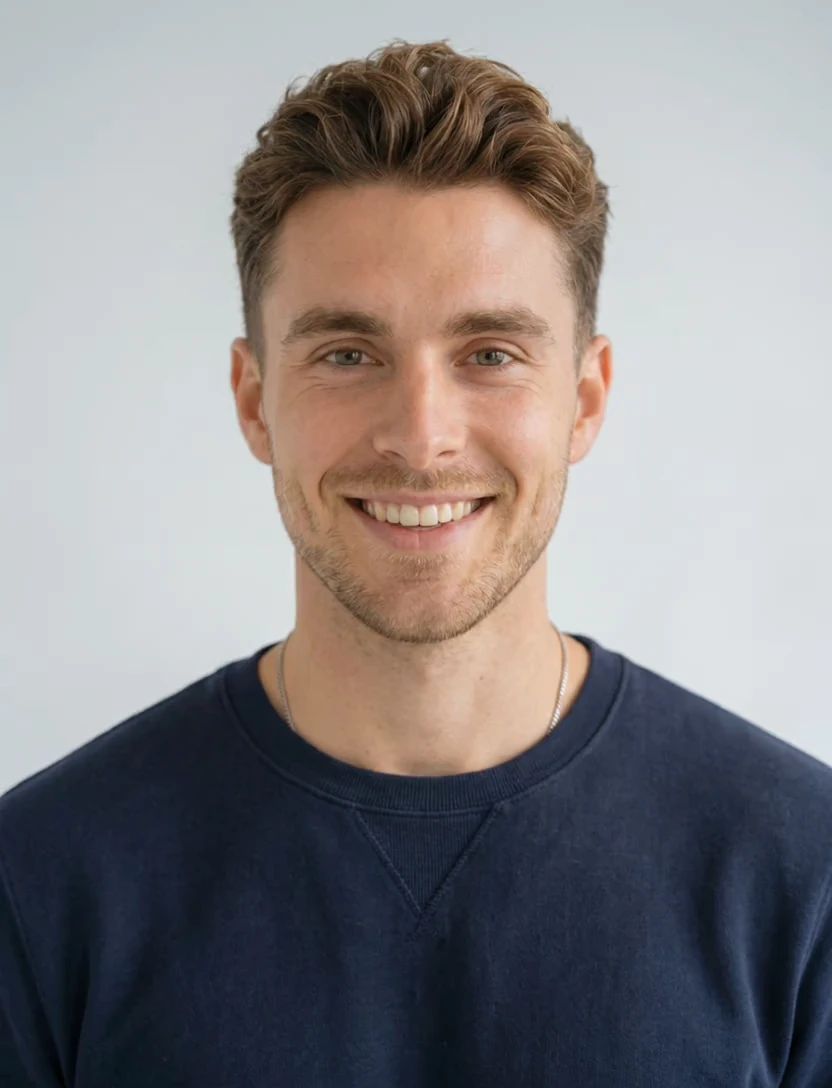
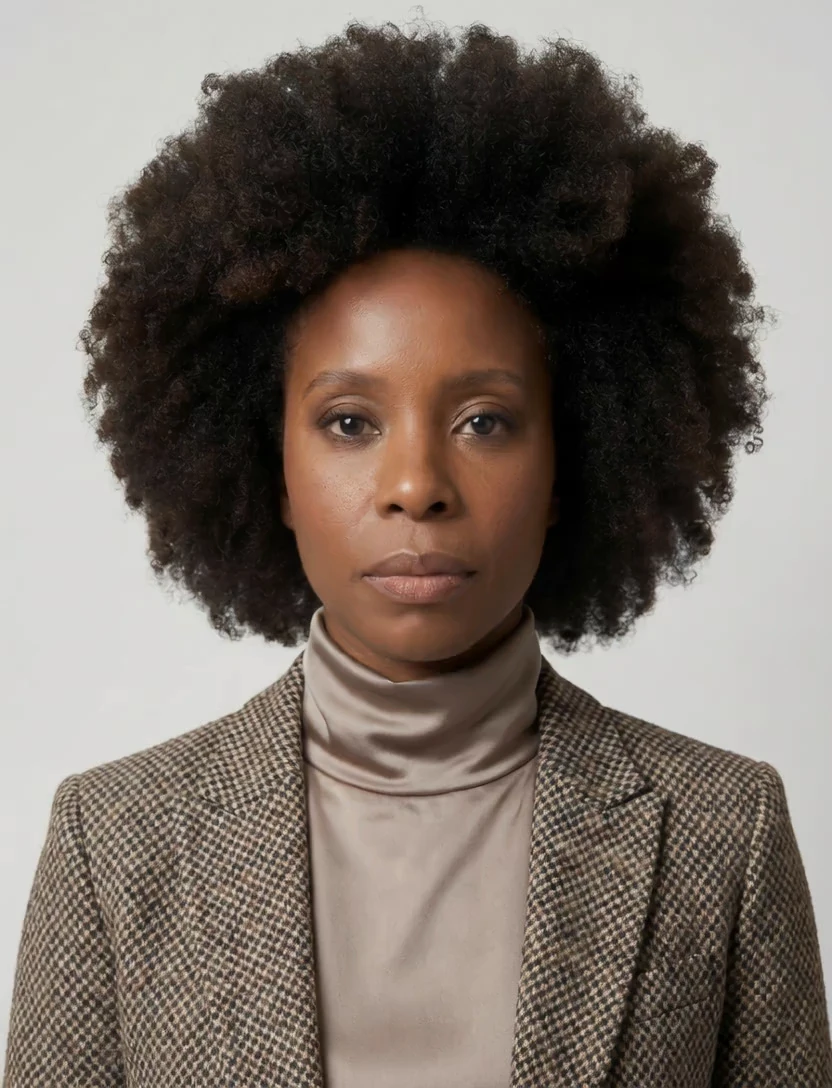
自分の写真から継続利用できるアバターを作成
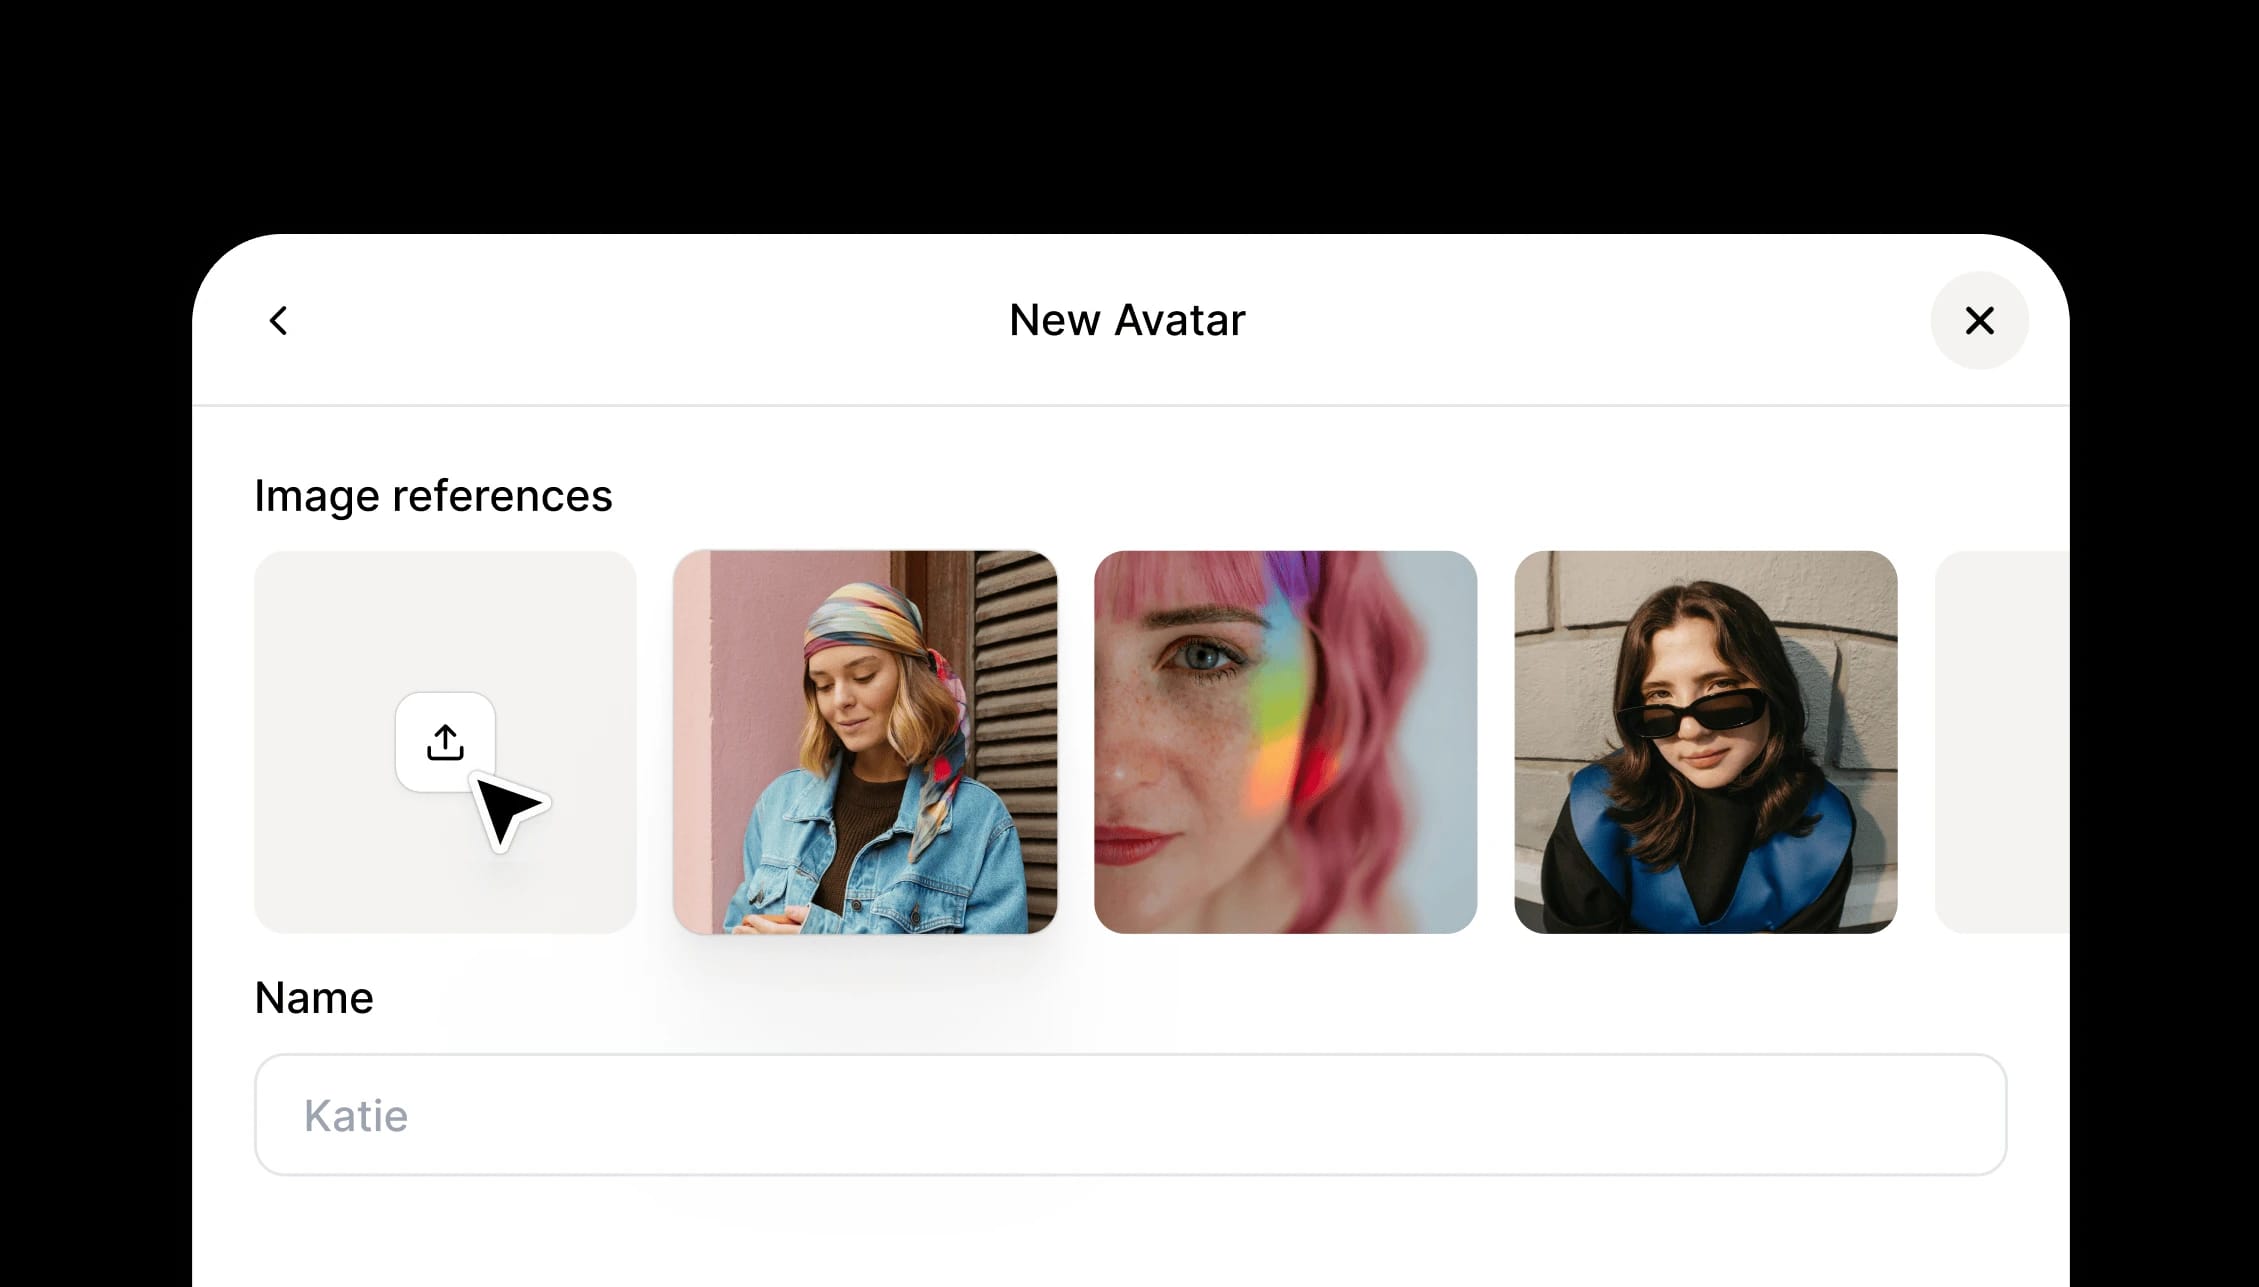
参照画像をアップロードし、アバターに名前を付けてスタイルを生成します。アバターは数百本のビデオで繰り返し使えるアイデンティティです。
参照画像をアップロード
同じ人物やキャラクターを、さまざまな角度から撮影した複数の参照画像を追加します。
スタイルを生成
角度、服装、背景、照明を変えたバリエーションを作成します。
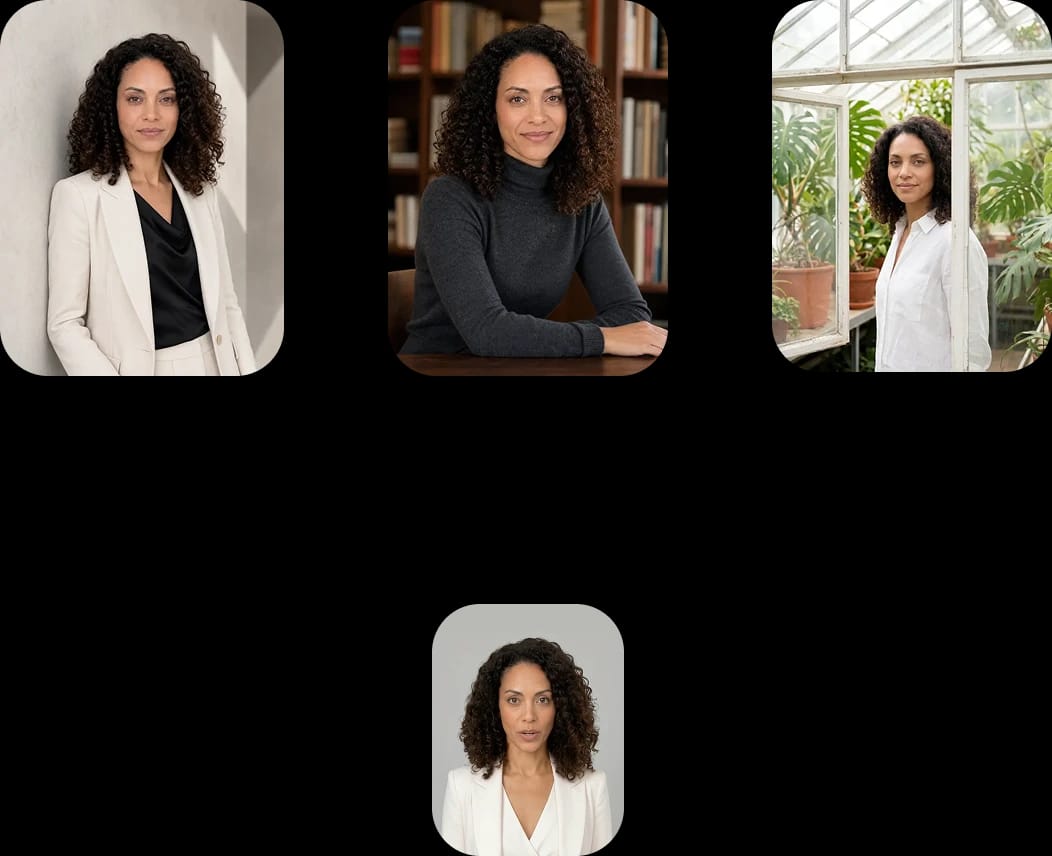
一貫性を保つ
ビデオを重ねても、同じアイデンティティを維持。生成ごとのずれを防ぎます。
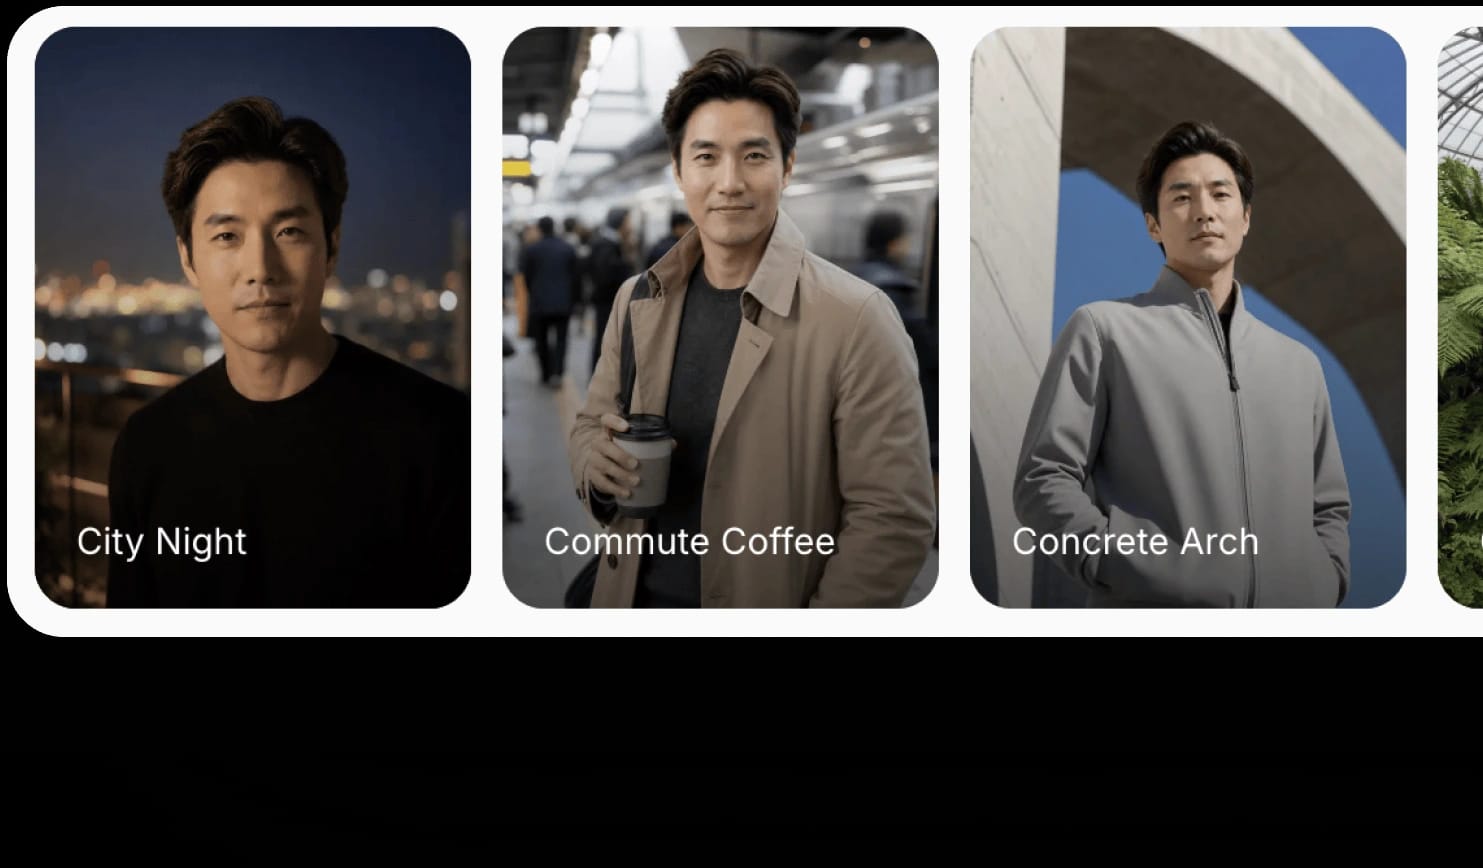
Flowsでスケール
フローにアバターノードを追加し、プロダクト、言語、フックに合わせたビデオを一括生成します。
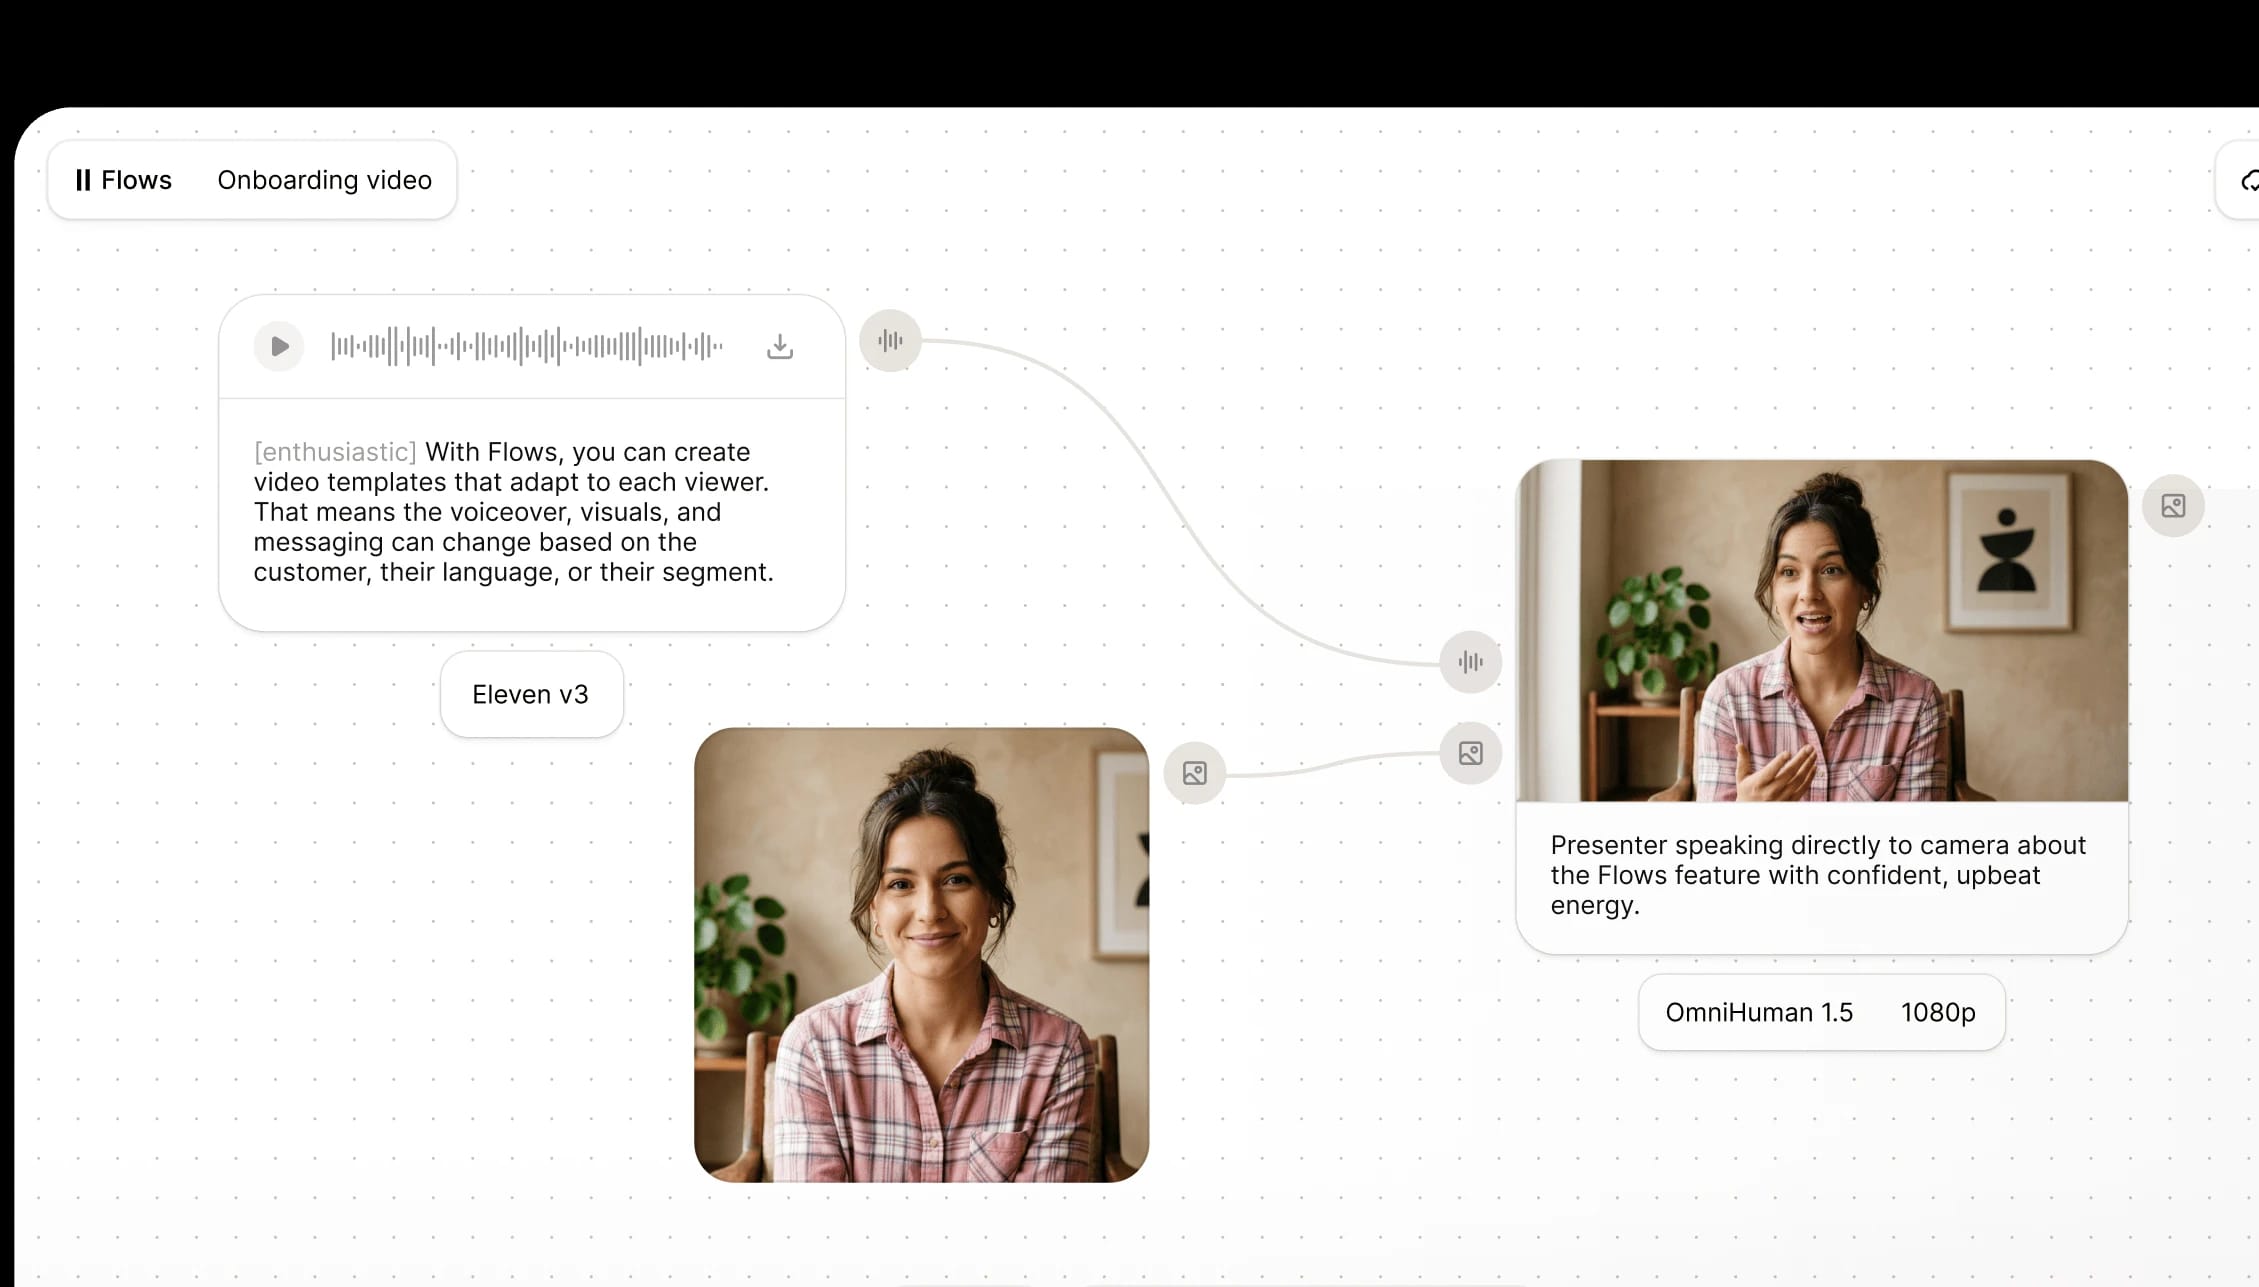
最高クラスのモデルでコンテンツに命を吹き込む
プロダクション品質のElevenLabsオーディオモデルと、業界をリードする画像・ビデオモデルを1つのプラットフォームで活用できます。