
Misurare l'IA conversazionale: metriche essenziali per il successo
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Gli strumenti di IA conversazionale riducono drasticamente i costi dell'assistenza clienti 24 ore su 24. Lo fanno senza dover coprire i turni notturni né assumere i rischi per la privacy dei dati legati all'esternalizzazione dei ruoli all'estero.
Ma il risparmio sui costi conta solo se un agente IA è in grado di risolvere i problemi dei clienti. Misurare l'IA conversazionale con gli indicatori chiave di prestazione giusti ti dice se sta funzionando, soprattutto nelle aziende che gestiscono un volume elevato di richieste dei clienti.
Questo articolo spiega come valutare il flusso conversazionale e l'accuratezza delle risposte protegga sia l'esperienza del cliente sia il tuo brand. Vedremo come i team che si occupano dell'esperienza del cliente svolgono efficaci esperimenti di A/B testing sui saluti rivolti a chi chiama. Scoprirai anche come gestire una piattaforma di IA conversazionale affidabile e multilingue.
In sintesi
- Misurare sistematicamente l'IA conversazionale in base a metriche di qualità, esperienza e operatività fornisce i dati necessari per proteggere l'esperienza del cliente.
- Gli strumenti di valutazione automatizzata monitorano e migliorano continuamente le metriche dell'IA conversazionale su larga scala, mentre gli operatori effettuano controlli a campione regolari.
- Isolare una variabile specifica alla volta nei test A/B semplifica l'individuazione esatta di ciò che non ha funzionato, così puoi implementare correzioni mirate direttamente ai problemi identificati.
- Il miglioramento continuo è necessario perché le aziende di IA aggiornano frequentemente i modelli sottostanti, facendo spesso comportare in modo diverso in produzione chatbot prima affidabili.
Cosa significa misurare l'IA conversazionale e perché è importante
Misurare l'IA conversazionale significa valutare sistematicamente quanto bene gli agenti IA che hai testato o distribuito gestiscono le richieste dei clienti e risolvono i problemi. L'obiettivo è determinare quanto efficacemente i tuoi sistemi automatizzati gestiscono conversazioni su più turni nel mondo reale, in base agli standard di prestazione che hai definito. Questi standard riflettono generalmente quanto bene i modelli comprendono l'intento dell'utente, rispettano il tono del brand, forniscono risposte accurate e risolvono con successo il problema.
Le valutazioni dei modelli possono sembrare molto lavoro aggiuntivo per un sistema pensato per ridurre le attività gestite dal tuo team. Ma senza una valutazione costante, sarebbe difficile sapere quanto bene il modello funziona nei casi d'uso reali. In altre parole, sai che il tuo sistema di IA riduce i costi operativi dell'assistenza clienti, ma puoi confermare che rende soddisfatti i clienti anziché spingerli a cercare altre soluzioni?
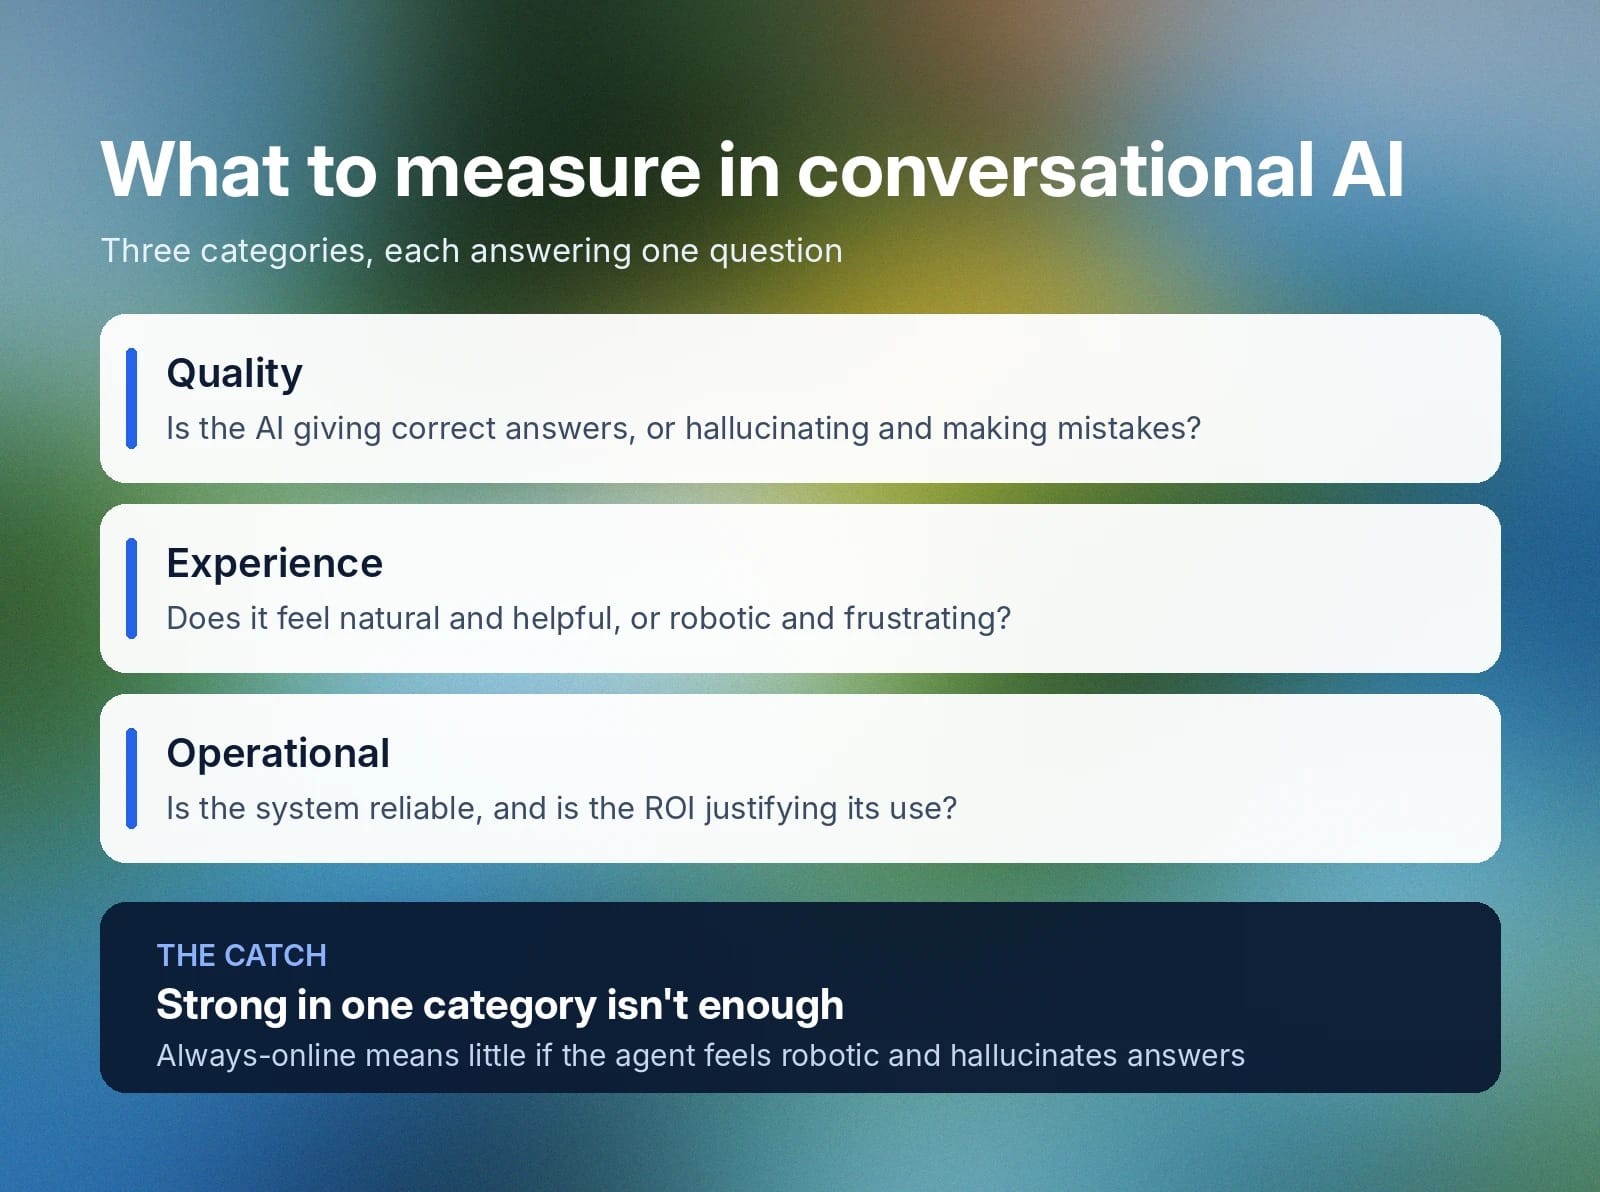
Una misurazione completa richiede di esaminare il modello in tre categorie principali:
- Qualità: valuta quanto le risposte dell'IA siano accurate, coerenti e pertinenti rispetto alla richiesta iniziale dell'utente. La domanda principale è: l'IA fa le cose correttamente e fornisce agli utenti le risposte giuste, oppure allucina e commette errori?
- Esperienza: valuta l'esperienza del cliente, ad esempio se l'IA ha risposto rapidamente e quanti turni sono stati necessari per fornire una risposta soddisfacente. La domanda principale è: l'esperienza risulta naturale e utile per l'utente, oppure robotica e frustrante?
- Operatività: determina se il sistema funziona in modo affidabile e rimane una soluzione conveniente per le tue esigenze di assistenza clienti. Le domande più comuni sono: il sistema ha un uptime elevato e garantisce il ritorno sull'investimento necessario a giustificarne l'uso?
Il successo ha un significato diverso per ogni team e in questo incidono molto i problemi iniziali prima dell'automazione dell'assistenza. Ad esempio, se inizialmente il tuo team faticava a mantenere un'assistenza clienti attiva 24 ore su 24, la disponibilità continua degli agenti IA migliora facilmente le prestazioni dell'assistenza clienti. Tuttavia, ciascuna di queste categorie è importante per il successo complessivo: un sistema sempre online e che raramente si blocca farà ben poco per i clienti se risulta robotico e allucina le risposte.
Metriche principali dell'IA conversazionale da monitorare
Monitora dati chiari e utilizzabili per valutare le prestazioni degli agenti con i clienti e capire se l'implementazione attuale genera un valore aziendale concreto. La valutazione continua apre anche la strada a miglioramenti regolari. Quando individui con precisione i colli di bottiglia nel tuo workflow o gli aspetti da modificare, hai i dati per affrontarne efficacemente la causa principale.
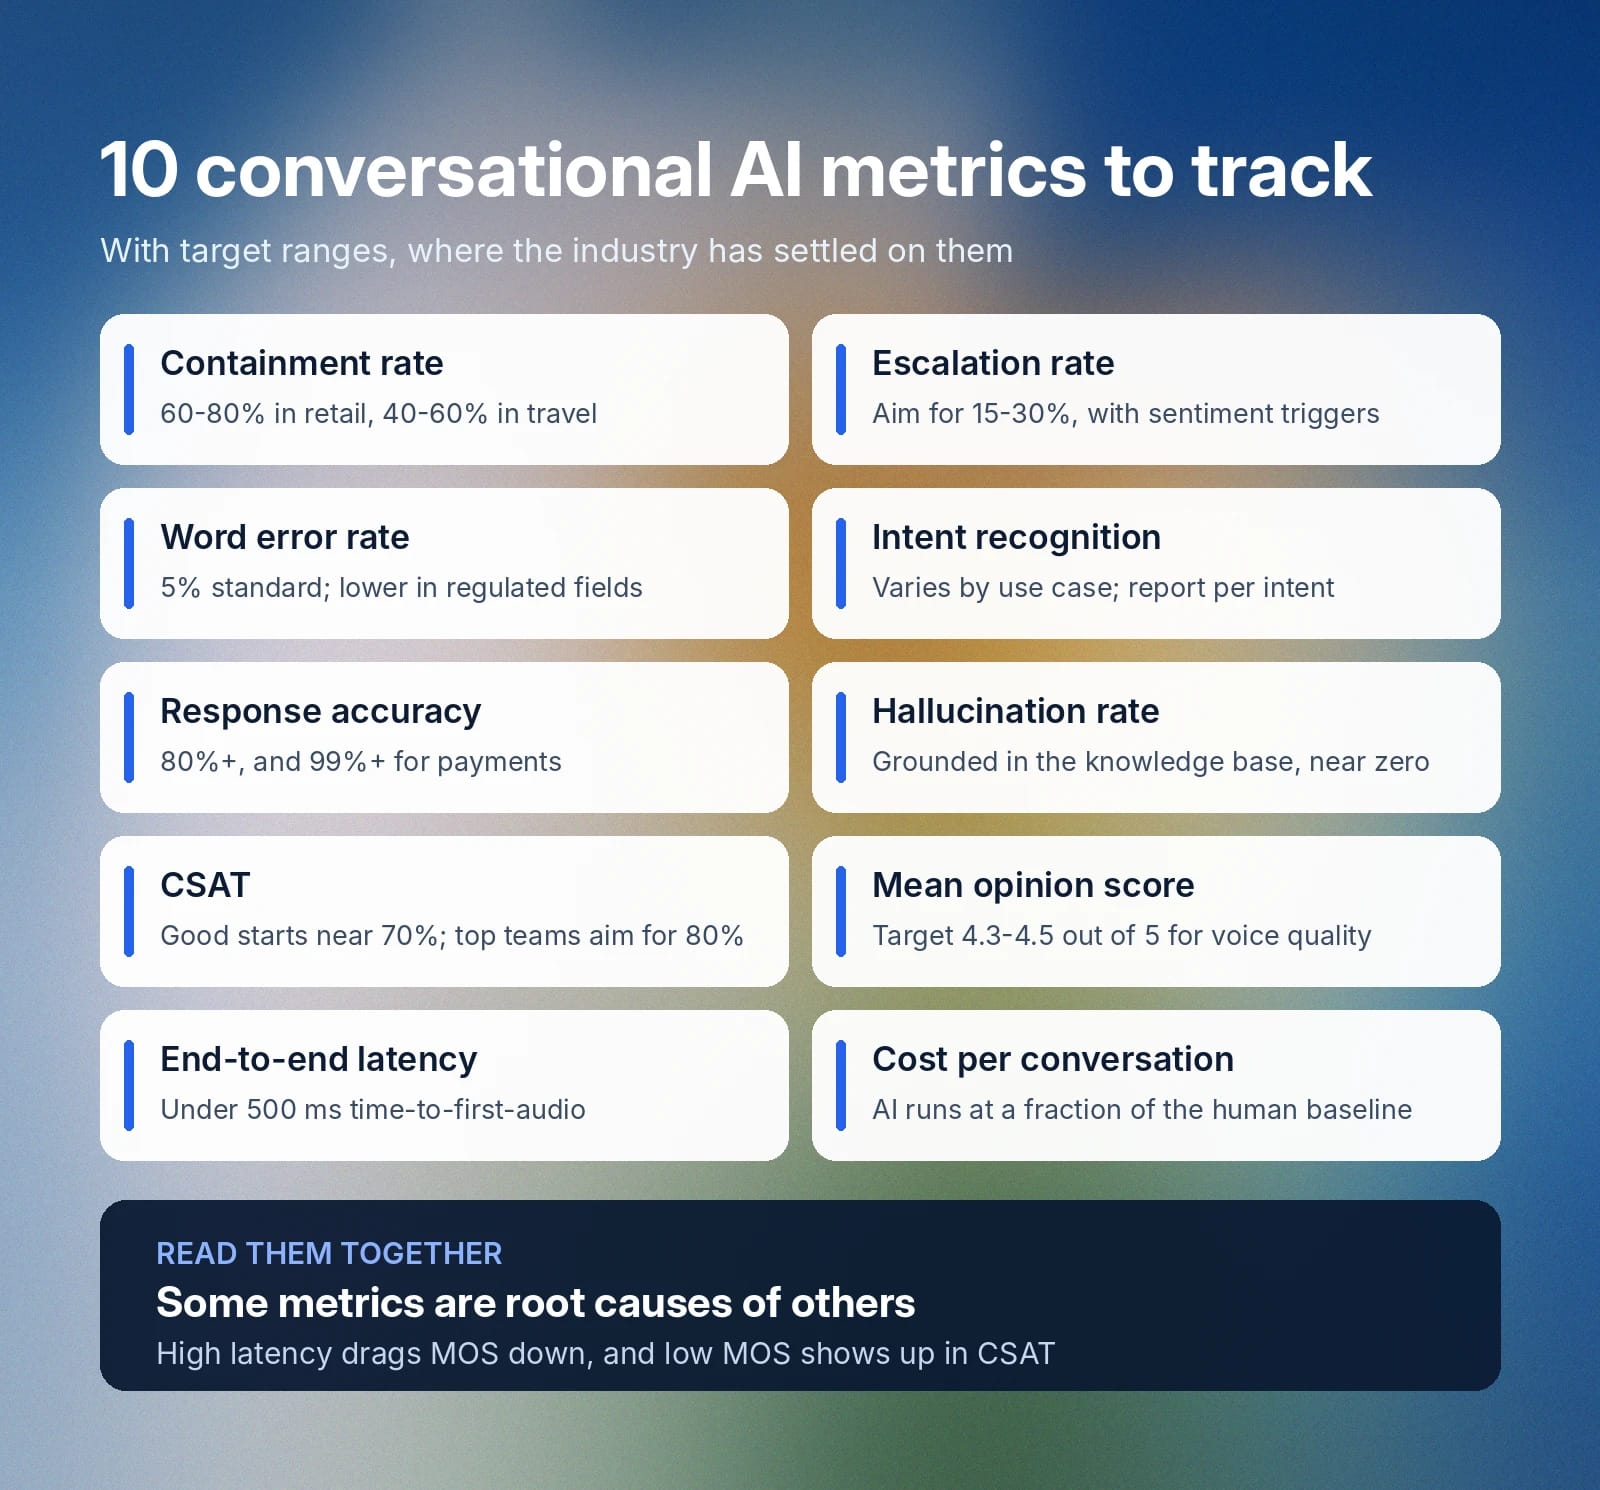
Usa queste metriche dell'IA conversazionale come punto di partenza per valutare le chiamate vocali e le prestazioni dei chatbot:
- Tasso di contenimento: monitora la percentuale di richieste risolte completamente nel canale automatizzato. Gli obiettivi variano in base al settore, al contesto, ai casi d'uso e al tipo di bot. Ad esempio, il 60–80% è abbastanza standard nel retail, mentre per i siti di viaggi i valori si attestano tra il 40 e il 60%.
- Tasso di escalation: misura la frequenza con cui gli agenti IA gestiscono le chiamate senza trasferirle a un operatore umano. Le aziende proattive impostano soglie automatiche per trasferire le chiamate a operatori umani non appena il sentiment diventa negativo. I buoni tassi di escalation variano in base al settore e alla complessità dell'attività, ma punta al 15–30%.
- Tasso di errore delle parole (WER): monitora quanto bene l'IA "ascolta" accuratamente le parole durante una chiamata o una trascrizione. Un buon standard di settore è il 5%, ma ti serve un WER più basso per casi d'uso in settori regolamentati o che gestiscono informazioni sensibili, come sanità, finanza e diritto.
- Accuratezza del riconoscimento dell'intento: oltre alle sole parole, le buone prestazioni di un agente IA iniziano dalla comprensione accurata del problema dell'utente e di ciò di cui ha bisogno. Gli obiettivi di accuratezza variano in base al caso d'uso e alle categorie per singolo intento.
- Accuratezza delle risposte: determina quanto affidabilmente il modello fornisce risposte veritiere e significative. È fondamentale per assicurarti che i clienti risolvano i loro problemi. Le richieste generiche al servizio clienti richiedono l'80% o più, mentre i casi d'uso sensibili, come i pagamenti, richiedono il 99% o più.
- Tasso di allucinazione: sebbene strettamente correlata all'accuratezza delle risposte, l'allucinazione determina nello specifico l'accuratezza fattuale delle risposte in base alla knowledge base. Tassi di allucinazione bassi sono fondamentali per l'utilità e per garantire che i modelli non facciano promesse che l'azienda non può mantenere.
- Soddisfazione del cliente (CSAT): raccogli il sentiment dei clienti con sondaggi post-chiamata per determinarne la soddisfazione. Le aziende raccolgono questi dati usando una scala da uno a cinque, ma spesso esprimono i risultati in percentuale. Secondo SurveyMonkey, i buoni punteggi CSAT iniziano solitamente intorno al 70%, e alcune aziende puntano all'80% o più.
- Mean opinion score (MOS): anche questa metrica incentrata sulle persone usa una scala da uno a cinque, ma mira a misurare quanto naturale suoni la risposta dell'IA e la chiarezza della voce sintetica. Punta a un MOS intorno a 4,3-4,5.
- Latenza vocale end-to-end: calcola il ritardo totale tra il completamento della richiesta da parte di un utente e l'inizio della risposta dell'agente. Gli agenti pronti per la produzione puntano a un tempo end-to-end al primo audio (TTFA) inferiore a 500 millisecondi. Il modello ElevenLabs Flash v2.5 raggiunge attualmente una latenza interna di inferenza del modello di circa 75 ms. La latenza end-to-end effettiva varierà in base a fattori quali la tua posizione e il tipo di endpoint utilizzato.
- Costo per conversazione: misura il costo operativo totale di ogni interazione automatizzata con un cliente rispetto alle sessioni umane. Le conversazioni ElevenLabs partono da 10 centesimi al minuto, mentre la retribuzione oraria media degli operatori del servizio clienti suggerisce che le conversazioni umane ammontino a circa 32 centesimi al minuto. Ciò comporta un risparmio sui costi di circa il 70%, anche se i prezzi possono variare in base al piano e all'utilizzo. Consulta la pagina dei prezzi di ElevenLabs per i prezzi aggiornati.
Quando scegli le metriche da usare per misurare le prestazioni del modello, considera gli ambiti più importanti per il tuo settore e modello di business. Ad esempio, accuratezza e correttezza fattuale sono particolarmente importanti in settori come il banking e le informazioni sui pazienti, mentre la latenza, il MOS e i tassi di escalation contano di più per le aziende che danno priorità all'esperienza del cliente.
Tieni presente che alcune metriche forniscono le cause alla radice di altre. Ad esempio, un'elevata latenza porta probabilmente a un punteggio MOS basso e, di conseguenza, a una scarsa soddisfazione del cliente espressa come CSAT.
Come misurare l'accuratezza dell'IA conversazionale
Misura l'accuratezza del modello creando un set di test di ground truth basato su circa 500-1.000 conversazioni storiche reali. I log reali catturano formulazioni naturali e disordinate che spesso mancano nei dati sintetici, come refusi, slang ed errori dell'utente. Quindi, valuta il tuo sistema rispetto a questi log reali per riconoscimento dell'intento, accuratezza delle risposte e tasso di allucinazione.
Esegui valutazioni automatizzate di queste interazioni usando un metodo di assegnazione del punteggio LLM-as-a-judge. Tuttavia, convalida sempre i punteggi automatizzati rispetto a sistemi etichettati da persone per assicurarti che siano allineati. I revisori umani eseguono quindi controlli settimanali a campione per valutare le prestazioni del chatbot tramite una semplice griglia a tre punti:
- Corretta: la risposta è fattuale, pertinente al contesto e soddisfa direttamente l'intento principale dell'utente.
- Accettabile: la risposta è tecnicamente corretta e utile, ma presenta alcuni piccoli problemi di stile, formulazioni poco naturali o una formattazione non in linea con il brand.
- Errata: la risposta richiede una correzione immediata perché contiene errori fattuali, allucinazioni gravi o fraintende completamente l'intento dell'utente.
Idealmente, usa un metodo per singolo intento per valutare il modello, perché gli agenti IA funzionano bene in alcuni contesti e falliscono miseramente in altri. L'uso di dati aggregati fa sì che le aree ad alte prestazioni nascondano punti deboli critici.
Abbiamo semplificato questo workflow integrando il testing Next Reply (Scenario) direttamente nel testing di ElevenAgents. La funzionalità Next Reply valuta il messaggio di follow-up inviato da un agente anziché l'intera conversazione su più turni. Tuttavia, fornisci la cronologia della chat che precede il punto di valutazione e assegni un punteggio alla risposta in base a standard di policy, tono e qualità.
Come eseguire test A/B sulle risposte dell'IA conversazionale
L'A/B testing raccoglie feedback dal mondo reale per evitare di dover indovinare ciò che i clienti preferiscono. Puoi quindi usare questi dati empirici per ottimizzare le prestazioni del modello di IA. Dopo aver monitorato le metriche, il tuo team avrà probabilmente un elenco di elementi da modificare o di esperimenti da eseguire. Tuttavia, modificare più aspetti contemporaneamente rende difficile capire cosa ha funzionato e cosa no.
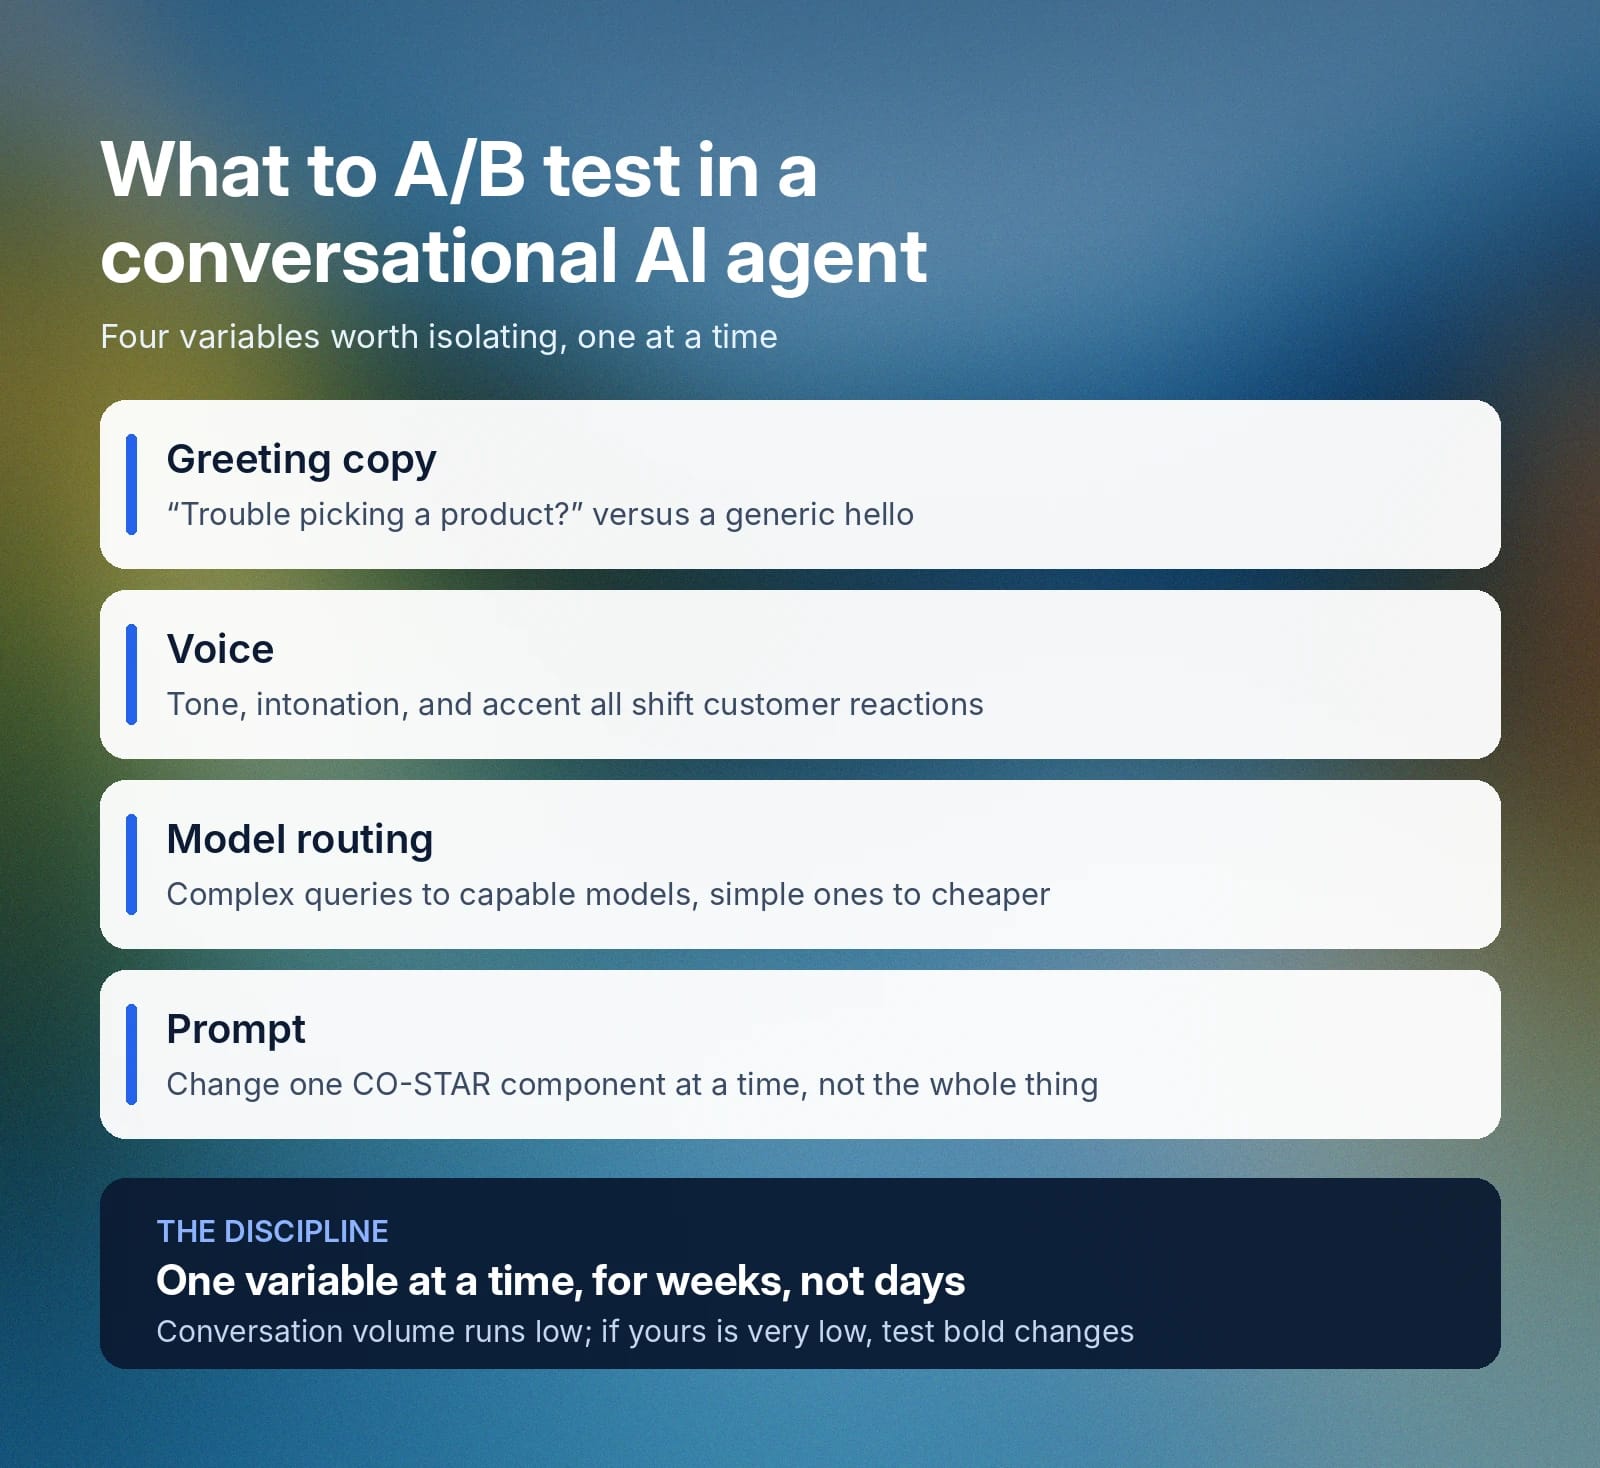
Di conseguenza, per eseguire un test valido devi isolare una variabile specifica alla volta, mantenendo costante il resto della knowledge base sottostante. Gli elementi che puoi variare includono:
- Testo del saluto: modifica il messaggio di saluto iniziale con qualcosa di specifico, ad esempio "Ciao! Hai difficoltà a scegliere un prodotto?", anziché limitarti a dire "Ciao, come posso aiutarti?"
- Voce: in circostanze specifiche, i clienti potrebbero reagire più favorevolmente ad alcune voci rispetto ad altre in base a mascolinità o femminilità, tono, intonazione e persino accento.
- Routing del modello: i modelli più capaci di solito costano di più, quindi l'opzione efficiente e conveniente consiste nell'instradare di conseguenza le richieste complesse e quelle semplici.
- Prompt: i prompt hanno diversi componenti, quindi modifica un solo aspetto alla volta, come il contesto, l'obiettivo, lo stile, il tono, il pubblico o il template di risposta (CO-STAR).
I team devono anche adattare la durata dei test. Il traffico conversazionale è in genere molto inferiore alle visualizzazioni delle pagine web, quindi dovrai eseguire il test per settimane anziché giorni per raggiungere la significatività statistica. Se il volume è estremamente basso, testa modifiche grandi e incisive anziché piccoli ritocchi.
Un workflow pratico richiede anche il versioning degli agenti, strumenti di confronto e rollback. Li abbiamo integrati direttamente in ElevenAgents.
Come testare un agente di IA conversazionale prima del deployment
Il servizio clienti è un punto di contatto diretto con le persone che incidono sui tuoi risultati economici e l'IA talvolta reagisce in modi imprevedibili a piccoli cambiamenti. Di conseguenza, testa sempre un agente di IA conversazionale nuovo o modificato prima di lanciarlo in produzione. Il semplice "vibe testing" non basta.
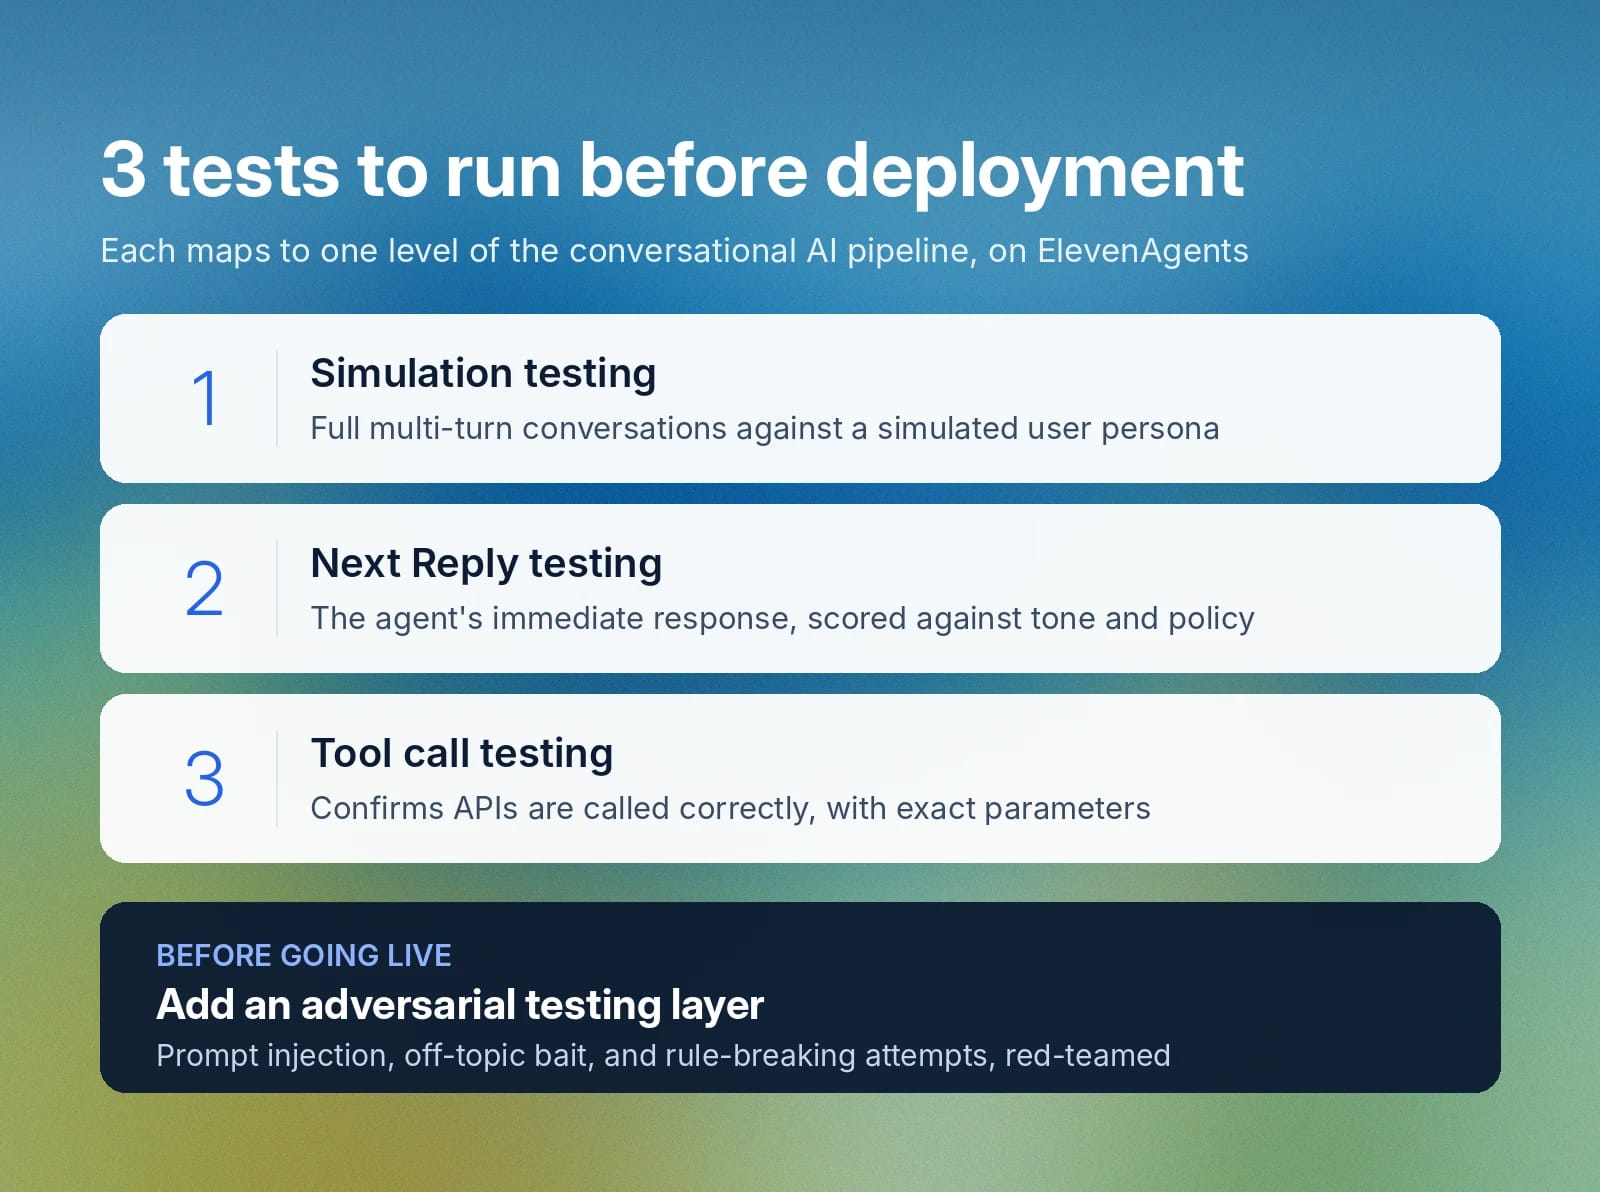
Abbiamo progettato il framework di testing di ElevenAgents attorno a tre tipi di test principali, che si rivolgono a livelli specifici della tua pipeline di IA conversazionale:
- Test di simulazione: esegue una conversazione completa su più turni con un utente simulato per confermare che il dialogo soddisfi i livelli di prestazione desiderati.
- Test Next Reply: testa esclusivamente le risposte immediate dell'agente rispetto a vincoli specifici di tono, policy o altro tipo, per confermarne adeguatezza e accuratezza.
- Test delle tool call: assicura che gli agenti chiamino correttamente le API connesse e trasmettano i parametri esatti necessari per ricerche o trasferimenti critici nel database.
Con così tanti aggressori che cercano di eseguire il jailbreak dei modelli per scopi malevoli, prima del go-live ti servirà anche un livello di test avversariali. Collabora con team QA, prompt engineer e professionisti della cybersecurity red team per testare prompt injection, esche fuori tema e tentativi di violazione delle regole.
Infine, esegui un rilascio graduale lanciando versioni pilota a un piccolo gruppo di utenti e monitorandone il comportamento nel mondo reale. Stabilisci criteri rigorosi che il modello deve superare prima di rilasciarlo a un gruppo più ampio o all'intera base clienti. Ricorda di assegnare un unico responsabile della release e di creare un percorso di rollback nel caso in cui una modifica causi un calo delle metriche di prestazione.
Valutare le prestazioni del chatbot in produzione
Prima di lanciare il tuo modello di IA conversazionale, definisci cosa significa successo per ogni caso d'uso. Questo è particolarmente importante per le applicazioni in settori altamente regolamentati, dove accuratezza e privacy dei dati hanno standard più elevati e requisiti più rigorosi.
Le risposte automatizzate facilitano l'A/B testing dei modelli su larga scala, ma un test oggettivo richiede di affiancarlo alla lettura ad hoc delle trascrizioni e ai feedback dei tester umani. Le persone coinvolte nel processo colgono le sfumature conversazionali che i modelli di IA non rilevano e le particolarità dei dati che altrimenti si perdono nei dati aggregati. Una strategia di valutazione completa include anche l'analisi del sentiment e il feedback diretto degli utenti.
Il miglioramento continuo distingue ulteriormente i sistemi maturi che offrono un elevato ritorno sull'investimento. Mentre i concorrenti considerano test e monitoraggio attività separate, una pipeline matura li combina in una sola. In questo caso, gli errori in produzione alimentano direttamente il tuo set di test per addestrare il successivo agente ottimizzato.
Modifiche regolari diventano necessarie anche quando le aziende di IA aggiornano i modelli di base su cui opera il tuo agente. Questo cambiamento spesso fa sì che un prompt prima efficace contribuisca improvvisamente a risposte inaffidabili o persino inappropriate.
Abbiamo integrato questo ciclo di feedback direttamente nella nostra piattaforma. Usa i nostri strumenti di analisi delle conversazioni per automatizzare la raccolta strutturata dei dati e valutare facilmente il sentiment. Le grandi organizzazioni usano anche la nostra infrastruttura di IA conversazionale per le aziende per monitorare e scalare con sicurezza i propri agenti in tutto il mondo.
Inizia con ElevenAgents per le metriche del servizio clienti
Lanciare con successo l'IA conversazionale su larga scala richiede più di voci di alta qualità e modelli a bassa latenza. Ti serve un ecosistema integrato per progettare, creare, testare, distribuire e adattare workflow multi-agente.
ElevenAgents ti offre l'infrastruttura scalabile di cui hai bisogno. Il tuo team ha accesso a strumenti come la verifica Next Reply, il monitoraggio del sentiment e la raccolta automatica dei dati per monitorare e ottimizzare continuamente i modelli e ottenere i migliori risultati. E c'è di più: intercetti le regressioni prima che raggiungano i tuoi clienti.
Vuoi semplificare il processo di misurazione dell'IA conversazionale? Esplora le nostre funzionalità di testing degli agenti e scopri come i nostri team enterprise distribuiscono agenti affidabili che migliorano le metriche del tuo servizio clienti.
Scopri di più su ElevenAgents oppure registrati per iniziare oggi.
Domande frequenti sulla misurazione dell'IA conversazionale

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.



