Eleven Realtime पेश है: प्राकृतिक वॉइस एजेंट बनाने का आसान तरीका
- लेखक
- Min Kim
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
आज स्वाभाविक सुनाई देने वाला वॉइस एजेंट बनाने के लिए कई फैसले लेने पड़ते हैं। आपको स्पीच रिकग्निशन, वॉइस एक्टिविटी डिटेक्शन, टर्न-टेकिंग, अंतर्निहित LLM और टेक्स्ट टू स्पीच जैसे अलग-अलग कंपोनेंट्स चुनने होते हैं। यह स्टैक बनाना अपने आप में एक प्रोजेक्ट है, और सभी कंपोनेंट्स को साथ में अच्छी तरह काम करवाने के लिए ज्यादा टेस्टिंग और ट्यूनिंग चाहिए।
Eleven Realtime स्पीच टू स्पीच मॉडल्स की एक नई श्रेणी है, जो इन मुश्किलों को दूर करती है। हर मॉडल एक संपूर्ण वॉइस एजेंट है, जिसे अलग-अलग उपयोग मामलों के लिए ऑप्टिमाइज़ किया गया है। दोनों 90 से ज़्यादा भाषाओं को सपोर्ट करते हैं और ElevenLabs लाइब्रेरी की 17,000+ में से कोई भी वॉइस इस्तेमाल कर सकते हैं:
आज हम लॉन्च कर रहे हैं:
- Eleven Realtime v1 Mini कम लागत में स्वाभाविक बातचीत के लिए। यह AI असिस्टेंट्स, शिक्षकों और इंटरैक्टिव कैरेक्टर्स के लिए सबसे अच्छा विकल्प है और ज़्यादातर उपयोग मामलों के लिए पर्याप्त होगा।
- Eleven Realtime v1 Max जटिल कामों के लिए। यह कस्टमर सपोर्ट, लीड क्वालिफिकेशन और मल्टी-स्टेप वर्कफ़्लो के लिए आदर्श है, जहाँ एजेंट को एक प्रक्रिया का पालन करना और हर चरण पर तर्क करना होता है।
हमने रियलटाइम मॉडल्स क्यों बनाए
स्वाभाविक सुनाई देने वाला वॉइस एजेंट बनाने के लिए आपको कॉन्फ़िगरेशन एक्सपर्ट बनने की ज़रूरत नहीं होनी चाहिए। किसी एजेंट का सही महसूस होना और सुनाई देना बारीक समझ वाले छोटे फैसलों पर निर्भर करता है, जैसे जवाब देने से पहले विराम के बाद कितना इंतज़ार करना है, यूज़र के एजेंट को बीच में रोकने पर कैसे संभलना है, और वॉइस, प्रॉम्प्ट्स व मॉडल आपस में कैसे काम करते हैं। ElevenAgents में आप इन सभी सेटिंग्स को बदल सकते हैं।
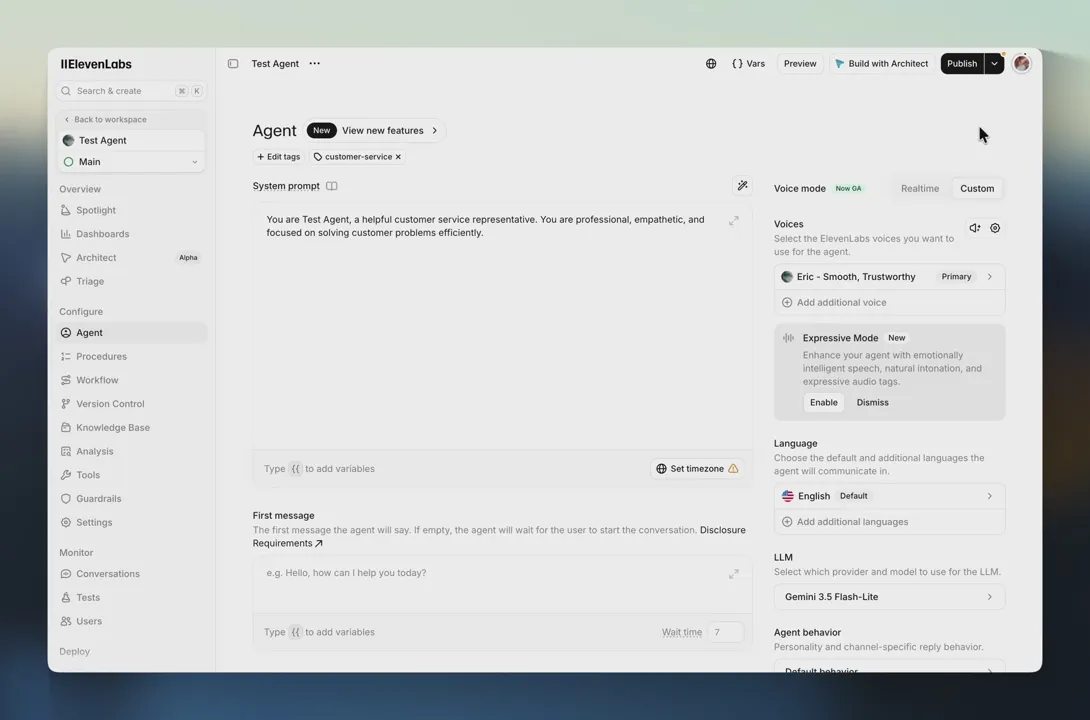
यह बात उन डेवलपर्स पर भी लागू होती है जो पहले से किसी रियलटाइम API पर हैं। हमारा API OpenAI के Realtime API के साथ संगत है, इसलिए Eleven Realtime आज़माने के लिए आपको अपने मौजूदा कोड में बस एंडपॉइंट और मॉडल का नाम बदलना है।
कैस्केडेड आर्किटेक्चर पर निर्मित
Eleven Realtime ऊपर बताए गए कंपोनेंट्स के कैस्केडेड आर्किटेक्चर पर बना है, जिसे शुरू से अंत तक ट्यून किया गया है। हम इन्हें स्पीच टू स्पीच मॉडल्स कहते हैं, क्योंकि इनमें ऑडियो इन, ऑडियो आउट, एक मॉडल ID और ऐसा सिस्टम मिलता है जिसे फ्यूज़्ड व डुप्लेक्स मॉडल्स जैसे ही लीडरबोर्ड्स पर मापा जा सकता है।
शुरुआत में फ्यूज़्ड मॉडल्स ने यह मानक तय किया कि वॉइस एजेंट कितना स्वाभाविक लग सकता है, जबकि कैस्केडेड सेटअप में हर हैंडऑफ पर लेटेंसी बढ़ती थी और कंपोनेंट्स को कभी एक-दूसरे के हिसाब से ट्यून नहीं किया जाता था। Realtime इस समझौते को हटाता है, और जो ट्यूनिंग पहले आपका प्रोजेक्ट हुआ करती थी, वह पहले से की जा चुकी है।
प्रोडक्शन में कैस्केडेड के व्यावहारिक फायदे भी हैं, क्योंकि हर चरण टेक्स्ट तैयार करता है। आप देख सकते हैं कि एजेंट ने क्या सुना और क्या कहने का फैसला किया, इसलिए आप गलत सुने गए शब्द और गलत फैसले में अंतर कर सकते हैं। इसी टेक्स्ट से ElevenAgents किसी Realtime एजेंट पर गार्डरेल्स और PII रिडैक्शन लागू कर पाता है।
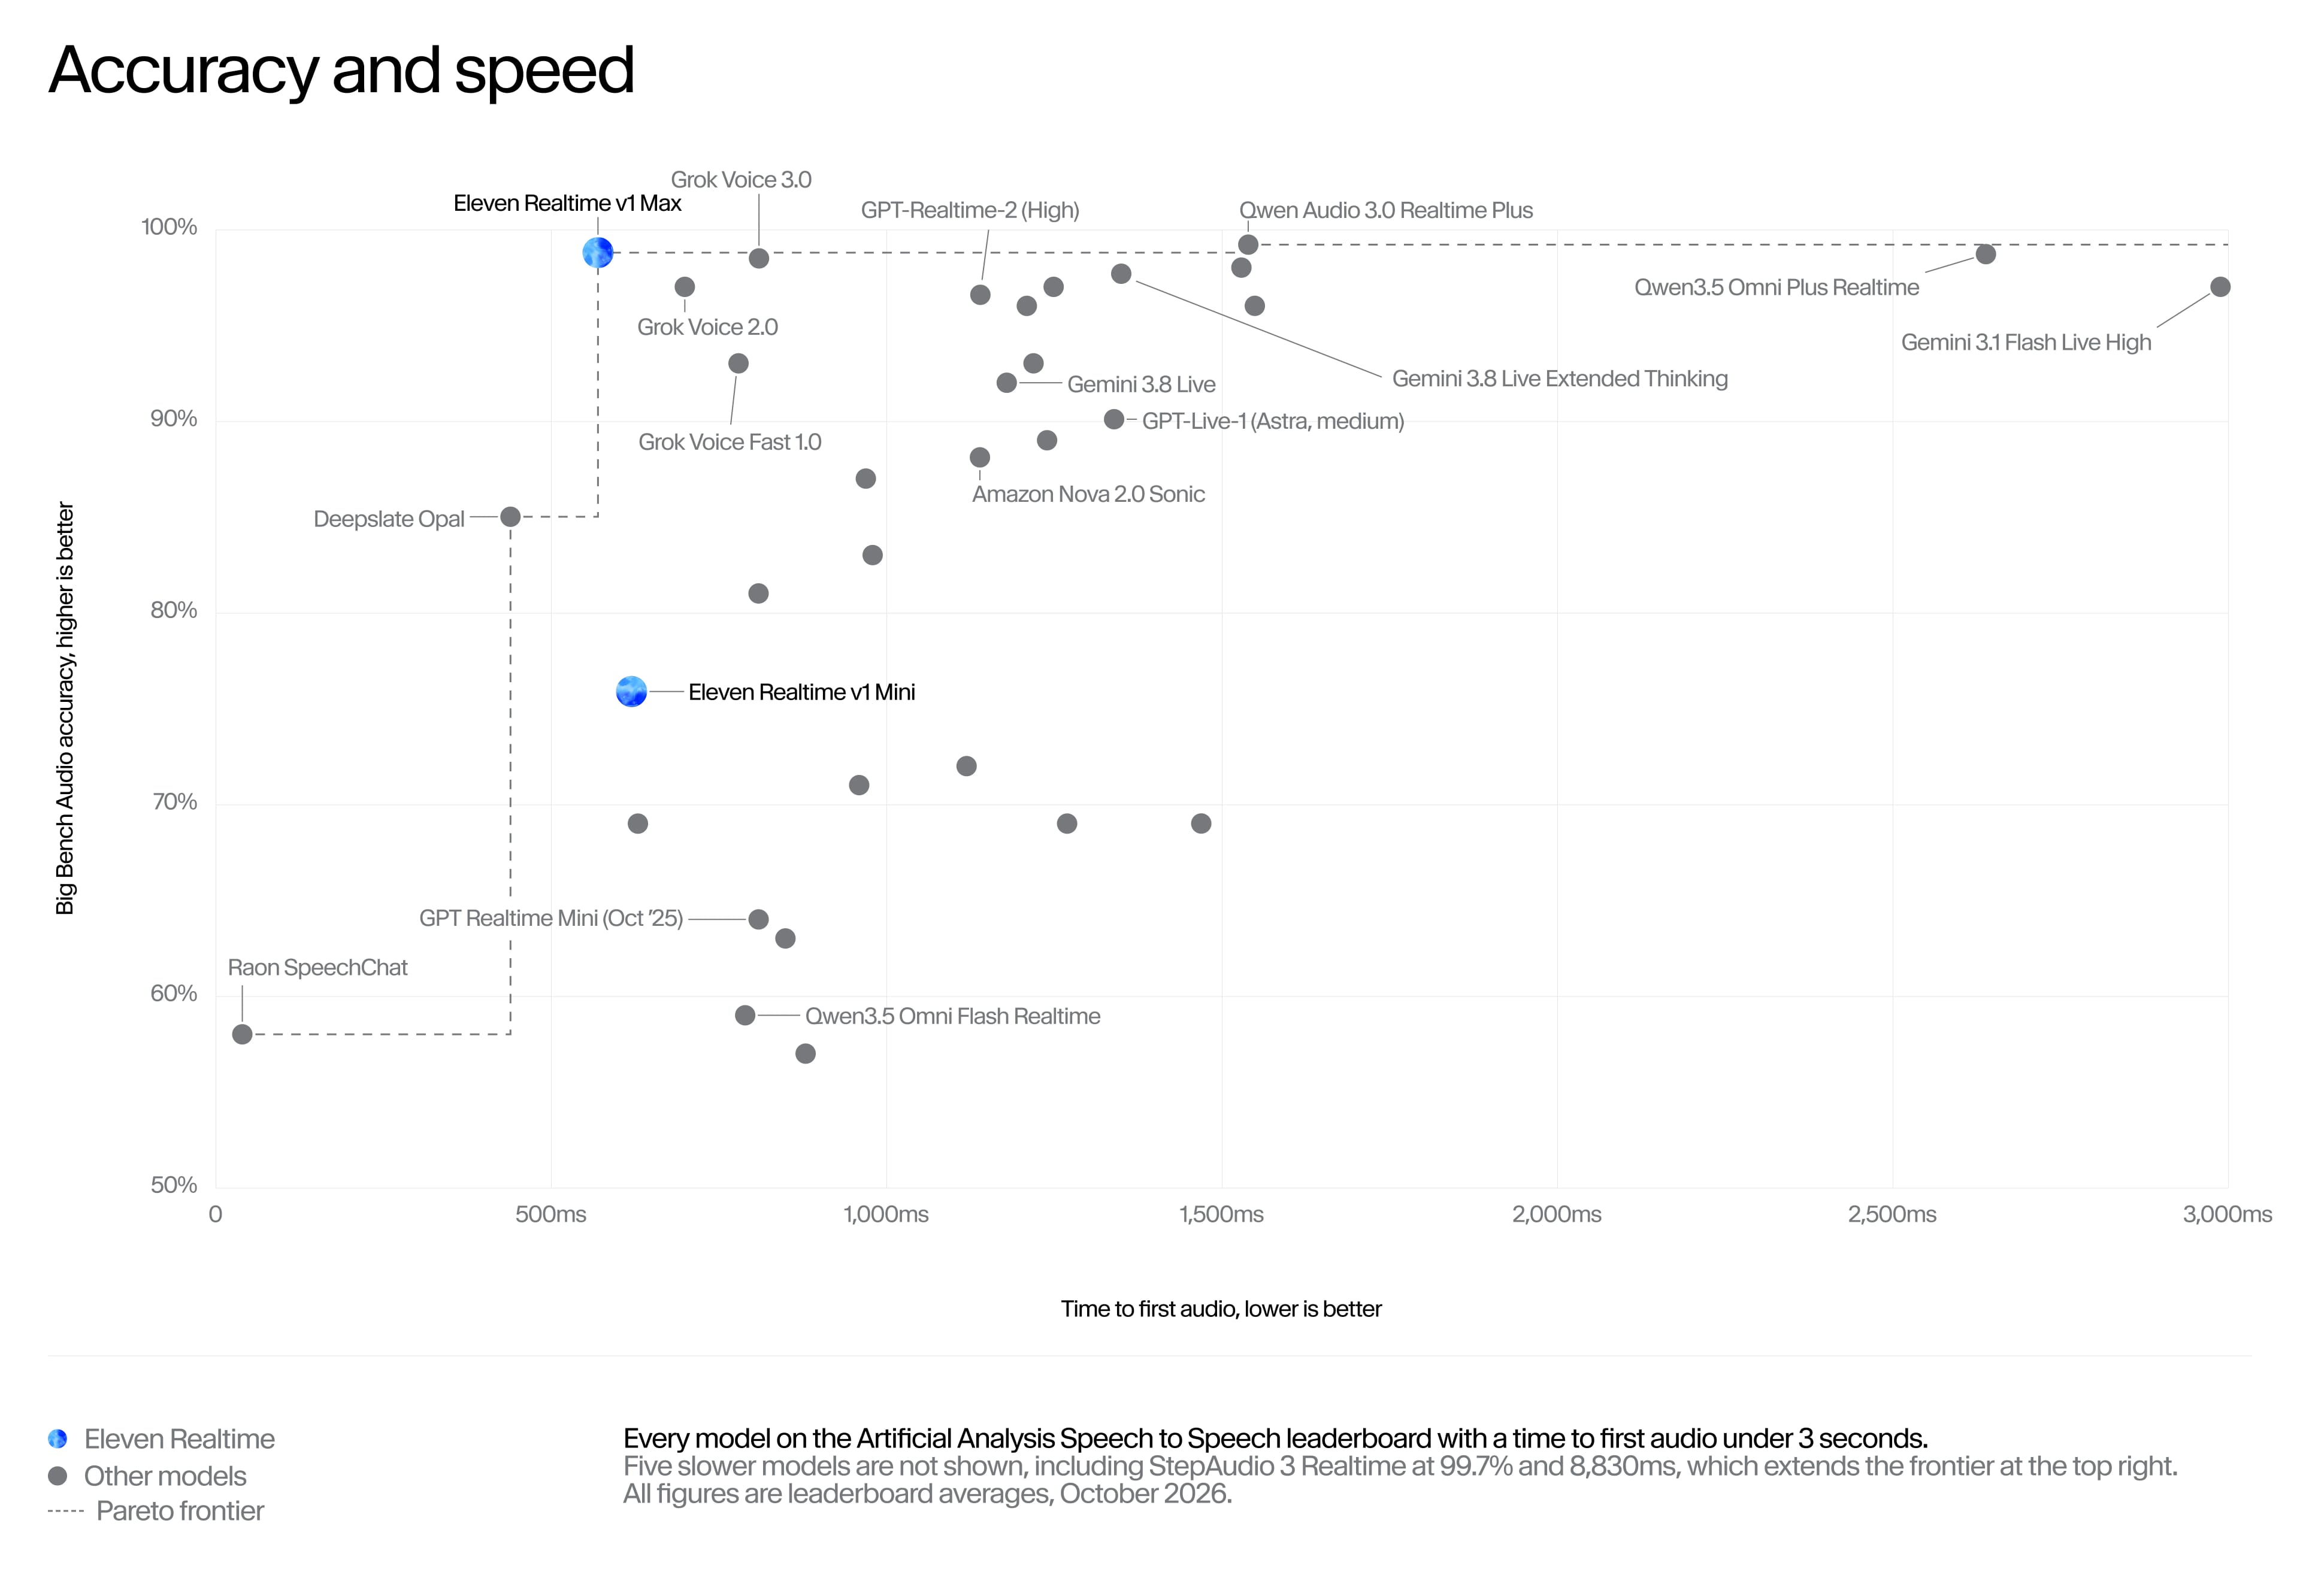
नीचे दिए गए बेंचमार्क्स यह जांचते हैं कि क्या वह समझौता सच में खत्म हो गया है। बातचीत की गतिशीलता में दोनों मॉडल्स का स्कोर फ्यूज़्ड मॉडल्स के समान रेंज में है। सटीकता और गति को साथ देखें, तो Artificial Analysis लीडरबोर्ड पर v1 Max से तेज़ और ज़्यादा सटीक कोई मॉडल नहीं है।
इनका प्रदर्शन
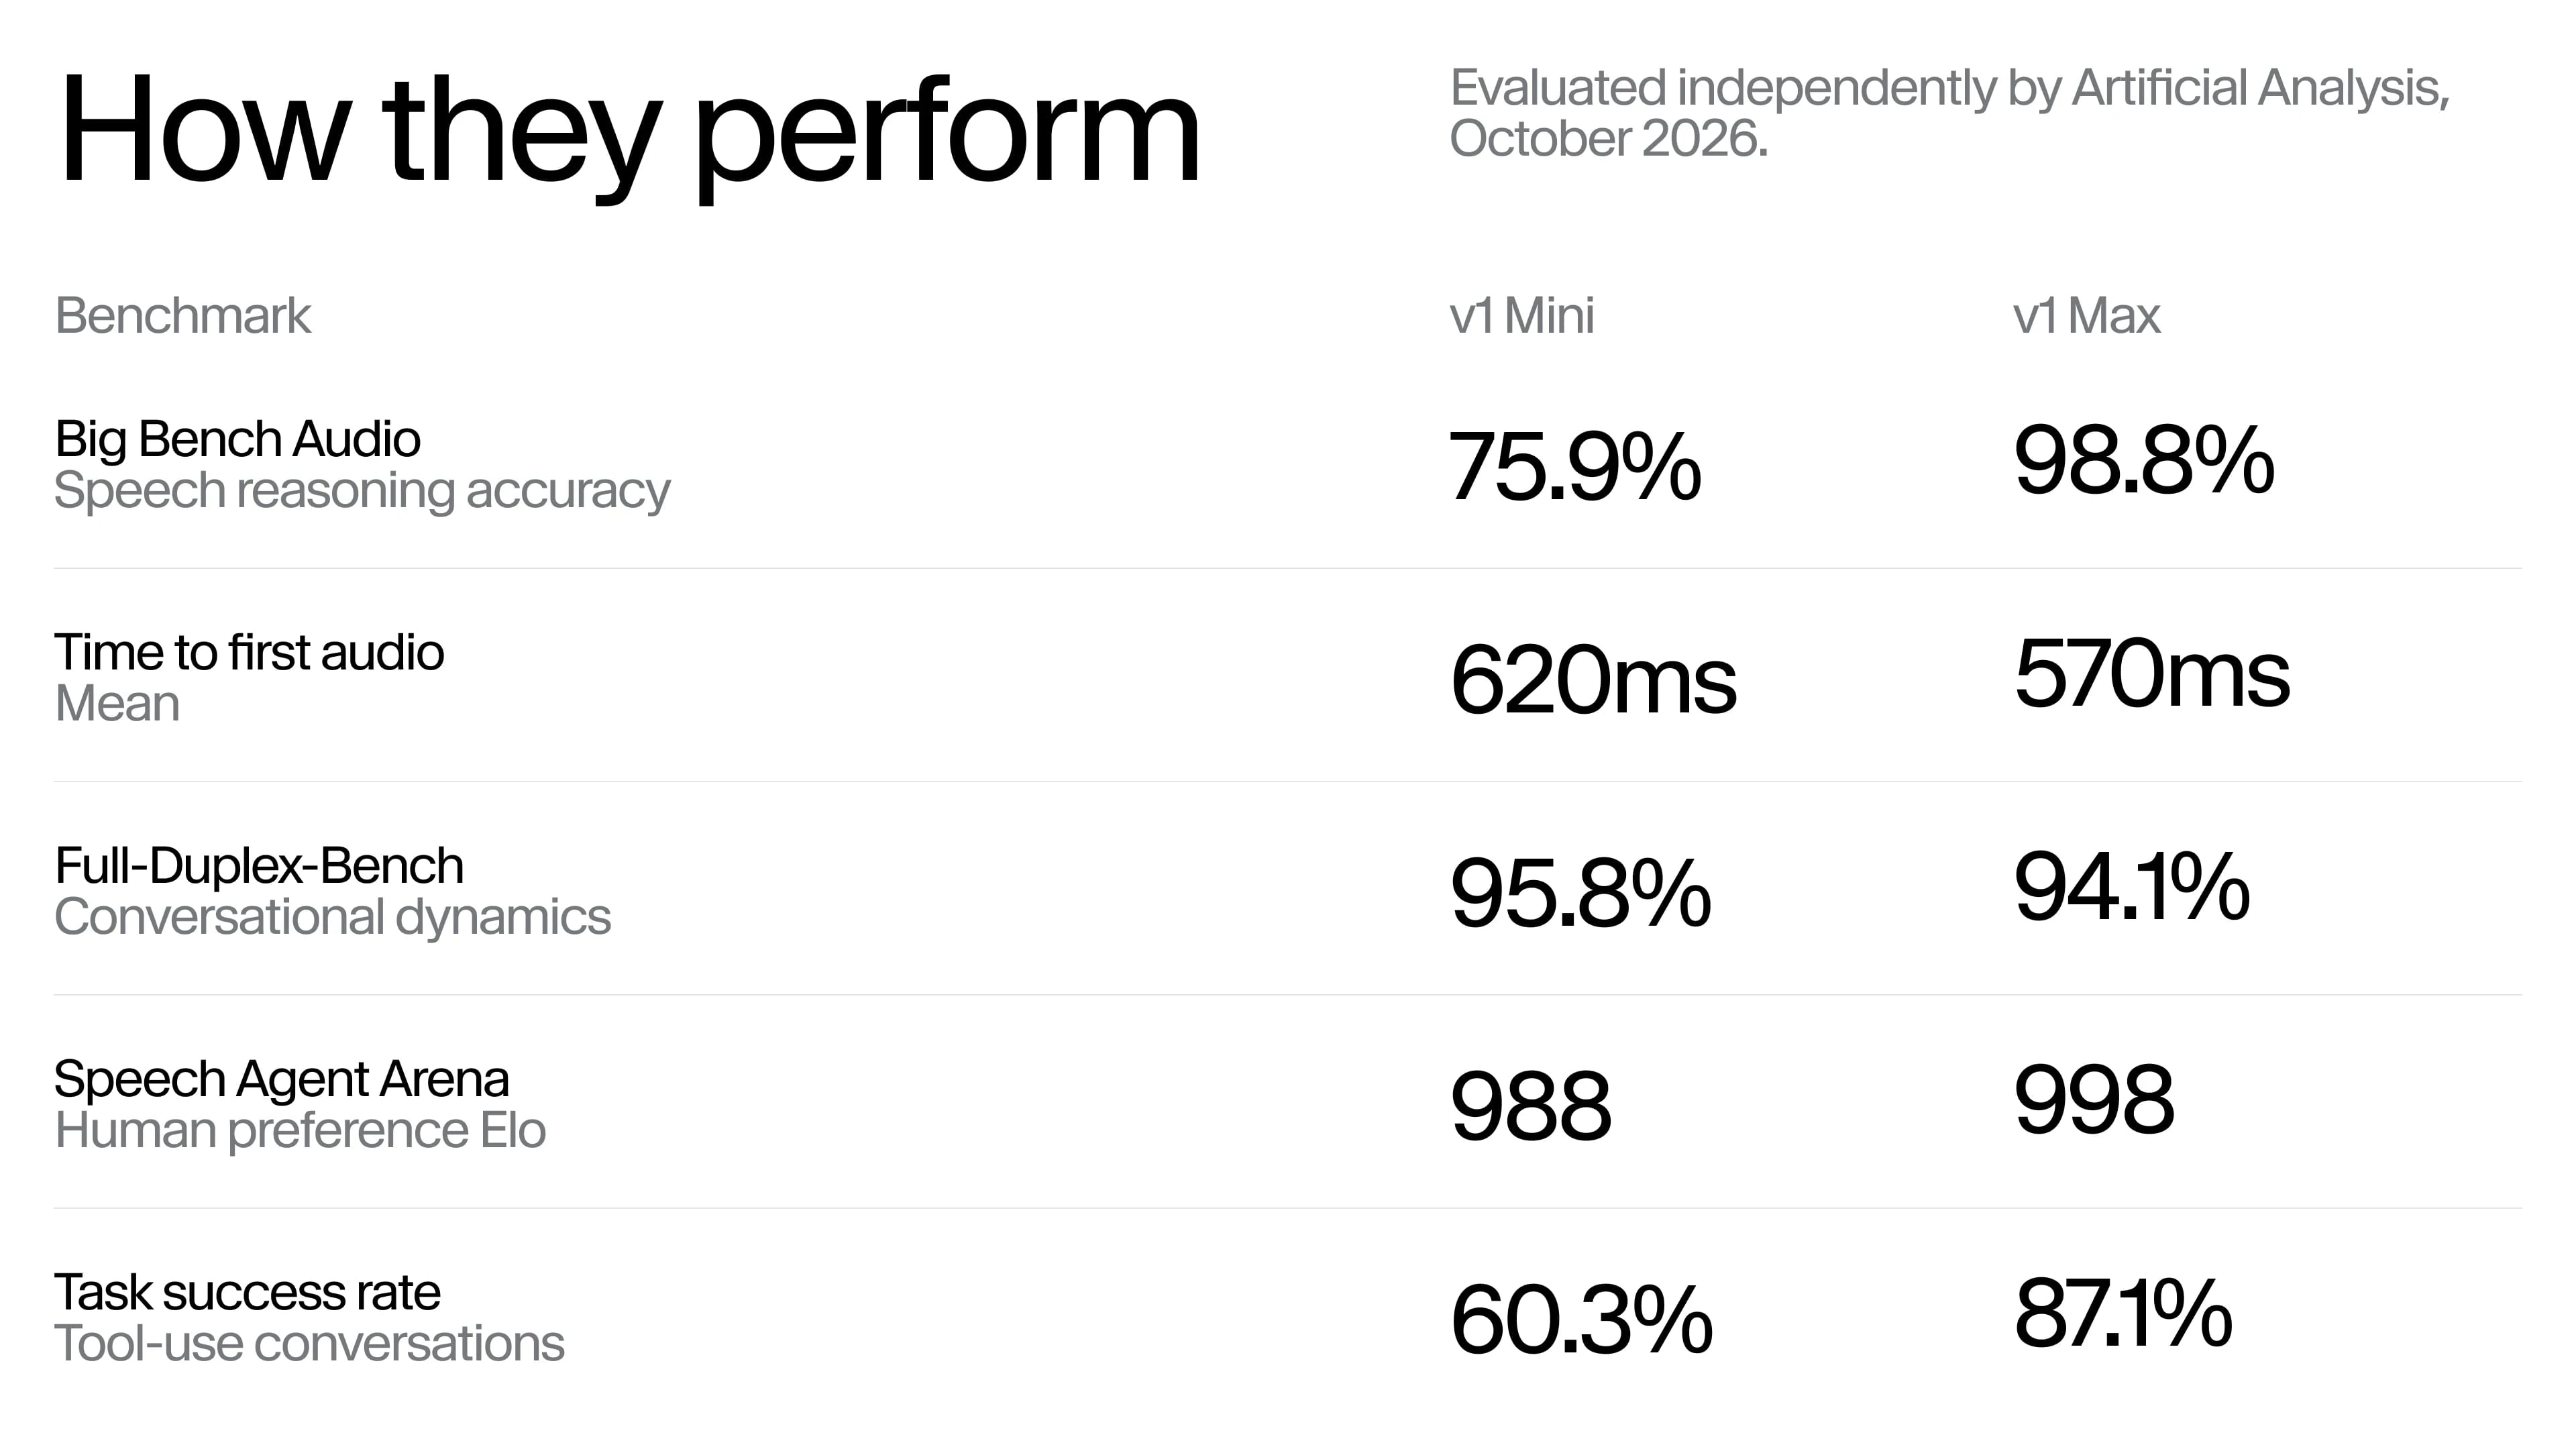
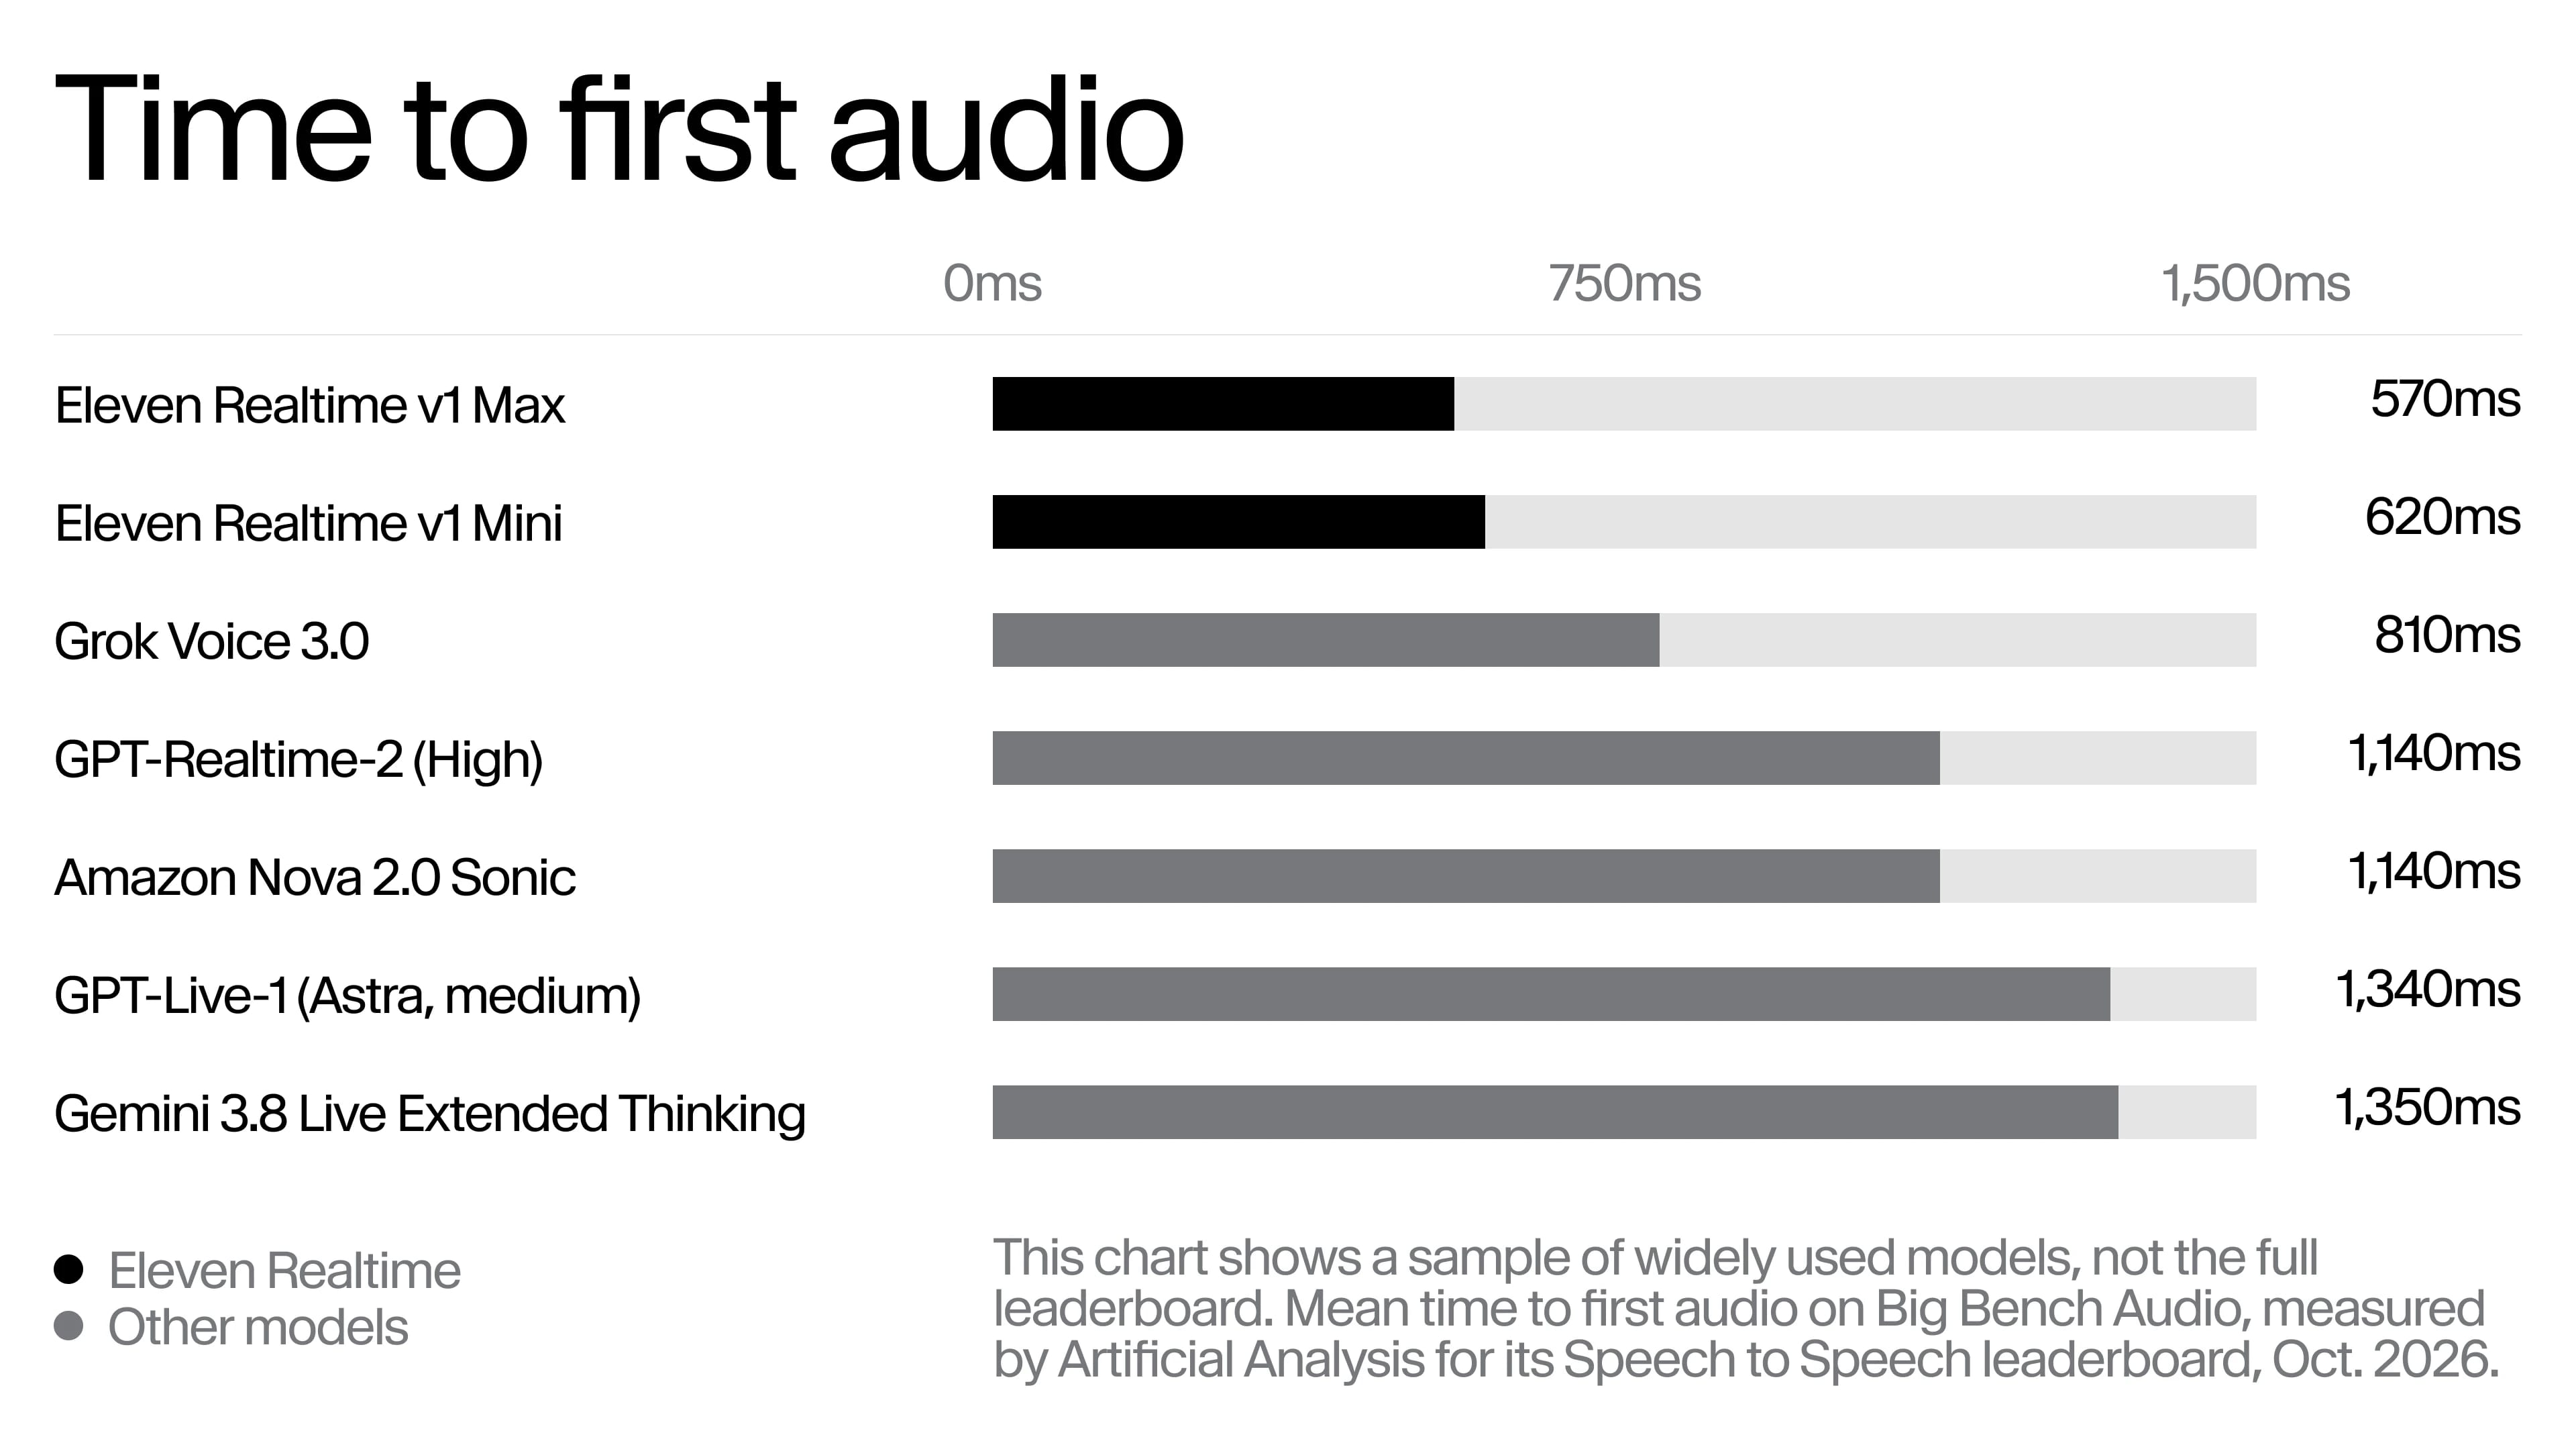
Artificial Analysis ने दोनों मॉडल्स का स्वतंत्र रूप से तीन सार्वजनिक बेंचमार्क्स पर मूल्यांकन किया: स्पीच रीजनिंग के लिए Big Bench Audio, बातचीत की गतिशीलता के लिए Full-Duplex-Bench और मानवीय पसंद व टास्क सफलता के लिए Speech Agent Arena।
स्पीच रीजनिंग
Big Bench Audio आवाज़ में 1,000 तर्क वाले सवाल पूछता है और बोले गए जवाब को स्कोर करता है। Realtime v1 Max ने 98.8% सवालों के सही जवाब दिए और v1 Mini ने 75.9% के।
गति
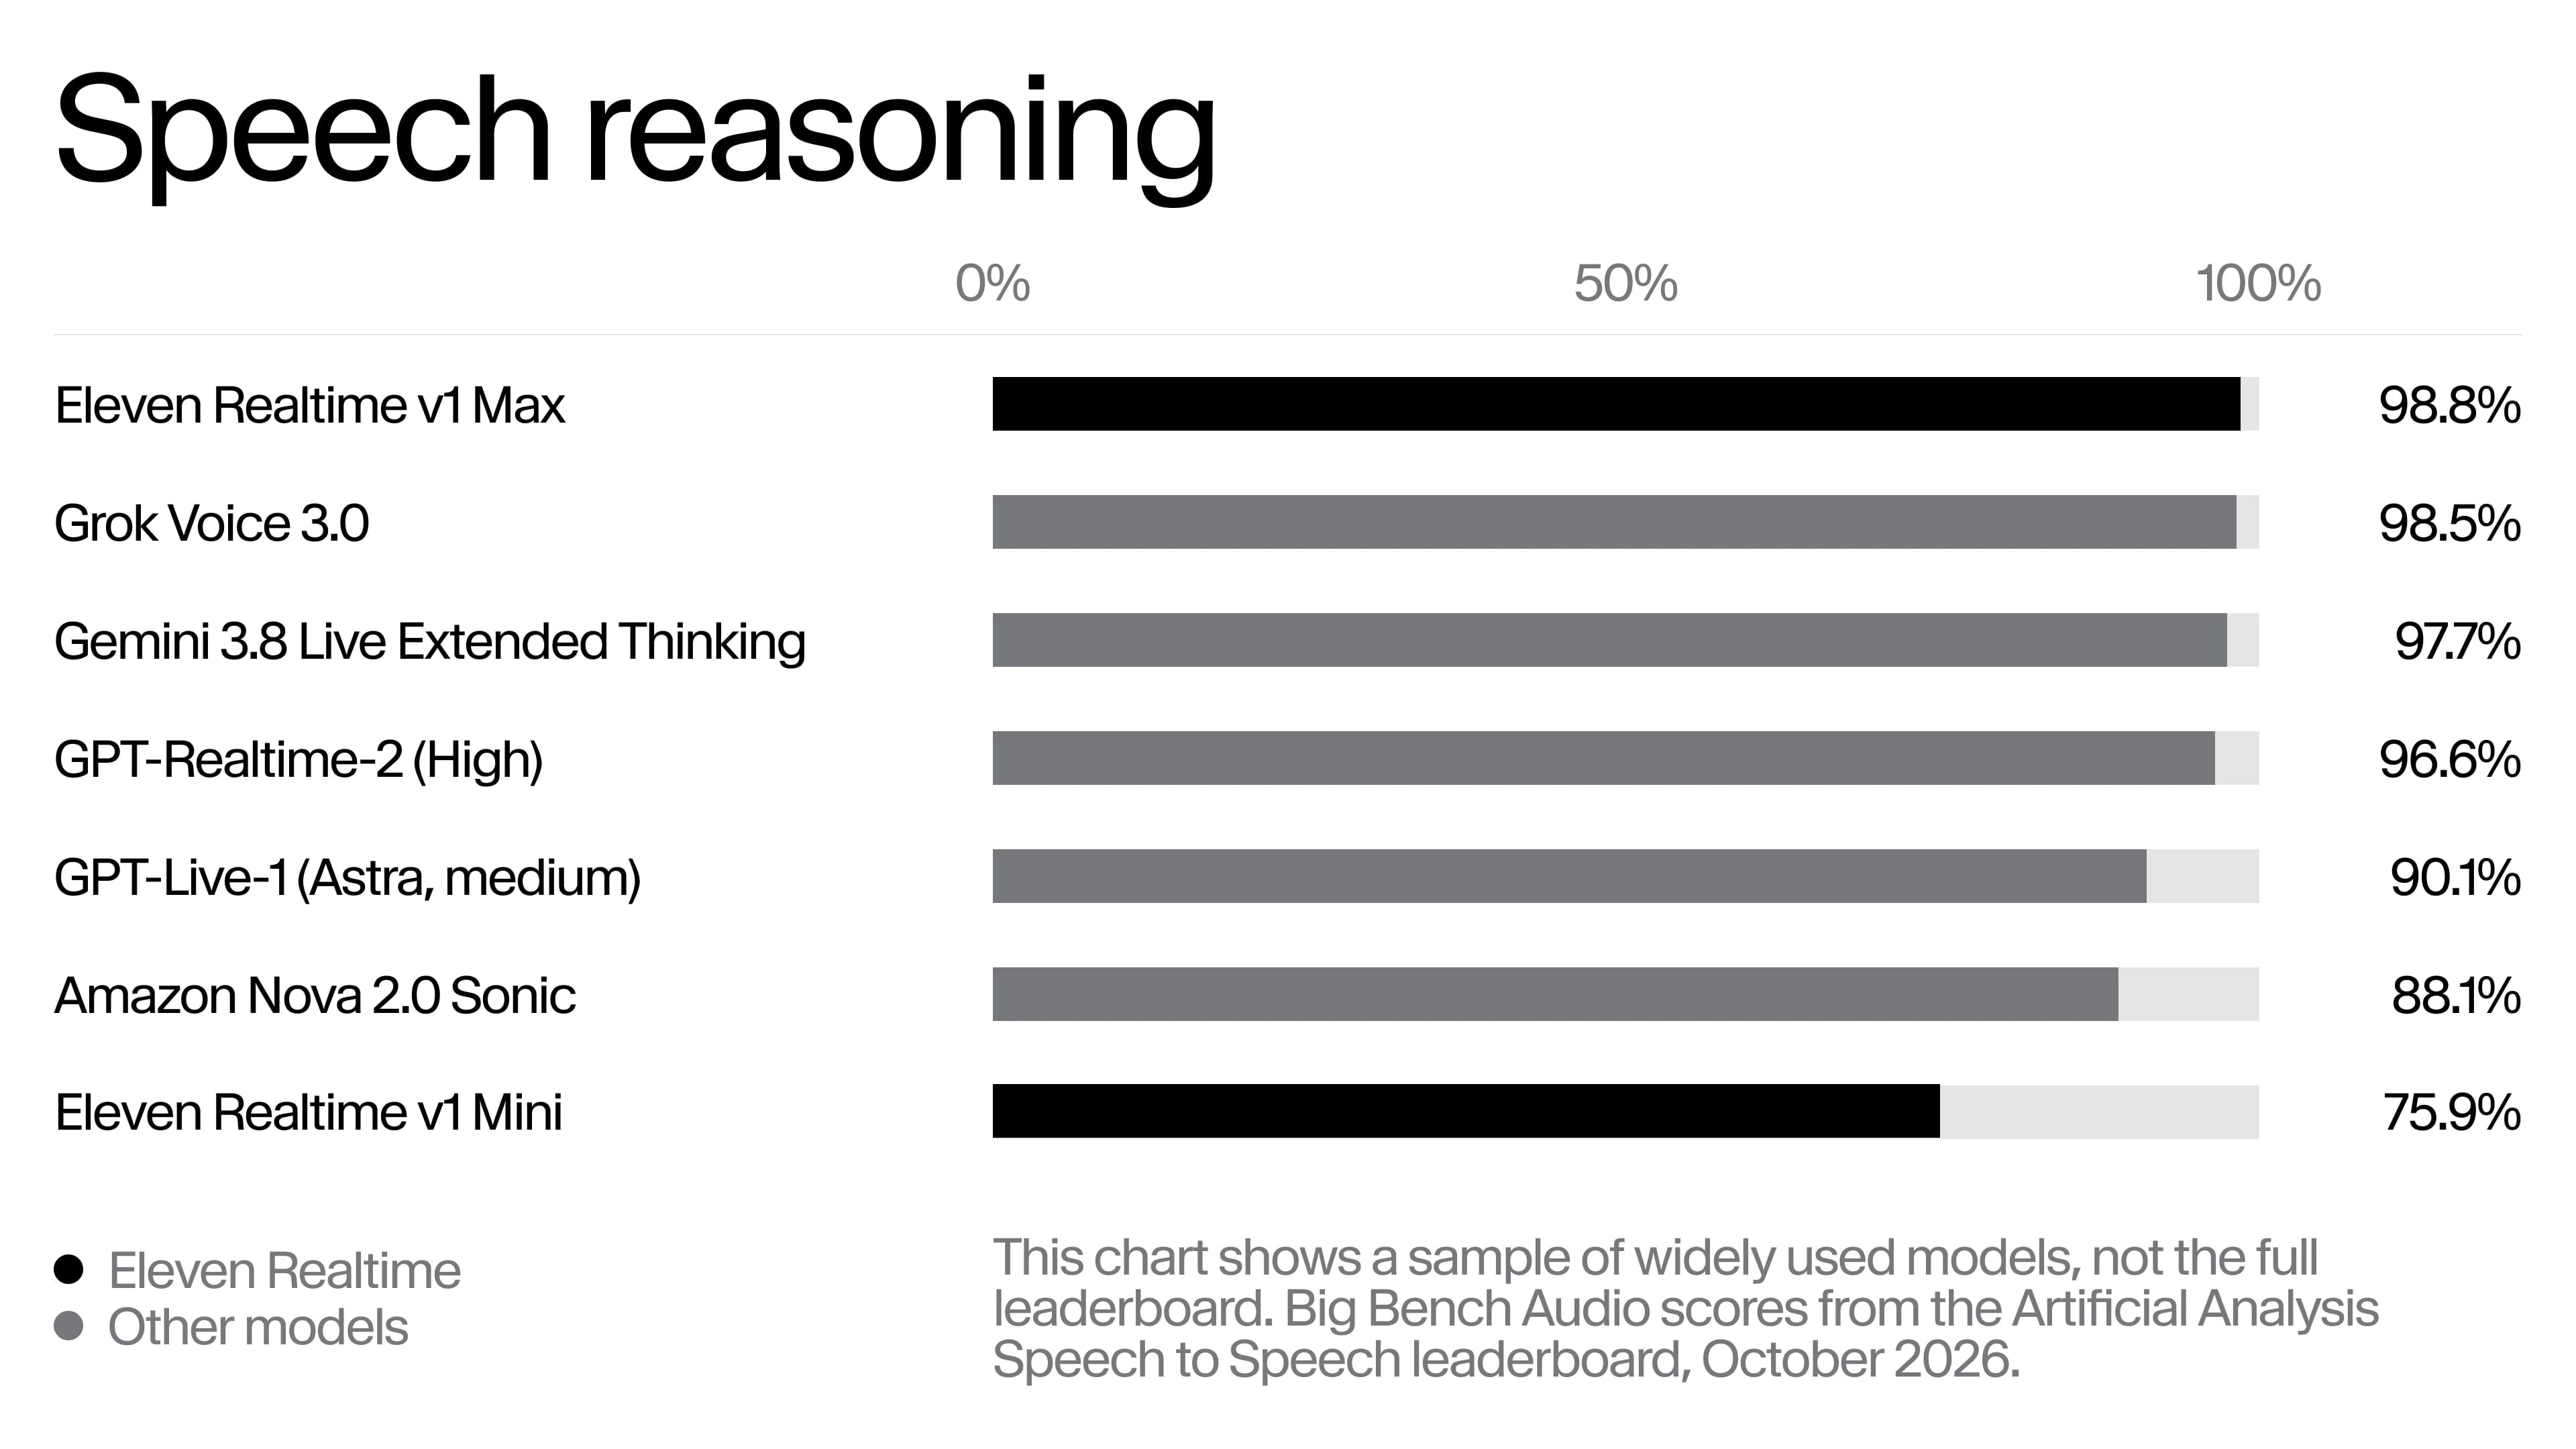
Big Bench Audio आवाज़ में 1,000 तर्क वाले सवाल पूछता है और बोले गए जवाब को स्कोर करता है। V1 Max औसतन 0.57 सेकंड में बोलना शुरू करता है और v1 Mini 0.62 सेकंड में।
सटीकता और गति के लिए पारेतो फ्रंटियर
सटीकता और गति को आमतौर पर एक समझौते के रूप में देखा जाता है। Big Bench Audio पर सबसे ज़्यादा स्कोर करने वाले मॉडल्स को जवाब देने में सबसे अधिक समय लगता है, और सबसे तेज़ मॉडल्स काफी सटीकता छोड़ देते हैं। v1 Max इन दोनों मेट्रिक्स में बेहतरीन है।
बातचीत की गतिशीलता और मानवीय पसंद
Full-Duplex-Bench में, जो विराम, टर्न-टेकिंग, रुकावटों और बैकचैनल्स को टेस्ट करता है, v1 Mini का स्कोर 95.8% और v1 Max का 94.1% है। Speech Agent Arena में, जहाँ लोग ब्लाइंड लाइव बातचीत में दो मॉडल्स की तुलना करते हैं, v1 Max का स्कोर 998 और v1 Mini का 988 रहा। टूल इस्तेमाल वाले कामों में v1 Max ने 87.1% और v1 Mini ने 60.3% काम पूरे किए। इसी वजह से हम ज़्यादा टूल कॉलिंग वाले उपयोग मामलों के लिए Max की सलाह देते हैं।
शुरू करें
ElevenAgents में (सुझाया गया)
एक एजेंट बनाएं या मौजूदा एजेंट खोलें, और ड्रॉपडाउन से Realtime मॉडल चुनें। इसके बाद एजेंट्स को प्रोडक्शन में चलाने के लिए आपको ElevenAgents की सभी सुविधाएं मिलती हैं। इनमें फ़ोन, वेब, WhatsApp और CCaaS चैनल्स, वर्कफ़्लो, नॉलेज बेस, गार्डरेल्स, टेस्टिंग और मॉनिटरिंग शामिल हैं।
ज़्यादा जानकारी के लिए ElevenAgents दस्तावेज़ देखें।
Realtime API के ज़रिए
अगर आपके पास पहले से OpenAI के Realtime API के साथ इंटीग्रेशन है, तो Eleven Realtime आज़माने का सबसे तेज़ तरीका है अपना कोड वैसे ही रखना और उसका पॉइंट किया हुआ स्थान बदलना। Realtime API WebSocket के ज़रिए कनेक्ट होता है और OpenAI Realtime स्पेक्स को फॉलो करता है, इसलिए OpenAI का SDK बिना बदलाव के काम करता है।
Realtime API केवल WebSocket के ज़रिए कनेक्ट होता है, इसलिए WebRTC इंटीग्रेशन को पहले WebSocket पर जाना होगा। यह ElevenAgents से अलग भी चलता है, इसलिए अगर आपको चैनल्स, नॉलेज बेस या प्लैटफ़ॉर्म की अन्य सुविधाएं चाहिए, तो शुरुआत से ElevenAgents पर बनाएं।
यह माइग्रेशन गाइड चरणों और OpenAI के API से अंतरों के बारे में बताती है।
Min, ElevenLabs की ग्रोथ टीम में हैं और ElevenAPI व ऑन-प्रेम/ऑन-डिवाइस पर काम करते हैं। इससे पहले, वे Stainless में दूसरी GTM हायर के रूप में प्रोडक्ट मार्केटिंग लीड करते थे। उससे पहले वे WorkOS में शुरुआती PMM थे, जहाँ उन्होंने लॉन्च, एनेबलमेंट, कंटेंट और ग्रोथ को आगे बढ़ाया।