वॉइस एक्टिविटी डिटेक्शन क्या है और यह कैसे काम करता है?
- लेखक
- Jack Limebear
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
वॉइस एक्टिविटी डिटेक्शन यह वर्गीकृत करता है कि छोटे, मिलीसेकंड-लंबे ऑडियो फ़्रेम में इंसानी आवाज़ है या नहीं। इसका इस्तेमाल ट्रांसक्रिप्शन, टेलीफोनी और वॉइस एजेंट्स समेत कई डिजिटल ऑडियो प्रोसेसिंग ऐप्लिकेशन में होता है।
इस लेख में हम जानेंगे कि वॉइस एक्टिविटी डिटेक्शन क्या करता है, क्या नहीं करता और प्रमुख एंटरप्राइज़ ऐप्लिकेशन में इसकी भूमिका क्या है।
सारांश
- वॉइस एक्टिविटी डिटेक्शन (VAD) आधुनिक ऑडियो वर्कफ़्लो का एक बुनियादी हिस्सा है। यह लगातार ऑडियो स्ट्रीम का विश्लेषण करता है और हर मिलीसेकंड-लंबे ऑडियो फ़्रेम में इंसानी आवाज़ मौजूद होने या न होने का हाँ/नहीं का निर्णय देता है।
- VAD डाउनस्ट्रीम ऑडियो टूल्स को बताता है कि उन्हें कब चलना है और कब इंतज़ार करना है। इसका उपयोग LLMs, ट्रांसक्रिप्शन सर्विसेज़ और अन्य एंटरप्राइज़ ऑडियो पाइपलाइनों में होता है।
- वॉइस एक्टिविटी डिटेक्शन एल्गोरिदम लगातार पाँच चरणों के लूप में काम करते हैं: ऑडियो कैप्चर करना, उसे फ़्रेम में बाँटना, वोकल फ़ीचर्स निकालना, स्पीच होने की संभावना को स्कोर करना और डाउनस्ट्रीम सर्विसेज़ को निर्णय भेजना।
- शुरुआत में VAD स्पीच की मौजूदगी पर हाँ/नहीं का निर्णय लेने के लिए पूरी तरह गणितीय सिग्नल प्रोसेसिंग पर निर्भर था। आधुनिक AI-आधारित सिस्टम यही काम न्यूरल नेटवर्क के ज़रिए करते हैं, लेकिन बैकग्राउंड नॉइज़ और सिमैंटिक संकेतों को संदर्भ के साथ बेहतर समझते हैं।
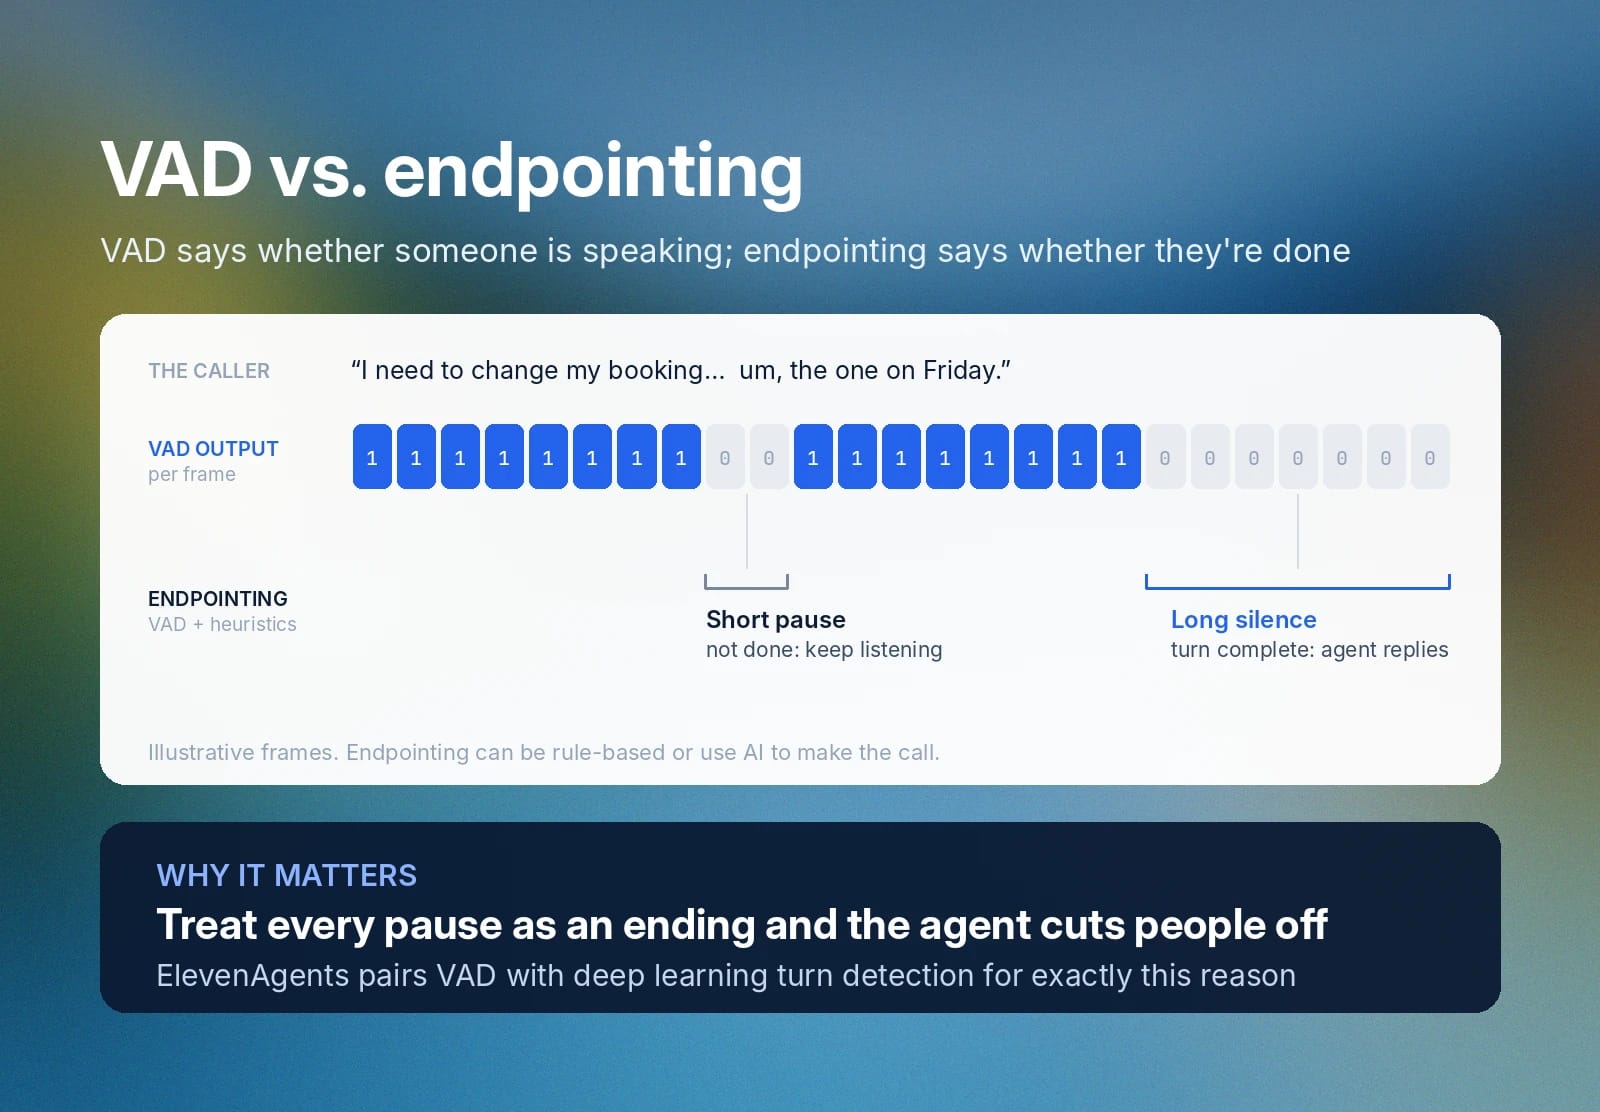
- VAD सिस्टम सिर्फ़ यह वर्गीकृत करते हैं कि किसी ऑडियो फ़्रेम में स्पीच है या नहीं। वे यह नहीं बताते कि कोई व्यक्ति बोलना कब पूरा कर चुका है। एंडपॉइंट सिस्टम यह तय करने के लिए VAD और अन्य हीयूरिस्टिक विश्लेषण टूल्स का उपयोग करते हैं कि वक्ता ने अपनी बात पूरी कर ली है या नहीं।
- एंटरप्राइज़ सेटिंग्स में, VAD वॉइस एजेंट्स को ग्राहकों की बात काटे बिना स्वाभाविक ढंग से बातचीत करने में मदद करता है, VoIP बैंडविड्थ के उपयोग को ऑप्टिमाइज़ करता है, स्पीच टू टेक्स्ट (STT) AI ट्रांसक्रिप्शन की लागत कम रखता है और इसके अन्य उपयोग भी हैं।
- VAD सिस्टम को वास्तविक परिस्थितियों में टेस्ट करें। बिल्कुल साफ़ स्टूडियो रिकॉर्डिंग उनकी क्षमताओं का आकलन करने का प्रभावी तरीका नहीं हैं।
वॉइस एक्टिविटी डिटेक्शन (VAD) क्या है?
वॉइस एक्टिविटी डिटेक्शन (VAD) एक सॉफ़्टवेयर प्रक्रिया है, जो यह वर्गीकृत करती है कि फ़्रेम कहे जाने वाले ऑडियो के छोटे हिस्सों में स्पीच है या नहीं। VAD एल्गोरिदम एक ऑडियो स्ट्रीम पर हर सेकंड दर्जनों से लेकर सैकड़ों बार चलते हैं और स्पीच का पता चलने या न चलने पर बाइनरी “हाँ” या “नहीं” उत्तर देते हैं।
इनका उपयोग व्यापक डिजिटल ऑडियो पाइपलाइनों में होता है, जैसे टेलीकम्यूनिकेशंस या स्पीच ट्रांसक्रिप्शन। ये ASR/STT, LLMs और टर्न प्लानर्स जैसे अन्य डाउनस्ट्रीम सिस्टम को बताते हैं कि ऑडियो स्ट्रीम को सक्रिय रूप से सुनना है या इंतज़ार करना है।
VAD, ऑटोमैटिक स्पीच रिकग्निशन (ASR) जैसा नहीं है। VAD सिस्टम सिर्फ़ इस बारे में संभाव्यता-आधारित हाँ या नहीं का उत्तर देता है कि उसे स्पीच मिली या नहीं। यह वास्तविक शब्द आउटपुट नहीं करता। इसका मुख्य काम डाउनस्ट्रीम सिस्टम को बताना है कि किसी दिए गए ऑडियो फ़्रेम को प्रोसेस करना है या नहीं।
वॉइस एक्टिविटी डिटेक्शन एल्गोरिदम कैसे काम करते हैं?
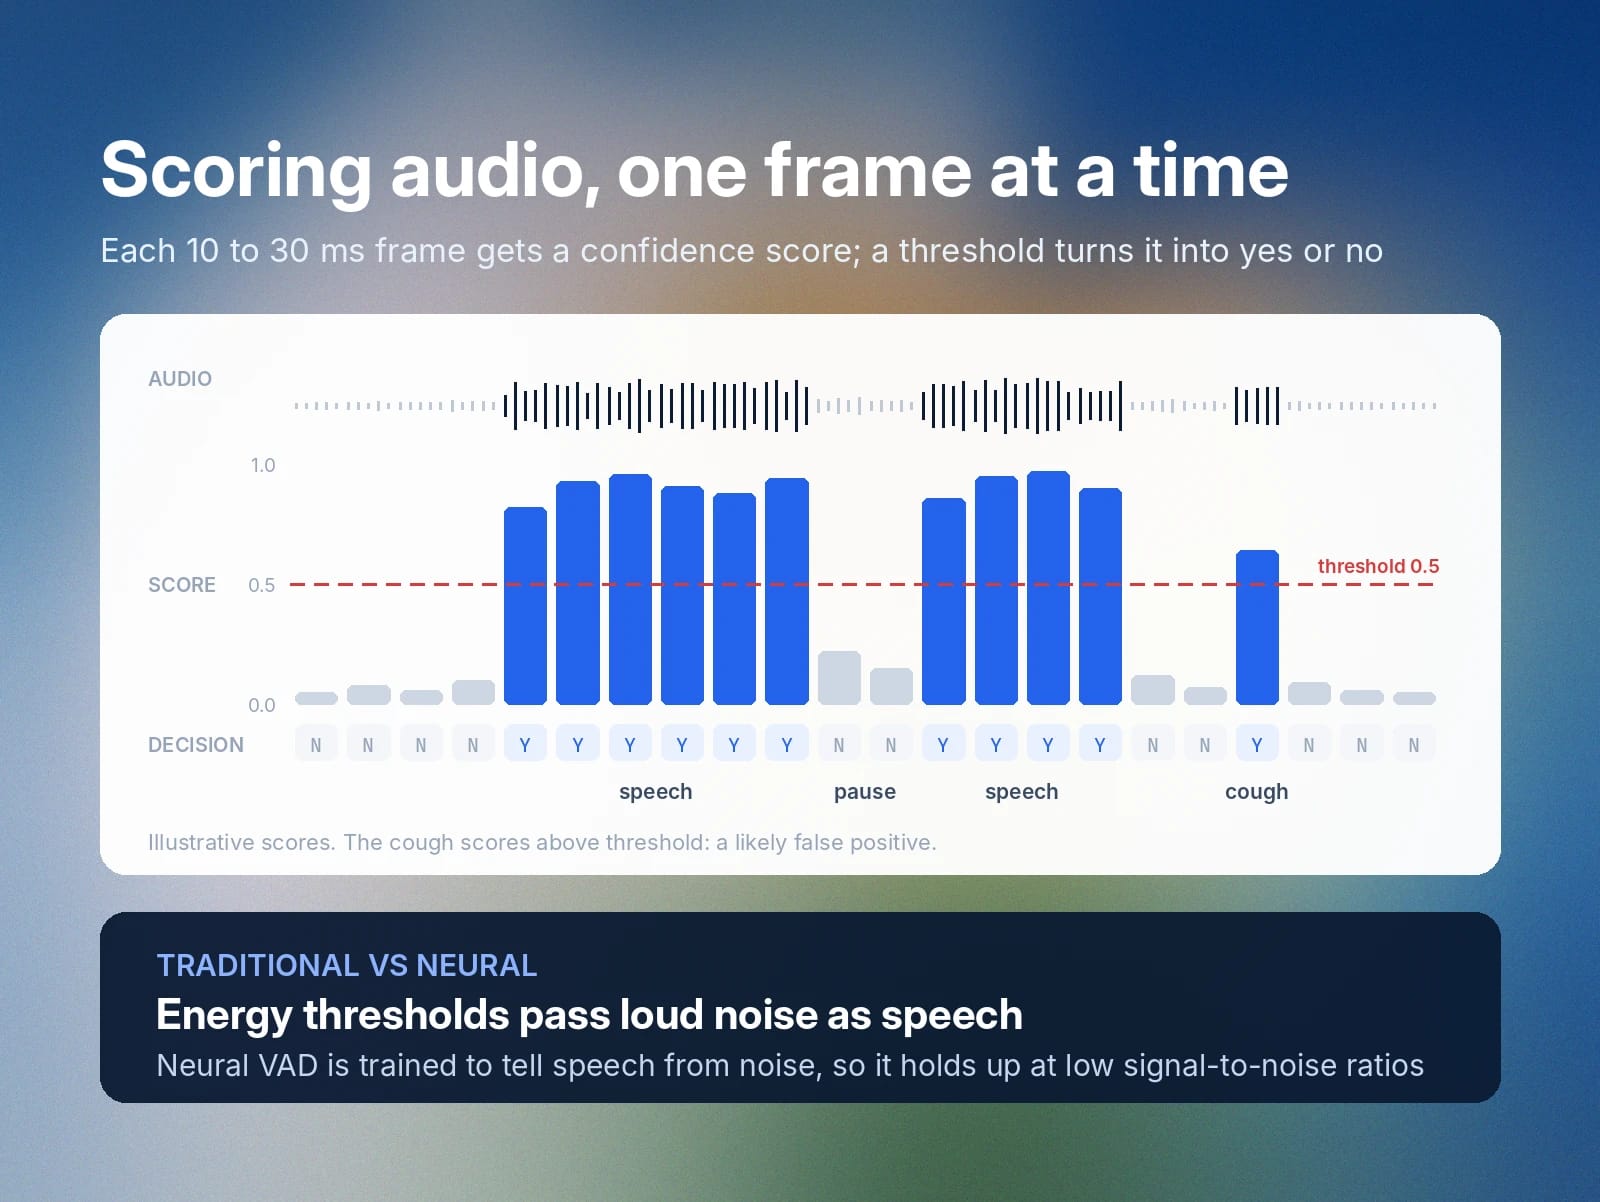
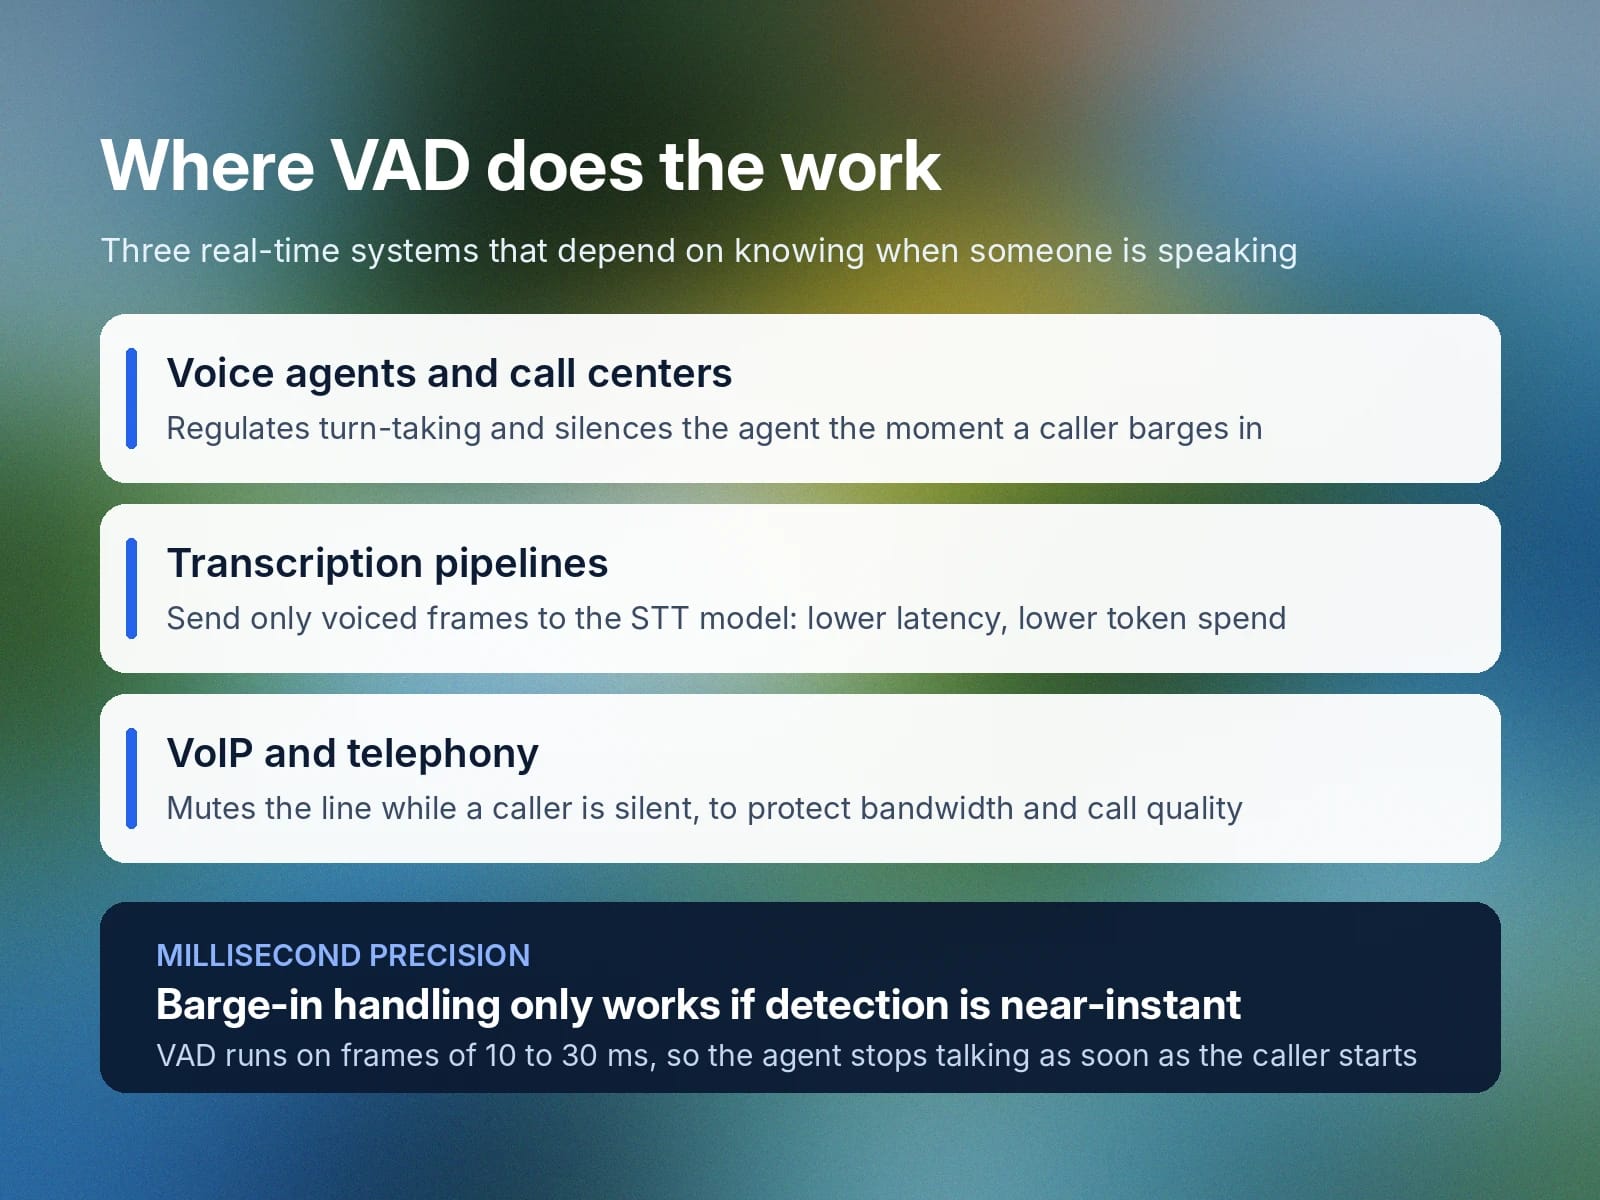
एक VAD एल्गोरिदम ऑडियो स्ट्रीम पर चलता है और यह हाँ/नहीं का निर्णय लेता है कि कोई ऑडियो फ़्रेम, जो आमतौर पर 10-30 मिलीसेकंड का होता है, स्पीच रखता है या नहीं।
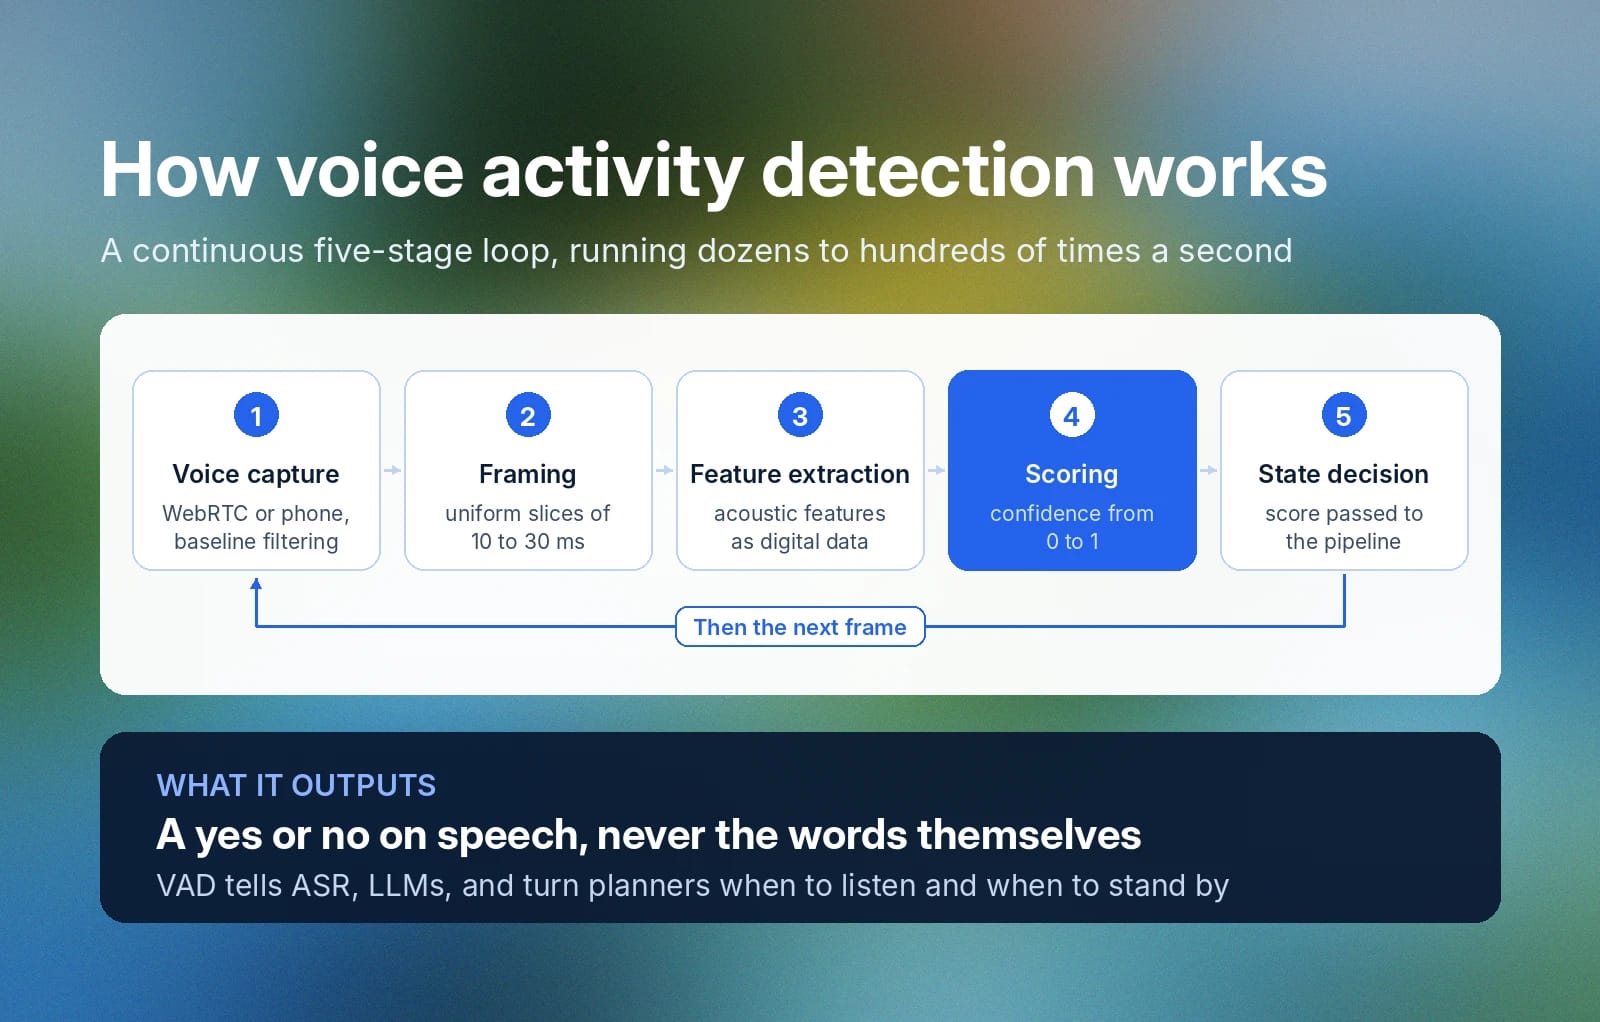
वे लगातार पाँच चरणों के लूप में काम करते हैं:
- वॉइस कैप्चर: VAD चलाने वाला सिस्टम WebRTC या टेलीफोनी के ज़रिए ऑडियो स्ट्रीम प्राप्त करता है और डेटा पर बुनियादी नॉइज़ फ़िल्टरिंग लागू करता है।
- फ़्रेमिंग: एल्गोरिदम कच्ची ऑडियो स्ट्रीम को एकसमान फ़्रेम में बाँटता है।
- फ़ीचर एक्सट्रैक्शन: एल्गोरिदम स्ट्रीम से ऐसे ध्वनिक फ़ीचर्स निकालता है, जिन्हें वह गणितीय रूप से डिजिटल डेटा के रूप में प्रस्तुत कर सकता है।
- स्कोरिंग: सिस्टम फ़्रेम में निकाले गए फ़ीचर्स को वास्तविक VAD एल्गोरिदम से प्रोसेस करता है, ताकि स्पीच होने की संभावना का 0 से 1 के बीच कॉन्फ़िडेंस स्कोर बनाया जा सके (0=”कोई स्पीच नहीं” और 1=”स्पीच”)।
- स्टेट निर्णय: VAD सिस्टम कॉन्फ़िडेंस स्कोर को उस ऑडियो पाइपलाइन तक भेजता है जिसमें वह चल रहा होता है, ताकि पाइपलाइन तय कर सके कि इसे कैसे हैंडल करना है।
पारंपरिक बनाम AI-आधारित वॉइस एक्टिविटी डिटेक्शन
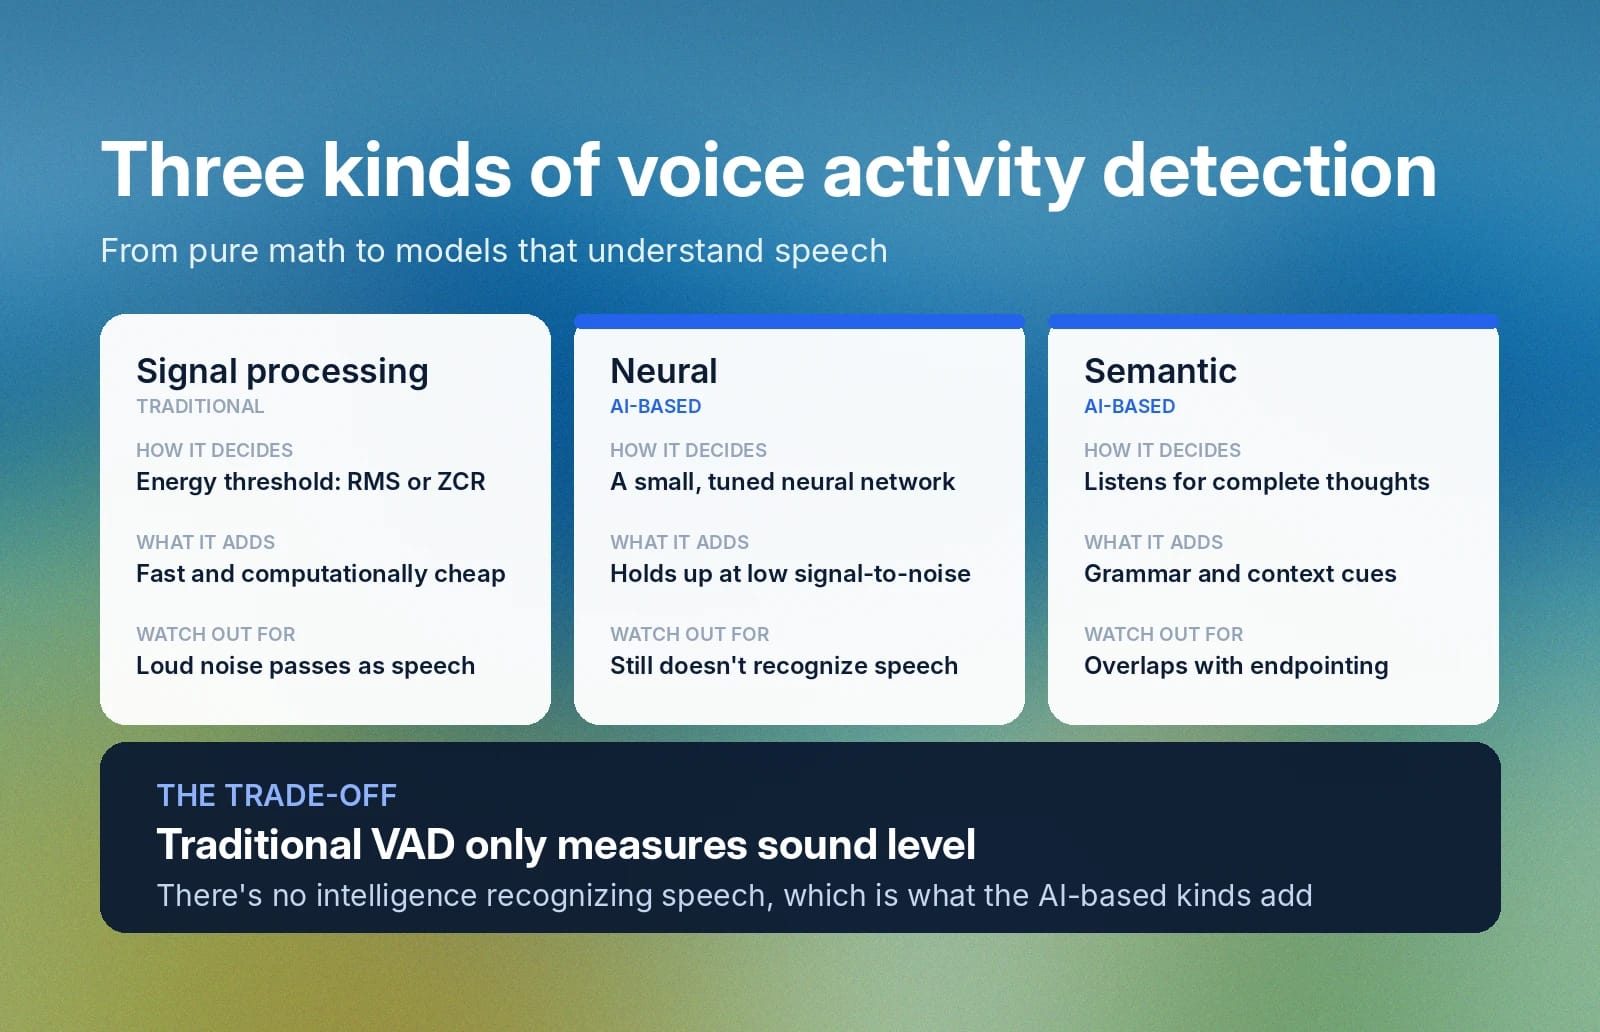
VAD दो व्यापक श्रेणियों में आता है: सिग्नल प्रोसेसिंग और AI।
AI-आधारित VAD में दो अलग-अलग तरीके हैं, यानी कुल मिलाकर वॉइस एक्टिविटी डिटेक्शन के तीन प्रकार हैं।
आइए इन्हें विस्तार से समझते हैं।
पारंपरिक (सिग्नल प्रोसेसिंग) VAD
पारंपरिक VAD तकनीक ऑडियो स्ट्रीम के एनर्जी लेवल को मापती है और अगर वह एक तय थ्रेशोल्ड पार कर जाए, तो स्पीच मौजूद होने की पुष्टि करती है। यह पूरी तरह गणितीय है, अक्सर रूट-मीन-स्क्वेयर (RMS) या ज़ीरो-क्रॉसिंग रेट (ZCR) कैलकुलेशन पर आधारित। यदि कोई फ़्रेम थ्रेशोल्ड से ऊपर मापा जाता है, तो उसे स्पीच माना जाता है। थ्रेशोल्ड से नीचे होने पर नहीं।
पारंपरिक VAD तेज़ है और कम कंप्यूटिंग संसाधन लेता है, लेकिन यह ऑडियो में केवल ध्वनि स्तर मापता है। तेज़ बैकग्राउंड नॉइज़ से फ़ॉल्स पॉज़िटिव हो सकते हैं। इसमें वास्तव में स्पीच को पहचानने वाली कोई इंटेलिजेंस नहीं होती।
AI-आधारित VAD
नए AI-आधारित VAD के दो प्रकार हैं: न्यूरल और सिमैंटिक। पूरी तरह गणितीय थ्रेशोल्ड का उपयोग करने के बजाय, न्यूरल VAD यह तय करने के लिए एक छोटे, बेहद बारीकी से ट्यून किए गए न्यूरल नेटवर्क का उपयोग करता है कि ऑडियो फ़्रेम में स्पीच है या साइलेंस। उनकी ट्रेनिंग उन्हें स्पीच और नॉइज़ का अंतर समझने देती है, इसलिए जब किसी ऑडियो स्ट्रीम में सिग्नल-टू-नॉइज़ रेशियो (SNR) कम हो, यानी बैकग्राउंड नॉइज़ अधिक हो, तो वे पारंपरिक VAD से बेहतर काम करते हैं।
न्यूरल VAD की कमी यह है कि वे अब भी स्पीच को खुद नहीं पहचानते। सिमैंटिक AI VAD एक अलग प्रकार है, जो ऐसा करता है। यह एंडपॉइंटिंग से इस मायने में जुड़ता है कि यह बोले गए विचार के पूरा होने के संकेतों के लिए ऑडियो फ़ीड सुनता है। यह व्याकरण और संदर्भ के आधार पर समझ सकता है कि आगे कुछ और बोला जा सकता है या नहीं।
VAD बनाम एंडपॉइंटिंग
VAD और एंडपॉइंटिंग एक-दूसरे की पूरक तकनीकें हैं। वॉइस एक्टिविटी डिटेक्शन सिस्टम बस यह तय करता है कि जिस ऑडियो फ़्रेम को वह प्रोसेस कर रहा है, उसमें कोई बोल रहा है या नहीं। यह बाइनरी हाँ/नहीं का निर्णय लेकर बाकी ऑडियो प्रोसेसिंग पाइपलाइन को भेज देता है।
एंडपॉइंटिंग सिस्टम यह तय करने के लिए हीयूरिस्टिक विश्लेषण के साथ VAD आउटपुट का उपयोग करता है कि वक्ता ने अपनी बात पूरी कर ली है या नहीं। यह निर्णय लेने के लिए नियम-आधारित सिग्नल प्रोसेसिंग या AI का उपयोग कर सकता है।
रीयल-टाइम AI में वॉइस एक्टिविटी डिटेक्शन के उपयोग
वॉइस एक्टिविटी डिटेक्शन कई उपयोग मामलों में महत्वपूर्ण है।
ऑटोनॉमस वॉइस एजेंट्स और कॉल सेंटर्स
ग्राहक कॉल्स की स्क्रीनिंग करने वाले ऑटोनॉमस एजेंट को पता होना चाहिए कि जवाब देना कब सही है। आप नहीं चाहेंगे कि एजेंट ग्राहक को वाक्य के बीच में टोक दे या ग्राहक के जल्दी जवाब देने पर उसके ऊपर बोलता रहे। VAD बातचीत में बारी लेने को नियंत्रित करने और इंटरैक्शन का स्वाभाविक प्रवाह बनाए रखने में मदद करता है। चूँकि यह मिलीसेकंड स्तर तक काम करता है, इसलिए ग्राहक के “बार्ज-इन” को मैनेज करने में भी बेहद प्रभावी है और ग्राहक के बीच में बोलने पर एजेंट को चुप कर देता है।
ट्रांसक्रिप्शन पाइपलाइन
अगर आप स्पीच टू टेक्स्ट ट्रांसक्रिप्शन API सर्विस का इस्तेमाल कर रहे हैं, जैसे ElevenAPI, तो वॉइस एक्टिविटी डिटेक्शन से भेजे जाने वाले ऑडियो को फ़िल्टर कर सकते हैं, ताकि मॉडल सिर्फ़ आवाज़ वाले फ़्रेम प्रोसेस करे। इससे नेटवर्क लेटेंसी कम होती है और, ज़्यादा महत्वपूर्ण रूप से, ट्रांसक्रिप्शन मॉडल पर आपके टोकन का उपयोग भी कम होता है। बैकग्राउंड नॉइज़ पर AI खर्च बर्बाद नहीं होगा।
VoIP और टेलीफोनी ऑप्टिमाइज़ेशन
एंटरप्राइज़ VoIP नेटवर्क पर लेटेंसी कॉल क्वालिटी को भी प्रभावित कर सकती है। परफ़ॉर्मेंस ऑप्टिमाइज़ करने के लिए, ये डिजिटल ऑडियो सिस्टम कॉलर के न बोलने पर VAD के ज़रिए लाइन को अस्थायी रूप से म्यूट कर देते हैं।
वॉइस एक्टिविटी डिटेक्शन चुनौतीपूर्ण क्यों है?
पारंपरिक वॉइस एक्टिविटी डिटेक्शन स्पीच की मौजूदगी तय करने के लिए गणितीय एल्गोरिदम पर निर्भर करता है। लेकिन इंसानी बोलने के पैटर्न बेतरतीब होते हैं। बातचीत अक्सर अनियमित और रुक-रुक कर होती है, और वास्तविक परिवेश में बैकग्राउंड नॉइज़ व आस-पास की बातचीत भी होती है। VAD की मुख्य चुनौती शोर-भरे ऑडियो में सार्थक साइलेंस पहचानना है।
यह कुछ खास चुनौतियों के रूप में सामने आता है।
वाक्य के बीच के विराम
लोग पूरी बातचीत में एक समान गति से नहीं बोलते। वे रुकते हैं, अपने विचार इकट्ठा करते हैं, बोलते समय अपनी बात पर फिर सोचते हैं और कभी विचार की कड़ी खो देते हैं। इनमें से किसी भी विराम का मतलब यह नहीं कि वक्ता ने बोलना पूरा कर लिया है। इसे समझना आम तौर पर इंसानी श्रोताओं के लिए आसान होता है, लेकिन सॉफ़्टवेयर के लिए, नए AI मॉडल्स के लिए भी, चुनौतीपूर्ण हो सकता है।
अगर VAD सिस्टम इन विरामों को स्पीच खत्म होने के रूप में समझ लें, तो ट्रांज़ैक्शन में वाक्य के बीच क्लिपिंग हो सकती है या वॉइस एजेंट किसी इंसानी वक्ता को बीच में रोक सकता है।
वोकल नॉइज़
धीमी आवाज़, धीरे-धीरे खत्म होने वाले अंतिम व्यंजन (जो वाक्य के अंत में आम हैं), और वोकल फ्राय जैसी विशेषताएँ VAD सिस्टम को वास्तविक स्पीच पहचानने से रोक सकती हैं।
अप्रत्याशित ध्वनिक स्थितियाँ
लगातार रहने वाले बैकग्राउंड व्हाइट नॉइज़, जैसे पंखे या बहते पानी की आवाज़, को VAD सिस्टम के लिए फ़िल्टर करना अपेक्षाकृत आसान है। रुक-रुक कर आने वाले शोर, जैसे कुत्ते के भौंकने की आवाज़, को संभावित रूप से झूठी स्पीच के रूप में फ़्लैग किया जा सकता है।
भारी ऑडियो कंप्रेशन डायनेमिक रेंज हटा देता है और VAD के लिए साइलेंट और स्पीच फ़्रेम के बीच अंतर करना मुश्किल बना सकता है।
VAD परफ़ॉर्मेंस का आकलन कैसे करें
इंसानी स्पीच बेतरतीब होती है, खासकर जब उसे गतिशील, वास्तविक परिवेश में रिकॉर्ड किया जाए। बिल्कुल साफ़ ऑडियो रिकॉर्डिंग VAD परफ़ॉर्मेंस टेस्ट करने का अच्छा तरीका नहीं हैं। केवल स्पीच टू टेक्स्ट की सटीकता भी VAD सिस्टम की प्रभावशीलता को सीधे नहीं मापती, क्योंकि यह VAD द्वारा पहचाने जाने के बाद की प्रक्रिया है।
फ़ॉल्स पॉज़िटिव बनाम फ़ॉल्स नेगेटिव
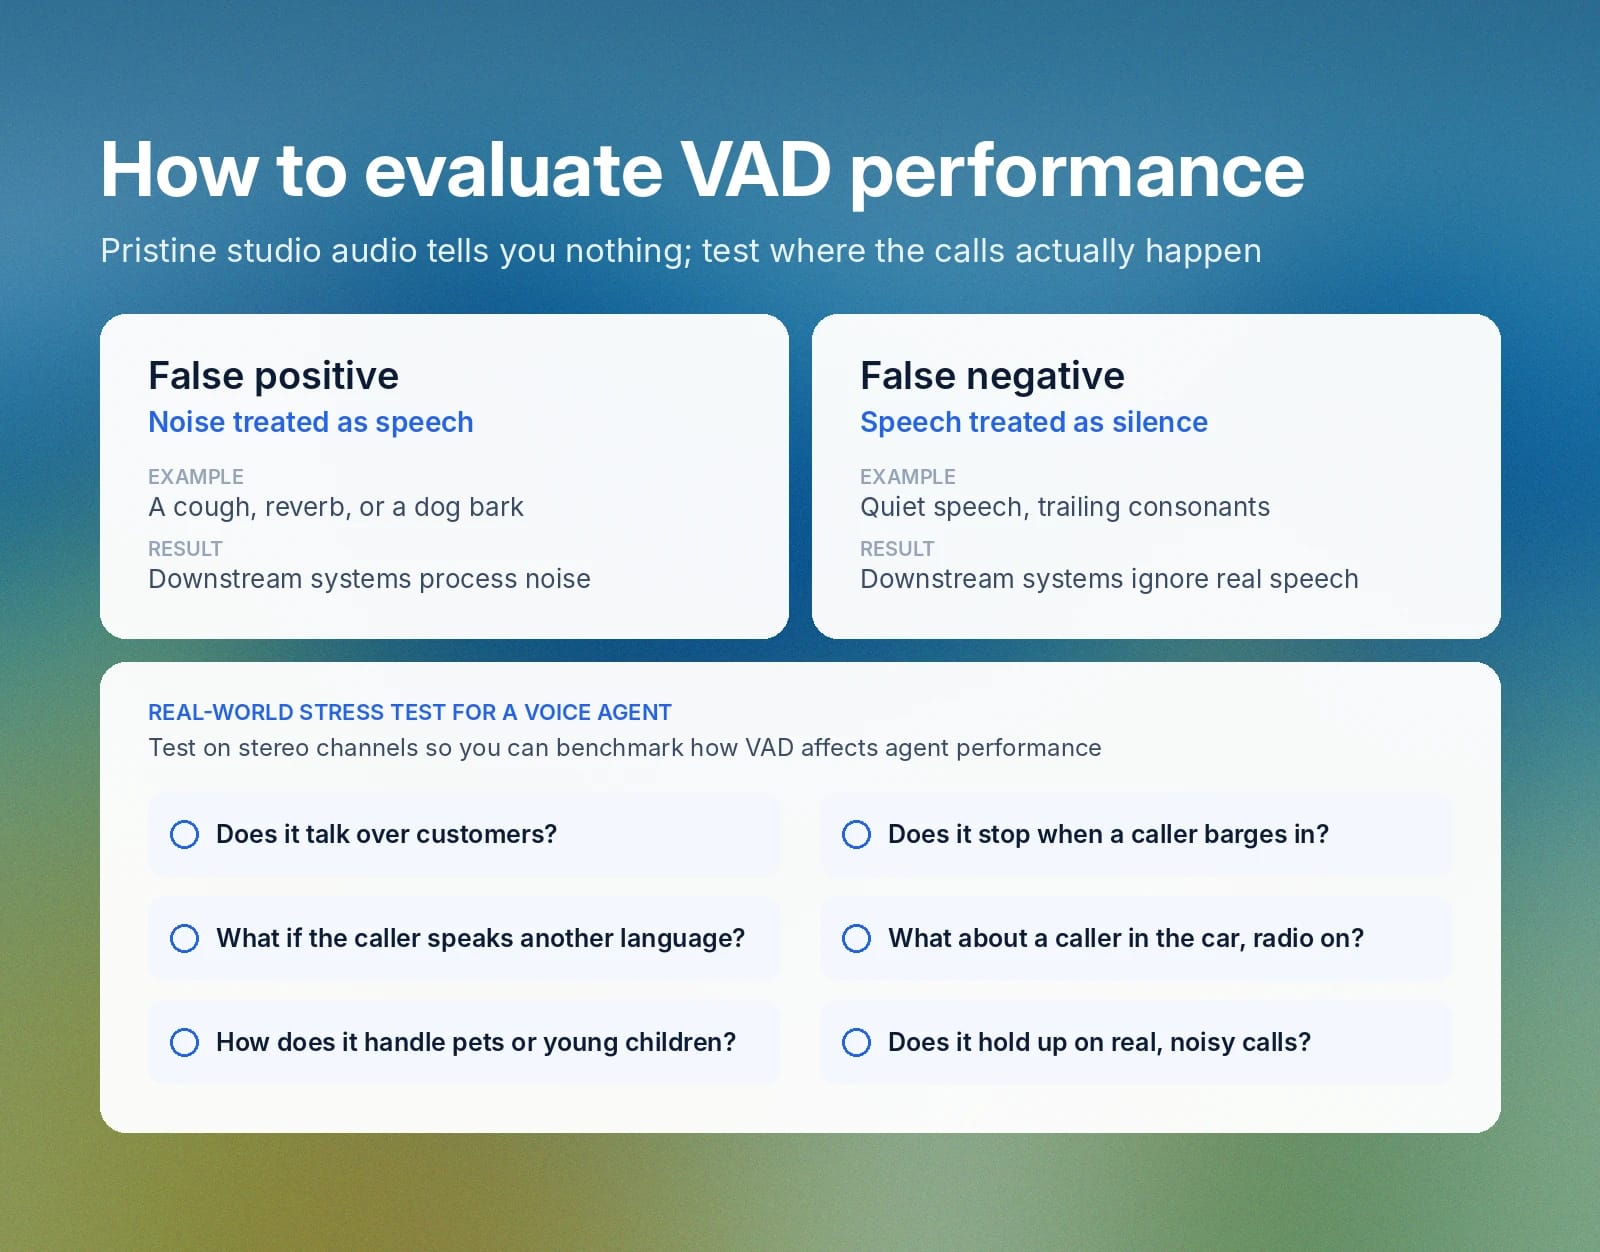
VAD फ़ॉल्स पॉज़िटिव ऐसे नॉइज़ होते हैं जिन्हें स्पीच मान लिया जाता है। खाँसी, रीवर्ब, कुत्ते का भौंकना और कोई भी अचानक होने वाला बैकग्राउंड नॉइज़ इन्हें ट्रिगर कर सकता है और गलती से स्पीच फ़्रेम के रूप में पास हो सकता है।
फ़ॉल्स नेगेटिव ऐसी स्पीच होती है जिसे साइलेंस मान लिया जाता है। VAD गलती से डाउनस्ट्रीम सर्विसेज़ को ऑडियो फ़्रेम अनदेखा करने के लिए कह देता है।
वास्तविक परिस्थितियों में स्ट्रेस टेस्टिंग
VAD सर्विस का आकलन करने के लिए आपको देखना होगा कि जहाँ ऑडियो रिकॉर्ड किया जाएगा, उन परिवेशों और वास्तविक परिस्थितियों में यह कैसे काम करती है।
उदाहरण के लिए, अगर आप वॉइस एजेंट के लिए VAD का उपयोग करने वाले हैं, तो स्टीरियो चैनल्स के साथ टेस्ट करें, ताकि आप माप सकें कि यह एजेंट की परफ़ॉर्मेंस को कैसे प्रभावित करता है। ऐसे सवाल सामने आ सकते हैं:
- क्या फ़ॉल्स नेगेटिव की वजह से एजेंट ग्राहकों के ऊपर बोलने लगता है?
- क्या यूज़र के बीच में बोलने पर यह एजेंट को बोलने से रोकता है?
- अगर कॉलर कोई विदेशी भाषा बोलता है, तो क्या होता है?
- वास्तविक परिवेश से कॉल करने वाले वक्ताओं को सुनते समय यह कैसे काम करता है?
- अगर कोई ग्राहक कार से कॉल करे, लेकिन रेडियो की आवाज़ कम न करे, तो क्या होता है?
- पालतू जानवरों या छोटे बच्चों के बैकग्राउंड नॉइज़ के साथ यह कैसा काम करता है?
ग्राहक कॉल्स में ये सभी स्थितियाँ होने की संभावना है। VAD को इन्हें संभालते हुए अच्छा काम करना चाहिए।
कस्टमर सर्विस के लिए ElevenAgents के साथ शुरुआत करें
ElevenAgents एजेंटिक बातचीत को सहज और स्वाभाविक बनाए रखने के लिए हाइब्रिड VAD और डीप लर्निंग टर्न-डिटेक्शन सिस्टम का उपयोग करता है।
आज ही ElevenAgents के साथ नया कस्टमर सर्विस एजेंट बनाना शुरू करें। साइन अप करें और शुरुआत करें।
अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।