
LLM क्या है? भाषा मॉडलों के लिए एक व्यावहारिक गाइड
- लेखक
- Jack Limebear
- प्रकाशित
सुनेंइस आर्टिकल को सुनें
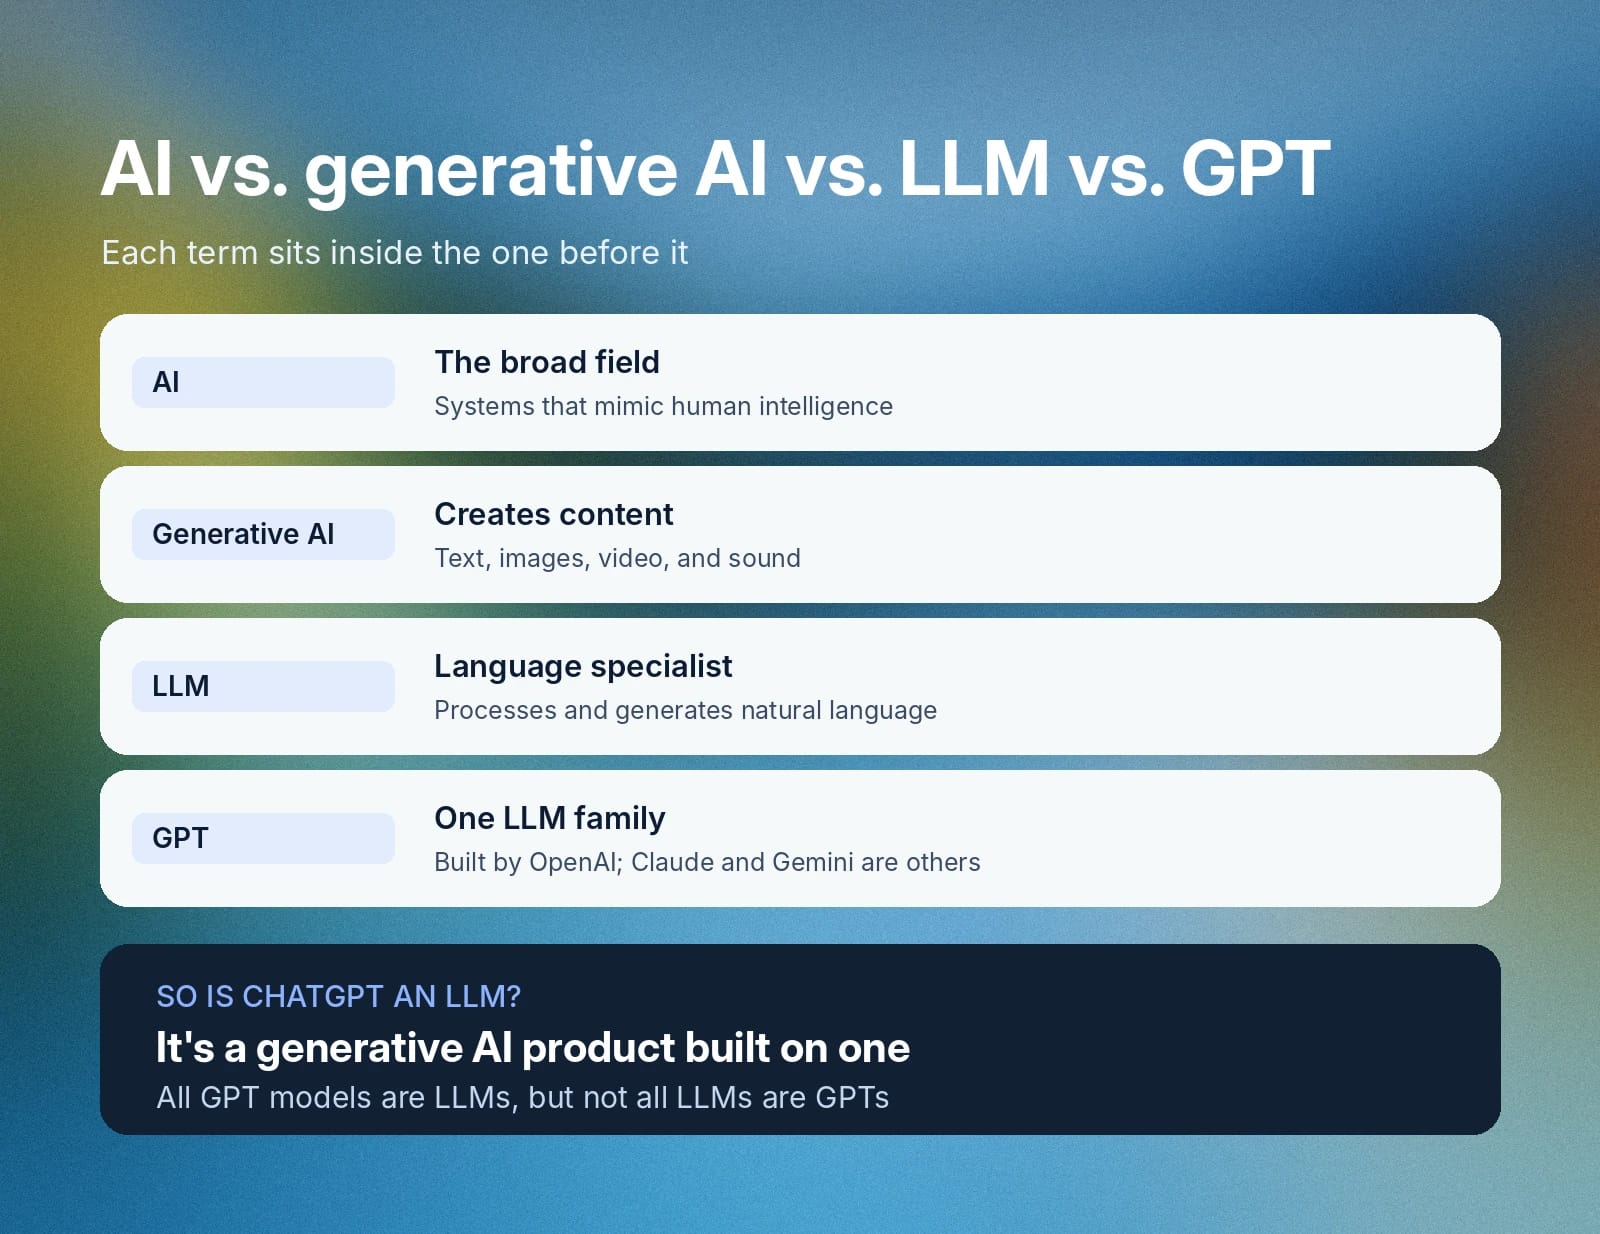
लार्ज लैंग्वेज मॉडल (LLM) एक आर्टिफिशियल इंटेलिजेंस सिस्टम है, जिसे प्राकृतिक भाषा का विश्लेषण करने, उसका अनुमान लगाने और उसे जनरेट करने के लिए विशाल डेटासेट पर प्रशिक्षित किया जाता है। लोकप्रिय LLM में OpenAI के GPT मॉडल, Anthropic का Claude और Google का Gemini शामिल हैं, जिनका इस्तेमाल अक्सर लेखन, संपादन और कोडिंग जैसे कामों के लिए होता है।
शुरुआत में, LLM डेटासेट में मुख्य रूप से किताबों, ब्लॉग और ऑनलाइन फ़ोरम जैसे स्रोतों का टेक्स्ट शामिल होता था। आधुनिक LLM अब उपयोग के दायरे को बढ़ाने के लिए मल्टीमॉडल डेटा का उपयोग करते हैं, जैसे कन्वर्सेशनल वॉइस एजेंट्स को पावर देना या संगीत बनाना।
इस तकनीक को लागू करने से पहले, संगठनों को अक्सर ऐसे सवालों के जवाब चाहिए होते हैं: LLM क्या है, LLM कैसे काम करता है और टीम को किन आर्किटेक्चर का उपयोग करना चाहिए? यह गाइड इन सवालों का जवाब देती है और साथ ही तकनीक के वास्तविक उपयोग और उनके ठोस फायदों को दिखाती है।
सारांश
- लार्ज लैंग्वेज मॉडल (LLM) एक आर्टिफिशियल इंटेलिजेंस मॉडल है, जिसे टेक्स्ट और मल्टीमॉडल डेटा के विशाल डेटासेट पर आउटपुट का विश्लेषण, अनुमान और निर्माण करने के लिए प्रशिक्षित किया जाता है।
- GPT और LLM के बीच मुख्य अंतर यह है कि GPT (Generative Pre-trained Transformer), OpenAI द्वारा बनाया गया LLM का एक खास परिवार है, जबकि LLM, Claude और Gemini जैसे मॉडलों के लिए व्यापक शब्द है।
- जनरेटिव AI, ट्रेनिंग डेटा के आधार पर अलग-अलग तरह का कंटेंट बनाने वाले मॉडलों की व्यापक श्रेणी है, जबकि LLM जनरेटिव AI का एक विशेष हिस्सा हैं जो प्राकृतिक भाषा प्रोसेसिंग पर केंद्रित होता है।
- LLM, टेक्स्ट को टोकन नाम की छोटी इकाइयों में बांटने के लिए ट्रांसफॉर्मर न्यूरल नेटवर्क का उपयोग करते हैं, फिर प्रॉम्प्ट और मौजूदा चैट हिस्ट्री की संदर्भ जानकारी के आधार पर अगले टोकन का अनुमान लगाते हैं।
- लार्ज लैंग्वेज मॉडल के व्यावहारिक उदाहरणों में कस्टमर सर्विस चैटबॉट, ऑटोमेटेड राइटिंग टूल, कोड जनरेटर और वॉइस ऐप्लिकेशन के लिए प्राकृतिक भाषा प्रोसेसिंग लेयर शामिल हैं।
LLM क्या है? लार्ज लैंग्वेज मॉडल की परिभाषा
लार्ज लैंग्वेज मॉडल एक AI प्रोग्राम है, जो प्राकृतिक भाषा का विश्लेषण, अनुमान और निर्माण करने के लिए डीप लर्निंग न्यूरल नेटवर्क पर बनाया जाता है। डेवलपर्स ने इन मॉडलों को किताबों, अकादमिक पेपरों, वेबसाइटों और ब्लॉग में मौजूद अरबों रचनाओं वाले डेटासेट पर प्रशिक्षित किया है। “लार्ज” शब्द इन मॉडलों को प्रशिक्षित करने में उपयोग होने वाले विशाल डेटा और इनके व्यवहार को नियंत्रित करने वाले अरबों आंतरिक पैरामीटर, दोनों को दर्शाता है।
लार्ज लैंग्वेज मॉडल, पुराने सॉफ़्टवेयर के काम करने के तरीके से एक बड़ा बदलाव हैं; पारंपरिक सॉफ़्टवेयर स्पष्ट सिंटैक्स कमांड पर निर्भर था, लेकिन LLM नहीं। हर शब्द को अलग-अलग प्रोसेस करने के बजाय, LLM जटिल भाषाई पैटर्न और व्याकरण को पहचानने के लिए संदर्भ संबंधों का उपयोग करते हैं। वे असंरचित मानव भाषा को समझते हैं और बातचीत के बीच में संदर्भ बदलने पर उसके अनुसार ढलते हुए, ओपन-एंडेड यूज़र प्रॉम्प्ट का जवाब देते रहते हैं।
प्राकृतिक भाषा प्रोसेसिंग में ये प्रगति ElevenAgents को जटिल ग्राहक इरादों को समझने और ऑटोमेटेड वर्कफ़्लो चलाने में सक्षम बनाती है।
लार्ज लैंग्वेज मॉडल कैसे काम करते हैं?
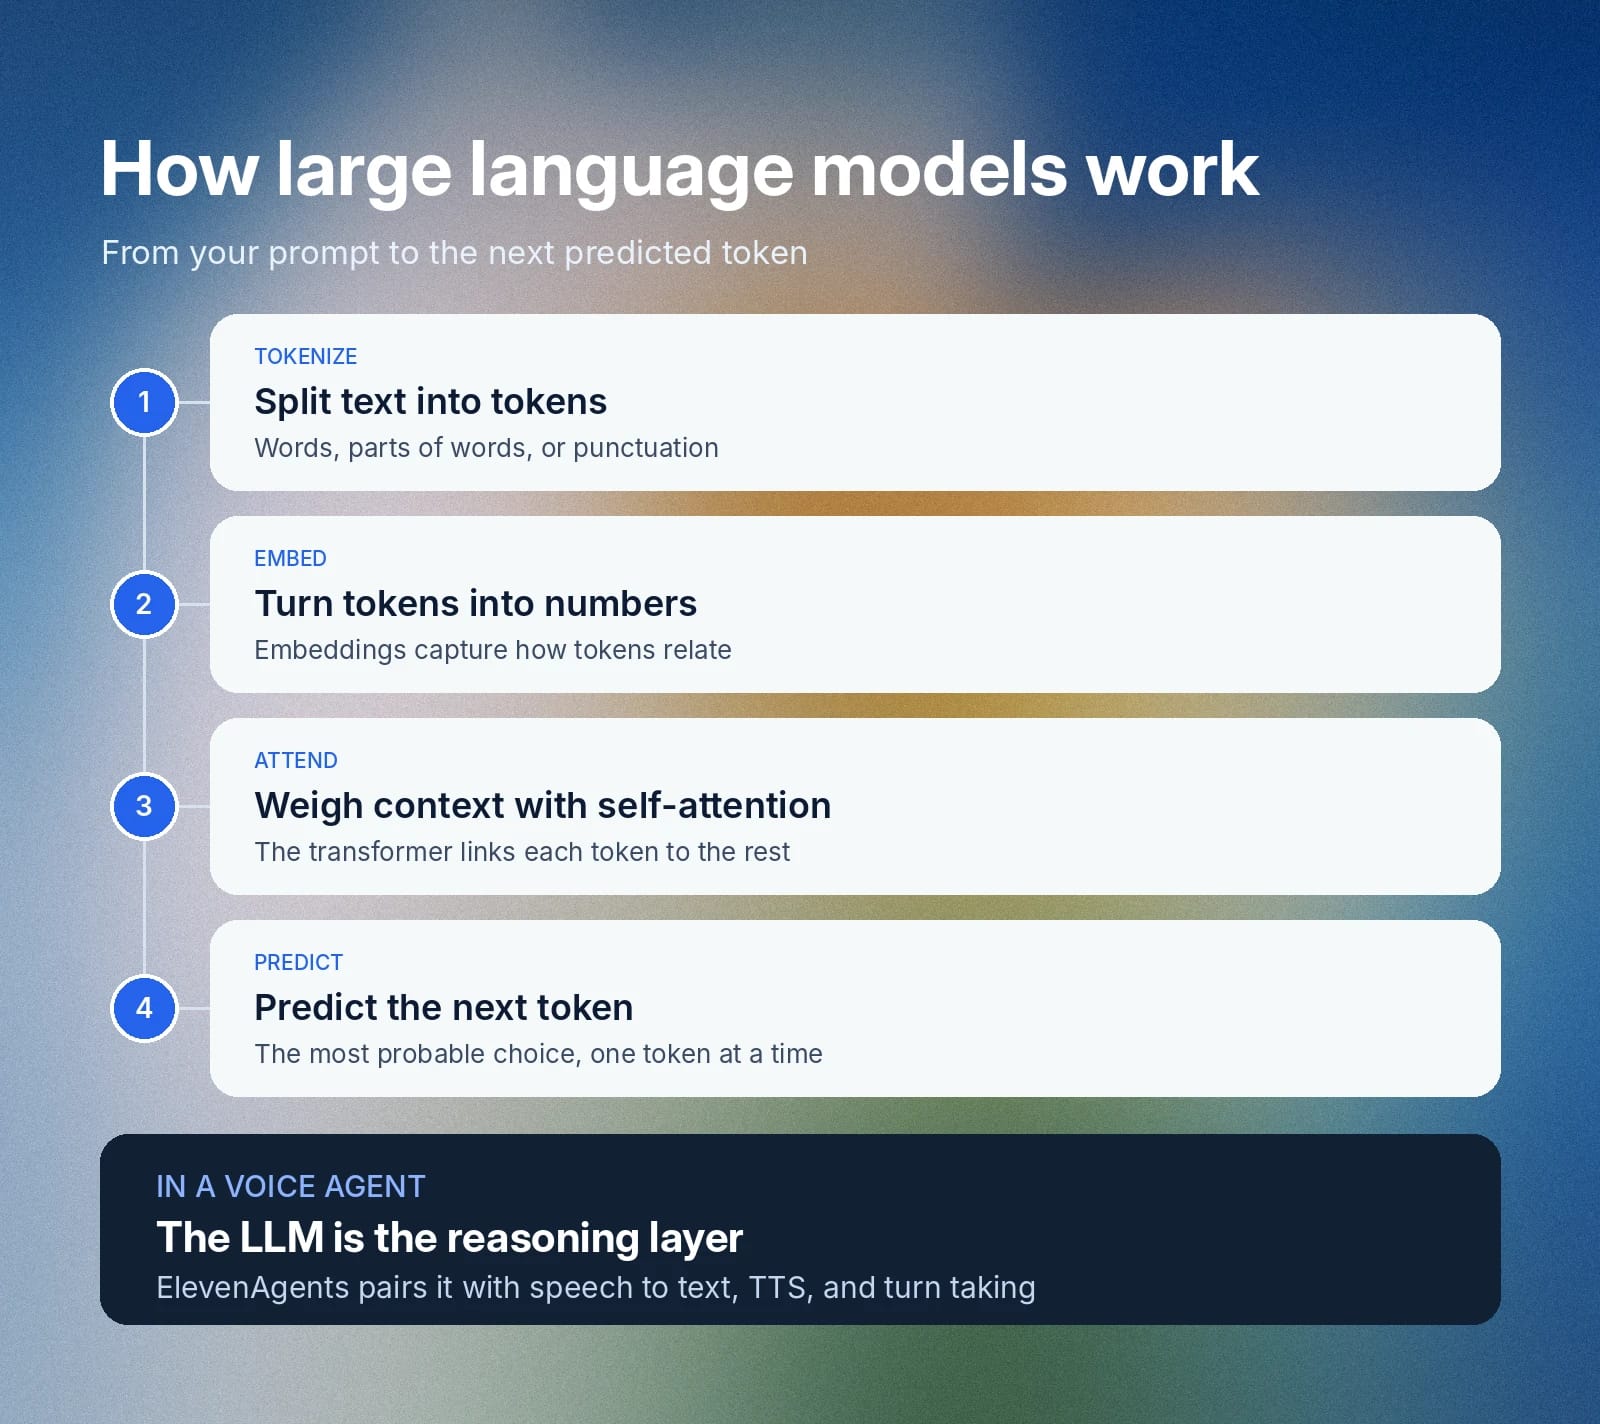
लार्ज लैंग्वेज मॉडल प्राकृतिक भाषा इनपुट का विश्लेषण करने और प्रासंगिक कंटेंट जनरेट करने के लिए आर्टिफिशियल न्यूरल नेटवर्क के माध्यम से टेक्स्ट को प्रोसेस करते हैं। प्रक्रिया टोकनाइज़ेशन से शुरू होती है, जिसमें मॉडल इनपुट टेक्स्ट को टोकन नाम की छोटी इकाइयों में बांटता है। फिर मॉडल इन टोकन को संख्यात्मक निरूपणों (जिन्हें एम्बेडिंग कहा जाता है) में बदलता है, ताकि टोकन के बीच गणितीय या सांख्यिकीय संबंधों का मूल्यांकन किया जा सके।
ज़्यादातर आधुनिक LLM सिस्टम ट्रांसफॉर्मर न्यूरल नेटवर्क आर्किटेक्चर पर निर्भर करते हैं। ट्रांसफॉर्मर सेल्फ-अटेंशन मैकेनिज़्म का इस्तेमाल करते हैं, जो टोकन के बीच संदर्भ संबंधों का मूल्यांकन करते हैं। मॉडल सीखे गए पैटर्न से प्रायिकता वितरण की गणना करके किसी अनुक्रम को पूरा करने वाले सांख्यिकीय रूप से सबसे संभावित टोकन का अनुमान लगाता है।
सेल्फ-अटेंशन प्राकृतिक भाषा प्रोसेसिंग मॉडलों को लंबे संदर्भ बनाए रखने और बातचीत के बीच में होने वाले बदलावों के अनुसार ढलने में सक्षम बनाता है। ElevenAgents के साथ प्लेटफ़ॉर्म इंटीग्रेशन इन क्षमताओं का उपयोग करके कम लेटेंसी वाले, प्रासंगिक जवाब देते हैं जो प्राकृतिक मानवीय बातचीत जैसे लगते हैं।
LLM में टेम्परेचर क्या है?
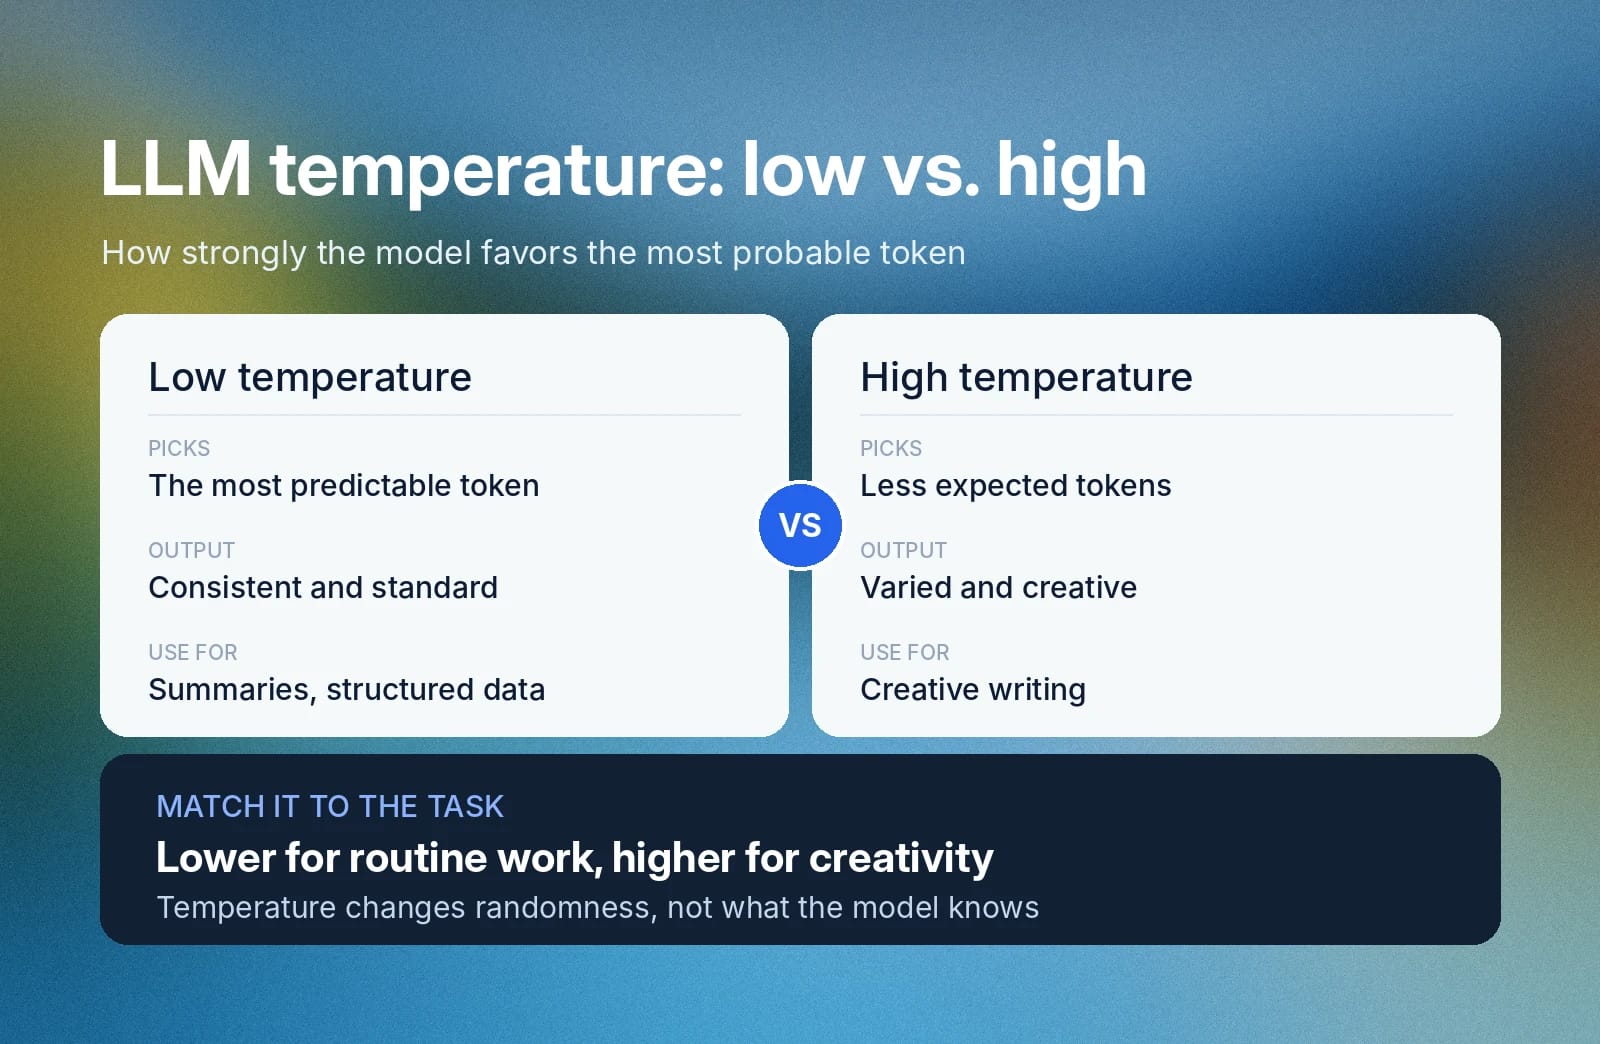
LLM टेम्परेचर एक बदल सकने वाली सेटिंग है, जिसे डेवलपर यह तय करने के लिए कॉन्फ़िगर कर सकते हैं कि LLM के आउटपुट कितने रैंडम होंगे। LLM शब्दों की श्रृंखला में सबसे आम विकल्प चुनकर अगला टोकन जनरेट करते हैं। हालांकि, LLM के हर चयन के लिए समान वेटिंग वाले कई अन्य विकल्प भी हो सकते हैं।
LLM टेम्परेचर को एडजस्ट करके आप बदलते हैं कि LLM सबसे संभावित विकल्प को कितनी प्राथमिकता देता है। कम टेम्परेचर सेटिंग मानक और एकरूप आउटपुट देगी, क्योंकि यह श्रृंखला में हमेशा सबसे अनुमानित अगले टोकन को चुनने की ओर झुकेगी। दूसरी ओर, अधिक टेम्परेचर अपेक्षित विकल्प से अधिक बार हटेगा, जिससे ज़्यादा रचनात्मक और विविध आउटपुट मिलेंगे।
आपको अपने LLM टेम्परेचर का मान उस काम के अनुसार सेट करना चाहिए जो आप करना चाहते हैं। जिन कामों में रचनात्मकता की ज़रूरत हो, उनमें अधिक टेम्परेचर चुनें, जबकि नियमित कामों या संरचित आउटपुट, जैसे डेटा सारांश, के लिए कम टेम्परेचर बेहतर है।
LLM को कैसे प्रशिक्षित और फाइन-ट्यून किया जाता है?
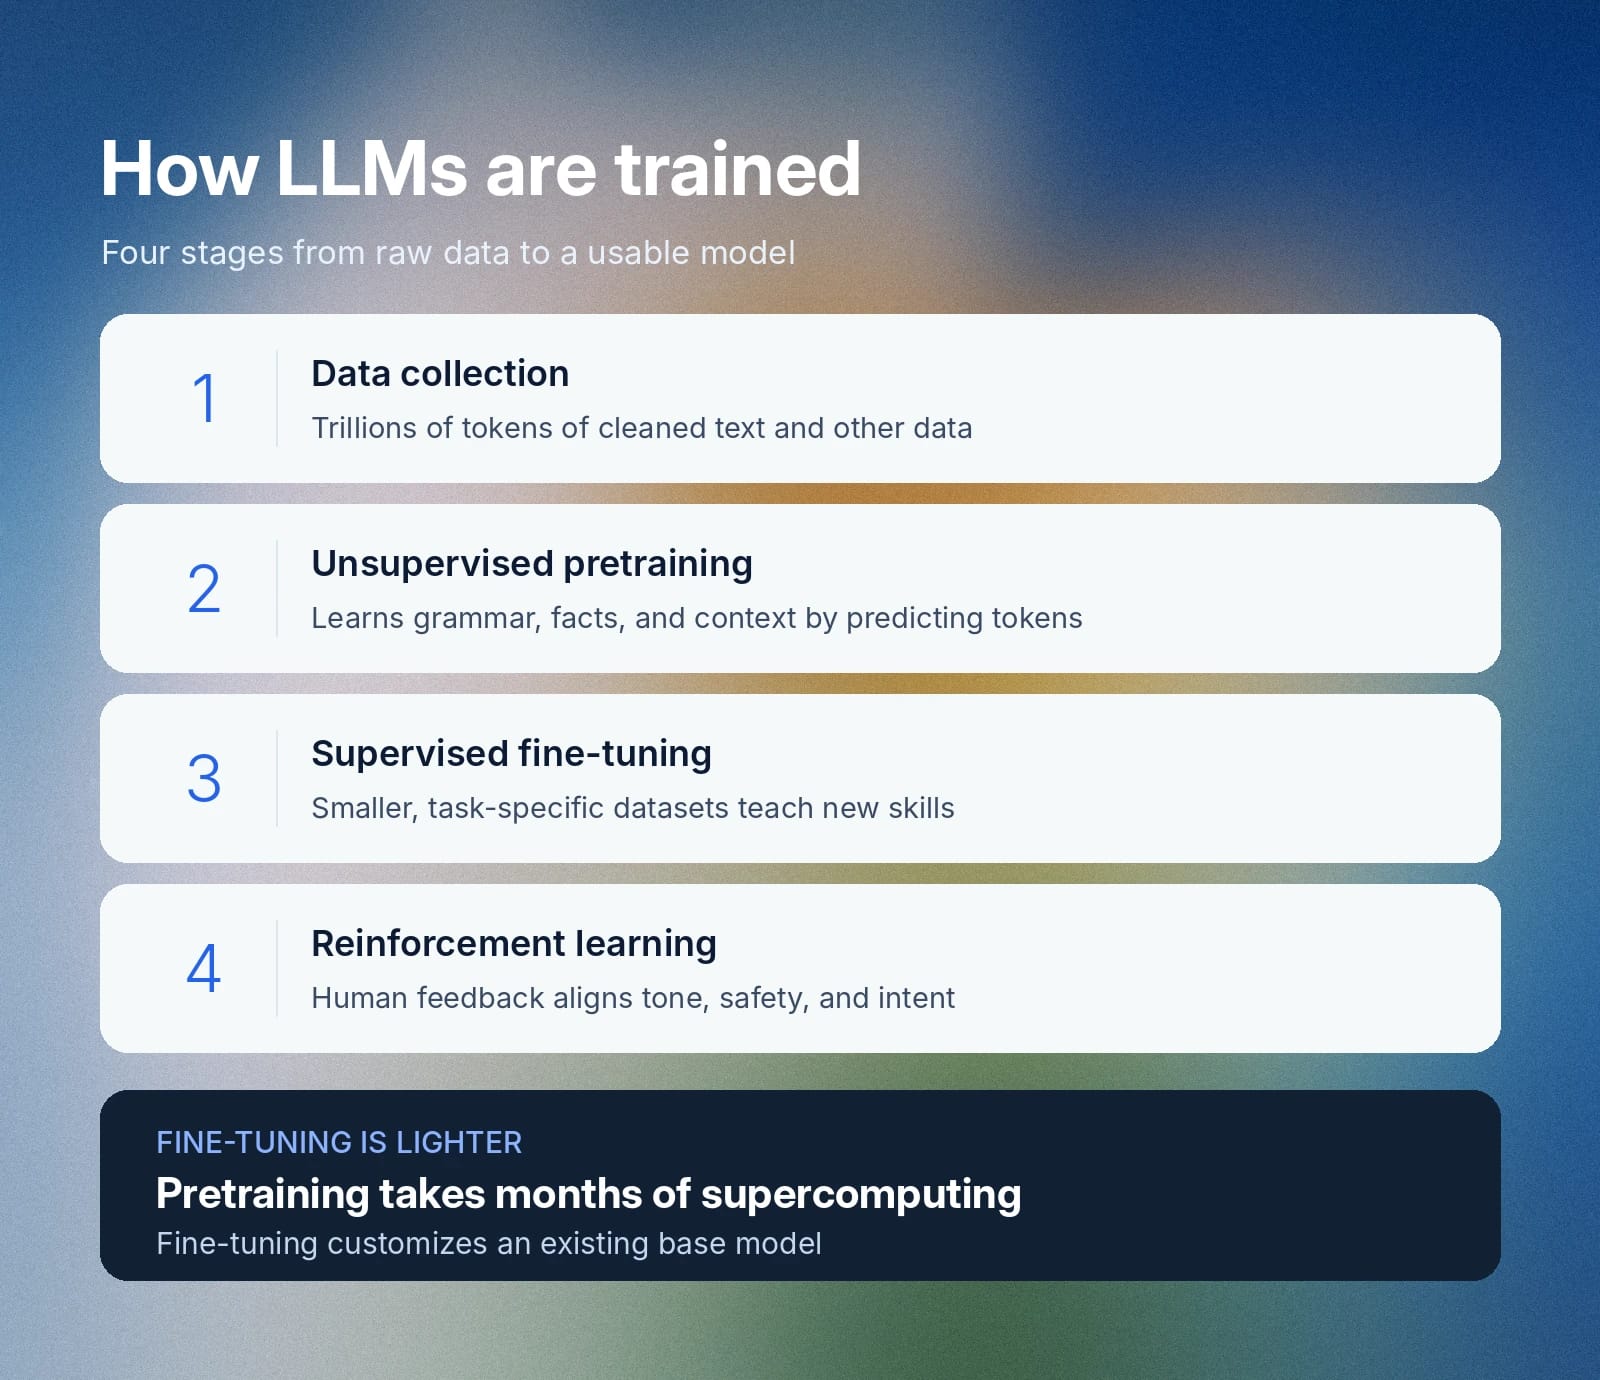
LLM को प्रशिक्षित करने के लिए कच्चे टेक्स्ट और मल्टीमॉडल डेटा को काम करने वाले भाषा सिस्टम में बदलने की बहु-चरणीय प्रक्रिया चाहिए। कंपनियों को कई महीनों तक चलने वाली उन्नत सुपरकंप्यूटिंग क्षमता की आवश्यकता होती है, जबकि फाइन-ट्यूनिंग मौजूदा बेस मॉडल को कस्टमाइज़ करने की अपेक्षाकृत हल्की प्रक्रिया है।
फ्रंटियर AI कंपनियां अपनी सटीक ट्रेनिंग प्रक्रिया को आमतौर पर मालिकाना जानकारी मानती हैं और अधिकांश कंपनियां सोर्स कोड या वेट्स का खुलासा नहीं करतीं। फिर भी, ट्रेनिंग आमतौर पर इस प्रक्रिया का पालन करती है:
- डेटा संग्रह और प्रीप्रोसेसिंग: डेवलपर कई स्रोतों से डेटासेट बनाते हैं, जिनके प्री-ट्रेनिंग कॉर्पस में साफ़ किए गए टेक्स्ट के टेराबाइट्स से लिए गए खरबों टोकन शामिल होते हैं। इंटरनेट स्रोतों से टेक्स्ट स्क्रैप या माइन करना, कंपनियों के लिए ये डेटासेट बनाने का एक मुख्य तरीका है।
- अनसुपरवाइज़्ड प्रीट्रेनिंग: लार्ज लैंग्वेज मॉडल व्याकरण नियमों, तथ्यात्मक संबंधों और भाषाई संदर्भ को सीखने के लिए खरबों टोकन पढ़ता है। यह मूल रूप से सेल्फ-अटेंशन मैकेनिज़्म से संचालित ऑटोरेग्रेसिव लैंग्वेज मॉडलिंग के जरिए खुद को प्रीट्रेन करता है, जो किसी अनुक्रम में सांख्यिकीय रूप से संभावित अगले टोकन की गणना करते हैं।
- सुपरवाइज़्ड फाइन-ट्यूनिंग: इंजीनियर प्रीट्रेंड मॉडल को समायोजित करने के लिए छोटे और ज़्यादा कार्य-विशिष्ट डेटासेट का उपयोग करते हैं। यह चरण मॉडल को सामान्य सवालों के जवाब देने से लेकर लोगो जनरेट करने या लैब रिसर्च करने तक की खास क्षमताएं सिखाता है।
- रिइनफोर्समेंट लर्निंग और अलाइनमेंट: डेवलपर मानव समीक्षकों के फ़ीडबैक और रिवॉर्ड मॉडल का उपयोग करके मॉडल के व्यवहार को बेहतर बनाते हैं। यह चरण मॉडल आउटपुट को सुरक्षा दिशानिर्देशों, टोन आवश्यकताओं और मानव इरादे के अनुरूप करता है।
LLM आर्किटेक्चर के प्रकार: एनकोडर, डिकोडर और हाइब्रिड मॉडल
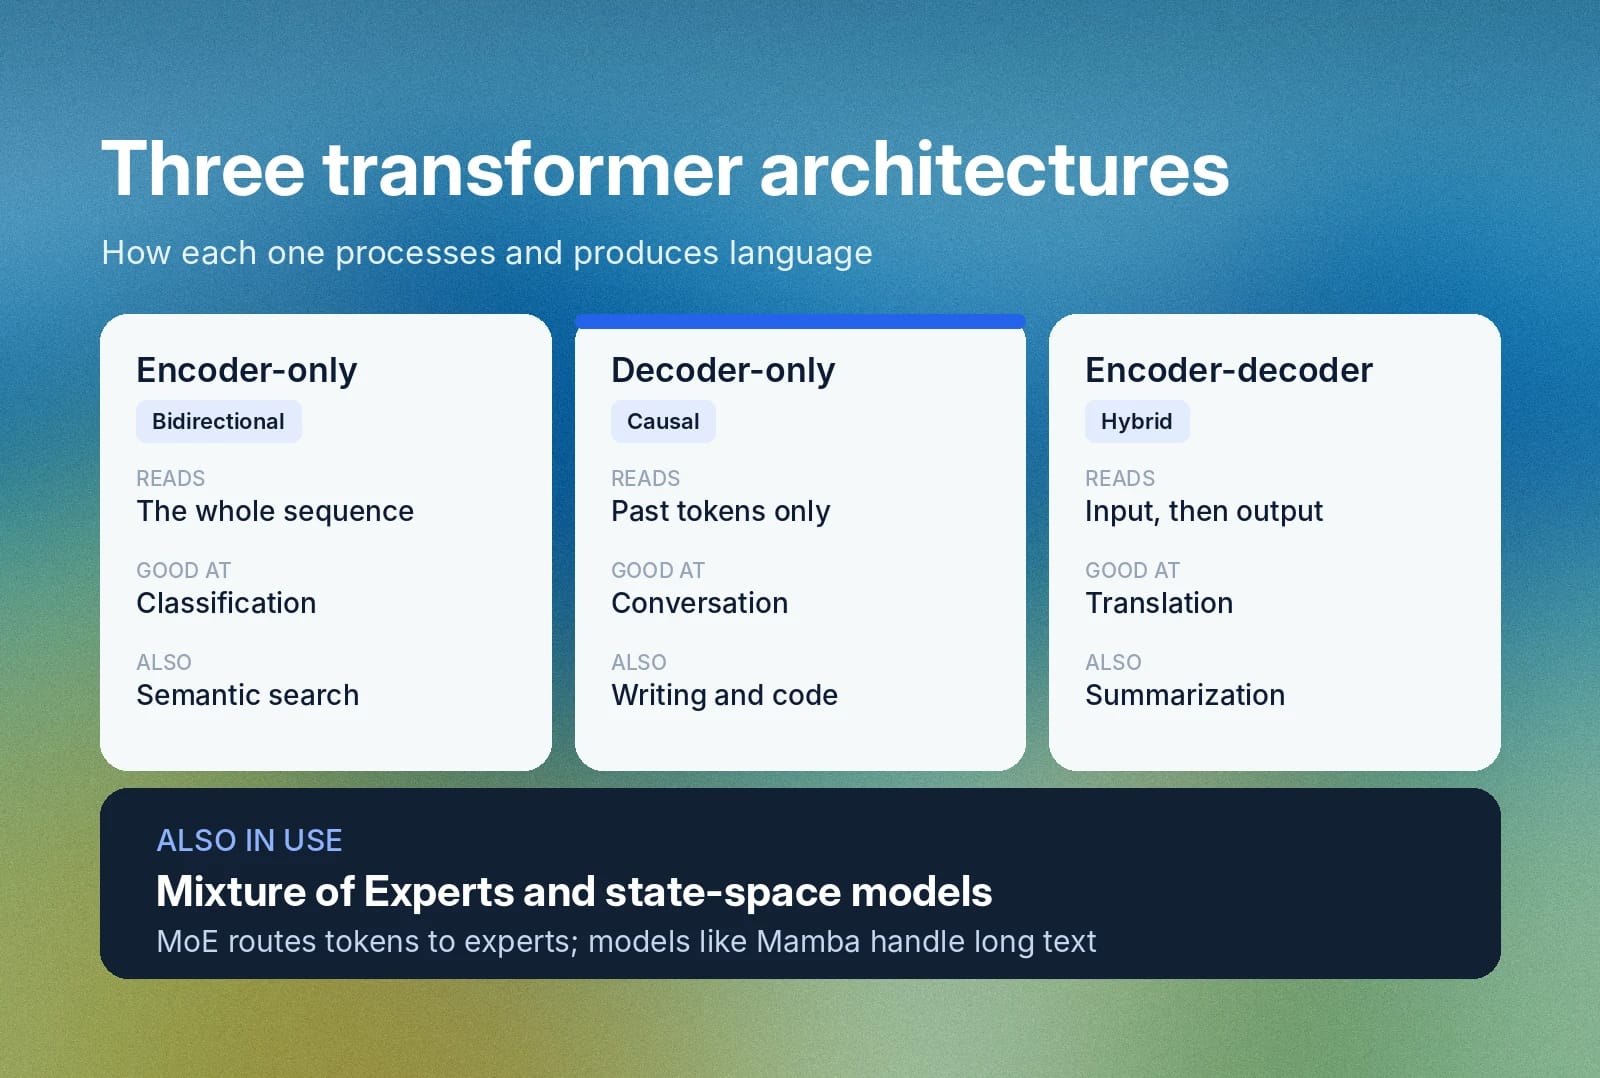
ट्रांसफॉर्मर आर्किटेक्चर इनपुट को प्रोसेस करने और कंटेंट बनाने के लिए न्यूरल नेटवर्क लेयर को अलग-अलग तरीकों से व्यवस्थित करते हैं। क्लासिक ट्रांसफॉर्मर तीन मुख्य श्रेणियों में आते हैं: केवल-एनकोडर, केवल-डिकोडर और एनकोडर-डिकोडर (हाइब्रिड) मॉडल। हालांकि, आधुनिक सिस्टम परफॉर्मेंस को स्केल करने के लिए दक्षता आर्किटेक्चर भी शामिल करते हैं।
केवल-एनकोडर मॉडल
केवल-एनकोडर आर्किटेक्चर बाय-डायरेक्शनल सेल्फ-अटेंशन का उपयोग करके पूरी श्रृंखला को एक साथ प्रोसेस करते हैं। इससे मशीन हर टोकन के संबंध को अन्य पिछले और भविष्य के टोकन के साथ तौल पाती है। व्यवहार में, यह मॉडल को इन कामों के लिए अनुकूलित करता है:
- टेक्स्ट वर्गीकरण
- भाव विश्लेषण
- जानकारी पुनर्प्राप्ति
- सिमैंटिक सर्च
ऐसे काम स्पीच वर्कफ़्लो में भी होते हैं। ElevenLabs का Scribe स्पीच टू टेक्स्ट मॉडल 90 से अधिक भाषाओं में स्पीच ट्रांसक्राइब करता है और इसकी एंटिटी डिटेक्शन सुविधा ट्रांसक्रिप्ट में संवेदनशील जानकारी और आपत्तिजनक भाषा को चिह्नित करती है।
केवल-डिकोडर मॉडल
केवल-डिकोडर आर्किटेक्चर टोकन को प्रोसेस करने के लिए कॉज़ल अटेंशन का उपयोग करते हैं और पिछले टोकन के आधार पर हर शब्द का अनुमान लगाते हैं। ये मॉडल सहज बातचीत जनरेट करते हैं और आधुनिक कन्वर्सेशनल चैटबॉट, ओपन-एंडेड राइटिंग असिस्टेंट और कोड जनरेशन टूल के पीछे मुख्य आर्किटेक्चर हैं।
ElevenAgents में, आपके द्वारा चुना गया LLM, जो आमतौर पर केवल-डिकोडर मॉडल होता है, एजेंट के जवाब जनरेट करता है, जबकि एक मालिकाना टर्न-टेकिंग मॉडल बातचीत का समय संभालता है।
एनकोडर-डिकोडर (हाइब्रिड) मॉडल
एनकोडर-डिकोडर मॉडल इनपुट को प्रोसेस करने के लिए एनकोडर और आउटपुट जनरेट करने के लिए डिकोडर का उपयोग करते हैं। यह दोहरी संरचना वाला तरीका हाइब्रिड मॉडल को उन कामों के लिए बेहतर बनाता है जिनमें संदर्भ को सख्ती से बनाए रखना आवश्यक है, जैसे दस्तावेज़ सारांश, भाषा अनुवाद और डेटा रीफ़ॉर्मेटिंग।
अनुवाद एक क्लासिक एनकोडर-डिकोडर कार्य है और ElevenLabs डबिंग 90 से अधिक भाषाओं को सपोर्ट करता है।
मिक्सचर ऑफ एक्सपर्ट्स (MoE) और स्टेट-स्पेस मॉडल
हर शब्द के लिए हर न्यूरल नेटवर्क पैरामीटर को सक्रिय करने के बजाय, मिक्सचर ऑफ एक्सपर्ट्स (MoE) अलग-अलग टोकन को विशेष “एक्सपर्ट” सब-नेटवर्क की छोटी टीमों तक भेजता है। इससे विशाल मॉडलों जैसी तर्क क्षमता मिलती है, लेकिन तेज़ गति और कम कंप्यूट लागत के साथ। वहीं, स्टेट-स्पेस मॉडल, जैसे Mamba, बेहद लंबे टेक्स्ट को कुशलता से प्रोसेस करते हैं।
ElevenAgents में ओपन-सोर्स LLM शामिल हैं, जिन्हें ElevenLabs हमारे अपने इन्फ्रास्ट्रक्चर पर होस्ट करता है।
लार्ज लैंग्वेज मॉडल के उदाहरण और रोज़मर्रा के उपयोग
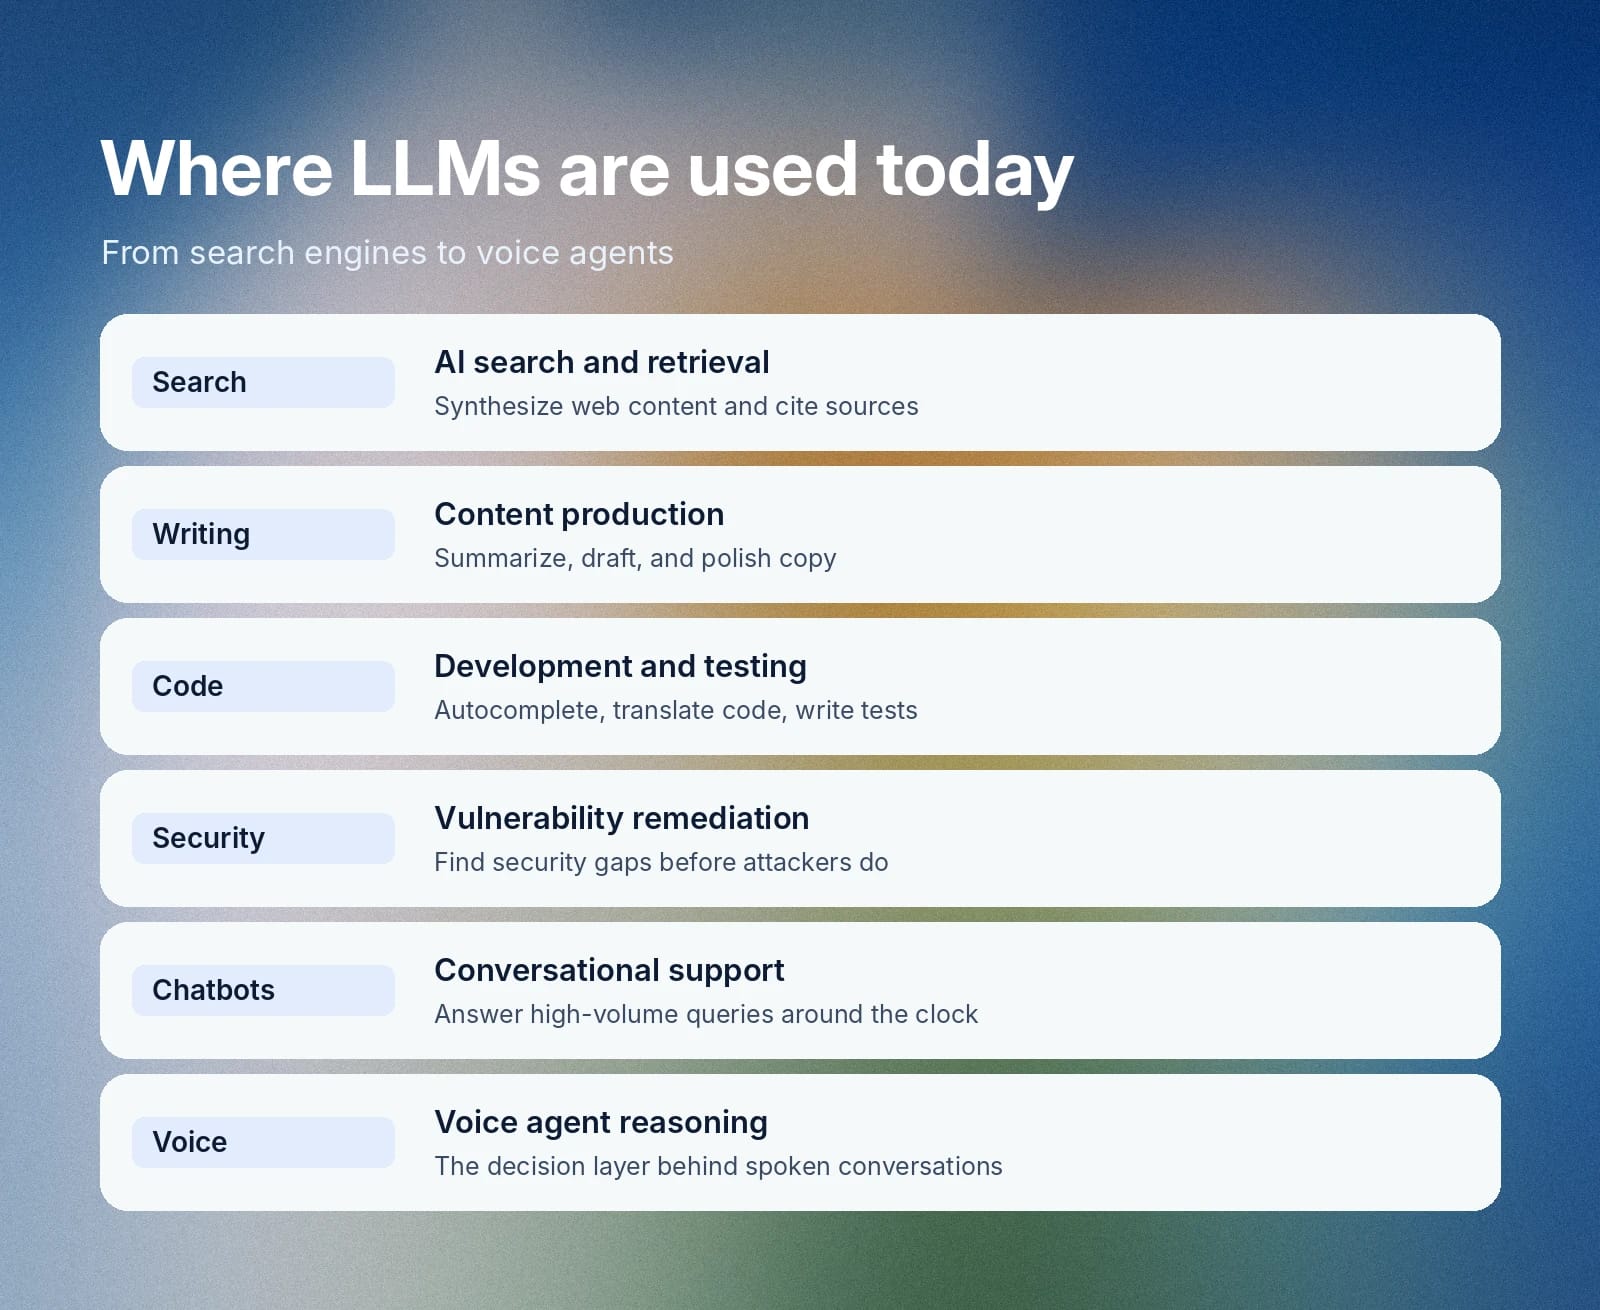
संगठनों ने लार्ज लैंग्वेज मॉडल के लिए कई तरह के उपयोग खोजे हैं। ये उपयोग दिखाते हैं कि AI कैसे प्रयोगात्मक रिसर्च से आगे बढ़कर वेब, सॉफ़्टवेयर ऐप्लिकेशन और रोज़मर्रा के डिवाइस में एक मानक सुविधा बन गया। AI वैज्ञानिक जहां अंतर्निहित आर्किटेक्चर का अध्ययन और अनुकूलन कर रहे हैं, वहीं वास्तविक LLM उदाहरण बताते हैं कि टीमों ने अब तक इन्हें कैसे लागू किया है:
- AI सर्च और जानकारी पुनर्प्राप्ति: Bing, Google AI Overviews और Perplexity जैसे कन्वर्सेशनल सर्च इंजन रियल टाइम में वेब कंटेंट का विश्लेषण करने के लिए LLM का उपयोग करते हैं। मॉडल जानकारी को संश्लेषित करते हैं, स्रोतों का सीधा उल्लेख करते हैं और यूज़र को फ़ॉलो-अप सवाल पूछने देते हैं।
- लेखन, संपादन और कंटेंट प्रोडक्शन: LLM और अन्य AI-संचालित टूल, आंतरिक और बाहरी उपयोग के लिए सामग्री लिखना और संपादित करना आसान बनाते हैं। उदाहरण के लिए, NotebookLM लंबे रिपोर्ट का सारांश बनाता है, Jasper AI विज्ञापन लिखता है और Grammarly कॉपी को बेहतर करता है।
- कोड जनरेशन, डेवलपमेंट और टेस्टिंग: AI, GitHub Copilot जैसे कोडिंग टूल को फ़ंक्शन ऑटोकंप्लीट करने और कोड को एक प्रोग्रामिंग भाषा से दूसरी में बदलने में सक्षम बनाता है। टीमें इसका उपयोग ऑटोमेटेड टेस्ट सूट जनरेट करने के लिए भी कर सकती हैं, ताकि डिप्लॉयमेंट से पहले बग को आसानी से पहचान और ठीक किया जा सके।
- साइबरसुरक्षा और कमज़ोरियों का समाधान: AI फ्रंटियर कंपनियों ने सुरक्षा कमियों का पता लगाने के लिए विशेष मॉडल जारी किए हैं, जिससे संगठन हमलावरों द्वारा उन्हें खोजने और उनका फायदा उठाने से पहले सुधार लागू कर सकते हैं।
- चैटबॉट और कन्वर्सेशनल असिस्टेंट: संगठन 24/7 कस्टमर सपोर्ट देने के लिए कन्वर्सेशनल इंटरफ़ेस तैनात करते हैं। ElevenAgents जैसे प्लेटफ़ॉर्म को इंटीग्रेट करने से कंपनियां FAQ पर निर्भर रहने के बजाय कन्वर्सेशनल समाधानों से बड़ी संख्या में आने वाले सवालों को ऑटोमेट कर सकती हैं।
- वॉइस एजेंट रीजनिंग इंजन: LLM, वॉइस AI सिस्टम के लिए केंद्रीय रीजनिंग लेयर के रूप में भी काम करते हैं। ElevenAgents प्राकृतिक, रियल-टाइम बातचीत के लिए आपके चुने हुए LLM को स्पीच टू टेक्स्ट, कम लेटेंसी वाले टेक्स्ट टू स्पीच और एक मालिकाना टर्न-टेकिंग मॉडल के साथ जोड़ता है।
लार्ज लैंग्वेज मॉडल की सीमाएं क्या हैं?
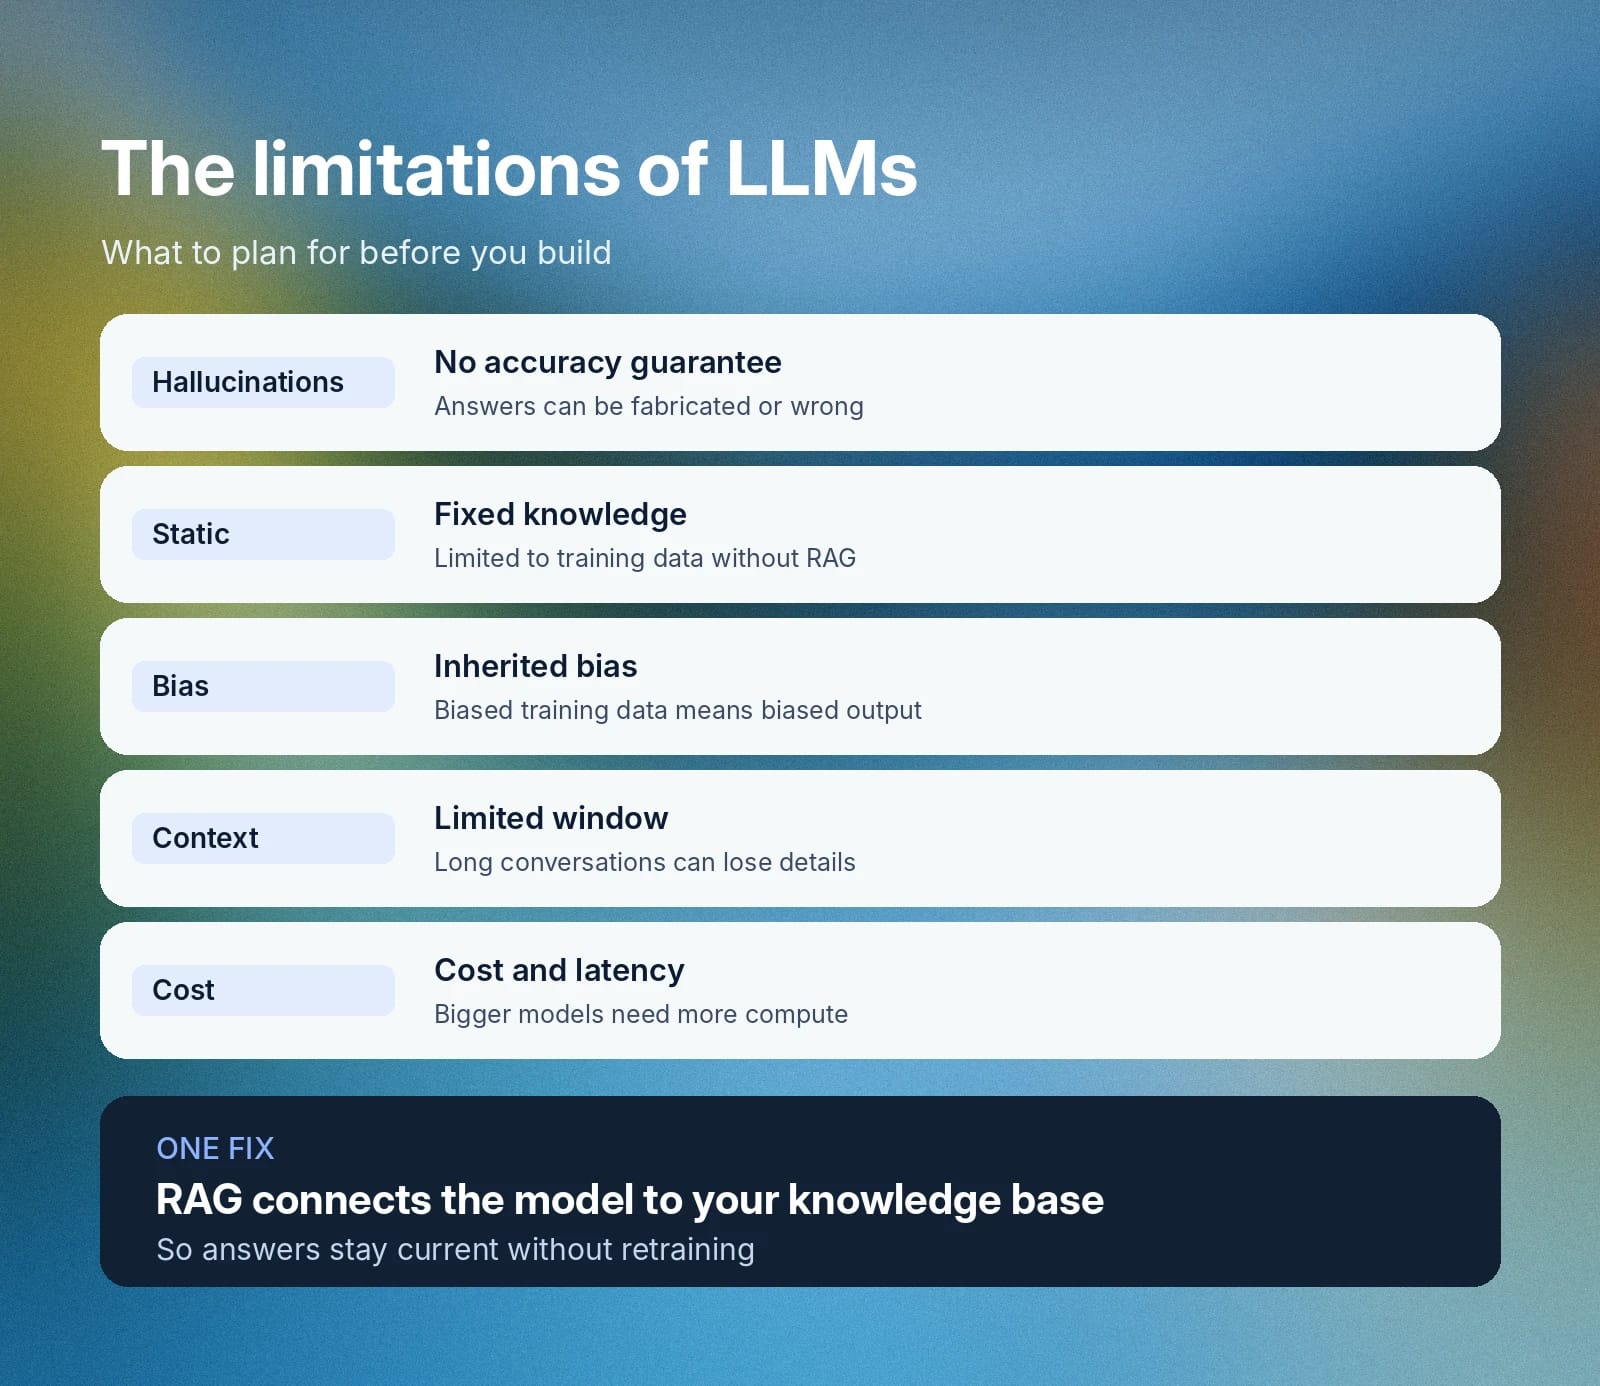
उपभोक्ताओं द्वारा इस्तेमाल किए जाने वाले ज़्यादातर AI प्रोडक्ट की रीढ़ होने के नाते, LLM एक शक्तिशाली आर्किटेक्चर हैं जो कई वर्कफ़्लो और उपयोग मामलों में मदद करते हैं। लेकिन अगर आप LLM के साथ कुछ बनाना चाहते हैं या अपना मॉडल प्रशिक्षित करना चाहते हैं, तो आपको उनकी मुख्य सीमाओं के बारे में पता होना चाहिए:
- हैलुसिनेशन: इस बात की कोई गारंटी नहीं है कि LLM जो जनरेट करता है वह सटीक होगा। किसी जवाब में आसानी से गढ़ी हुई या गलत जानकारी हो सकती है।
- स्थिर ज्ञान: RAG के बिना, LLM ट्रेनिंग प्रक्रिया के दौरान उसे दिए गए पहले से तय ज्ञान के दायरे तक सीमित रहता है।
- पूर्वाग्रह: अगर आपके ट्रेनिंग डेटा में पूर्वाग्रह है, तो आपका मॉडल भी उसे दर्शाएगा। अगर आप डेटा को वर्गीकृत करने या जानकारी के बारे में निर्णय लेने के लिए LLM का उपयोग कर रहे हैं, तो इस पर ध्यान देना खास तौर पर ज़रूरी है, क्योंकि आपके डेटा में मौजूद कुछ अंतर्निहित पूर्वाग्रह आपकी जानकारी के बिना आउटपुट को नकारात्मक रूप से प्रभावित कर सकते हैं।
- सीमित संदर्भ विंडो: LLM आमतौर पर सिर्फ़ एक तय मात्रा के टेक्स्ट के साथ काम करते हैं, जिसका मतलब है कि लंबी बातचीत में समय के साथ विवरण छूटने लग सकते हैं और वह कम प्रभावी हो सकती है।
- लागत और लेटेंसी: LLM जितना बड़ा होगा, उसे चलाने के लिए उतनी अधिक कंप्यूट की ज़रूरत होगी। अगर आप अधिक शक्तिशाली मॉडल चुनते हैं, तो इस बेहतर सेवा के लिए आपको संभवतः अधिक भुगतान करना होगा।
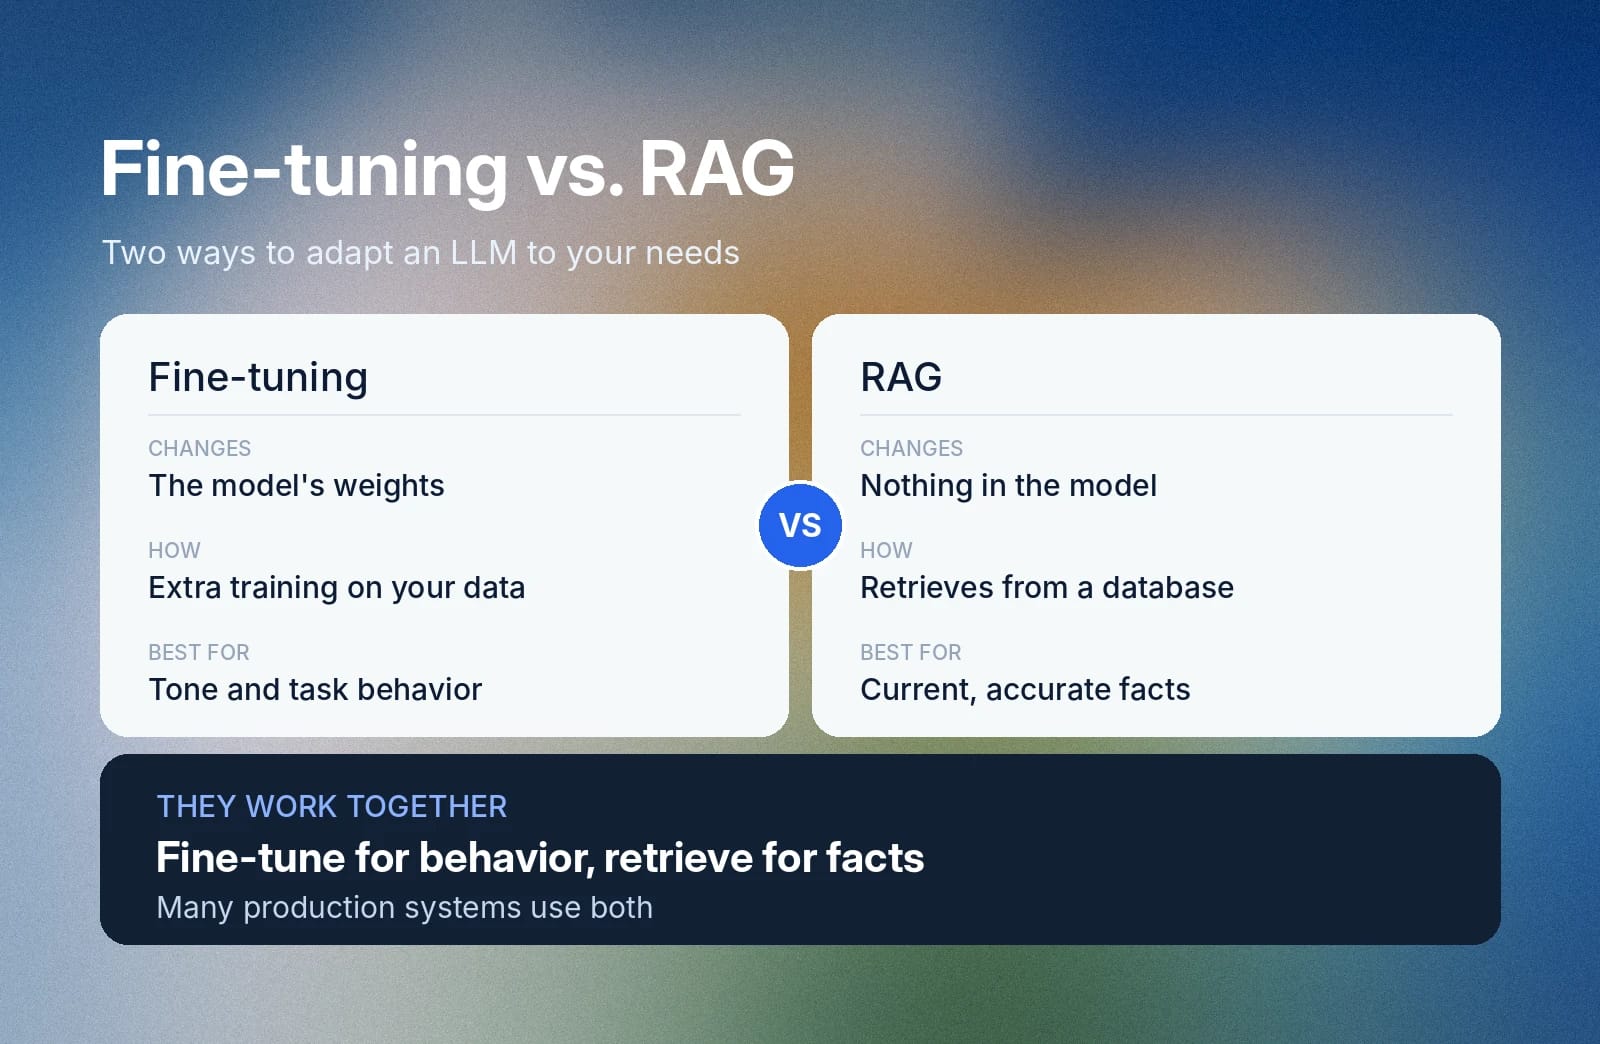
इन सीमाओं के प्रभाव को कम करने के लिए आप कई रणनीतियों पर विचार कर सकते हैं या कई कार्यान्वयन कर सकते हैं। उदाहरण के लिए, LLM में RAG सक्षम करना और लगातार बढ़ता नॉलेज बेस जोड़ना, स्थिर ज्ञान की समस्या को दूर कर सकता है।
ElevenAgents के साथ वॉइस-सक्षम LLM अनुभव बनाएं
अपने उपयोग के मामले के लिए लार्ज लैंग्वेज मॉडल चुनना एक अहम निर्णय है, जिसे आपके बिज़नेस की ज़रूरतों और नियामकीय आवश्यकताओं में बदलाव के साथ समायोजित करना पड़ सकता है। कन्वर्सेशनल वॉइस AI समाधान बनाते समय वेंडर लॉक-इन से बचने से बिज़नेस की फुर्ती और लचीलापन बना रहता है।
ElevenAgents आपको OpenAI, Anthropic और Google समेत प्रदाताओं के सपोर्टेड LLM में से चुनने या OpenAI-संगत एंडपॉइंट के जरिए अपना कस्टम मॉडल कनेक्ट करने देता है। इससे अपनी खास ज़रूरतों के लिए गति, रीजनिंग क्षमता और लागत का सबसे अच्छा संतुलन चुनना आसान हो जाता है।
होस्टेड LLM वॉइस वर्कफ़्लो को कैसे सरल बनाते हैं, यह देखने के लिए ElevenAgents देखें या आज ही अपने कम-लेटेंसी वाले वॉइस एजेंट बनाना शुरू करने के लिए सेल्स टीम से संपर्क करें।
LLM के बारे में अक्सर पूछे जाने वाले सवाल

Jack Limebear हमारी ग्रोथ टीम में हैं और ब्लॉग व इनसाइट्स पेज के लिए कंटेंट राइटर और स्ट्रैटेजिस्ट के तौर पर काम करते हैं। ElevenLabs से पहले, उन्होंने दस साल से ज़्यादा समय तक तेज़ी से बढ़ती SaaS स्टार्टअप्स से लेकर Fortune 500 कंपनियों तक के लिए कंटेंट स्ट्रैटेजी लीड की है। उनके पास यूनिवर्सिटी ऑफ़ कैम्ब्रिज से इंग्लिश लिटरेचर में मास्टर डिग्री है।


