
ElevenLabs और Twilio के साथ 20 मिनट में वॉइस एजेंट बनाएं
- प्रकाशित
- आखिरी बार अपडेट किया गया
सुनेंइस आर्टिकल को सुनें
वॉइस एजेंट इनकमिंग फ़ोन कॉल का जवाब दे सकता है, कॉलर की आवाज़ को रीयल टाइम में स्पीच टू टेक्स्ट (STT) से ट्रांसक्राइब कर सकता है, लार्ज लैंग्वेज मॉडल (LLM) से जवाब बना सकता है और टेक्स्ट टू स्पीच (TTS) मॉड्यूल से बोलकर जवाब दे सकता है। ElevenLabs और Twilio के साथ, आप लगभग 20 मिनट में किसी असली फ़ोन नंबर पर काम करने वाला एजेंट तैयार कर सकते हैं।
डेवलपर के तौर पर, आपके स्टैक में स्पीच सिंथेसिस (Flash v2.5) और ट्रांसक्रिप्शन (Scribe v2 Realtime) के लिए ElevenLabs, टेलीफोनी के लिए Twilio और LLM के तौर पर OpenAI या Anthropic होगा। हालांकि, इन सभी को बदला जा सकता है, इसलिए आप अपने परिचित कॉम्पोनेंट चुनकर उनकी जगह इस्तेमाल कर सकते हैं।
यह लेख Node.js और Typescript का उपयोग करके 20 मिनट में वॉइस एजेंट बनाना दिखाता है। अगर आप ऐसा मैनेज्ड विकल्प चाहते हैं जो खुद कैस्केड संभाले बिना टर्न-टेकिंग, इंटरप्शन और टेलीफोनी संभालता हो, तो ElevenAgents.
वॉइस एजेंट आर्किटेक्चर कैसे काम करता है
कोड लिखने से पहले, यह समझना मददगार होता है कि आपके टेक स्टैक की तीनों सेवाएं कैसे जुड़ती हैं।
- Twilio: फ़ोन कॉल और ऑडियो ट्रांसपोर्ट संभालता है।
- ElevenLabs: Scribe v2 Realtime के ज़रिए STT और Flash v2.5 के ज़रिए TTS संभालता है।
- LLM: टूल कॉलिंग और जवाब लिखना संभालता है।
हर चरण एक हल्का अडैप्टर है, इसलिए बाकी को छुए बिना आप एक सेवा को दूसरी से बदल सकते हैं। उदाहरण के लिए, आप अपने दूसरे कॉम्पोनेंट दोबारा लिखे बिना OpenAI LLM को Anthropic से बदल सकते हैं।
फ़ोन कॉल Twilio के ज़रिए आपके सर्वर तक पहुंचती है। Twilio PSTN कॉल का जवाब देता है, आपके सर्वर तक वापस एक WebSocket खोलता है और कॉलर का ऑडियो base64-एन्कोडेड mu-law फ़्रेम की स्ट्रीम के रूप में भेजता है। आपका सर्वर कैस्केड चलाता है और उसी WebSocket से सिंथेसाइज़ किया गया ऑडियो वापस स्ट्रीम करता है, जिसे Twilio कॉलर को सुनाता है।
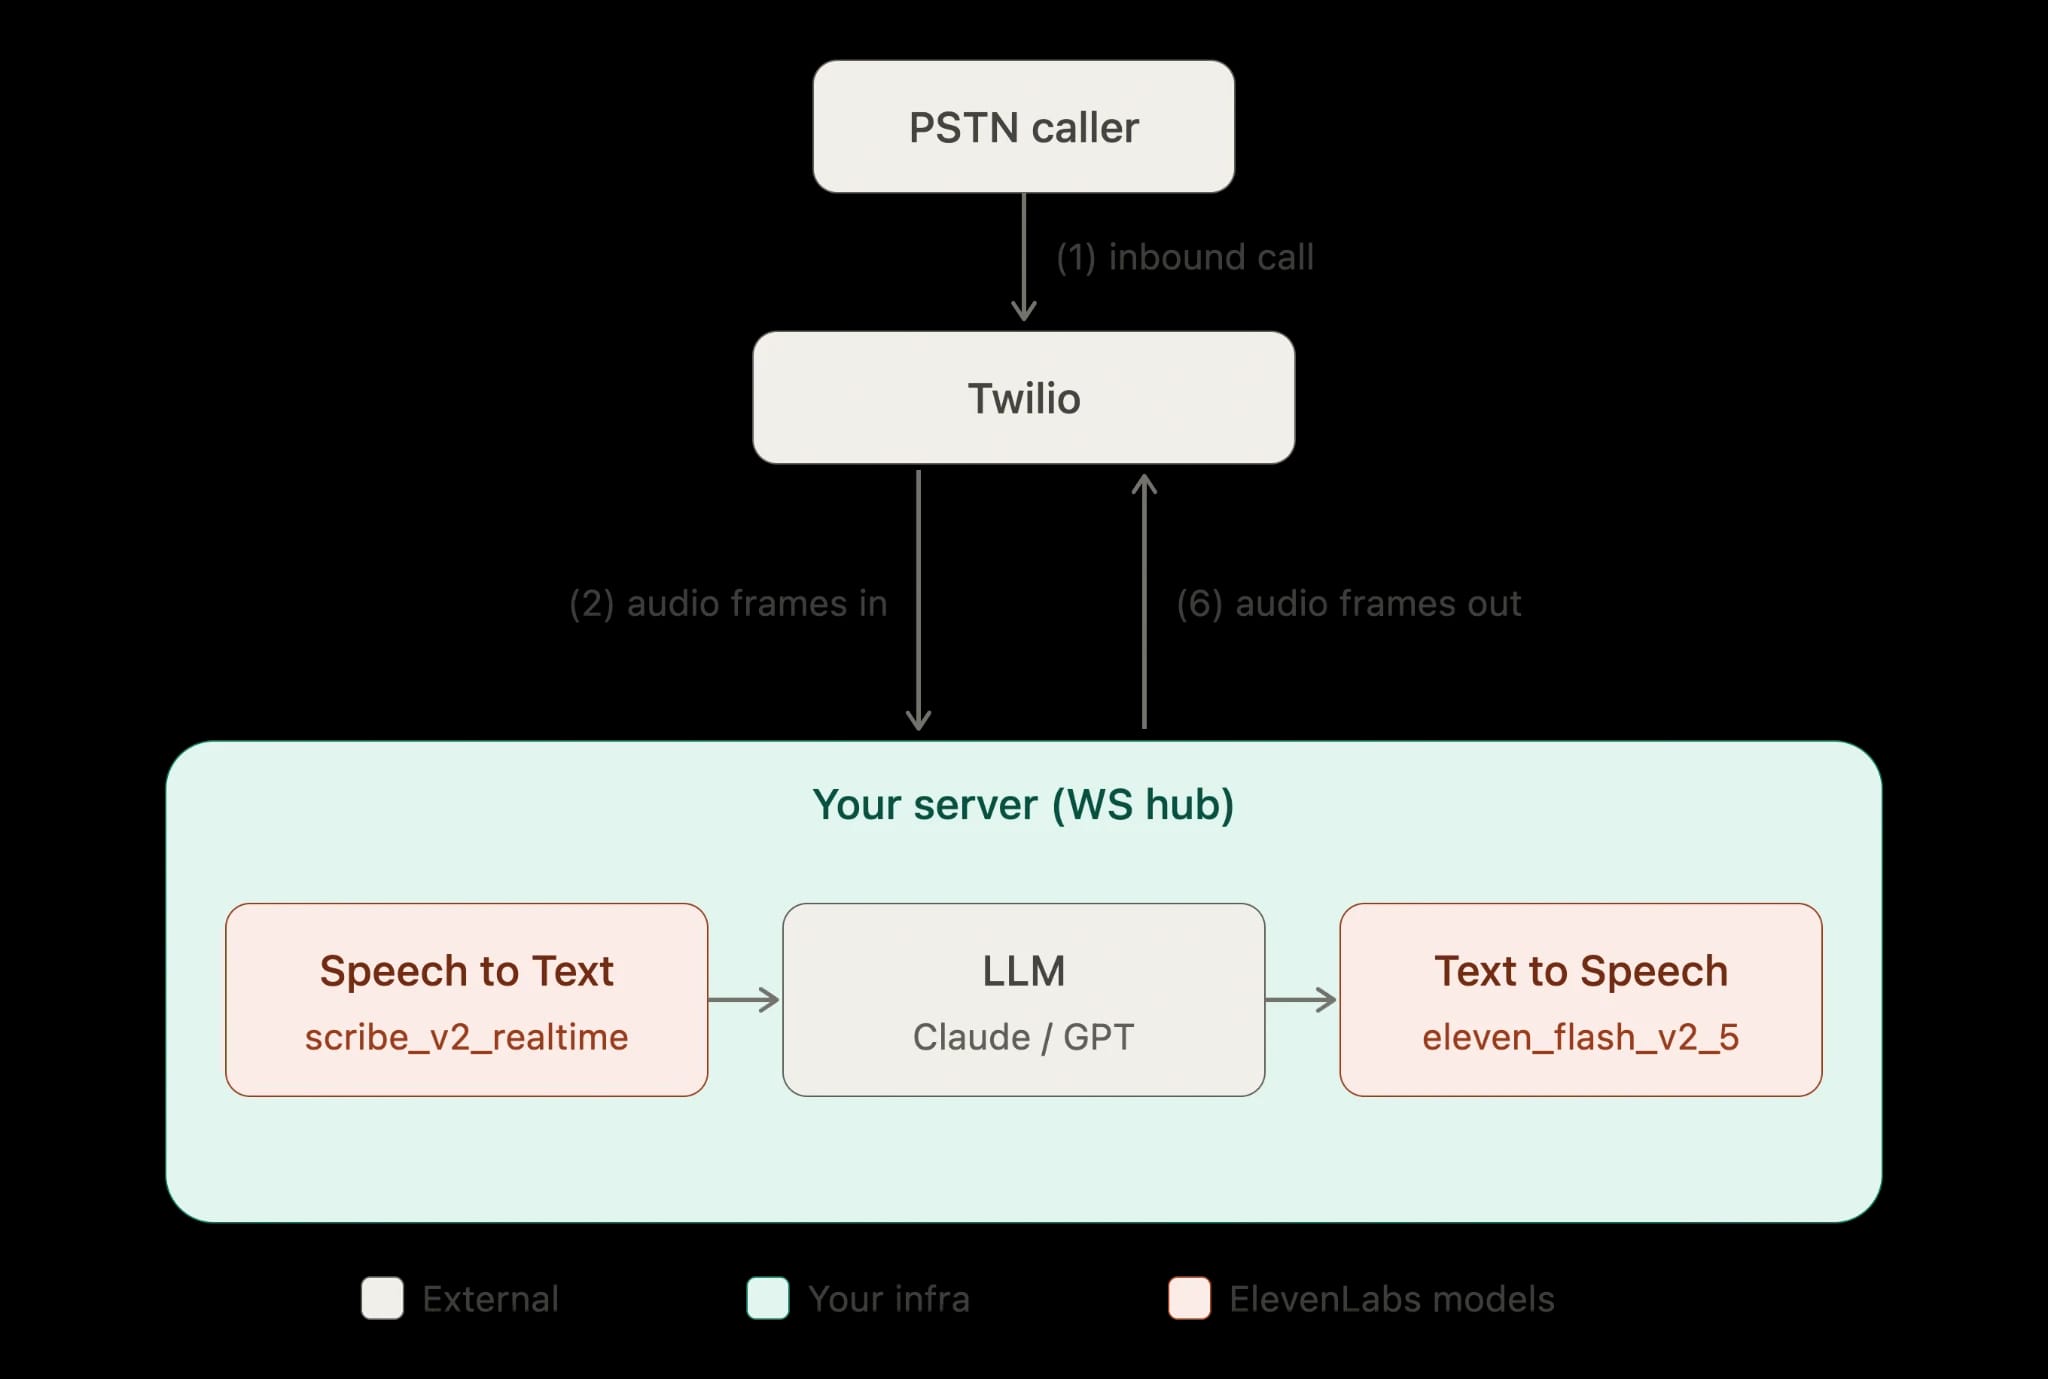
वॉइस एजेंट बनाने के लिए आप यह फ़्लो इस्तेमाल करेंगे:
कॉलर आपके Twilio नंबर पर डायल करता है। Twilio आपके वेबहुक से TwiML डॉक्यूमेंट फ़ेच करता है। TwiML, Twilio को आपके WebSocket एंडपॉइंट के लिए Media Stream खोलने का निर्देश देता है। Twilio, base64 mu-law (ulaw_8000) पेलोड वाले JSON इवेंट के रूप में इनकमिंग ऑडियो स्ट्रीम करता है।
आपका सर्वर ऑडियो चंक्स को स्ट्रीमिंग ट्रांसक्रिप्शन के लिए Scribe v2 Realtime को भेजता है। कॉलर का टर्न पूरा होने पर, आप ट्रांसक्रिप्ट LLM को भेजते हैं और फिर जवाब को Flash v2.5 से ulaw_8000 में सिंथेसाइज़ करते हैं। आप सिंथेसाइज़ किए गए mu-law फ़्रेम को base64-एन्कोड करके WebSocket पर वापस Twilio को भेजते हैं, और Twilio उन्हें कॉलर को सुनाता है।
Scribe v2 Realtime लगभग 150ms की लेटेंसी पर आंशिक ट्रांसक्रिप्शन भेजता है और Flash v2.5 नेटवर्क व ऐप्लिकेशन लेटेंसी को छोड़कर लगभग 75ms में मॉडल इन्फ़रेंस करता है। ऑडियो शुरू होने तक के समय में LLM का योगदान सबसे बड़ा और सबसे कम अनुमानित होता है, और अधिकांश लेटेंसी बजट यहीं खर्च होता है। इस अंतर को कम रखने के लिए, हम LLM आउटपुट को टोकन-दर-टोकन स्ट्रीम करते हैं और मॉडल के वाक्य पूरा करने से पहले ही सिंथेसिस शुरू कर देते हैं।
इन विकल्पों के पीछे मॉडल के ट्रेड-ऑफ़ समझने के लिए मॉडल्स ओवरव्यू और लेटेंसी को समझना देखें।
वॉइस एजेंट बनाना शुरू करने से पहले आपको क्या चाहिए
यह गाइड मानती है कि आपके पास चार चीज़ें तैयार हैं। हर एक को सेट अप करना जल्दी है, लेकिन इनमें से कोई भी न होने पर सर्वर नहीं चलेगा।
इन ज़रूरी चीज़ों की जांच करें:
- Voice क्षमता वाला Twilio फ़ोन नंबर: Twilio कंसोल से नंबर के साथ अपना Account SID और Auth Token नोट कर लें।
- ElevenLabs API key: इसे अपने ElevenLabs डैशबोर्ड में बनाएं। यह key xi-api-key हेडर में जाती है और गोपनीय है, इसलिए इसे सिर्फ़ सर्वर-साइड रखें। API ऑथेंटिकेशन देखें।
- LLM API key: यह ट्यूटोरियल Anthropic Claude और OpenAI को एक-दूसरे की जगह इस्तेमाल किए जा सकने वाले बैकएंड मानता है, इसलिए कोई एक चुनें।
- लोकल डेवलपमेंट के लिए Ngrok (या कोई भी टनल): Twilio को सार्वजनिक HTTPS और WSS URL के ज़रिए आपके सर्वर तक पहुंचना होता है, और ngrok बिना कुछ डिप्लॉय किए यह सुविधा देता है।
अपने सीक्रेट्स को एनवायरनमेंट वेरिएबल के रूप में सेट करें और उन्हें कभी कमिट न करें।
फिर उस पोर्ट पर पॉइंट करती टनल शुरू करें जिसे आपका सर्वर इस्तेमाल करेगा:
Twilio Media Streams प्रोटोकॉल को समझना
Twilio आपको रॉ ऑडियो सॉकेट नहीं देता। इसके बजाय, यह WebSocket पर एक स्ट्रक्चर्ड JSON प्रोटोकॉल में सब कुछ रैप करता है। चार इवेंट टाइप और सेंड फ़ॉर्मैट समझने पर, उसे लिखने से पहले ही चरण 2 का WebSocket हैंडलर पूरी तरह समझ आ जाएगा।
Twilio के आपके WebSocket से जुड़ने के बाद, यह JSON टेक्स्ट मैसेज की एक श्रृंखला भेजता है, जिनके चार इवेंट टाइप हो सकते हैं।
connected इवेंट सबसे पहले आता है और पुष्टि करता है कि WebSocket चालू है। media stream शुरू होने पर start इवेंट एक बार भेजा जाता है; इसमें streamSid होता है जिसे आपको स्टोर करना होता है, क्योंकि ऑडियो वापस भेजने के लिए इसकी ज़रूरत पड़ती है। इसमें start.customParameters और start.callSid के अंतर्गत कॉल मेटाडेटा भी होता है।
media इवेंट बार-बार आता है: media.payload, 8kHz mu-law ऑडियो का base64-एन्कोडेड चंक होता है, हर फ़्रेम 20ms का होता है और कॉलर ऑडियो के लिए media.track inbound होता है। अंत में, stream समाप्त होने पर stop भेजा जाता है, आमतौर पर कॉल कटने की वजह से।
ऑडियो वापस चलाने के लिए, आप उसी streamSid और base64 mu-law पेलोड के साथ media टाइप का मैसेज भेजते हैं। पहले से कतार में लगे ऑडियो को रोकने के लिए, आप streamSid के साथ clear मैसेज भेजते हैं, जो Twilio का आउटबाउंड बफ़र खाली कर देता है।
इनबाउंड और आउटबाउंड एन्कोडिंग एक जैसी हैं (ulaw_8000)। हम ElevenLabs टेक्स्ट टू स्पीच से ulaw_8000 मांगते हैं और बीच में दोबारा सैंपल किए बिना बाइट्स सीधे Twilio को भेज देते हैं।
चरण 1: TwiML वेबहुक सर्व करें
कॉल आने पर, Twilio आपके वेबहुक को HTTP अनुरोध भेजता है और आप कॉल को अपनी Media Stream से जोड़ने वाले TwiML से जवाब देते हैं। <Connect><Stream> वर्ब एक द्विदिश WebSocket खोलता है। यहां <Start> की बजाय <Connect> इस्तेमाल करें: यह स्ट्रीम की अवधि तक कॉल को चालू रखता है और आपको ऑडियो वापस भेजने देता है, जो इस सेटअप का उद्देश्य है।
वेबहुक यह TwiML लौटाता है:
Express में, यह एक सिंगल POST हैंडलर है जो होस्ट भरता है और डॉक्यूमेंट लौटाता है:
Twilio कंसोल में, नंबर का "A call comes in" वेबहुक https://your-subdomain.ngrok.app/incoming-call पर HTTP POST से सेट करें।
चरण 2: Media Stream WebSocket स्वीकार करें
WebSocket हैंडलर Twilio इवेंट पढ़ता है, कैस्केड चलाता है और ऑडियो वापस लिखता है।
हम हर कॉल के लिए थोड़ी-सी स्टेट रखते हैं: streamSid, एक STT कनेक्शन और एजेंट के इस समय बोलने का फ़्लैग। हैंडलर हर इनबाउंड मीडिया फ़्रेम को base64 से डिकोड करता है और रॉ mu-law बाइट्स को STT तक भेजता है:
चरण 3: Scribe v2 Realtime से ट्रांसक्राइब करें
Scribe v2 Realtime स्ट्रीमिंग ऑडियो चंक्स स्वीकार करता है और आंशिक व अंतिम ट्रांसक्रिप्शन लौटाता है। यह सीधे mu-law एन्कोडिंग सपोर्ट करता है, इसलिए हम इसे Twilio के फ़्रेम बिना बदले देते हैं।
यह वॉइस एक्टिविटी डिटेक्शन भी देता है, जिससे साइलेंस-आधारित सेगमेंटेशन और सेगमेंट पूरा करने के लिए मैन्युअल कमिट कंट्रोल मिलता है। फ़ोन एजेंट के लिए VAD-आधारित सेगमेंटेशन आमतौर पर सही विकल्प है, क्योंकि स्वाभाविक विराम सबसे भरोसेमंद संकेत है कि कॉलर का टर्न समाप्त हो गया है।
ये चरण हैं: कॉल शुरू होने पर STT स्ट्रीम खोलें। हर इनबाउंड mu-law चंक पुश करें। अंतिम ट्रांसक्रिप्ट मिलने पर LLM को कॉल करें।
रीयलटाइम STT क्लाइंट इंटरफ़ेस अभी विकसित हो रहा है, इसलिए नीचे के स्वरूप को छोटे TypeScript अडैप्टर (openRealtimeStt) के पीछे रखा गया है। इसे फ़ील्ड नामों के स्थिर सेट के बजाय लाइव API के अनुसार लागू करें। onFinal को उस हुक की तरह मानें जो कॉलर के पूरे टर्न को अगले चरण तक पहुंचाता है।
आंशिक नतीजों के लिए रीयलटाइम रिकग्निशन लेटेंसी लगभग 150ms है, जिससे कॉलर के खत्म करने और एजेंट के शुरू होने के बीच का महसूस होने वाला अंतर कम रहता है। बैच विकल्प और पूरी सुविधा सूची के लिए स्पीच टू टेक्स्ट दस्तावेज़ और रीयलटाइम स्पीच टू टेक्स्ट प्रोडक्ट पेज देखें।
चरण 4: LLM से जवाब जनरेट करें
यह चरण जवाब तैयार करता है। LLM बातचीत का इतिहास लेता है और असिस्टेंट का टेक्स्ट लौटाता है। जवाब को स्ट्रीम करें, ताकि आप पहले वाक्य पर ही सिंथेसिस शुरू कर सकें।
यहां इसके लिए OpenAI इस्तेमाल किया गया है:
ऊपर दिया मॉडल ID, gpt-4.1-mini, कम लेटेंसी वाले विकल्प का एक उदाहरण है; Anthropic की ओर से claude-haiku-4-5 एक तुलनीय विकल्प है। दोनों में से कोई भी प्रोवाइडर उसी llmReply कॉन्ट्रैक्ट के साथ काम कर सकता है; फ़ंक्शन का बॉडी बदलें और बाकी एजेंट वैसा ही रहेगा।
सिस्टम प्रॉम्प्ट जवाब की लंबाई सीमित करता है, जो फ़ोन पर अहम है: लंबे जवाब धीमे लगते हैं और उन्हें स्वाभाविक रूप से बीच में रोकना मुश्किल होता है।
चरण 5: ulaw_8000 में Flash TTS से सिंथेसाइज़ करें
अब टेक्स्ट को ऐसे ऑडियो में बदलना है जिसे Twilio चला सके। outputFormat: "ulaw_8000" के साथ Flash v2.5 का अनुरोध करें, ताकि बाइट्स Twilio की अपेक्षित एन्कोडिंग से मेल खाएं। फिर ऑडियो स्ट्रीम करें और हर चंक को media इवेंट के रूप में WebSocket पर वापस भेजें।
LLM टोकन को वाक्य-आकार के टुकड़ों में इकट्ठा करें और हर टुकड़ा पूरा होते ही सिंथेसाइज़ करें, पूरे जवाब का इंतज़ार न करें। इससे पहला ऑडियो आने का समय घटता है, क्योंकि मॉडल दूसरा वाक्य बना रहा होता है, तब तक कॉलर पहला वाक्य सुन लेता है। इंक्रीमेंटल सिंथेसिस पर बेहतर नियंत्रण के लिए, रीयलटाइम TTS WebSocket गाइड दिखाती है कि एक खुले सिंथेसिस सॉकेट में टेक्स्ट कैसे भेजें; नीचे दिया HTTP स्ट्रीमिंग तरीका आसान है और छोटे बातचीत वाले टर्न के लिए पर्याप्त है।
अपने AI वॉइस एजेंट को प्रोडक्शन के लिए मज़बूत बनाएं
ऊपर दिए पांच चरणों के बाद, आपके पास काम करने वाला एजेंट है। यह प्रोडक्शन डिप्लॉयमेंट के बराबर नहीं है।
एजेंट को असली फ़ोन लाइन पर लगाने से पहले, कई बातों का ध्यान रखना ज़रूरी है।
Twilio वेबहुक सिग्नेचर वैलिडेट करें
जिसे भी आपका वेबहुक URL पता हो, वह उस पर POST कर सकता है, इसलिए सबसे पहला काम यह पुष्टि करना है कि अनुरोध वास्तव में Twilio से आया है। Twilio हर अनुरोध पर X-Twilio-Signature हेडर में आपके Auth Token से साइन करता है और वैलिडेशन में विफल किसी भी अनुरोध को आपको अस्वीकार करना चाहिए। सिग्नेचर पूरे URL और POST पैरामीटर से कैलकुलेट होता है, इसलिए आपको भी इसे Twilio की तरह ही कैलकुलेट करना होगा।
Twilio का हेल्पर आपके लिए यह करता है:
सीक्रेट्स को सही तरीके से मैनेज करें
ELEVENLABS_API_KEY, LLM key और TWILIO_AUTH_TOKEN को secrets manager में रखें, सोर्स में या रेपो में कमिट की गई प्लेनटेक्स्ट env फ़ाइलों में नहीं। ElevenLabs key को केवल इस सेवा के लिए ज़रूरी एंडपॉइंट तक सीमित रखें और उसे क्रेडिट कोटा दें, ताकि लीक होने पर नुकसान सीमित रहे।
Enterprise प्लान IP व्हाइटलिस्टिंग के ज़रिए किसी key को खास IP रेंज तक सीमित भी कर सकते हैं। यह सर्वर API key को सीधे इस्तेमाल करता है, क्योंकि key कभी आपके बैकएंड से बाहर नहीं जाती; अगर कोई ऑडियो लॉजिक ब्राउज़र या मोबाइल क्लाइंट में चला जाए, तो key को क्लाइंट-साइड एक्सपोज़ होने से बचाने के लिए आप single-use tokens इस्तेमाल करेंगे।
कनकरेंसी सीमा समझें
हर प्लान में मॉडल फ़ैमिली के अनुसार अलग कनकरेंसी सीमा होती है, और यह सीमा गिनती है कि एक ही समय में कितने अनुरोध सक्रिय रूप से ऑडियो जनरेट कर रहे हैं।
फ़ोन एजेंट के लिए यह हिसाब आपके पक्ष में काम करता है। ऑडियो जनरेशन प्लेबैक से तेज़ होती है, इसलिए हर कॉल पूरी अवधि के लिए नहीं, बल्कि जवाब सिंथेसाइज़ होने के छोटे समय में ही TTS कनकरेंसी इस्तेमाल करती है। मोटे तौर पर, लगभग पांच की कनकरेंसी सीमा करीब 100 एक साथ चलने वाली बातचीत वाली कॉल संभाल सकती है, क्योंकि जनरेशन प्लेबैक से बहुत पहले पूरी हो जाती है।
फिर भी अनुमान लगाने के बजाय हेडरूम मॉनिटर करें। ElevenLabs के रिस्पॉन्स current-concurrent-requests और maximum-concurrent-requests हेडर देते हैं; उन्हें लॉग करें और अधिकतम के करीब पहुंचने पर अलर्ट पाएं। सीमा पार होने पर अनुरोध प्राथमिकता के अनुसार कतार में लगते हैं, जिससे आमतौर पर लगभग 50ms जुड़ते हैं, और लगातार ओवरलोड होने पर HTTP 429 मिलता है।
HTTP 429 रिस्पॉन्स को कम समय के बैकऑफ़ के साथ हैंडल करें। अगर वे बने रहें, तो प्राइसिंग पेज पर अपग्रेड करके या Enterprise ग्राहकों के लिए अपने अकाउंट मैनेजर के ज़रिए सीमाएं बढ़ाएं।
बार्ज-इन और इंटरप्शन संभालें
एजेंट के बोलते समय बात शुरू करने वाला कॉलर उम्मीद करता है कि एजेंट रुक जाए। इसे बार्ज-इन कहते हैं और इसे सही ढंग से संभालना एजेंट को स्क्रिप्टेड के बजाय स्वाभाविक महसूस कराने का बड़ा हिस्सा है।
एजेंट प्लेबैक के दौरान STT VAD सिग्नल का इस्तेमाल करके कॉलर की आवाज़ पहचानें। पहचानने पर दो काम करें। पहला, TTS चंक्स आगे भेजना रोकें; speak में agentSpeaking फ़्लैग लूप तोड़कर यह पहले से संभालता है। दूसरा, अपने पास पहले से कतार में लगे ऑडियो को फ्लश करने के लिए Twilio को clear मैसेज भेजें।
अगर आप clear छोड़ देते हैं, तो भेजना बंद करने के बाद भी Twilio बफ़र किया हुआ ऑडियो चलाता रहता है, जिससे एजेंट कॉलर के ऊपर बोलता हुआ लगता है।
लॉग करें, मॉनिटर करें और आसानी से विफल हों
हर चरण में इंस्ट्रूमेंटेशन जोड़ें, ताकि कॉल धीमी लगने पर आप लेटेंसी की वजह पता कर सकें। अंतिम ट्रांसक्रिप्ट से पहले LLM टोकन तक, पहले LLM टोकन से पहले TTS बाइट तक और पहले TTS बाइट से Twilio को भेजे गए फ़्रेम तक का अंतर मापें। आपको मिलेगा कि आपकी ज़्यादातर बदलती लेटेंसी LLM चरण में होती है; STT और TTS चरण तुलनात्मक रूप से स्थिर हैं।
फिर आंशिक विफलताओं की योजना बनाएं। LLM टाइम आउट हो सकता है, STT स्ट्रीम ड्रॉप हो सकती है और ElevenLabs तक नेटवर्क राउंड-ट्रिप भौगोलिक स्थिति के आधार पर सार्वजनिक इंटरनेट पर लगभग 20 से 200ms तक हो सकती है। अपने सर्वर को केवल ElevenLabs के नहीं, बल्कि कॉलर के भी पास रखें, क्योंकि ElevenLabs पहले से अपने उत्तर अमेरिका, यूरोप और दक्षिण-पूर्व एशिया क्लस्टरों में सबसे नज़दीकी तक रूट करता है।
किसी चरण के विफल होने पर कॉलर को चुप्पी में न छोड़ें: एक छोटा फ़ॉलबैक वाक्य ("माफ़ कीजिए, क्या आप दोबारा कह सकते हैं?") सिंथेसाइज़ करें और कॉल चालू रखें। हर चरण को timeout और try/catch में रखें, ताकि एक विफल टर्न पूरा WebSocket बंद न कर दे।
लॉन्च से पहले कुछ और डिफ़ॉल्ट सेट करना भी फायदेमंद है:
- जैसा दिखाया गया है, सिस्टम प्रॉम्प्ट में जवाब की लंबाई सीमित रखें, ताकि टर्न छोटे रहें और उन्हें बीच में रोका जा सके।
- बातचीत का इतिहास सीमित रखें, ताकि लंबी कॉल में LLM कॉन्टेक्स्ट बिना सीमा न बढ़े।
- अटके हुए सेशन चुपचाप कनकरेंसी न खाएं, इसके लिए अधिकतम कॉल अवधि सेट करें।
जिन हिस्सों को आप नियंत्रित करते हैं, उन्हें बेहतर बनाते रहने के लिए लेटेंसी दस्तावेज़ बताता है कि पहला ऑडियो आने का समय कहां से आता है, मॉडल्स ओवरव्यू स्पीड और क्वालिटी के ट्रेड-ऑफ़ कवर करता है, और रीयलटाइम TTS WebSocket गाइड दिखाती है कि इंक्रीमेंटल टेक्स्ट इनपुट से सिंथेसिस लेटेंसी कैसे कम करें।
ElevenAPI के साथ प्रोडक्शन-रेडी वॉइस एजेंट बनाएं
अब 20 मिनट बीत चुके हैं और आपके पास प्रोडक्शन वॉइस एजेंट की हर लेयर है। Twilio टेलीफोनी संभालता है, Scribe v2 Realtime ट्रांसक्राइब करता है, LLM जवाब बनाता है और Flash v2.5 उसी WebSocket पर बोलकर जवाब देता है।
अगर आप कैस्केड को खुद मेंटेन नहीं करना चाहते, तो ElevenAgents उन्हीं मॉडलों पर बना मैनेज्ड सर्विस देता है जिन्हें आपने अभी हाथ से जोड़ा है। यह टर्न-टेकिंग, इंटरप्शन हैंडलिंग और टेलीफोनी इंटीग्रेशन देता है।
अपने नियंत्रित स्टैक को बेहतर बनाते रहने के लिए ElevenAPI प्रोडक्ट पेज पर प्लान, कनकरेंसी सीमाएं और वॉइस लाइब्रेरी देखें। या साइन अप करें और आज ही अपनी पहली कॉल शुरू करें।
Twilio और ElevenLabs के साथ वॉइस एजेंट बनाएं: FAQ

Tadas Petra एक डेवलपर रिलेशंस इंजीनियर हैं, जो डेवलपर्स को ElevenLabs के प्रोडक्ट्स के साथ काम करने में मदद करते हैं। वह Hungrimind के फाउंडर भी हैं, जो एक डेवलपर एजुकेशन प्लेटफॉर्म है। इससे पहले, वह Agora में लीड डेवलपर एडवोकेट और Zero To Mastery में इंस्ट्रक्टर थे।




