Concevoir des agents vocaux durables : enseignements tirés de l’ingénierie déployée sur le terrain
- Publié
- Dernière mise à jour
ÉcouterÉcouter cet article
Pour la plupart des organisations, les solutions ponctuelles dédiées au support sont depuis longtemps évaluées à l’aune de leur capacité de déviation. Autrement dit, à réduire le volume d’appels et à limiter les interactions avec des agents humains. Mais dévier une demande ne signifie pas la résoudre, et c’est dans cet écart que l’expérience client se dégrade. Le combler exige des agents qui accèdent non seulement aux données, mais aussi aux systèmes nécessaires pour agir. Ils peuvent ainsi traiter des remboursements, guider les clients tout au long du paiement et transférer la conversation à un agent humain avec tout son contexte lorsque la situation l’exige. Les entreprises peuvent alors gérer les interactions clients à grande échelle, réduire sensiblement la charge des équipes de support humain et améliorer l’expérience des deux côtés de l’appel. Lors d’un récent déploiement chez Revolut, une fintech au service de 70 millions de clients dans le monde, cela s’est traduit par un délai de résolution divisé par huit et un taux de réussite des appels de 99,7 %.
Les organisations doivent aborder des changements de cette ampleur de manière itérative, en les reliant étroitement à la mission de l’entreprise et en s’appuyant sur un solide soutien de la direction. Sur le plan technique, raisonner dans un environnement non structuré comporte des risques inhérents qu’il faut gérer avec rigueur. Donner à un agent la capacité d’agir dans le système de gestion de la relation client (CRM), de modifier une commande dans le système de point de vente ou de faire remonter un dossier implique que le modèle de gouvernance compte autant que le modèle lui-même. La question n’est alors plus de savoir si les agents peuvent effectuer un travail réel, mais quels mécanismes sont nécessaires pour les déployer de façon sûre et reproductible.
Dans cet article, nous partageons notre expérience sur ce qui fait la réussite des agents, du premier déploiement à leur généralisation à l’ensemble des opérations clients d’une organisation.
Déployer des agents ou déployer des logiciels
Avant d’approfondir la conception d’agents, il est utile de comparer le déploiement d’agents vocaux à celui des logiciels traditionnels, que les entreprises pratiquent depuis des décennies. Sous cet angle, les agents se divisent en deux composants distincts : le logiciel traditionnel et l’orchestrateur central.
Logiciel


Orchestrateur central
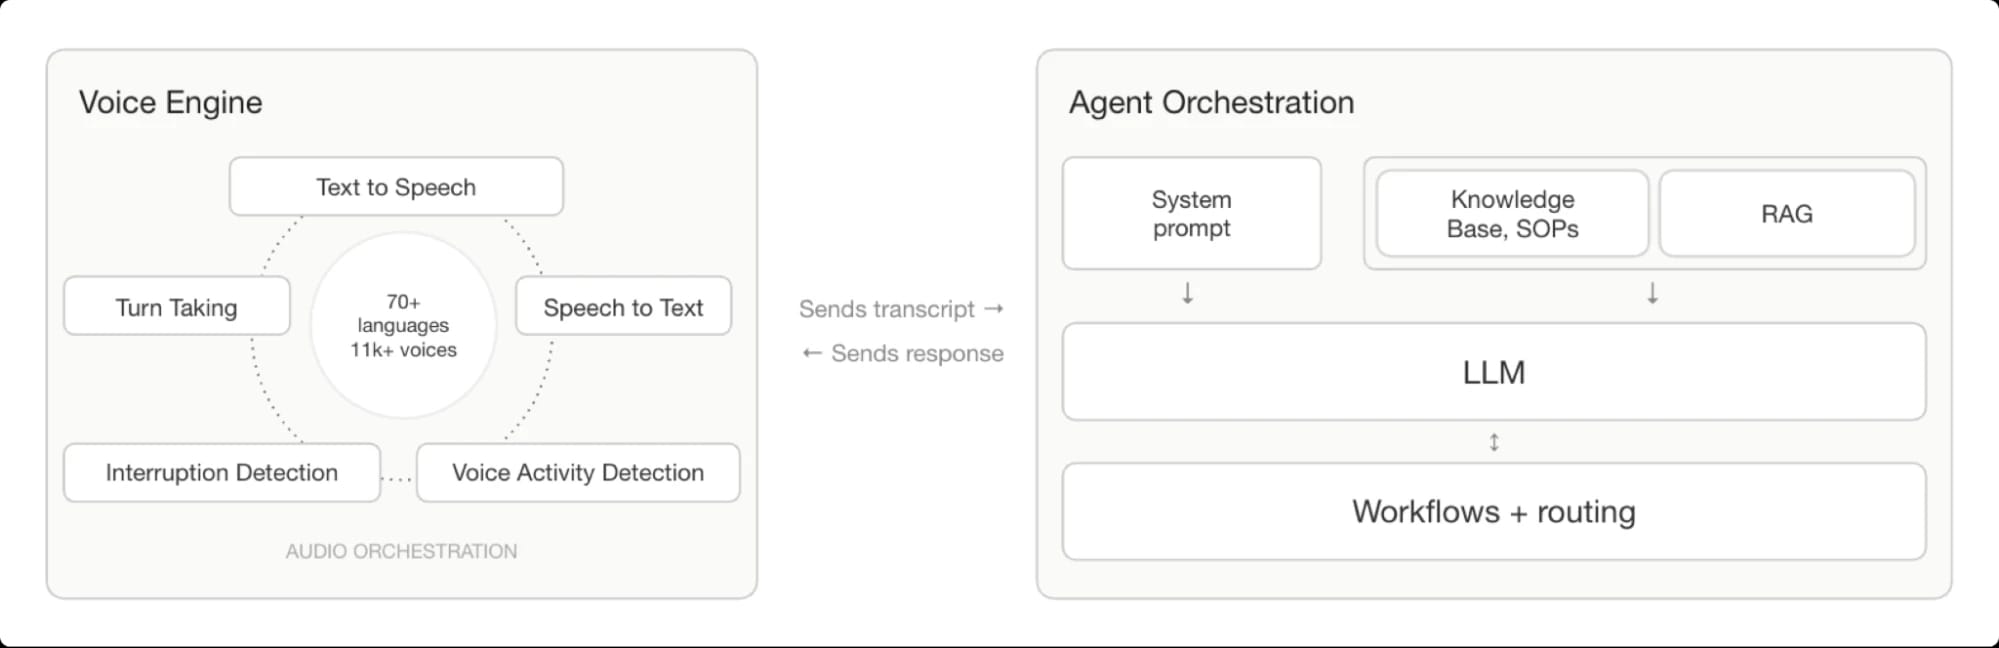
Les composants logiciels traditionnels visent avant tout à améliorer la diffusion et les performances de l’agent. Pour ElevenAgents, cela inclut des fonctionnalités telles que la gestion des versions, les tests A/B, la téléphonie et la configuration du premier message, entre autres. Ces composants présentent peu, voire aucune dérive après le déploiement, ce qui rend leur comportement très prévisible. Grâce à des pratiques d’ingénierie rigoureuses, les organisations peuvent rapidement s’appuyer sur ces fonctionnalités et conserver une compréhension fine de leurs performances en production grâce à un ensemble rigoureux de métriques, traces et journaux. Les gains de latence à ce niveau suivent des schémas bien connus : mise en cache, mutualisation des connexions, montée en capacité de l’infrastructure et optimisation des protocoles sont autant de leviers fiables aux résultats déterministes.
Les composants de l’orchestrateur central sont par nature plus difficiles à prédire, mais ils déterminent les performances de l’agent en exécution, tant pour la qualité des réponses que pour la latence perçue. Contrairement aux logiciels traditionnels, ces composants traitent le langage naturel et l’audio, où l’espace des entrées est pratiquement illimité et où de petits changements de formulation, de contexte, de bruit de fond ou de comportement utilisateur peuvent produire, au fil du temps, des résultats très différents. Les tests conventionnels ne suffisent donc pas à eux seuls : un agent peut fonctionner parfaitement sur des centaines de cas de test tout en échouant en production de manière difficile à anticiper.
La latence à ce niveau est également moins déterministe : elle dépend des temps d’inférence du modèle, de l’injection d’artefacts sonores, des chaînes d’appels d’outils et de la variabilité inhérente aux systèmes génératifs. Bien gérer ces composants exige une discipline différente, fondée sur des cadres d’évaluation, le suivi de la production et la volonté d’itérer continuellement à partir de données de conversations réelles, plutôt que des seules hypothèses formulées avant le déploiement.
Cette distinction définit la manière dont les organisations doivent aborder l’adoption : commencer par des cas d’usage pertinents pour l’organisation mais peu risqués, puis monter en charge de manière réfléchie à mesure que la confiance dans le système augmente.
Cycle de publication
Choisir les cas d’usage pionniers
Pour les équipes qui commencent à adopter des agents vocaux, le choix des bons cas d’usage pionniers est l’une des premières décisions les plus déterminantes. Et il dépend moins de la technologie qu’on ne le pense. Les équipes qui obtiennent rapidement des résultats et évitent l’interminable impasse des POC ont généralement un point commun : elles répondent clairement aux questions suivantes.
- Comment ce cas d’usage génère-t-il une valeur métier mesurable ? Le bon premier cas d’usage n’est pas le plus intéressant sur le plan technique, mais celui qui a le plus de chances d’améliorer un résultat dont l’entreprise se préoccupe déjà. Il se mesure par l’impact sur les revenus, la réduction des coûts, la satisfaction client ou d’autres métriques que les dirigeants suivent déjà et dont ils sont responsables. Sans ce lien direct avec la valeur métier, il devient difficile de justifier les cycles d’itération nécessaires pour mettre l’agent au point, et l’élan risque de s’essouffler avant que la technologie puisse faire ses preuves.
- Les utilisateurs comprennent-ils immédiatement le périmètre et l’objectif de l’agent ? L’ambiguïté du périmètre est l’une des sources les plus fréquentes de dérive entre le développement et la production. Les utilisateurs qui ne comprennent pas ce qu’un agent peut ou ne peut pas faire testeront ses limites de façons que la suite d’évaluation n’avait jamais anticipées. Un agent au périmètre bien défini fixe les attentes dès le premier message et traite avec souplesse les demandes hors périmètre.
- À quoi reconnaît-on une bonne ou une mauvaise interaction, et peut-on le formaliser en critères d’évaluation concrets ? Une bonne interaction ne se limite pas à l’exécution de la tâche par l’agent : l’utilisateur doit se sentir écouté, l’escalade doit intervenir au bon moment et le résultat doit correspondre à l’intention métier. Les critères d’évaluation se répartissent en deux catégories : les métriques quantitatives collectées par la plateforme, comme le taux de réalisation des tâches et le taux d’escalade, et les critères fondés sur les transcriptions, qui nécessitent d’analyser la conversation elle-même. Définir ces derniers tôt donne à l’équipe un objectif concret vers lequel travailler. Ils fixent aussi un seuil naturel de mise en production. Lorsque votre agent satisfait systématiquement ses critères d’évaluation et que les métriques de la plateforme se sont stabilisées, vous pouvez passer en production en toute confiance. Sans critères définis, la mise en production relève du jugement.
- Quels compromis faut-il faire entre performances et contrôle, et lequel prime à ce stade ? Plus un agent dispose d’autonomie, plus les interactions sont naturelles et flexibles, mais plus le risque d’agir hors de limites validées augmente. Un contrôle plus strict, via des prompts contraints et une logique d’escalade plus rigoureuse, réduit ce risque mais peut rendre l’agent rigide. Aucun de ces extrêmes n’est souhaitable. Les organisations qui verrouillent trop tôt se retrouvent avec un SVI à peine amélioré. Celles qui vont trop vite avant d’avoir établi la confiance créent une charge de support qui dépasse les gains. Comprendre où placer ce curseur à chaque étape de maturité orientera la configuration du modèle, la logique d’escalade et la part des connaissances de l’agent qui réside dans le prompt plutôt que dans des sources récupérées ou structurées.
Une fois ces questions résolues, l’organisation peut passer de la stratégie à l’exécution et commencer à définir le périmètre de la conception.
Ancrer la conception initiale
Lors du passage à l’exécution, les équipes peuvent s’appuyer sur des méthodologies presque aussi anciennes que le logiciel lui-même. Le développement piloté par les tests (TDD) fournit le cadre nécessaire pour maintenir les agents alignés sur les métriques clés tout au long de la conception.
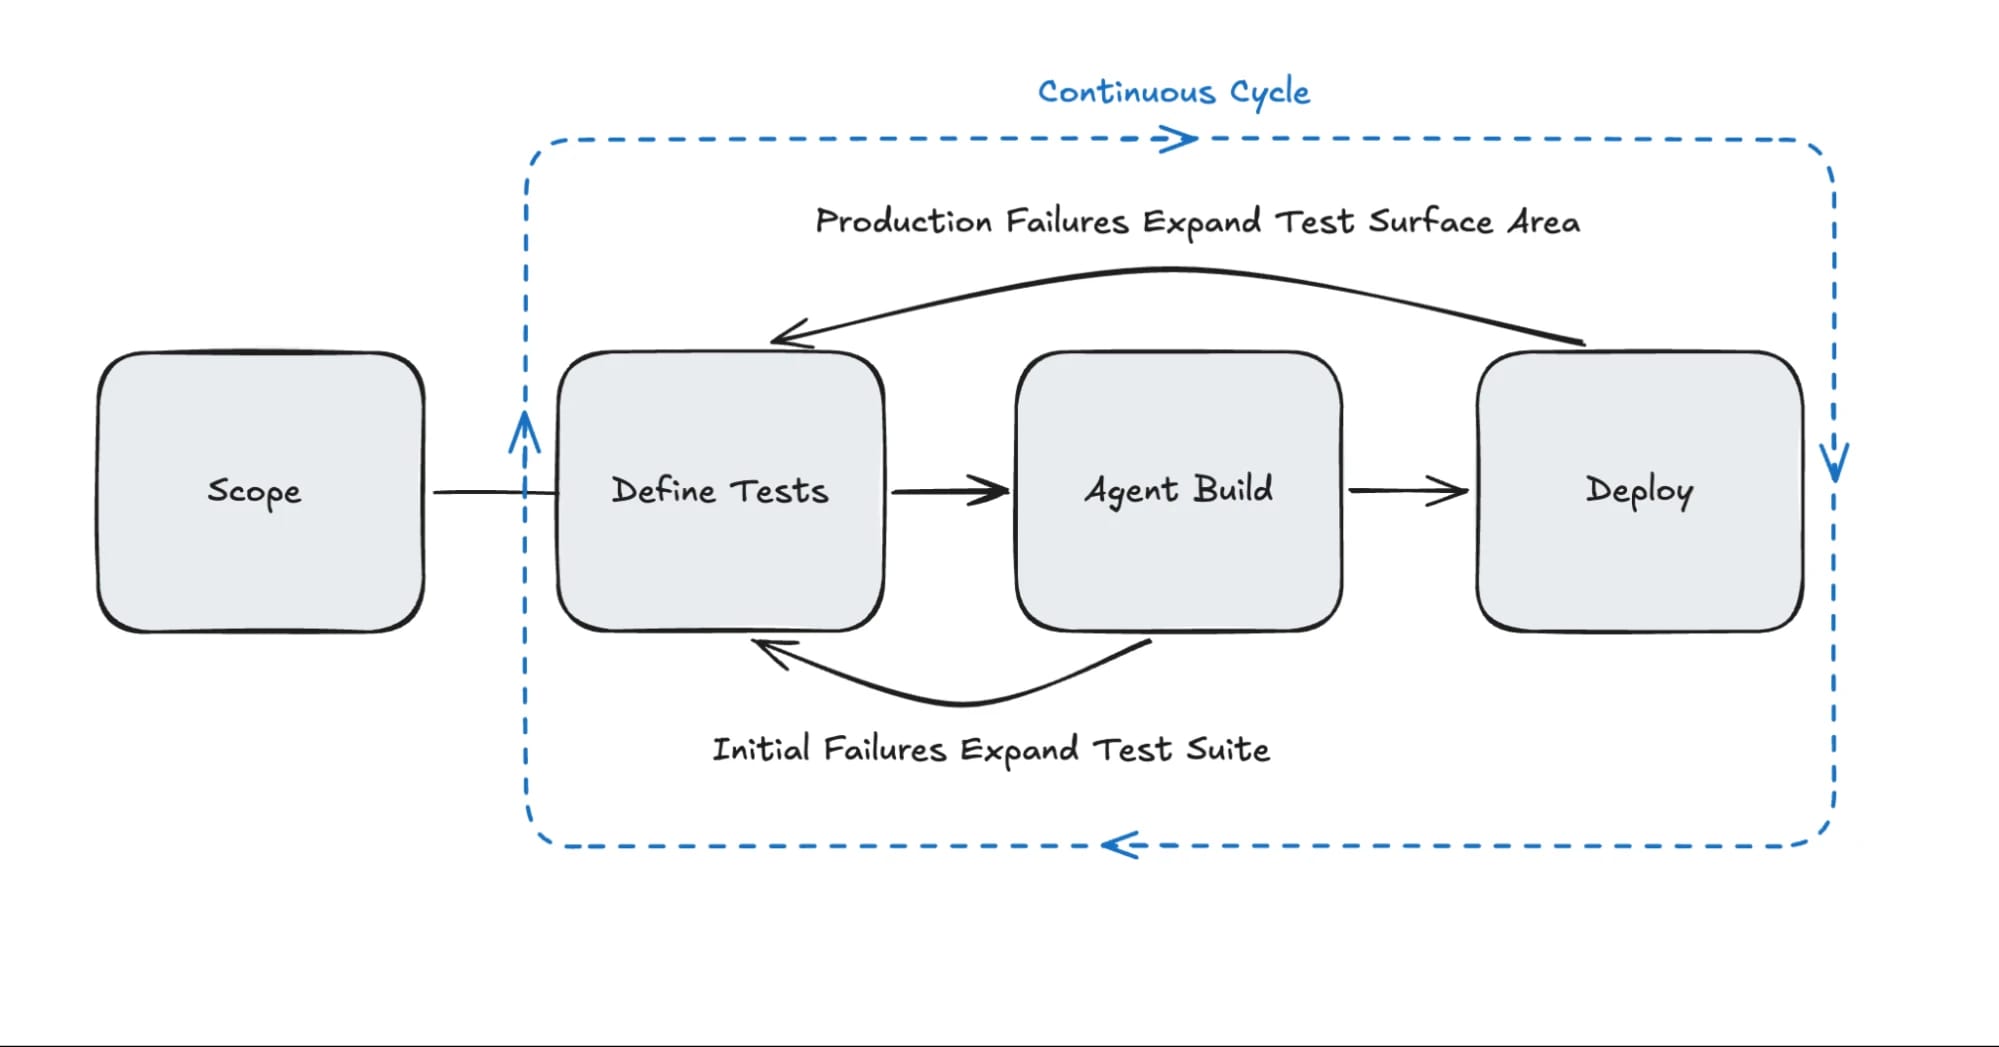
Concrètement, les équipes de développement et les parties prenantes métier doivent définir et élaborer conjointement deux éléments fondamentaux : les critères d’évaluation du succès, qui définissent ce qu’est une bonne performance au niveau de chaque appel comme à l’échelle globale, et les tests d’agent, qui vérifient de façon répétée les comportements précis que l’agent doit adopter. Les premiers s’appuient au mieux sur l’examen d’appels réels traités par des humains, dès qu’ils sont disponibles. Les seconds se construisent progressivement, à partir d’un ensemble initial de comportements attendus, puis s’enrichissent à mesure que de nouveaux comportements sont introduits et que des cas limites sont découverts.
Une fois un premier ensemble de tests en place, le développement de l’agent commence par le prompt système. C’est là que sont définis ses règles, son ton et son approche : ce qu’il doit faire, ce qu’il ne doit pas faire et son comportement aux limites de son rôle. Un prompt système bien conçu dépend autant de sa structure que de son contenu. Séparer les instructions en sections clairement identifiées, regrouper les directives liées et éviter les formulations conditionnelles améliorent sensiblement la cohérence du comportement de l’agent. À ce stade, nous revenons souvent au guide de prompting.
Parallèlement au prompt système, les composants essentiels de l’agent sont configurés : le LLM, le modèle de synthèse vocale (TTS) et la voix. Le choix du LLM repose principalement sur un compromis entre latence et performances : les modèles optimisés pour la vitesse sacrifient généralement une partie de leur capacité de raisonnement, et inversement. Pour le TTS, le bon choix dépend de la priorité du cas d’usage : expressivité, faible latence ou prise en charge multilingue. La voix, en revanche, est autant une décision de marque qu’une décision technique. Elle façonne la perception qu’a chaque appelant de l’organisation, ce qui en fait l’une des rares décisions de configuration qui concerne autant les équipes de marque et de marketing que les ingénieurs qui conçoivent l’agent. La sélection de la voix peut donc se faire en parallèle du reste du développement, plutôt que de devenir un goulot d’étranglement au début ou à la fin. ElevenAgents donne accès à plus de 10 000 voix, et si aucune ne convient, les équipes peuvent créer ou cloner la leur.
À partir de là, les agents peuvent être enrichis, si nécessaire, d’une base de connaissances, d’outils et de configurations de canaux. Chaque ajout apporte de nouvelles capacités, mais étend aussi le périmètre à tester. Qu’il s’agisse d’une intégration téléphonique, d’un accès à des bases de données externes ou de la capacité d’agir au nom d’un client, ces décisions doivent être mises à l’épreuve des critères d’évaluation avant d’élargir le périmètre. Lorsque des outils sont ajoutés, le prompt système et leur description indiquent explicitement quand et comment les appeler, afin que l’agent les utilise systématiquement dans le bon contexte.
Ces fondations en place, l’agent est prêt à être mis à l’épreuve.
Vers la préparation à la production
Une fois les tests et critères d’évaluation définis pendant la phase d’ancrage exécutés sur un agent conçu, le développement devient une boucle courte : ajouter des tests, identifier les échecs, mettre à jour le prompt système ou la configuration, puis recommencer. À ce stade, la plupart des échecs ne viennent pas du modèle, mais du prompt. Une instruction qui semblait claire isolément se révèle ambiguë lorsque l’agent la rencontre au milieu d’une conversation. Des cas limites non prévus par la suite de tests initiale apparaissent. Chacun devient un nouveau test Next Turn, créé à partir de la conversation elle-même. La question de savoir quand arrêter d’itérer a une réponse concrète : lorsque l’agent satisfait systématiquement ses critères d’évaluation sur plusieurs exécutions et que les métriques de la plateforme, telles que le taux de réalisation des tâches et le taux d’escalade, se sont stabilisées dans des plages acceptables. C’est pourquoi définir ces critères avant de concevoir l’agent est si important. Sans eux, l’état de préparation relève du jugement et la ligne d’arrivée ne cesse de se déplacer.
En pratique, la plupart des équipes constatent qu’un petit ensemble de schémas d’échec récurrents explique la majorité des problèmes. Les plus fréquents sont l’ambiguïté du prompt, lorsque l’agent reçoit des instructions contradictoires ou insuffisamment précises et adopte par défaut un comportement imprévisible ; la mauvaise utilisation des outils, lorsqu’il appelle un outil dans un contexte inadapté ou omet de le faire alors qu’il le devrait ; et la dérive de l’escalade, lorsqu’il escalade de façon excessive ou conserve des conversations qu’il aurait dû transférer. Chacun de ces problèmes peut être corrigé au niveau du prompt. Il suffit généralement de préciser l’instruction concernée, d’ajouter un exemple explicite ou d’ajuster le seuil d’escalade. Le risque est de ne pas les détecter avant la mise en production.
L’erreur la plus courante consiste à considérer une suite de tests réussie comme une garantie plutôt qu’un signal. Une suite qui ne couvre que le scénario idéal réussira facilement et n’aura que peu de valeur. Ce qui donne du poids aux résultats, c’est la couverture des refus, des changements de direction en cours de conversation, des entrées ambiguës et des interactions faisant largement appel aux outils. De même, les équipes qui omettent les tests de simulation et s’appuient uniquement sur des tests par tour passent à côté d’une catégorie d’échecs qui ne se révèle que sur une conversation entière : dérive de contexte, lorsque l’agent perd le fil des tours précédents, ou erreurs cumulatives, lorsqu’un petit faux pas au début de l’appel conduit à un mauvais résultat. Une fois les schémas d’échec récurrents résolus et l’agent capable de gérer avec souplesse, plutôt que parfaitement, la longue traîne des cas limites, la valeur marginale d’itérations supplémentaires en préproduction diminue. À ce stade, les conversations réelles fournissent le signal le plus précieux.
La mise en production ne signifie pas la fin des itérations. Elle déplace l’apprentissage des tests synthétiques vers les transcriptions de production. Les critères d’évaluation qui ont défini la mise en production deviennent la référence pour mesurer les performances en conditions réelles, et le cycle se poursuit à partir de là.
Boucles de rétroaction, évaluation et moment où arrêter d’itérer
Une fois les tests définis et lancés, les lacunes du processus apparaissent rapidement. Grâce à l’analyse des conversations, les équipes peuvent identifier le moment exact où une interaction a mal tourné, puis utiliser ce signal pour créer un nouveau test et déterminer les changements nécessaires. Les interventions les plus fréquentes concernent le prompt : préciser les descriptions d’appels d’outils, ajouter des instructions plus explicites pour les cas limites ou clarifier des conditions d’escalade qui se sont révélées ambiguës en pratique. Dans certains cas, le problème est plus profond et la configuration du modèle sous-jacent doit être revue si la latence ou la qualité du raisonnement ne répond pas aux exigences du cas d’usage.
À ce stade, la discipline la plus importante consiste à valider les changements plutôt qu’à les supposer efficaces. Une correction qui résout un échec peut discrètement en introduire un autre. ElevenAgents prend en charge la gestion des versions, ce qui permet aux équipes de tester de nouvelles itérations auprès d’un faible pourcentage d’utilisateurs avant de les déployer auprès d’une population plus large. Elles peuvent ainsi confirmer que les améliorations améliorent réellement les résultats, au lieu de déplacer le mode d’échec ailleurs.
Ce qui peut mal tourner
L’erreur la plus lourde de conséquences à ce stade consiste à ignorer les déploiements par branches et à appliquer directement les changements à l’ensemble des utilisateurs. Sans déploiement progressif, vous perdez la capacité d’isoler l’impact de chaque changement et, à grande échelle, il devient presque impossible de comprendre ce qui entraîne réellement les améliorations ou les régressions dans vos métriques de plateforme. Utiliser l’ensemble des utilisateurs comme environnement de test n’est pas seulement risqué : cela élimine l’observabilité dont vous avez besoin pour prendre des décisions éclairées par la suite.
Au-delà de la stratégie de déploiement, deux autres modes d’échec méritent votre attention. Le premier consiste à accorder trop d’importance aux échecs récents. Lorsqu’une conversation très visible se passe mal, la réaction naturelle est de la corriger immédiatement et largement ; pourtant, des modifications réactives du prompt réalisées sans exécuter l’intégralité de la suite de tests provoquent souvent des régressions dans des comportements auparavant stables. Tout changement, même mineur, doit être traité comme une nouvelle itération et testé en conséquence. Le second est la dérive de l’évaluation. Avec le temps, les équipes peuvent inconsciemment abaisser le niveau requis pour qu’un test soit considéré comme réussi, particulièrement sous la pression de livrer. Les critères d’évaluation définis pendant le cadrage doivent rester le point d’ancrage. S’ils semblent trop stricts, il faut les réexaminer et les mettre à jour délibérément, sans laisser les exigences s’éroder de manière informelle.
Monter en charge avec confiance
Augmenter le trafic est une décision fondée sur la confiance, non sur le temps écoulé. Le signal pour élargir le déploiement est le suivant : l’agent satisfait systématiquement ses critères d’évaluation sur plusieurs exécutions de tests, les métriques de la plateforme se sont stabilisées et les déploiements par branches n’ont montré aucune régression significative par rapport au groupe de contrôle.
À ce stade, une question fréquente est de savoir quel volume de trafic suffit pour tirer une conclusion. Des lots de moins de 100 appels par branche produisent trop de variance pour évaluer les résultats de manière fiable. Un taux de réussite de 60 % sur 25 appels et le même taux sur 100 appels ne représentent pas le même niveau de confiance. Au-delà d’un seuil défini, le lot doit aussi être assez important pour faire apparaître l’ensemble des entrées réalistes, notamment les cas limites probables, les intentions peu fréquentes et les modes d’échec qui ne surviennent qu’à haut volume et apparaissent rarement dans de petits échantillons.
Un trafic plus important amplifie ce qui fonctionne comme ce qui ne fonctionne pas. Élargir le déploiement avant d’avoir résolu les principaux schémas d’échec crée une charge de support difficile à résorber.
Répéter le cycle
Savoir où s’arrêter est aussi important que savoir quoi corriger. Les itérations offrent des rendements décroissants, et le bon signal pour faire une pause est lorsque l’agent satisfait systématiquement les critères d’évaluation fixés pendant le cadrage. À ce stade, de nouveaux changements comportent plus de risques que de bénéfices.
Ce que signifie « satisfaire systématiquement les critères » varie selon le contexte. Les équipes ayant un accès limité aux données ou des intégrations incomplètes peuvent constater qu’un taux d’escalade d’environ 50 % constitue un plafond réaliste tant que ces contraintes ne sont pas levées. Lorsque l’accès aux données est solide, les déploiements les plus performants visent généralement un taux de réalisation des tâches supérieur à 80 % et un taux d’escalade inférieur à 20 %. Plus important que n’importe quel chiffre isolé : la stabilité. Des performances constantes durant plusieurs semaines de trafic en production, sans régression significative d’une exécution de tests à l’autre, constituent le véritable signal. Lorsque le gain marginal de la prochaine itération est inférieur au risque de régression, il est temps de s’arrêter.
Cela ne signifie pas que le travail est terminé. Lorsque de nouvelles exigences apparaissent, le processus recommence depuis le début. Les questions de cadrage de la première conception restent tout aussi pertinentes pour la deuxième. La différence est que les équipes qui entament un second cycle disposent d’une suite de tests, d’une référence d’évaluation et d’une expérience opérationnelle que le premier cycle a dû construire de zéro. Cet avantage cumulatif distingue les organisations qui tirent une valeur durable des agents vocaux de celles qui restent bloquées au stade de la preuve de concept.
Conclusion
Les équipes que nous avons vues combler l’écart entre déviation et résolution sont celles qui définissent ce qu’est une bonne performance avant de commencer à concevoir, maintiennent une discipline tout au long du cycle d’itération et considèrent chaque déploiement comme le fondement du suivant. Les agents conversationnels ne sont pas un déploiement ponctuel : les conversations réelles révèlent des cas limites qu’aucune suite de tests ne peut pleinement anticiper, et le travail d’amélioration ne s’arrête pas à la mise en production.
ElevenAgents est conçu pour cette réalité. Les tests d’agent, l’analyse des conversations et les déploiements par branches constituent la base qui transforme une preuve de concept en un système capable de résoudre réellement les problèmes clients à grande échelle, et non de simplement les dévier. C’est cet écart qu’il faut combler.



