Presentamos Scribe v3 y v3 Live, nuestros modelos de Voz a Texto más precisos
- Escrito por
- Min Kim
- Publicado
EscucharEscucha este artículo
Los productos basados en audio empiezan con una transcripción: notas de reuniones, agentes de voz, doblaje, documentación clínica y archivos de emisiones que abarcan décadas de contenido. Acertar con esa transcripción a la primera importa, porque cada error llega a las etapas posteriores, donde corregirlo cuesta mucho más.
Pero el audio del mundo real es complicado. Puede haber varias personas hablando a la vez en una reunión, un cliente en una calle concurrida que hace una pausa a mitad de frase o una llamada de soporte en la que ninguna de las dos personas habla su lengua materna.
Hoy, ElevenLabs lanza dos nuevos modelos de Voz a Texto diseñados precisamente para estas condiciones:
- Scribe v3, para audio grabado, comete un 27 % menos de errores de palabras que Scribe v2 en 102 idiomas y ofrece las etiquetas de hablante más precisas de todos los modelos que hemos probado,
- Scribe v3 Live es la variante de baja latencia para audio en tiempo real y comete un 43 % menos de errores que Scribe v2 Realtime. Además, incluye por primera vez la diarización de hablantes (identifica quién dijo qué) y una detección de turnos mejorada.
Scribe v3 Live ya está disponible en ElevenAgents. Ambos modelos también están disponibles en ElevenAPI, donde pasar de Scribe v2 solo requiere cambiar el ID del modelo en una línea.
Los comentarios que dieron forma a Scribe v3
Scribe ha impulsado cientos de millones de horas de transcripción en apps de notas de reuniones, centros de contacto, herramientas de documentación clínica y agentes de voz. En todos los casos de uso, los equipos que lo desarrollan pedían las mismas cinco cosas.
Los equipos de reuniones y toma de notas querían una mejor diarización en intercambios rápidos y con tres o más hablantes. Los equipos de agentes de voz señalaron que un temporizador de silencio corta a quienes llaman cuando hacen una pausa a mitad de frase o reducen el ritmo para decir un número. Los equipos que desarrollaban productos en directo sacrificaban precisión por velocidad, ya que el tiempo real rendía notablemente peor que el procesamiento por lotes. Clientes de India querían que el hindi tuviera la misma calidad que el inglés, incluso cuando quienes llaman alternan entre ambos idiomas a mitad de frase. Y muchos querían más control sobre el resultado, desde números escritos como «123» hasta listas de términos clave lo bastante extensas para un catálogo de productos o una lista de nombres de medicamentos.
Etiquetas de hablante, detección de turnos y más control sobre el resultado
Diarización fiable incluso en una sala llena
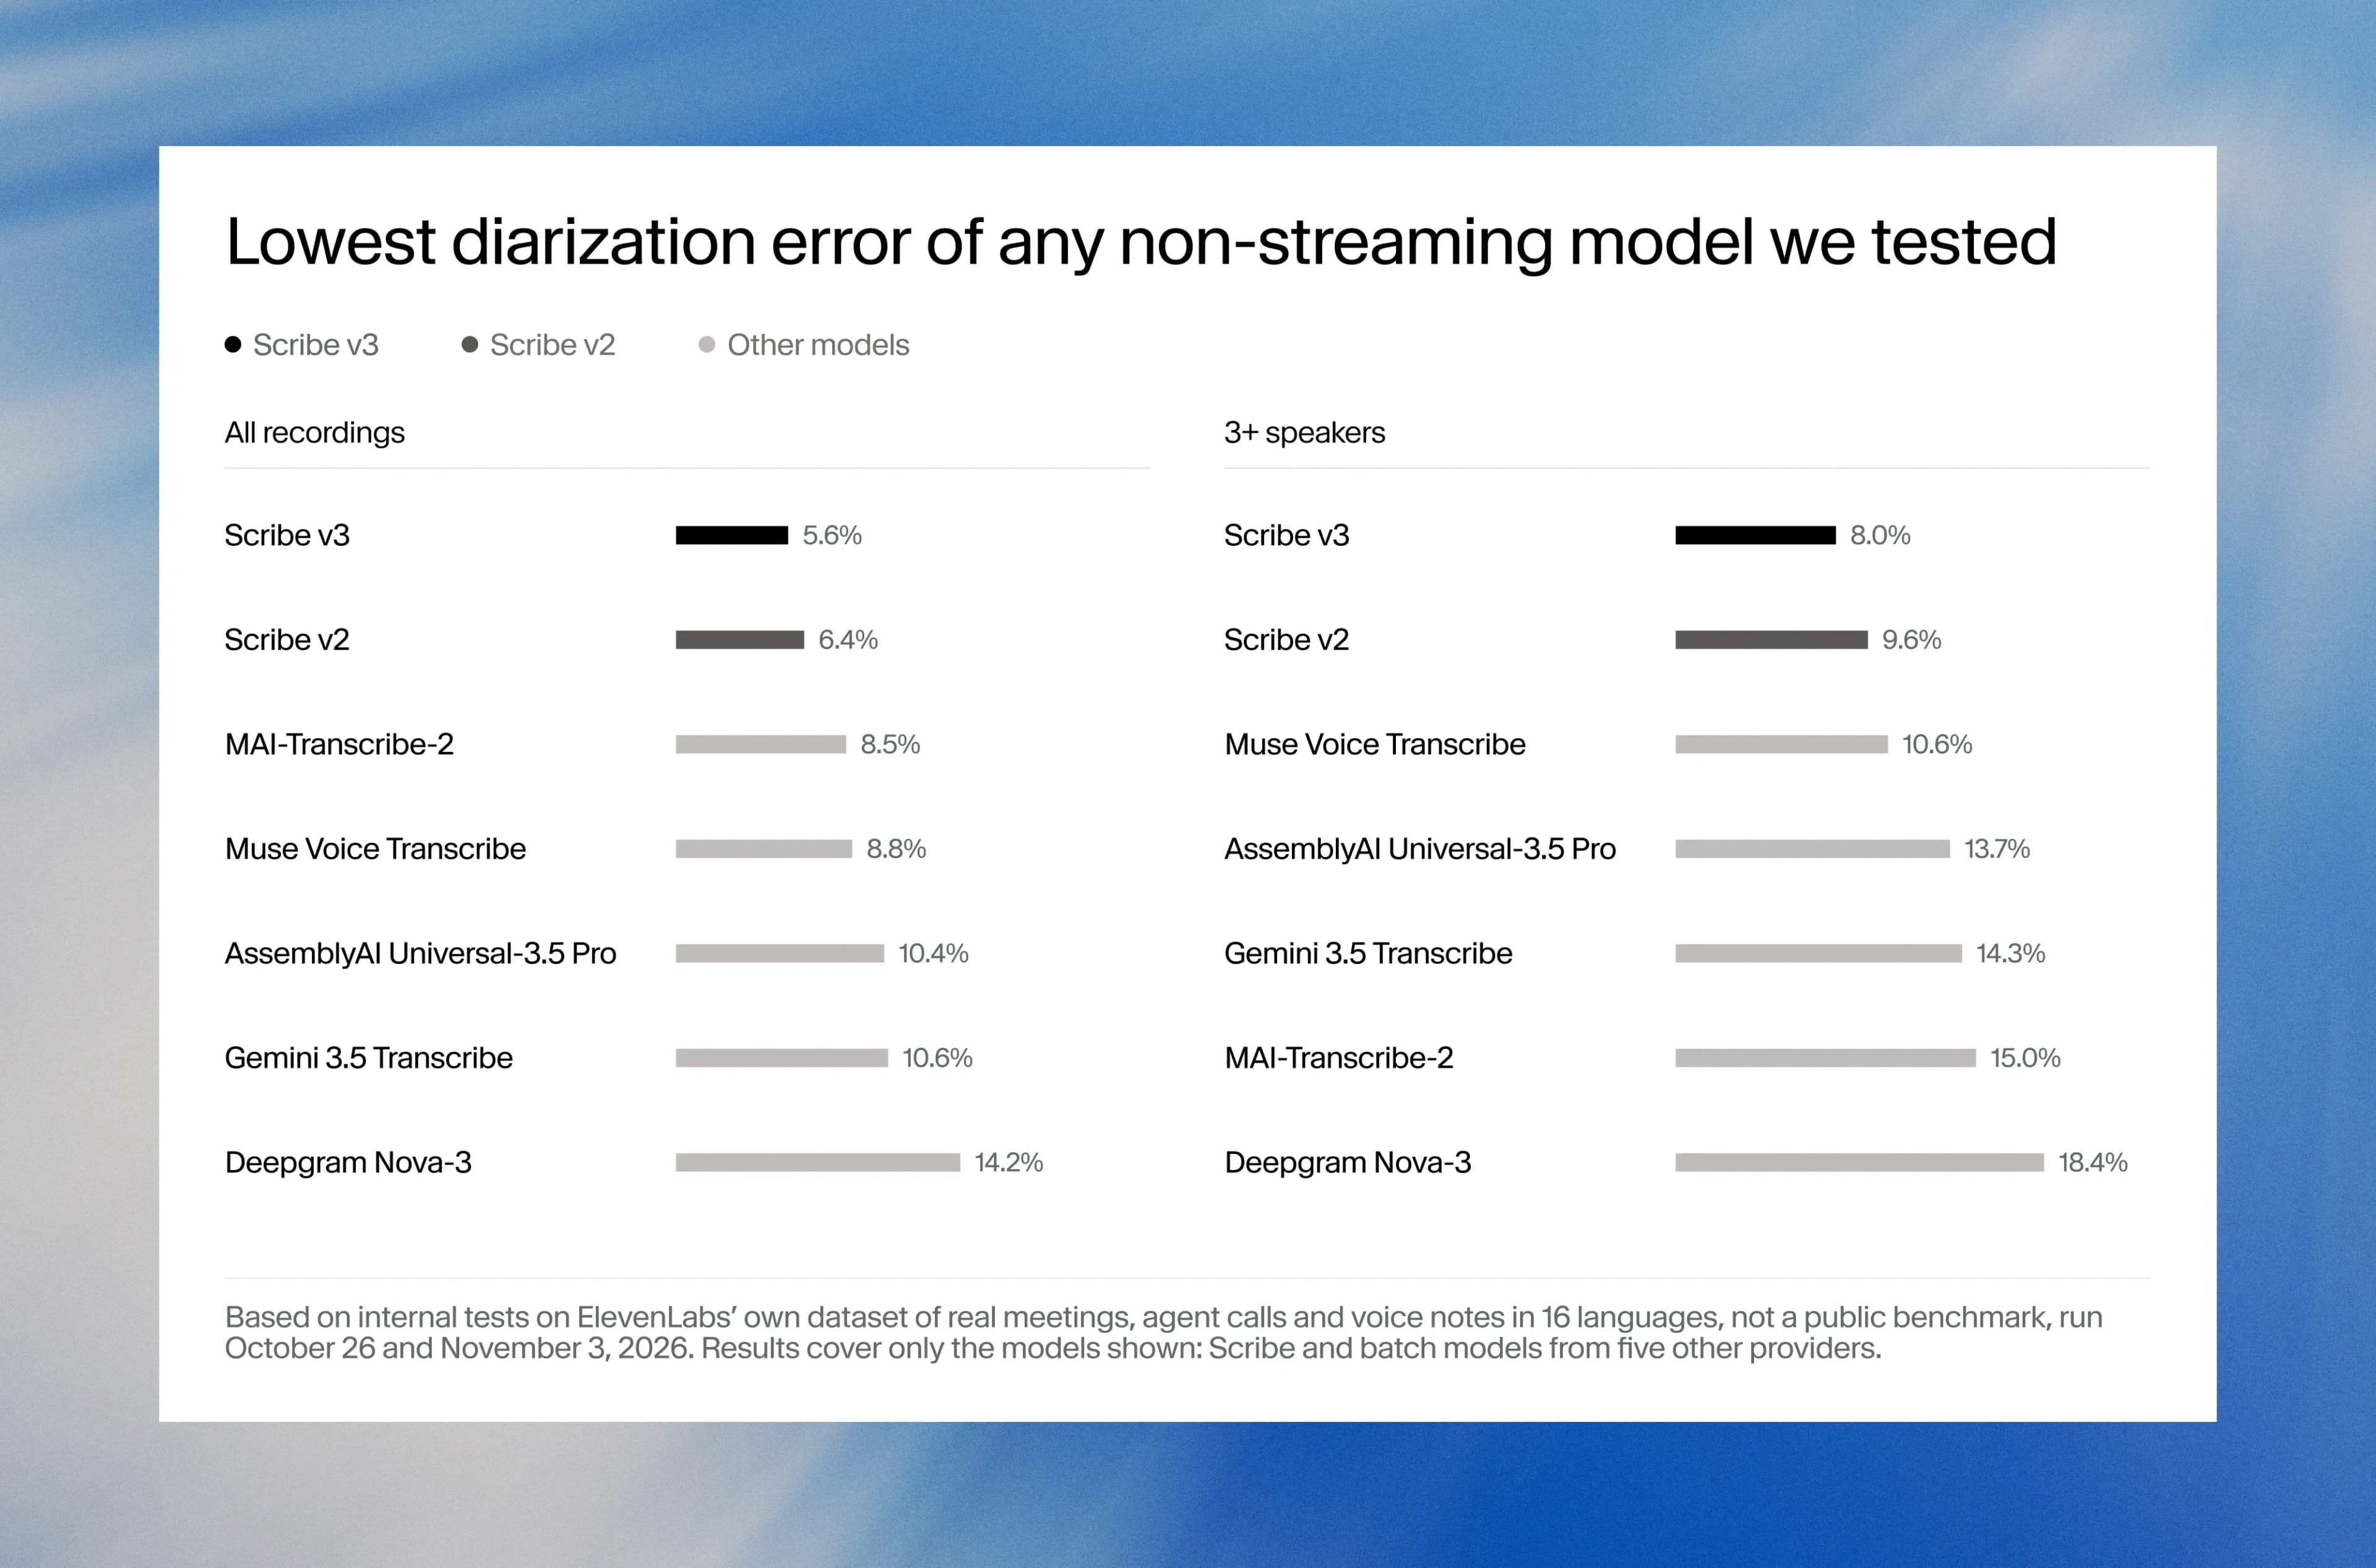
En la transcripción de una reunión, identificar al hablante correcto importa tanto como transcribir las palabras correctas. Scribe v3 comete un 17 % menos de errores de diarización que Scribe v2 en grabaciones con tres o más hablantes, que son las grabaciones en las que fallan la mayoría de los modelos existentes. Scribe v3 Live también incorpora por primera vez la diarización a la transcripción en tiempo real, con un 39 % menos de errores de diarización que el siguiente mejor modelo en tiempo real que probamos.
Detección de turnos que escucha la conversación
Para que las conversaciones resulten naturales, los agentes de voz deben predecir con precisión cuándo un hablante ha terminado de hablar. Los sistemas tradicionales de turnos se basan en periodos de silencio. Pero el silencio por sí solo obliga a elegir: establecer un umbral corto puede interrumpir a quienes hacen una pausa a mitad de frase, mientras que uno largo hace que un agente parezca lento. Scribe v3 Live usa tanto el contexto de la conversación como el audio, por lo que no corta a quien llama si hace una pausa a mitad de un número. Es la misma detección de turnos que ya utiliza ElevenAgents, ahora disponible en ElevenAPI.
Más control sobre idiomas, terminología y formato
Scribe v3 puede deducir qué idiomas puede contener una grabación y permite elegir si los números se devuelven como cifras o palabras. El prompting de términos clave admite hasta 1000 términos que sabes que aparecerán, como nombres de marcas, acrónimos y jerga, y las ediciones de transcripciones aplican reglas de formato escritas en inglés sencillo, como «escribe todas las fechas como AAAA-MM-DD».
Scribe v3 Live añade un modo multilingüe para conversaciones que cambian de idioma a mitad de frase. También añade una biblioteca de términos clave para vocabularios demasiado grandes para una lista. Mientras que el prompting de términos clave cubre términos que sabes que aparecerán, la biblioteca de términos clave contiene miles que podrían aparecer, y el modelo solo la consulta cuando detecta una posible coincidencia.
Cómo se compara Scribe v3
ElevenLabs evaluó ambos modelos frente a Scribe v2, Scribe v2 Realtime y otros modelos de Voz a Texto populares, puntuando cada uno con los mismos conjuntos de datos. La precisión multilingüe se midió con una versión interna del benchmark FLEURS, que evalúa fragmentos cortos y claros de habla leída en 102 idiomas. FLEURS no puede medir la diarización, ya que cada clip tiene un solo hablante, así que también creamos nuestro propio conjunto de datos de reuniones reales, llamadas de agentes y notas de voz en 16 idiomas. Próximamente lo publicaremos como código abierto.
Diarización de hablantes
Scribe v3 tiene el menor error de diarización de todos los modelos que probamos, con un 12 % menos de errores que Scribe v2 en general y un 17 % menos en grabaciones con tres o más hablantes.
Precisión de transcripción multilingüe
Informamos de la tasa de error de palabras (WER) junto con la WER semántica, que solo cuenta un error cuando cambia el significado de la transcripción.
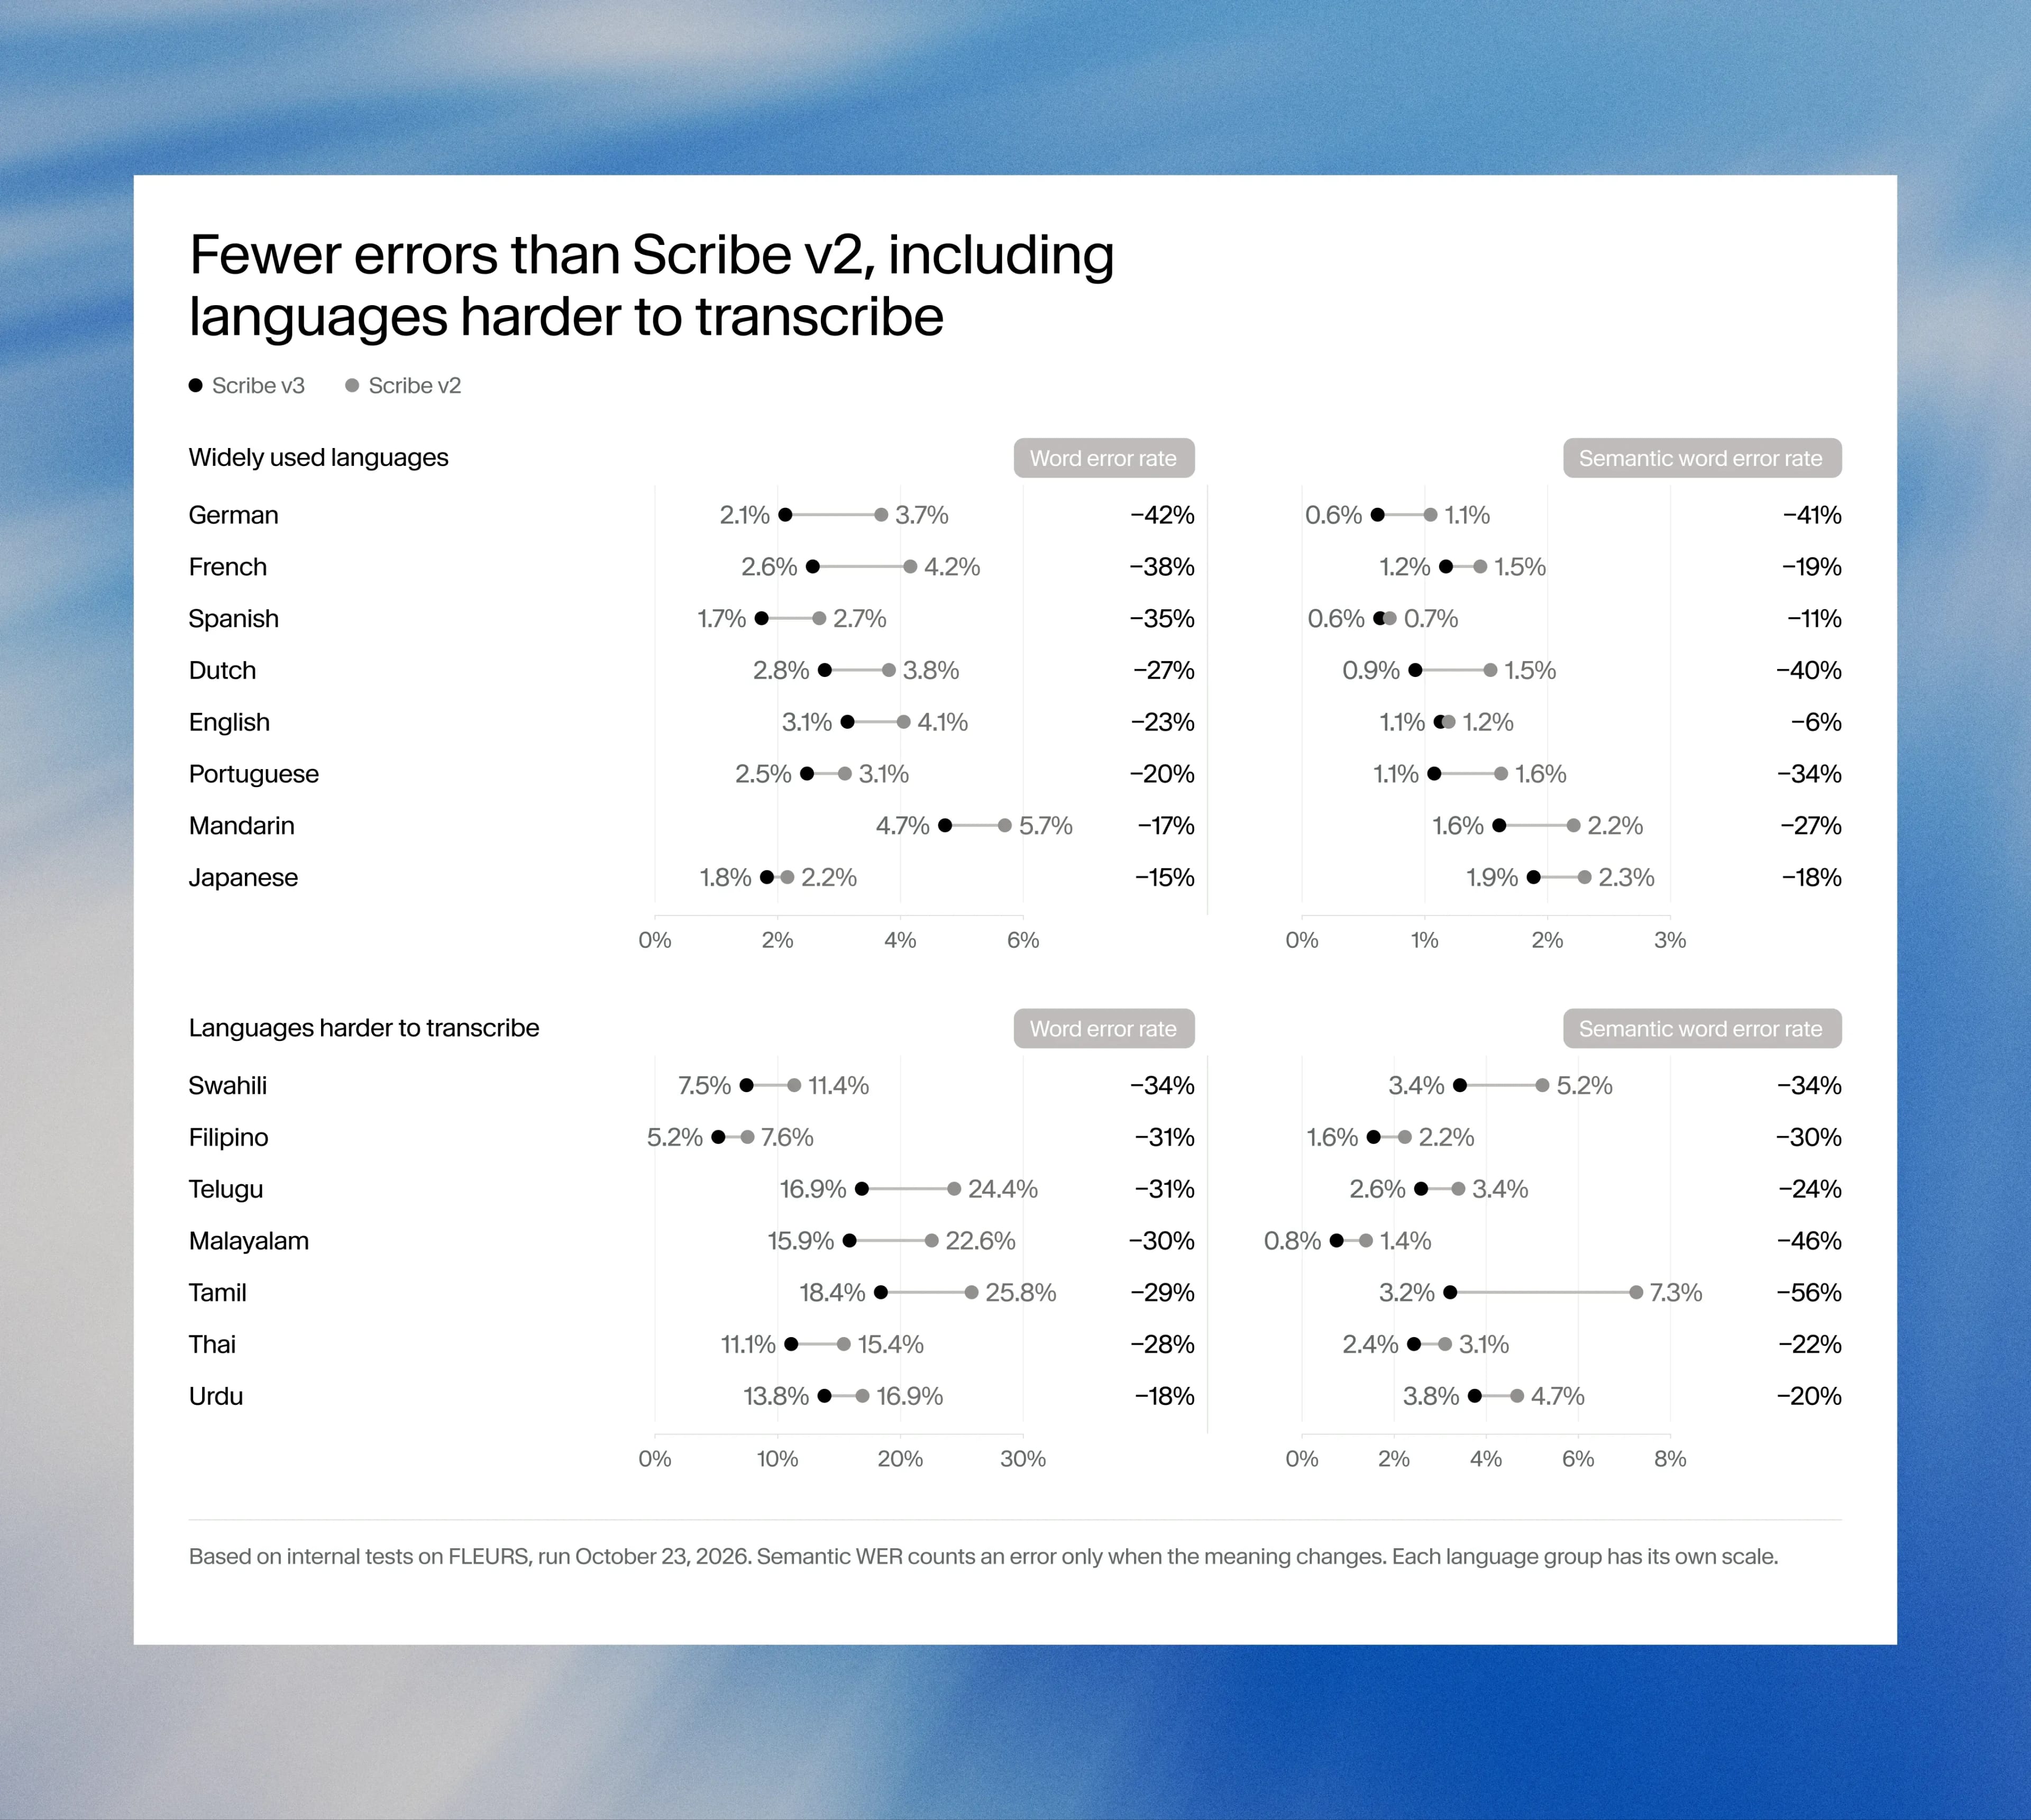
En los 102 idiomas de FLEURS, Scribe v3 reduce la WER un 27 % en comparación con Scribe v2 y mejora en todos los idiomas evaluados. En los idiomas más fáciles de transcribir, el alemán mejoró un 42 %, el español un 35 % y el inglés un 23 %. Las mejoras son mayores en los idiomas más difíciles de transcribir: el suajili reduce los errores un 34 %, el tamil un 29 % y el tailandés un 28 %.
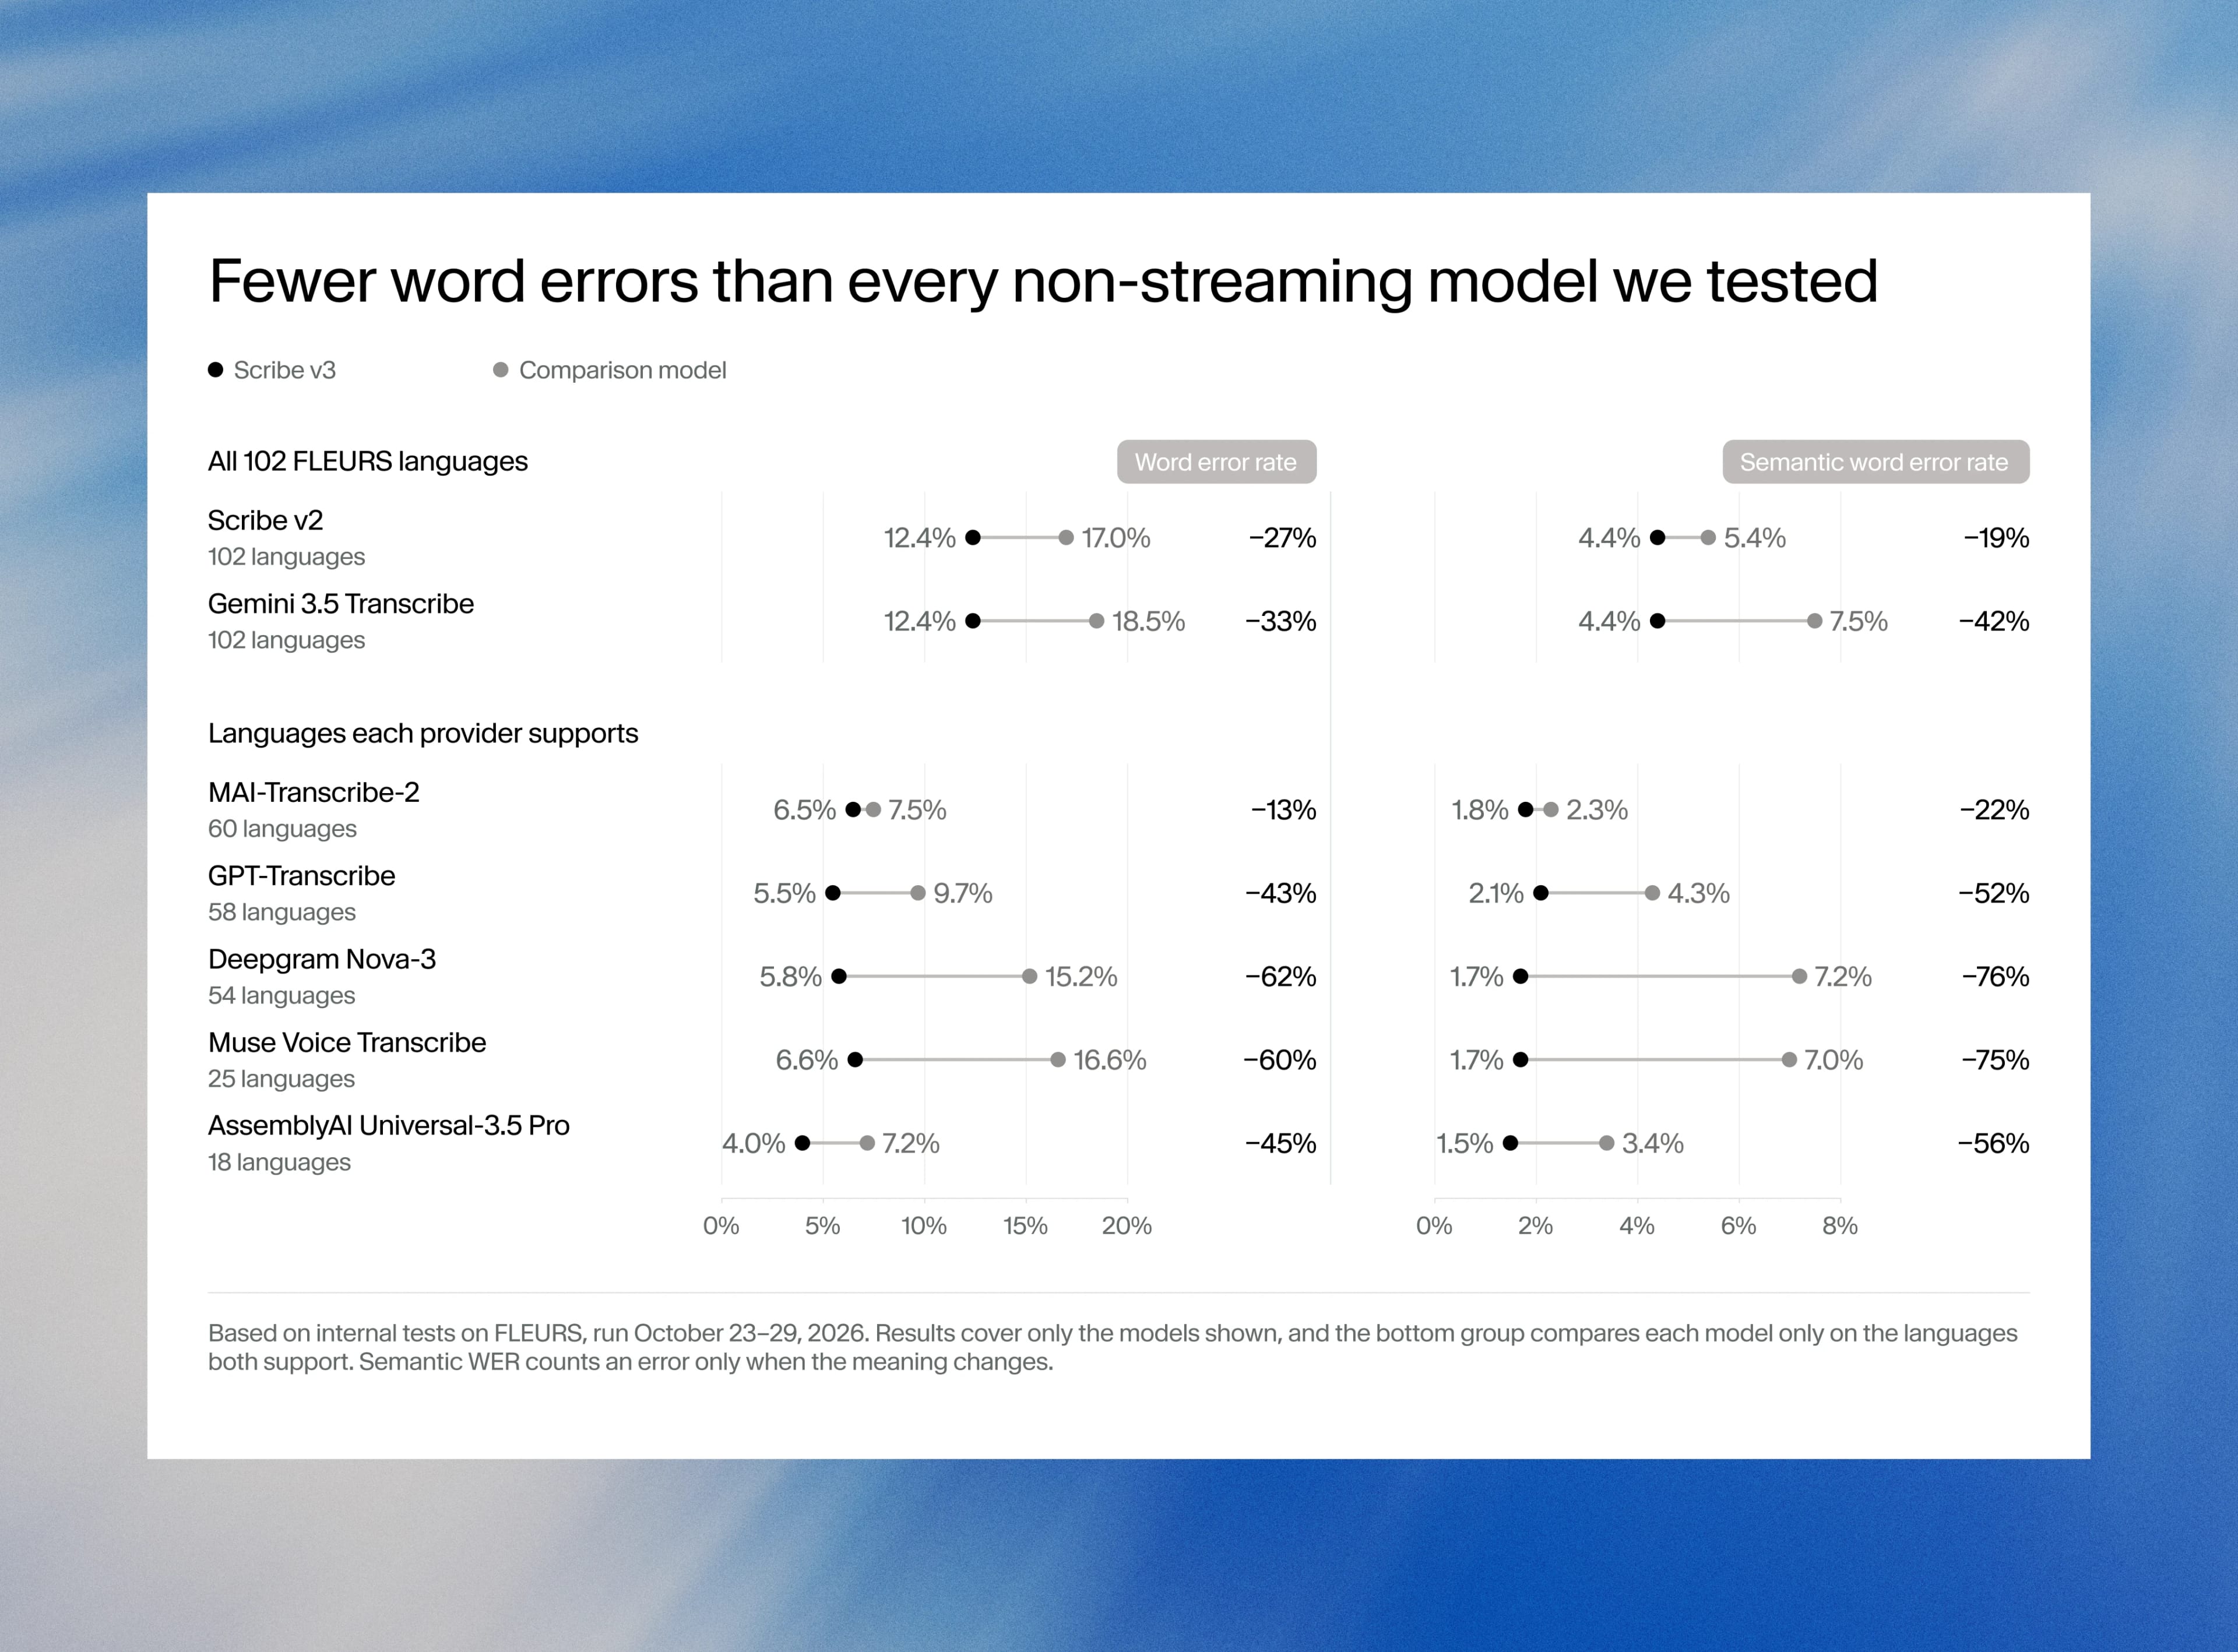
Scribe v3 también comete menos errores de palabras que cualquier otro modelo por lotes (sin streaming) que probamos, comparando cada uno en los idiomas que ambos modelos admiten.
Diarización de hablantes en tiempo real
En la parte en inglés de nuestro conjunto de datos del mundo real en 16 idiomas, Scribe v3 Live tiene una tasa de error de diarización del 3,1 %, frente al 5,9 % y el 7,3 % de los otros modelos en tiempo real que probamos.
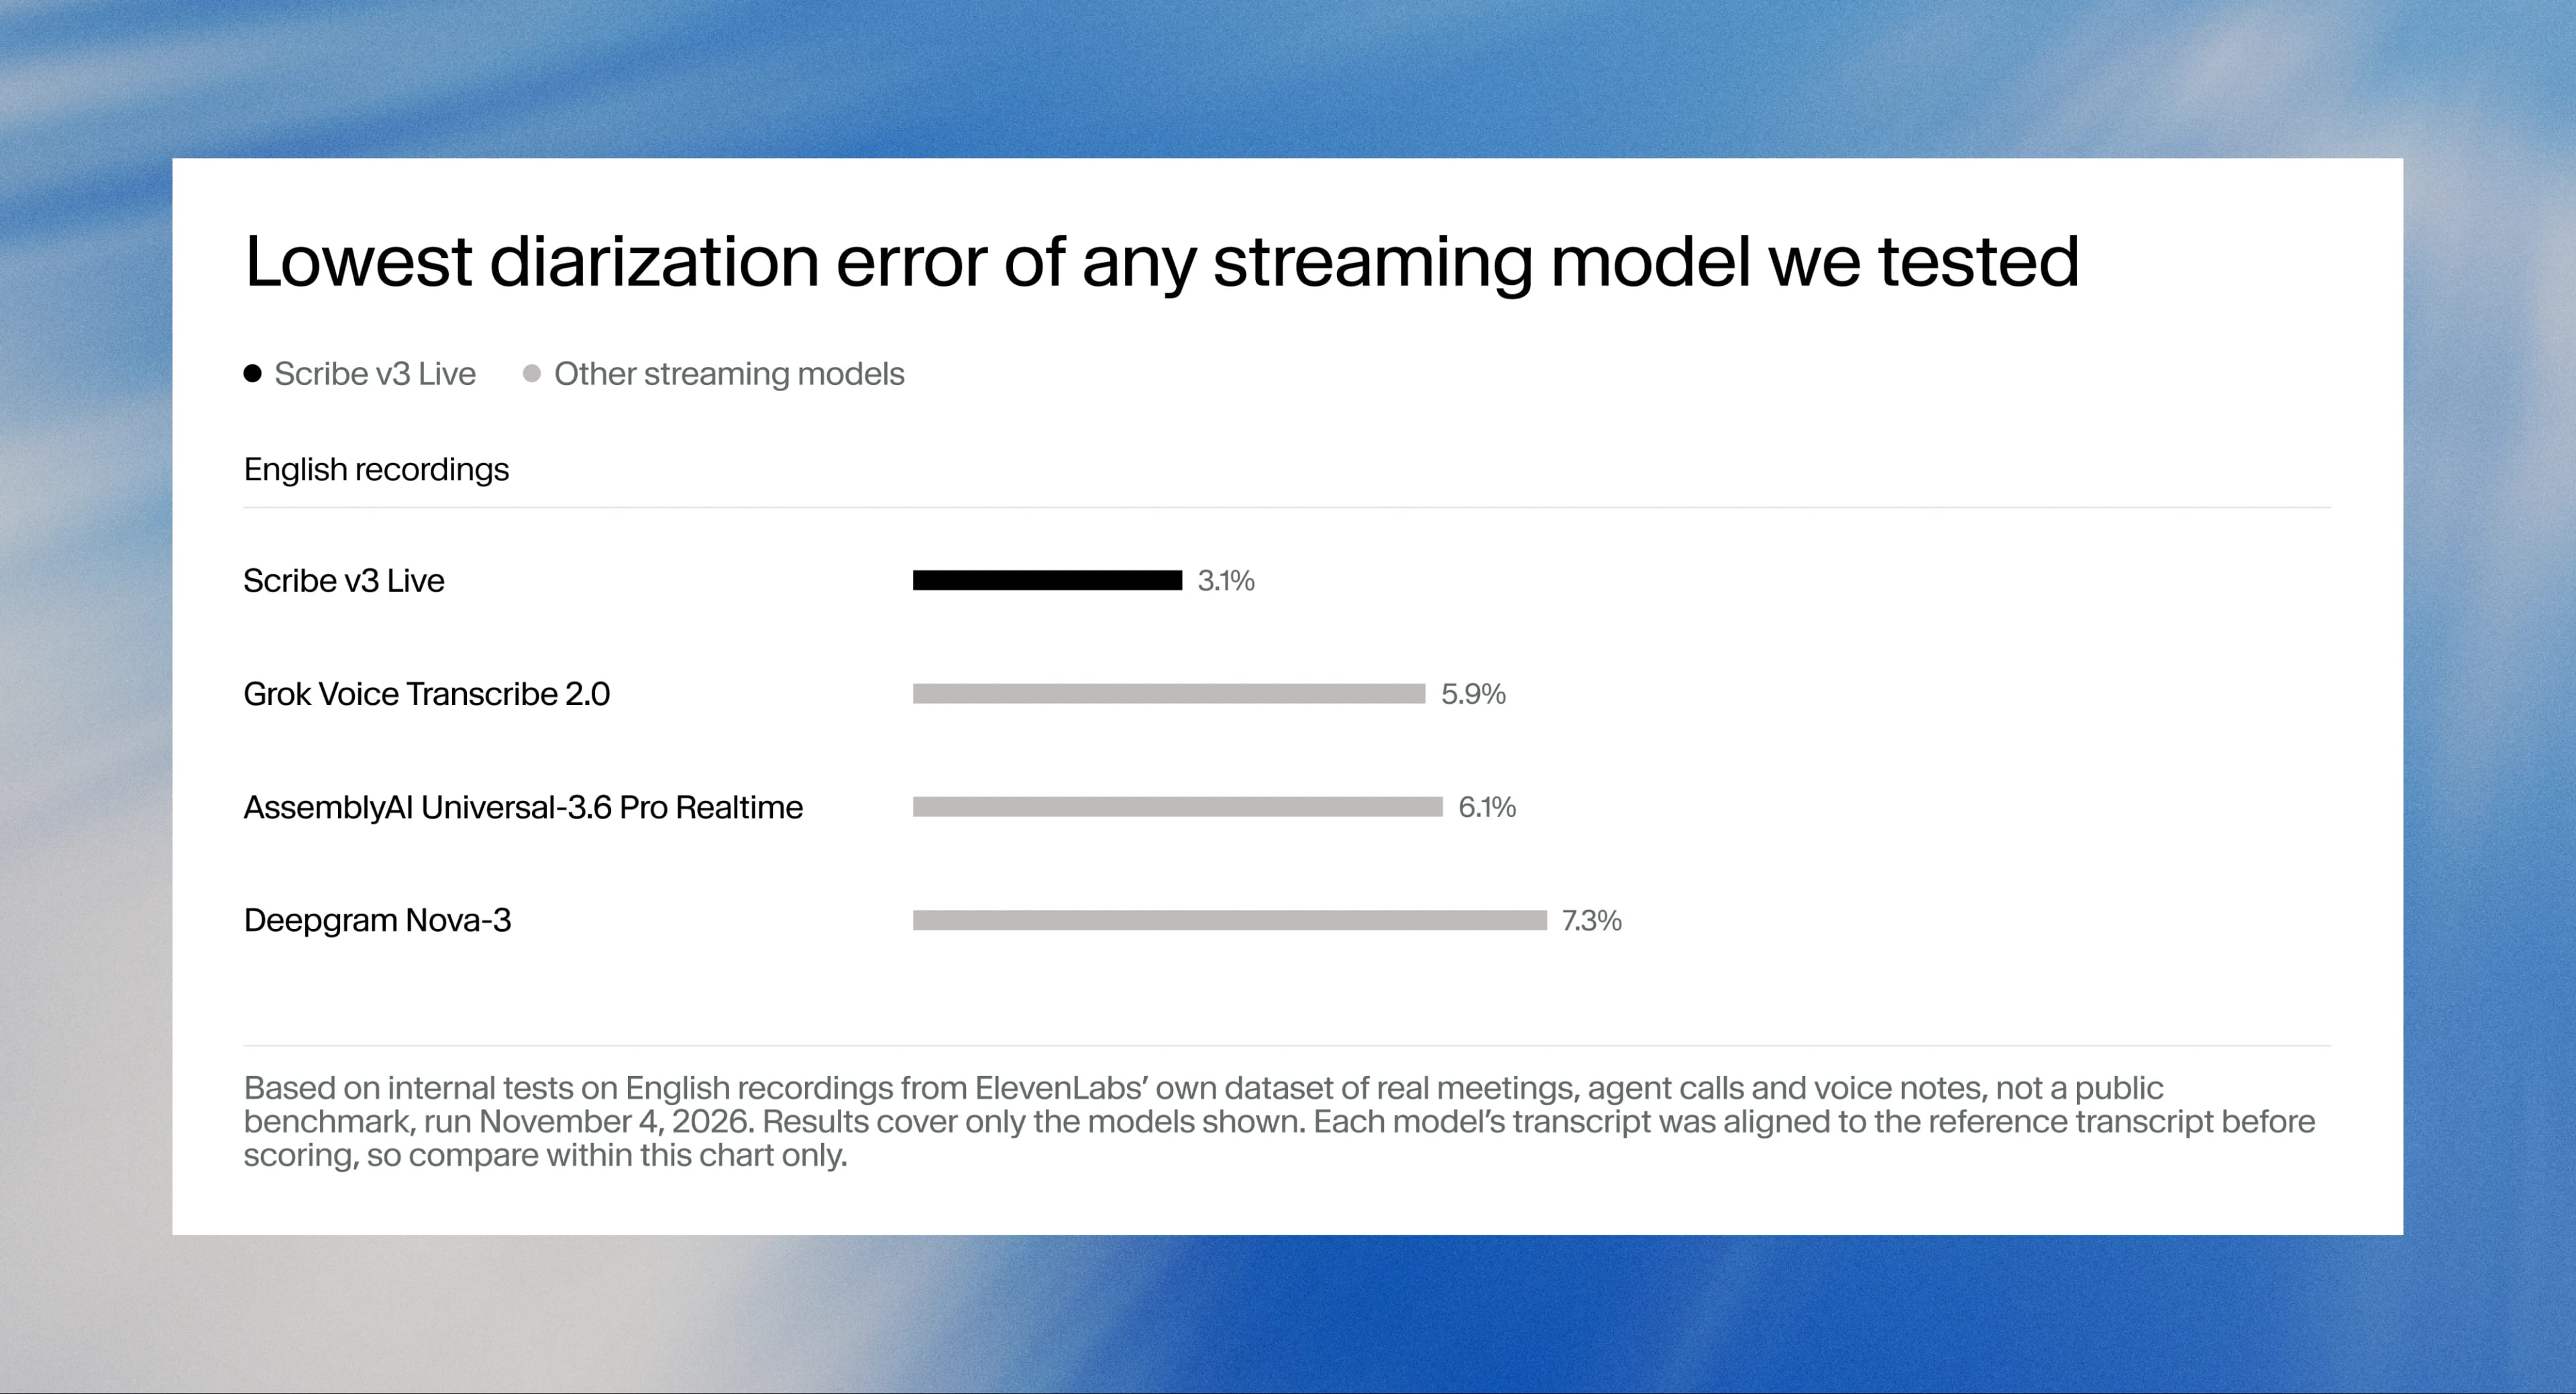
Las puntuaciones estándar de diarización también cuentan los errores de transcripción, como palabras omitidas, y los modelos en tiempo real omiten más palabras que los modelos por lotes. Para medir únicamente si cada palabra se asignaba al hablante correcto, alineamos la transcripción de cada modelo con la referencia antes de puntuarla. Esto reduce la tasa de error de todos los modelos, por lo que estos resultados no se pueden comparar con los resultados de diarización por lotes anteriores.
Precisión multilingüe en tiempo real
Para los modelos en tiempo real, priorizamos la WER semántica. Un modelo de streaming escribe texto antes de haber oído toda la frase, y cada proveedor formatea los números, la puntuación y las mayúsculas de forma distinta durante el proceso. La WER estándar cuenta esas diferencias como errores incluso cuando el significado es el mismo, así que la WER semántica es una comparación más justa.
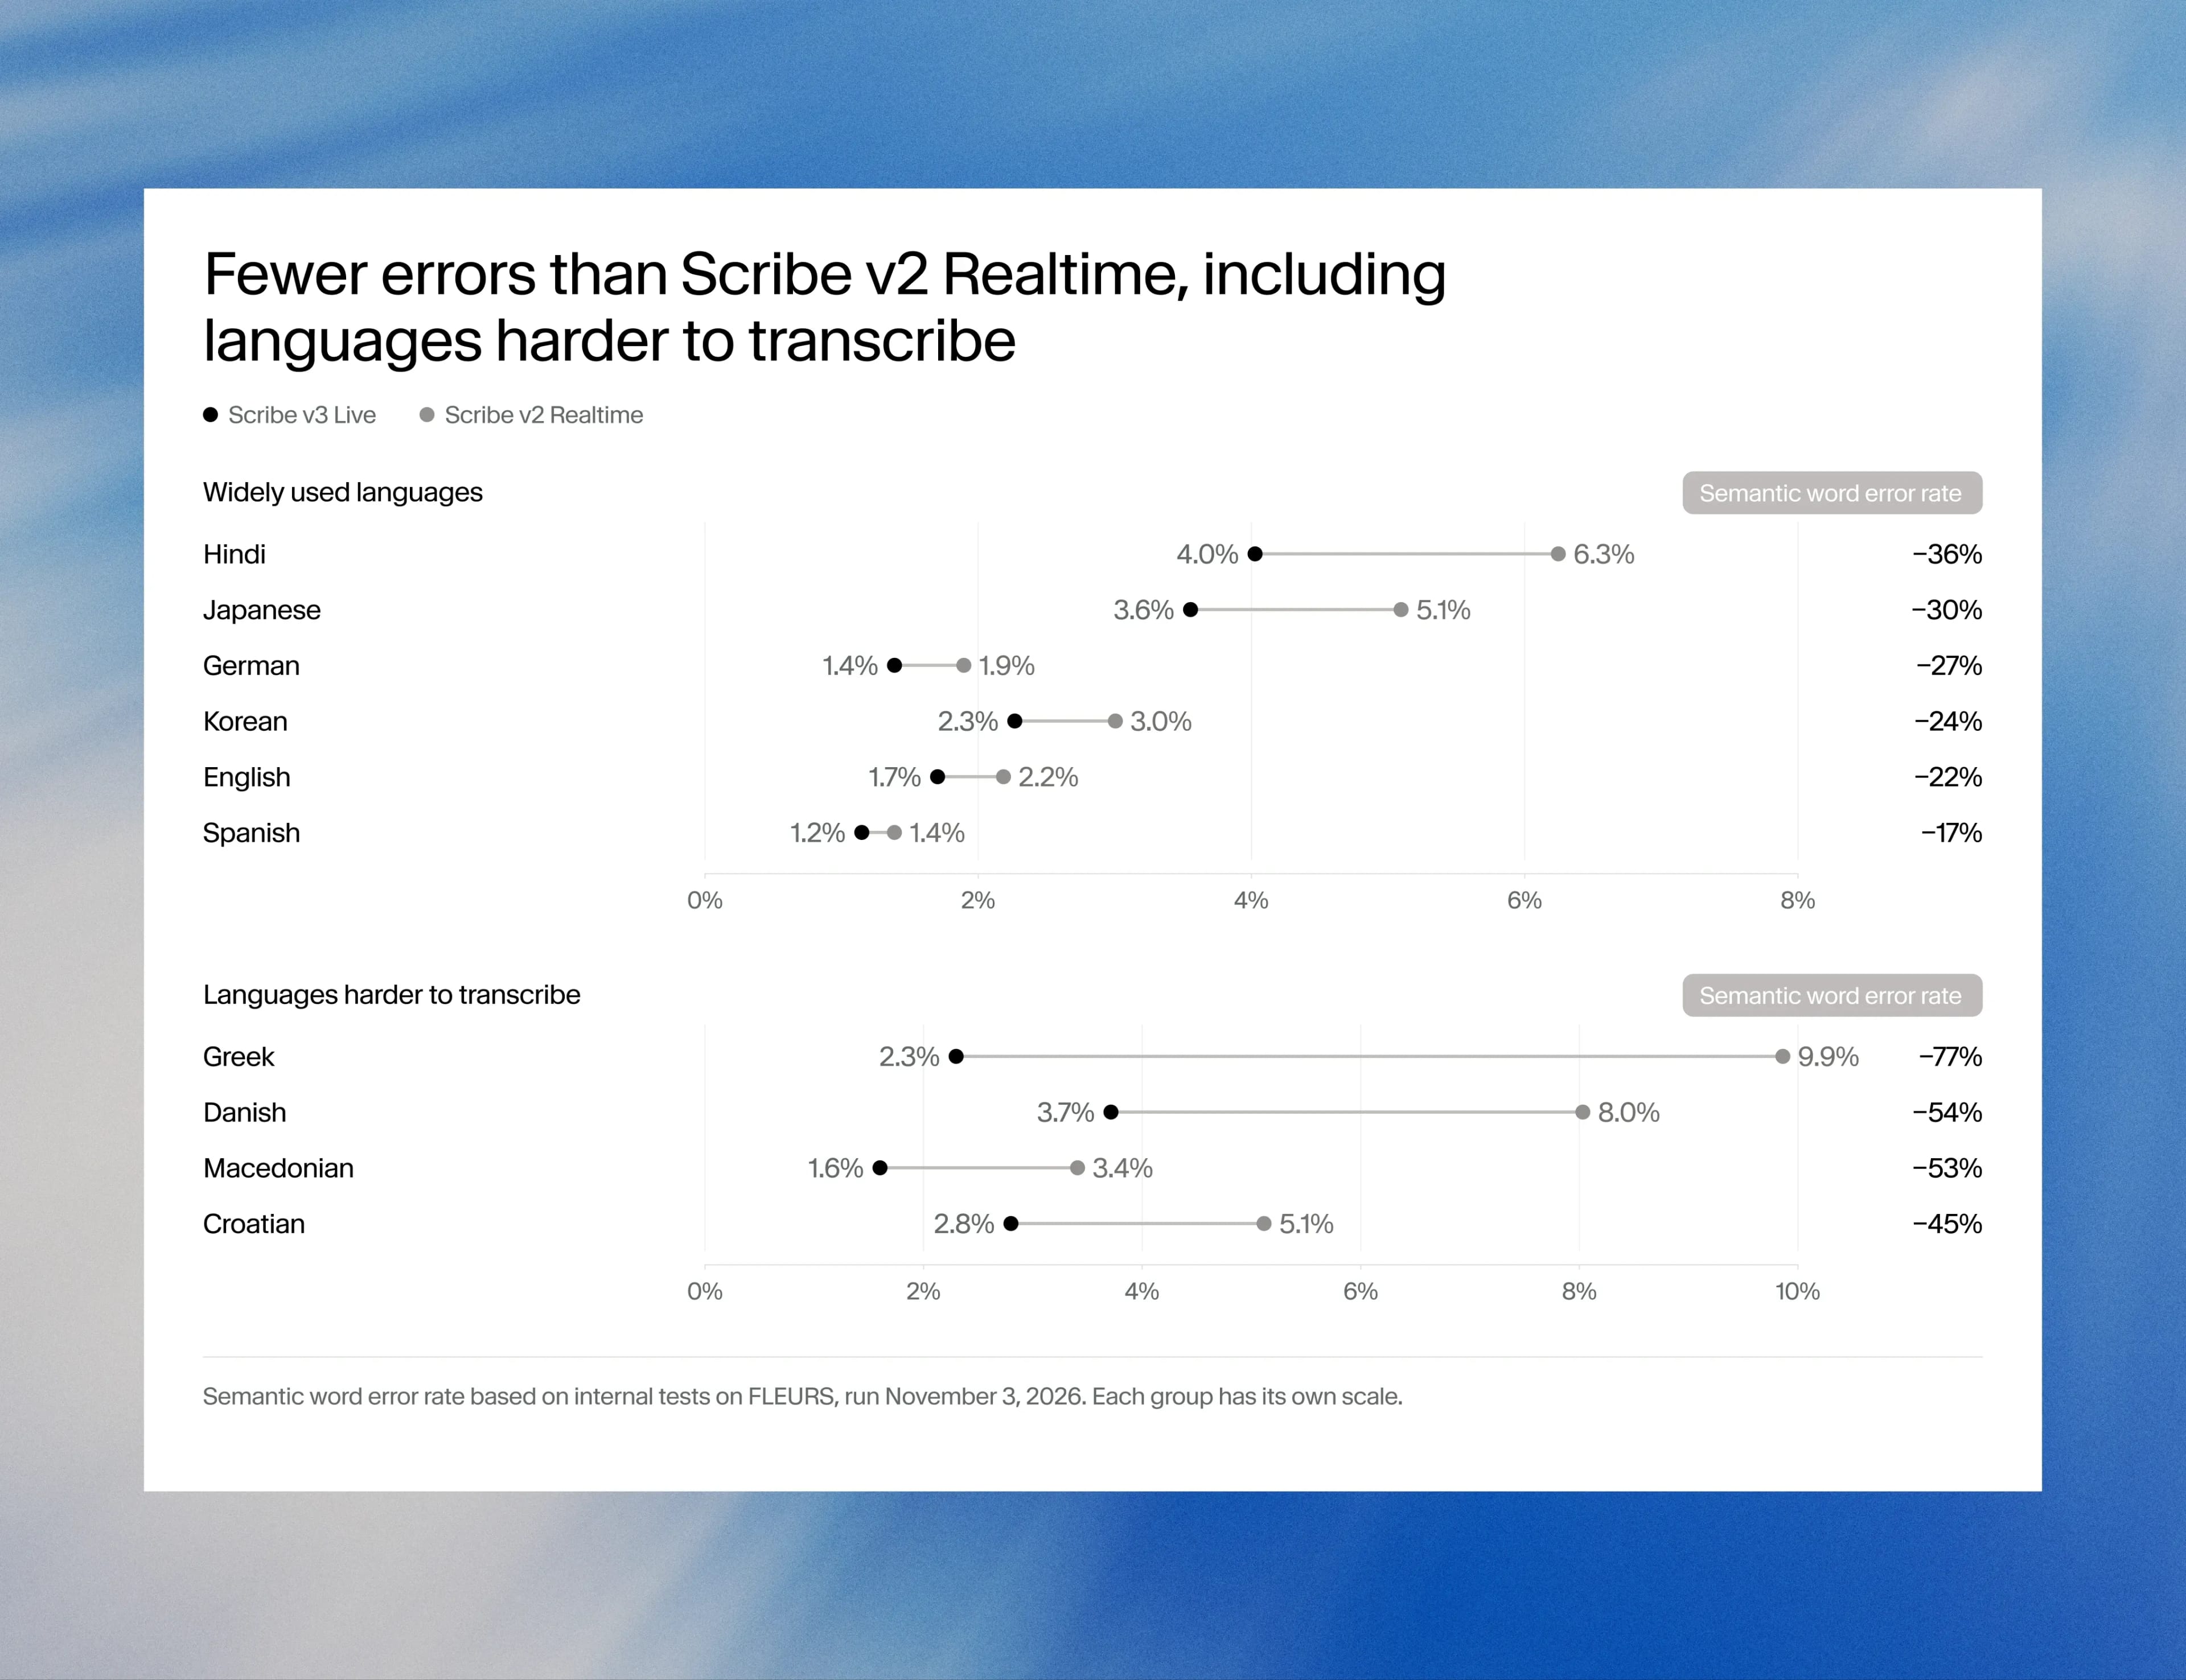
En 102 idiomas, Scribe v3 Live reduce la WER semántica un 43 % y la WER un 31 % en comparación con Scribe v2 Realtime. Mejora en todos los idiomas y tiene una tasa de error inferior a la de cualquier otro modelo en tiempo real que probamos.
Las mejoras son mayores donde la transcripción en tiempo real se ha quedado atrás: el griego mejora un 77 %, el danés un 54 % y el croata un 45 %, mientras que el hindi mejora un 36 %.
Una nota sobre la metodología: puntuamos cada idioma por separado antes de calcular la media, por lo que los 102 idiomas cuentan por igual. Muchos resultados publicados agrupan todos los clips en una sola puntuación, lo que suele dar cifras más bajas, así que los resultados medidos de formas distintas no son directamente comparables.
El valor de unos pocos puntos de precisión
Cada lanzamiento de un modelo viene acompañado de porcentajes, incluido este, y sobre el papel es difícil distinguir qué significan unos pocos puntos en situaciones reales. Una reunión de una hora a 150 palabras por minuto suma unas 9000 palabras, así que la diferencia entre una tasa de error de palabras del 4 % y otra del 2 % son 180 palabras incorrectas: tres por cada minuto que alguien ha hablado. El error de diarización se mide en tiempo, no en palabras, así que en esa misma reunión cada punto equivale a 36 segundos de habla bajo el nombre equivocado.
El coste de esos errores depende de dónde ocurran. En la transcripción de un pódcast, una palabra incorrecta es una errata, pero en una llamada de resultados, oír «quince» como «cincuenta» acaba en el modelo de un analista. Los errores también se concentran en nombres, números, acrónimos y jerga, precisamente las palabras que más necesitan acertar un resumen o un agente.
Acertar a la primera en ElevenAgents
Los agentes de voz son quienes más lo notan, porque un solo dígito mal entendido puede hacer fallar la comprobación que inicia la llamada. Eneco, que suministra energía a más de 2 millones de hogares y empresas en los Países Bajos, ejecuta su agente de voz en ElevenAgents y probó Scribe v3 Live antes de su lanzamiento. En llamadas reales de clientes, el agente reconoció correctamente los códigos postales neerlandeses al primer intento un 40 % más de veces y los números de portal un 15 % más de veces.
«ElevenLabs es un verdadero socio para Eneco. Junto con sus ingenieros desplegados en nuestro equipo, trabajamos para seguir mejorando nuestro agente de voz», afirma Ruud Huigsloot, Senior Product Manager de Eneco. «Es fantástico ver resultados tan significativos tan pronto y nos entusiasma seguir colaborando».
Diseñado para empresas
Scribe v3 y Scribe v3 Live se ejecutan en EE. UU. de forma predeterminada y se ofrecen en entornos aislados de la UE, India y Singapur para clientes empresariales con requisitos de residencia de datos. Zero Retention Mode elimina el audio y el texto en cuanto finaliza una solicitud. Ambos modelos están cubiertos por nuestros programas SOC 2, ISO 27001 y PCI DSS de nivel 1, son aptos para HIPAA con un Acuerdo de Socio Comercial y están disponibles para implementaciones privadas.
Empieza hoy
Scribe v3 Live está disponible en ElevenAgents, y tanto v3 como v3 Live son los modelos predeterminados en la app de ElevenLabs. Regístrate para probarlos.
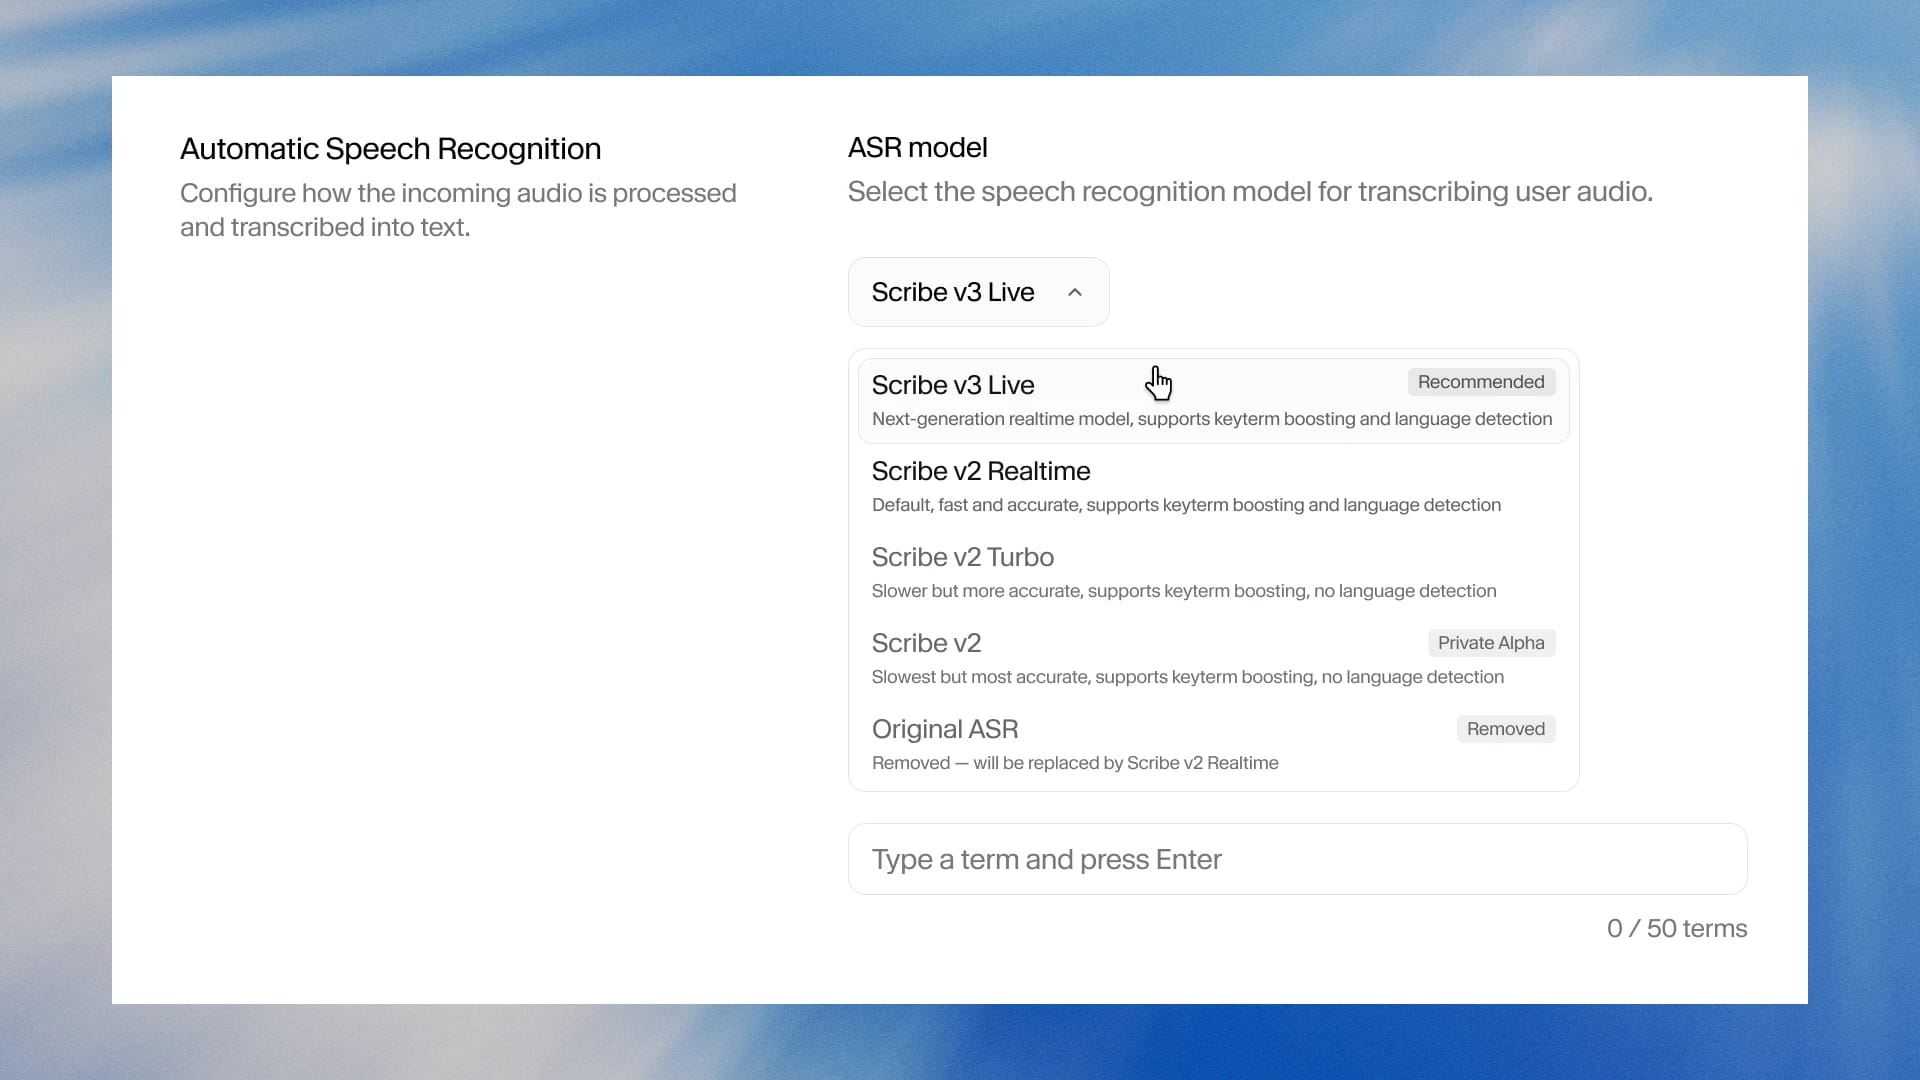
Ambos modelos también están disponibles hoy en ElevenAPI. Las integraciones existentes se actualizan cambiando el ID del modelo a scribe_v3 o scribe_v3_live.
Para equipos sanitarios, también lanzamos una versión de Scribe v3 Live optimizada para conversaciones médicas en ElevenAgents.
Min forma parte del equipo de Growth de ElevenLabs y se encarga de ElevenAPI y las soluciones On-Prem/On-Device. Anteriormente, lideró el marketing de producto en Stainless como la segunda incorporación al equipo de GTM y, antes de eso, fue uno de los primeros responsables de marketing de producto en WorkOS, donde impulsó lanzamientos, capacitación, contenido y crecimiento.