Presentamos Eleven Realtime: una forma más sencilla de crear agentes de voz naturales
- Escrito por
- Min Kim
- Publicado
- Última actualización
EscucharEscucha este artículo
Crear hoy un agente de voz que suene natural requiere tomar muchas decisiones. Tienes que elegir componentes individuales como el reconocimiento de voz, la detección de actividad de voz, la gestión de turnos, el LLM subyacente y la conversión de texto a voz. Crear esta pila ya es un proyecto en sí mismo, y conseguir que todos los componentes funcionen bien juntos exige más pruebas y ajustes.
Eleven Realtime es una nueva clase de modelos de Voz a Voz que elimina esos obstáculos. Cada modelo es un agente de voz completo, optimizado para casos de uso distintos. Ambos admiten más de 90 idiomas y pueden usar cualquiera de las más de 17.000 voces de la biblioteca de ElevenLabs:
Hoy lanzamos:
- Eleven Realtime v1 Mini para conversaciones naturales a bajo coste. Es la mejor opción para asistentes de IA, profesores y personajes interactivos, y será suficiente para la mayoría de casos de uso.
- Eleven Realtime v1 Max para tareas complejas. Es ideal para atención al cliente, cualificación de leads y workflows de varios pasos, donde el agente debe seguir un proceso y razonar paso a paso.
Por qué creamos modelos en tiempo real
No deberías tener que convertirte en experto en configuración para crear un agente de voz que suene natural. Conseguir que un agente se sienta y suene bien depende de pequeñas decisiones que requieren matices, como cuánto esperar tras una pausa antes de responder, cómo recuperarse cuando usuario interrumpe al agente y cómo funcionan conjuntamente la voz, los prompts y un modelo. En ElevenAgents, puedes ajustar todos estos parámetros.
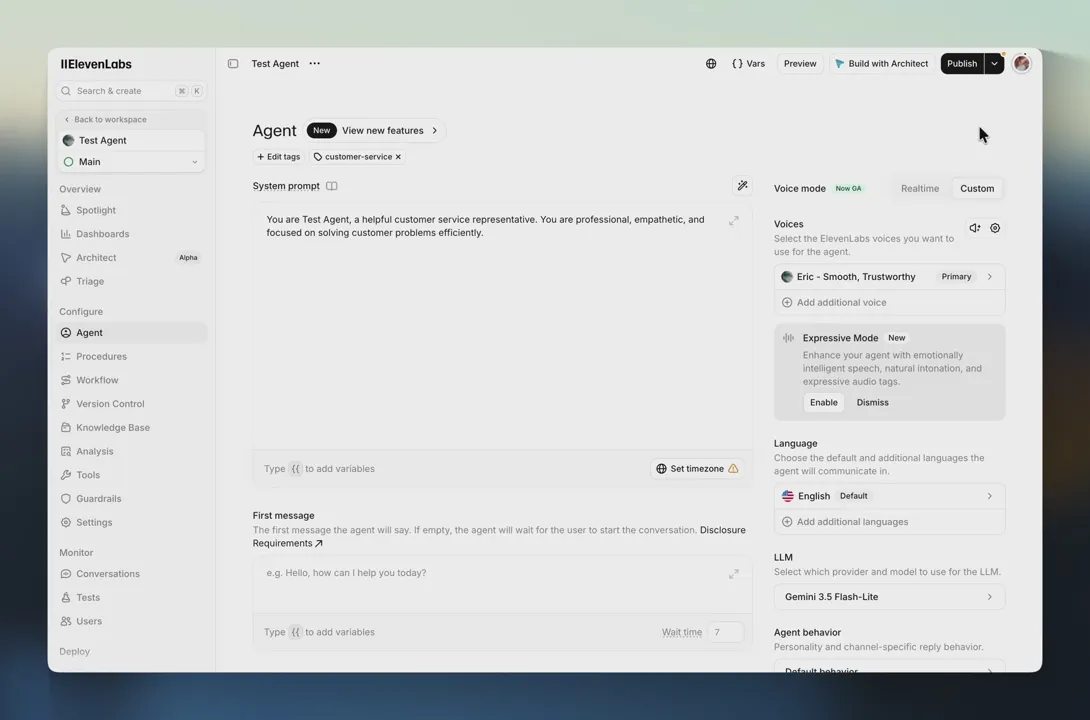
Lo mismo ocurre con desarrolladores que ya usan una API en tiempo real. La nuestra es compatible con la API Realtime de OpenAI, así que probar Eleven Realtime solo implica cambiar la ruta de API y el nombre del modelo en el código que quizá ya tengas.
Basado en una arquitectura en cascada
Eleven Realtime se basa en una arquitectura en cascada de los componentes descritos anteriormente, ajustada de extremo a extremo. Los llamamos modelos de Voz a Voz porque eso es lo que obtienes: audio de entrada, audio de salida, un ID de modelo y un sistema que puede medirse en las mismas clasificaciones que los modelos fusionados y dúplex.
Los modelos fusionados establecieron inicialmente el estándar de lo natural que puede sentirse un agente de voz, mientras que una configuración en cascada implicaba más latencia en cada transferencia y componentes que nunca se ajustaban entre sí. Realtime elimina ese compromiso, y el ajuste que antes era tu proyecto ya está hecho.
La arquitectura en cascada también tiene ventajas prácticas en producción, porque cada paso genera texto. Puedes ver qué ha oído el agente y qué ha decidido decir, así que puedes distinguir una palabra mal entendida de una decisión equivocada. Ese mismo texto permite a ElevenAgents aplicar barreras de seguridad y ocultación de información personal identificable a un agente Realtime.
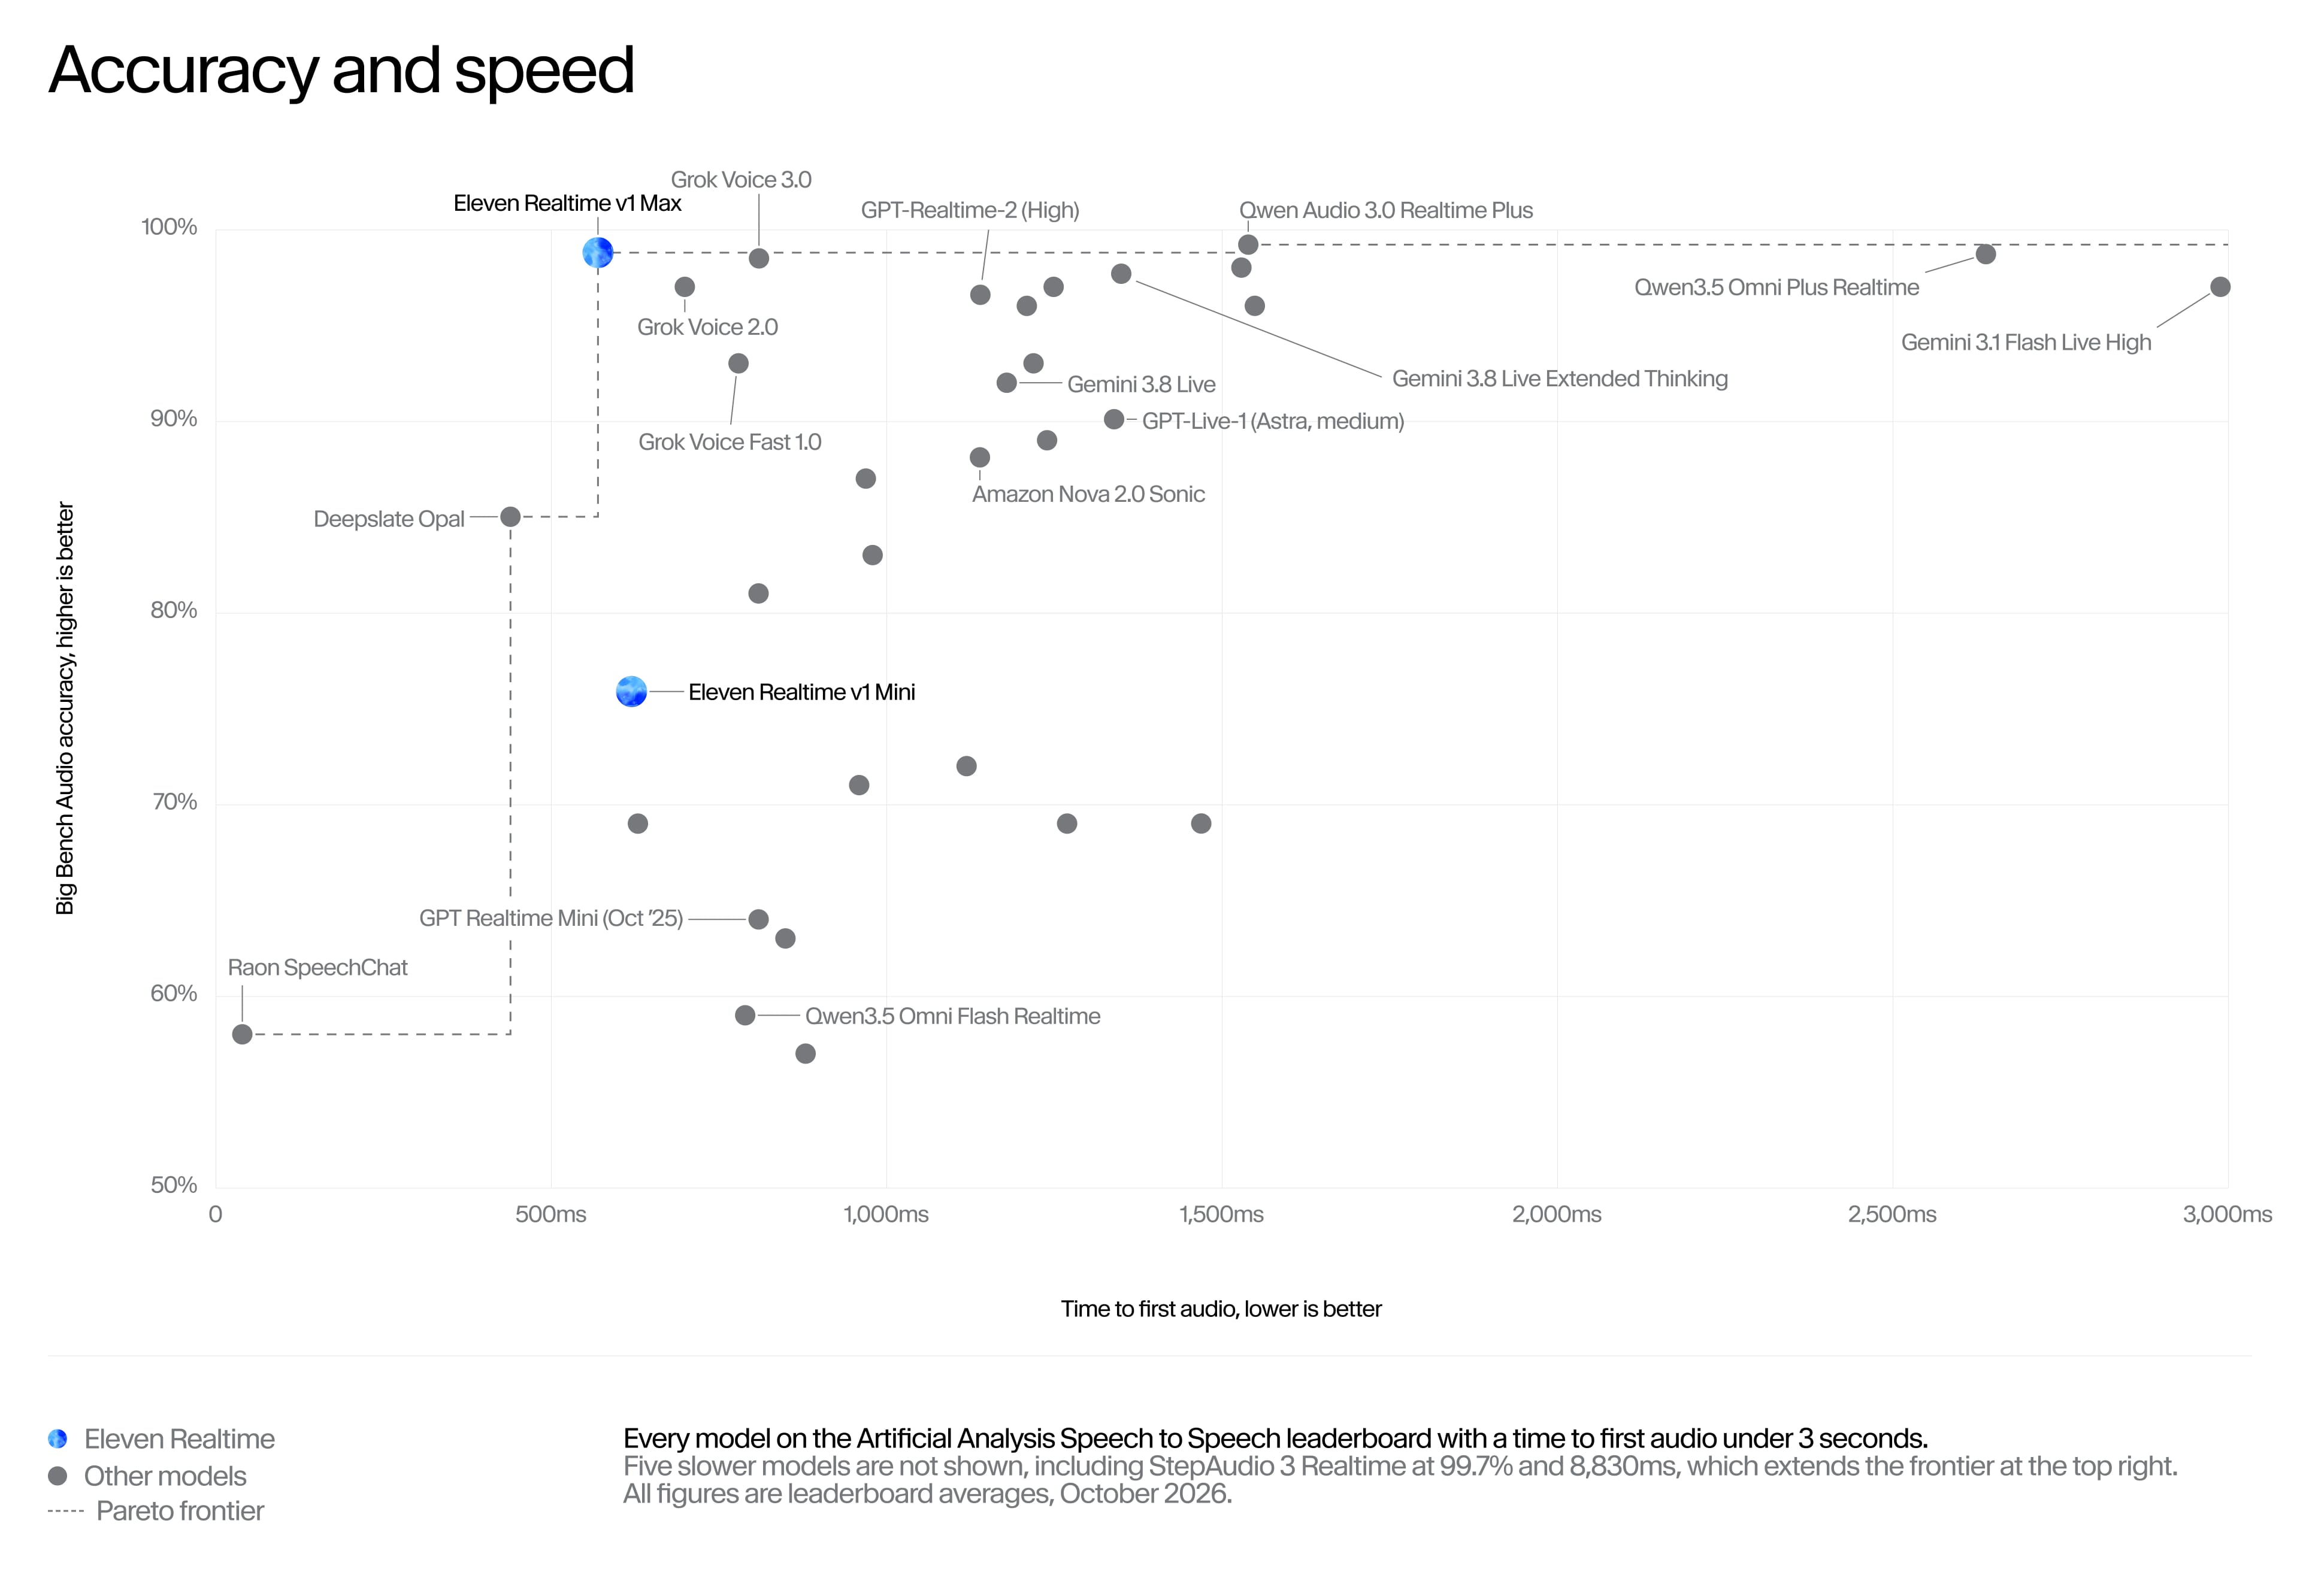
Los benchmarks de abajo comprueban si ese compromiso realmente ha desaparecido. En dinámica conversacional, ambos modelos obtienen resultados en la misma franja que los modelos fusionados. En precisión y velocidad combinadas, ningún modelo de la clasificación de Artificial Analysis es a la vez más rápido y más preciso que v1 Max.
Cómo rinden
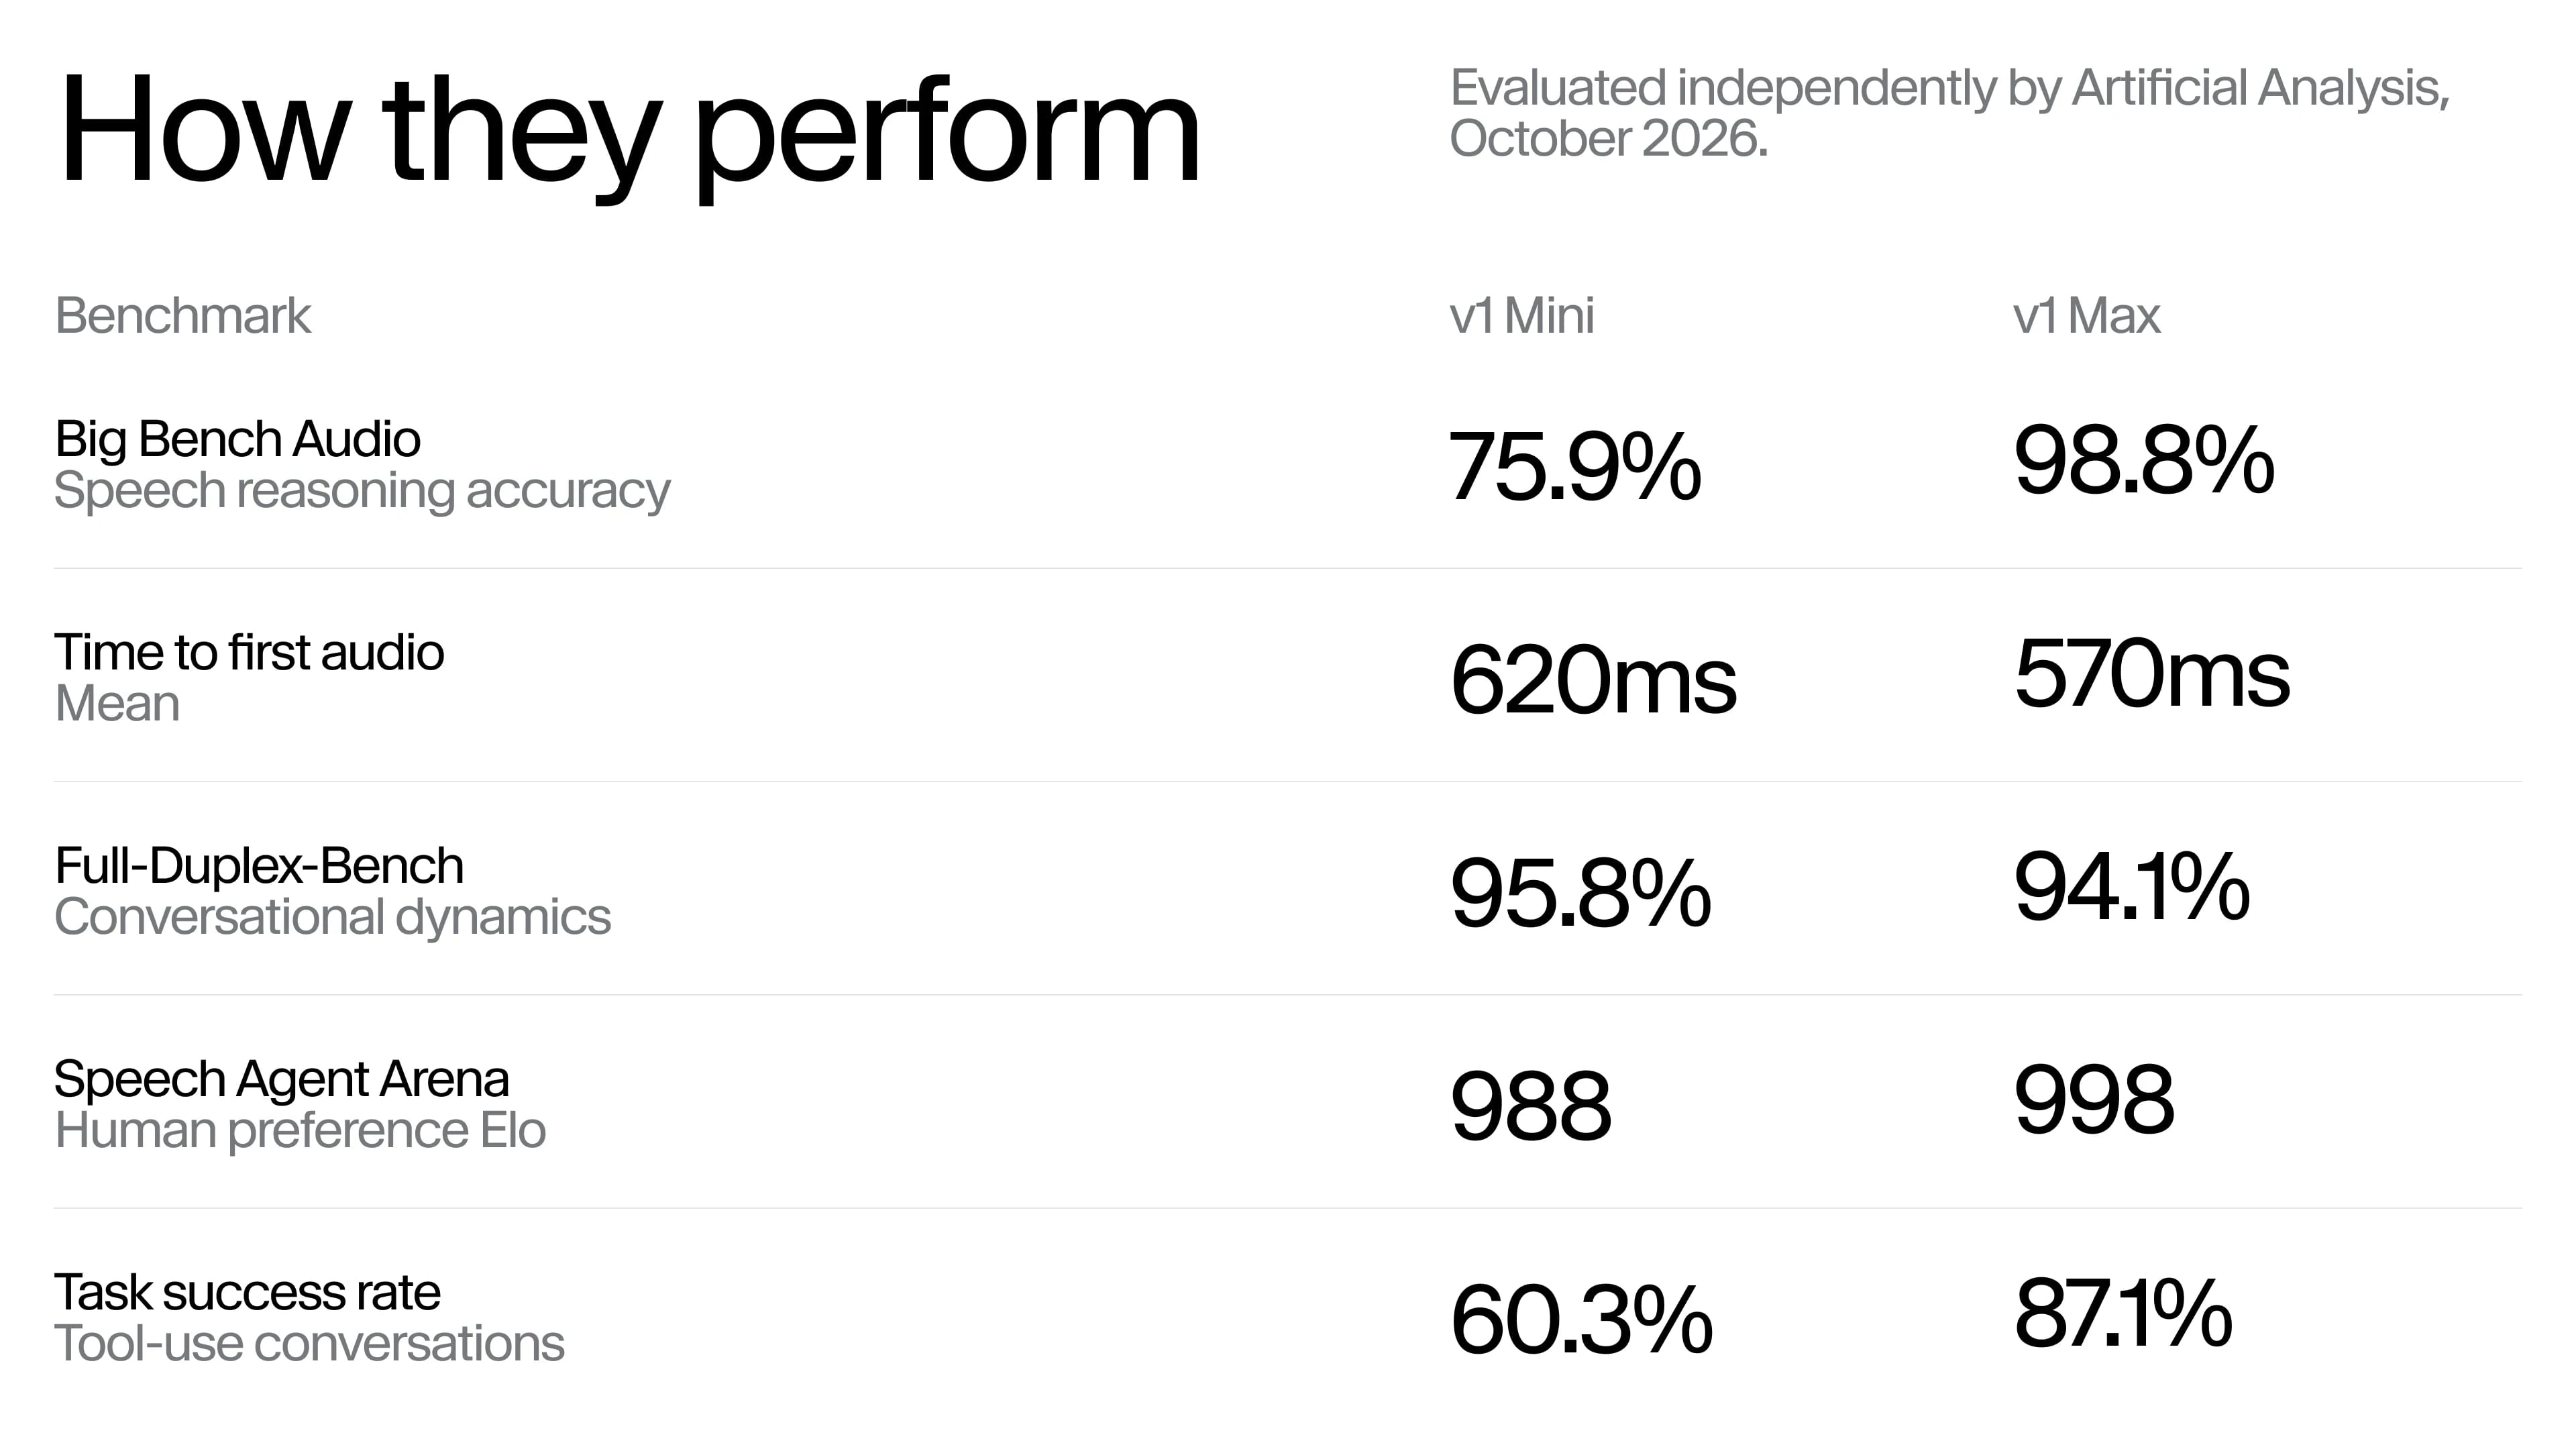
Artificial Analysis evaluó ambos modelos de forma independiente en tres benchmarks públicos: Big Bench Audio para razonamiento por voz, Full-Duplex-Bench para dinámica conversacional y Speech Agent Arena para preferencias humanas y éxito en las tareas.
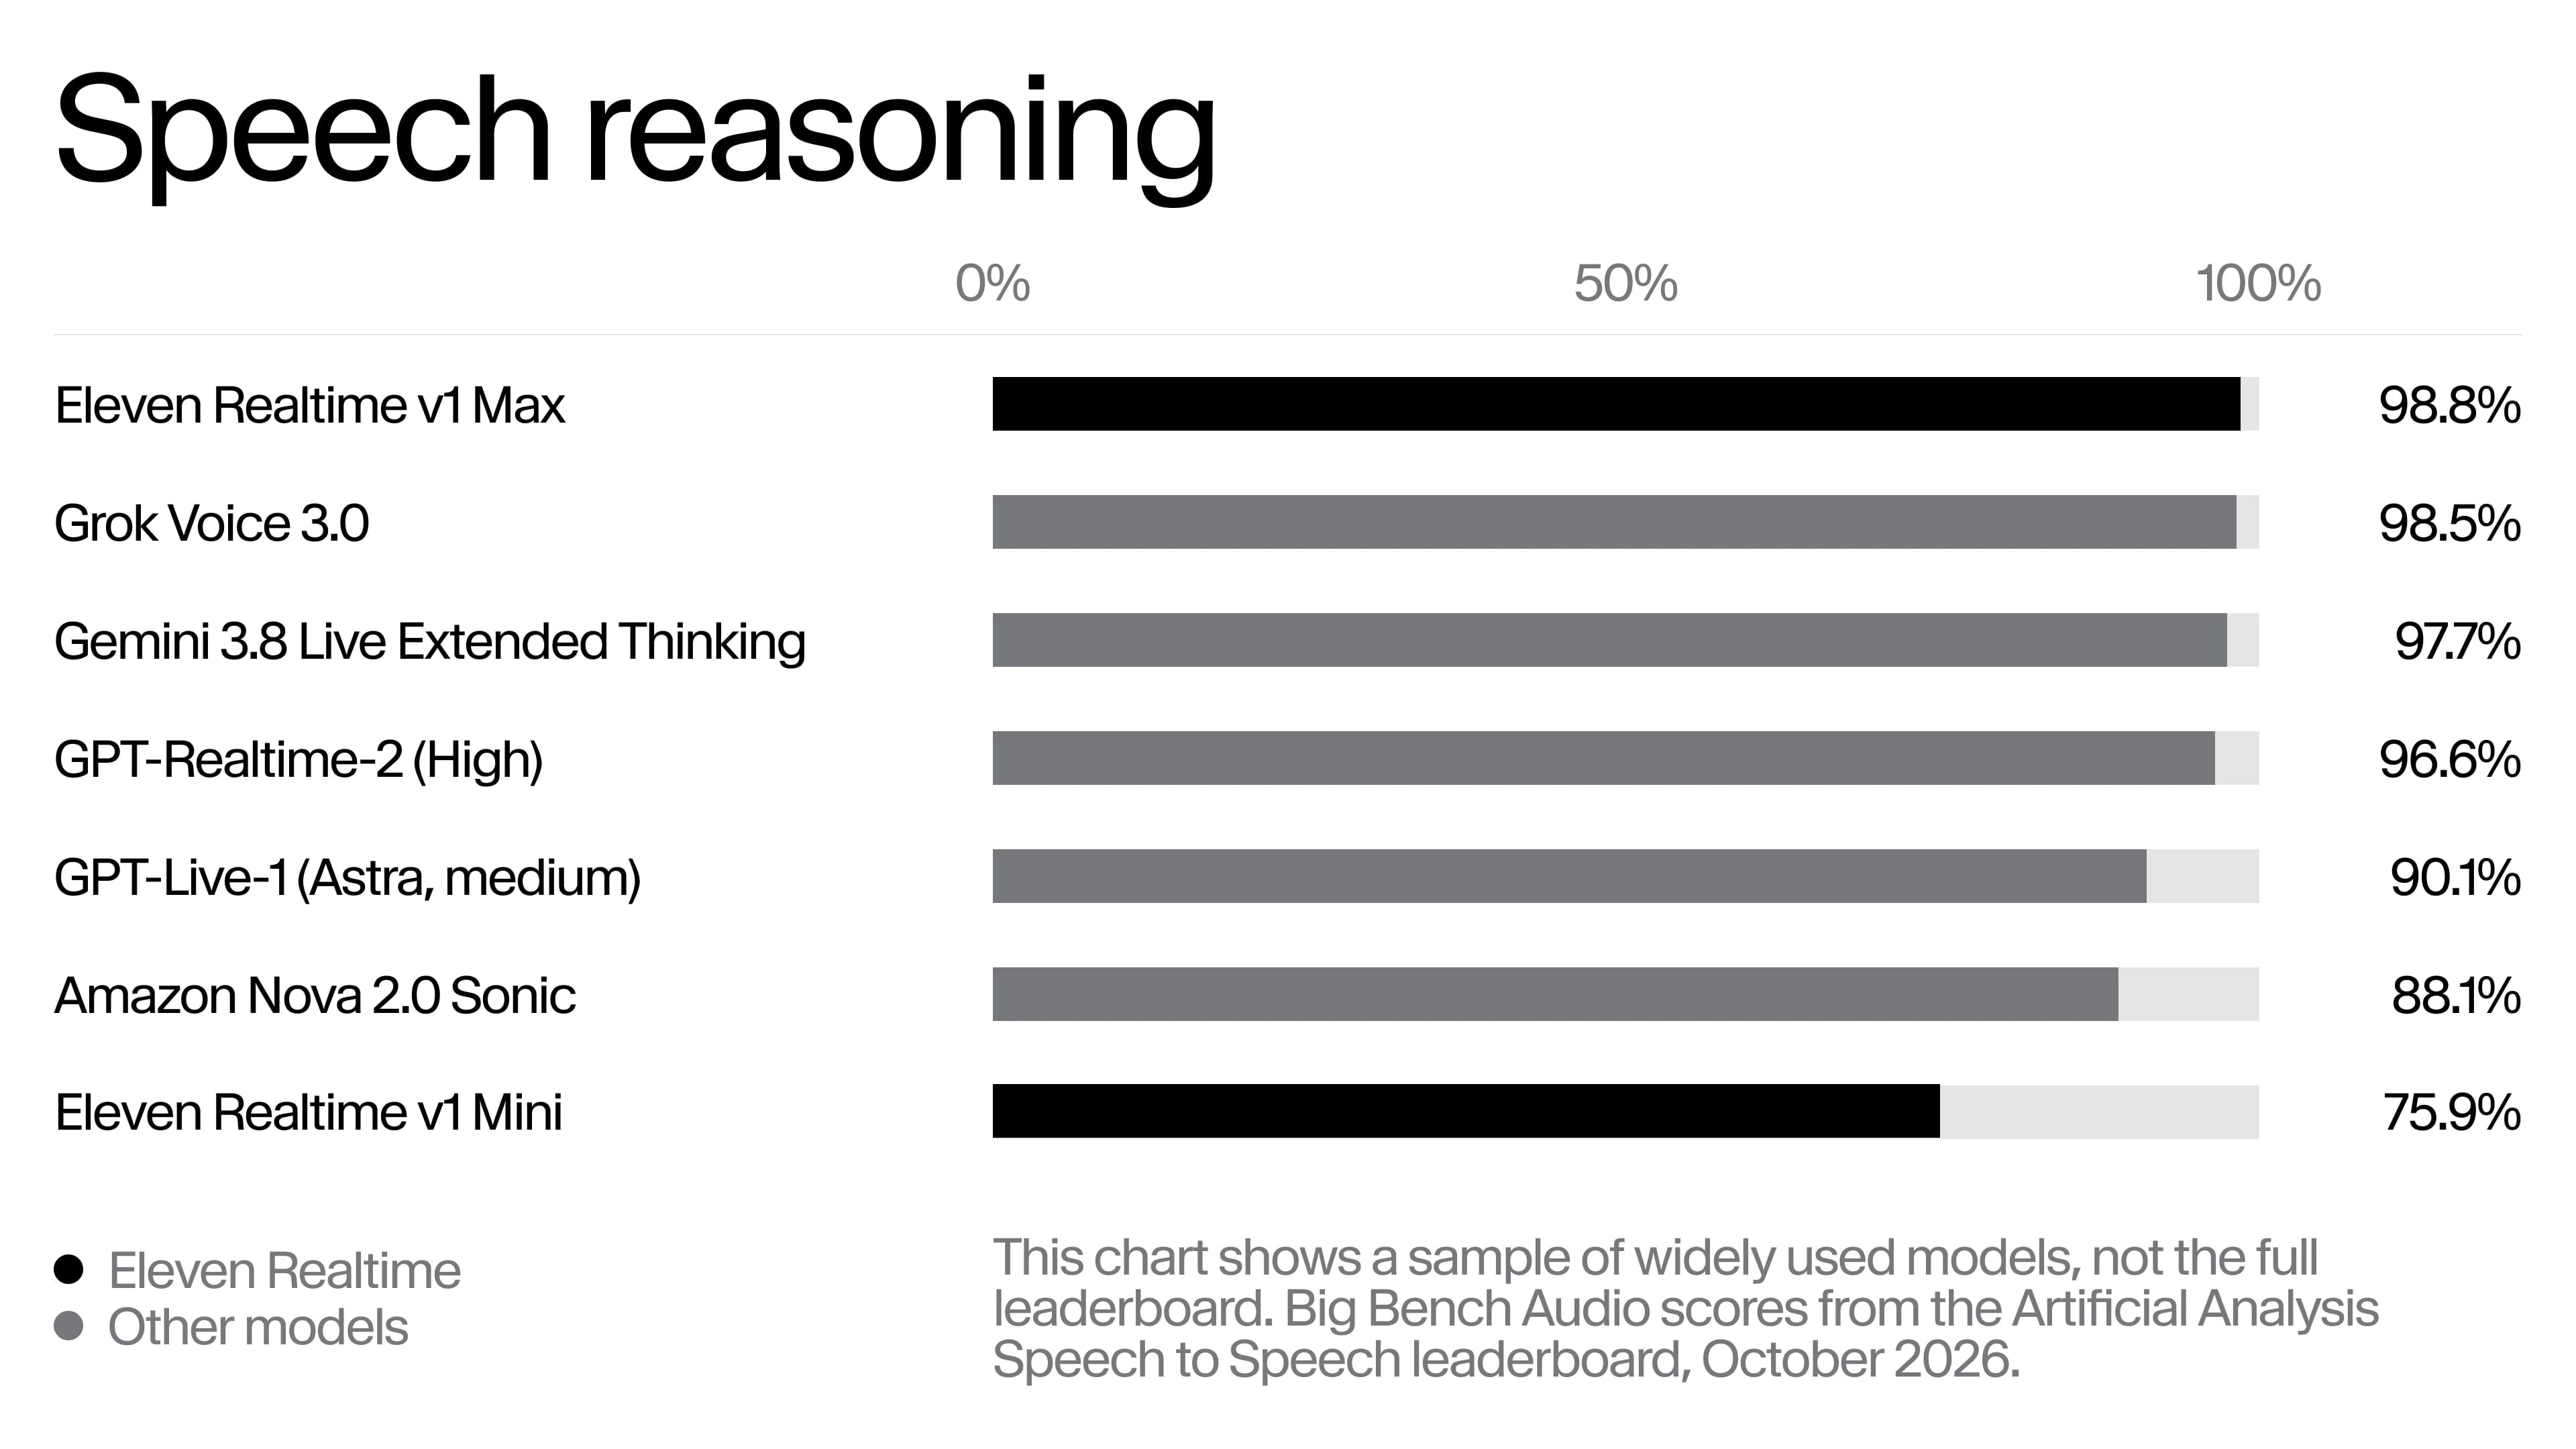
Razonamiento por voz
Big Bench Audio plantea 1.000 preguntas de razonamiento por voz y evalúa la respuesta hablada. Realtime v1 Max respondió correctamente al 98,8 % de las preguntas y v1 Mini al 75,9 %.
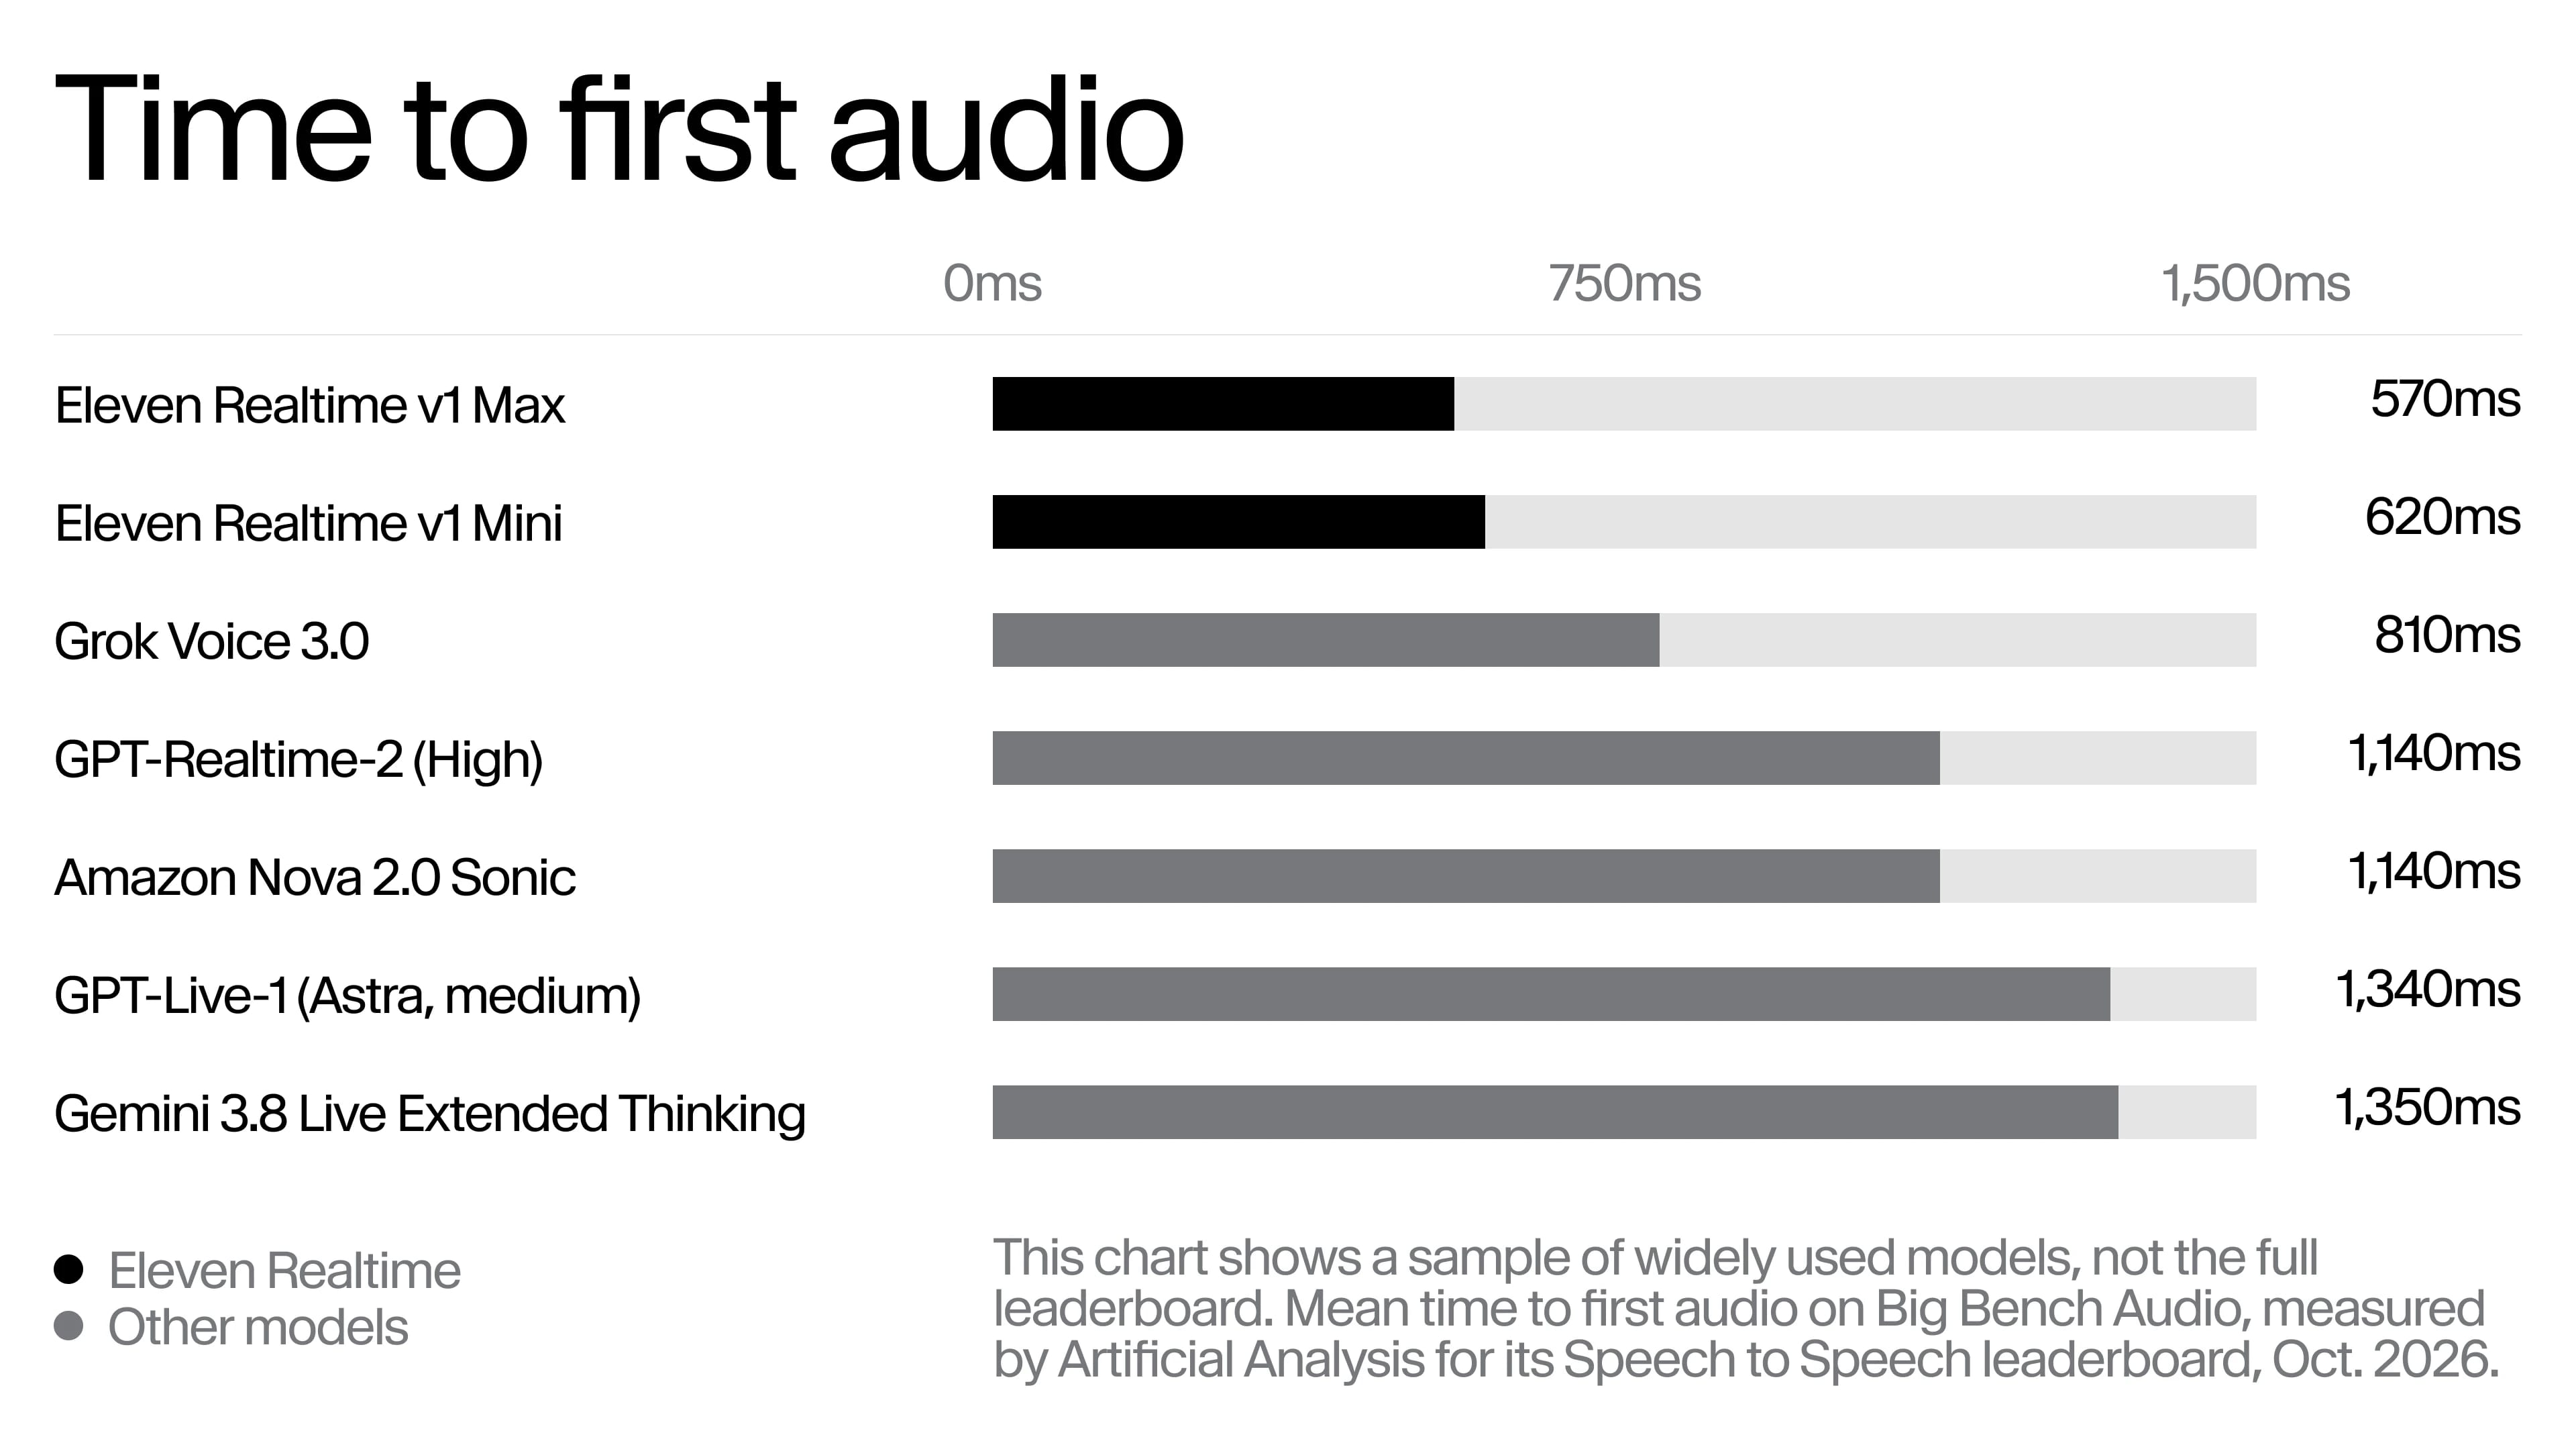
Velocidad
Big Bench Audio plantea 1.000 preguntas de razonamiento por voz y evalúa la respuesta hablada. V1 Max empieza a hablar en 0,57 segundos de media y v1 Mini en 0,62 segundos.
La frontera de Pareto de precisión y velocidad
La precisión y la velocidad suelen considerarse un compromiso. Los modelos que obtienen las puntuaciones más altas en Big Bench Audio son los que más tardan en responder, y los más rápidos sacrifican mucha precisión. v1 Max destaca en ambas métricas.
Dinámica conversacional y preferencias humanas
En Full-Duplex-Bench, que evalúa pausas, gestión de turnos, interrupciones y señales de escucha, v1 Mini obtiene un 95,8 % y v1 Max un 94,1 %. En Speech Agent Arena, donde las personas comparan dos modelos en conversaciones en directo a ciegas, v1 Max obtuvo 998 y v1 Mini 988. En tareas de uso de herramientas, v1 Max completó el 87,1 % y v1 Mini el 60,3 %, por lo que recomendamos Max para casos de uso que requieren muchas llamadas a herramientas.
Primeros pasos
En ElevenAgents (recomendado)
Crea un agente o abre uno existente y selecciona un modelo Realtime en el menú desplegable. A partir de ahí, tienes todo lo que ofrece ElevenAgents para ejecutar agentes en producción. Esto incluye canales de teléfono, web, WhatsApp y CCaaS, workflows, una base de conocimiento, barreras de seguridad, pruebas y monitorización.
Consulta la documentación de ElevenAgents para más información.
A través de la API Realtime
Si ya tienes una integración con la API Realtime de OpenAI, la forma más rápida de probar Eleven Realtime es mantener tu código y cambiar a dónde apunta. La API Realtime se conecta mediante WebSocket y sigue las especificaciones de OpenAI Realtime, así que el SDK de OpenAI funciona tal cual.
La API Realtime solo se conecta mediante WebSocket, así que una integración con WebRTC debe migrar primero a WebSocket. También funciona de forma independiente de ElevenAgents, por lo que, si necesitas canales, una base de conocimiento u otras funciones de la plataforma, crea tu solución en ElevenAgents desde el principio.
La guía de migración explica los pasos y las diferencias con respecto a la API de OpenAI.
Min forma parte del equipo de Growth de ElevenLabs y se encarga de ElevenAPI y las soluciones On-Prem/On-Device. Anteriormente, lideró el marketing de producto en Stainless como la segunda incorporación al equipo de GTM y, antes de eso, fue uno de los primeros responsables de marketing de producto en WorkOS, donde impulsó lanzamientos, capacitación, contenido y crecimiento.