
Crea un agente de voz en 20 minutos con ElevenLabs y Twilio
- Publicado
- Última actualización
EscucharEscucha este artículo
Un agente de voz puede responder llamadas telefónicas entrantes, transcribir a quienes llaman en tiempo real con Voz a Texto (STT), generar una respuesta con un modelo de lenguaje de gran tamaño (LLM) y responder con un módulo de Texto a Voz (TTS). Con ElevenLabs y Twilio, puedes tener un agente operativo en un número de teléfono real en unos 20 minutos.
Para desarrolladores, el stack completo que usarás incluye ElevenLabs para síntesis de voz (Flash v2.5) y transcripción (Scribe v2 Realtime), Twilio para telefonía y OpenAI o Anthropic como LLM. Dicho esto, todos estos componentes son intercambiables, por lo que puedes elegir los que mejor conozcas y utilizarlos en su lugar.
Este artículo explica cómo crear un agente de voz en 20 minutos con Node.js y Typescript. Si quieres una alternativa gestionada que se encargue de los turnos, las interrupciones y la telefonía sin tener que mantener tú mismo la cascada, descubre ElevenAgents.
Cómo funciona la arquitectura de un agente de voz
Antes de escribir código, conviene entender cómo se conectan los tres servicios de tu stack tecnológico.
- Twilio: Gestiona la llamada telefónica y el transporte de audio.
- ElevenLabs: Gestiona STT mediante Scribe v2 Realtime y TTS mediante Flash v2.5.
- LLM: Gestiona llamadas a herramientas y la redacción de la respuesta.
Cada etapa es un adaptador ligero, por lo que puedes sustituir una por otro servicio sin modificar el resto. Por ejemplo, puedes cambiar el LLM de OpenAI por Anthropic sin tener que reescribir los demás componentes.
Una llamada telefónica llega a tu servidor a través de Twilio. Twilio responde la llamada de la RTPC, abre un WebSocket de vuelta a tu servidor y reenvía el audio de quien llama como un flujo de tramas mu-law codificadas en base64. Tu servidor ejecuta la cascada y transmite el audio sintetizado de vuelta a través del mismo WebSocket, y Twilio lo reproduce para quien llama.
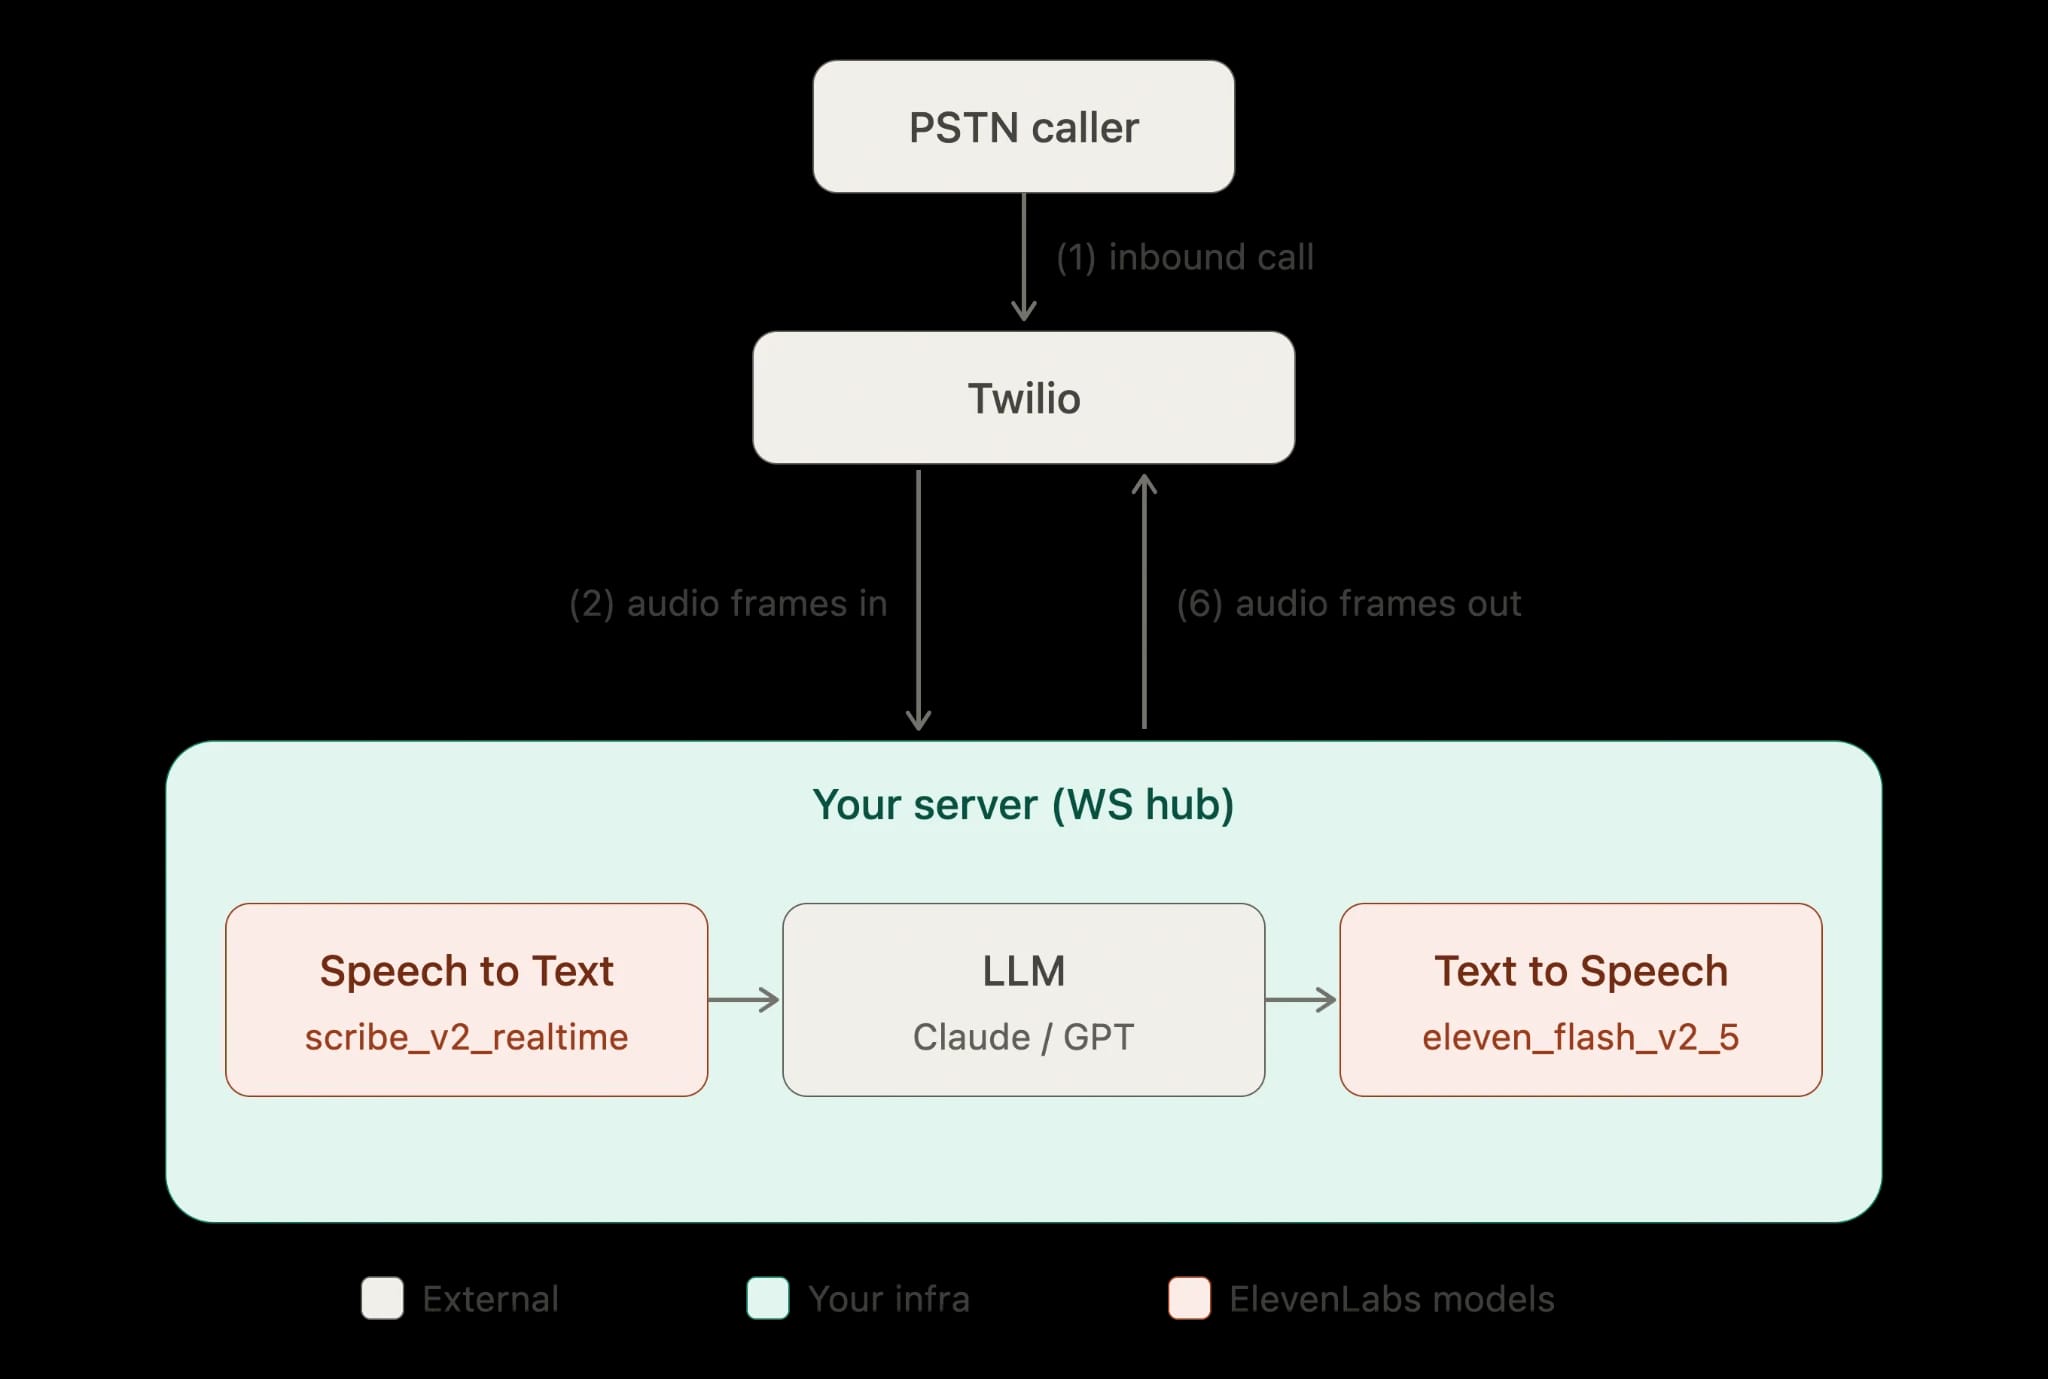
Este es el flujo que usarás para crear un agente de voz:
Alguien llama a tu número de Twilio. Twilio obtiene un documento TwiML de tu webhook. El TwiML indica a Twilio que abra un Media Stream hacia tu endpoint de WebSocket. Twilio transmite el audio entrante como eventos JSON que contienen cargas útiles mu-law (ulaw_8000) en base64.
Tu servidor reenvía fragmentos de audio a Scribe v2 Realtime para la transcripción en streaming. Cuando finaliza el turno de quien llama, envías la transcripción al LLM y, después, sintetizas la respuesta con Flash v2.5 en ulaw_8000. Envías las tramas mu-law sintetizadas de vuelta a Twilio por WebSocket, codificadas en base64, y Twilio las reproduce para quien llama.
Scribe v2 Realtime emite transcripciones parciales con una latencia aproximada de 150 ms, y Flash v2.5 funciona con una inferencia de modelo de aproximadamente 75 ms, sin contar la latencia de red y de la aplicación. El LLM es el factor que más contribuye al tiempo hasta el primer audio y el menos predecible, y es donde se concentra la mayor parte del presupuesto de latencia. Para reducir el intervalo, transmitimos la salida del LLM token a token y empezamos a sintetizar antes de que el modelo termine la frase.
Para conocer las ventajas e inconvenientes entre modelos que motivan estas decisiones, consulta la vista general de modelos y la explicación sobre cómo entender la latencia.
Qué necesitas antes de empezar a crear un agente de voz
Esta guía presupone que ya tienes cuatro elementos preparados. Cada uno se configura rápidamente, pero si falta alguno, el servidor no podrá ejecutarse.
Estos son los requisitos que debes comprobar:
- Un número de teléfono de Twilio con capacidad de voz: Anota el número, junto con tu Account SID y Auth Token de la consola de Twilio.
- Clave de API de ElevenLabs: créala en el panel de ElevenLabs. La clave se envía en el encabezado xi-api-key y es secreta, así que mantenla solo en el servidor. Consulta autenticación de la API.
- Clave de API del LLM: Este tutorial trata Anthropic Claude y OpenAI como backends intercambiables, así que elige uno.
- Ngrok (o cualquier túnel) para desarrollo local: Twilio debe acceder a tu servidor mediante una URL pública HTTPS y WSS, y ngrok lo permite sin desplegar nada.
Configura tus secretos como variables de entorno y nunca los incluyas en un commit.
Después, inicia un túnel que apunte al puerto que usará tu servidor:
Entender el protocolo Twilio Media Streams
Twilio no te proporciona un socket de audio sin procesar. En su lugar, encapsula todo en un protocolo JSON estructurado mediante WebSocket. Entender los cuatro tipos de eventos y el formato de envío hará que el controlador de WebSocket del paso 2 tenga todo el sentido antes de escribirlo.
Cuando Twilio se conecta a tu WebSocket, envía una secuencia de mensajes de texto JSON que pueden tener cuatro tipos de eventos.
El evento connected llega primero y confirma que el WebSocket está activo. El evento start se envía una vez cuando comienza el flujo multimedia; incluye un streamSid que debes almacenar, ya que lo necesitas para enviar audio de vuelta, y también incluye metadatos de la llamada en start.customParameters y start.callSid.
El evento media es recurrente: media.payload es un fragmento de audio mu-law de 8 kHz codificado en base64, de 20 ms por trama, y media.track es inbound para el audio de quien llama. Por último, stop se envía cuando termina el flujo, normalmente porque se ha colgado la llamada.
Para reproducir audio de vuelta, envías un mensaje de tipo media con el mismo streamSid y una carga útil mu-law en base64. Para interrumpir el audio que ya has puesto en cola, envías un mensaje clear con el streamSid, que vacía el búfer de salida de Twilio.
Las codificaciones de entrada y salida son idénticas (ulaw_8000). Solicitamos ulaw_8000 a Texto a Voz de ElevenLabs y reenviamos los bytes directamente a Twilio sin remuestrear nada entre medias.
Paso 1: Servir el webhook de TwiML
Cuando llega una llamada, Twilio realiza una solicitud HTTP a tu webhook, y respondes con TwiML que conecta la llamada a tu Media Stream. El verbo <Connect><Stream> abre un WebSocket bidireccional. Usa <Connect> en lugar de <Start> aquí: mantiene la llamada activa durante el flujo y te permite enviar audio de vuelta, que es el propósito de esta configuración.
El TwiML que devuelve el webhook es:
En Express, se trata de un único controlador POST que completa el host y devuelve el documento:
En la consola de Twilio, configura el webhook «A call comes in» del número en https://your-subdomain.ngrok.app/incoming-call mediante HTTP POST.
Paso 2: Aceptar el WebSocket de Media Stream
El controlador de WebSocket lee los eventos de Twilio, gestiona la cascada y envía audio de vuelta.
Mantenemos una pequeña cantidad de estado por llamada: el streamSid, una conexión STT y un indicador de si el agente está hablando en ese momento. El controlador descodifica cada trama multimedia entrante de base64 y reenvía los bytes mu-law sin procesar a STT:
Paso 3: Transcribir con Scribe v2 Realtime
Scribe v2 Realtime acepta fragmentos de audio en streaming y devuelve transcripciones parciales y finales. Además, admite directamente la codificación mu-law, por lo que le enviamos las tramas de Twilio sin modificarlas.
También ofrece detección de actividad de voz para segmentación basada en silencios y control de confirmación manual para finalizar un segmento. Para un agente telefónico, la segmentación basada en VAD suele ser la elección adecuada porque una pausa natural es la señal más fiable de que ha terminado el turno de quien llama.
Estos son los pasos: abre un flujo STT cuando empiece la llamada. Envía cada fragmento mu-law entrante. Reacciona a las transcripciones finalizadas invocando el LLM.
La interfaz del cliente STT en tiempo real sigue evolucionando, así que la estructura de abajo se mantiene detrás de un pequeño adaptador de TypeScript (openRealtimeStt) que implementas según la API activa, en lugar de depender de un conjunto fijo de nombres de campos. Considera onFinal como el hook que entrega un turno completado de quien llama a la siguiente etapa.
La latencia de reconocimiento en tiempo real es de aproximadamente 150 ms para resultados parciales, lo que reduce el intervalo percibido entre que quien llama termina y el agente empieza. Para la alternativa por lotes y todas las funcionalidades, consulta la documentación de Voz a Texto y la página de producto de Voz a Texto en Tiempo Real.
Paso 4: Generar una respuesta con un LLM
Esta es la etapa que genera la respuesta. El LLM toma el historial de la conversación y devuelve el texto del asistente. Transmite la respuesta para poder empezar la síntesis con la primera frase.
Aquí se usa OpenAI como backend:
El ID de modelo anterior, gpt-4.1-mini, es un ejemplo de opción de baja latencia; claude-haiku-4-5 es una opción comparable de Anthropic. Cualquiera de los dos proveedores puede implementar el mismo contrato llmReply; cambia el cuerpo de la función y el resto del agente no se modifica.
El prompt de sistema limita la longitud de las respuestas, algo importante por teléfono: las respuestas largas se perciben como lentas y resultan incómodas de interrumpir de forma natural.
Paso 5: Sintetizar con Flash TTS en ulaw_8000
Ahora el texto debe convertirse en audio que Twilio pueda reproducir. Solicita Flash v2.5 con outputFormat: "ulaw_8000" para que los bytes coincidan con la codificación que espera Twilio; después transmite el audio y reenvía cada fragmento por el WebSocket como evento media.
Acumula tokens del LLM en fragmentos del tamaño de una frase y sintetiza cada fragmento cuando se complete, en lugar de esperar toda la respuesta. Así se reduce el tiempo hasta el primer audio porque quien llama oye la primera frase mientras el modelo aún genera la segunda. Para un control más preciso de la síntesis incremental, la guía de WebSocket de TTS en tiempo real muestra cómo introducir texto en un único socket de síntesis abierto; el enfoque de streaming HTTP de abajo es más sencillo y suficiente para turnos conversacionales cortos.
Preparar tu agente de voz IA para producción
Después de los cinco pasos anteriores, tienes un agente operativo. Esto no equivale a un despliegue en producción.
Hay varias cuestiones que debes tener en cuenta antes de poner el agente en una línea telefónica real.
Validar las firmas de webhook de Twilio
Cualquiera que conozca la URL de tu webhook puede hacerle un POST, así que lo primero es confirmar que la solicitud procede realmente de Twilio. Twilio firma cada solicitud con tu Auth Token en el encabezado X-Twilio-Signature, y debes rechazar cualquier solicitud que no supere la validación. La firma se calcula sobre la URL completa y los parámetros POST, así que debes calcularla igual que Twilio.
El helper de Twilio lo hace por ti:
Gestionar los secretos correctamente
Guarda ELEVENLABS_API_KEY, la clave del LLM y TWILIO_AUTH_TOKEN en un gestor de secretos, no en el código fuente ni en archivos env de texto sin cifrar incluidos en un repositorio. Limita la clave de ElevenLabs solo a las rutas de API que necesita este servicio y asígnale una cuota de créditos para que una filtración tenga un impacto acotado en vez de ilimitado.
Los planes Enterprise también pueden restringir una clave a rangos de IP específicos mediante una lista blanca de IP. Este servidor utiliza directamente la clave de API porque nunca sale de tu backend; si alguna lógica de audio se trasladara a un navegador o una app móvil, usarías tokens de un solo uso para que la clave nunca quede expuesta en el cliente.
Entender el límite de concurrencia
Cada plan tiene un límite de concurrencia que varía según la familia de modelos, y el límite cuenta cuántas solicitudes están generando audio activamente al mismo tiempo.
En el caso de un agente telefónico, este cálculo juega a tu favor. La generación de audio es más rápida que la reproducción, por lo que cada llamada solo consume concurrencia de TTS durante los breves intervalos en los que se sintetiza una respuesta, no durante toda la llamada. Como estimación aproximada, un límite de concurrencia de alrededor de cinco puede admitir unas 100 llamadas conversacionales simultáneas, porque la generación termina mucho antes que la reproducción.
Aun así, supervisa el margen disponible en lugar de hacer suposiciones. Las respuestas de ElevenLabs incluyen los encabezados current-concurrent-requests y maximum-concurrent-requests; regístralos y configura alertas cuando te acerques al máximo. Cuando superas el límite, las solicitudes se ponen en cola por prioridad, lo que suele añadir unos 50 ms, y una sobrecarga sostenida devuelve HTTP 429.
Gestiona las respuestas HTTP 429 con una espera breve antes de reintentarlo. Si persisten, aumenta los límites actualizando tu plan en la página de precios o, para clientes Enterprise, a través de tu gestor de cuenta.
Gestionar las intervenciones y las interrupciones
Quien llama y empieza a hablar mientras el agente habla espera que el agente se detenga. Esto se conoce como barge-in, y gestionarlo correctamente es una parte importante de que un agente se perciba como natural y no como un guion.
Detecta la voz de quien llama durante la reproducción del agente mediante la señal VAD de STT. Cuando la detectes, haz dos cosas. Primero, deja de reenviar fragmentos de TTS, algo que el indicador agentSpeaking de speak ya gestiona al interrumpir el bucle. Segundo, envía a Twilio un mensaje clear para vaciar el audio que ya hayas puesto en cola en su lado.
Si omites clear, Twilio seguirá reproduciendo el audio almacenado en búfer después de que hayas dejado de enviarlo, por lo que parecerá que el agente habla por encima de quien llama.
Registrar, supervisar y gestionar los fallos correctamente
Instrumenta cada etapa para poder atribuir la latencia cuando una llamada parezca lenta. Mide el intervalo entre la transcripción final y el primer token del LLM, entre el primer token del LLM y el primer byte de TTS, y entre el primer byte de TTS y la trama enviada a Twilio. Verás que la mayor parte de la latencia variable se concentra en la etapa del LLM; las etapas de STT y TTS son comparativamente estables.
Después, planifica los fallos parciales. El LLM puede agotar el tiempo de espera, el flujo STT puede interrumpirse y el viaje de ida y vuelta por red a ElevenLabs varía aproximadamente entre 20 y 200 ms en internet público según la ubicación geográfica. Ubica tu servidor cerca de quienes llaman, no solo cerca de ElevenLabs, ya que ElevenLabs ya enruta al clúster más cercano de Norteamérica, Europa y el Sudeste Asiático.
Cuando falle una etapa, no dejes a quien llama en silencio: sintetiza una frase alternativa breve («Lo siento, ¿puedes repetirlo?») y mantén activa la llamada. Envuelve cada etapa en un tiempo de espera y un try/catch para que un turno fallido no cierre todo el WebSocket.
Conviene configurar algunos valores predeterminados más antes del lanzamiento:
- Limita la longitud de las respuestas en el prompt de sistema, como se muestra, para que los turnos sean breves e interrumpibles.
- Limita el historial de la conversación para que las llamadas largas no hagan crecer sin límite el contexto del LLM.
- Establece una duración máxima de llamada como medida de seguridad ante sesiones bloqueadas que consumen concurrencia sin que se note.
Para seguir ajustando los componentes que controlas, el documento sobre latencia explica de dónde procede el tiempo hasta el primer audio; la vista general de modelos aborda las ventajas e inconvenientes entre velocidad y calidad; y la guía de WebSocket de TTS en tiempo real muestra cómo reducir aún más la latencia de síntesis con entrada de texto incremental.
Crea agentes de voz listos para producción con ElevenAPI
Ahora que han pasado 20 minutos, tienes todas las capas de un agente de voz para producción. Twilio gestiona la telefonía, Scribe v2 Realtime transcribe, un LLM genera respuestas y Flash v2.5 responde por el mismo WebSocket.
Si prefieres no mantener tú mismo la cascada, ElevenAgents ofrece gestión de turnos, control de interrupciones e integración de telefonía como servicio gestionado basado en los mismos modelos que acabas de conectar manualmente.
Para seguir ajustando un stack que controlas, explora la página de producto de ElevenAPI para consultar los planes, límites de concurrencia y la biblioteca de voces. También puedes registrarte y empezar hoy mismo a realizar tu primera llamada.
Preguntas frecuentes sobre cómo crear un agente de voz con Twilio y ElevenLabs

Tadas Petra es Developer Relations Engineer y ayuda a desarrolladores a crear con la suite de productos de ElevenLabs. Además, es fundador de Hungrimind, una plataforma de formación para desarrolladores. Antes fue Lead Developer Advocate en Agora e instructor en Zero To Mastery.




