Poznaj Eleven v4Poznaj Eleven v4, nasz najbardziej emocjonalny model.

Przejdź do treści

Text to Speech

Text to Speech z wysokiej jakości głosami AI brzmiącymi jak ludzie

Zaufało nam ponad 1 mln użytkowników · Zacznij za darmo

Wybrane dla ciebie

Wybrane dla ciebie

Wybierz głos

Wygeneruj mowę

Najnowszy model

Eleven v4

Twórz ekspresyjną mowę, którą możesz kontrolować i wzbogacać emocjami, zdarzeniami audio oraz immersyjnymi pejzażami dźwiękowymi.

Głosy AI Text to Speech rozumiejące emocje i kontekst

Nasza AI głosowa reaguje na emocjonalne wskazówki w tekście i dostosowuje sposób mówienia zarówno do bieżącej treści, jak i szerszego kontekstu. Dzięki temu głosy AI mają szeroki zakres emocji i unikają błędów logicznych podczas odczytywania treści.
Kontroluj emocje, sposób mówienia i wskazówki

Twórz ekspresyjną mowę, którą możesz kontrolować i wzbogacać emocjami, zdarzeniami audio oraz immersyjnymi pejzażami dźwiękowymi.

Dostęp do biblioteki ponad 10 000 ludzkich głosów

Odkrywaj stale rosnącą kolekcję ekspresyjnych, realistycznych głosów do każdego zastosowania — od narracji po tworzenie postaci.

Obsługa dialogów

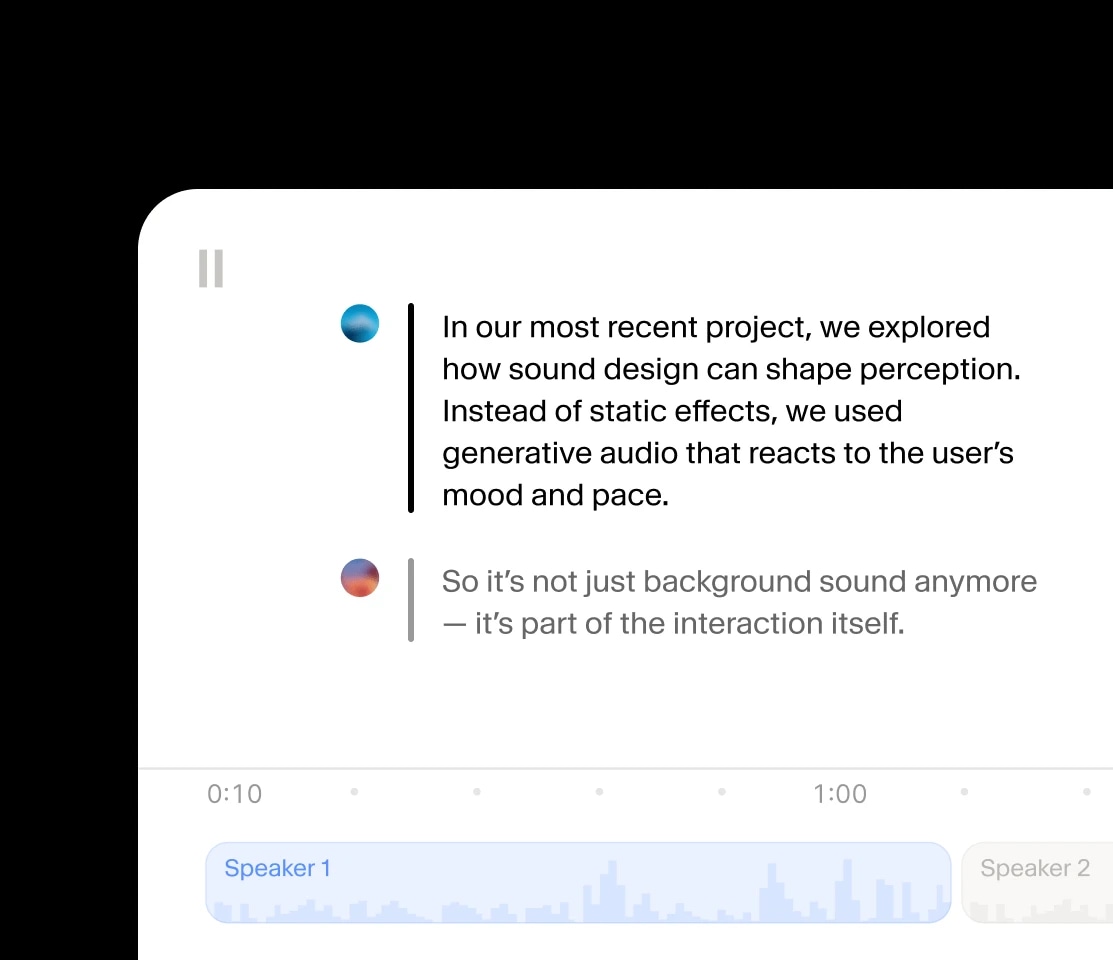
Twórz rozmowy audio, w których mówcy dzielą kontekst i emocje.

Sklonuj lub zaprojektuj głos

Błyskawicznie odtwórz własny głos lub twórz wyjątkowe głosy AI z pełną kontrolą.

Mowa wielojęzyczna

Ożywiaj historie w ponad 70 językach — z emocjami i klarownością na poziomie native speakera.
Do wielu zastosowań — od agentów AI po audiobooki i nałożone głosy

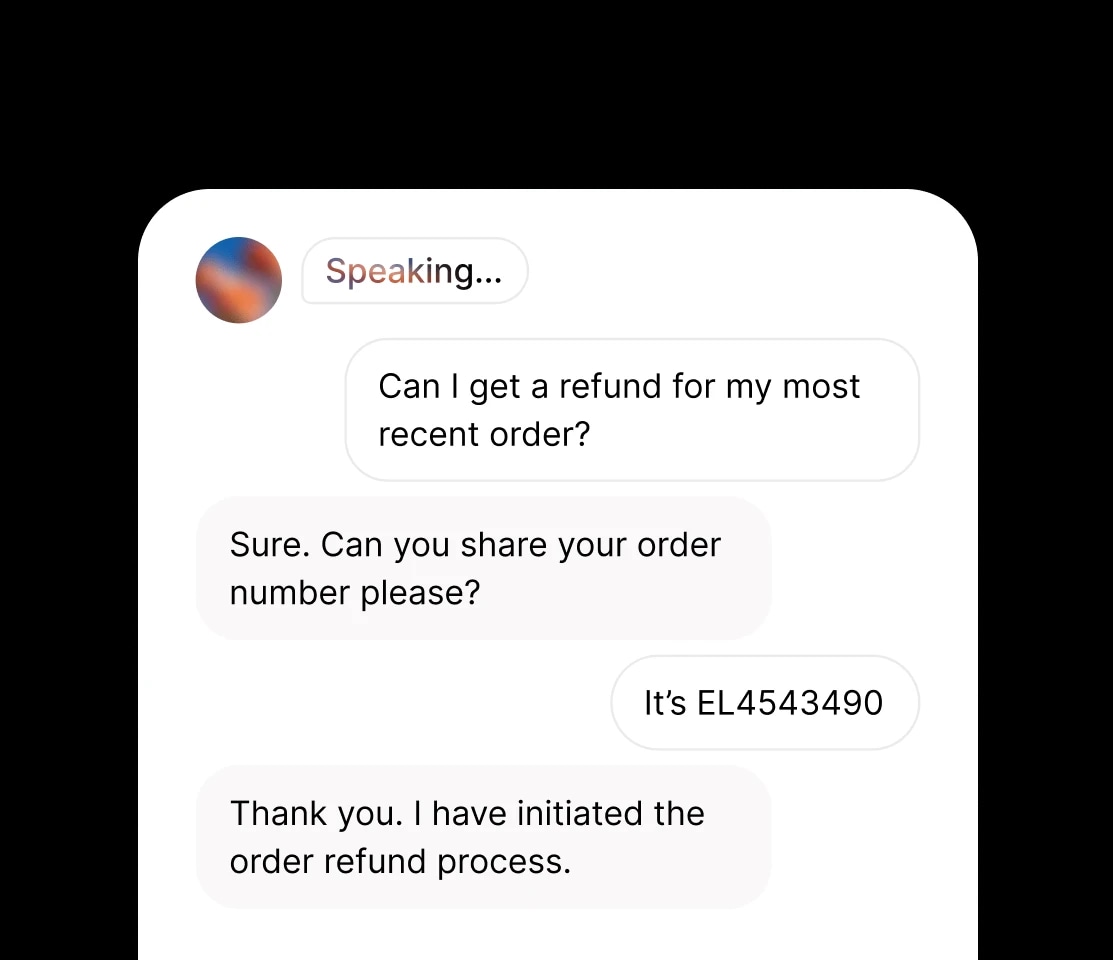
Agenci konwersacyjni

Używaj zamiany tekstu na mowę AI, by tworzyć naturalne, ludzkie głosy dla chatbotów i wirtualnych asystentów oraz poprawiać interakcje dzięki realistycznym odpowiedziom.
TTS used for Conversational Agents

Gry

Generuj nałożone głosy dla postaci z gier wideo przez API zamiany tekstu na mowę — z głosami rozumiejącymi kontekst i trafnie oddającymi emocje w grze.
Text to Speech for narration in video games

Audiobooki

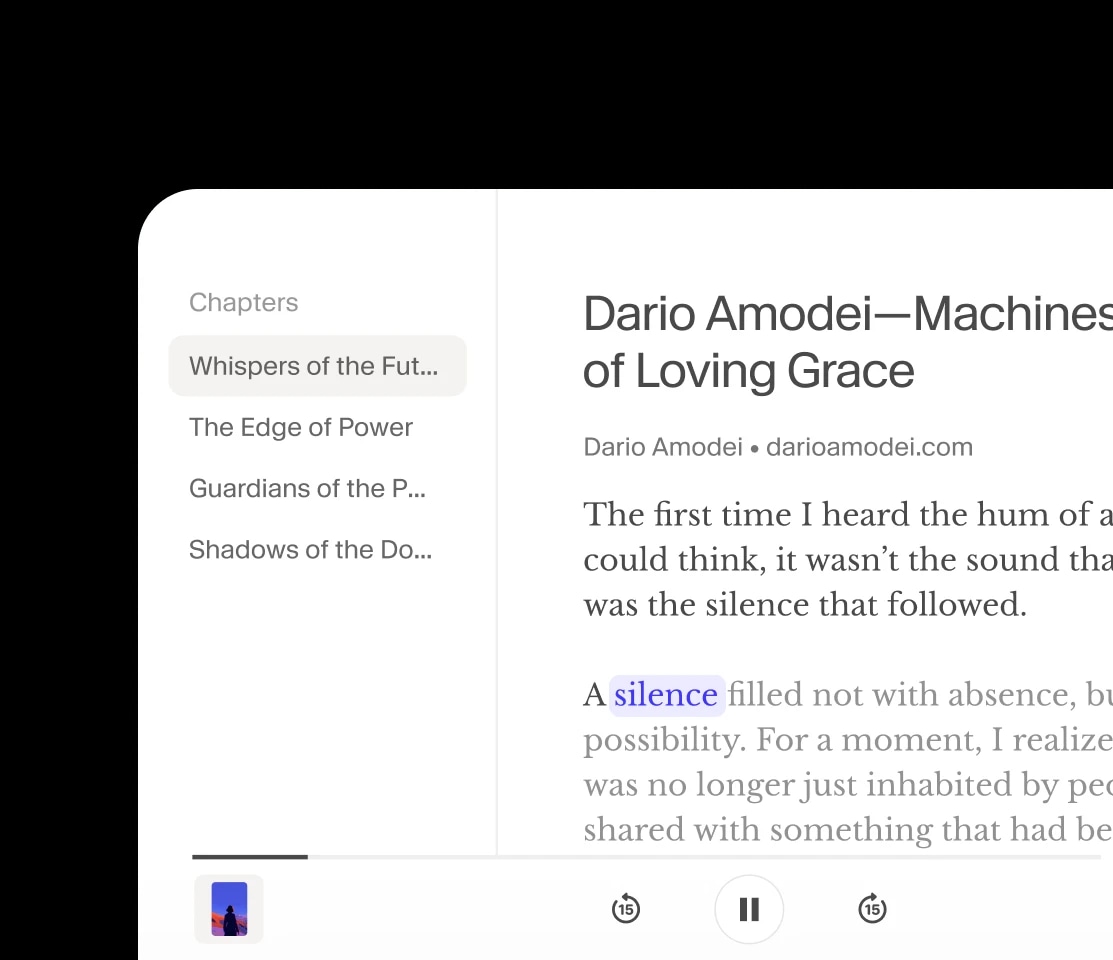
Zamieniaj tekst pisany w naturalnie brzmiące głosy AI do audiobooków i szybko twórz treści w wielu językach.
Use TTS to generate audiobooks

Nałożone głosy do wideo

Twórz wysokiej jakości nałożone głosy do filmów, programów TV i animacji dzięki AI, bez potrzeby angażowania aktorów głosowych i z szybszą produkcją.
Add voiceovers to videos with TTS

Podcasty

Używaj zamiany tekstu na mowę AI do tworzenia podcastów ze spójną, profesjonalną narracją i ogranicz czas ręcznych nagrań.
Generate podcasts in Studio

Dostępność

Dodaj zamianę tekstu na mowę do stron i aplikacji, aby udostępniać wersje audio treści i ułatwiać dostęp osobom z wadami wzroku lub trudnościami w czytaniu.
Use text to speech for screen readers

Miliony słów generowanych co minutę

Generuj mowę w ponad 90 językach i szerokiej gamie akcentów

  • English
  • Afrikaans
  • Arabic
  • Armenian
  • Assamese
  • Azerbaijani
  • Belarusian
  • Bengali
  • Bosnian
  • Bulgarian
  • Catalan
  • Cebuano
  • Chichewa
  • Chinese
  • Croatian
  • Czech
  • Danish
  • Dutch
  • Estonian
  • Filipino
  • Finnish
  • French
  • Galician
  • Georgian
  • German
  • Greek
  • Gujarati
  • Hausa
  • Hebrew
  • Hindi
  • Hungarian
  • Icelandic
  • Igbo
  • Indonesian
  • Irish
  • Italian
  • Japanese
  • Javanese
  • Kannada
  • Kazakh
  • Kirghiz
  • Korean
  • Latvian
  • Lingala
  • Lithuanian
  • Luxembourgish
  • Macedonian
  • Malay
  • Malayalam
  • Mandarin Chinese
  • Marathi
  • Nepali
  • Norwegian
  • Pashto
  • Persian
  • Polish
  • Portuguese
  • Punjabi
  • Romanian
  • Russian
  • Serbian
  • Sindhi
  • Slovak
  • Slovenian
  • Somali
  • Spanish
  • Swahili
  • Swedish
  • Tamil
  • Telugu
  • Thai
  • Turkish
  • Ukrainian
  • Urdu
  • Vietnamese
  • Welsh
  • African
  • American
  • Argentine
  • Australian
  • British
  • Californian
  • Canadian
  • Cockney
  • Country
  • Czech Moravian
  • Desi
  • Filipino
  • French Swiss
  • German
  • German Bavarian
  • Indian
  • Irish
  • Italian
  • Jamaican
  • Latin American
  • Latino
  • Mexican
  • New York
  • Pakistani
  • Portuguese
  • Russian
  • Scandinavian
  • Scottish
  • Southern USA
  • Spanish
  • Spanish Castilian
  • Texas
  • Turkish Istanbul

Oparte na najpotężniejszych modelach Text to Speech

Abstract blurred gradient in warm coral, orange, green, and brown tones.

Eleven v4

Nasz najszybszy i najbardziej emocjonalny model głosowy do ekspresyjnej mowy wzbogaconej emocjami, zdarzeniami audio i pejzażami dźwiękowymi
  • Kontrolowana, ekspresyjna mowa
  • Obsługa ponad 90 języków
  • Limit 5000 znaków
  • Dialogi wielu mówców
Abstract red, orange, and pink gradient background.

Eleven v3

Nasz zaawansowany, ekspresyjny model z tagami audio do precyzyjnej kontroli emocji. Najlepszy do opowieści, gier i produkcji medialnych w ponad 70 językach.
  • Dramatyczna interpretacja
  • Obsługa ponad 70 języków
  • Limit 5000 znaków
  • Dialogi wielu mówców
Abstract blurred gradient blending blue, orange, red, and purple tones.

Multilingual v2

Nasz realistyczny model zamiany tekstu na mowę, pełen emocji i obsługujący 29 języków. Najlepszy do nałożonych głosów, audiobooków, postprodukcji i tworzenia treści.
  • Naturalne brzmienie
  • Obsługa 29 języków
  • Limit 10 000 znaków
  • Do długich generacji
Abstract pink and purple gradient background with soft diagonal color bands.

Flash / Turbo v2.5

Nasz szybki i przystępny model syntezy mowy. Najlepszy do zastosowań deweloperskich, gdy liczy się szybkość i potrzebujesz języków innych niż angielski

  • Bardzo niskie opóźnienie (~75 ms*)
  • Obsługa 32 języków
  • Limit 40 000 znaków
  • Szybszy model, cena za znak niższa o 50%

Zaufali nam czołowi twórcy na świecie i ich społeczności

Cennik Text to Speech

0 $ miesięcznie

10k kredytów miesięcznie

Darmowy
0 $ miesięcznie
Starter
6 $ miesięcznie, pierwszy miesiąc 1 $
Creator
22 $ miesięcznie, pierwszy miesiąc 11 $
Pro
99 $ miesięcznie

10k kredytów miesięcznie

30k kredytów miesięcznie

121k kredytów miesięcznie

600k kredytów miesięcznie

Text to Speech (UI)

Minuty wliczone

Dodatkowa minuta

Użytek komercyjny

Model Eleven v3

Języki

Miejsca na własne głosy

Natychmiastowe klonowanie głosu

Profesjonalne klonowanie głosu

Jakość audio

WAV / PCM 44,1 kHz

Jednoczesne żądania

~10

~0,36 $

74

3

128 kbps, 44.1kHz

2

~30

~0,20 $

74

10

128 kbps, 44.1kHz

3

~121

~0,18 $

74

30

1

128 i 192 kbps, 44.1kHz

5

~600

~0,17 $

74

160

1

128 i 192 kbps, 44.1kHz

10

Ceny nie zawierają podatków, opłat i ceł. Zobacz wszystkie plany cenowe.

Bezpieczeństwo i infrastruktura klasy enterprise na dużą skalę

Data Protection graphics

Dane są szyfrowane podczas przesyłania i przechowywania, a rozwiązanie wspiera zgodność z SOC 2, HIPAA i RODO. Tryby EU Data Residency oraz Zero Retention zapewniają ściślejszą kontrolę nad danymi.
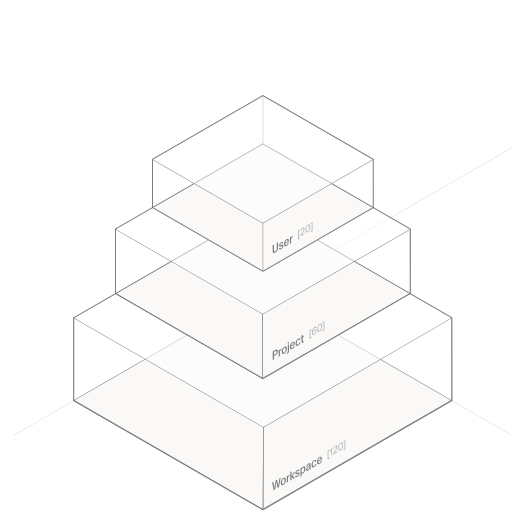
Dane są szyfrowane podczas przesyłania i przechowywania, a rozwiązanie wspiera zgodność z SOC 2, HIPAA i RODO. Tryby EU Data Residency oraz Zero Retention zapewniają ściślejszą kontrolę nad danymi.

Permissions

Ustawiaj szczegółowe uprawnienia zespołu i współpracuj w całej firmie, udostępniając głosy, zasoby i materiały między agentami oraz etapami produkcji treści.

Nasz zespół zapewnia płynne uruchomienie i niezawodne działanie, oferując stałą wydajność i spokój.

Dostępne w sieci, na urządzeniach mobilnych oraz przez API i SDK

ElevenLabs Studio

Najlepsze modele audio AI w jednym zaawansowanym edytorze.
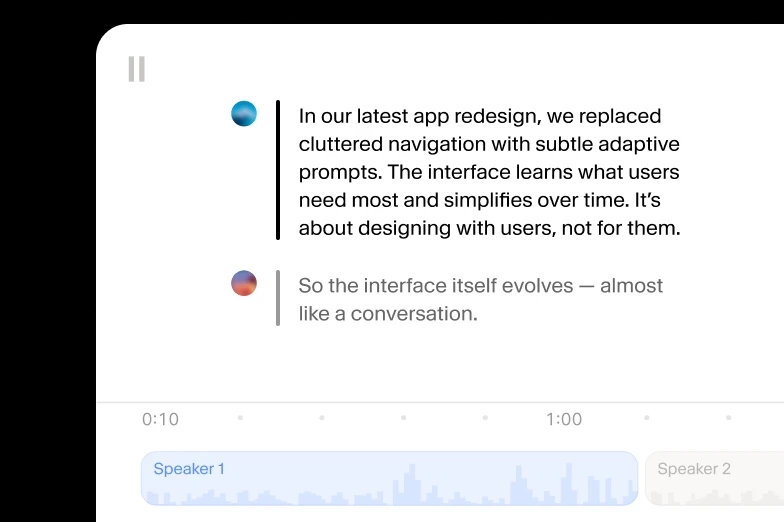
Use TTS in the ElevenLabs Studio

Aplikacja mobilna ElevenLabs

Twórz ekspresyjne audio w kilka sekund w naszych aplikacjach na iOS i Androida.
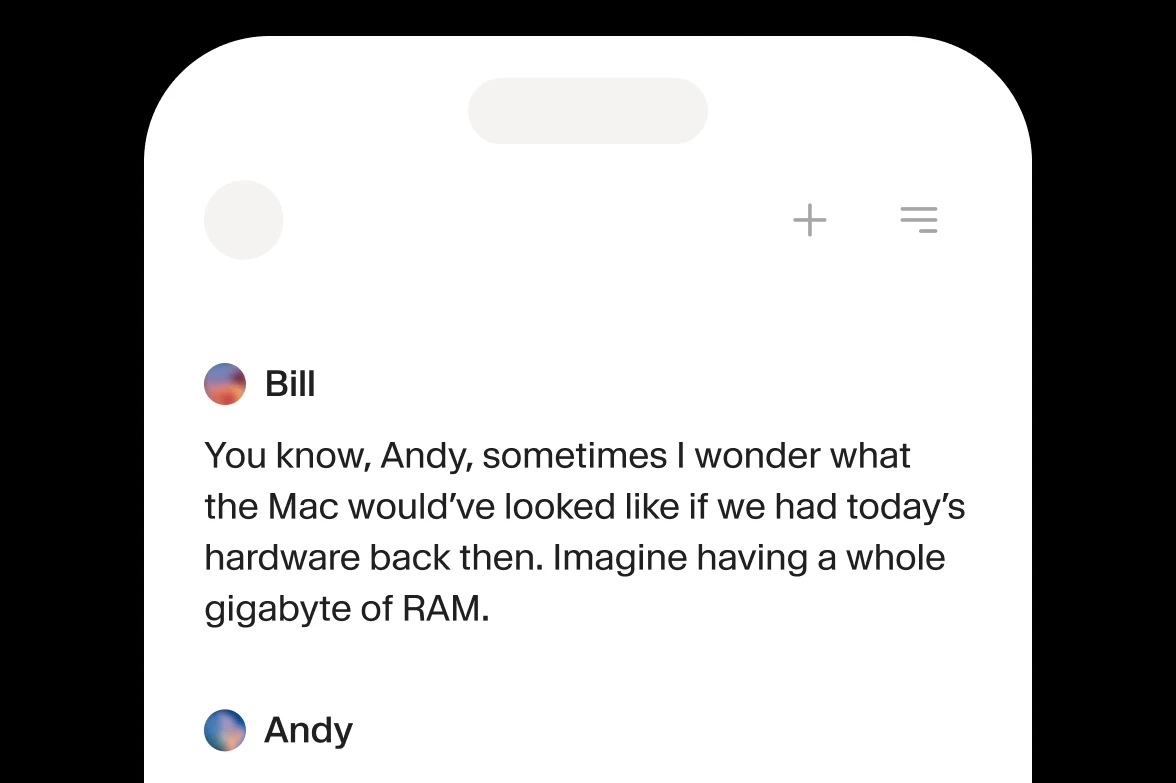
ElevenLabs Mobile app

API i SDK Text to Speech

Zintegruj ElevenLabs Text to Speech (TTS) ze swoim produktem przez API lub SDK.
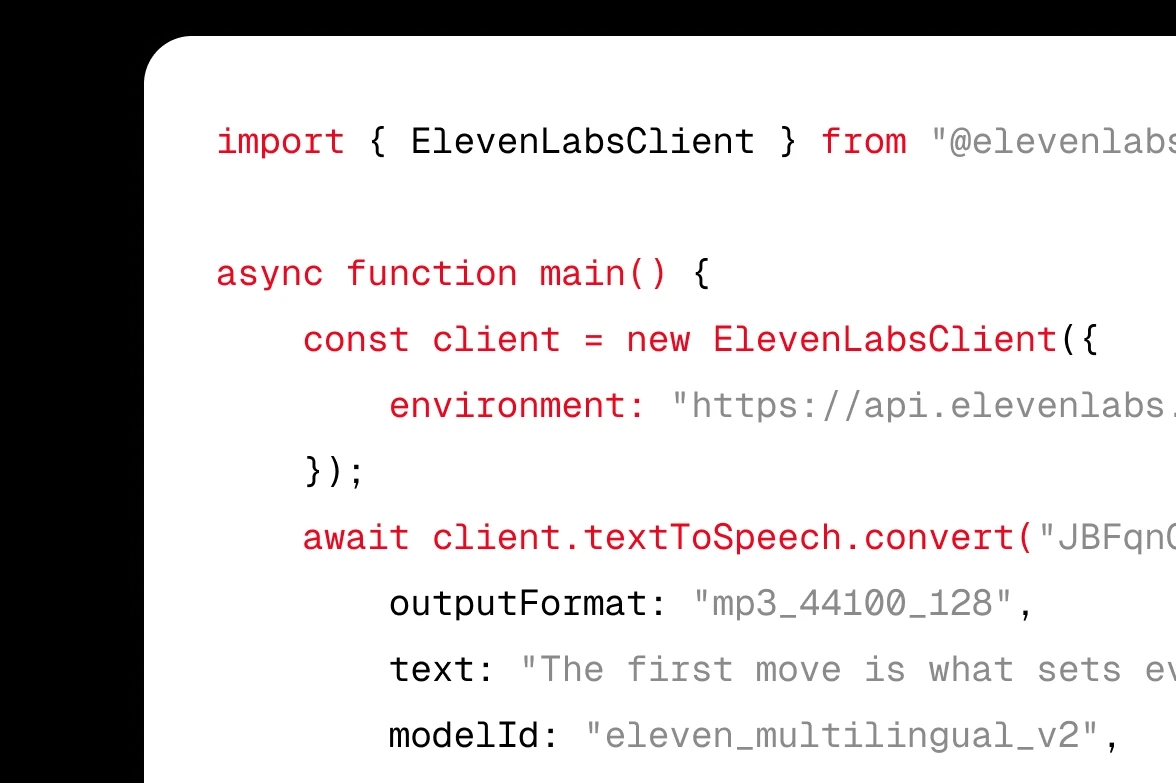
TTS API

Globalny wpływ badań nad audio AI

Najczęściej zadawane pytania

Najnowsze aktualizacje

Twórz z najwyższej jakości audio AI