Jak transkrypcja wie, kiedy pada każde słowo
- Autor
- Mike Murphy
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Jeśli zdarzyło ci się oglądać film w telewizji z problemami z transmisją, przez które dialogi aktorów zupełnie nie pasują do napisów, wiesz, jak bardzo to rozprasza i wybija z historii. Ten sam problem dotyczy filmów i oprogramowania korzystających z modeli głosowych: napisy wyświetlone o sekundę za późno albo transkrypcja podświetlająca niewłaściwe słowo mogą sprawiać wrażenie równie zepsutych.
„Ludzie całkiem dobrze radzą sobie z synchronizowaniem mediów, przynajmniej na poziomie słów” — mówi Danila Kozlov, badacz w ElevenLabs pracujący nad synchronizacją. „Często intuicyjnie wyczuwamy, gdzie zaczyna się słowo, ale na poziomie znaków i z dokładnością poniżej milisekundy jest to znacznie trudniejsze”.
Dziś ElevenLabs opowiada więcej o Cue — modelu wymuszonego dopasowania, który umieszcza każdy znak w pliku audio na precyzyjnej osi czasu. Cue napędza rodzinę modeli Scribe od ElevenLabs, a na nagraniach z rzeczywistego świata jest dokładniejszy niż każdy synchronizator testowany przez ElevenLabs — we wszystkich 29 językach benchmarku. Obsługuje też nagrania dowolnej długości w jednym przebiegu i synchronizuje godzinę audio w mniej niż sekundę.
Czym jest wymuszone dopasowanie?
Wyobraź sobie, że ktoś daje ci film i transkrypcję, a potem prosi o dopasowanie każdego słowa do chwili, w której zostało wypowiedziane. To właśnie wymuszone dopasowanie. Gdy klikasz słowo w transkrypcji ElevenLabs, a odtwarzacz przeskakuje dokładnie do tego miejsca, pracę wykonuje synchronizator.
Wymuszone dopasowanie różni się jednak od bardziej niejasnego pojęcia alignmentu AI. Chodzi w nim o projektowanie systemów AI tak, aby ich zachowanie odpowiadało ludzkim wartościom i preferencjom biznesowym. W wymuszonym dopasowaniu mówimy po prostu o zsynchronizowaniu tekstu z dźwiękiem.
Cue to ostatni etap procesu zamiany mowy na tekst. Scribe, model ElevenLabs do zamiany mowy na tekst, transkrybuje audio, a synchronizator ustawia znaczniki czasu. Przechodzi przez niego każde żądanie Scribe. Ten sam model obsługuje też napisy, dubbing i synchronizację tekstów piosenek, a także jest dostępny osobno przez Forced Alignment API.
Ponieważ zależy od niego tak wiele produktów, synchronizator musi być precyzyjny w każdym obsługiwanym języku, bardzo szybki i zdolny obsłużyć wiele żądań naraz.
Gdzie zawodzą tradycyjne synchronizatory
Przed stworzeniem nowego modelu zespół zbudował synchronizator używany dotąd we wszystkich produktach ElevenLabs. Choć był skuteczny, wiedzieli, że mogą stworzyć lepszą wersję. Gdy dołączył Kozlov, on i zespół zaczęli od rozmów z klientami oraz wewnętrznymi użytkownikami ElevenLabs o tym, co frustrowało ich w pracy z poprzednim synchronizatorem. Ich uwagi pokrywały się z ograniczeniami narzędzi open source, które testował zespół.
Pierwszym dużym problemem jest długość nagrań. Wiele synchronizatorów dobrze działa dziś z klipami trwającymi około 30 sekund, ale dłuższe pliki trzeba dzielić na fragmenty. Każdy kolejny fragment może wprowadzić niewielki błąd czasu, a łączenie ich może dodać następne. W pełnych nagraniach średni błąd czasu Cue wynosi zaledwie 179 milisekund, podczas gdy w narzędziach open source mieścił się w przedziale od 283 ms do ponad 6 000 ms.
Jeszcze większym wyzwaniem jest audio nagrane w rzeczywistych warunkach. Hałas w tle, nakładające się wypowiedzi i muzyka w otoczeniu sprawiają, że wiele narzędzi gubi się podczas dopasowywania tekstu do audio. A przecież to właśnie takie pliki wiele osób chce transkrybować, bo rzadko żyjemy w idealnej ciszy. W angielskich nagraniach z zakłóceniami w tle średni błąd Cue wynosi 57 ms, wobec 65–920 ms w innych narzędziach.
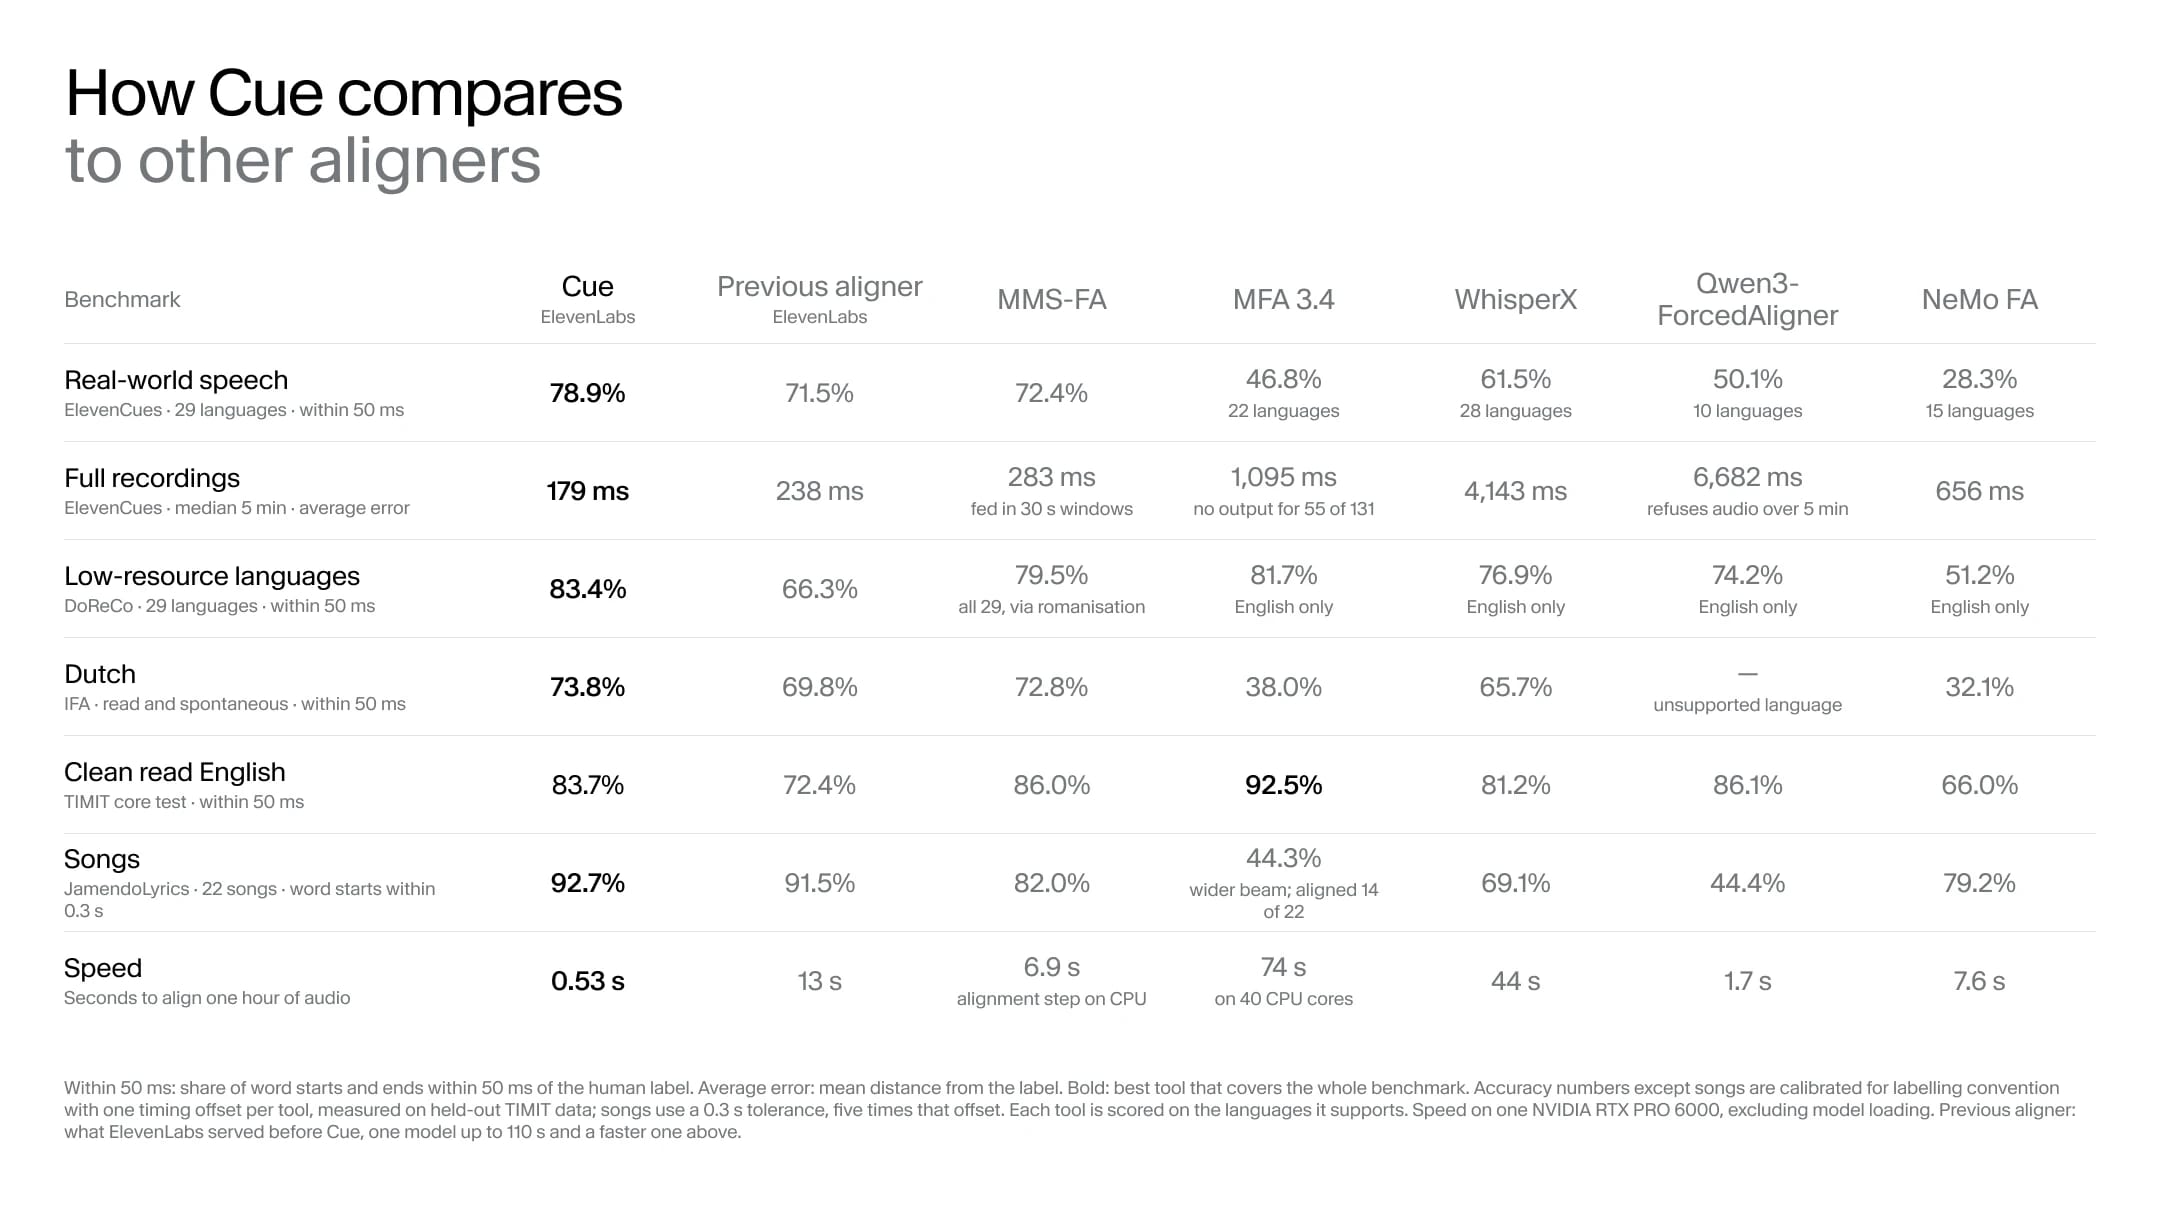
Kolejnym ograniczeniem jest obsługa języków. Większość synchronizatorów open source potrzebuje osobnego modelu dla każdego obsługiwanego języka, więc języki z mniejszą ilością danych treningowych często działają gorzej albo w ogóle nie są obsługiwane. MMS-FA to jedyne inne narzędzie obsługujące wszystkie 29 języków benchmarku, a Cue zazwyczaj szybciej wyznaczał granice między słowami.
Problemem dla tych modeli jest też szybkość, ponieważ synchronizacja dużych ilości audio może szybko generować wysokie koszty. Cue potrafi zsynchronizować godzinę audio w około pół sekundy na naszym produkcyjnym GPU. Kolejne najszybsze narzędzie, Qwen3-ForcedAligner, potrzebuje prawie 2 sekund, a najwolniejsze z testowanych — znacznie ponad minuty.
Czym wyróżnia się Cue
Cue to jeden model, który obejmuje ponad 90 języków benchmarkowych — w przeciwieństwie do większości konkurencyjnych rozwiązań. Może też przetwarzać nagrania dowolnej długości w jednym przebiegu, bez dzielenia ich na fragmenty, które powoduje narastanie błędów czasu w długich plikach.
Zsuń lub rozsuń palce albo przewijaj z Ctrl, aby przybliżać i oddalać. Przesuwaj poziomo lub przewijaj z Shiftem, aby przesuwać widok. Gdy słowo jest zaznaczone, użyj plusa i minusa, aby przybliżać i oddalać, lub Shift oraz strzałki w lewo i w prawo, aby przesuwać widok.
Wybierz słowo, aby zobaczyć jego znaki
Jak mówi Kozlov, podczas gdy większość modeli rosła wraz ze wzrostem wydajności, Cue jest mniejszy od poprzedniego synchronizatora ElevenLabs. Nadal działa na GPU, ale synchronizuje godzinę audio w około pół sekundy.
Zespół stworzył Cue z myślą o rodzajach audio, które ludzie naprawdę przesyłają. Traktując poprzedni synchronizator jako punkt odniesienia, stworzyli benchmark na podstawie rzeczywistych żądań i ocenili każde narzędzie tak samo, uznając każde słowo, którego narzędzie nie umiało umieścić na osi czasu, za błąd. Cue działa na poziomie znaków, co zapewnia większą precyzję niż etykiety na poziomie słów używane w większości benchmarków, więc wyniki prawdopodobnie nie oddają w pełni jego dokładności.
„W pewnym momencie osiągasz poziom ludzkich możliwości” — mówi Kozlov o modelach do synchronizacji. „Nasz obecny synchronizator ten poziom przekracza, więc znacznie trudniej sprawdzić, czy wszystko jest w pełni poprawne i jak duża jest jego dokładność, bo nie ma dla niego idealnego benchmarku. Musieliśmy użyć benchmarków na poziomie słów do oceny systemu działającego na poziomie znaków, co niekoniecznie pokazuje pełny potencjał Cue”.
Jakość Cue pokazuje też, jak szybko ElevenLabs reaguje na opinie użytkowników. Niedługo po wdrożeniu Cue klient zwrócił zespołowi uwagę, że gruziński i kilka innych języków z mniejszą ilością danych działały gorzej, niż oczekiwano. ElevenLabs ściśle łączy badania z zespołami i klientami korzystającymi z naszych produktów. Dzięki temu mogliśmy szybko wykryć problem, zbadać możliwe ulepszenia modelu, wytrenować jego nową wersję i ją udostępnić — wszystko w mniej niż 24 godziny od pierwszego zgłoszenia przez klienta.
Synchronizacja piosenek
Muzyka jest trudna, bo śpiew rozciąga i zaciera słowa, a niewiele modeli radzi sobie z tym dobrze. Zespół nie spodziewał się, że Cue poradzi sobie tak dobrze. Cue zdołał zsynchronizować podzbiór utworów z licencjonowanego na Creative Commons zbioru danych JamendoLyrics MultiLang. Zrobił to po angielsku, francusku, hiszpańsku i niemiecku — w jednym przebiegu — z zaskakującą dokładnością. Umieścił 92,7% słów w odległości 0,3 sekundy od etykiety, wobec 82,0% w kolejnym najlepszym narzędziu.
Średni błąd początku w Cue wyniósł 0,82 sekundy, czyli około połowę wyniku najbliższego konkurenta. Cue był dokładniejszy od każdego innego narzędzia w co najmniej 19 z 22 piosenek. Możliwość śpiewania na karaoke ulubionych nowych piosenek już w dniu premiery jest ogromna.
Wypróbuj Cue już dziś
Cue obsługuje już każdą transkrypcję Speech to Text w ElevenLabs. Aby użyć go bezpośrednio, wypróbuj Forced Alignment API.
Podziękowania
Praca nad modelami synchronizującymi ElevenLabs nie byłaby możliwa bez wielu osób z całej firmy. Zespół chce podziękować wszystkim, którzy pracowali nad poprzednią i nową wersją modelu, w tym współzałożycielowi i CTO Piotrowi Dąbkowskiemu, badaczom Danili Kozlovowi, Luce Lanzendörferowi, Flavio Schneiderowi, Maxowi Leviemu, Timowi von Känelowi i Angelosowi Perivolaropoulosowi, a także Ani Janelidze z Data Operations, naszym zespołom Forward Deployed Engineer i Support oraz Lorenzo Dossiemu za pracę nad wizualizacją w tym wpisie na blogu.
Mike Murphy jest głównym redaktorem i autorem bloga ElevenLabs, gdzie zamienia złożone badania i technologie w jasne, angażujące historie. Zanim dołączył do ElevenLabs, przez lata pracował jako reporter technologiczny, m.in. w Quartz, a także kierował działem treści w IBM Research. Ma tytuł magistra dziennikarstwa Northwestern.