Przedstawiamy Eleven v4, nasz najbardziej emocjonalny model
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Znaczenie zdania może się mocno zmienić zależnie od tego, jak zostanie wypowiedziane. „Musisz zachować spokój” zabrzmi inaczej w ustach lekarza, który łagodnie mówi to przestraszonemu pacjentowi, a inaczej, gdy postać w grze krzyczy to do swojej drużyny przed rozpoczęciem bitwy.
Dziś wprowadzamy Eleven v4, nasz najbardziej ekspresyjny dotąd model zamiany tekstu na mowę, oraz jego niskolatencyjny wariant Eleven v4 Turbo.
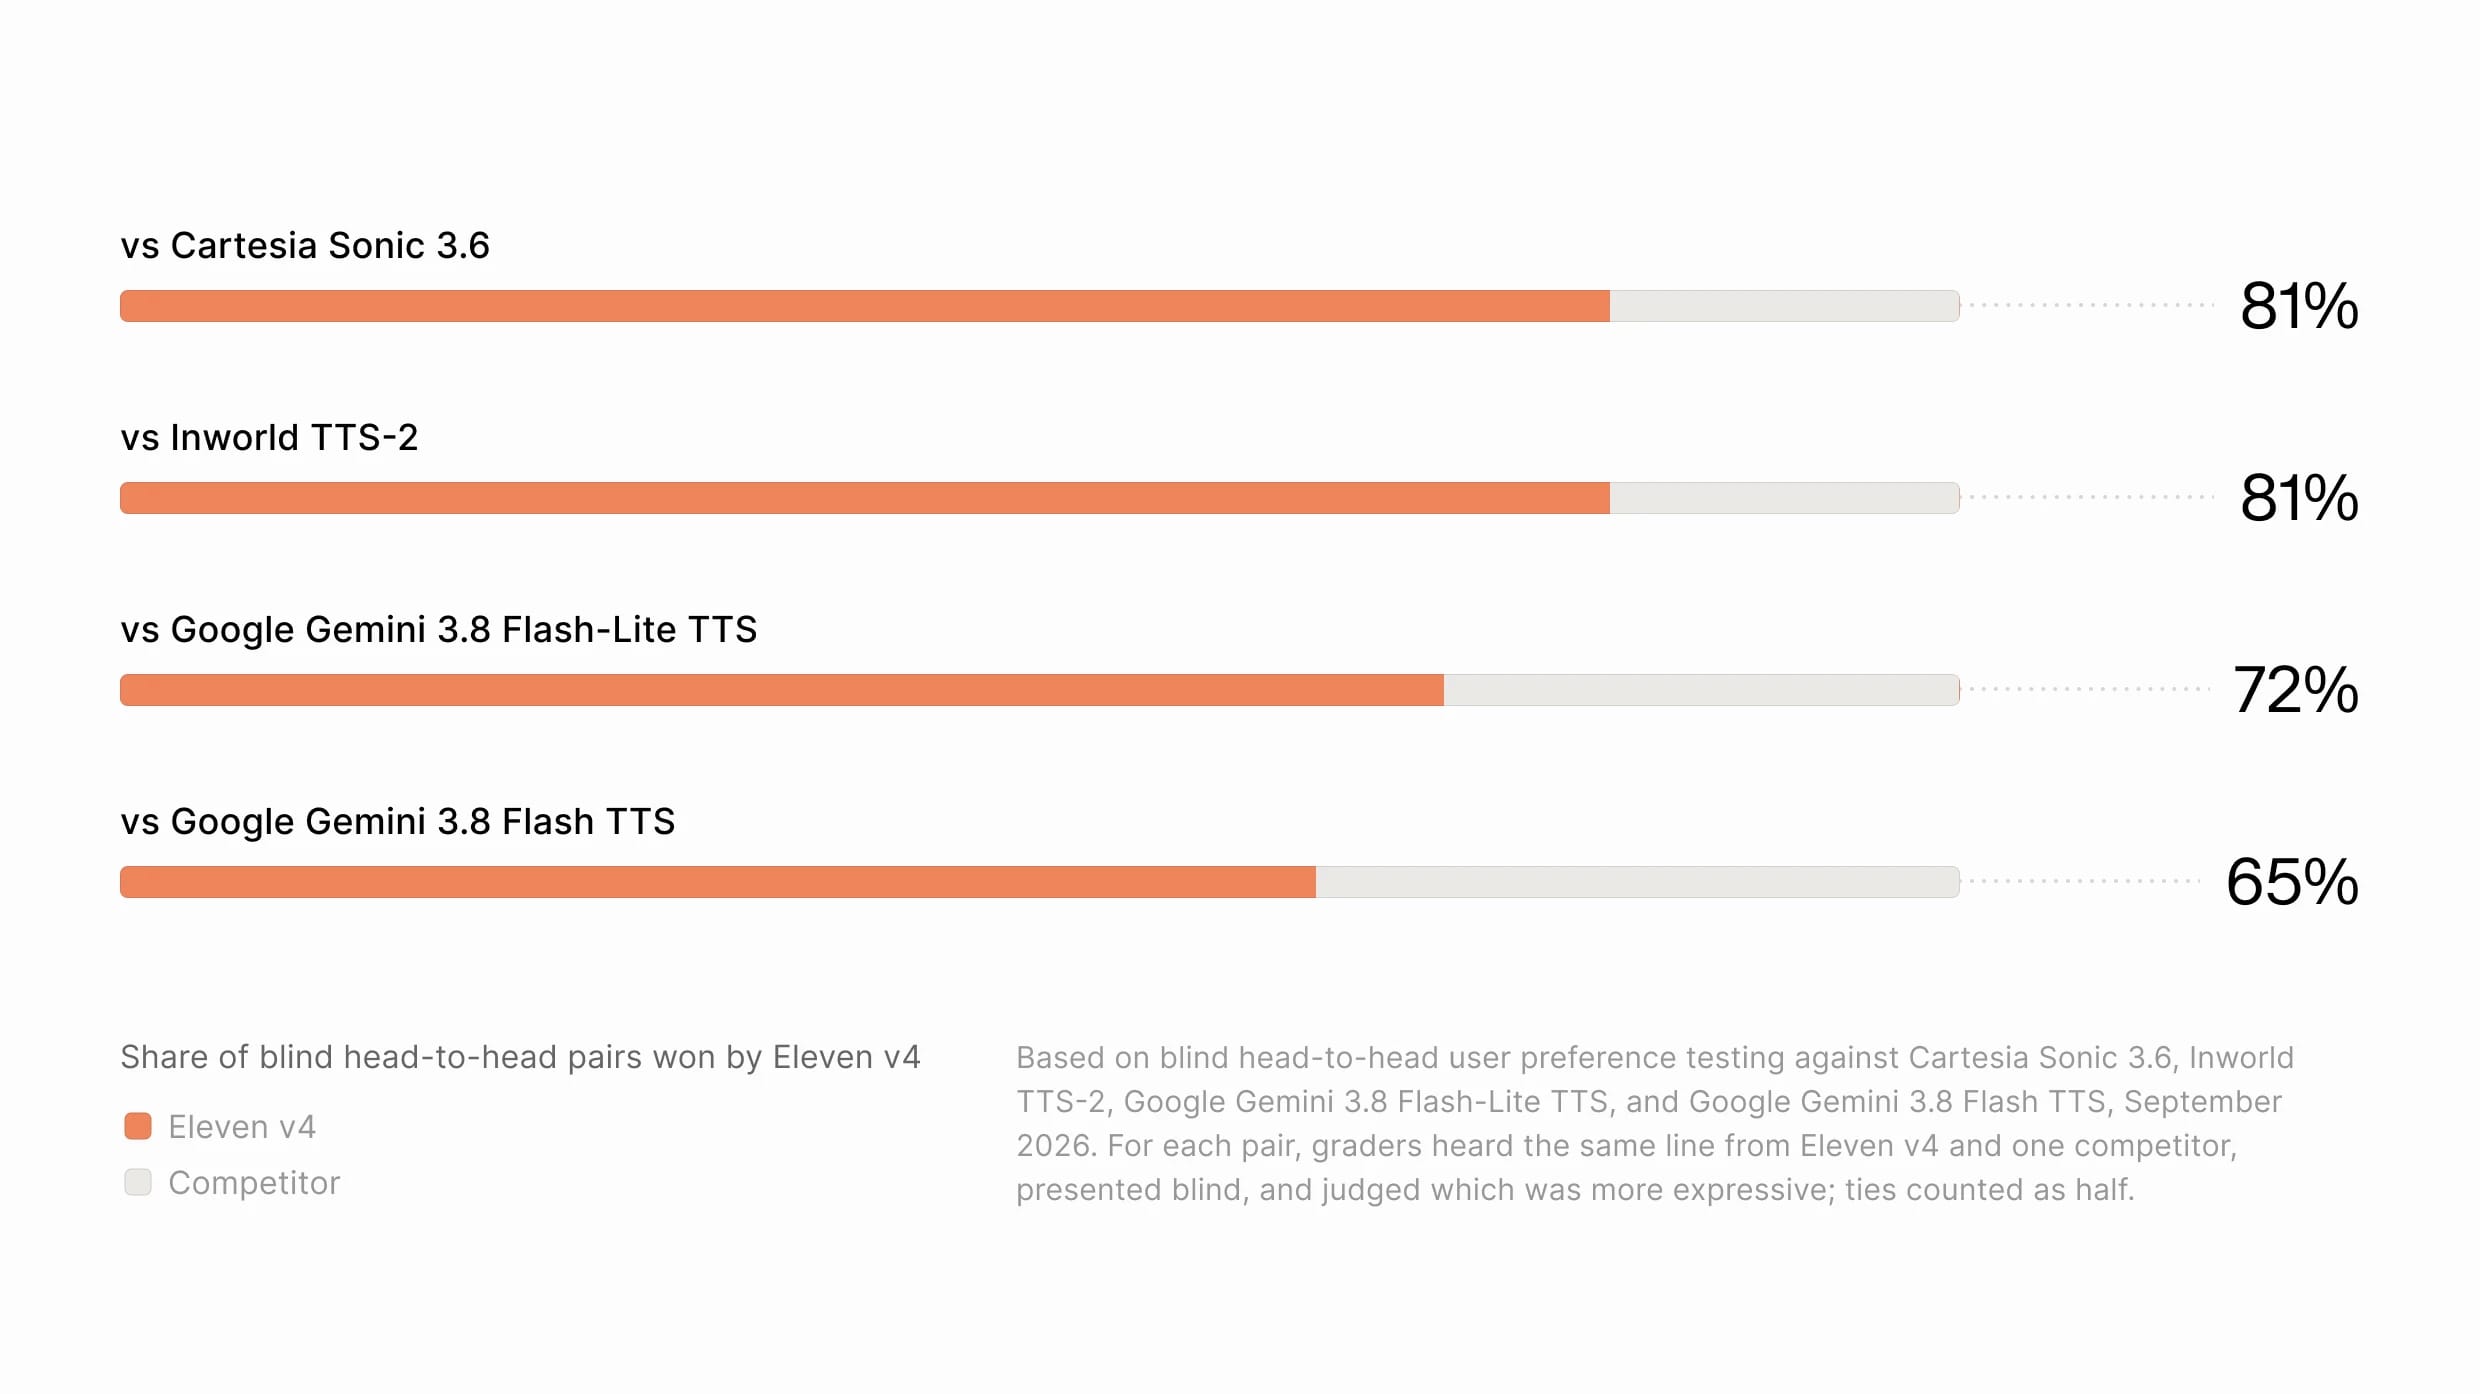
Nr 1 według Artificial Analysis1, a w ślepych testach porównawczych preferowany przez ok. 75% słuchaczy względem konkurencyjnych modeli2, Eleven v4 powstał, by rozumieć ton, tempo, emocje, charakter i kontekst. Generuje mowę, która może brzmieć dramatycznie, czule, pilnie, komediowo lub konwersacyjnie, zachowując tożsamość mówiącego. Bardziej naturalna dynamika wielu rozmówców sprawia, że rozmowy brzmią jak prawdziwa wymiana zdań, a nie osobne kwestie złożone w całość. Mówcy reagują na kontekst rozmowy, dzięki czemu dialogi i interakcje postaci są bardziej naturalne.
Nowa architektura stworzona z myślą o wydajności
Oparty na całkowicie nowej architekturze Eleven v4 to nasz najbardziej ekspresyjny model Text to Speech, zajmujący 1. miejsce w rankingu Artificial Analysis1. Eleven v4 Turbo wykorzystuje tę samą technologię w zastosowaniach wymagających niskich opóźnień, takich jak agenci. Przy medianie opóźnienia inferencji wynoszącej ok. 100 ms może odpowiadać szybciej niż trwa przeciętna przerwa między wypowiedziami dwóch osób.
Oba modele generują mowę pełną emocji, a nie mechaniczną. Jakość dźwięku jest też wyższa pod każdym względem — rezultaty są czystsze i bardziej naturalne.
Wcześniejsze generacje modeli zamiany tekstu na mowę potrafią czytać tekst na głos, ale Eleven v4 nadaje mowie znacznie bardziej naturalną głębię emocjonalną. Model interpretuje zamierzony ton, tempo wypowiedzi, charakter tekstu i jego kontekst, by generować mowę, która porusza emocjonalnie.
Użytkownicy mają też precyzyjną kontrolę nad rezultatem i mogą w języku naturalnym opisać, jak dana kwestia ma zostać wypowiedziana. Mogą też dodać konkretne instrukcje dotyczące wymowy danych fraz, emocji, które mają przekazać, a nawet efekty dźwiękowe, używając tagów śródliniowych, takich jak [laughs], [said angrily in French accent], [light rain] lub [phone buzzing]. Eleven v4 dokładniej niż wcześniejsze modele stosuje te tagi audio i wskazówki, więc otrzymujesz dokładnie taką interpretację, jaką opiszesz. Ułatwia to reżyserowanie narracji, rozwijanie postaci i ich dialogów oraz wszystko tam, gdzie liczy się sposób wypowiedzi.
W dokumentacji dla deweloperów ElevenLabs znajdziesz pełną składnię tagów i informacje, jak stosować je przez API. Znacznie poprawiliśmy też obsługę fonemów Międzynarodowego Alfabetu Fonetycznego (IPA), dzięki czemu niestandardowa wymowa działa bardziej niezawodnie.
Eleven v4 poprawia też spójność i dynamikę rozmów między wieloma mówcami. Dzięki nowej metodzie uchwytywania tożsamości mówców Eleven v4 zachowuje unikalne cechy każdego głosu. Utrzymuje spójność mowy w rozmowach agentów, audiobookach i reklamach. Ponieważ model rozumie kontekst całej sceny, tworzy naturalne dialogi, w których mówcy reagują na to, co przed chwilą usłyszeli, zamiast łączyć odizolowane kwestie.
Model Turbo do zastosowań wymagających niskich opóźnień
Wysokiej jakości modele głosowe zwykle wolniej generowały mowę, więc użytkownicy musieli wybierać między szybkimi a ekspresyjnymi agentami głosowymi. Wielu wybierało sprawnych, ale monotonnych agentów, którzy mogą brzmieć robotycznie dla zdenerwowanego klienta chcącego po prostu rozwiązać swój problem.
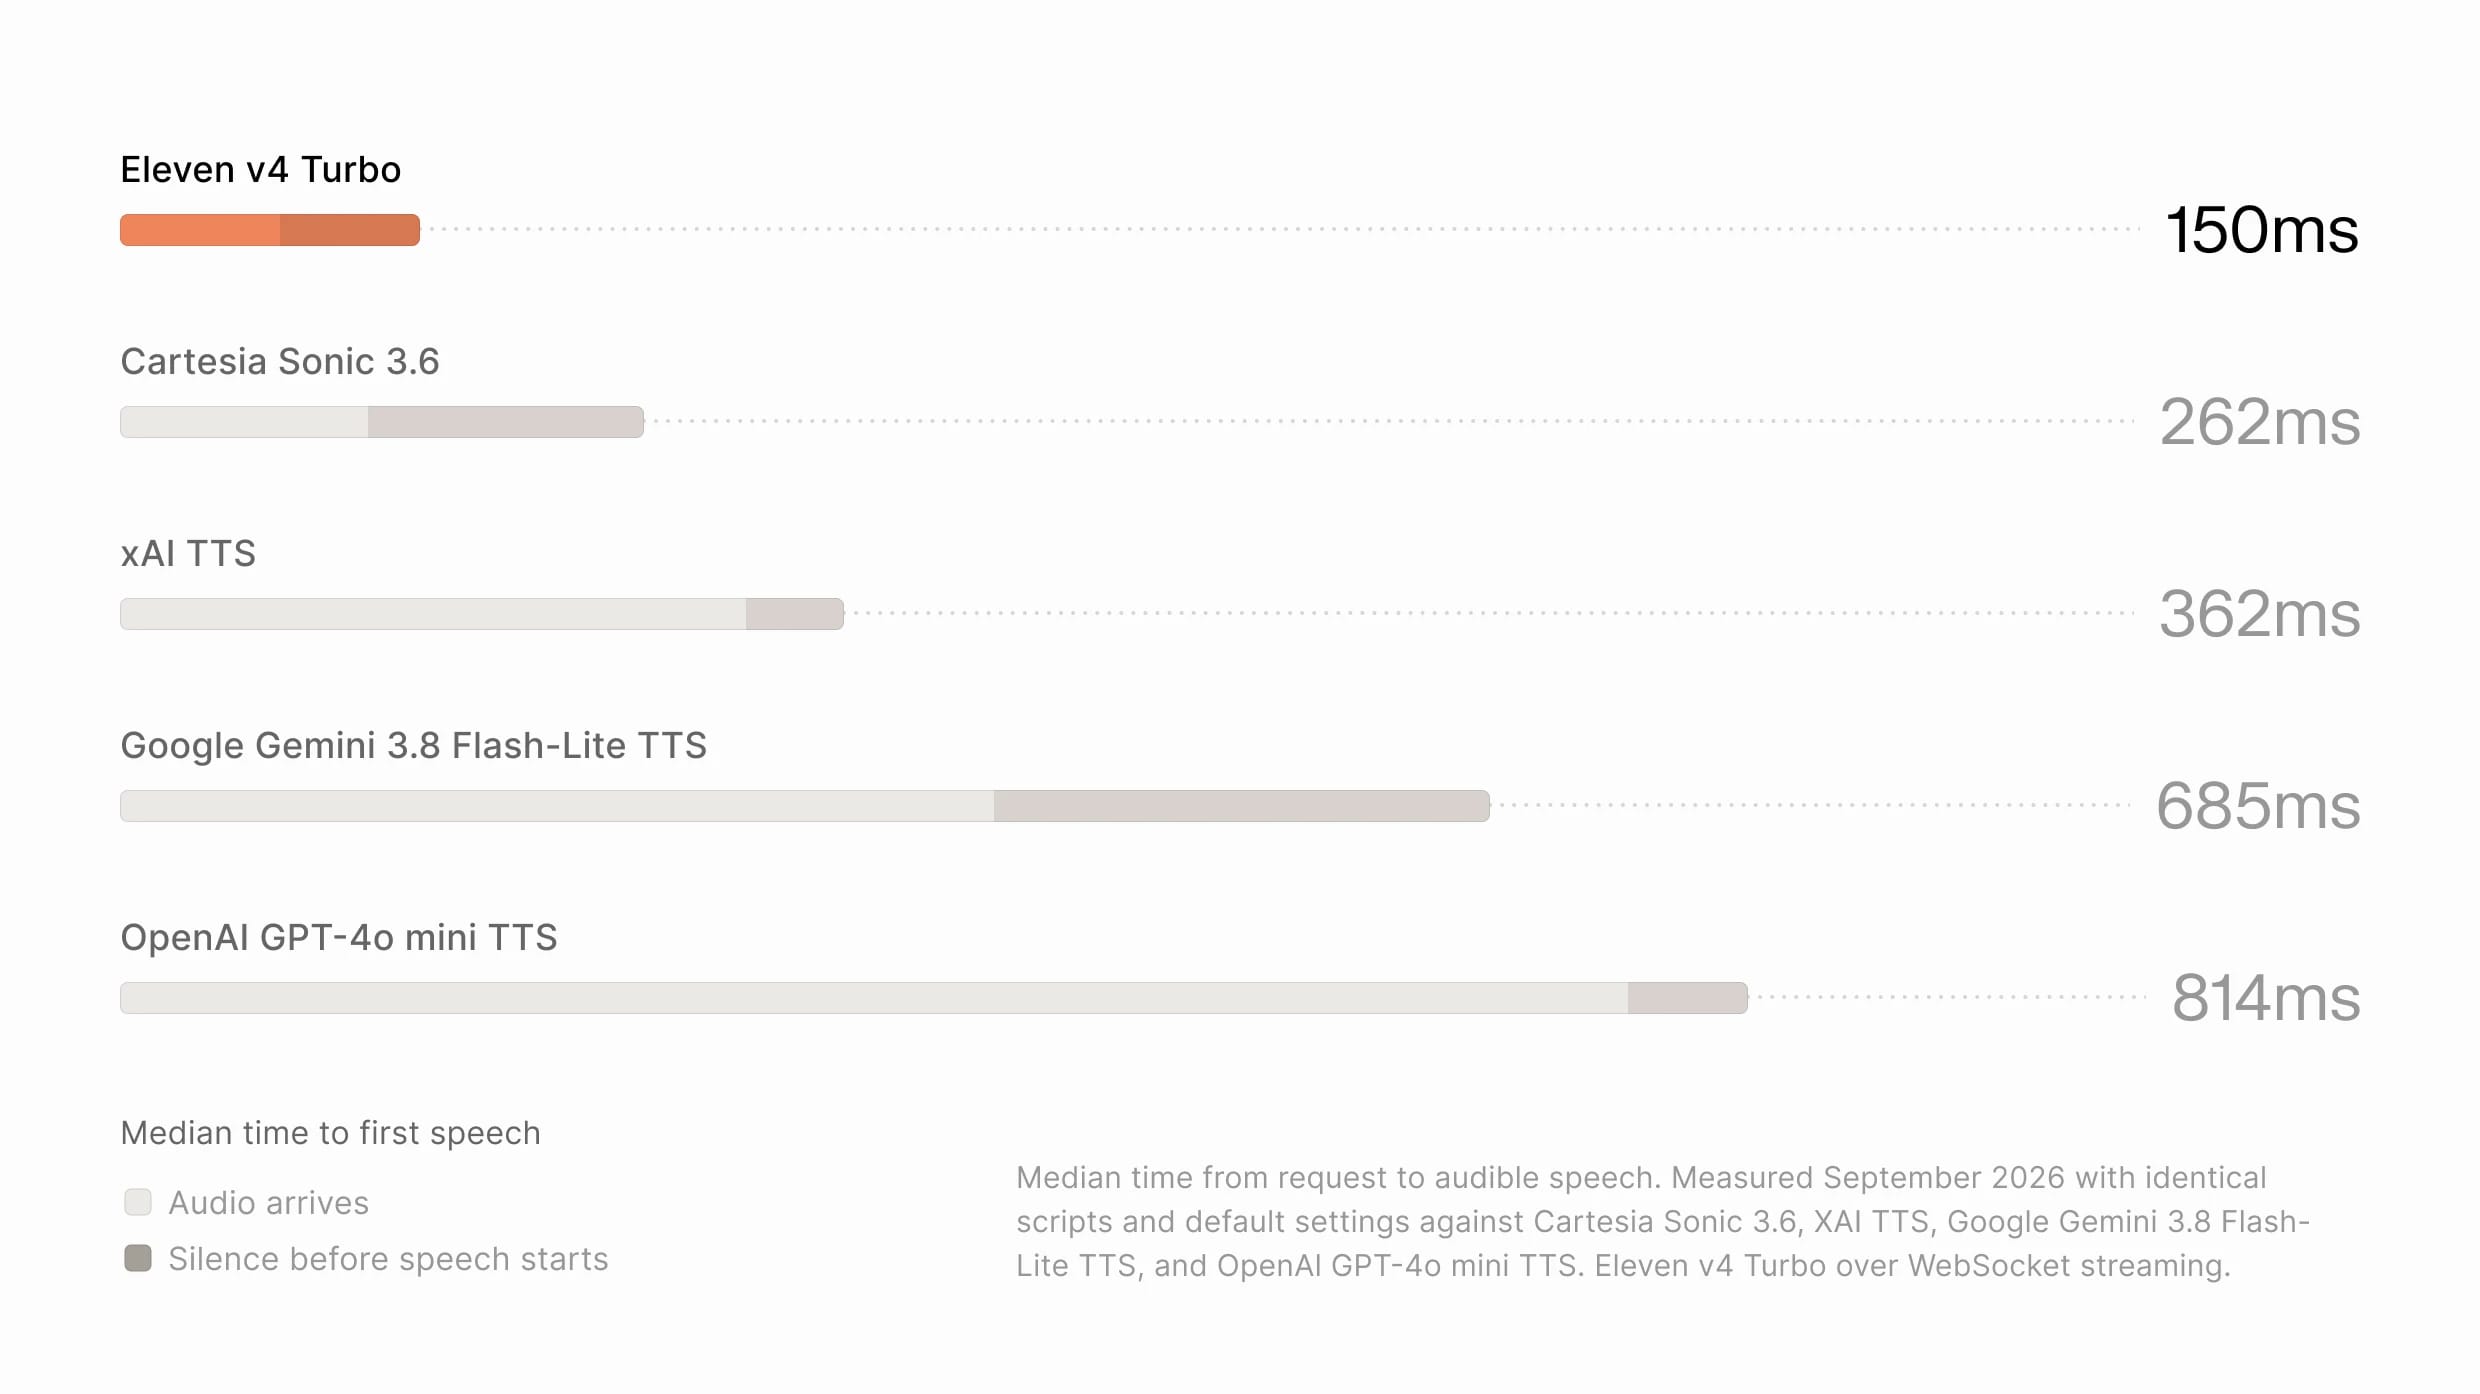
Eleven v4 Turbo łączy szybkość z emocjami, oferując medianę czasu do pierwszej wypowiedzi na poziomie ok. 150 ms3, co pozwala wdrażać zaawansowanych agentów w niezliczonych branżach — od ciepłych, uspokajających agentów, którzy poprawnie wymawiają terminy medyczne w ochronie zdrowia, po szybko mówiących agentów używających slangu, którzy bawią graczy w gamingu.
Model Eleven v4 Turbo stworzono do współpracy z platformą agentów konwersacyjnych ElevenLabs, ElevenAgents. Inni twórcy agentów łączą modele i oprogramowanie od różnych dostawców, przez co użytkownicy nie mają możliwości dopracowania ani ulepszenia wyników modelu pod swoje zastosowania. Zespoły badawcze i inżynieryjne ElevenLabs zoptymalizowały Eleven v4 Turbo i ElevenAgents jako jeden system, zapewniając bardziej ekspresyjnych, niezawodnych agentów o niskich opóźnieniach.
Jeden głos, niezliczone języki
Sposób, w jaki się komunikujemy, zależy od kontekstu, miejsca, a nawet pory dnia. Tworzenie ekspresyjnej mowy, która odzwierciedla te różnice w wielu językach, wciąż jest jednym z najtrudniejszych wyzwań w audio AI.
Eleven v4 to postęp w każdym z tych obszarów, a ulepszenia wykraczają poza samą wymowę fraz. Eleven v4 lepiej oddaje rytm, emocje i sposób wypowiedzi w różnych językach, pomagając twórcom generować mowę naturalną dla danego języka i kontekstu. Na przykład do starszej nieznajomej osoby w Japonii zwrócisz się zupełnie inaczej niż we Włoszech.
Zarówno Eleven v4, jak i Eleven v4 Turbo obsługują ponad 90 języków. Głos nagrany w jednym języku może teraz płynnie mówić w każdym innym, przyjmując akcent rodzimego użytkownika języka i zachowując tożsamość oryginału. Wierność akcentowi jest zauważalnie większa niż wcześniej, więc głos nie wraca już stopniowo do akcentu języka źródłowego podczas generowania.
Kataloński
Hiszpański
W przypadku dubbingu i lokalizacji oznacza to, że wybrany przez ciebie głos marki — niezależnie od tego, czy jest to znany aktor, z którym współpracujesz, czy ton najlepiej pasujący do stylu twojej firmy — będzie świetnie brzmiał w każdym języku obsługiwanym przez Eleven v4.
Bardziej autentyczne i spójne klonowanie głosu
Klonowanie głosu w Eleven v4 i Eleven v4 Turbo jest bardziej autentyczne, skuteczne i spójne, ze znacznie lepszym podobieństwem mówcy do oryginalnego głosu źródłowego. Instant Voice Clones potrafią teraz wiernie uchwycić głos na podstawie zaledwie 10 sekund nagrania.
Prawdziwy głos
Eleven v4
Eleven v4 niezawodniej zachowuje też tożsamość mówcy w kolejnych generacjach, dialogach, narracji i regenerowanych kwestiach. Oznacza to, że w dłuższych projektach postacie, narratorzy i sklonowane głosy pozostają spójne przez całą produkcję. Eleven v4 dodaje również obsługę Professional Voice Clones (PVC) dla zastosowań wymagających najwyższej jakości klonowania.
Łączenie żądań — zestawianie kolejnych generacji w dłuższe treści — jest też znacznie bardziej niezawodne w Eleven v4, co ułatwia pracę w ElevenLabs Studio i aplikacji Reader od ElevenLabs.
Usłysz różnicę
Eleven v4 i Eleven v4 Turbo są efektem naszych najnowszych badań nad generowaniem ekspresyjnej mowy. Stworzyliśmy je do treści, w których sposób wypowiedzi jest równie ważny jak same słowa — od audiobooków, przez kreacje postaci i nałożone głosy, po dubbing i lokalizację agentów konwersacyjnych.
Oba modele są już dostępne w ElevenAgents, ElevenCreative oraz przez ElevenAPI. Utwórz darmowe konto i zacznij generować z Eleven v4 lub Eleven v4 Turbo już dziś.
- Artificial Analysis, ranking Provider Voice Arena, wrzesień 2026
- Na podstawie ślepych testów preferencji użytkowników w bezpośrednim porównaniu z Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS i Google Gemini 3.8 Flash TTS, wrzesień 2026. W każdej parze oceniający słyszeli tę samą kwestię z Eleven v4 i od jednego konkurenta, bez informacji o źródle, a następnie oceniali, która wersja jest bardziej ekspresyjna i brzmi naturalniej; remisy liczono jako połowę.
- Mediana czasu od żądania do słyszalnej mowy. Pomiar z września 2026 r. przeprowadzono na identycznych skryptach i ustawieniach domyślnych względem Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS i OpenAI GPT-4o mini TTS; dla wszystkich systemów zmierzono i odjęto opóźnienie sieciowe. Eleven v4 Turbo przez streaming WebSocket.