Czym są Audio Tags? Kompletny przewodnik po emocjonalnym TTS
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
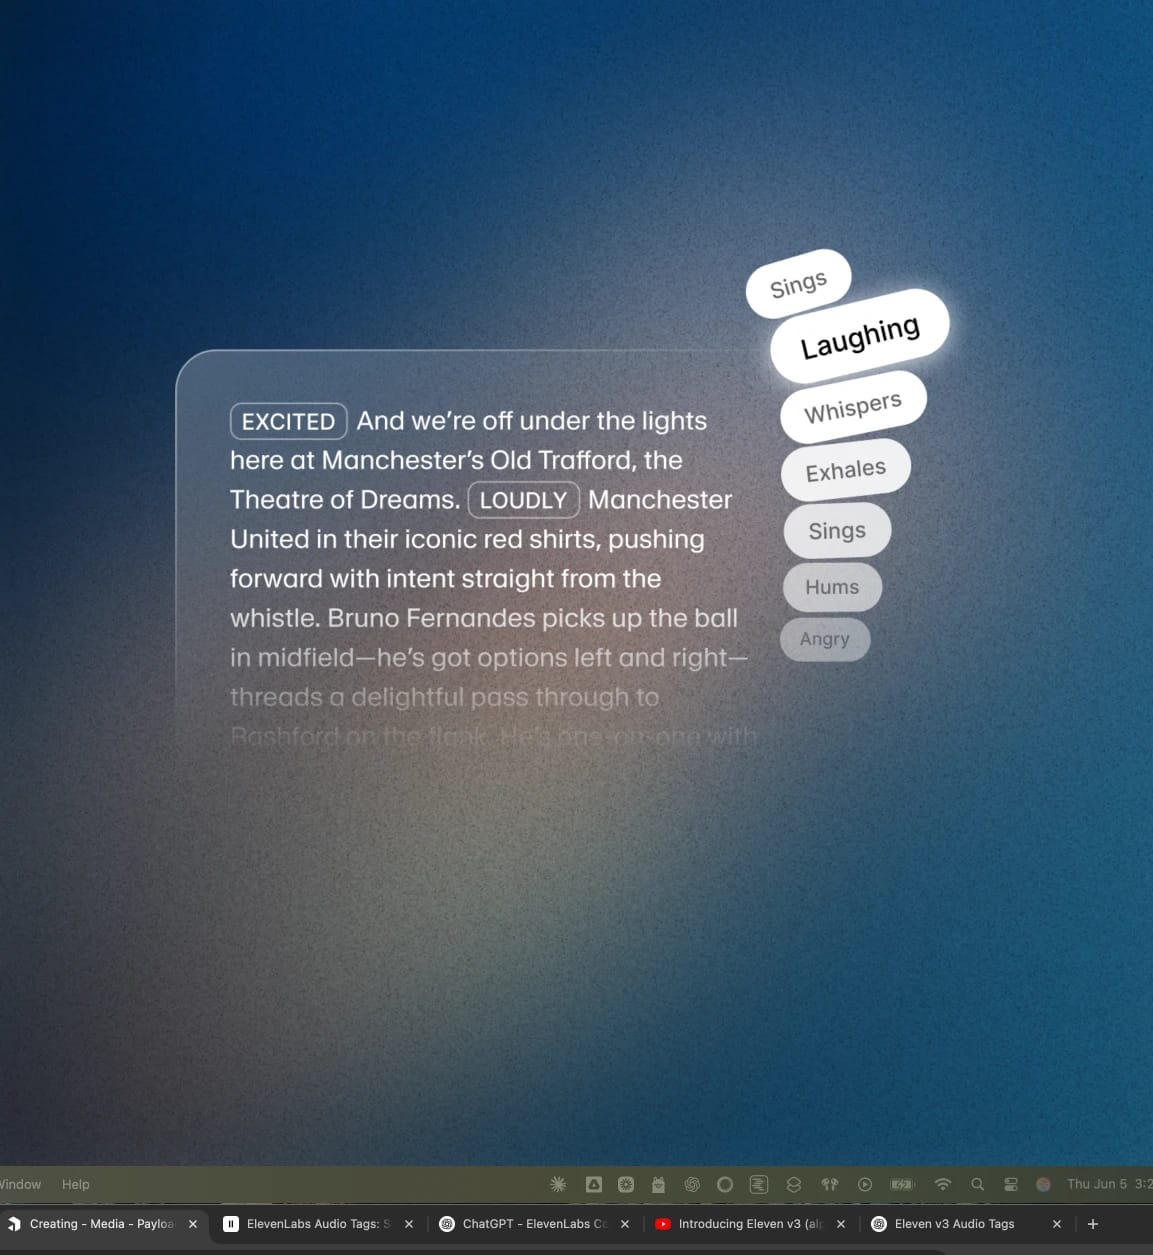
Audio Tags to wskazówki w nawiasach kwadratowych, zapisane naturalnym językiem, takie jak [laughs], [gasps], [excited] i [worried]. Eleven v3 i Eleven v4 odczytują je jako wskazówki wykonawcze, a nie słowa do wypowiedzenia. Gdy piszesz skrypt dla modelu zamiany tekstu na mowę, Audio Tags dają ci precyzyjną kontrolę nad emocjonalnym przekazem tekstu.
Eleven v3 został udostępniony publicznie w marcu 2026 roku. Przed v3 uzyskanie konkretnego emocjonalnego wykonania z modelu Text to Speech wymagało ponownego generowania treści i liczenia na najlepszy efekt. Audio Tags eliminują tę zgadywankę, dając ci pełną kontrolę nad emocjonalnym wykonaniem zamiany tekstu na mowę. Eleven v4 idzie jeszcze dalej, dając ci precyzyjną kontrolę nad emocjami.
Z tego przewodnika dowiesz się, czym są Audio Tags, jak działają, jakie kategorie tagów są dostępne oraz jak wypadają na tle SSML (Speech Synthesis Markup Language). Omówimy też typowe zastosowania — każde z linkiem do osobnego przewodnika.
Podsumowanie
- Audio Tags to wskazówki w nawiasach kwadratowych, takie jak [shouts] czy [excited], które kierują emocjami, tempem, sposobem wypowiedzi i tonem TTS w Eleven v3 oraz Eleven v4.
- Eleven v3 i Eleven v4 nie obsługują SSML, lecz zastępują go Audio Tags, dzięki czemu skrypty pisze się bardziej naturalnie.
- Tagi obejmują kilka kategorii, m.in. emocje, sposób wypowiedzi i tempo, ludzkie reakcje, akcenty oraz efekty dźwiękowe.
- Interpunkcja i wielkie litery w tekście pozwalają kształtować tempo wypowiedzi głosu AI.
- Z Audio Tags w ElevenLabs możesz korzystać w UI lub przez API.
Jak działają Audio Tags?
Audio Tags umieszczasz bezpośrednio w transkrypcji i zapisujesz w nawiasach kwadratowych. Gdy chcesz zmienić sposób wypowiedzi, na przykład z normalnego na [worried], po prostu dodaj tag audio.
W jednym zdaniu możesz użyć kilku tagów i łączyć je, by uzyskać bardziej złożoną interpretację, np. [tired] To był długi dzień… [upset] Ile jeszcze dni tak wytrzymam?
Architektura Eleven v4 pozwala modelowi rozumieć kontekst głębiej niż wcześniejsze modele. Dzięki temu podąża za wskazówkami emocjonalnymi, zmianami tonu, przejściami między mówcami i sygnałami z kontekstu bez osobnych parametrów czy ustawień. Po prostu powiedz modelowi, czego wymaga dana chwila, a wypowie kwestię dokładnie tak, jak planujesz.
Eleven v4 obsługuje też spontanicznie brzmiące dialogi wielu osób, w tym przerwania, zmiany nastroju i naturalną wymianę zdań — wyłącznie na podstawie tagów i struktury skryptu.
Audio Tags a SSML
Jeśli pracujesz z innymi systemami TTS, zapewne znasz Speech Synthesis Markup Language. Platformy takie jak Amazon Polly i Microsoft Azure Speech używają tagów SSML, np. <break> lub <emphasis>, aby dodać kontekst do skryptu TTS.
Eleven v4 nie obsługuje tagów przerw SSML ani pozostałych tagów SSML. Zamiast nich Audio Tags, interpunkcja i sama struktura tekstu pełnią tę funkcję, jednocześnie zapewniając precyzyjną kontrolę nad sposobem wypowiedzi.
W poniższej tabeli znajdziesz odpowiedniki popularnych tagów SSML w Eleven v4.
Z perspektywy autora dodanie [whispers] do kwestii wymaga znacznie mniej wysiłku niż ustawienie tempa prozodii.
Kategorie Audio Tags w v3: kierowanie interpretacją za pomocą Audio Tags
Audio Tags możesz umieścić w dowolnym miejscu skryptu, aby na bieżąco kształtować sposób wypowiedzi. Możesz też łączyć tagi w skrypcie, a nawet w jednym zdaniu.
Tagi należą do następujących głównych kategorii.
Emocje
Te tagi pomagają ustawić emocjonalny ton głosu — ponury, intensywny lub radosny. Możesz użyć na przykład jednego tagu albo połączyć [sad], [angry], [happily] i [sorrowful].
Sposób wypowiedzi i tempo
Dotyczą bardziej tonu i interpretacji. Używaj ich, by dostosować głośność i energię w scenach wymagających powściągliwości lub siły. Przykłady to [whispers], [shouts] i [softly].
Ludzkie reakcje
Naprawdę naturalna mowa obejmuje reakcje. Możesz na przykład dodać realizmu, wplatając w wypowiedź naturalne, nieskryptowane momenty. Tagi takie jak [laughs], [clears throat] i [sighs] pomagają tworzyć model TTS, który potrafi oddać ludzkie emocje.
Inne przykłady kategorii tagów audio to:
- Akcenty i głosy postaci: Tagi akcentów zmieniają głos na określony region lub personę bez zmiany modelu, np. [French accent], [British accent] lub [pirate voice]. Dzięki nim jeden głos może stać się elastyczną obsadą zamiast jednej stałej interpretacji.
- Efekty dźwiękowe: Tagi efektów dźwiękowych dodają dźwięki niemowy bezpośrednio do generowania, np. [gunshot], [explosion] i [clapping]. Sprawdzają się w immersyjnym audio, grach i dramatyzowanych narracjach, gdy scena potrzebuje czegoś więcej niż głosu. Alternatywnie użyj generatora efektów dźwiękowych AI ElevenCreative.
Tagi dają ci dużą kontrolę, ale rytm i nacisk możesz też kształtować interpunkcją. Na przykład dodaj wielokropek, by uzyskać naturalną pauzę, lub użyj przecinków, by stworzyć naturalny rytm oddechu. Spróbuj zapisać słowo WIELKIMI LITERAMI, by je podkreślić: „Chcę tego WŁAŚNIE TERAZ”.
Co możesz zrobić z Audio Tags?
Audio Tags w intuicyjny sposób dodają skryptom emocjonalnej złożoności. Pisz naturalnie i dodawaj tagi po drodze.
Oto kilka zastosowań emocjonalnego TTS z Audio Tags.
Świadomość sytuacyjna w audio AI
Tagi takie jak [whisper] lub [shouting] pozwalają Eleven v4 reagować na daną chwilę. Możesz złagodzić ostrzeżenie albo wydłużyć pauzę, by budować napięcie, i w ten sposób nadać skryptowi dynamiczną świadomość sytuacyjną.
Pełne omówienie znajdziesz w naszym przewodniku o świadomości sytuacyjnej w audio AI.
Kierowanie interpretacją postaci w mowie
Tworząc skrypt z wieloma postaciami, chcesz wyraźnie pokazać, czym różni się każdy głos. Od dopracowania osobowości za pomocą [sarcastically] po określenie sposobu mówienia tagiem [British accent] — nasz silnik TTS pozwala uchwycić pełną gamę emocji.
Dowiedz się więcej o kierowaniu interpretacją postaci w mowie AI.
Wyrażanie emocjonalnego kontekstu w mowie
Audio Tags pozwalają kształtować emocjonalny przekaz kwestii w miarę jej rozwoju. Możesz budować emocje w całej wypowiedzi i osiągnąć kulminację dokładnie wtedy, gdy wyobrażasz sobie postać u szczytu swoich możliwości. Tagi takie jak [awe], [booming] i [big laugh] pomagają wbudować pełną gamę emocji w interpretację głosu AI.
Przeczytaj więcej o używaniu emocjonalnego kontekstu w mowie AI.
Ożywianie dialogów wielu postaci
Tworząc dialogi wielu postaci, możesz zaczynać każdą kwestię od tagu audio, by budować bogate rozmowy postaci.
Spójrz na ten przykład: Tom: [coughing] [beginning to speak] przepraszam, jestem dziś trochę chory— Emma: [interrupting] —Chory? Wiesz, jak nie znoszę kaszlu, Tom! Tom: [surprised] To tylko lekki kaszel, nic poważnego. Jak byś się czuła, gdyby— Emma: [overlapping] [annoyed] —Myślę, że powinieneś iść do domu.
Zobacz, co jeszcze możesz zrobić z dialogami wielu postaci w Eleven v3.
Precyzyjna kontrola sposobu wypowiedzi w mowie AI
W Eleven v3 i Eleven v4 możesz kontrolować tempo mowy za pomocą Audio Tags lub interpunkcji. Tagi takie jak [pause], [rushed] i [drawn out] pozwalają precyzyjnie kształtować kwestię. Możesz też użyć wielokropków, kropek i wykrzykników, aby naturalnie dodać emocje do interpretacji TTS.
Napisaliśmy szczegółowy przewodnik o precyzyjnej kontroli sposobu wypowiedzi w Eleven v3.
Emocjonalne TTS jest dostępne przez API
Audio Tags działają tak samo przez Text to Speech API jak w UI ElevenLabs. Wstaw tag bezpośrednio do tekstu skryptu, a API zwróci wygenerowane audio z taką interpretacją — od procesów tworzenia audiobooków po głosy do reklam.
Dowiedz się więcej o Eleven v4 lub skontaktuj się ze sprzedażą i zacznij już dziś.
FAQ: Audio Tags i emocjonalne TTS

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.