Eleven v3 Audio Tags: Świadomość sytuacyjna dla audio AI
- Autor
- Ryan Morrison
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
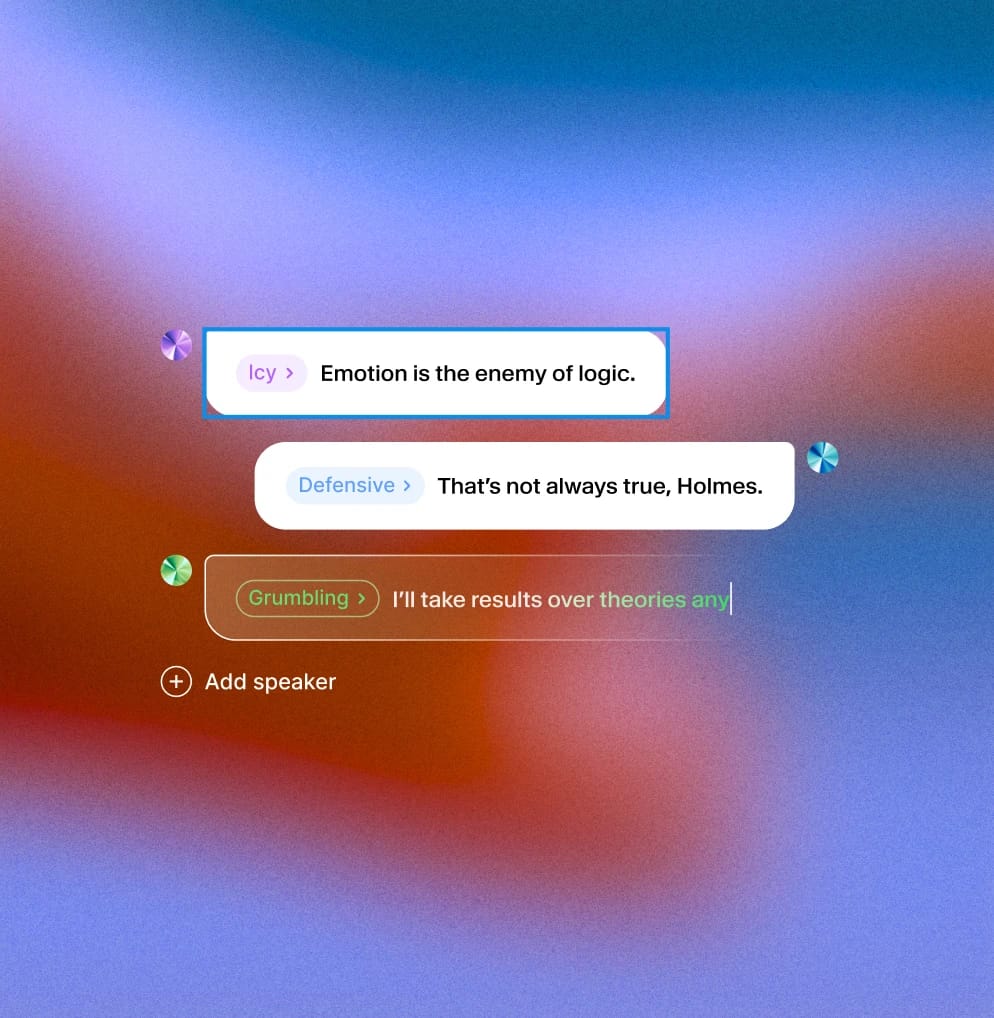
Audio Tags to kluczowa część nowego modelu Eleven v3 (alfa) Text to Speech. Pozwalają kontrolować sposób wypowiadania kwestii — zmieniać ton, emocje i tempo, by oddać kontekst rzeczywistej sytuacji.
W najprostszej formie Audio Tags to słowa w nawiasach kwadratowych. Model interpretuje je jako wskazówki dotyczące wykonania. Dzięki temu możesz w środku zdania zmienić sposób wypowiedzi, by oddać emocje lub zmianę sytuacji — nadając AI pewną świadomość sytuacyjną.
Czym jest świadomość sytuacyjna w mowie AI?
Świadomość sytuacyjna oznacza, że AI dostosowuje sposób wypowiedzi do chwili. Dzięki Audio Tags kontrolujesz nie tylko to, co mówi model — ale też jak reaguje.
Niezależnie od tego, czy dodajesz pilności tagiem [SHOUTING], łagodzisz ostrzeżenie tagiem [WHISPER], czy sygnalizujesz wahanie tagiem [SIGH], tagi zmieniają narrację w występ. Są szczególnie przydatne w scenach z bogatym kontekstem lub dynamiczną akcją.
Występ, nie tylko czytanie
Wyobraź sobie, że piszesz scenariusz filmu z najważniejszymi momentami meczu piłki nożnej między 11 United a 12 United w Veo 3. Chcesz, by napięcie rosło wraz z akcją: „Mija jednego obrońcę — [EXCITED] nadchodzi dośrodkowanie — [SHOUTING] GOOOOL!”
Albo podkładasz głos do pełnej napięcia sceny w audiobooku: „[WHISPERING] Chyba ktoś jest w domu. [PAUSE] Bądź cicho.”
To nie są tylko stylistyczne dodatki. Definiują chwilę i budują jej odczucie. Model nie czyta — występuje.
Popularne tagi do użycia w konkretnych sytuacjach
Audio Tags pozwalają symulować różne sygnały emocjonalne i fizyczne:
- Ton emocjonalny: [EXCITED], [NERVOUS], [FRUSTRATED], [TIRED]
- Reakcje: [GASP], [SIGH], [LAUGHS], [GULPS]
- Głośność i energia: [WHISPERING], [SHOUTING], [QUIETLY], [LOUDLY]
- Tempo i rytm: [PAUSES], [STAMMERS], [RUSHED]
Tagi można łączyć, by dodać niuansów: „[NERVOUSLY] Ja... nie wiem, czy to zadziała. [GULPS] Ale spróbujmy.”
Występ, którym możesz sterować
Eleven v3 obsługuje te tagi dzięki głębszemu modelowi kontekstowemu. Może zmieniać ton w środku wypowiedzi, obsługiwać przerwania i zachować płynność — dzięki czemu brzmienie jest bardziej naturalne bez przepisywania scenariusza.
Dla twórców voice design, deweloperów gier i storytellerów otwiera to nową warstwę kreatywności. Nie tylko piszesz kwestie. Reżyserujesz je.
Wybór właściwego głosu
Professional Voice Clones (PVC) nie są obecnie w pełni zoptymalizowane pod Eleven v3, więc jakość klonów może być niższa niż w przypadku wcześniejszych modeli. Na etapie podglądu badawczego najlepiej wybrać Instant Voice Clone (IVC) lub zaprojektowany głos do projektu, jeśli potrzebujesz funkcji v3. Optymalizacja PVC dla v3 pojawi się wkrótce.
Ryan dołączył do ElevenLabs po ponad dwóch dekadach pracy w mediach i wydawnictwach, w tym w BBC i Future Plc. Skupia się na strategii treści i opowiadaniu historii, pomagając ElevenLabs kształtować i dzielić się swoją narracją.