Jak powstają syntetyczne głosy brzmiące naturalnie?
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Dzisiejsze zaawansowane modele AI tworzą syntetyczne głosy, które brzmią jak naturalna mowa. Modele te są trenowane na ogromnych zbiorach danych z prawdziwymi ludzkimi głosami i wykorzystują zaawansowane sieci neuronowe do rozpoznawania oraz odtwarzania autentycznych wzorców mowy. Tworzenie syntetycznego głosu nazywa się też syntezą mowy lub syntezą głosu, a generowane przez niego audio — mową syntetyczną.
Aby stworzyć nowy syntetyczny głos, użytkownik nagrywa swoją wypowiedź. Model AI analizuje przy tym jego unikalne wzorce fonetyczne i intonację, a następnie używa tych danych, by odtworzyć głos. Użytkownik może potem dostosować cechy głosu, takie jak akcent, ton i tempo, aby uzyskać końcowy efekt. Niektóre syntetyczne głosy są bezpośrednim klonem mowy jednej osoby, a inne łączą wiele głosów. Głosy można też zaprojektować na podstawie opisu tekstowego, całkowicie bez nagrania.
Syntetyczne głosy dają szerokie możliwości twórcze w podcastach, audiobookach, grach wideo i reklamie. W tym artykule wyjaśniamy, jak powstają syntetyczne głosy, co sprawia, że brzmią naturalnie, oraz jak stworzyć własny syntetyczny głos z ElevenLabs.
Podsumowanie
- Syntetyczne głosy powstają dzięki neuronowym modelom AI, które analizują i odtwarzają wzorce ludzkiej mowy.
- Syntetyczne głosy przydają się do narracji audiobooków, tworzenia dialogów do gier wideo, skalowania podcastów i nałożonych głosów, budowania agentów AI do obsługi klienta, a nawet zachowywania głosów zagrożonych utratą.
- Klonowanie głosu polega na analizie nagrań głosu konkretnej osoby i odtwarzaniu jej unikalnego akcentu oraz wzorców mowy.
- Współczesne głosy AI brzmią naturalnie, ponieważ odtwarzają ludzką prozodię i rozumieją kontekst, zamiast jedynie powielać pojedyncze słowa lub sylaby.
Jak krok po kroku powstają syntetyczne głosy
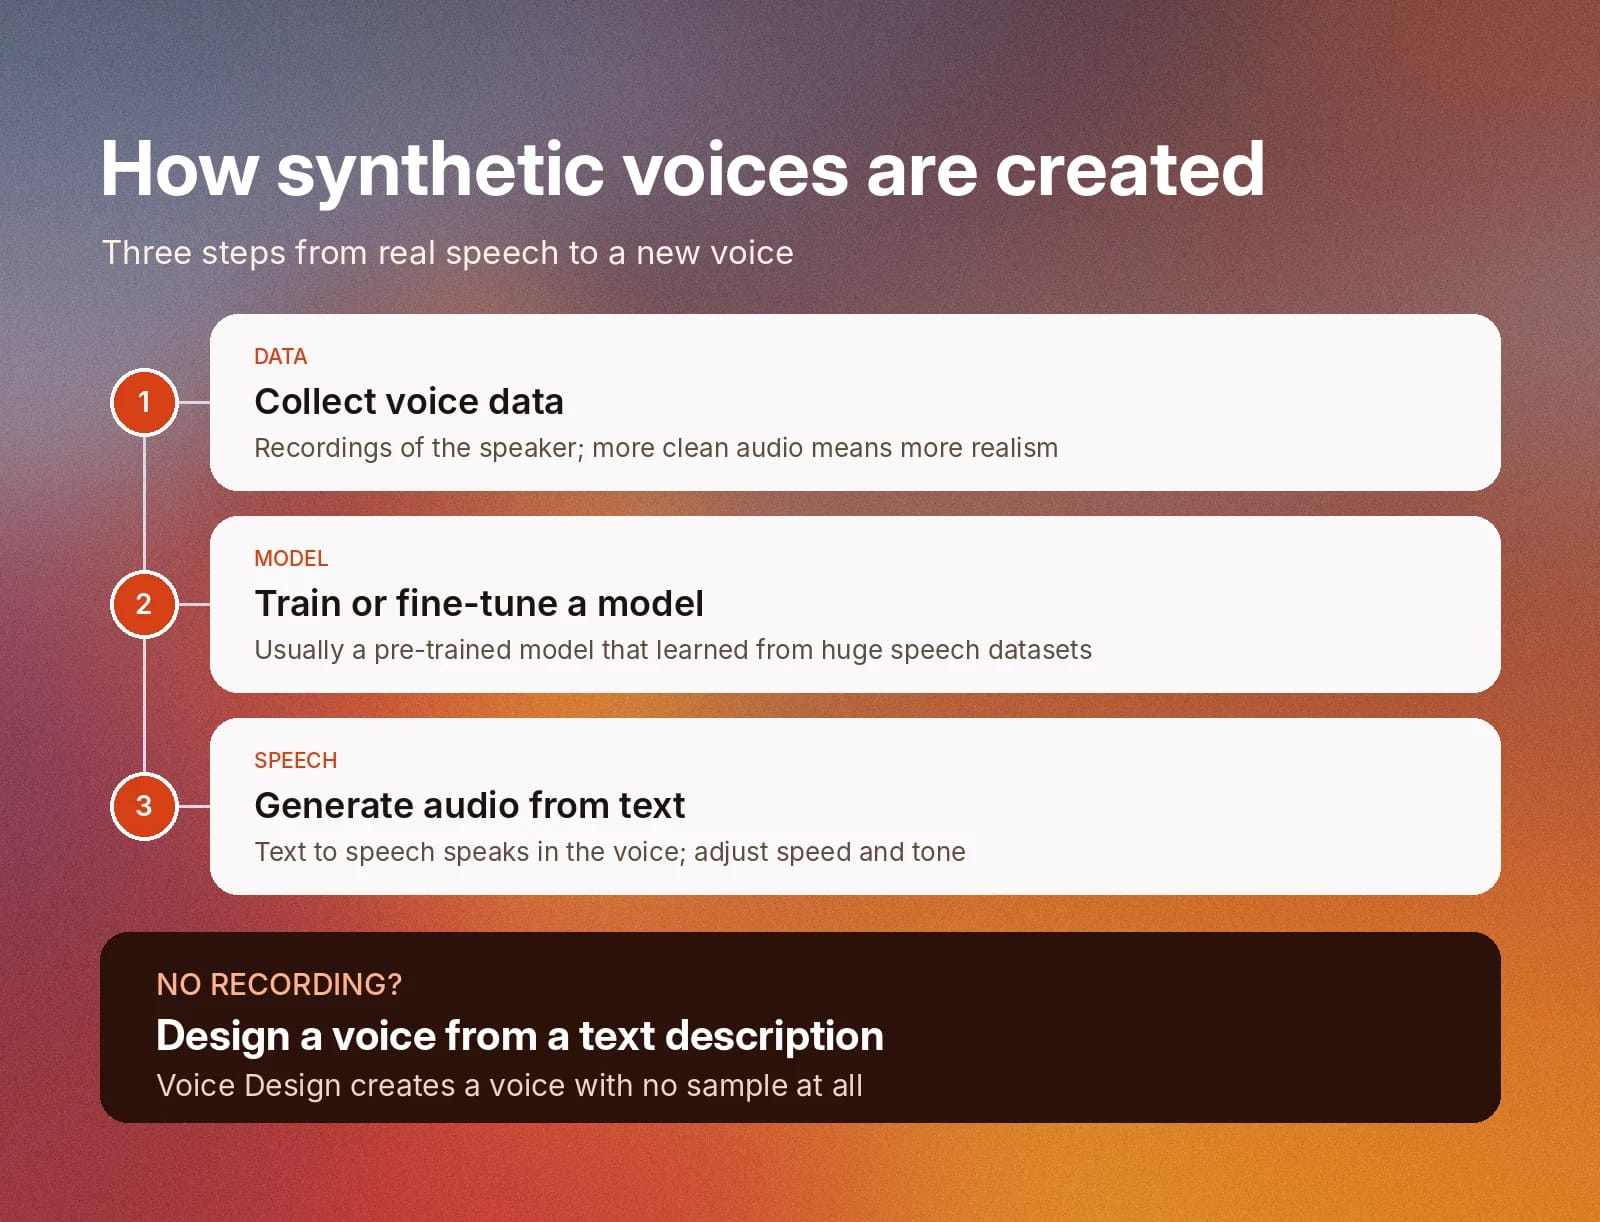
Tworzenie syntetycznego głosu przebiega w trzech krokach.
Tak wygląda to w praktyce:
- Krok 1: Zbierz dane głosowe: Syntetyczne głosy zaczynają się od prawdziwej ludzkiej mowy. Aby stworzyć nowy głos, potrzebujesz nagrań audio osób, których głos chcesz odtworzyć. Im więcej danych podasz, tym dokładniejszy i bardziej realistyczny będzie efekt. Oto kilka dobrych praktyk klonowania głosu.
- Krok 2: Wytrenuj lub dostrój model AI: Aby tworzyć syntetyczne głosy, modele AI najpierw analizują obszerne zbiory różnorodnych nagrań mowy. Wykorzystują te dane, by zrozumieć wzorce ludzkiej mowy. Po wytrenowaniu model AI może klonować prawdziwe głosy na podstawie jednego nagrania. W większości przypadków użyjesz gotowego, wytrenowanego modelu, zamiast budować własny od zera.
- Krok 3: Wygeneruj audio z tekstu: Syntetyczne głosy wykorzystują zamianę tekstu na mowę do generowania audio. Możesz dostosować takie parametry jak szybkość i ton do swoich preferencji. Więcej informacji znajdziesz w naszym przewodniku o tym, jak działa technologia zamiany tekstu na mowę.
Od danych mowy do neuronowej zamiany tekstu na mowę
Neuronowe modele zamiany tekstu na mowę są trenowane na licznych zbiorach prawdziwych nagrań mowy. Obejmują one nagrania w różnych językach, z różnymi akcentami, emocjami i wysokością głosu. Neuronowa zamiana tekstu na mowę to dziś powszechnie stosowana forma syntezy mowy.
Tradycyjne modele łączyły istniejące nagrania słów, sylab i fonemów. Efekty były bardzo mechaniczne, ponieważ modele te nie potrafiły odtworzyć zmian wysokości głosu, rytmu i ekspresji, które sprawiają, że mowa brzmi po ludzku.
Nowoczesne neuronowe modele zamiany tekstu na mowę nie uczą się jedynie brzmienia liter i sylab, lecz naturalnych wzorców wymowy oraz rytmu ludzkiej mowy. Podczas zamiany tekstu na mowę analizują tekst, przekształcają go w cechy akustyczne, a następnie wykorzystują je do generowania przebiegów falowych.
Ponieważ cechy akustyczne, takie jak wysokość głosu, rytm i ton, są wbudowane w neuronowe modele AI, generowana mowa brzmi znacznie naturalniej i bardziej autentycznie niż w dawnych modelach.
Wyniki można też dostosować: zmienisz szybkość, emocje, a nawet akcent, aby uzyskać dokładnie taki głos, jakiego szukasz. Na przykład marka może używać tego samego syntetycznego głosu na całej stronie, ale w treściach marketingowych nadać mu ekscytację i pilność, a w obsłudze klienta — spokój.
Standardowa, neuronowa i generatywna zamiana tekstu na mowę
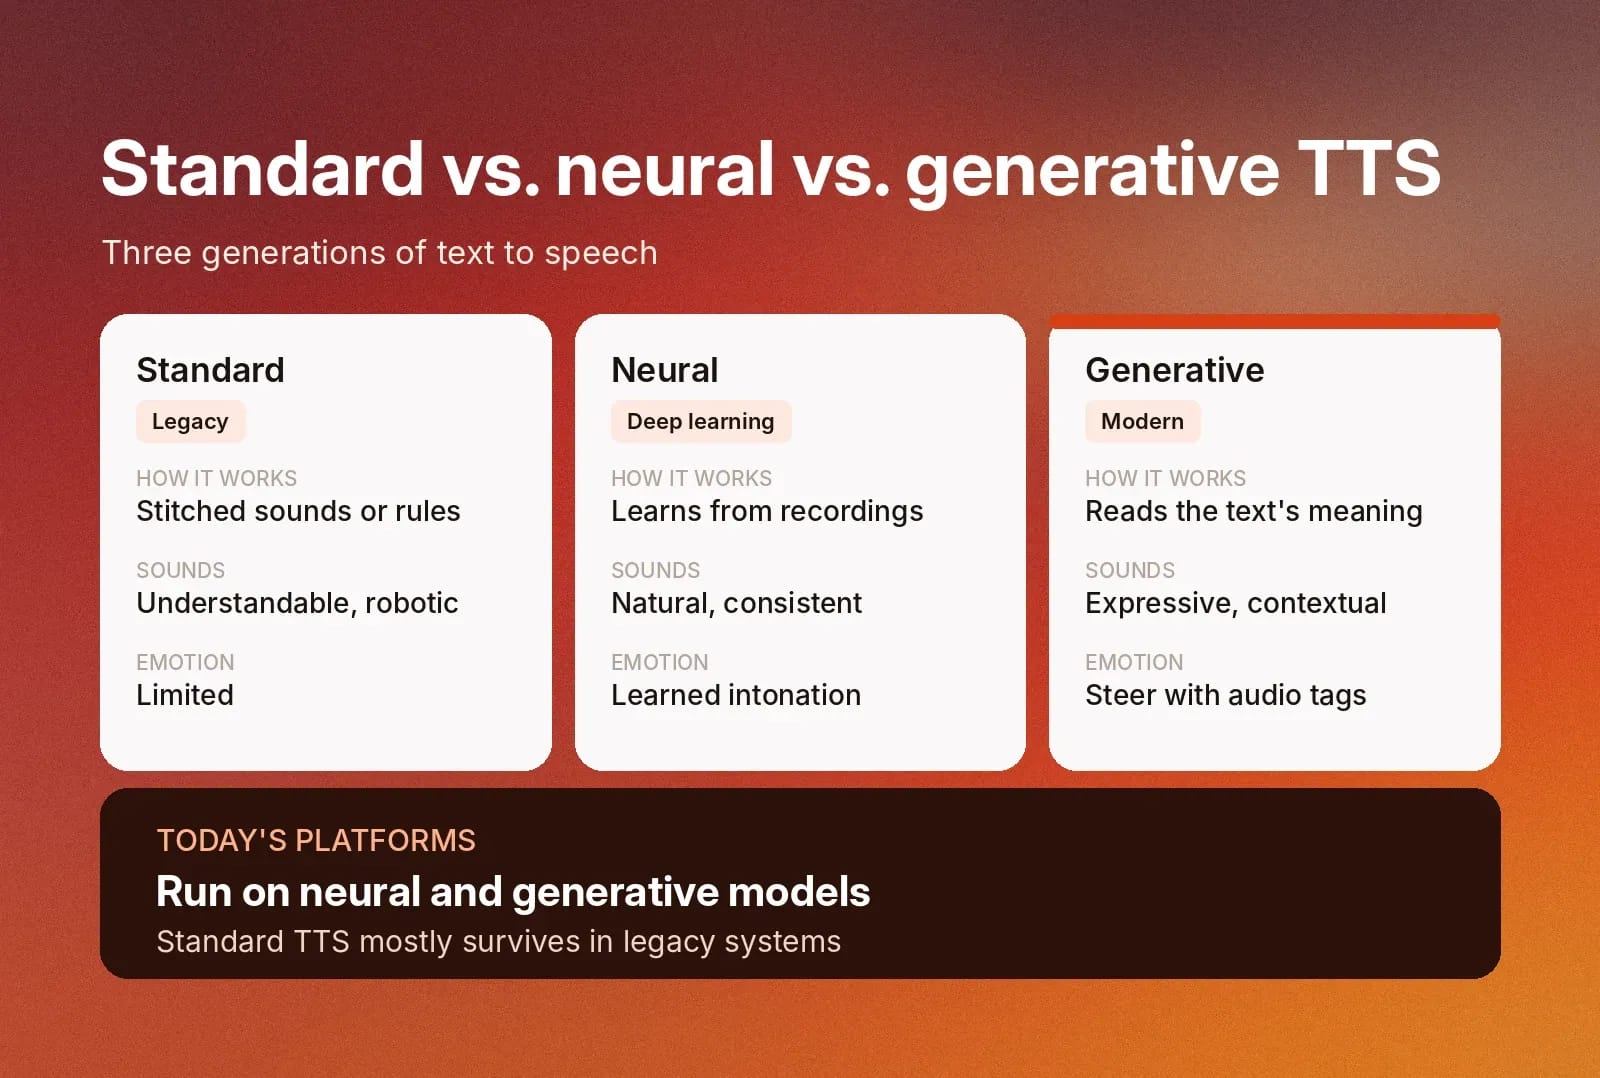
Modele zamiany tekstu na mowę dzielą się na trzy główne generacje.
Zrozumienie różnic między nimi pomaga wyjaśnić, dlaczego współczesne modele, takie jak ElevenLabs Text to Speech, mogą brzmieć tak naturalnie.
- Standardowa zamiana tekstu na mowę: Systemy te łączą wcześniej nagrane dźwięki albo stosują reguły i modele statystyczne do odczytywania tekstu. Wynik jest zrozumiały, ale mechaniczny i ma ograniczoną ekspresję emocji.
- Neuronowa zamiana tekstu na mowę: Modele deep learning uczą się wymowy, rytmu i intonacji z dużych zbiorów nagrań, a następnie generują mowę brzmiącą znacznie naturalniej i bardziej spójnie.
- Generatywna zamiana tekstu na mowę: Modele generatywne są trenowane na jeszcze większych i bardziej zróżnicowanych danych mowy. Wykorzystują znaczenie tekstu, by określić emocje, tempo i akcentowanie. Możesz kierować ich sposobem mówienia za pomocą instrukcji, takich jak tagi audio.
Nowoczesne platformy głosowe opierają się na modelach neuronowych i generatywnych, podczas gdy standardowa zamiana tekstu na mowę przetrwała głównie w starszych systemach.
Co sprawia, że generowanie głosu AI brzmi naturalnie?
Syntetyczne głosy generowane przez AI brzmią bardzo podobnie do ludzkich. Jeśli nie słuchasz uważnie, rozróżnienie ich może być trudne.
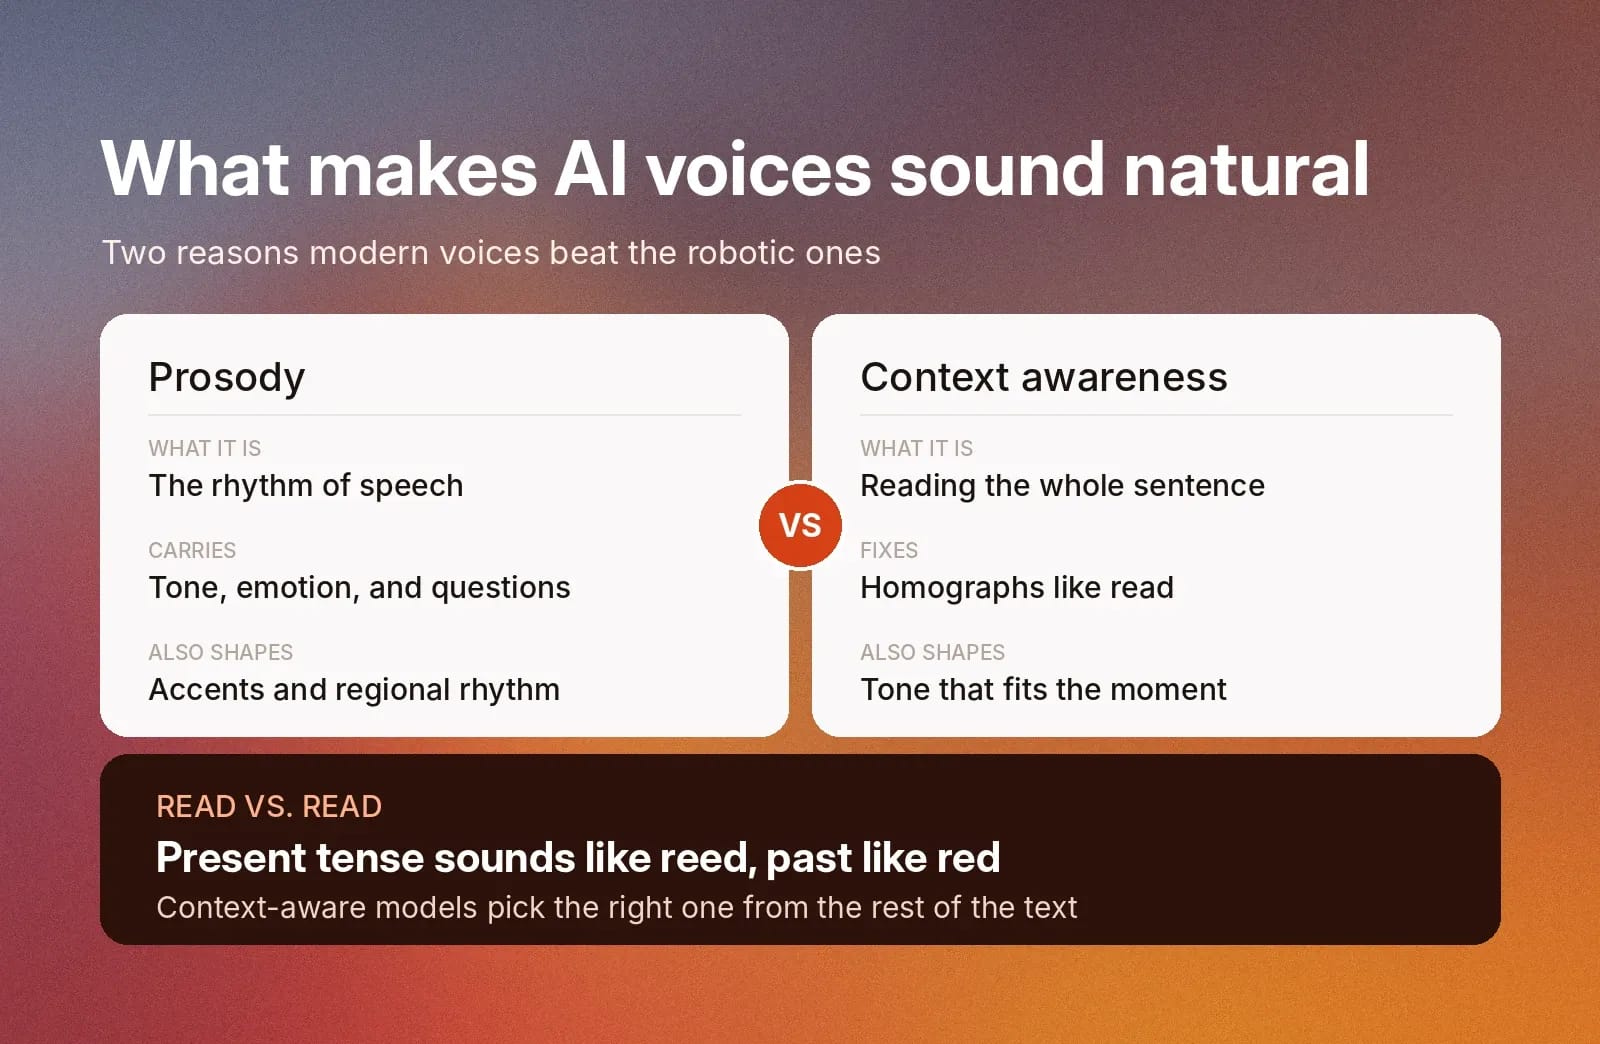
Są dwa powody, dla których głosy generowane przez AI brzmią bardziej naturalnie niż mechaniczne głosy z przeszłości: prozodia i rozumienie kontekstu.
Prozodia
Prozodia to rytm naturalnej ludzkiej mowy. Drobne zmiany intonacji i szybkości przekazują ton oraz emocje podczas rozmowy. Na przykład szybkie mówienie może wyrażać stres lub ekscytację, a podniesienie tonu na końcu zdania zmienia stwierdzenie w pytanie.
Dzisiejsze modele głosowe AI są trenowane, by rozumieć i odtwarzać prozodię. Dzięki temu ich wypowiedzi oddają naturalny tok rozmowy, zamiast brzmieć sztywno lub płasko.
Jeśli używasz syntetycznego głosu do narracji audiobooka lub tworzenia dialogów do gier wideo, wykorzysta on prozodię, aby oddać emocje postaci. Jeśli tworzysz nałożony głos do treści edukacyjnych albo agenta AI do obsługi klienta, model AI dostosuje prozodię, by mówić spokojnie i empatycznie.
Dzięki rozumieniu prozodii modele AI potrafią też odtwarzać unikalne akcenty. Na przykład rytm północnoamerykańskiego angielskiego bardzo różni się od angielskiego brytyjskiego, szkockiego czy irlandzkiego, choć wszyscy mówią tym samym językiem.
Rozumienie kontekstu
Zamiast przetwarzać każde słowo osobno, modele TTS oparte na AI analizują całą frazę, zdanie lub rozmowę i dostosowują sposób mówienia do kontekstu.
Na przykład wiele słów zapisuje się tak samo, ale wymawia inaczej zależnie od czasu i kontekstu. W języku angielskim „read” w czasie teraźniejszym wymawia się jak „reed”, a w przeszłym — jak „red”.
Ponieważ głosy AI rozumieją kontekst, rozpoznają właściwą wymowę na podstawie reszty tekstu. Dostosowują też sposób mówienia, aby ton i emocje pasowały do sytuacji.
Jak działa klonowanie głosu?
Klonowanie głosu wykorzystuje AI do analizy głosu prawdziwej osoby, a następnie przenosi jego cechy na syntetyczną mowę.
Najpierw osoba klonująca swój głos musi przesłać krótką próbkę audio. Model AI wykorzystuje ją, aby rozpoznać akcent, wysokość głosu, ton i kadencję danej osoby. Następnie używa tych cech do stworzenia cyfrowej repliki jej głosu. Użytkownicy mogą generować nową mowę tym głosem za pomocą technologii zamiany tekstu na mowę.
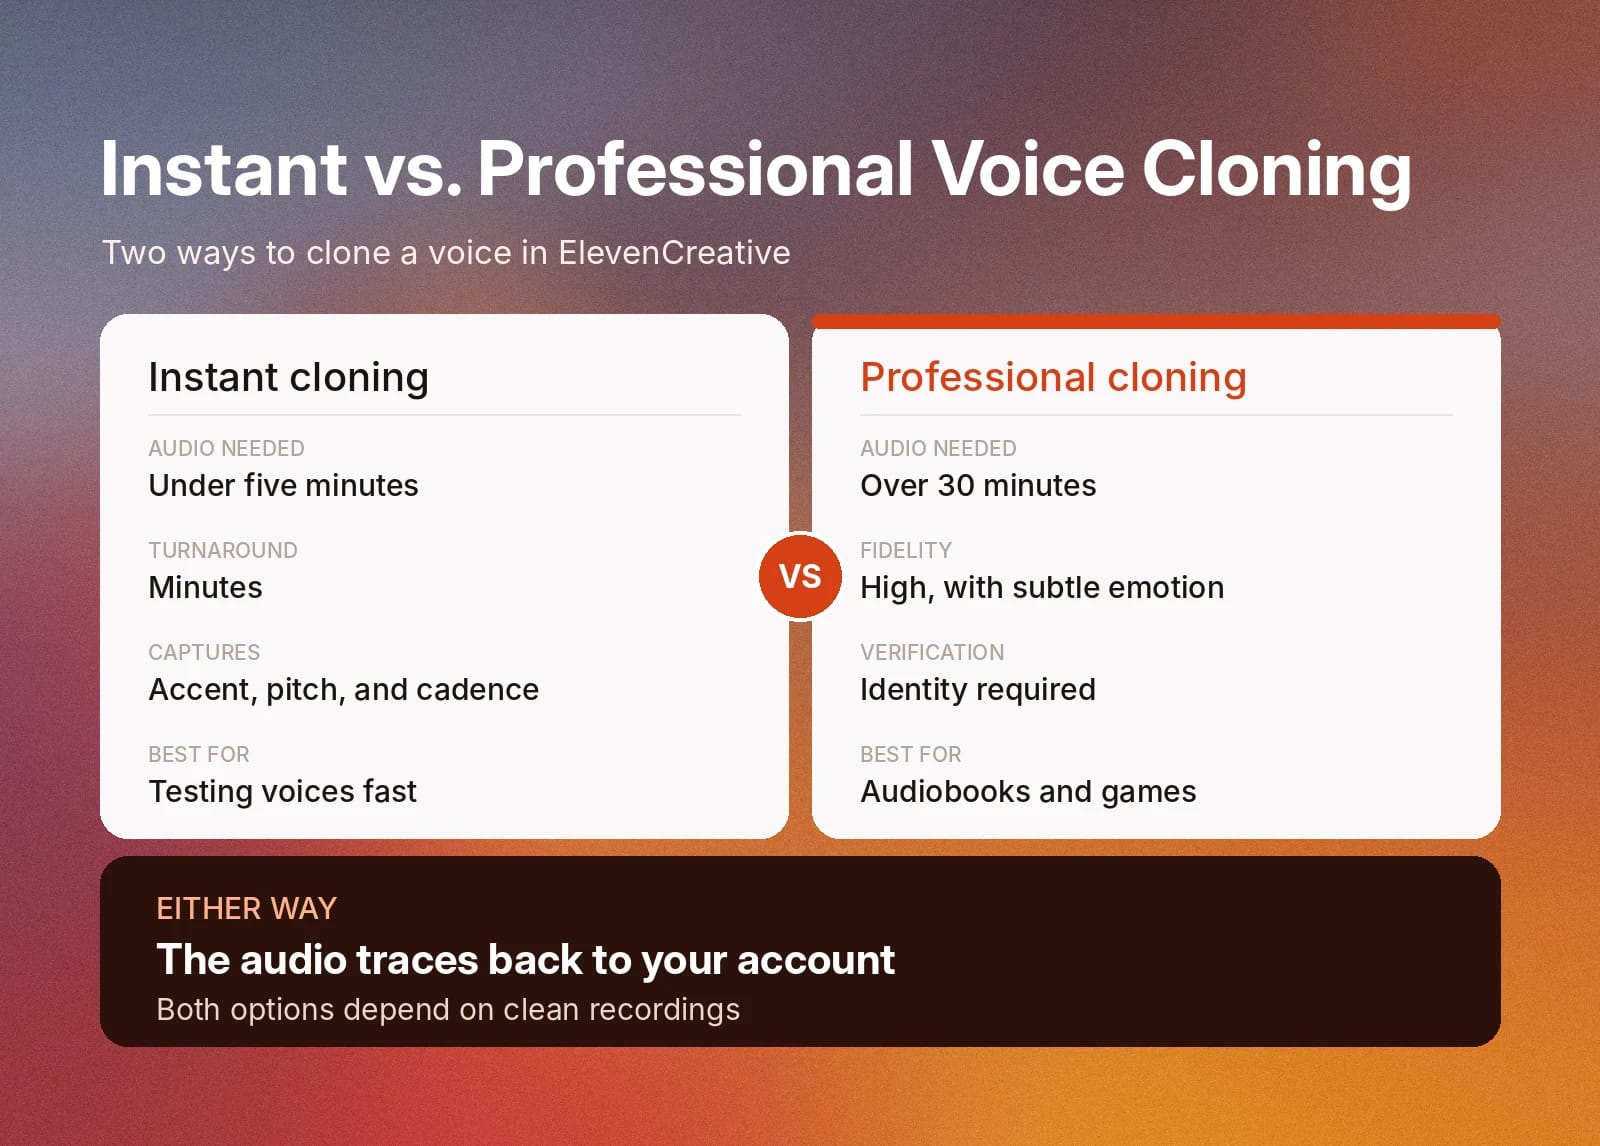
Istnieją dwa rodzaje klonowania głosu: Instant i Professional. Klonowanie Instant tworzy replikę głosu na podstawie mniej niż dwóch minut próbki audio. Ułatwia to testowanie opcji głosowych przed rozpoczęciem większego projektu.
Klonowanie Professional wykorzystuje od 30 minut do trzech godzin próbek audio, aby stworzyć klon głosu o wysokiej wierności. Professional Voice Clones zachowują subtelne detale, takie jak emocje i intonacja, których nie ma w Instant Clones. Wymagają też weryfikacji tożsamości.
Klonowanie głosu ma wiele zastosowań — od szybkiego generowania nałożonych głosów po zachowywanie głosów, które w innym przypadku mogłyby zostać utracone.
Jak nagrać dobre próbki głosu do syntezy mowy
Jakość klonu głosu zależy od jakości nagrania. Nawet bez drogiego sprzętu możesz zrobić wiele drobnych rzeczy, by poprawić brzmienie swojego klonu głosu.
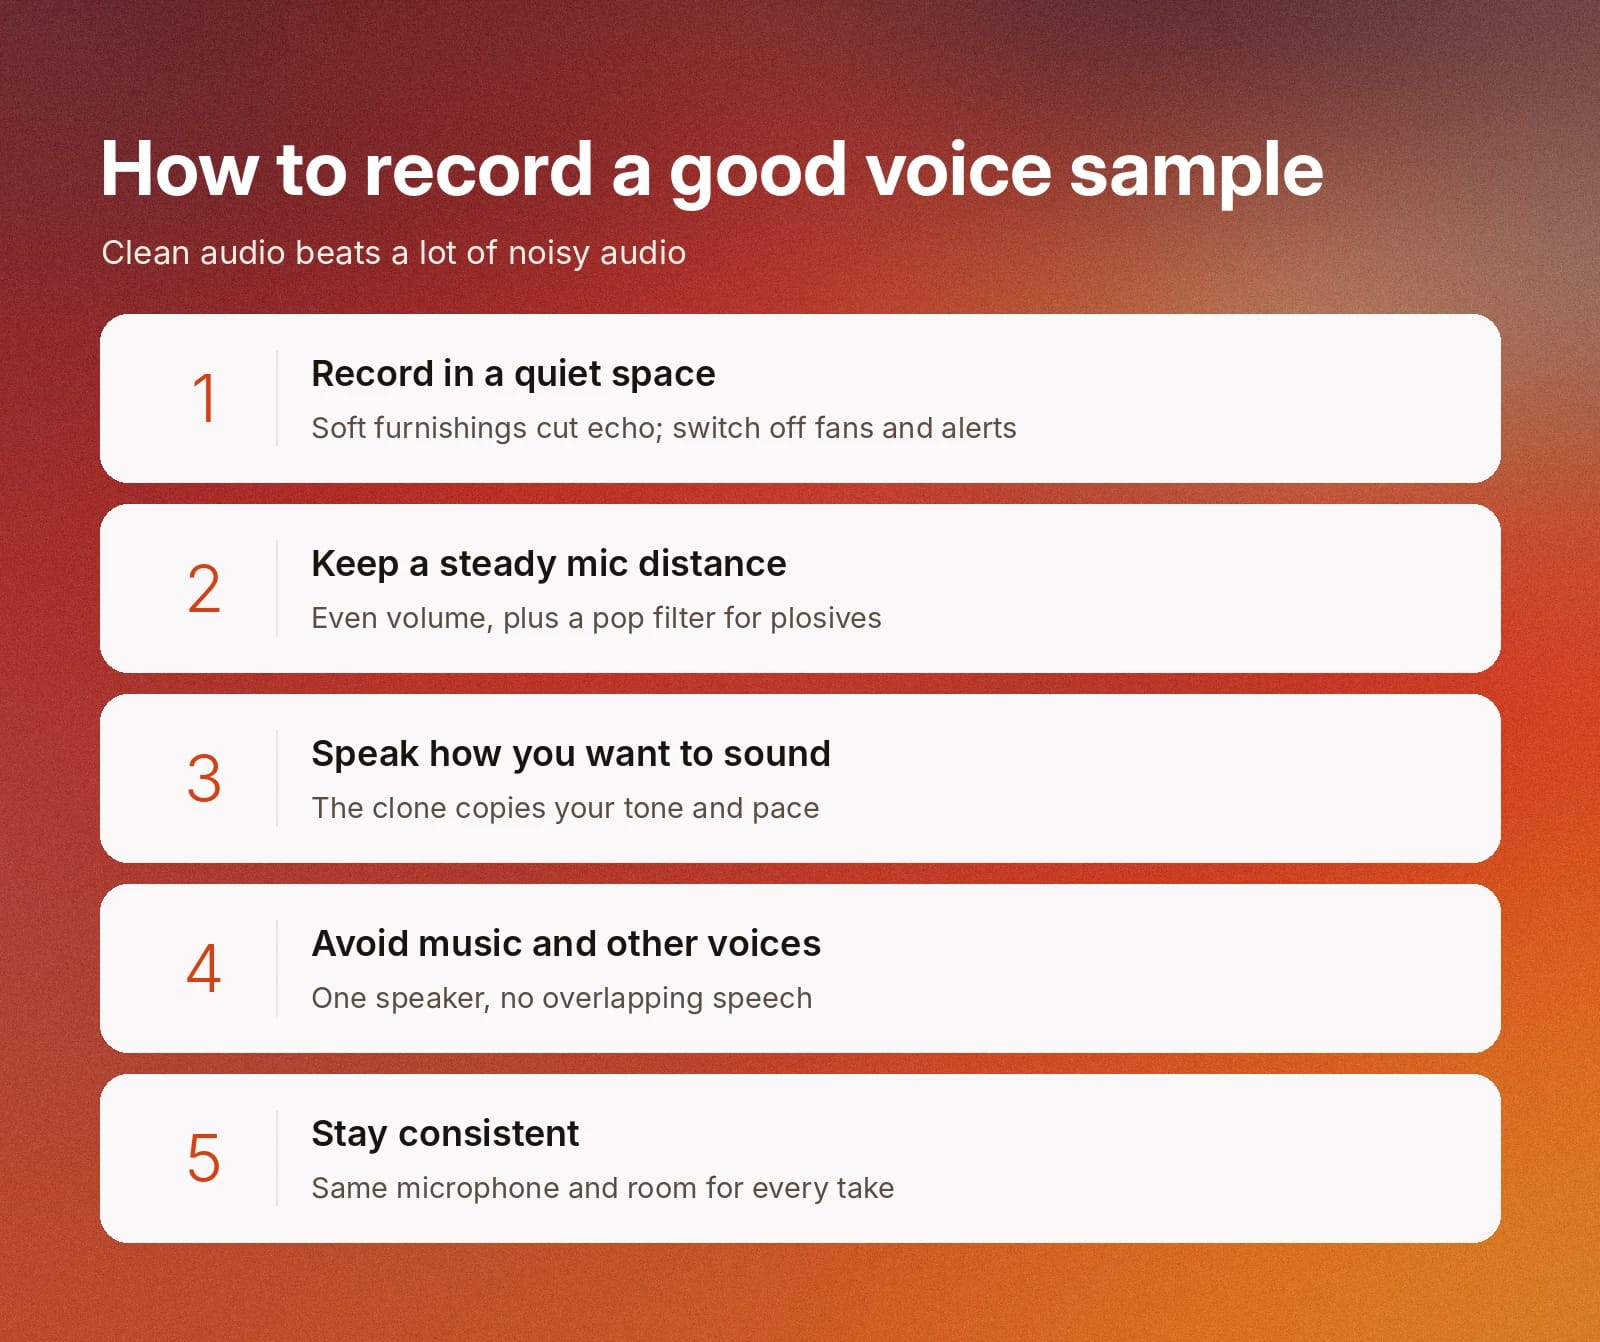
Te nawyki pomogą ci nagrać czyste próbki:
- Nagrywaj w cichym miejscu: Miękkie wyposażenie, takie jak zasłony i dywany, ogranicza echo, a wyłączenie wentylatorów i powiadomień usuwa hałas w tle.
- Trzymaj mikrofon w stałej odległości: Stała odległość zapewnia równy poziom głośności, a pop filtr ogranicza ostre głoski wybuchowe.
- Mów tak, jak chcesz, by brzmiał klon: Klon naśladuje twój sposób mówienia. Nagrywaj w tonie i tempie, których zamierzasz używać.
- Unikaj muzyki i innych głosów: Nagrywaj jedną osobę, bez muzyki w tle i nakładającej się mowy.
- Zachowaj spójność: We wszystkich nagraniach używaj tego samego mikrofonu i pomieszczenia.
Instant Cloning wymaga mniej audio, a Professional Cloning więcej, ale oba zależą od czystych nagrań. Czyste audio o odpowiedniej długości daje lepsze wyniki niż duża ilość zaszumionego materiału.
Jak stworzyć głos bez nagrywania: Voice Design
Nie każdy syntetyczny głos zaczyna się od nagrania. W Voice Design opisujesz tekstem głos, którego potrzebujesz, uwzględniając takie szczegóły jak wiek, płeć, akcent, ton i tempo, a model AI generuje opcje głosowe pasujące do opisu. Możesz ich posłuchać, wybrać tę, która ci odpowiada, i zapisać ją w swojej bibliotece głosów.
Voice Design przydaje się, gdy potrzebujesz głosu dla postaci, marki lub produktu, a nie ma prawdziwej osoby do sklonowania. Przeczytaj dokumentację Voice Design, aby dowiedzieć się, jak pisać skuteczne opisy głosu.
Jak rozpoznać, czy głos został wygenerowany przez AI
Nie ma jednego znaku, który jednoznacznie potwierdza, że głos został wygenerowany przez AI. Uważne słuchanie, narzędzia wykrywania i sprawdzenie pochodzenia audio działają lepiej niż poleganie tylko na jednym z tych sposobów.
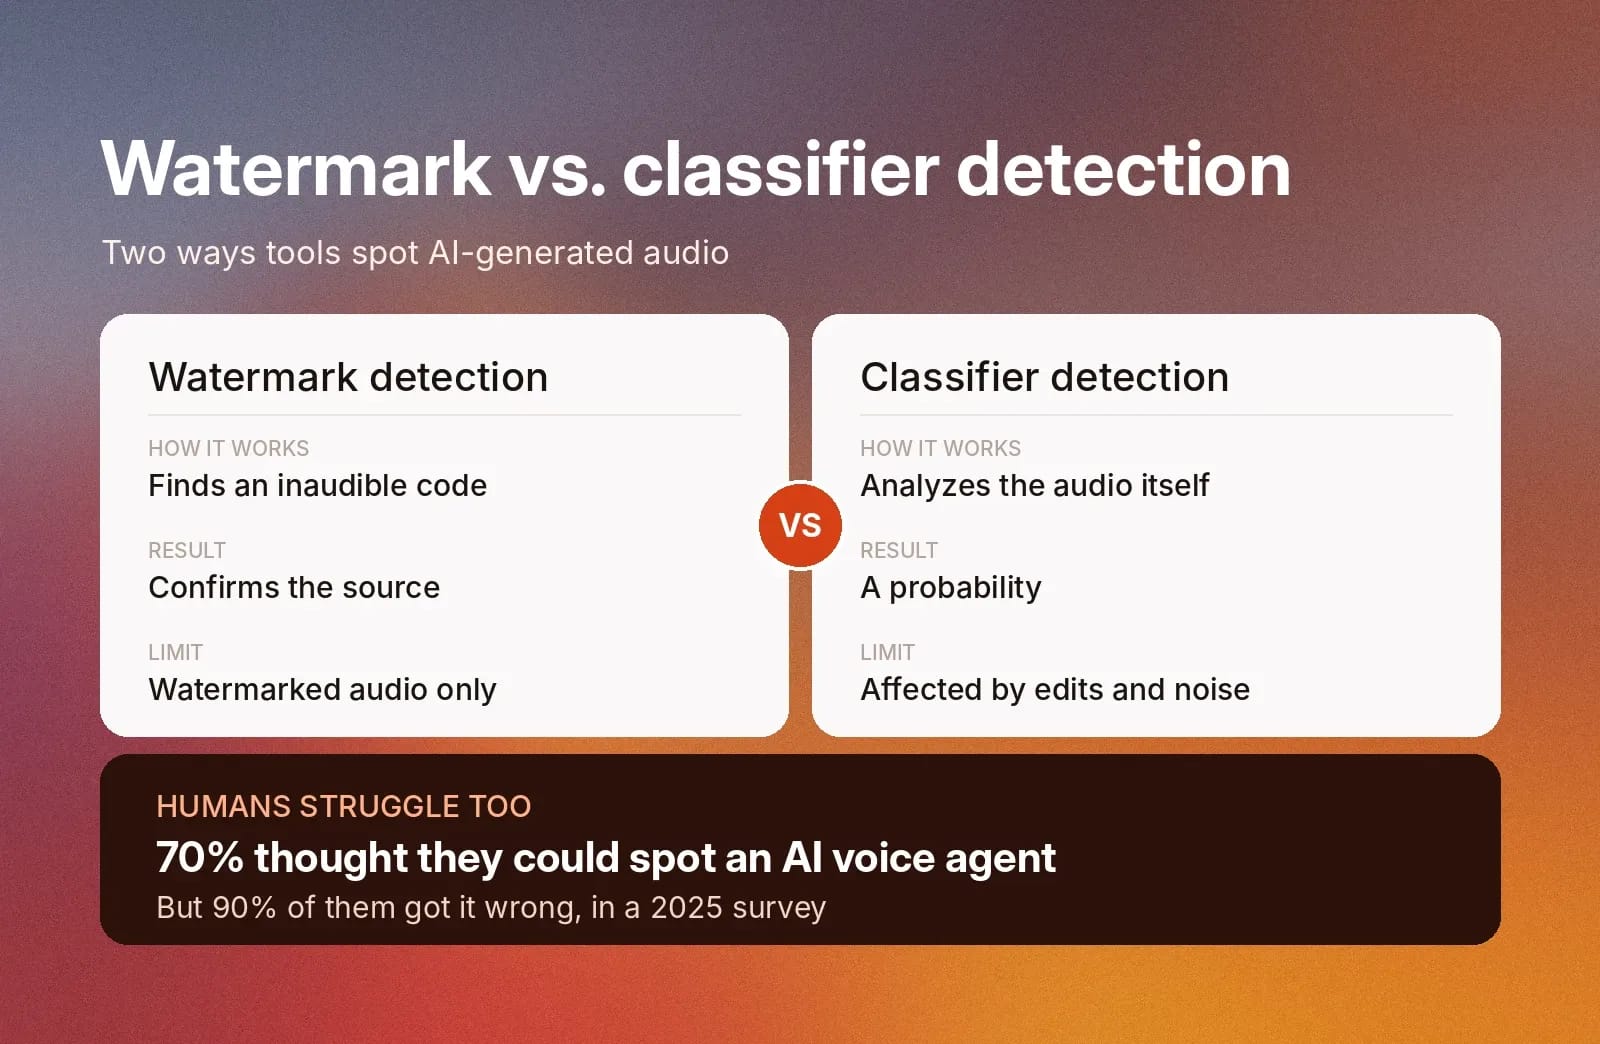
Wiele osób uważa, że potrafi odróżnić prawdziwy głos od wygenerowanego przez AI, ale nie zawsze ma rację. Badanie z 2025 roku wykazało, że 70% konsumentów sądziło, że potrafi poprawnie rozpoznać głosowego agenta AI, lecz 90% z nich nie zrobiło tego prawidłowo.
Zamiast polegać na ludzkim słuchu, możesz użyć narzędzia do wykrywania. Działają one na dwa główne sposoby:
- Wykrywanie znaków wodnych: Niektórzy dostawcy AI osadzają w generowanym audio znak wodny — kod niesłyszalny dla ludzi. Detektor może go znaleźć i potwierdzić pochodzenie audio. Działa to tylko w przypadku audio zawierającego znak wodny.
- Wykrywanie oparte na klasyfikatorze: Klasyfikator analizuje audio i szacuje prawdopodobieństwo, że zostało wygenerowane przez AI. Może oznaczyć audio bez znaku wodnego, ale wynik ma charakter probabilistyczny i może być zaburzony przez kompresję, hałas w tle lub edycję.
Żadna z metod nie jest idealna. Traktuj wynik wykrywania jako jeden z dowodów i porównaj go z tym, co wiesz o źródle. Przygotowaliśmy przewodnik o wykrywaniu deepfake’ów audio, który omawia ten temat bardziej szczegółowo.
ElevenLabs Speech Classifier to narzędzie, które określa prawdopodobieństwo, że próbka audio została wygenerowana przez modele głosowe AI ElevenLabs. ElevenLabs współpracuje też z Reality Defender w ramach inicjatyw wykrywania deepfake’ów, aby rozpoznawać i zapobiegać oszustwom głosowym.
Na co zwracać uwagę
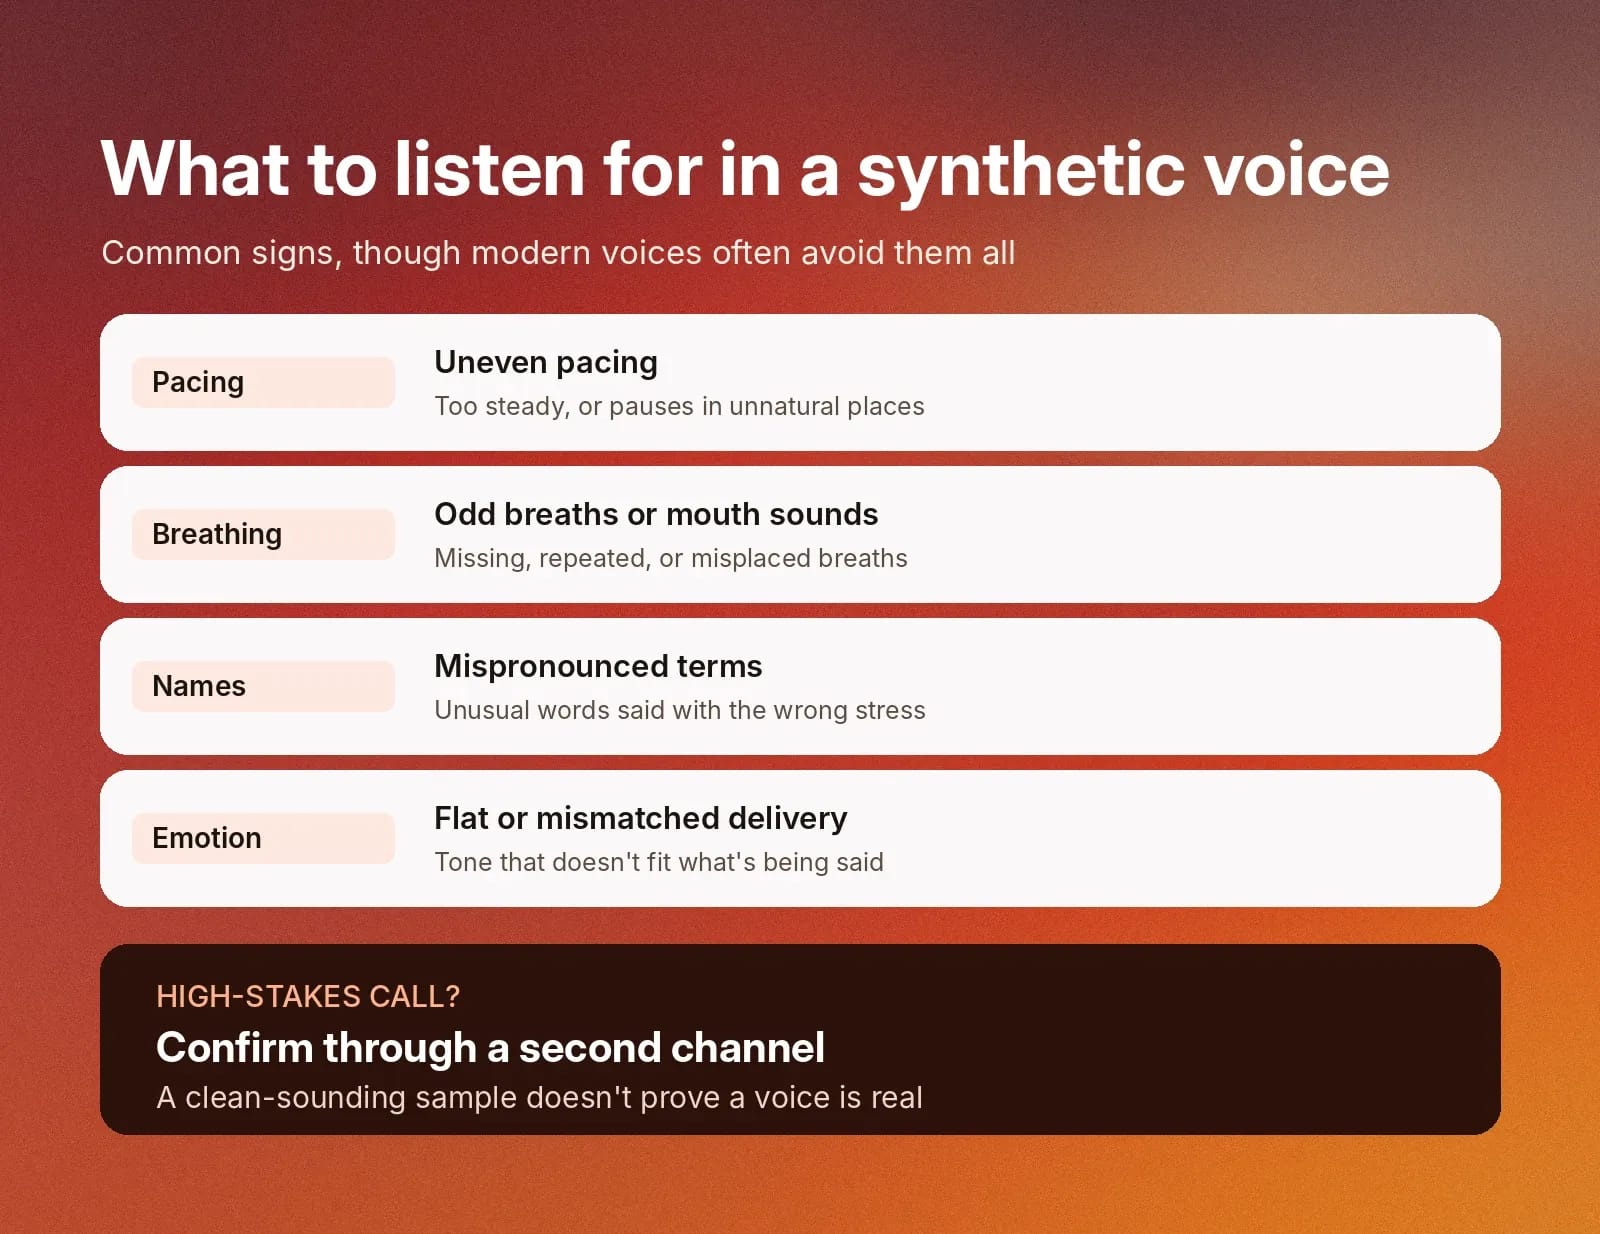
Narzędzia wykrywania nie zawsze są pod ręką, dlatego warto znać typowe oznaki syntetycznego głosu.
Zwróć uwagę na:
- Nierówne tempo: Mowę, która jest zbyt jednostajna lub zawiera pauzy w nienaturalnych miejscach.
- Dziwne odgłosy oddechu lub ust: Oddechy, których brakuje, które się powtarzają lub pojawiają się w nieodpowiednich miejscach. Mogą wskazywać na artefakty audio nieumyślnie wygenerowane przez model.
- Błędnie wymawiane nazwy lub terminy: Nietypowe słowa wypowiedziane z niewłaściwym akcentem. Jest to jeszcze częstsze w językach, które stosują znaki akcentowe do podkreślania określonych sylab, takich jak hiszpański.
- Płaskie lub niedopasowane emocje: Sposób mówienia, który nie pasuje do znaczenia słów. Wskazuje to na brak zrozumienia samego tekstu, co jest częstym problemem starszych modeli TTS.
Nowoczesne syntetyczne głosy często unikają wszystkich tych problemów. Czysto brzmiąca próbka nie dowodzi, że głos jest prawdziwy. W przypadku spraw wysokiej wagi, na przykład telefonu z prośbą o pieniądze, potwierdź to drugim kanałem.
Twórz własne doświadczenia głosowe z ElevenCreative
ElevenCreative pomaga tworzyć własne doświadczenia głosowe dla twoich projektów kreatywnych. Wybieraj z obszernej biblioteki ponad 20 000 gotowych głosów lub stwórz własny dzięki dokładnemu i bezpiecznemu klonowaniu głosu.
Użyj ElevenCreative, aby odtworzyć swój głos za pomocą Instant Voice Cloning lub Professional Voice Cloning. Instant Voice Cloning działa w kilka minut, pomagając szybko testować opcje głosowe lub uruchamiać osobiste projekty. Professional Voice Cloning wykorzystuje dłuższe próbki audio, by tworzyć wysokiej jakości głosy idealne do dłuższych projektów, takich jak audiobooki, gry wideo czy podcasty. Niezależnie od wybranej opcji, audio można powiązać z twoim kontem dla bezpieczeństwa.
Dostosowywalna Voice Library i narzędzia do klonowania głosu od ElevenCreative pomagają ożywiać twoje kreatywne projekty. Zarejestruj się w ElevenCreative, aby odkrywać kultowe głosy lub stworzyć własny.
FAQ

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.