Wykrywanie deepfake’ów audio: jak działa i jak sprawdzić dźwięk z ElevenLabs
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Wykrywanie deepfake’ów audio to analiza nagrania głosowego, która pozwala ustalić, czy mowa jest autentyczna. Syntezatory głosu AI tworzące deepfake’i są coraz łatwiej dostępne. Dlatego zarówno w życiu publicznym, jak i w biznesie ważne jest szybkie rozpoznanie, czy słyszana mowa jest prawdziwa, czy została zmanipulowana przez oszusta.
W tym artykule wyjaśniamy, jak działa wykrywanie deepfake’ów audio, jakie są jego rodzaje, ich mocne i słabe strony oraz jak wdrożyć je w systemach wykrywania oszustw na dużą skalę.
Podsumowanie
- Mowę syntetyzowaną przez deepfake’i coraz trudniej wykryć wyłącznie ze słuchu. Stanowi to poważne ryzyko zarówno w życiu publicznym, jak i w biznesie.
- Istnieje wiele rodzajów oprogramowania do wykrywania deepfake’ów. Tradycyjne narzędzia wykorzystują analizę statystyczną, by ocenić prawdopodobieństwo, że próbka audio została wygenerowana przez AI.
- Nowa technologia watermarkingu pozwala jednoznacznie stwierdzić, czy próbka głosu została zsyntetyzowana.
- Watermarking jest bardzo dokładny, ale detektory działają tylko z nagraniami własnego dostawcy. Na przykład Audio Detector od ElevenLabs potrafi z dużą dokładnością wykrywać watermarki tworzone przez nasze produkty, ale nie przez produkty innych firm.
- Watermarking to ważne narzędzie dla organizacji, które potrzebują wykrywać deepfake’i na dużą skalę, ale powinien być tylko jednym z elementów ich zestawu narzędzi.
Czym jest wykrywanie deepfake’ów audio?
Wykrywanie deepfake’ów audio to proces ustalania, czy nagranie głosowe zostało wygenerowane lub zmanipulowane przez sztuczną inteligencję.
Deepfake to dowolny rodzaj medium — najczęściej obraz, wideo lub audio — stworzony przez aplikację generatywnej AI, aby fałszywie przedstawić czyjeś słowa lub działania. Deepfake’i audio mogą być wykorzystywane na wiele szkodliwych sposobów: do oszustw, prób uzyskania dostępu do kont osobistych, propagandy politycznej albo potajemnego podszywania się pod współmałżonka czy członka rodziny w sporach domowych.
Według obecnych trendów ofiarami oszustw z użyciem deepfake’ów audio są najczęściej:
- Politycy i inne osoby publiczne: Osoby, których liczne próbki głosu są dostępne online do trenowania modeli, mogą usłyszeć swój głos sfałszowany przez przeciwników lub osoby trzecie w celu wprowadzenia opinii publicznej w błąd.
- Członkowie rodziny: Oszust może wykorzystać znalezione nagrania głosu, by wyłudzać pieniądze od starszych członków rodziny za pomocą spreparowanych próśb.
- Kadra zarządzająca: Fałszywe wywiady, prezentacje i rozmowy o wynikach finansowych mogą szkodzić marce firmy.
- Zespoły obsługi klienta: Oszuści mogą wykorzystywać zebrane próbki głosu do nakłaniania zespołów obsługi klienta do udzielania dostępu do prywatnych kont.
Niestety ludzie nie są wiarygodni w wykrywaniu deepfake’ów. W kontrolowanych badaniach zdolność ludzi do ich rozpoznawania nie jest lepsza niż przypadek, a badania te pochodzą jeszcze z 2024 roku. Od tego czasu media generatywne stały się znacznie bardziej zaawansowane.
Edukacja i przepisy mogą znacznie uodpornić społeczeństwo na wpływ deepfake’ów, ale nadal potrzebujemy niezawodnych metod ich wykrywania.
Jak działa wykrywanie deepfake’ów audio?
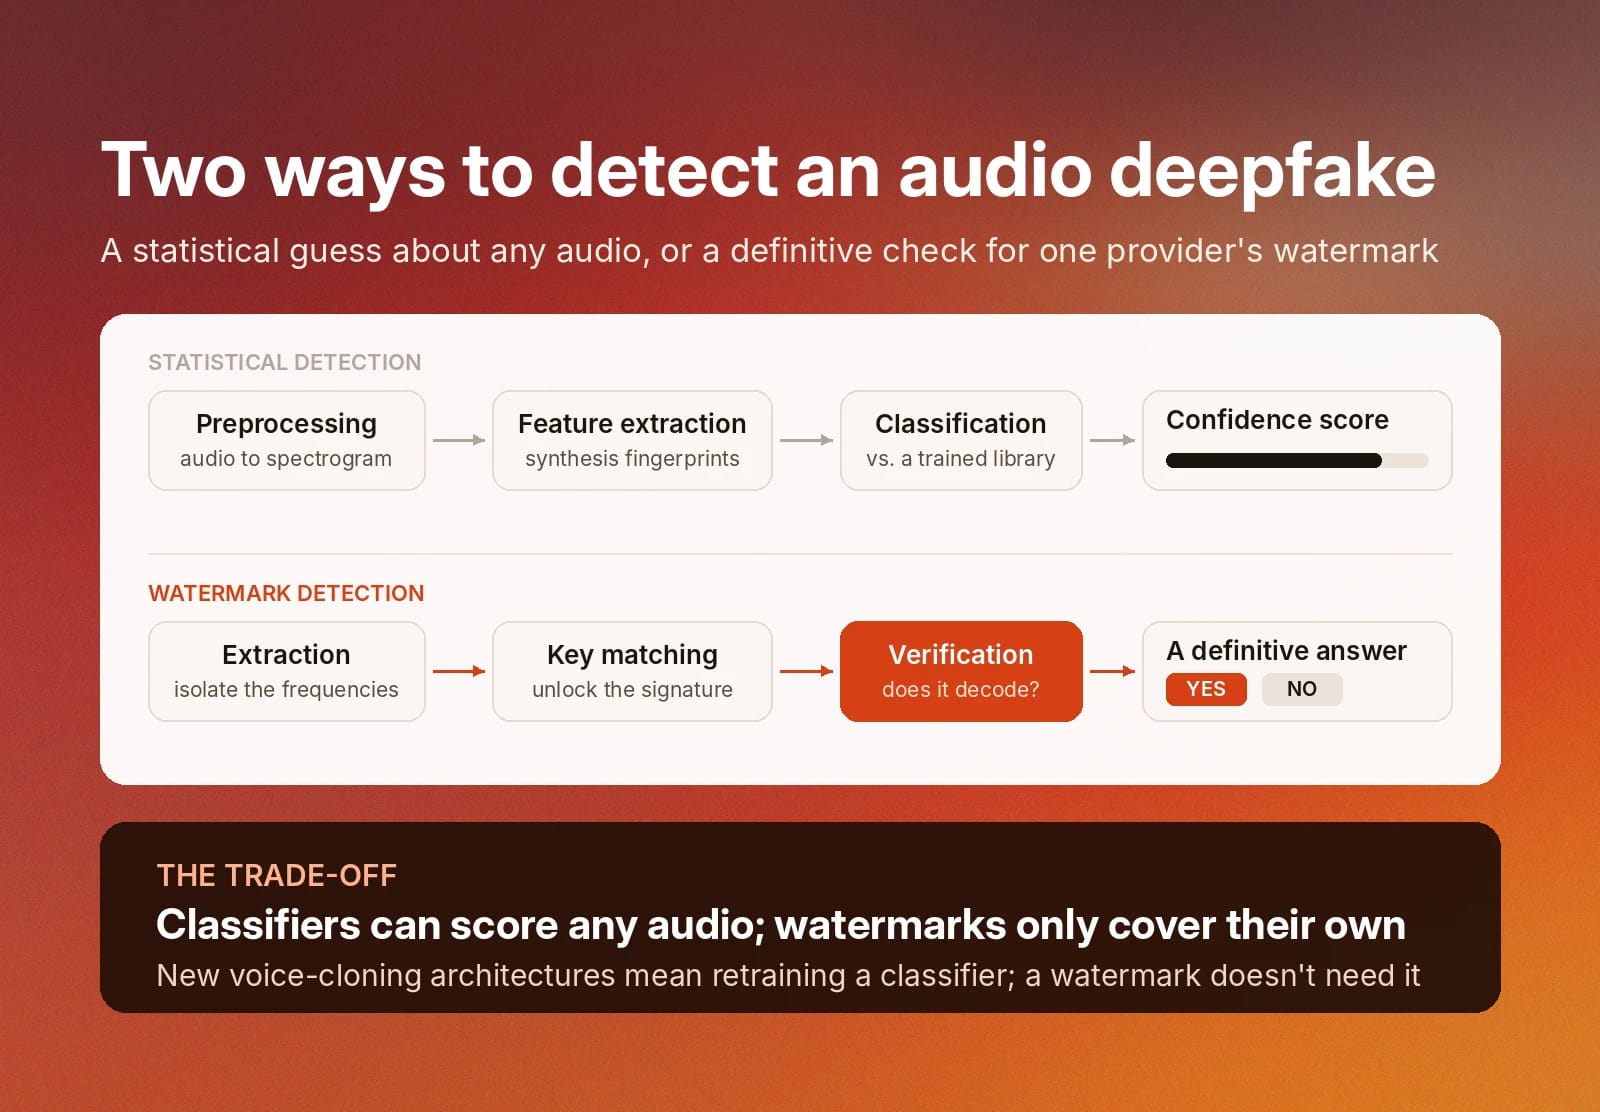
Tradycyjne wykrywanie deepfake’ów wykorzystuje analizę statystyczną do określania prawdopodobieństwa, że medium zostało wygenerowane przez AI. Narzędzie wykrywające stosuje techniki uczenia maszynowego, by rozpoznawać wzorce leżące u podstaw różnych rodzajów syntetyzowanej mowy.
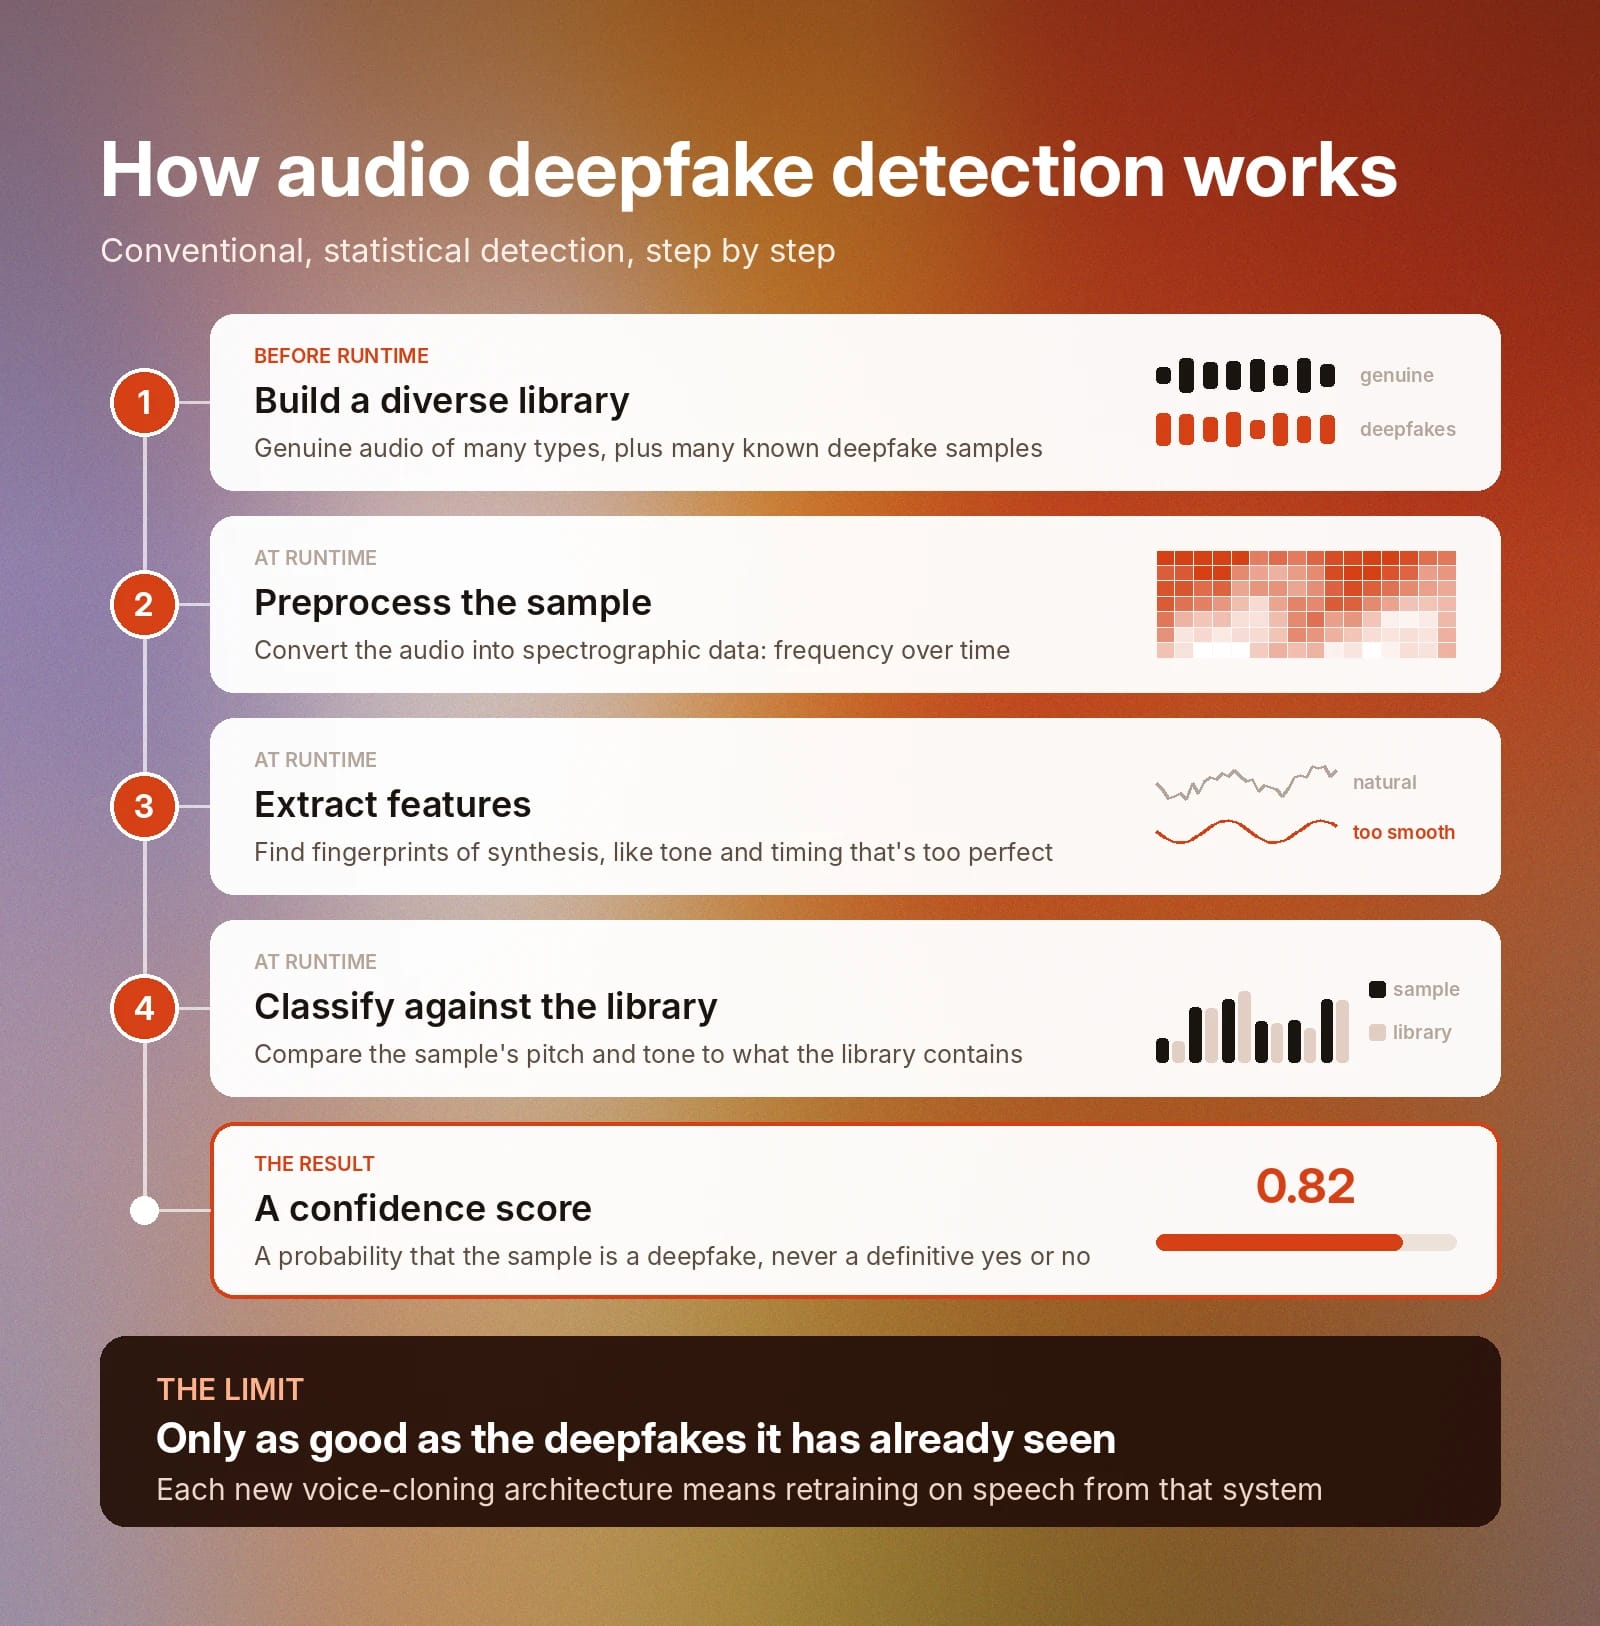
Pierwszym krokiem jest zbudowanie biblioteki materiałów audio, z którą można porównywać podejrzane deepfake’i. Powinna zawierać zróżnicowane dane: prawdziwe nagrania różnego rodzaju oraz wiele znanych próbek deepfake’ów, aby umożliwiać pozytywne wykrycia.
Podczas działania proces obejmuje trzy etapy: wstępne przetwarzanie, ekstrakcję cech i klasyfikację.
Wstępne przetwarzanie audio
Gdy podasz próbkę audio wytrenowanemu narzędziu wykrywającemu, przekształci je ono w dane spektrograficzne, czyli matematyczną reprezentację zmian częstotliwości w czasie.
Ekstrakcja cech
Następnie narzędzie wydobywa z danych próbki cechy przypominające odciski palców syntetyzowanej mowy. Mowa AI bywa na przykład zbyt idealna i nie ma nieregularności tonu oraz rytmu typowych dla naturalnej mowy. Porównanie wysokości i barwy głosu mówcy z biblioteką pomaga też narzędziu wykryć inne sygnały ostrzegawcze.
Klasyfikacja
Ponieważ tradycyjne wykrywanie deepfake’ów opiera się na analizie statystycznej, nie może dać jednoznacznej odpowiedzi „tak” lub „nie” na pytanie, czy próbka jest deepfake’iem. Zamiast tego generuje wynik ufności, czyli prawdopodobieństwo, że próbka jest deepfake’iem.
Ponieważ tradycyjne narzędzia mierzą podobieństwa między próbką a istniejącą biblioteką audio, ich skuteczność ograniczają znane im próbki deepfake’ów. Za każdym razem, gdy ktoś udostępnia nową architekturę klonowania głosu, musisz ponownie wytrenować narzędzie na mowie zsyntetyzowanej w tym systemie, aby dokładnie ją wykrywać.
Czym różni się watermarking od wykrywania statystycznego?
Watermarking to zupełnie inne podejście do klasyfikacji mowy. Klasyfikator uczenia maszynowego probabilistycznie ocenia autentyczność próbki na podstawie danych treningowych o naturalnej mowie — na przykład tego, jak w danych spektrograficznych wyglądają prawdziwe emocje i akcentowanie oraz jakie zmiany tonu i rytmu są naturalne.
Watermarking jest deterministyczny. Watermark to matematyczny podpis osadzony przez syntezator w danych audio na poziomie niesłyszalnym dla człowieka. Detektor watermarków jednoznacznie weryfikuje, czy znajdzie ten ukryty podpis.
Detektor działa w trzech prostych etapach:
- Ekstrakcja: Narzędzie wydobywa dane spektrograficzne i wyodrębnia częstotliwości, na których spodziewa się znaleźć watermark.
- Dopasowanie klucza: Próbuje odblokować podpis za pomocą klucza.
- Weryfikacja: Jeśli sygnał zostanie poprawnie zdekodowany, narzędzie potwierdza, że dźwięk został wygenerowany przez dany generator głosu AI.
Proces wykrywania watermarków w ElevenLabs
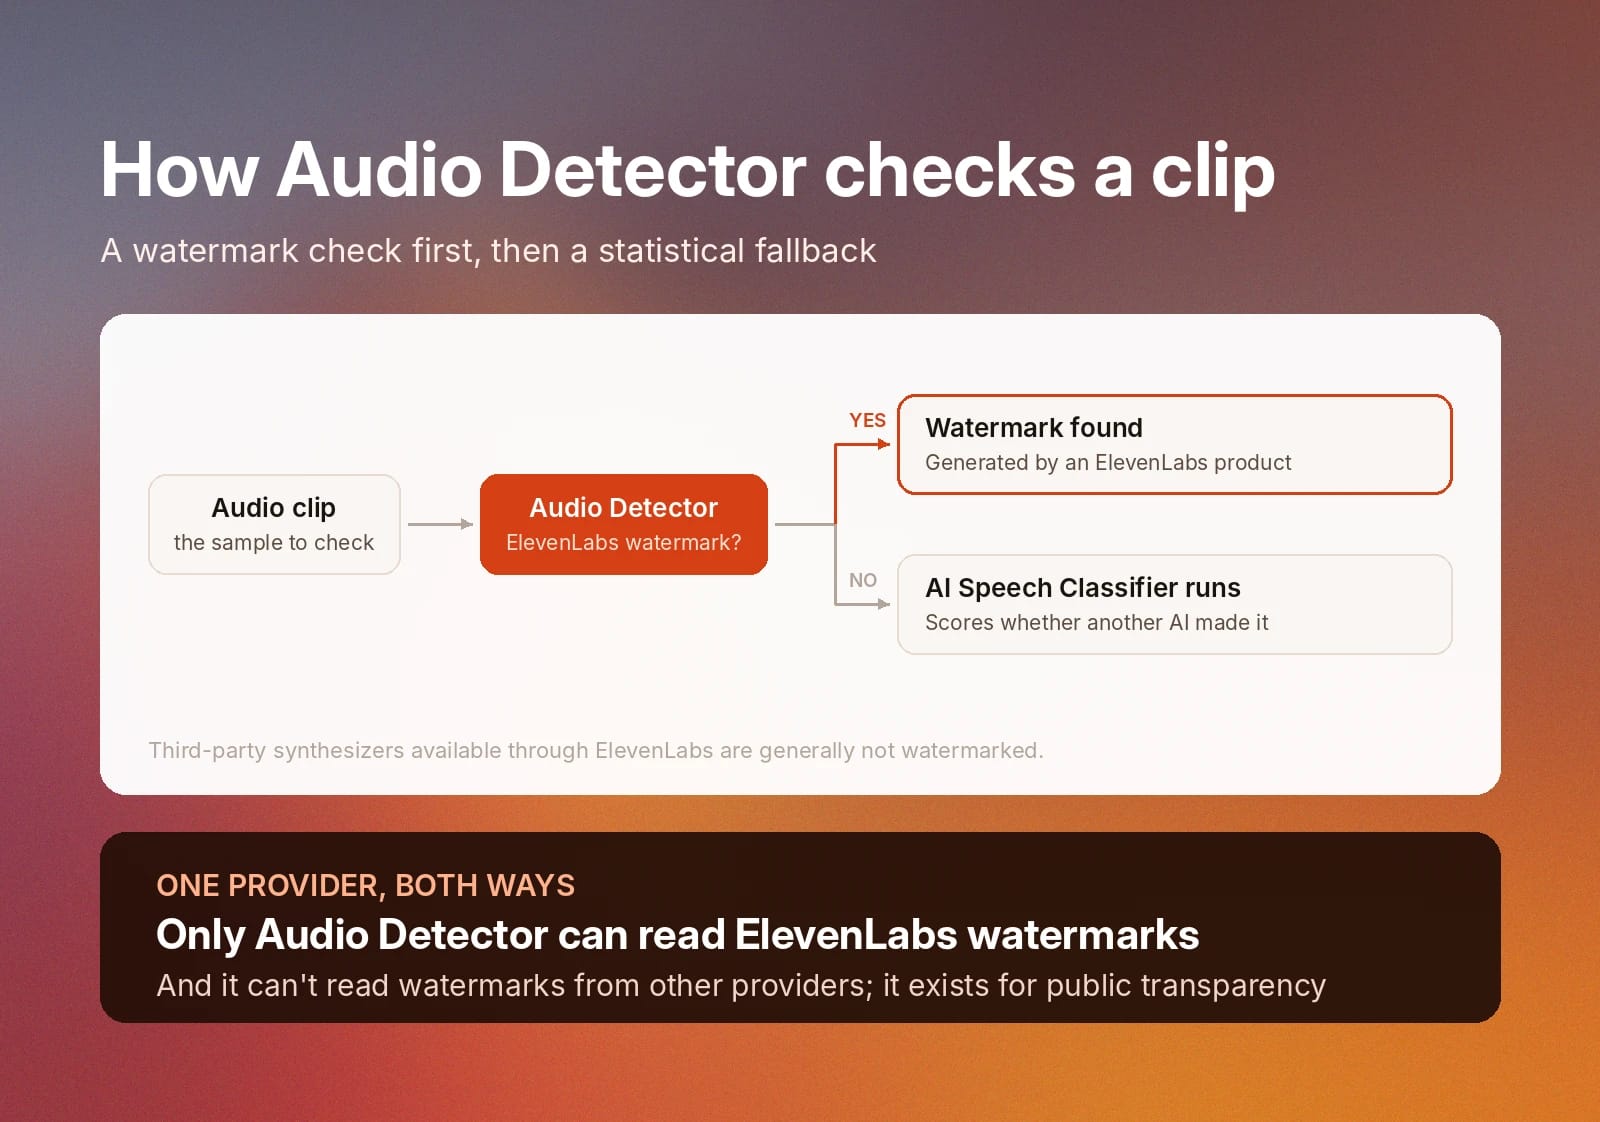
Narzędziem ElevenLabs do watermarkingu jest Audio Detector. Skanuje próbki audio i sprawdza, czy treść została wygenerowana przez produkt ElevenLabs. Jeśli nie znajdzie watermarku, uruchamia następnie statystyczny AI Speech Classifier aby ocenić, czy dźwięk został wygenerowany przez AI z innego źródła.
Ze względu na sposób działania watermarkingu Audio Detector od ElevenLabs wykrywa tylko dźwięk wygenerowany przez ElevenLabs. Obecnie nie potrafi rozpoznać watermarków innych dostawców głosów AI.
I odwrotnie: tylko Audio Detector od ElevenLabs potrafi wykryć watermarki ElevenLabs.
Pamiętaj też, że treści generowane przez syntezatory innych firm dostępne w ElevenLabs zwykle nie mają watermarków.
Inne sposoby wykrywania dźwięku wygenerowanego przez ElevenLabs
Narzędzie ElevenCreative AI Speech Classifier jest dostępne bezpłatnie i bez logowania. Analizuje pierwszą minutę próbki audio i podaje wynik ufności określający, jak prawdopodobne jest, że dźwięk został wygenerowany przez model ElevenLabs.
Pamiętaj, że nie potrafi niezawodnie klasyfikować dźwięku z Eleven v3. Najlepiej sprawdza się przy audio wygenerowanym przez starsze modele ElevenLabs TTS. Jego dokładność spada też przy analizie mocno skompresowanych lub edytowanych treści mówionych.
Jak wykrywać syntetyczne głosy na dużą skalę?
Niektóre zespoły biznesowe muszą wykrywać deepfake’i na dużą skalę, niemal w czasie rzeczywistym. Weźmy zespół obsługi klienta dużego banku. Jego pracownicy rozmawiają codziennie z tysiącami klientów. Członkowie zespołu muszą regularnie udostępniać i aktualizować prywatne dane kont.
Kierownictwu tego zespołu bardzo zależy na tym, jak szybko potrafią zarówno rozpoznać oszusta dzwoniącego na infolinię, jak i odpowiedzieć prawdziwym klientom. Potrzebują systemu wykrywania głosu, który na żywo podczas rozmów z klientami rozpozna dźwięk ze wszystkich głównych silników generowania głosu.
Budowanie kompletnego systemu wykrywania głosu
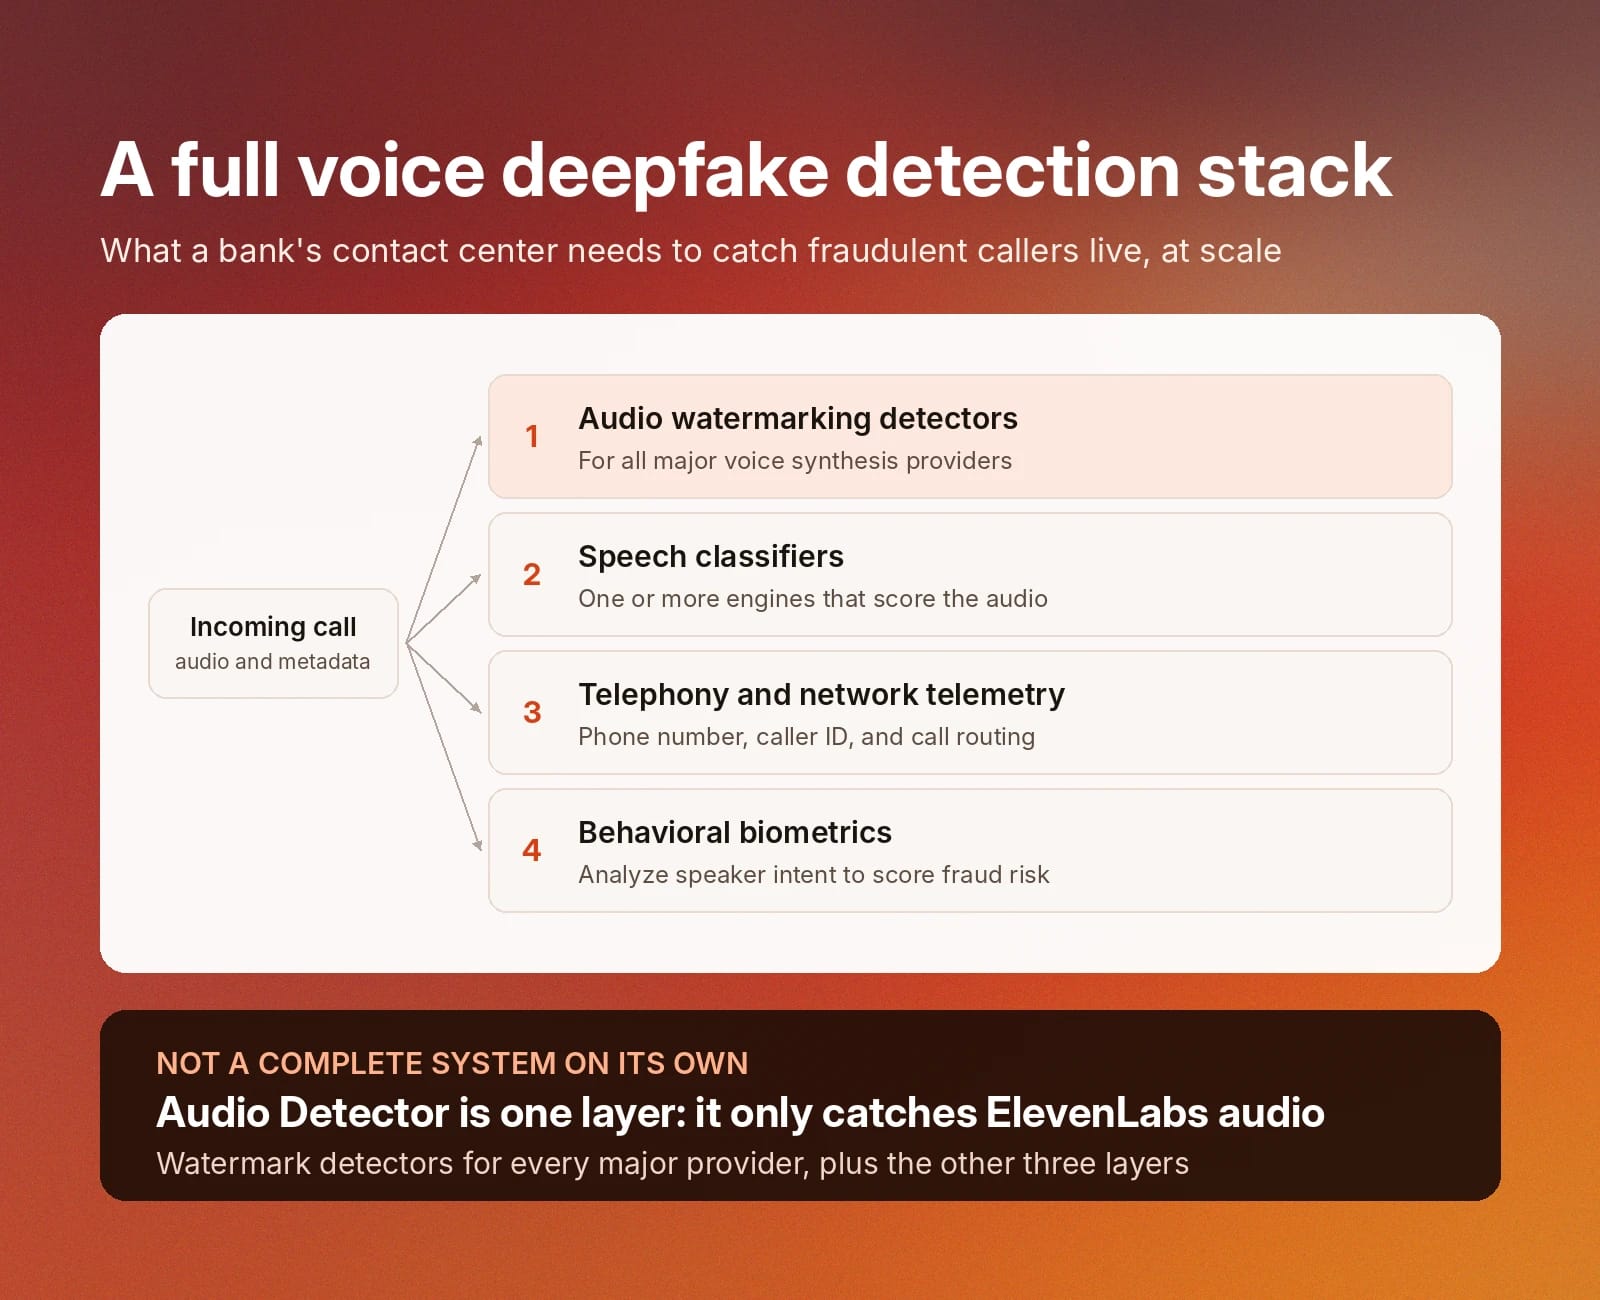
Audio Detector od ElevenLabs odgrywa tu ważną rolę, ale warto ponownie zaznaczyć, że wykrywa tylko dźwięk z watermarkiem ElevenLabs. Sam nie jest kompletnym systemem wykrywania głosu. Organizacje, które potrzebują pełnych możliwości wykrywania głosu, muszą połączyć kilka rodzajów narzędzi:
- Detektory watermarków audio: Dla wszystkich głównych dostawców syntezy głosu.
- Klasyfikatory mowy: Jeden lub więcej silników klasyfikacyjnych, które potrafią oceniać dane audio.
- Telemetria telefoniczna i sieciowa: Analiza metadanych połączeń, takich jak numer telefonu, ID rozmówcy i przekierowanie połączenia.
- Biometria behawioralna: Oprogramowanie analizujące intencje rozmówcy, aby ocenić ryzyko oszustwa.
Zacznij wykrywać deepfake’i z ElevenLabs
ElevenLabs chce pozytywnie wpływać na życie publiczne — zarówno dzięki usługom generowania głosu, jak i narzędziom, które pomagają rozpoznawać deepfake’i oraz inne szkodliwe zastosowania dźwięku generowanego przez AI.
Masz klip audio, który chcesz sprawdzić pod kątem deepfake’ów? Zarejestruj się, aby wypróbować ElevenLabs Audio Detector lub zacznij korzystać z AI Speech Classifier już dziś.
FAQ

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.