Jak działa technologia zamiany tekstu na mowę: od tekstu do naturalnego głosu
- Autor
- Jack Limebear
- Opublikowano
PosłuchajPosłuchaj tego artykułu
Technologia zamiany tekstu na mowę (TTS) przekształca słowa pisane w dźwięk mowy. System najpierw ustala, co mówi tekst i jak powinien brzmieć, a potem model AI generuje audio.
Najpierw silnik TTS normalizuje wprowadzony tekst i zamienia go na tokeny matematyczne oraz reprezentacje wektorowe, które system komputerowy może przetwarzać. Następnie model przekształca te konstrukcje matematyczne w cyfrowe reprezentacje dźwięku, a na końcu w wyjściowe audio.
W tym artykule wyjaśniamy, jak działają różne narzędzia do zamiany tekstu na mowę i dlaczego najnowsza generacja neuronowej syntezy mowy z generatywną AI oferuje najbardziej naturalną mowę.
Podsumowanie
- Systemy zamiany tekstu na mowę przekształcają słowa pisane w audio w dwóch etapach. Najpierw zamieniają tekst w tokeny, czyli matematyczne reprezentacje języka. Potem przekształcają tokeny w reprezentację akustyczną odtwarzaną jako dźwięk.
- Nowsze neuronowe silniki TTS używają modeli AI, by tworzyć naturalnie brzmiącą mowę. Zespoły biznesowe wykorzystują je do tworzenia treści, napisów i obsługi klientów przez agentów.
- Słowniki wymowy i tagi fonetyczne pozwalają dopracować wynik TTS, by brzmiał jak najbardziej naturalnie oraz poprawnie wymawiał żargon techniczny i nazwy.
- Interfejs Text to Speech API pozwala połączyć aplikacje biznesowe z generowaniem głosu wysokiej jakości.
Czym jest TTS? Jak działa technologia zamiany tekstu na mowę
Zamiana tekstu na mowę działa przez analizę tekstu pisanego, określenie brzmienia każdego słowa, a następnie użycie modelu neuronowego i wokodera do wygenerowania mowy.
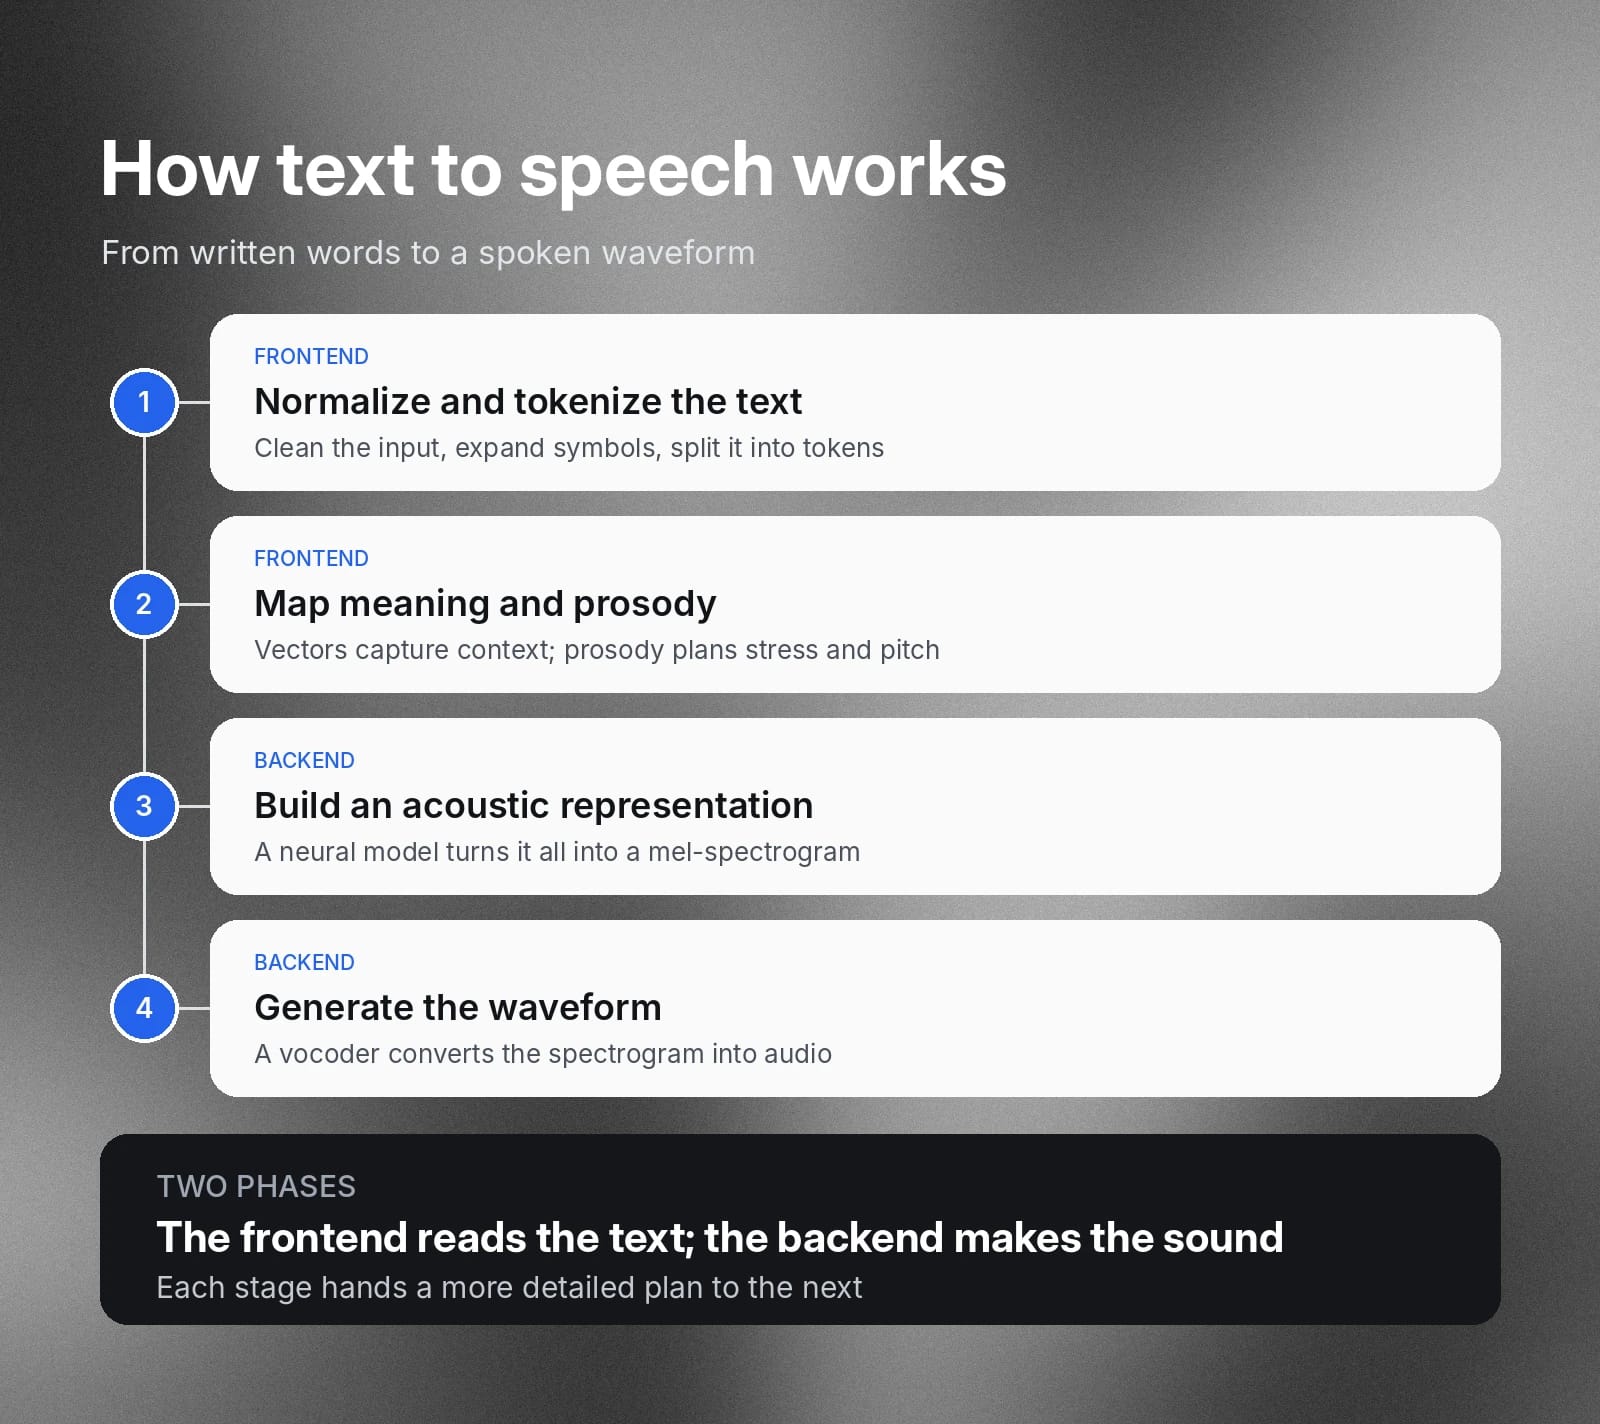
TTS dzieli się ogólnie na dwa etapy:
- Frontend: System zamienia tekst w formę matematyczną, z którą może pracować silnik TTS.
- Backend: System bierze wynik pierwszego etapu i przekształca go w przebiegi falowe modelujące mowę.
Przyjrzyjmy się bliżej elementom działania TTS.
Normalizacja tekstu i analiza językowa
Pierwszym krokiem procesu TTS jest przetwarzanie języka naturalnego (NLP): oczyszczanie, tokenizacja i rozstrzyganie niejednoznaczności surowego tekstu. Tekst dzielony jest na tokeny, czyli pojedyncze jednostki języka pisanego, którymi silnik TTS może operować. Tokenem może być całe słowo, jednostka „podwyrazowa” lub znak interpunkcyjny.
Tekst często zawiera znaki inne niż pełne słowa, na przykład skróty i liczby. Silnik TTS musi też ustalić, jak je wypowiedzieć. Na przykład odczytuje „$11” i zamienia ten tekst na dźwięki odpowiadające „jedenastu dolarom”.
Znaczenie semantyczne i prozodia
Prozodia to wysokość i rytm mowy — dzięki nim TTS brzmi naturalnie. Podczas przetwarzania tekstu silnik tworzy też warstwę informacji prozodycznej, która nanosi na tekst zmiany akcentu i intonacji, by brzmiał naturalniej.
Silnik TTS musi też dostosować wymowę do kontekstu. Zbiera te informacje w postaci reprezentacji wektorowych, czyli danych liczbowych odwzorowujących podobieństwo semantyczne między słowami i frazami. Można to porównać do wykresu X-Y, gdzie linia przebiega przez wiele punktów, ale jest odwzorowana w znacznie większej liczbie wymiarów niż dwa.
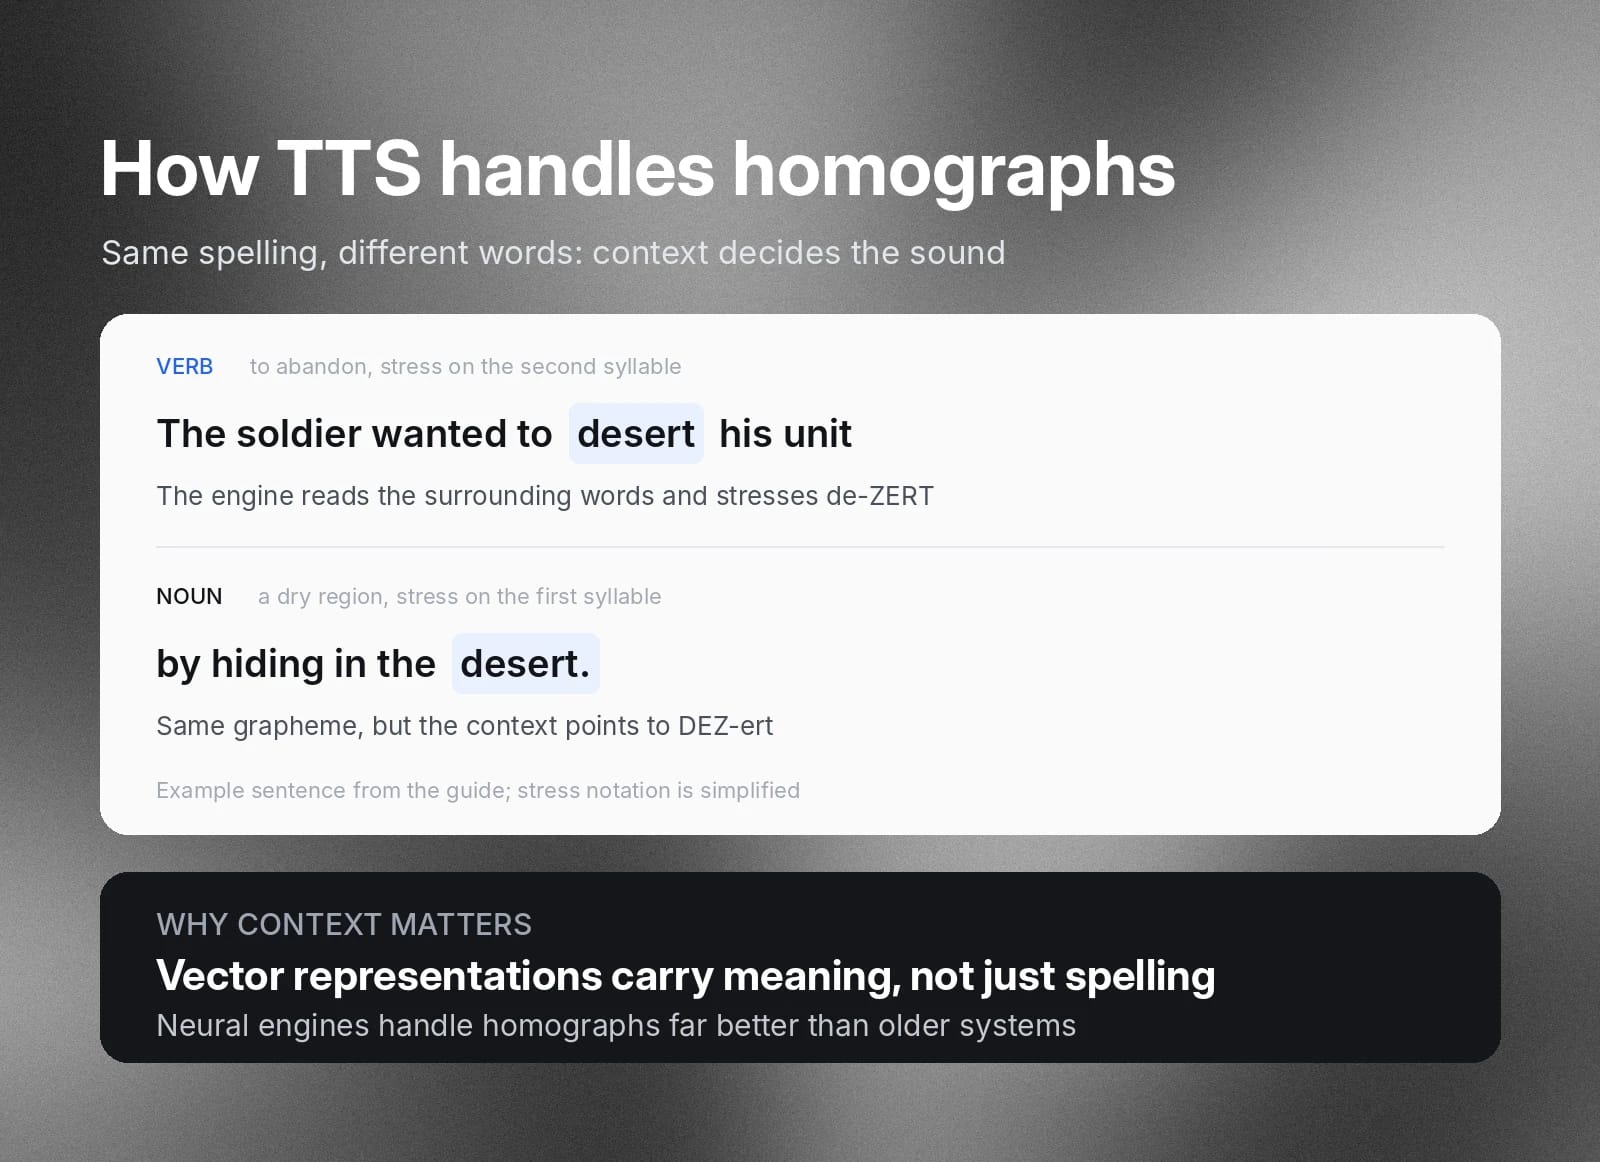
Szczególnym przykładem są homografy. Homografy, czyli różne słowa o tej samej pisowni, czasem wymagają innej wymowy. Silnik TTS musi rozpoznać odpowiednią dla każdego z nich intonację i akcent. Na przykład, jak wymówić grafem „desert” w zdaniu „The soldier wanted to desert his unit by hiding in the desert.”
Zobacz, jak Eleven v4 ożywia ten przykład.
Modelowanie akustyczne i synteza przebiegu falowego (mowy)
Silnik TTS bierze ztokenizowane informacje i wektory kontekstowe, które są już danymi liczbowymi, a następnie zamienia je w reprezentację akustyczną, na przykład spektrogram mel. Obejmuje ona różne częstotliwości, poziomy energii i dźwięki, które mózg interpretuje jako emocje. W przeszłości tę funkcję realizowało wiele systemów, lecz dziś modele neuronowe należą do najskuteczniejszych.
W ostatnim kroku wokoder zamienia te spektrogramy w audio rozpoznawane przez ludzi jako mowa. Ten proces nazywa się generowaniem przebiegu falowego.
Jak TTS działa w praktyce: przykład
Najłatwiej zobaczyć, jak etapy TTS łączą się ze sobą, śledząc drogę jednego zdania przez cały proces.
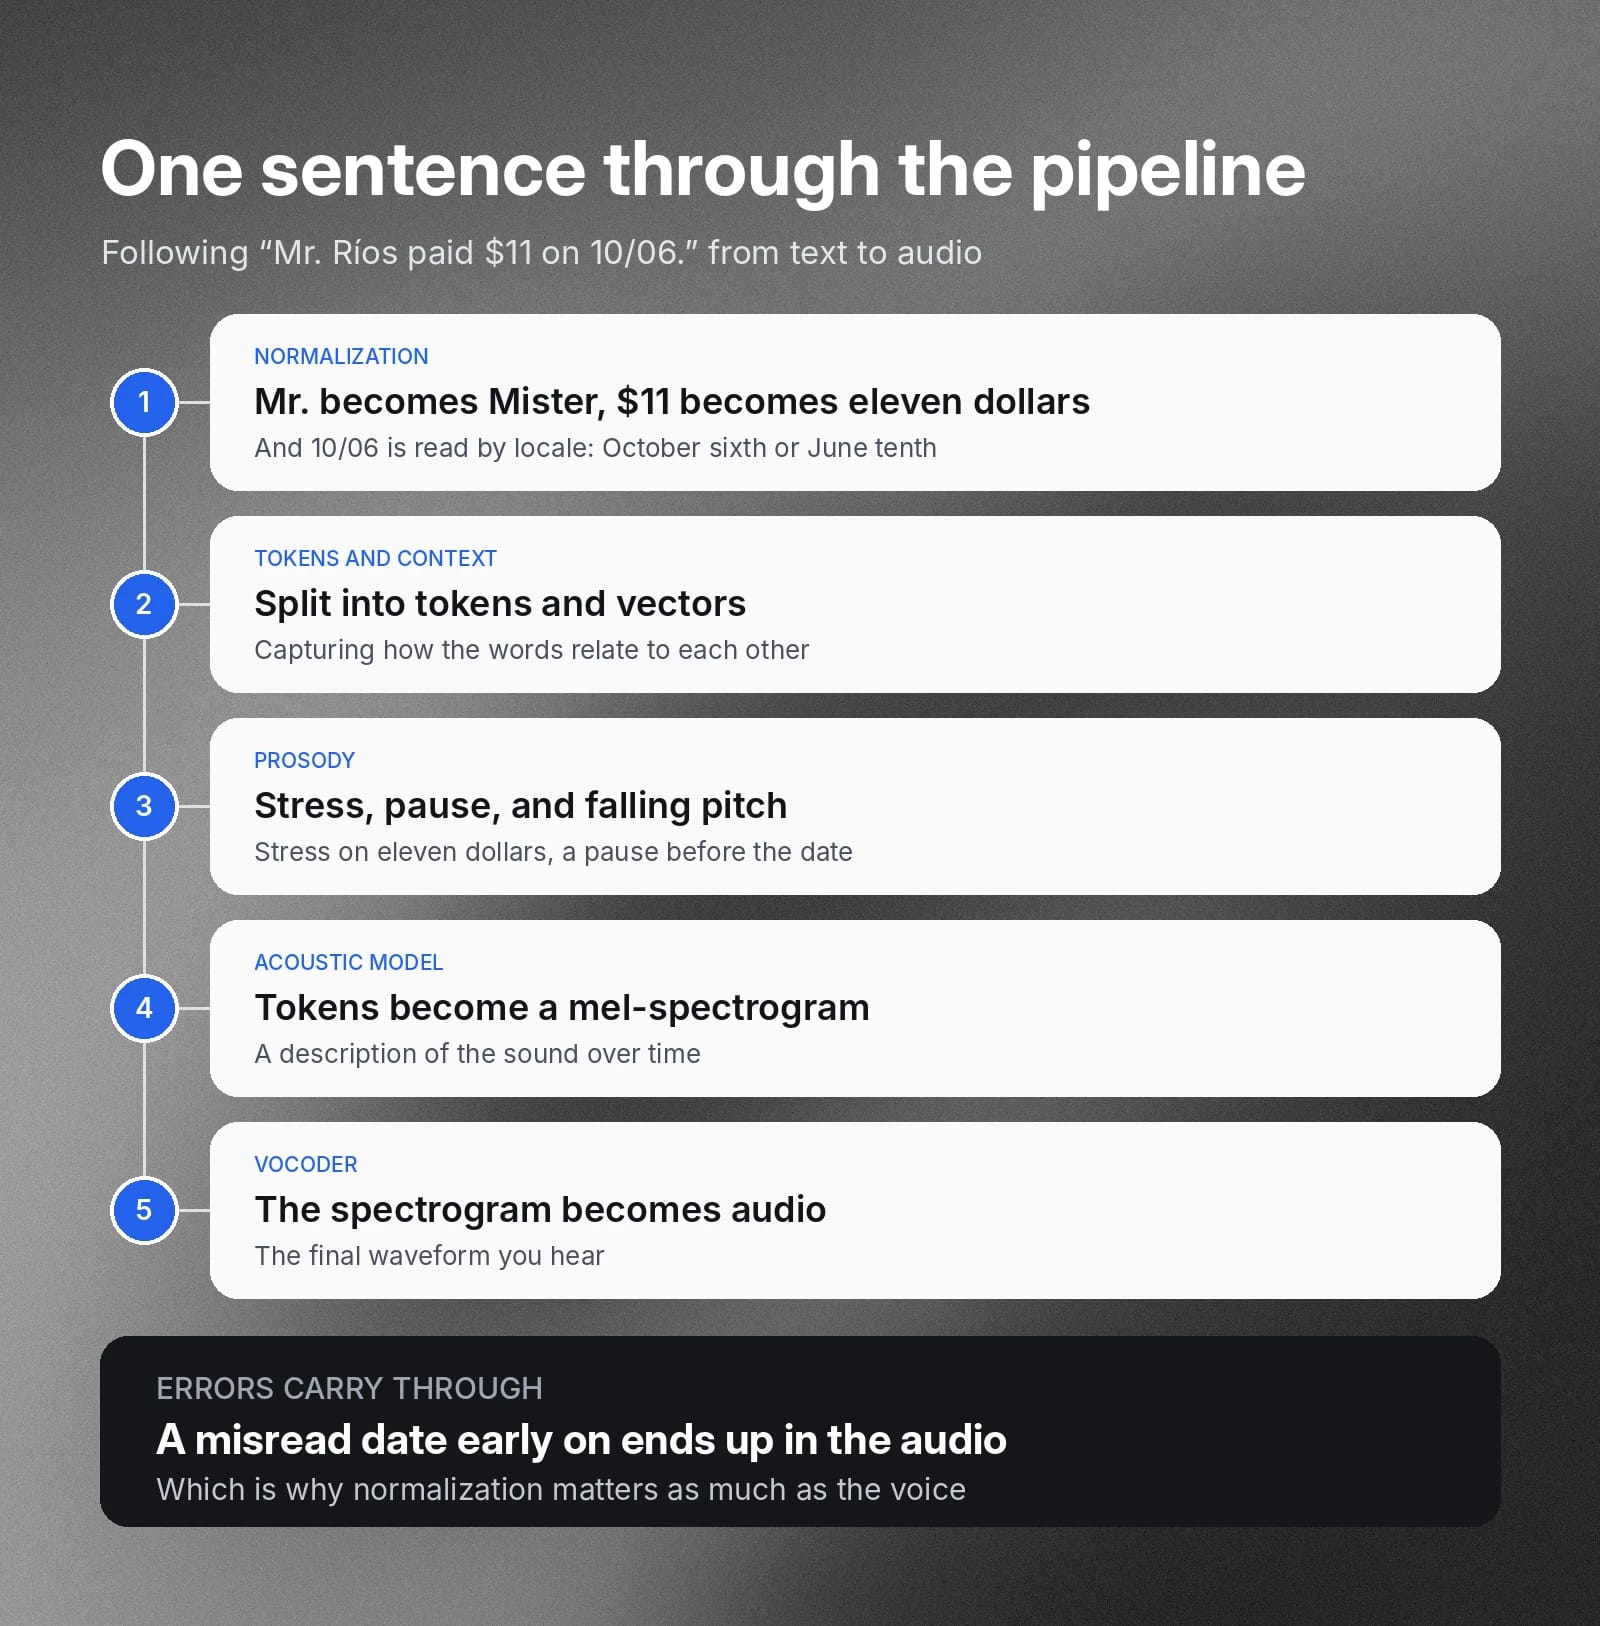
Weźmy tekst: „Mr. Ríos paid $11 on 10/06.”
- Normalizacja: Silnik rozwija „Mr.” do „Mister”, odczytuje „$11” jako „eleven dollars” i zależnie od lokalizacji oraz kontekstu ustala, czy „10/06” to „October sixth”, czy „the tenth of June”.
- Tokenizacja i kontekst: Oczyszczony tekst zostaje podzielony na tokeny i zamieniony na wektory, które opisują relacje między słowami.
- Prozodia: Silnik kładzie akcent na „eleven dollars”, dodaje krótką pauzę przed datą i obniża ton na końcu zdania.
- Model akustyczny: Model neuronowy zamienia tokeny i plan prozodii w spektrogram mel opisujący dźwięk w czasie.
- Wokoder: Wokoder zamienia spektrogram w końcowy przebieg audio, który słyszysz.
Każdy etap przekazuje kolejnemu bardziej szczegółowy plan, dlatego błędy na początku procesu, takie jak źle odczytana data, przenoszą się do gotowego audio.
Dlaczego neuronowa zamiana tekstu na mowę brzmi bardziej po ludzku?
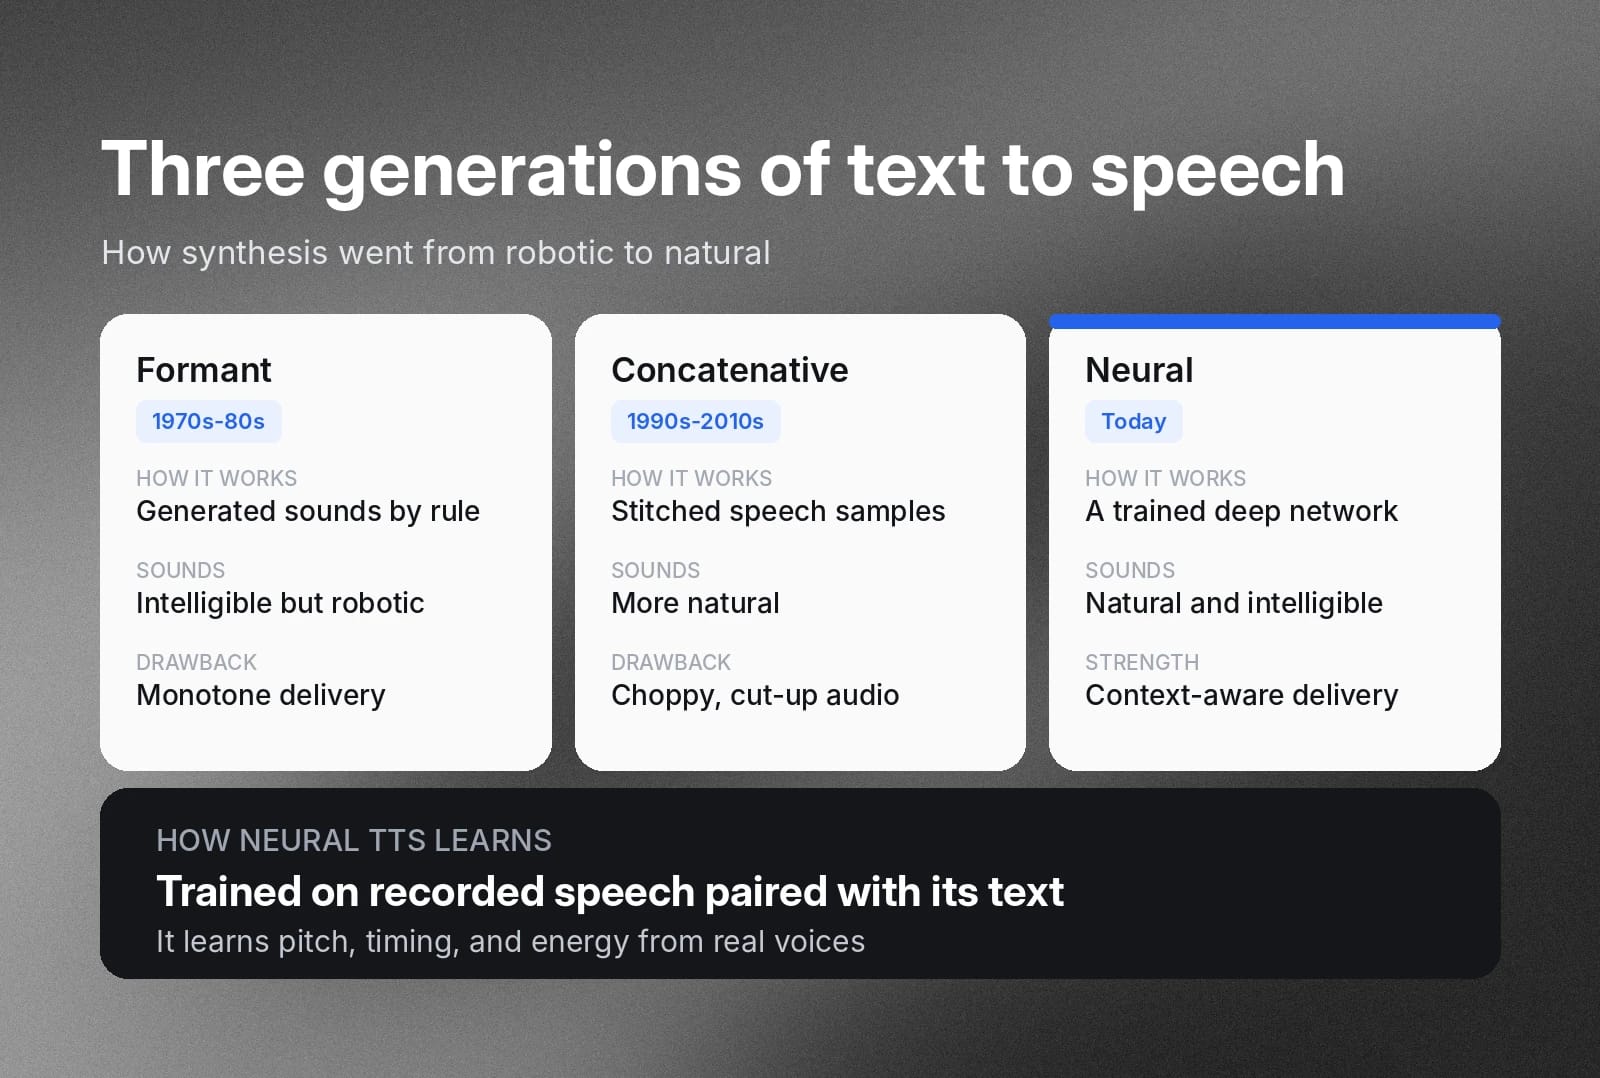
Neuronowa synteza mowy doskonale tworzy naturalną i zrozumiałą mowę — to dwie cechy, którymi inżynierowie oceniają silniki TTS. Neuronowy TTS działa przez trenowanie głębokiej sieci neuronowej (DNN), by tworzyła mowę na podstawie tekstu. DNN trenuje się na dużych zbiorach nagranej mowy połączonej z odpowiadającym jej tekstem.
Silniki neuronowej syntezy mowy to tylko najnowsza generacja TTS klasy enterprise. Poprzedzały je dwie generacje komercyjnej technologii syntezy.
Synteza formantowa dominowała w latach 70. i 80. Zamiast korzystać z próbek ludzkiej mowy podczas działania, generowała syntetyczne dźwięki modelujące mowę. Była zrozumiała, ale monotonna i brzmiała robotycznie.
Synteza konkatenacyjna dominowała od lat 90. do 2010. i brzmiała bardziej naturalnie niż wcześniejsze systemy formantowe. Zamiast generować tony na podstawie reguł matematycznych, łączyła, czyli konkatenowała, krótkie próbki ludzkiej mowy. Systemy te używały językowych tabel wyszukiwania, by dopasować znormalizowany tekst do dźwięków, a potem odtwarzały małe fragmenty połączonego audio mowy pobrane z ogromnej biblioteki, czyli „korpusu”. Choć brzmi naturalniej niż mowa z silnika formantowego, konkatenacja może nadal powodować poszarpane brzmienie.
Czym różni się generator głosu AI od zamiany tekstu na mowę?
„Generator głosu AI” to określenie często używane w marketingu dla szerokiej gamy technologii głosowych, w tym zamiany tekstu na mowę. Zamiana tekstu na mowę oznacza konkretnie systemy, które przyjmują tekst pisany, modelują jego semantykę i prozodię oraz tworzą przebiegi audio.
Generatory głosu AI to cały ekosystem powiązanych technologii głosowych, obejmujący TTS i inne systemy generatywne do projektowania głosu, klonowania głosu i transferu stylu głosu. Choć w marketingu termin ten bywa stosowany zamiennie z zamianą tekstu na mowę, najlepiej rozumieć generatory głosu AI jako szerszą kategorię generatywnych narzędzi głosowych, której częścią jest TTS.
Jak używać zamiany tekstu na mowę do treści, dostępności i wsparcia
Modele Text to Speech stały się kluczową częścią workflow na całym świecie — zarówno w zastosowaniach prywatnych, jak i komercyjnych.
Oto najważniejsze zastosowania zamiany tekstu na mowę.
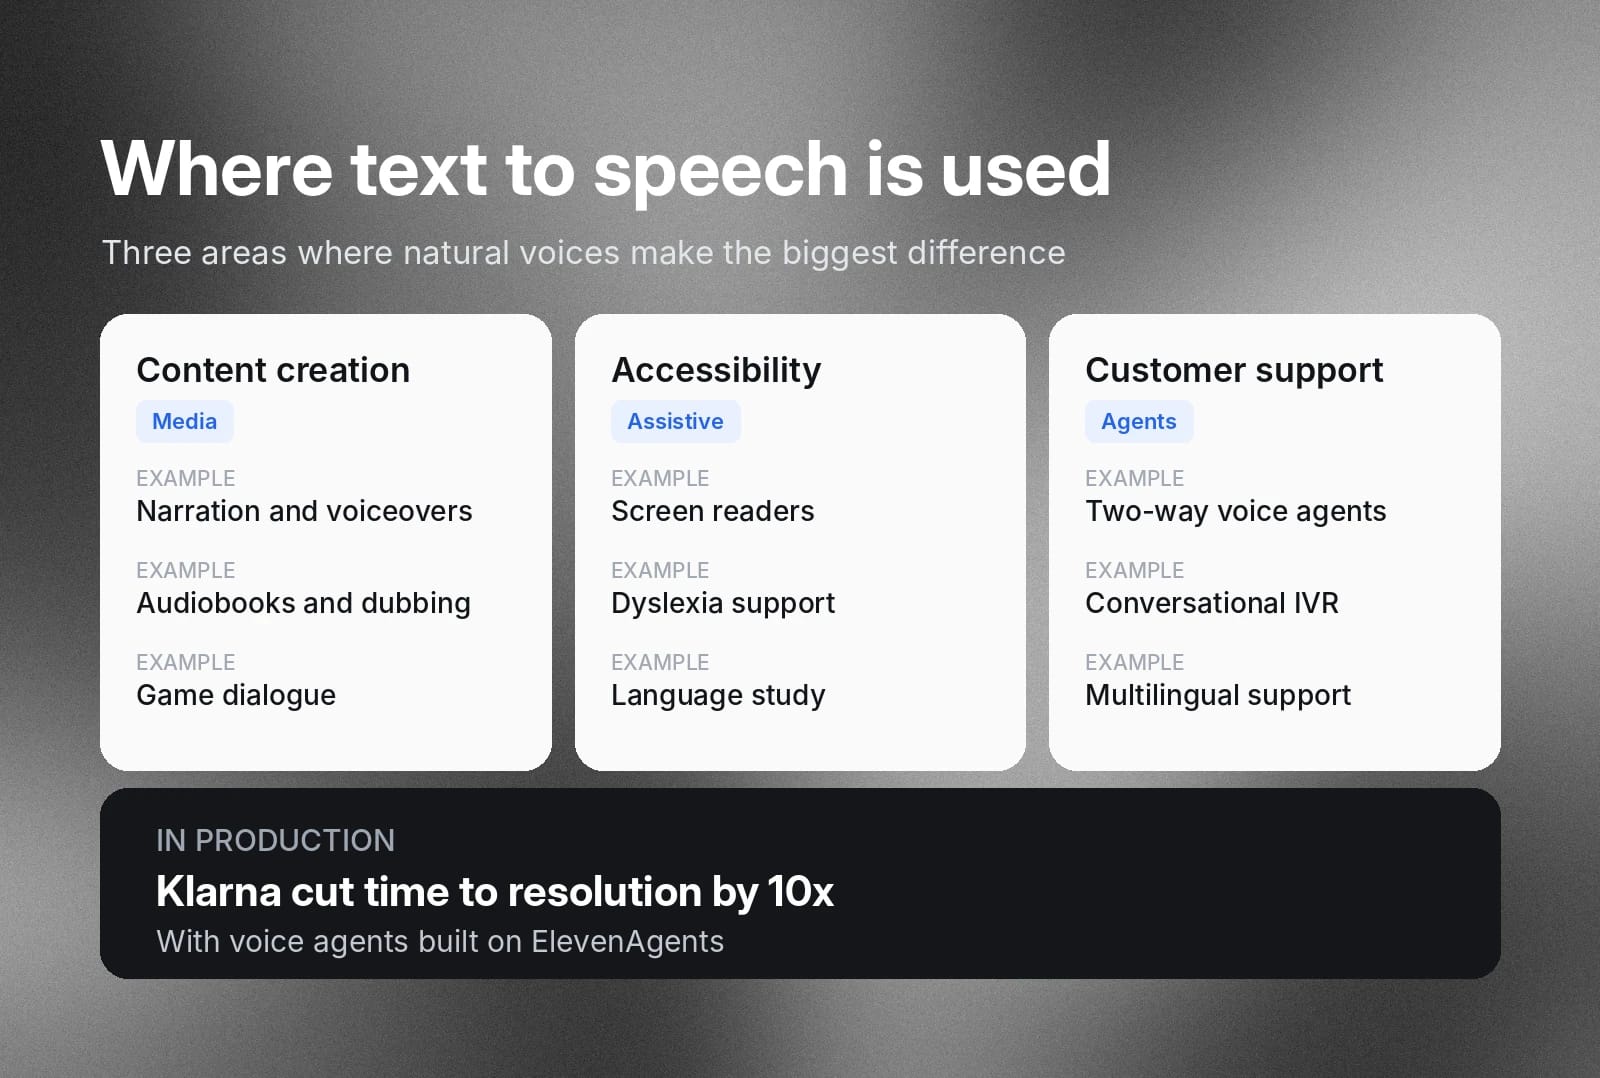
Tworzenie treści
Narzędzia do zamiany tekstu na mowę pomagają obniżyć koszty produkcji mediów na dużą skalę i skrócić czas spędzany w studiu na narracji oraz poprawkach po produkcji.
Przykładowe zastosowania:
- Narracja
- Nałożone głosy
- Dubbing
- Produkcja audiobooków
- Dialogi w grach
Na przykład TAP użył ElevenLabs TTS do skalowania treści edukacyjnych dla szkół w całych Indiach.
Dostępność
Zamiana tekstu na mowę jest jedną z najczęściej używanych technologii wspomagających, ponieważ pozwala odbierać treści pisane przez słuchanie. Naturalna mowa zwiększa zaangażowanie słuchaczy i zmniejsza zmęczenie podczas słuchania długich materiałów.
Typowe zastosowania TTS w dostępności to:
- Czytniki ekranu: Odczytuj całe strony na głos za pomocą czytnika ekranu i TTS.
- Wsparcie przy dysleksji i nauce czytania: Zmniejsz wysiłek związany z czytaniem, dodając głos TTS do sesji czytania.
- Słaby wzrok i ślepota: Czytniki ekranu odczytują elementy interfejsu i treść strony, dzięki czemu można poruszać się po programach i stronach bez patrzenia na ekran.
- Różnice poznawcze i trudności z uwagą: Słuchanie tekstu może zmniejszyć wysiłek potrzebny do czytania długich dokumentów i ułatwić skupienie.
- Nauka i nauka języków: Uczniowie słyszą poprawną wymowę nowego słownictwa i mogą słuchać podręczników podczas dojazdów lub nauki.
Czytniki ekranu to pełne narzędzia dostępności, które opisują wszystko na ekranie, w tym przyciski i menu. Narzędzia do odczytu na głos skupiają się na samej treści, zwykle z podświetlaniem śledzącym tekst. Korzystają na bardziej naturalnych głosach, bo ludzie używają ich przez dłuższy czas.
Obsługa klienta
Neuronowa synteza mowy może zapewnić wysoką jakość obsługi klienta w połączeniu z LLM zdolnym do działania jako agent. Platformy takie jak ElevenAgents łączą warstwę głosową z rozpoznawaniem mowy, LLM i połączonymi narzędziami, które pozwalają agentowi zrozumieć potrzeby dzwoniącej osoby i odpowiedzieć naturalnym głosem.
Agenci zbudowani z ElevenAgents działają przez telefon, w internecie, przez WhatsApp, e-mail i SMS, dzięki czemu klienci mogą kontynuować rozmowę między kanałami bez powtarzania tych samych informacji. Przykładowe zastosowania:
- Dwukierunkowi agenci głosowi AI: Prowadzą rozmowy na żywo, odpowiadając na pytania z bazy wiedzy lub kierując klientów do konkretnych procesów, takich jak zwroty czy zakupy.
- Systemy interaktywnej odpowiedzi głosowej (IVR): Zastępują przestarzałe drzewa menu typu „Naciśnij 3, aby połączyć się ze sprzedażą” rozmowami, w których klienci mogą mówić naturalnie.
- Obsługa wielojęzyczna: Obsługuj klientów w ich własnym języku z jednej konfiguracji agenta.
Na przykład Klarna skróciła czas rozwiązania sprawy 10-krotnie dzięki ElevenAgents
Jak silniki zamiany tekstu na mowę kontrolują wymowę?
Nowoczesne silniki neuronowej syntezy mowy potrafią generować bardzo naturalnie brzmiącą mowę, ale w czymś tak szerokim, głębokim i dynamicznym jak ludzki język zawsze będą występować przypadki brzegowe. Możesz chcieć zachować akcenty, slang lub regionalną wymowę w generowanej mowie. Możesz tworzyć audio dla branży, w której terminy techniczne wymawia się w szczególny sposób. Możesz też po prostu chcieć, aby nazwa twojej marki była wymawiana w konkretny i spójny sposób.
Słowniki wymowy i zastępowanie fonemów
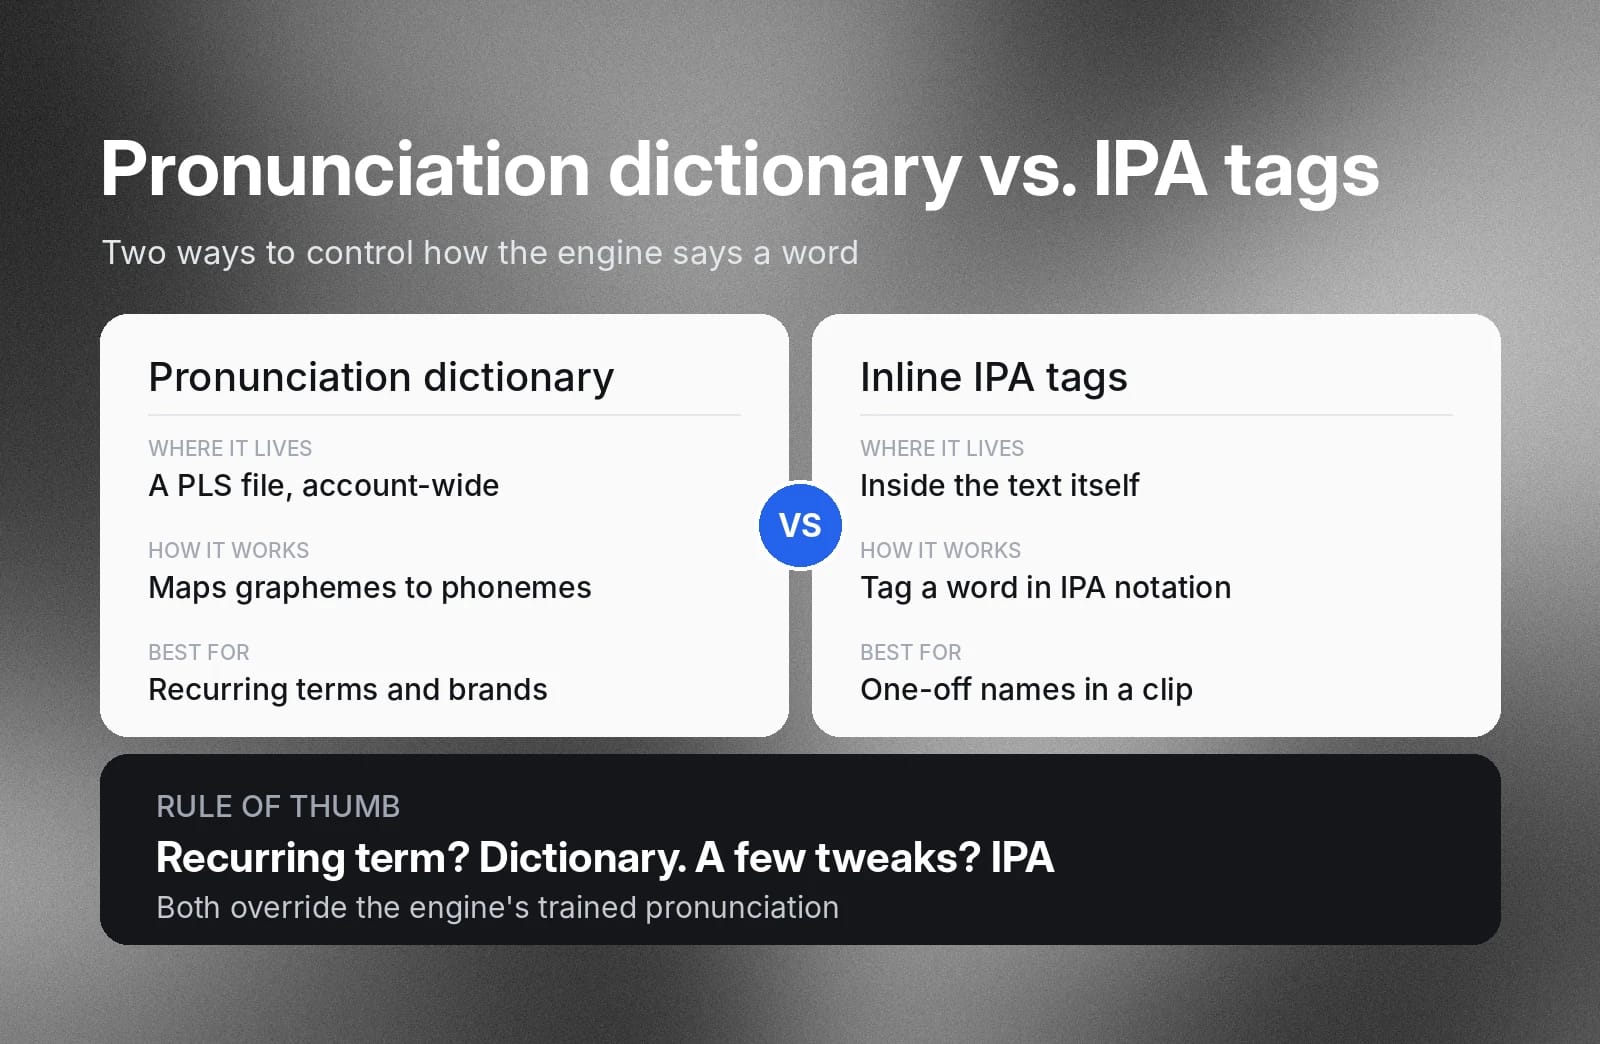
ElevenAPI od ElevenLabs zawiera słownik wymowy, który pozwala dostosować sposób mówienia silnika. Tworzysz słownik w pliku Pronunciation Lexicon Specification (PLS), zgodnym ze standardem W3C, który mapuje grafemy (symbole w tekście) na fonemy (słowa mówione rozłożone na dźwięki). Gdy silnik TTS napotka jeden z wymienionych grafemów, zastępuje wyuczoną wymowę wymową fonetyczną ze słownika.
Dowiedz się, jak stworzyć słownik wymowy w ElevenAPI, w dokumentacji Korzystanie ze słowników wymowy.
Natywne IPA i wskazówki fonetyczne
Niektóre modele TTS rozpoznają też tagi wymowy wstawiane bezpośrednio w tekście wejściowym. Zamiast więc tworzyć słownik dla całego konta, jeśli chcesz tylko poprawić wymowę w jednym lub dwóch klipach audio, możesz oznaczyć słowa w tekście za pomocą standardowej notacji IPA. Na przykład gdy nagrywasz audiobook i chcesz, aby imię fikcyjnej postaci było wymawiane w określony sposób.
Typowe wyzwania TTS i jak sobie z nimi radzić
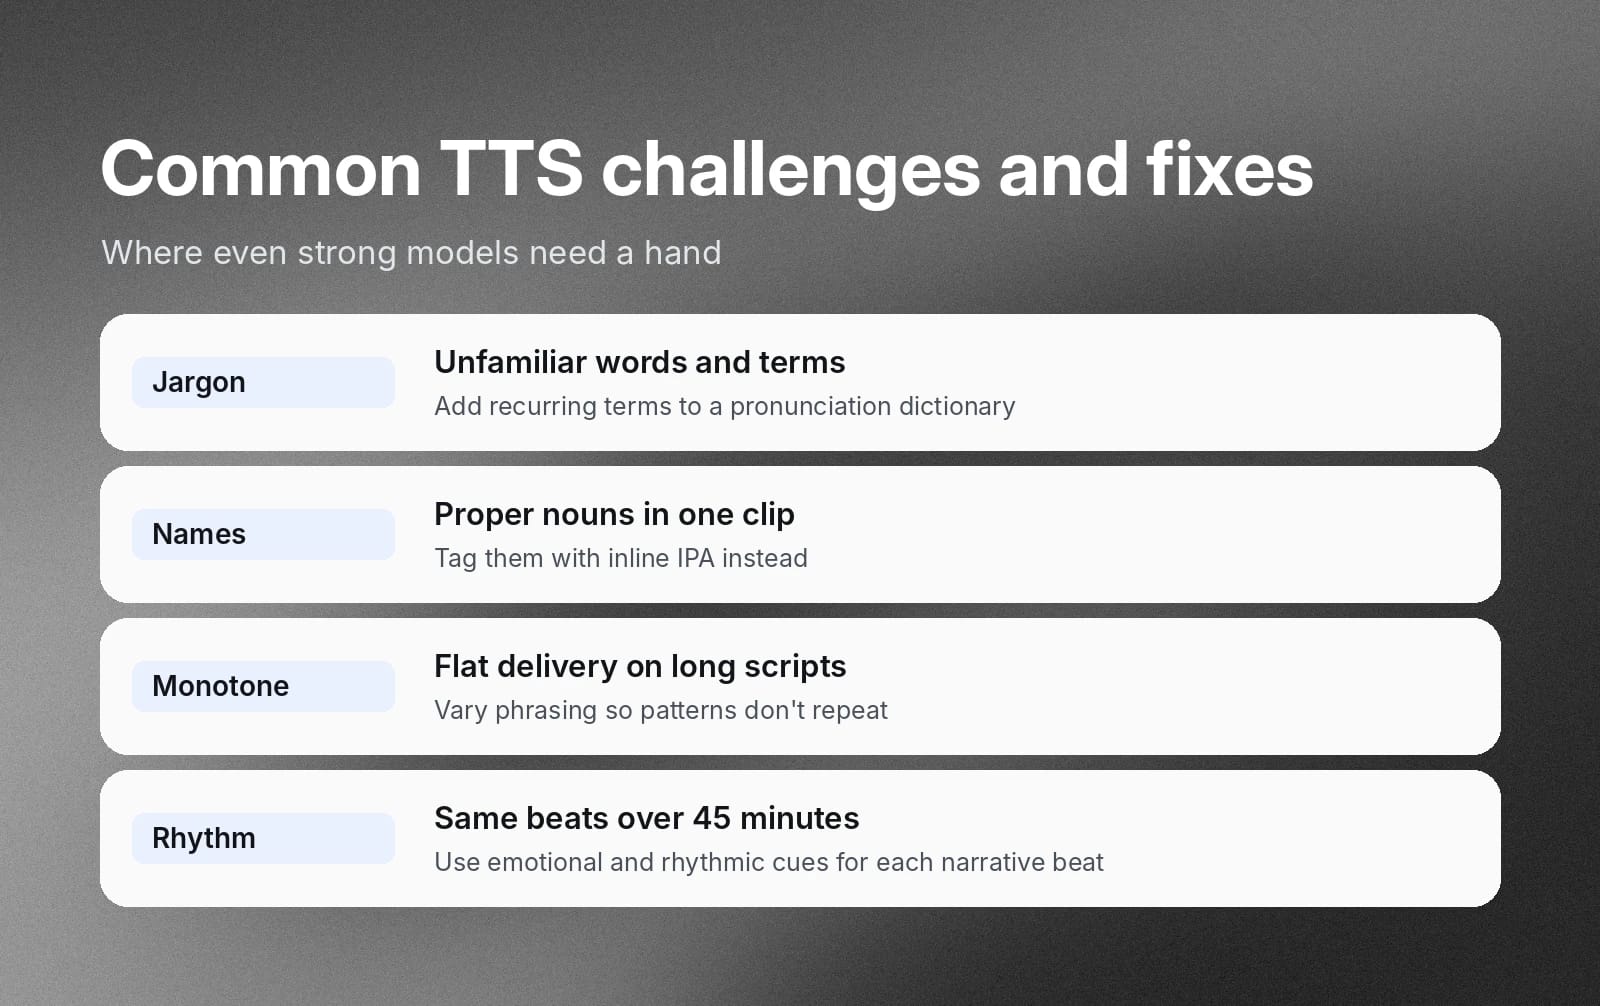
Nawet najlepsze modele TTS mogą mieć trudności z niuansami ludzkiego języka. Dwa najczęstsze problemy to błędna wymowa nowych słów i monotonna mowa. Oto jak sobie z nimi radzić.
Błędna wymowa nieznanych słów, żargonu i nazw własnych
Silniki TTS używają algorytmów, które przewidują wymowę znormalizowanego tekstu na podstawie tego, jak grafemy odpowiadają fonemom w danych treningowych. Dokonują najlepszego możliwego osądu na podstawie przetworzonego tekstu i kontekstu. Jednak, jak wspomnieliśmy wcześniej, będzie wiele przypadków brzegowych, w których zależy ci na bardzo konkretnej wymowie.
Słowniki wymowy lub celowane tagi IPA będą najlepszymi narzędziami w takich przypadkach. Jeśli masz często powtarzający się termin, który ma być zawsze wymawiany tak samo, najlepszym rozwiązaniem jest słownik. Jeśli chcesz poprawić tylko kilka terminów, użyj fonetycznych tagów IPA.
Monotonna interpretacja
Problemy te najczęściej pojawiają się przy przetwarzaniu dłuższych skryptów, gdy te same słowa lub frazy są wypowiadane wciąż od nowa. Syntezowana mowa może brzmieć świetnie w 10-sekundowych klipach, ale słuchanie tej samej mechanicznej wymowy i rytmu przez 45-minutowy wykład szybko męczy odbiorcę.
Różnicuj sformułowania w skryptach i rozsądnie używaj tagów fonetycznych, by od czasu do czasu zmieniać wymowę. Używaj wskazówek emocjonalnych i rytmicznych, aby mowa była bardziej dynamiczna, wznosząc się i opadając wraz z kolejnymi momentami narracji.
Twórz naturalne doświadczenia głosowe z Text to Speech API
Lekkie narzędzia internetowe świetnie sprawdzają się przy małych klipach audio, ale nie skalują się dobrze do większych potrzeb biznesowych. Jeśli chcesz obsługiwać tysiące interakcji z klientami na minutę lub generować długie treści audio wysokiej jakości, potrzebujesz bardziej rozbudowanych narzędzi TTS.
Text to Speech API, takie jak ElevenAPI, pozwala połączyć twoje oprogramowanie bezpośrednio z modelami neuronowej syntezy mowy. Możesz używać żądań REST lub trwałych połączeń WebSocket, by generować audio na żądanie dla agentów lub innych celów na dużą skalę.
Jak działa żądanie do API zamiany tekstu na mowę
Choć modele są złożone, ten proces dla dewelopera jest łatwy do zrozumienia i wdrożenia.
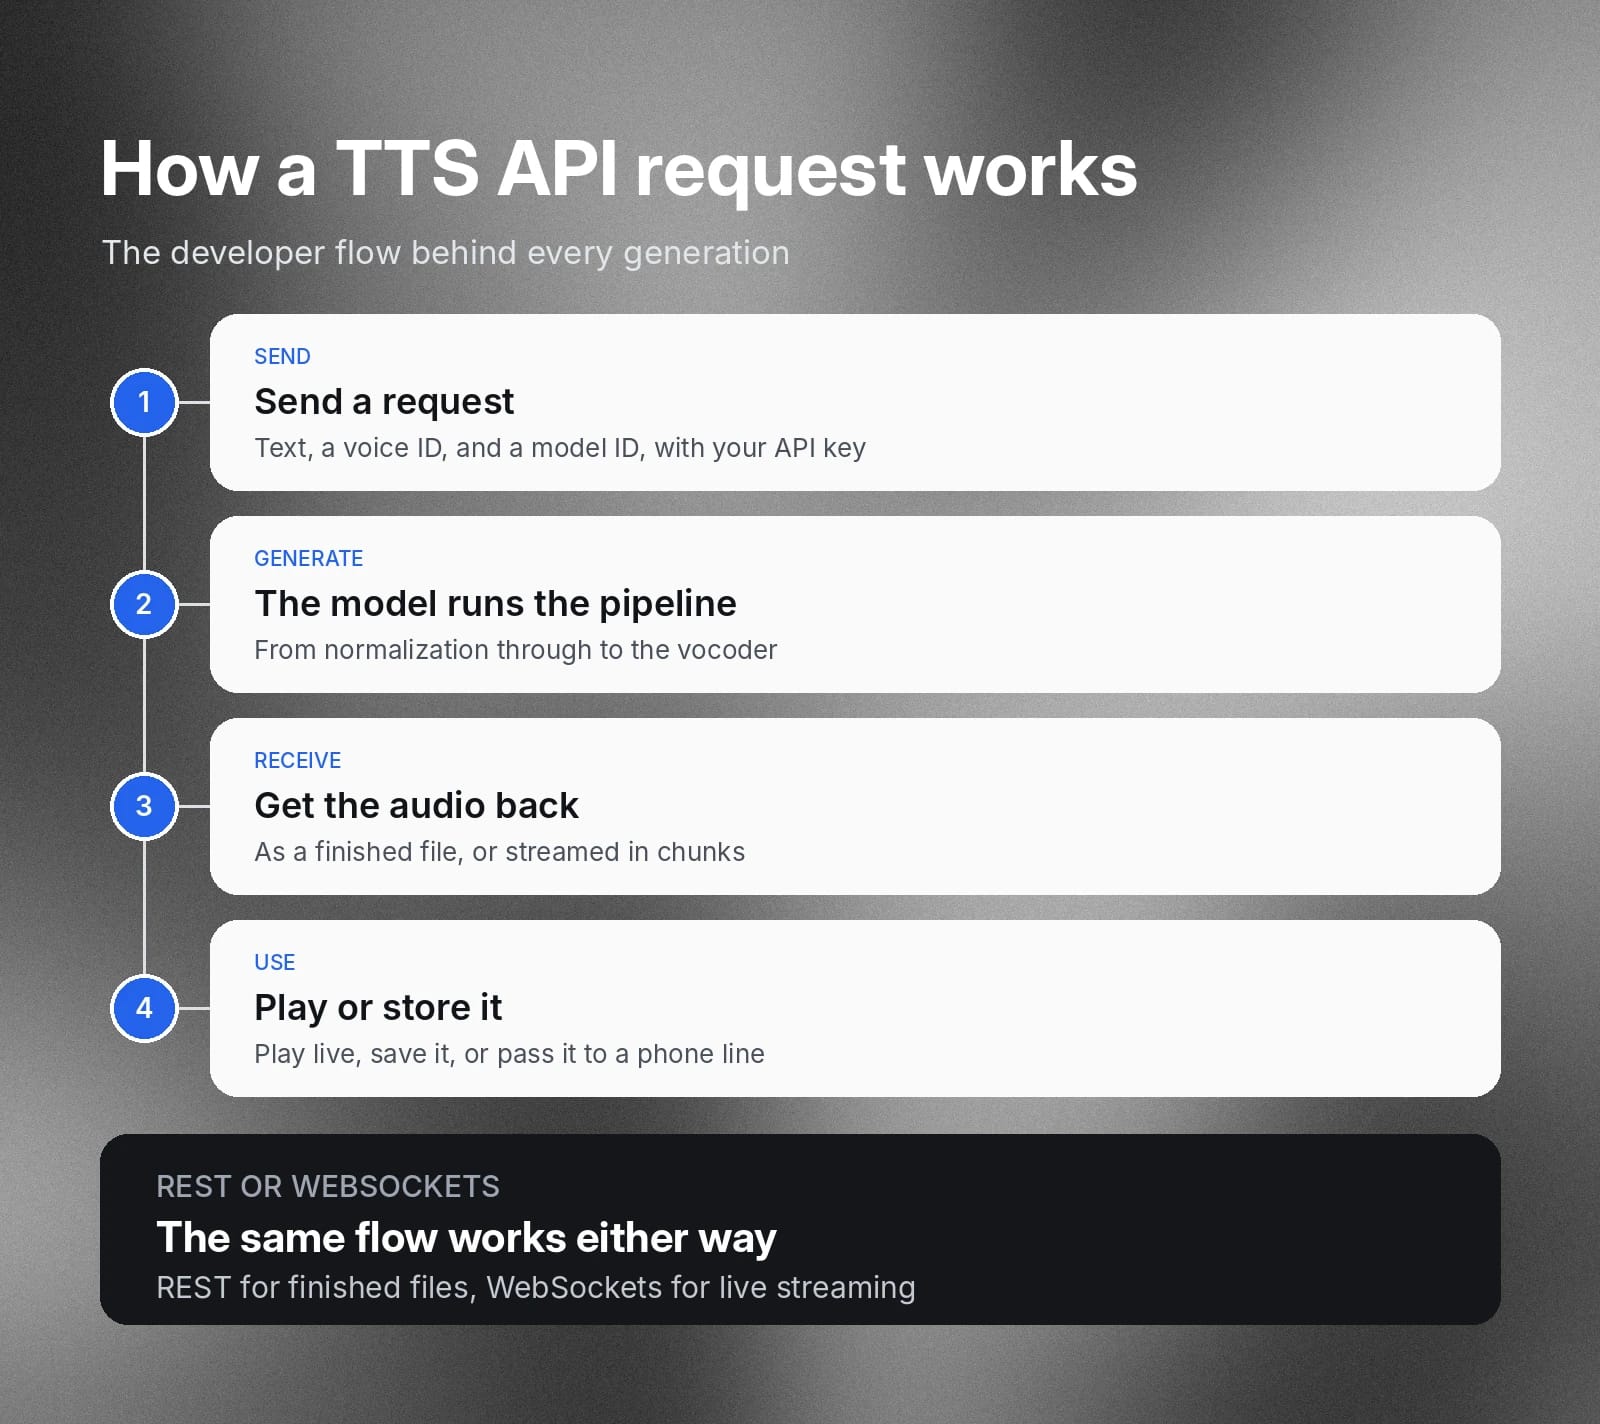
Z ElevenAPI możesz zintegrować Text to Speech ze swoimi aplikacjami w kilka minut:
- Wyślij żądanie: Twoja aplikacja wysyła do API tekst, identyfikator głosu i identyfikator modelu wraz z kluczem API.
- Wygeneruj: Model uruchamia opisany wyżej proces — od normalizacji po wokoder.
- Odbierz audio: API zwraca gotowy plik audio lub przesyła go strumieniowo w częściach, dzięki czemu odtwarzanie może zacząć się przed zakończeniem generowania.
- Odtwórz lub zapisz: Twoja aplikacja odtwarza audio na żywo, zapisuje je lub przekazuje do innego systemu, na przykład linii telefonicznej.
Ten sam proces obowiązuje niezależnie od tego, czy używasz REST dla gotowych plików, czy WebSocketów do transmisji na żywo, a opisane niżej SDK obsługują te wywołania za ciebie.
Kwestie architektoniczne dla deweloperów
W zależności od zastosowania może być konieczne wyważenie kompromisów między szybkością przetwarzania, wiernością audio, opóźnieniami sieciowymi i protokołami oraz możliwościami integracji.
Opóźnienie a wierność
Aby agenci konwersacyjni brzmieli naturalnie, warto dążyć do około 100 ms do pierwszego audio, co oznacza minimalizowanie opóźnień w sieci i do silnika TTS. Ważne jest tu, jaką jakość audio potrafisz uzyskać z architektury agenta w ramach tego ograniczenia.
Z kolei opóźnienie ma mniejsze znaczenie przy tworzeniu długiego audio, na przykład podcastu lub wykładu. Zamiast minimalizować opóźnienie, warto maksymalizować jakość dźwięku.
Protokoły strumieniowania
Protokoły używane do połączenia z API również mogą wpływać na opóźnienia i wydajność. WebSockety umożliwiają prawdziwe dwukierunkowe strumieniowanie audio, czyli możesz przetwarzać fragmenty tekstu na bieżąco zamiast czekać na wyrenderowanie całego strumienia. Odtwarzanie może zacząć się od pierwszych fragmentów, gdy silnik TTS nadal przetwarza kolejne.
SDK
Text to Speech API klasy enterprise, takie jak ElevenAPI, oferują pełne zestawy narzędzi programistycznych (SDK) dla Pythona i TypeScript/JavaScript, a także REST API, które pomagają szybko uruchomić nową architekturę. Używaj ich, by zmniejszyć nakład pracy zespołu deweloperskiego przy integracji.
Zacznij korzystać z ElevenAPI do Text to Speech
Naturalna synteza TTS z wiodącego modelu mowy zapewnia wysokiej jakości audio, którego twoi agenci i produkcje audio potrzebują, by utrzymać zaangażowanie słuchaczy. Niezależnie od tego, czy szukasz wysokiej jakości agenta konwersacyjnego do obsługi procesów klienta, czy chcesz wbudować TTS w aplikację, ElevenLabs ma rozwiązanie.
Zacznij już dziś i twórz własne audio wysokiej jakości z ElevenAPI, lub dowiedz się więcej o ElevenAgents.
Najczęstsze pytania

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.