Neuralna zamiana tekstu na mowę (TTS): jak działają głosy AI
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Neuralna zamiana tekstu na mowę (TTS) to technologia stojąca za głosami AI, które słyszysz wszędzie. Mały przycisk na stronie z newsami, który odczytuje artykuł. Automatyczne rozmowy z pomocą techniczną. Narracja wideo na TikToku i YouTube. To tylko kilka przykładów. Neural TTS zastąpiło tradycyjne, robotyczne formy zamiany tekstu na mowę.
W 2026 roku rynek TTS przekroczył 4,8 mld USD i rośnie w tempie 22,4% rocznie (CAGR). Z roku na rok pojawiają się nowe zastosowania, a twórcy i firmy coraz chętniej korzystają z tej technologii.
W tym przewodniku wyjaśniamy, czym jest neuralna zamiana tekstu na mowę i dlaczego ma kluczowe znaczenie dla szybkiego rozwoju tej branży. Omówimy też różnice względem tradycyjnego TTS i to, na co zwrócić uwagę przy integracji TTS API z aplikacją.
Podsumowanie
- Neuralna zamiana tekstu na mowę wykorzystuje deep learning, by generować mowę od podstaw.
- Głosy neuralne odwzorowują prozodię, intonację, akcent i rytm, dzięki czemu rozumieją brzmienie ludzkiego głosu.
- Tradycyjne TTS konkatenacyjne i parametryczne nadal występuje w starszych systemach, ale tam, gdzie liczy się jakość głosu, zastąpiła je synteza neuralna.
- Deweloperzy mogą integrować neuralne TTS przez API, a opóźnienie streamingu jest dziś na tyle niskie, że pozwala prowadzić rozmowy w czasie rzeczywistym.
Czym jest neuralna zamiana tekstu na mowę?
Neuralna zamiana tekstu na mowę (neural TTS) to forma syntezy mowy, która wykorzystuje głębokie sieci neuronowe do tworzenia mowy brzmiącej jak ludzka. Sieć neuronowa w AI składa się z warstw połączonych jednostek przetwarzających. Jej nazwa wynika z luźnego podobieństwa do sieci neuronowej w ludzkim mózgu.
Wcześniejsze modele zamiany tekstu na mowę opierały się na ręcznie zapisanych regułach i nagranych fragmentach audio, aby opisać język i nauczyć się tworzyć mowę na podstawie próbek tekstu. Model neuralnego TTS sam wyprowadza reguły, ucząc się z kontekstu radzić sobie z trudniejszymi elementami mowy, takimi jak miejsce pauzy czy słowo, które należy zaakcentować.
To właśnie rozumienie prozodii i emocji odróżnia neuralne TTS od tradycyjnych modeli.
Jak działa neuralne TTS: przegląd technologii
Neuralne TTS zamienia tekst w audio, zachowując elementy niosące znaczenie: wymowę, emocje, rytm, akcent i ton. W tle współpracuje ze sobą kilka modeli, które przekształcają tekst w mowę brzmiącą jak ludzka.
Dokładna architektura różni się między dostawcami, ale neuralne TTS zwykle obejmuje poniższe główne etapy.
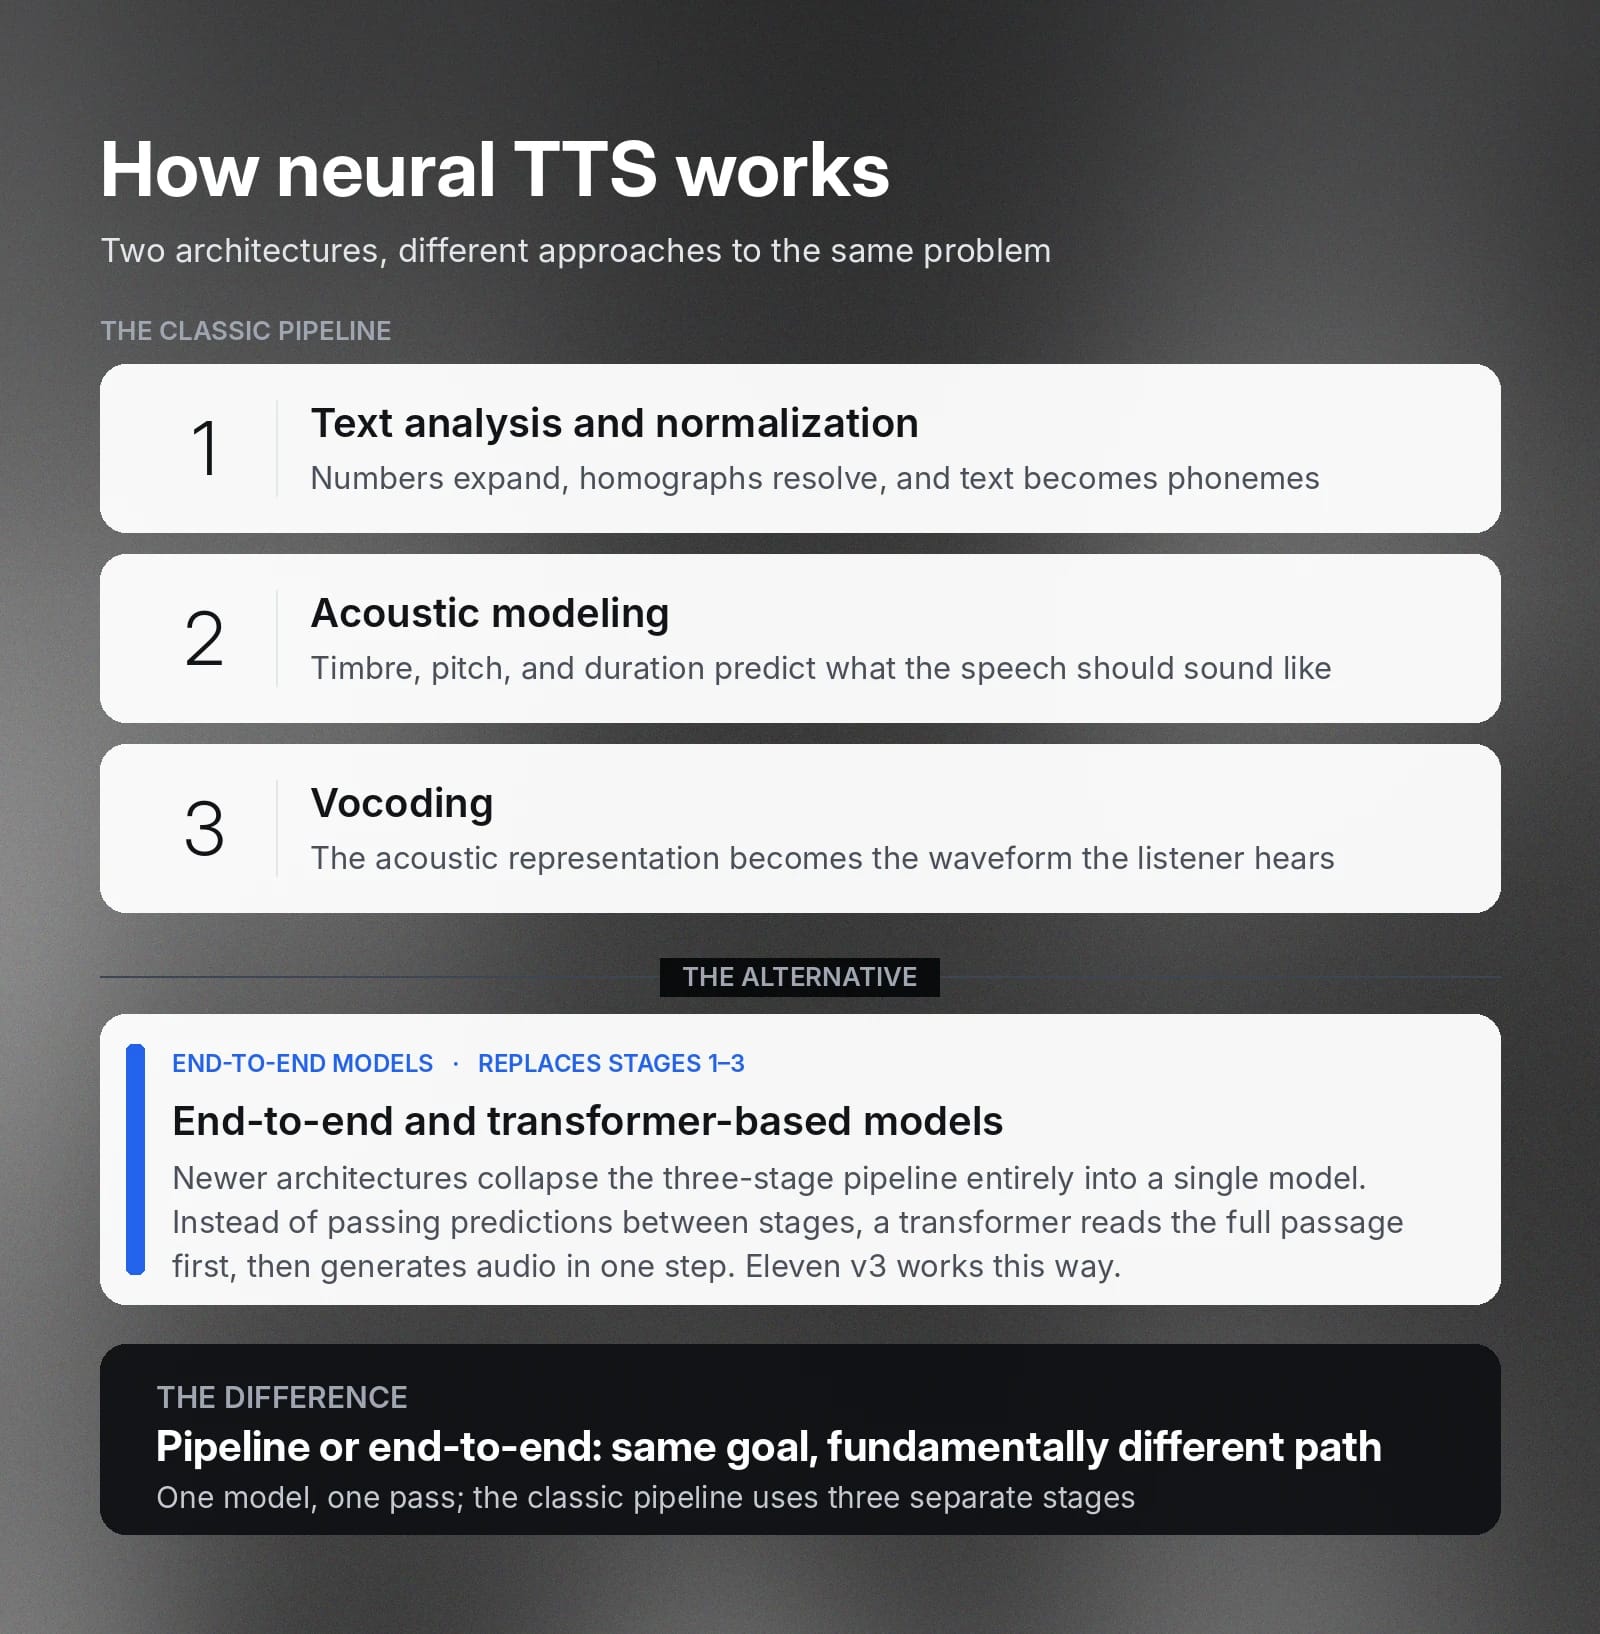
Analiza tekstu
Tekst pisany jest pełen niejednoznaczności. W języku angielskim istnieje znane zdanie, w którym akcent na innym słowie zmienia znaczenie: „I didn't say he stole the money.” Zaakcentuj „I”, a zasugerujesz, że powiedział to ktoś inny. Zaakcentuj „he”, a zasugerujesz, że ukradł to ktoś inny. Zaakcentuj „money”, a nagle okazuje się, że skradziono coś innego.
Analiza tekstu rozwiązuje te niejednoznaczności przed wygenerowaniem audio. Rozwija skróty i zamienia typowe elementy tekstu, takie jak daty, liczby czy symbole, na formy mówione. Homografy, takie jak angielskie „read”, „lead” i „bass”, są rozpoznawane i wymawiane poprawnie na podstawie kontekstu całego zdania. Model przewiduje też oznaczenia prozodyczne, wskazując słowa o największym znaczeniu. Model akustyczny realizuje te oznaczenia w następnym etapie.
Znormalizowany tekst jest następnie zamieniany na pojedyncze fonemy w procesie konwersji grafem-fonem. Ten krok pomaga zapewnić stabilne i poprawne audio, nawet w językach, takich jak angielski, których zasady wymowy są wyjątkowo nieprzewidywalne.
Przygotowaliśmy przewodnik po fonemach, który dokładniej omawia tę warstwę.
Modelowanie akustyczne
Model akustyczny to neuralny rdzeń systemu: przyjmuje sekwencję fonemów i przewiduje, jak powinna brzmieć mowa.
Warstwa akustyczna ma trzy główne wymiary:
- Barwa: Cechy brzmienia, dzięki którym rozpoznajemy konkretną osobę; czasem nazywane jej „odciskiem głosu”.
- Wysokość: Przebieg tonu w zdaniu, w tym intonacja frazy oraz wzrost tonu w pytaniu i spadek w stwierdzeniu.
- Czas trwania: Jak długo model utrzymuje każdy fonem. Wpływa to na tempo zdania i zapobiega zmianie słowa takiego jak „jump” w „jjjjump”.
Razem elementy te określają prozodię zdania. Neuralne TTS wykorzystuje je, by odczyt był mniej robotyczny. Ucząc się na godzinach prawdziwej mowy, model rozmieszcza pauzy i akcenty podobnie jak człowiek. Uczy się na podstawie kontekstu i danych treningowych, a nie konkretnych reguł wdrożonych przez deweloperów.
Architektury takie jak FastSpeech i Tacotron 2 są podstawą tego etapu. Potrafią zamienić sekwencję fonemów w spektrogram mel. Spektrogram mel to mapa częstotliwości audio w czasie. Opisuje mowę, ale nie jest odtwarzalnym plikiem audio — to cyfrowa reprezentacja dźwięków.
Wokodowanie
Wokoder to ostatnia sieć w klasycznym pipeline. Zamienia opisaną wyżej reprezentację akustyczną w rzeczywistą falę dźwiękową, którą słyszy użytkownik.
Podczas tworzenia i używania wokoderów branża mierzyła się z problemem ich zbyt małej szybkości do zastosowań produkcyjnych. Dopiero rozwiązania takie jak HiFi-GAN, ulepszające wcześniejsze wokodery, np. WaveNet od DeepMind, osiągnęły szybkość wystarczającą do realnych zastosowań.
Neuralne TTS w czasie rzeczywistym stało się możliwe dopiero dzięki innowacjom w tej części pipeline.
Modele end-to-end i oparte na transformerach
Tradycyjne modele TTS przechodzą przez trzy opisane wyżej etapy, aby tworzyć audio z tekstu. Nowsze generacje całkowicie łączą ten pipeline. Model oparty na transformerze, korzystający z tej samej architektury co duże modele językowe, mapuje tekst na audio w jednym procesie end-to-end, zamiast przekazywać predykcje między osobnymi sieciami akustycznymi i wokoderami.
Model pipeline musi przetwarzać zdanie po zdaniu, podczas gdy transformer analizuje cały fragment, zanim zdecyduje na podstawie szerszego kontekstu, jak powinna brzmieć dana kwestia. To samo zdanie może zostać odczytane zupełnie inaczej w komedii niż w dramacie.
Modele ElevenLabs, takie jak Eleven v3, rozumieją te niuanse i obsługują tagi audio w tekście, takie jak [whispers] czy [nervous], dając użytkownikom większą kontrolę nad brzmieniem skryptów.
Neuralna zamiana tekstu na mowę a tradycyjne TTS
Przed upowszechnieniem sieci neuronowych systemy TTS stosowały jedno z dwóch głównych podejść. Oba nadal spotkasz w starszych menu IVR i czytnikach ekranu.
Oto dwa tradycyjne rodzaje TTS:
- TTS konkatenacyjne: Nagrywano aktora głosowego czytającego tysiące zdań, a następnie dzielono nagrania na małe fragmenty. Gdy system miał stworzyć mowę, łączył te fragmenty. Poszczególne słowa mogły brzmieć naturalnie, ale przejścia między nimi tworzyły urywany, robotyczny rytm, który wciąż kojarzy się z głosem generowanym przez komputer.
- TTS parametryczne: Tworzyło audio na podstawie statystycznego modelu parametrów mowy, a nie nagrań. Było mniejsze i bardziej elastyczne niż synteza konkatenacyjna, lecz audio brzmiało przytłumienie i bzyczało, ponieważ uproszczony model pomijał drobne szczegóły prawdziwej mowy.
Neuralne TTS natomiast generuje całą falę dźwiękową na podstawie wyuczonego modelu mowy, eliminując oba te problemy naraz.
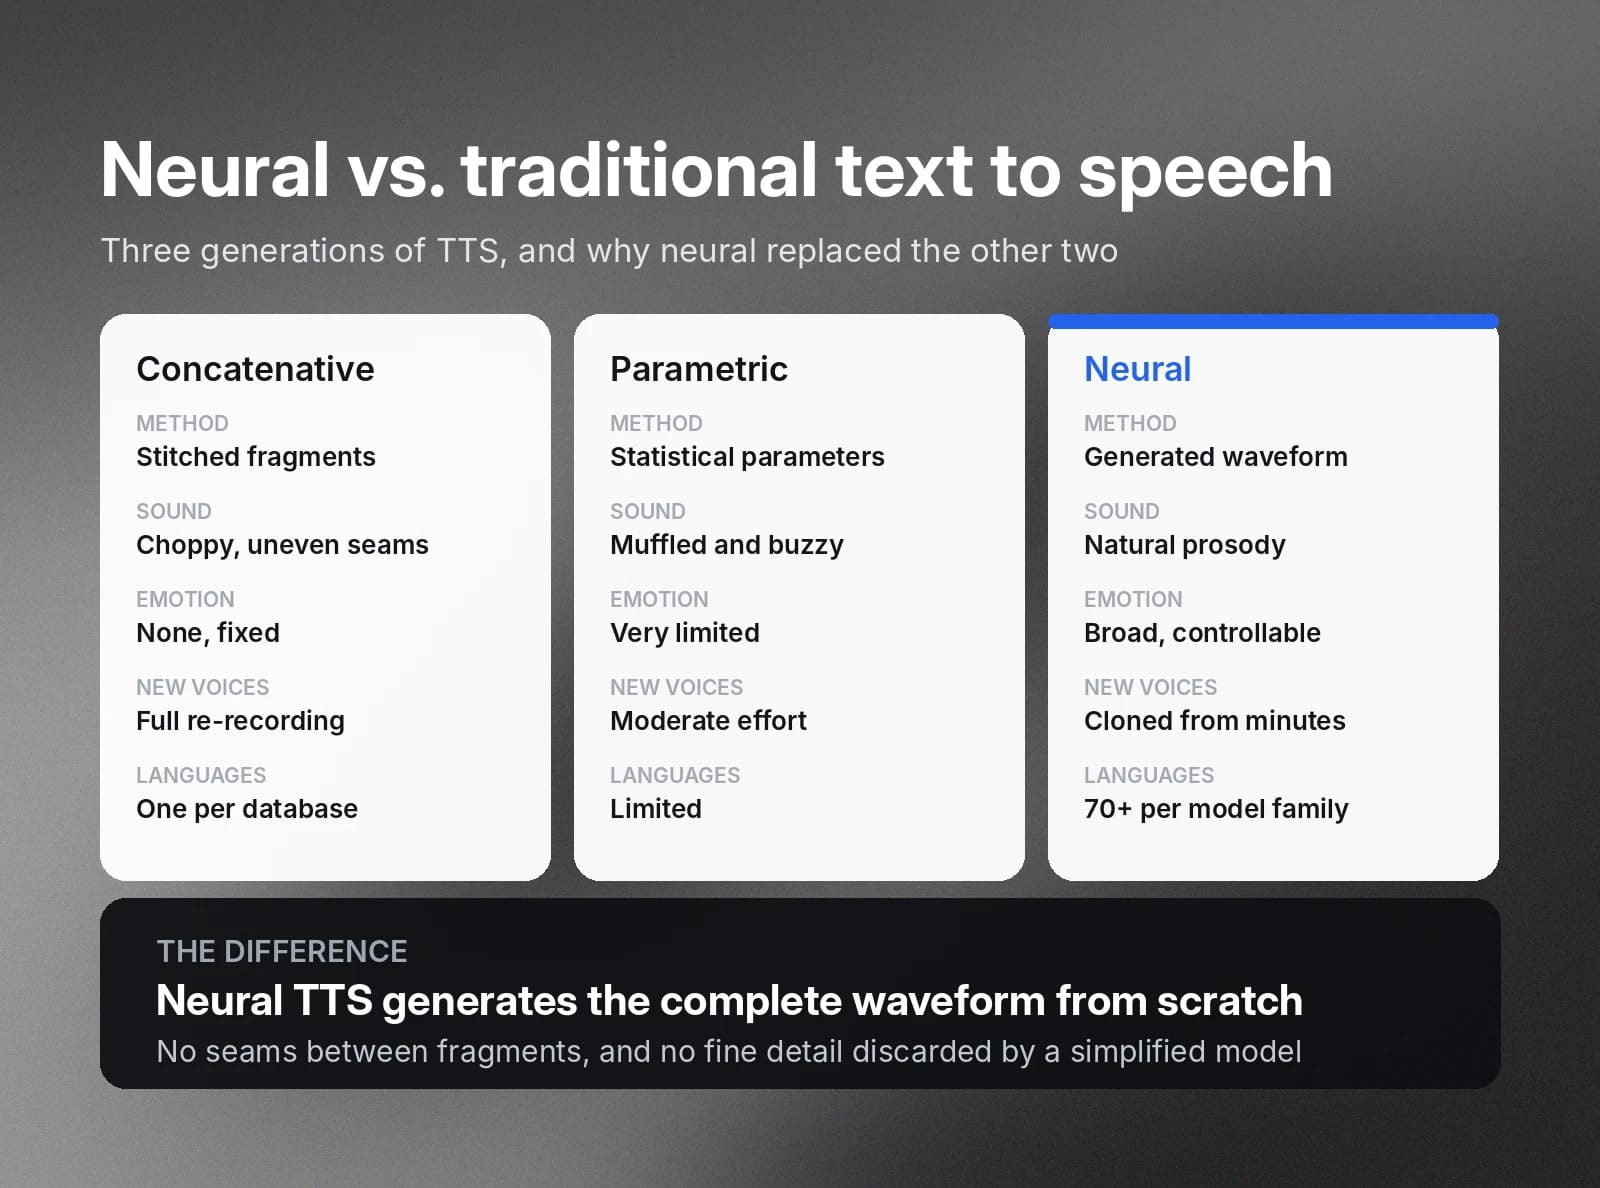
Tak neuralna zamiana tekstu na mowę wypada na tle tradycyjnego TTS.
Kluczowe funkcje i zalety neuralnego TTS
Płynne audio neuralnego TTS, brzmiące jak ludzka mowa, sprawdza się w wielu zastosowaniach. Większa naturalność otwiera też możliwości niedostępne w tradycyjnym TTS.
Oto najważniejsze funkcje i zalety neuralnej zamiany tekstu na mowę:
- Naturalna prozodia: Głosy stosują akcent, pauzy i intonację jak ludzki mówca, dzięki czemu angażują słuchaczy przy dłuższych treściach, zamiast ich męczyć lub frustrować.
- Wyrażanie emocji: Nowoczesne modele tworzą ekspresyjną mowę — od dramatycznych monologów po spokojne odczyty. W Eleven v3 autorzy sterują tym za pomocą tagów audio wpisywanych bezpośrednio w skrypt.
- Klonowanie głosu: Model neuralny uczy się barwy i stylu konkretnego mówcy na podstawie krótkiej próbki. Możesz użyć Voice Cloning — Instant lub Professional — aby zachować spójny głos we wszystkich wdrożeniach TTS.
- Wielojęzyczność: Model neuralny może mówić w dziesiątkach języków, a klon głosu zachowuje swoją tożsamość w każdym z nich. Marka może dzięki temu zadbać, by wybrany głos brzmiał tak samo w Londynie i w Rzymie.
- Szybkość w czasie rzeczywistym: Neuralny model zamiany tekstu na mowę może tworzyć mowę szybciej, niż jest odtwarzana, a opóźnienie streamingu jest wystarczająco niskie do rozmów na żywo.
- Skala: Po wytrenowaniu neuralnego TTS głos może bez trudu przeczytać miliony słów, w tym nowe nazwy i opisy produktów, co znacznie obniża koszty nagrań studyjnych.
Neuralna zamiana tekstu na mowę zmienia działanie TTS pod każdym względem. Otwiera to nowe możliwości w zakresie dostępności, biznesu, zasięgu i wyrażania emocji.
Najważniejsze zastosowania neuralnych rozwiązań TTS
Zmiana podstawowej architektury modelu zamiany tekstu na mowę oraz poprawa szybkości i sposobu wypowiedzi umożliwiają nowe zastosowania.
Oto zastosowania, w których technologia ta daje dziś najwięcej korzyści.
Conversational AI i agenci głosowi
Obsługa klienta, wirtualne recepcje, asystenci telefoniczni i AI SDR — wszystkie te rozwiązania potrzebują głosów, które brzmią wiarygodnie i reagują niemal natychmiast.
Conversational AI to najbardziej wymagające zastosowanie neuralnego TTS, łączące najwyższe oczekiwania wobec jakości z najbardziej rygorystycznymi limitami opóźnień.
Audiobooki i wydawnictwa
Neuralna narracja sprawia, że opłaca się tworzyć wersje audio tytułów z katalogu, które zwykle nie uzasadniałyby kosztów nagrań w studio. Możesz wygenerować cały audiobook w kilka godzin dzięki neuralnemu Text to Speech.
ElevenCreative maksymalnie upraszcza ten proces. Character Casting automatycznie znajduje najlepsze głosy dla postaci i przypisuje ich kwestie w całym manuskrypcie.
Gry i media interaktywne
Dynamiczne dialogi, treści generowane proceduralnie i rozmowy z NPC to ogromne projekty, jeśli nagrywa się je ręcznie w studio. Neuralne TTS pozwala studiom udźwiękowić je na dużą skalę i poprawiać błędy przez edycję tekstu, zamiast opłacać kolejne godziny w studio.
Lokalizacja i dubbing
Neuralne TTS połączone z tłumaczeniem przenosi treści wideo i audio na nowe rynki, zachowując przy tym tożsamość głosu oryginalnego mówcy.
Odbiorcy twórcy w Medellín słyszą ten sam rozpoznawalny głos co odbiorcy w Bostonie, tylko mówiący po hiszpańsku.
Jak zintegrować neuralną zamianę tekstu na mowę z aplikacją
Dla deweloperów neuralne TTS jest dostępne przez jedno wywołanie API.
Oto pełny przykład zamiany tekstu na mowę z użyciem ElevenAPI i SDK dla Pythona.
Ten sam endpoint jest dostępny przez REST oraz SDK dla Pythona, JavaScriptu i innych języków. Większość aplikacji korzysta z jednego z trzech wzorców integracji:
- Synteza wsadowa: Wyślij tekst i odbierz gotowy plik audio. To dobre rozwiązanie dla gotowych treści: artykułów, komunikatów IVR, audiobooków i wideo.
- Streaming HTTP: Fragmenty audio docierają w trakcie generowania, więc odtwarzanie zaczyna się przed końcem syntezy. Użyj go do odczytywania długich dokumentów lub generowania na żądanie treści w stylu podcastu.
- Streaming WebSocket: W przypadku konwersacyjnych agentów stałe połączenie WebSocket przyjmuje tekst stopniowo, na przykład tokeny przesyłane z LLM, i zwraca audio z możliwie najniższym opóźnieniem.
Produkcyjne integracje wymagają też logiki ponawiania prób, limitów czasu żądań i rozsądnej obsługi błędów. Więcej informacji znajdziesz w naszym przewodniku po wzorcach integracji Text to Speech API.
Wybór Text to Speech API: na co zwrócić uwagę
Text to Speech API mogą wydawać się podobne, ale różnią się wieloma funkcjami, które mogą sprawić, że jedno lepiej odpowie na twoje potrzeby niż inne.
To niepełna lista, ale oto czego szukać w TTS API:
- Jakość audio: Przede wszystkim: jeśli audio z neuralnego TTS API nie brzmi dobrze, ten dostawca nie jest dla ciebie. Przeprowadź ślepe testy odsłuchowe, szczególnie dla długich narracji — tam najłatwiej zauważyć niedociągnięcia.
- Opóźnienie: W pipeline i aplikacjach Conversational AI sprawdź czas do pierwszego bajtu. Znaczenie ma też infrastruktura regionalna. Zmniejszyliśmy globalne opóźnienie API nawet o 40%, kierując ruch przez centra danych bliżej użytkowników.
- Obsługa streamingu: Sprawdź, czy streaming HTTP i WebSocket są dostępne oraz opisane w dokumentacji. API obsługujące tylko tryb wsadowy całkowicie wykluczają zastosowania w czasie rzeczywistym.
- Obsługiwane języki i głosy: Szukaj neuralnych API zamiany tekstu na mowę z szeroką obsługą języków, zwłaszcza tych, których regularnie potrzebujesz w aplikacjach.
- Kontrola ekspresji: Szukaj narzędzi, które pozwalają dostosować brzmienie neuralnego TTS w praktyce. Tagi audio ElevenLabs zapewniają precyzyjną kontrolę nad mową.
- Podobieństwo głosu: Jeśli korzystasz z klonowania głosu, sprawdź, jak dobrze model zachowuje styl wypowiedzi i prozodię klonu w dłuższym tekście. W skryptach z większą liczbą znaków jakość może z czasem spadać, przez co głos zacznie brzmieć inaczej niż oryginalna próbka.
- Licencje i etyka: Upewnij się, że masz prawa komercyjne do wyniku, i sprawdź, jak dostawca podchodzi do zgody na użycie głosu, przechowywania danych i zapobiegania nadużyciom. Klienci korporacyjni powinni pytać o zgodność z SOC 2 oraz zewnętrzne certyfikaty zabezpieczeń AI, takie jak AIUC-1 i ISO 42001.
- Dokumentacja i doświadczenie dewelopera: Godzina przeglądania dokumentacji dla deweloperów powie ci wszystko o możliwościach produktu. Zaufaj dokumentacji i poradom inżynierów, a nie hasłom sprzedażowym.
- Model cenowy: Wiele API pobiera opłaty za znak lub kredyt. Oszacuj miesięczny wolumen i porównaj plany dla tej liczby, zamiast kierować się ceną wejściową.
Zacznij korzystać z ElevenAPI i twórz wysokiej jakości neuralne TTS
ElevenAPI daje deweloperom bezpośredni dostęp do modeli neuralnego Text to Speech od ElevenLabs — w ponad 70 językach i z tysiącami głosów. Oferujemy streaming HTTP, obsługę WebSocket i niskie opóźnienia stworzone z myślą o rozmowach w czasie rzeczywistym.
Otwórz stronę produktu Text to Speech API, aby posłuchać modeli, lub zarejestruj się i utwórz darmowy klucz API, aby zacząć.



