
Integracja Text to Speech API: streaming, batch, ponawianie
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Integracja z API Text to Speech jest prosta… po podjęciu kilku konkretnych decyzji: którego trybu przesyłania użyć, jak wybrać model i format wyjściowy, jak streamować, jak obsłużyć duży wolumen bez przekraczania limitu współbieżności, jak korzystać z pamięci podręcznej i ponawiać żądania, by nigdy nie płacić dwa razy za wygenerowanie tego samego audio, oraz jak porównać czas do pierwszego bajtu z innym dostawcą.
Aby ułatwić ci integrację z API Text to Speech, omawiamy każdą z tych decyzji architektonicznych i podpowiadamy, co zrobić. Ten przewodnik pomoże ci zintegrować API Text to Speech ElevenLabs i skalować rozwiązanie dzięki fragmentom kodu, które możesz wkleić do środowiska produkcyjnego.
Aby lepiej poznać omówione tu zagadnienia, zobacz nasze przewodniki o streamingu audio, optymalizacji opóźnień oraz przeglądzie modeli ElevenLabs.
Podsumowanie
- Istnieje jeden endpoint API Text to Speech ElevenLabs, dostępny na trzy sposoby: konwersja wsadowa, streaming HTTP i WebSocket stream-input.
- W HTTP każde trwające żądanie wlicza się do limitu współbieżności, a w WebSocket liczy się tylko aktywne generowanie.
- Ustaw równoległość nieco poniżej limitu planu i zapisuj hash każdego parametru wpływającego na wynik, aby nigdy nie naliczać opłaty za ten sam tekst dwa razy.
- Ponawiaj żądania 429 i 5xx z wykładniczym backoffem i pełnym jitterem, aby zwolnić przed osiągnięciem limitu współbieżności.
Trzy sposoby integracji z API Text to Speech
Endpoint Text to Speech jest jeden, ale sposób integracji wpływa na opóźnienia, złożoność i koszt.
To samo wywołanie POST /v1/text-to-speech/{voice_id} działa w trzech wariantach, z których każdy sprawdza się w nieco innych zastosowaniach. Oto trzy sposoby integracji z API Text to Speech:
- Batch (convert) to najprostsza integracja: wysyłasz jedno żądanie i otrzymujesz jedną odpowiedź audio. To opcja o najmniejszej złożoności i najdłuższym czasie do pierwszego audio, ponieważ cały klip jest syntezowany, zanim wrócą jakiekolwiek bajty.
- Streaming HTTP (stream) zachowuje to samo żądanie, ale dzieli odpowiedź na fragmenty: dodajesz /stream do ścieżki, wywołujesz metodę stream, a audio wraca jako odpowiedź fragmentowana. Kod jest niemal identyczny, a odczuwalne opóźnienie jest dużo mniejsze.
- WebSocket (stream-input) utrzymuje stałe połączenie: wysyłasz tekst stopniowo i na bieżąco otrzymujesz fragmenty audio. To rozwiązanie dla interaktywnych agentów i przekazywania odpowiedzi LLM do syntezy mowy podczas generowania tokenów, jeszcze przed końcem zdania.
Streaming nie przyspiesza generowania audio przez model; czas inferencji się nie zmienia. Zmienia się moment otrzymania pierwszego fragmentu: jest wysyłany przed zakończeniem całego klipu, więc użytkownik czeka krócej, choć całkowita praca pozostaje taka sama.
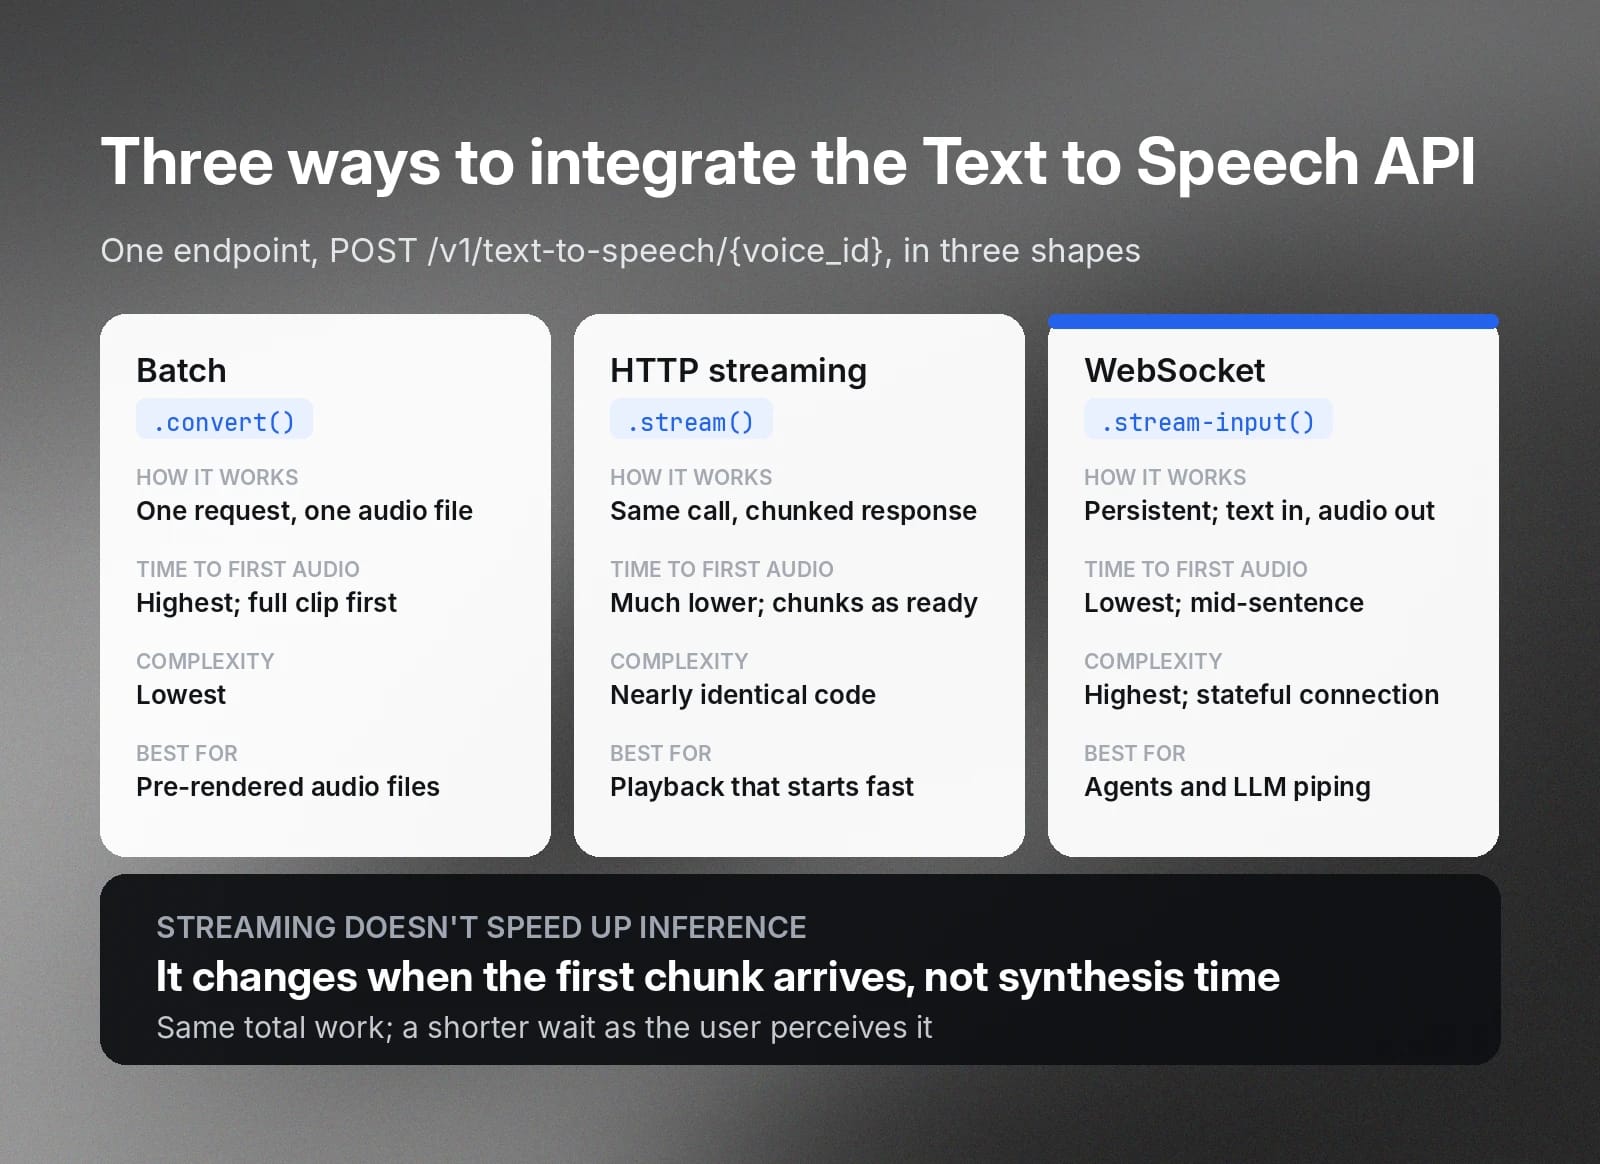
Tabela wyboru: batch, streaming czy WebSocket
Wybierając między tymi trzema metodami, warto uwzględnić kilka czynników.
W skrócie: wybierz batch do generowania offline, streaming HTTP dla znanego tekstu, na który czeka użytkownik, a WebSocket dla agentów i przesyłania odpowiedzi LLM do mowy na żywo.
Tabela poniżej pokazuje kompromisy w wymiarach istotnych przy skalowaniu.
W HTTP, niezależnie od tego, czy używasz batch, czy streamingu, każde trwające żądanie wlicza się do limitu współbieżności planu przez cały czas trwania. W WebSocket liczy się tylko czas, gdy model aktywnie generuje audio; otwarte, ale bezczynne gniazdo prawie nic nie kosztuje.
W przypadku kaskadowego agenta głosowego, który utrzymuje połączenie przez całą rozmowę, ale generuje audio tylko podczas wypowiedzi agenta, różnica jest znacząca. To główny powód, by przy budowie agentów używać WebSocketów. Pełny protokół opisujemy w przewodniku po WebSocket Text to Speech w czasie rzeczywistym.
Wybór modelu i formatu wyjściowego
Audio otrzymywane z integracji API TTS zależy od dwóch decyzji. Pierwsza to model, który określa jakość i szybkość. Druga to format wyjściowy, który określa kontener, bitrate i częstotliwość próbkowania.
Dobry wybór obu od początku sprawi, że dalsze elementy, takie jak opóźnienie i zgodność z telefonią, ułożą się właściwie.
Modele
Udostępniamy kilka modeli Text to Speech. Nie są uszeregowane od najlepszego do najgorszego — każdy oferuje inne kompromisy.
Warto pamiętać, że ~75 ms oznacza inferencję modelu w reprezentatywnych warunkach, bez opóźnień sieci i aplikacji. Czas rośnie przy dłuższych danych wejściowych i pod obciążeniem. Zawsze mierz z poziomu swojej aplikacji, a nie na podstawie wyniku benchmarku.
Modele Flash są mniejsze i stosują bardziej agresywne przybliżenia, aby skrócić czas inferencji. Eleven v4 i Multilingual v2 są większe i poświęcają więcej czasu na znak, by tworzyć bogatsze wyniki.
Do zastosowań w czasie rzeczywistym lub agentów użyj eleven_flash_v2_5 — to wielojęzyczna opcja o najniższym opóźnieniu. Do narracji, audiobooków lub marketingowego nałożonego głosu użyj eleven_multilingual_v2, jeśli zależy ci na stabilnej, wysokiej jakości, lub eleven_v4, jeśli potrzebujesz maksymalnej ekspresji i zakresu emocji.
Gdy wymowa ma znaczenie, na przykład w przypadku numerów telefonów, dat lub walut, normalizuj liczby samodzielnie w aplikacji, zanim tekst dotrze do API. Zapisz słownie formę, którą model ma wypowiedzieć.
Własna normalizacja zapewnia przewidywalną wymowę w różnych modelach i pozwala uniknąć zależności od domyślnych ustawień modelu, które mogą się zmieniać.
Format wyjściowy
Parametr output_format określa kontener, częstotliwość próbkowania i bitrate zwracanego audio. Najczęściej używane wartości:
Ustawienia głosu
Te ustawienia określają sposób generowania mowy:
- Stability: określa równowagę między spójnością a ekspresją. Niższe wartości dają bardziej zróżnicowaną, ekspresyjną mowę, a wyższe — stabilniejsze i bardziej przewidywalne brzmienie.
- SimilarityBoost: określa, jak ściśle wynik odwzorowuje głos referencyjny.
- Style: po zwiększeniu uwydatnia naturalny styl mówienia głosu.
- useSpeakerBoost: zwiększa podobieństwo do oryginalnego mówcy kosztem niewielkiego wzrostu opóźnienia.
- Speed: dostosowuje tempo względem domyślnej wartości 1.0.
Spośród tych ustawień Stability zwykle najbardziej wpływa na postrzeganą jakość. Niższe wartości dają bardziej ekspresyjny, ale mniej spójny wynik, a wyższe stawiają na spójność i przewidywalność.
Wybierając głos, najniższe opóźnienie uzyskasz, łącząc Flash z Instant Voice Clone albo głosem domyślnym; Professional Voice Clones brzmią świetnie, ale zwiększają narzut każdego generowania, co warto uwzględnić.
W całym przewodniku przykładowy identyfikator głosu to JBFqnCBsd6RMkjVDRZzb (George).
Integracja streamingu (HTTP i WebSocket)
W tej sekcji omawiamy praktyczne podstawy integracji z API Text to Speech: instalację SDK, otwieranie strumienia i odbieranie przychodzącego audio. Ścieżka HTTP obsługuje większość odtwarzania w internecie i aplikacjach, a WebSocket — agentów i odpowiedzi LLM na żywo.
Obie te ścieżki zakładają, że masz zainicjalizowanego klienta ElevenLabs, jak poniżej.
Ścieżka streamingu otwiera strumień i odbiera fragmenty, gdy nadejdą. voiceId jest pierwszym argumentem pozycyjnym, a następnie przekazujesz obiekt opcji z kluczami camelCase (modelId, outputFormat, voiceSettings):
W wariancie WebSocket połącz się z wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input, wyślij pierwszą wiadomość z ustawieniami głosu i początkową spacją, następnie wysyłaj wiadomości tekstowe, gdy staną się dostępne, i odczytuj ramki JSON, których pole audio zawiera fragmenty zakodowane w base64.
Batching i limity współbieżności dla wysokiej przepustowości
Integracją o wysokiej przepustowości rządzi współbieżność, czyli liczba żądań generujących audio w tym samym momencie. Każdy plan ma limit dla danej rodziny modeli.
Każdy plan obejmuje inny limit współbieżności:
- Free: 4 równoczesne żądania Flash.
- Starter: 6 równoczesnych żądań Flash.
- Creator: 10 równoczesnych żądań Flash.
- Pro: 20 równoczesnych żądań Flash.
- Scale i Business: 30 równoczesnych żądań Flash; limity Enterprise są ustalane indywidualnie.
Limity Multilingual v2 wynoszą około połowy powyższych wartości.
Ograniczona pula łagodzi ten problem, limitując liczbę jednocześnie uruchomionych żądań:
Ustaw MAX_CONCURRENCY nieco poniżej limitu planu, a nie dokładnie na nim. Ten zapas obsłuży inny ruch korzystający z tego samego klucza i utrzyma cię poniżej progu zwracającego 429.
Limity znaków i dzielenie długiego tekstu
Każdy model ogranicza liczbę znaków przyjmowanych w jednym żądaniu. Każda integracja dla długich treści musi dzielić tekst i łączyć audio z powrotem.
Oto limity znaków na żądanie dla każdego modelu:
- Flash v2.5: przyjmuje do 40 000 znaków na żądanie.
- Flash v2: przyjmuje do 30 000 znaków na żądanie.
- Multilingual v2: przyjmuje do 10 000 znaków na żądanie.
- Eleven v3: przyjmuje do 5 000 znaków na żądanie.
- Eleven v4: przyjmuje do 10 000 znaków na żądanie.
Dłuższy tekst musisz podzielić na kilka żądań. Staraj się dzielić go na granicach zdań, aby zachować prozodię na łączeniach fragmentów.
Generuj fragmenty w kolejności i połącz audio. W przypadku długiej narracji, w której każdy fragment jest niezależny, oba elementy współpracują bezpośrednio: przekaż wynik splitText do ograniczonej puli powyżej i pozwól jej obsłużyć resztę.
Pamięć podręczna i idempotencja
Wynik Text to Speech jest na tyle deterministyczny, że ponowne generowanie tego samego tekstu tym samym głosem, modelem i ustawieniami jest marnotrawstwem. Zapisuj wynik w pamięci podręcznej pod hashem danych wejściowych wpływających na audio; ten sam klucz służy też jako token idempotencji przy ponownych próbach.
Tak zrobisz jedno i drugie.
Zasada jest taka, że klucz musi zawierać każdy parametr zmieniający audio, w tym outputFormat i ustawienia głosu. Jeśli zrobisz to poprawnie, ten sam klucz będzie też tokenem idempotencji. Gdy klient ponowi żądanie, które już się powiodło, zwracasz zapisane bajty zamiast generować je ponownie.
Obsługa błędów i limity szybkości (429)
Klient produkcyjny potrzebuje ponawiania żądań z backoffem i jitterem oraz obsługi zależnej od kodu statusu, bo niektóre błędy warto ponawiać, a innych nie.
Tabela poniżej przypisuje właściwe działanie do każdego statusu i wyjaśnia, dlaczego 429 to miękki limit, a nie twarda ściana.
Kod 429 nie jest twardą ścianą — warto znać ten mechanizm. Gdy przekroczysz limit współbieżności, żądania są najpierw kolejkowane według priorytetu, co zwykle dodaje około 50 ms. Dopiero gdy nadal przekraczasz dostępną pojemność, otrzymujesz 429.
Odpowiedź zawiera też nagłówki current-concurrent-requests i maximum-concurrent-requests, które pokazują bieżący zapas. Możesz je odczytać i zwolnić, zanim osiągniesz limit.
Jeśli potrzebujesz większego zapasu, a nie lepszego ponawiania żądań, zmień plan na wyższy. Klienci Enterprise mogą poprosić o wyższe limity przez opiekuna konta.
Benchmarking opóźnienia i czasu do pierwszego bajtu
Opóźnienie zależy od regionu, danych wejściowych i aktualnego obciążenia, więc jedyną wiarygodną wartością jest ta zmierzona we własnym środowisku.
Ta sekcja pokazuje czas do pierwszego bajtu (TTFB) dla endpointu streamingu Flash. Jej struktura pozwala skierować ten sam test do innego dostawcy i porównać wyniki w identycznych warunkach.
Traktuj to jako metodologię, nie opublikowany wynik. Pojedynczy przebieg niczego nie gwarantuje.
Oto kilka zastrzeżeń ważnych przy benchmarkowaniu opóźnienia integracji z API Text to Speech:
- Uwzględnij czas podróży pakietu w obie strony: TTFB zależy od twojej lokalizacji i najbliższego klastra dostawcy, więc uruchom test tam, gdzie zwykle działają twoje serwery.
- Odrzuć przebieg rozgrzewkowy: pierwsze żądanie na nieaktywnym połączeniu jest wolniejsze i może zniekształcić wyniki.
- Zachowaj stałe dane wejściowe: długość tekstu, głos, model i obciążenie wpływają na wynik, więc zachowaj je identyczne u wszystkich dostawców.
- Raportuj rozkład: wyniki różnią się między przebiegami, więc podaj medianę i p95 zamiast jednej wartości.
Po uwzględnieniu tych kwestii możesz rozpocząć benchmark.
Aby porównać innego dostawcę, napisz funkcję o tej samej strukturze. Następnie uruchom obie funkcje w prostym runnerze, który odrzuci jedno wywołanie rozgrzewkowe, pobierze około 20 próbek czasowych w odstępach, aby nie nakładały się na siebie, i poda medianę oraz p95 w milisekundach.
Uczciwe porównanie wymaga kontrolowania zmiennych.
Uruchom test obu dostawców z tej samej maszyny i sieci — najlepiej serwera w regionie, do którego faktycznie wdrażasz rozwiązanie, a nie laptopa na domowym łączu. Użyj tego samego tekstu i zachowaj krótkie audio, aby wynik zależał głównie od inferencji modelu, a nie długości generowania. Raportuj medianę i p95 z wielu przebiegów, bo pojedynczy pomiar to szum.
Pamiętaj, że TTFB przez publiczny internet obejmuje 20–200 ms czasu podróży pakietu w obie strony, co nie ma związku z modelem. Obsługujemy klastry w Ameryce Północnej, Europie i Azji Południowo-Wschodniej oraz kierujemy ruch do najbliższego z nich, więc odpowiednio umieść klienta testowego — inaczej będziesz głównie mierzyć odległość do centrum danych.
Najważniejsze wskazówki dotyczące integracji z API Text to Speech
Produkcyjna integracja z API Text to Speech sprowadza się do kilku ważnych decyzji.
Jeśli podejmiesz je właściwie, reszta ułoży się sama:
- Dobierz model do zadania: używaj Flash v2.5 do wszystkiego, co interaktywne, a modelu o wyższej jakości, takiego jak Multilingual v2 lub Eleven v4 do generowania offline, gdzie opóźnienie ma mniejsze znaczenie.
- Streamuj, gdy użytkownik czeka: używaj streamingu HTTP dla znanego tekstu, a WebSocket dla agentów, aby czas bezczynności nie obciążał limitu współbieżności.
- Ogranicz równoległość do limitu planu: ogranicz liczbę równoczesnych żądań do wartości nieco niższej niż limit planu i zapisuj hash każdego parametru wpływającego na wynik, aby nigdy nie naliczać opłaty za to samo audio dwa razy.
- Ponawiaj 429 i 5xx z wykładniczym backoffem oraz pełnym jitterem: zwalniaj przy 429 i 5xx, stosując pełny jitter, oraz obserwuj nagłówki współbieżności, by wiedzieć, jak blisko limitu jesteś.
- Dziel długi tekst na granicach zdań: dziel tekst na granicach zdań, w limicie znaków danego modelu, aby prozodia przetrwała łączenia.
Jeśli chcesz wejść jeszcze głębiej w temat, zobacz instrukcję streamingu, opis koncepcji streamingu audio, uwierzytelnianie oraz tokeny jednorazowe do użycia po stronie klienta.
Zbuduj integrację Text to Speech z ElevenAPI
Po przeczytaniu tego przewodnika znasz wszystkie wzorce potrzebne do produkcyjnej integracji z API Text to Speech. Streaming, batching, cache, ponawianie żądań, a nawet benchmarki — możesz wdrożyć to w praktyce.
Zacznij od poznania API Text to Speech lub załóż konto, aby jeszcze dziś wykonać pierwsze wywołanie z ElevenAPI.
FAQ: integracja z API Text to Speech

Tadas Petra to Developer Relations Engineer, który pomaga deweloperom korzystać z produktów ElevenLabs. Jest też założycielem Hungrimind, platformy edukacyjnej dla deweloperów. Wcześniej był Lead Developer Advocate w Agora i instruktorem w Zero To Mastery.



