
Zbuduj agenta głosowego w 20 minut z ElevenLabs i Twilio
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Agent głosowy może odbierać połączenia przychodzące, transkrybować rozmówców w czasie rzeczywistym za pomocą zamiany mowy na tekst (STT), generować odpowiedź za pomocą dużego modelu językowego (LLM) i odpowiadać głosem dzięki modułowi zamiany tekstu na mowę (TTS). Z ElevenLabs i Twilio możesz uruchomić działającego agenta pod prawdziwym numerem telefonu w około 20 minut.
Dla deweloperów pełny stos obejmuje ElevenLabs do syntezy mowy (Flash v2.5) i transkrypcji (Scribe v2 Realtime), Twilio do telefonii oraz OpenAI lub Anthropic jako LLM. Każdy z tych elementów można jednak wymienić, więc możesz wybrać komponenty, które znasz najlepiej.
Ten artykuł pokazuje, jak zbudować agenta głosowego w 20 minut, używając Node.js i Typescript. Jeśli wolisz zarządzaną alternatywę, która obsługuje zmianę tur, przerwania i telefonię bez samodzielnego utrzymywania całego łańcucha, przejdź do ElevenAgents.
Jak działa architektura agenta głosowego
Zanim napiszesz kod, warto zrozumieć, jak łączą się trzy usługi w twoim stosie technologicznym.
- Twilio: Obsługuje połączenie telefoniczne i przesyłanie audio.
- ElevenLabs: Obsługuje STT przez Scribe v2 Realtime i TTS przez Flash v2.5.
- LLM: Obsługuje wywoływanie narzędzi i tworzenie odpowiedzi.
Każdy etap to prosty adapter, dlatego możesz zastąpić go inną usługą bez zmiany reszty. Na przykład możesz zamienić LLM OpenAI na Anthropic bez przepisywania pozostałych komponentów.
Połączenie telefoniczne dociera do twojego serwera przez Twilio. Twilio odbiera połączenie PSTN, otwiera WebSocket do twojego serwera i przekazuje audio rozmówcy jako strumień ramek mu-law zakodowanych w base64. Twój serwer uruchamia ten łańcuch i przesyła zsyntetyzowane audio z powrotem przez ten sam WebSocket, a Twilio odtwarza je rozmówcy.
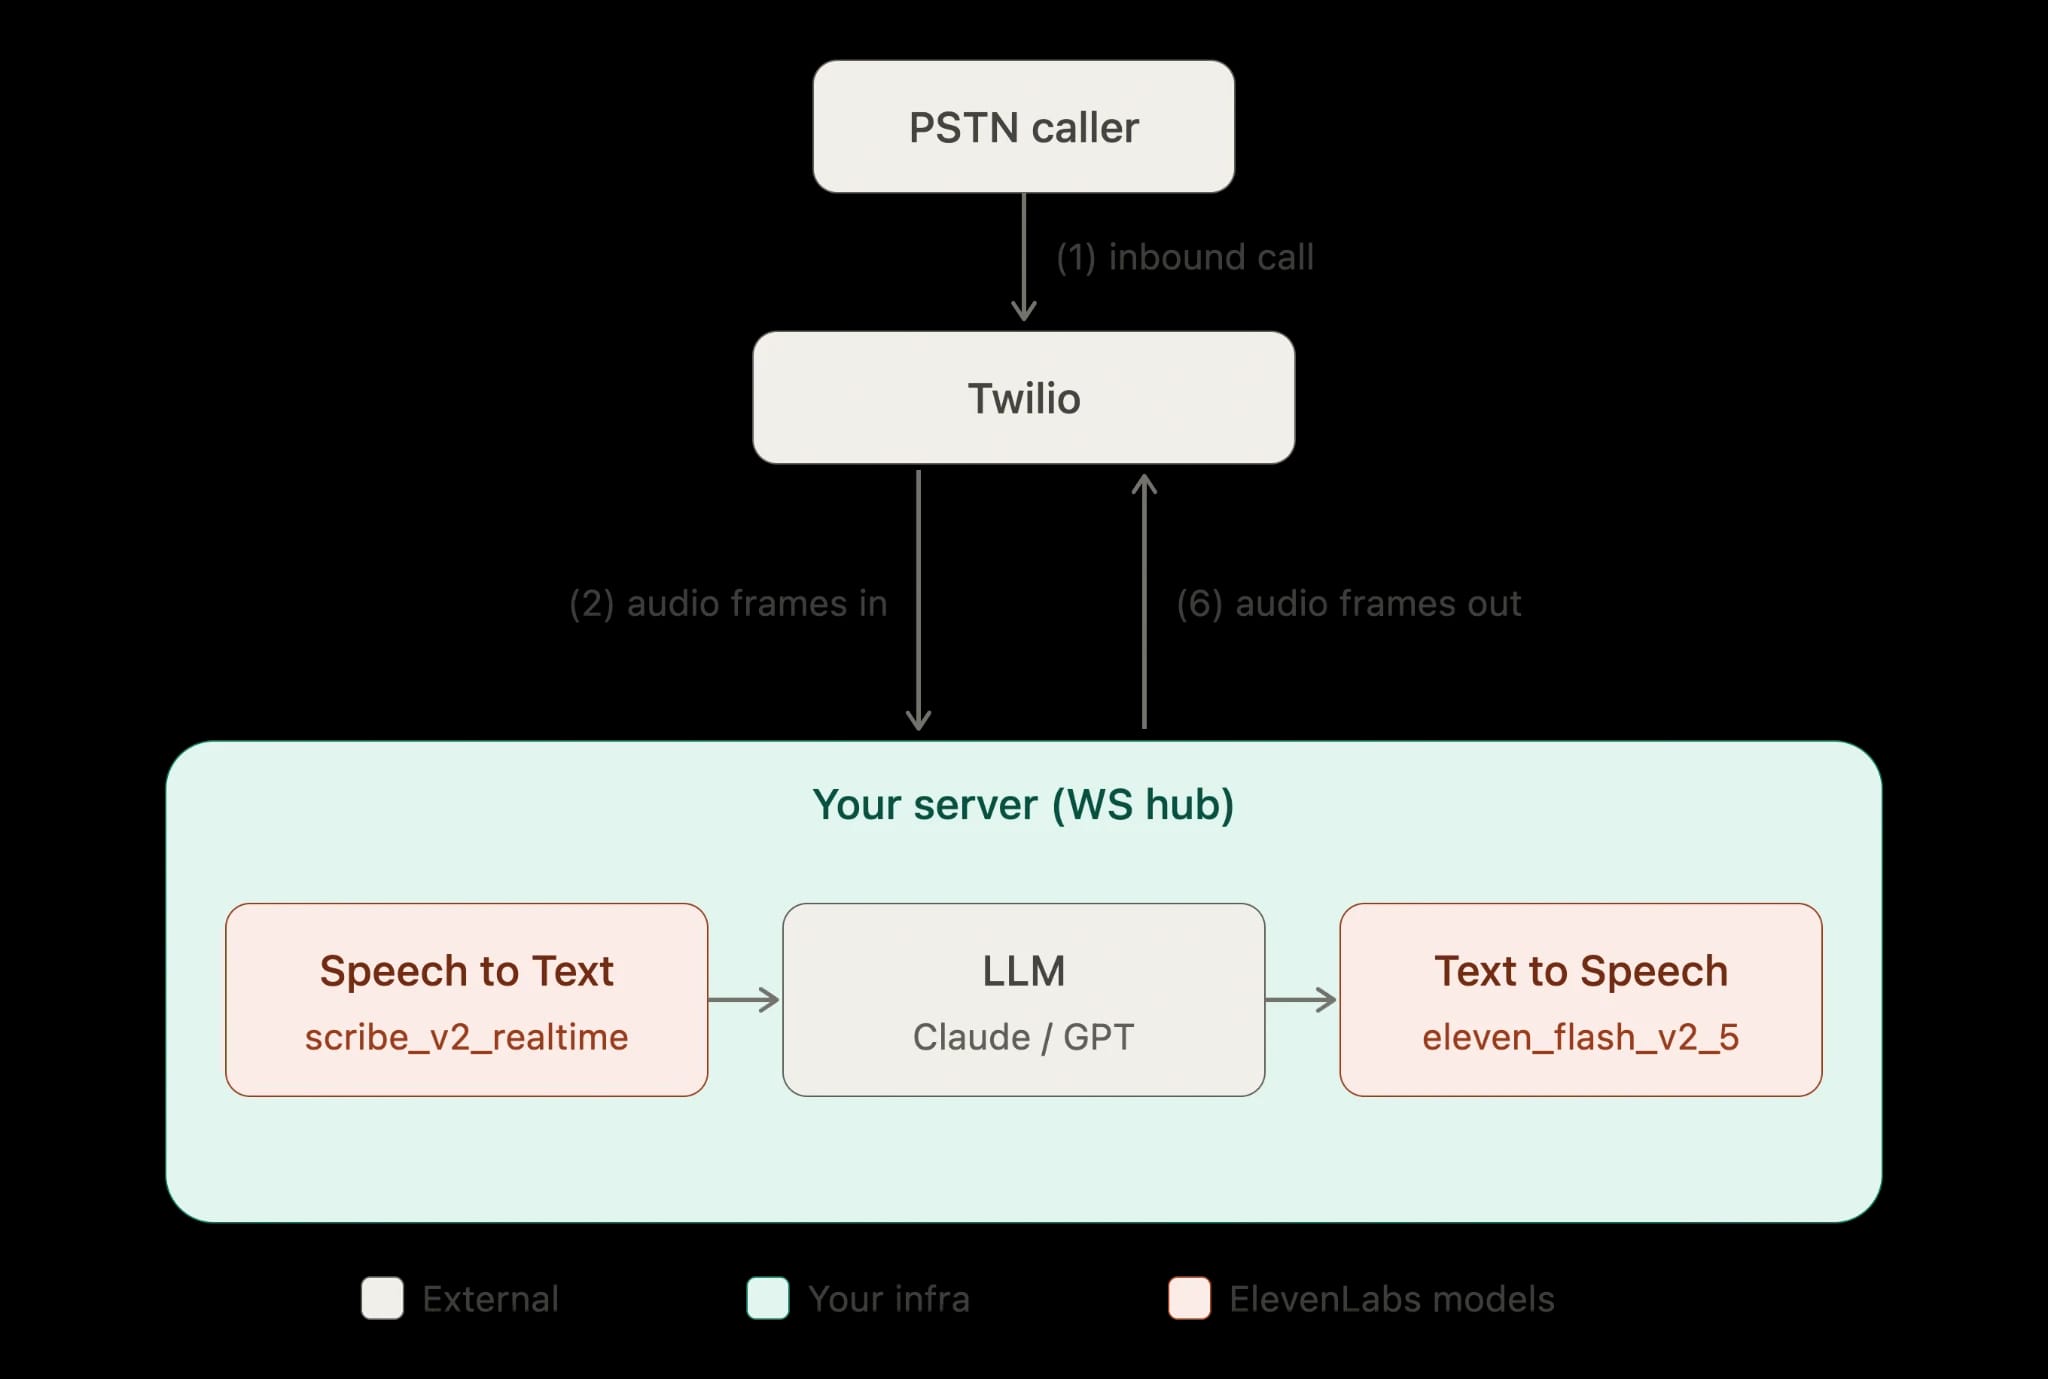
Tak wygląda przepływ, którego użyjesz do zbudowania agenta głosowego:
Rozmówca wybiera twój numer Twilio. Twilio pobiera dokument TwiML z twojego webhooka. TwiML poleca Twilio otworzyć Media Stream do endpointu WebSocket. Twilio przesyła przychodzące audio jako zdarzenia JSON zawierające dane mu-law (ulaw_8000) zakodowane w base64.
Twój serwer przekazuje fragmenty audio do Scribe v2 Realtime do transkrypcji strumieniowej. Gdy tura rozmówcy zostanie zakończona, wysyłasz transkrypcję do LLM, a następnie syntezujesz odpowiedź za pomocą Flash v2.5 w formacie ulaw_8000. Zsyntetyzowane ramki mu-law kodujesz w base64 i wysyłasz z powrotem do Twilio przez WebSocket, a Twilio odtwarza je rozmówcy.
Scribe v2 Realtime generuje częściowe transkrypcje z opóźnieniem około 150 ms, a czas inferencji modelu Flash v2.5 wynosi około 75 ms, bez opóźnień sieci i aplikacji. LLM ma największy i najmniej przewidywalny wpływ na czas do pierwszego audio — to on pochłania większość budżetu opóźnień. Aby skrócić przerwę, przesyłamy wynik LLM token po tokenie i zaczynamy syntezę, zanim model skończy zdanie.
Więcej o kompromisach stojących za tymi wyborami znajdziesz w przeglądzie modeli oraz artykule jak rozumieć opóźnienia.
Czego potrzebujesz przed rozpoczęciem budowy agenta głosowego
Ten poradnik zakłada, że masz przygotowane cztery rzeczy. Każdą skonfigurujesz szybko, ale brak którejkolwiek uniemożliwi uruchomienie serwera.
Sprawdź te wymagania wstępne:
- Numer telefonu Twilio z obsługą Voice: Zapisz numer oraz Account SID i Auth Token z konsoli Twilio.
- Klucz API ElevenLabs: utwórz go w panelu ElevenLabs. Klucz jest przesyłany w nagłówku xi-api-key i jest tajny, więc przechowuj go wyłącznie po stronie serwera. Zobacz uwierzytelnianie API.
- Klucz API LLM: Ten poradnik traktuje Anthropic Claude i OpenAI jako wymienne backendy, więc wybierz jeden z nich.
- Ngrok (lub inny tunel) do lokalnego developmentu: Twilio musi połączyć się z twoim serwerem przez publiczny URL HTTPS i WSS, a ngrok zapewnia to bez wdrażania aplikacji.
Ustaw sekrety jako zmienne środowiskowe i nigdy nie zapisuj ich w repozytorium.
Następnie uruchom tunel wskazujący port, którego użyje serwer:
Jak działa protokół Twilio Media Streams
Twilio nie udostępnia surowego gniazda audio. Zamiast tego opakowuje wszystko w uporządkowany protokół JSON przez WebSocket. Gdy zrozumiesz cztery typy zdarzeń i format wysyłania, handler WebSocket z kroku 2 będzie jasny, zanim go napiszesz.
Gdy Twilio połączy się z twoim WebSocketem, wyśle sekwencję tekstowych komunikatów JSON, które mogą mieć cztery typy zdarzeń.
Zdarzenie connected przychodzi jako pierwsze i potwierdza działanie WebSocketu. Zdarzenie start jest wysyłane raz, gdy zaczyna się strumień multimediów. Zawiera streamSid, który musisz zapisać, aby wysyłać audio z powrotem, oraz metadane połączenia w start.customParameters i start.callSid.
Zdarzenie media powtarza się: media.payload to zakodowany w base64 fragment audio mu-law 8 kHz, po 20 ms na ramkę, a media.track ma wartość inbound dla audio rozmówcy. Na końcu wysyłane jest stop, gdy strumień się kończy, zwykle po rozłączeniu rozmowy.
Aby odtworzyć audio, wysyłasz komunikat typu media z tym samym streamSid i danymi mu-law w base64. Aby przerwać audio, które już dodałeś do kolejki, wysyłasz komunikat clear ze streamSid, co czyści bufor wyjściowy Twilio.
Kodowanie wejściowe i wyjściowe jest identyczne (ulaw_8000). Żądamy ulaw_8000 od ElevenLabs Text to Speech i przekazujemy bajty prosto do Twilio, bez ponownego próbkowania po drodze.
Krok 1: Udostępnij webhook TwiML
Gdy nadchodzi połączenie, Twilio wysyła żądanie HTTP do twojego webhooka, a ty odpowiadasz TwiML, który łączy rozmowę z Media Stream. Czasownik <Connect><Stream> otwiera dwukierunkowy WebSocket. Użyj tutaj <Connect>, a nie <Start>: utrzymuje połączenie przez czas trwania strumienia i pozwala wysyłać audio z powrotem, co jest celem tej konfiguracji.
Webhook zwraca taki TwiML:
W Express wystarczy jeden handler POST, który uzupełnia host i zwraca dokument:
W konsoli Twilio ustaw webhook „A call comes in” numeru na https://your-subdomain.ngrok.app/incoming-call przy użyciu HTTP POST.
Krok 2: Odbierz WebSocket Media Stream
Handler WebSocket odczytuje zdarzenia Twilio, obsługuje łańcuch i odsyła audio.
Przechowujemy niewielki stan dla każdego połączenia: streamSid, połączenie STT oraz flagę określającą, czy agent aktualnie mówi. Handler dekoduje każdą przychodzącą ramkę media z base64 i przekazuje surowe bajty mu-law do STT:
Krok 3: Transkrybuj za pomocą Scribe v2 Realtime
Scribe v2 Realtime przyjmuje strumieniowe fragmenty audio i zwraca częściowe oraz końcowe transkrypcje. Obsługuje też bezpośrednio kodowanie mu-law, więc przekazujemy mu ramki Twilio bez zmian.
Oferuje też wykrywanie aktywności głosowej do segmentacji na podstawie ciszy oraz ręczne zatwierdzanie do finalizacji segmentu. Dla agenta telefonicznego segmentacja oparta na VAD jest zwykle najlepszym wyborem, ponieważ naturalna pauza to najbardziej wiarygodny sygnał zakończenia tury rozmówcy.
Kroki są proste: otwórz strumień STT na początku połączenia. Przekaż każdy przychodzący fragment mu-law. Reaguj na sfinalizowane transkrypcje, wywołując LLM.
Interfejs klienta STT w czasie rzeczywistym wciąż się rozwija, dlatego poniższy kształt ukryto za niewielkim adapterem TypeScript (openRealtimeStt), który implementujesz względem aktualnego API, a nie niezmiennego zestawu nazw pól. Traktuj onFinal jako hook przekazujący zakończoną turę rozmówcy do kolejnego etapu.
Opóźnienie rozpoznawania w czasie rzeczywistym dla częściowych wyników wynosi około 150 ms, dzięki czemu przerwa między zakończeniem wypowiedzi rozmówcy a rozpoczęciem odpowiedzi agenta jest krótka. Informacje o odpowiedniku wsadowym i pełnym zestawie funkcji znajdziesz w dokumentacji Speech to Text oraz na stronie produktu Speech to Text w czasie rzeczywistym.
Krok 4: Wygeneruj odpowiedź za pomocą LLM
Na tym etapie powstaje odpowiedź. LLM pobiera historię rozmowy i zwraca tekst asystenta. Strumieniuj odpowiedź, aby rozpocząć syntezę już przy pierwszym zdaniu.
Tutaj używamy OpenAI:
Powyższy identyfikator modelu, gpt-4.1-mini, to przykład wyboru o niskim opóźnieniu; porównywalną opcją po stronie Anthropic jest claude-haiku-4-5. Każdy dostawca może obsługiwać ten sam kontrakt llmReply — wystarczy zamienić treść funkcji, a reszta agenta pozostanie bez zmian.
Prompt systemowy ogranicza długość odpowiedzi, co ma znaczenie w rozmowie telefonicznej: długie odpowiedzi wydają się powolne i trudno naturalnie je przerwać.
Krok 5: Syntezuj z Flash TTS w ulaw_8000
Tekst musi teraz stać się audio, które Twilio może odtworzyć. Poproś Flash v2.5 o outputFormat: „ulaw_8000”, aby bajty pasowały do oczekiwanego przez Twilio kodowania, a następnie strumieniuj audio i przekazuj każdy fragment z powrotem przez WebSocket jako zdarzenie media.
Łącz tokeny LLM w fragmenty wielkości zdania i syntezuj każdy, gdy tylko będzie gotowy, zamiast czekać na całą odpowiedź. Skraca to czas do pierwszego audio, ponieważ rozmówca słyszy pierwsze zdanie, gdy model nadal tworzy drugie. Aby precyzyjniej sterować syntezą przyrostową, przewodnik po WebSocket TTS w czasie rzeczywistym pokazuje, jak przekazywać tekst do jednego otwartego gniazda syntezy; poniższe podejście HTTP ze strumieniowaniem jest prostsze i wystarczające dla krótkich tur rozmowy.
Przygotowanie agenta głosowego AI do produkcji
Po wykonaniu pięciu kroków masz działającego agenta. To nie to samo co wdrożenie produkcyjne.
Zanim podłączysz agenta do prawdziwej linii telefonicznej, musisz pamiętać o kilku kwestiach.
Waliduj podpisy webhooków Twilio
Każdy, kto pozna URL twojego webhooka, może wysłać do niego żądanie POST, więc najpierw potwierdź, że żądanie faktycznie pochodzi od Twilio. Twilio podpisuje każde żądanie twoim Auth Tokenem w nagłówku X-Twilio-Signature, a ty odrzucasz wszystko, co nie przejdzie walidacji. Podpis jest obliczany na podstawie pełnego URL i parametrów POST, więc musisz obliczyć go tak samo jak Twilio.
Helper Twilio zrobi to za ciebie:
Prawidłowo zarządzaj sekretami
Przechowuj ELEVENLABS_API_KEY, klucz LLM i TWILIO_AUTH_TOKEN w menedżerze sekretów, a nie w kodzie źródłowym ani w plikach env z jawnym tekstem zapisanych w repozytorium. Ogranicz klucz ElevenLabs do endpointów potrzebnych tej usłudze i ustaw limit kredytów, aby wyciek miał ograniczony zasięg.
Plany Enterprise pozwalają dodatkowo ograniczyć klucz do konkretnych zakresów IP za pomocą listy dozwolonych adresów IP. Ten serwer używa klucza API bezpośrednio, bo nigdy nie opuszcza on backendu; gdyby logika audio trafiła do przeglądarki lub klienta mobilnego, użyłbyś tokenów jednorazowych, aby klucz nigdy nie był ujawniony po stronie klienta.
Zrozum limit współbieżności
Każdy plan ma limit współbieżności, różny dla każdej rodziny modeli. Limit określa liczbę żądań, które aktywnie generują audio w tym samym czasie.
W przypadku agenta telefonicznego działa to na twoją korzyść. Generowanie audio jest szybsze niż odtwarzanie, więc każde połączenie zużywa współbieżność TTS tylko w krótkich oknach syntezy odpowiedzi, a nie przez całą rozmowę. Orientacyjnie limit współbieżności na poziomie pięciu może obsłużyć około 100 jednoczesnych rozmów, ponieważ generowanie kończy się na długo przed odtwarzaniem.
Mimo to monitoruj zapas zamiast zgadywać. Odpowiedzi ElevenLabs zawierają nagłówki current-concurrent-requests i maximum-concurrent-requests; zapisuj je w logach i ustaw alert, gdy zbliżasz się do maksimum. Po przekroczeniu limitu żądania trafiają do kolejki według priorytetu, co zwykle dodaje około 50 ms, a długotrwałe przeciążenie zwraca HTTP 429.
Obsługuj odpowiedzi HTTP 429 krótkim backoffem. Jeśli problem się utrzymuje, zwiększ limity, przechodząc na wyższy plan na stronie cenowej lub — w przypadku klientów Enterprise — przez opiekuna konta.
Obsługuj wtrącenia i przerwania
Rozmówca, który zaczyna mówić, gdy agent odpowiada, oczekuje, że agent się zatrzyma. To wtrącenie i jego właściwa obsługa w dużej mierze sprawia, że agent brzmi naturalnie, a nie jak według skryptu.
Wykrywaj mowę rozmówcy podczas odtwarzania odpowiedzi agenta za pomocą sygnału STT VAD. Gdy ją wykryjesz, zrób dwie rzeczy. Po pierwsze, przestań przekazywać fragmenty TTS — flaga agentSpeaking w speak już to obsługuje, przerywając pętlę. Po drugie, wyślij do Twilio komunikat clear, aby wyczyścić audio, które jest już w kolejce po jego stronie.
Jeśli pominiesz clear, Twilio będzie dalej odtwarzać zbuforowane audio po zatrzymaniu wysyłania, więc agent będzie sprawiał wrażenie, że mówi jednocześnie z rozmówcą.
Loguj, monitoruj i obsługuj błędy z wdziękiem
Dodaj metryki do każdego etapu, aby ustalić źródło opóźnienia, gdy rozmowa wydaje się powolna. Mierz czas od końcowej transkrypcji do pierwszego tokenu LLM, od pierwszego tokenu LLM do pierwszego bajtu TTS oraz od pierwszego bajtu TTS do ramki wysłanej do Twilio. Większość zmiennego opóźnienia występuje na etapie LLM; etapy STT i TTS są względnie stabilne.
Zaplanuj też częściowe awarie. LLM może przekroczyć limit czasu, strumień STT może się rozłączyć, a czas rundy sieciowej do ElevenLabs przez publiczny internet waha się zależnie od lokalizacji od około 20 do 200 ms. Umieść serwer blisko rozmówców, nie tylko blisko ElevenLabs, ponieważ ElevenLabs już kieruje ruch do najbliższego klastra w Ameryce Północnej, Europie lub Azji Południowo-Wschodniej.
Gdy etap zawiedzie, nie zostawiaj rozmówcy w ciszy: syntezuj krótką komunikat zastępczy („Przepraszam, możesz powtórzyć?”) i utrzymaj połączenie. Otocz każdy etap limitem czasu i try/catch, aby jedna nieudana tura nie zamknęła całego WebSocketu.
Przed wdrożeniem warto ustawić jeszcze kilka domyślnych wartości:
- Ogranicz długość odpowiedzi w prompcie systemowym, jak pokazano wyżej, aby tury były krótkie i łatwe do przerwania.
- Ogranicz historię rozmowy, aby przy długich połączeniach kontekst LLM nie rósł bez końca.
- Ustaw maksymalny czas połączenia jako zabezpieczenie przed zawieszonymi sesjami, które po cichu zużywają współbieżność.
Aby dalej optymalizować elementy, nad którymi masz kontrolę, dokument o opóźnieniach wyjaśnia, skąd bierze się czas do pierwszego audio, przegląd modeli omawia kompromisy między szybkością a jakością, a przewodnik po WebSocket TTS w czasie rzeczywistym pokazuje, jak zmniejszyć opóźnienie syntezy dzięki przyrostowemu wprowadzaniu tekstu.
Twórz gotowych na produkcję agentów głosowych z ElevenAPI
Po 20 minutach masz już wszystkie warstwy produkcyjnego agenta głosowego. Twilio obsługuje telefonię, Scribe v2 Realtime transkrybuje, LLM generuje odpowiedzi, a Flash v2.5 odpowiada głosem przez ten sam WebSocket.
Jeśli nie chcesz samodzielnie utrzymywać tego łańcucha, ElevenAgents oferuje zarządzaną obsługę zmian tur, przerwań i integrację telefonii, opartą na tych samych modelach, które przed chwilą połączyłeś ręcznie.
Aby dalej optymalizować stos, którym zarządzasz, sprawdź stronę produktu ElevenAPI z planami, limitami współbieżności i biblioteką głosów. Możesz też zarejestrować się i zacząć już dziś od pierwszego połączenia.
FAQ: budowanie agenta głosowego z Twilio i ElevenLabs

Tadas Petra to Developer Relations Engineer, który pomaga deweloperom korzystać z produktów ElevenLabs. Jest też założycielem Hungrimind, platformy edukacyjnej dla deweloperów. Wcześniej był Lead Developer Advocate w Agora i instruktorem w Zero To Mastery.




