Tworzenie Vibe Draw: połączenie ElevenLabs i FLUX Kontext do tworzenia obrazów głosem
- Autor
- Ryan Morrison
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Interfejsy głosowe zmieniają sposób, w jaki komunikujemy się z AI. A gdyby tworzenie obrazu było tak proste jak opisanie go na głos?
To właśnie ta idea skłoniła mnie do stworzenia Vibe Draw jako projektu na weekend. To narzędzie kreatywne oparte na głosie, które łączy Voice AI ElevenLabs z FLUX Kontext od Black Forest Labs, by zamieniać wypowiedziane prompty w obrazy.
FLUX Kontext to nowa klasa modeli do obrazów. W odróżnieniu od tradycyjnych systemów zamiany tekstu na obraz, Kontext obsługuje zarówno generowanie, jak i edycję. Może tworzyć nowe obrazy na podstawie promptów, modyfikować istniejące, a nawet łączyć wiele obrazów referencyjnych w jeden wynik.
Modele takie jak GPT-4o i Gemini 2 Flash oferują funkcje multimodalne, ale FLUX Kontext powstał z myślą o wysokiej jakości manipulacji obrazem. W testach mogłem zmieniać pojedyncze litery w stylizowanym tekście lub przesuwać obiekt — wystarczyło opisać zmianę.
Wtedy pomyślałem: „Czemu nie zrobić tego głosem?”. A czy jest lepsza podstawa niż zaawansowana technologia głosowa ElevenLabs?

Wyzwanie techniczne
Stworzenie systemu obrazów sterowanego głosem wymagało rozwiązania pięciu kluczowych problemów:
- Rozumienie języka naturalnego — Rozróżnianie tworzenia nowych obrazów i edycji
- Świadomość kontekstu — Zachowanie ciągłości między interakcjami
- Zarządzanie dźwiękiem — Unikanie nakładających się odpowiedzi i zarządzanie kolejką
- Generowanie obrazu — Płynne przejścia między generowaniem a edycją
- Doświadczenie użytkownika — Intuicyjne korzystanie z zaawansowanych interakcji z AI
Przegląd architektury
Vibe Draw działa całkowicie po stronie klienta i korzysta z następujących elementów:
- Web Speech API do rozpoznawania mowy
- ElevenLabs TTS API do odpowiedzi głosowych
- FLUX Kontext API do generowania i edytowania obrazów
- Własne wykrywanie intencji do rozumienia danych od użytkownika
Takie podejście pozwala zachować lekkość prototypu, ale w wersji produkcyjnej dla bezpieczeństwa warto kierować żądania przez serwer.
Wykorzystanie głosu z ElevenLabs
Vibe Draw używa API zamiany tekstu na mowę ElevenLabs, dostrojonego pod szybką rozmowę:
Aby dodać różnorodność, odpowiedzi głosowe są losowo wybierane z gotowych szablonów:
Zarządzanie odtwarzaniem dźwięku
Nakładające się odpowiedzi głosowe psują wrażenie rozmowy. Vibe Draw rozwiązuje ten problem systemem kolejki audio:
Każda wiadomość jest odtwarzana do końca, zanim uruchomi się kolejna.
Wykrywanie intencji i zarządzanie kontekstem
System używa wykrywania słów kluczowych i kontekstu, aby ustalić, czy prompt użytkownika dotyczy nowego obrazu, czy edycji:
To podejście sprawia, że edycje są stosowane tylko wtedy, gdy istnieje już obraz i wynika to jasno z kontekstu.
Generowanie obrazów z FLUX Kontext
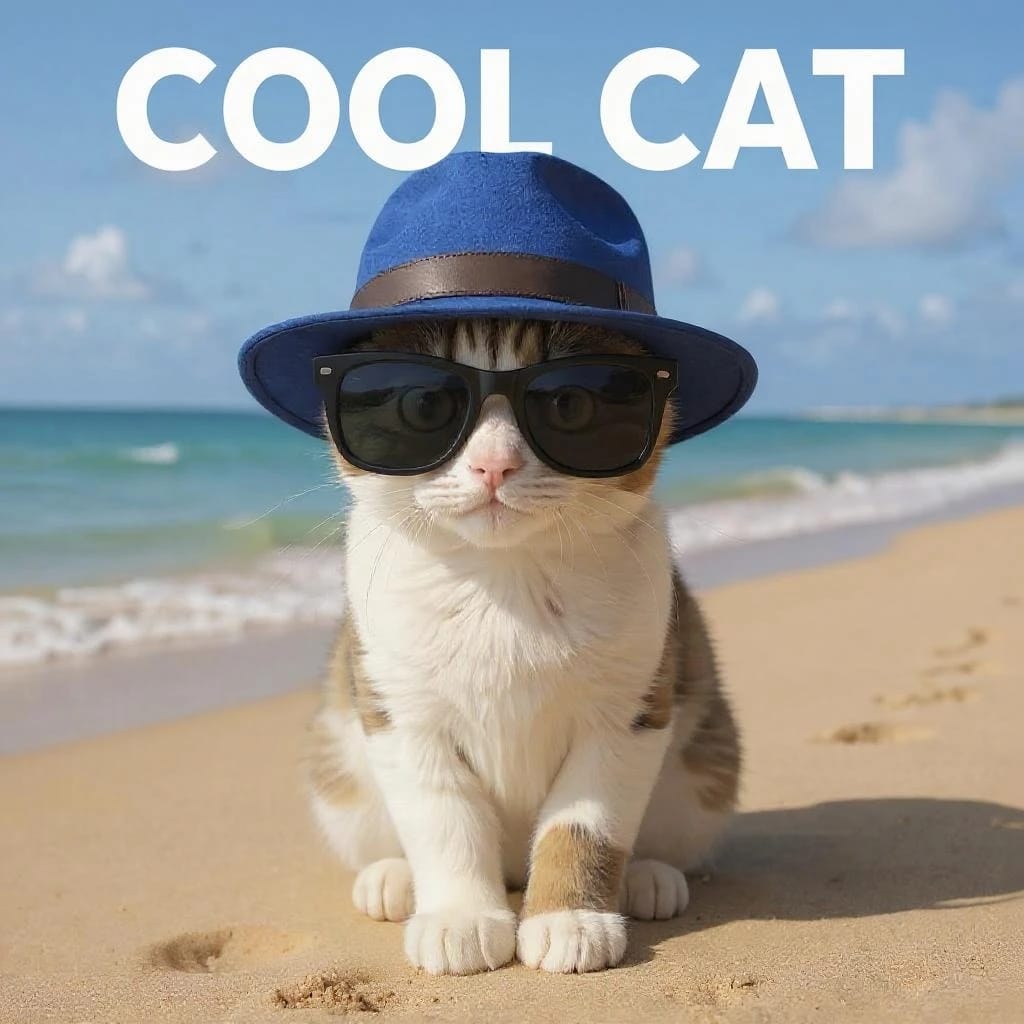
Kontext obsługuje dwa tryby: generowanie i edycję.
Generowanie (tekst na obraz)
Edycja (transformacja kontekstowa)
Obsługa złożonych transformacji
Niektóre prompty sugerują zmiany wykraczające poza limity API edycji. Gdy system je wykryje, oferuje rozwiązanie alternatywne:
Optymalizacja działania
Stopniowe informacje zwrotne
Informacje zwrotne w UI pomagają użytkownikom śledzić stan systemu:
Inteligentne wyczucie czasu
Naturalna rozmowa wymaga naturalnego tempa:
Stan sesji
Aby zachować kontekst, dane sesji są przechowywane:
Wydajność
Aby zapewnić szybką reakcję:
- Leniwe ładowanie — Inicjuj API tylko wtedy, gdy jest potrzebne
- Debouncing — Ogranicz liczbę żądań API na interakcję
- Obsługa błędów — Sprawnie reaguj na przekroczenia czasu i błędy
- Czyszczenie zasobów — Prawidłowo usuwaj obiekty audio i nasłuchiwacze zdarzeń
Co dalej
Konwersacyjne UI otwierają drogę do nowych możliwości:
- Wejście multimodalne — „Niech wygląda bardziej jak to zdjęcie.”
- Sesje współpracy — Wielu użytkowników pracuje nad jednym projektem
- Pamięć stylu — System z czasem uczy się twojej estetyki
- Streaming w czasie rzeczywistym — Przesyłaj aktualizacje obrazu, gdy użytkownik mówi, i zintegruj Conversational AI z przesyłaniem mowy strumieniowo.
Najważniejsze wnioski
Tworzenie Vibe Draw ujawniło kilka kluczowych zasad dla narzędzi opartych na głosie:
- Kontekst jest kluczowy — Śledzenie stanu sprawia, że interakcje są spójne
- Tempo nadaje charakter — Odpowiednie tempo odpowiedzi sprawia, że AI wydaje się responsywna
- Alternatywy utrzymują tempo — Gdy generowanie zawiedzie, zaproponuj inne rozwiązanie
- Różnorodność utrzymuje świeżość — Powtarzanie tej samej frazy psuje immersję
Podsumowanie
Vibe Draw pokazuje, co się dzieje, gdy konwersacyjne AI głosowe spotyka wizualną kreatywność. Naturalna synteza mowy ElevenLabs i API obrazów FLUX Kontext tworzą nowy sposób tworzenia — bez kliknięć, bez suwaków, tylko głosem.
Gdy tworzenie jest tak proste jak opisywanie, usuwamy bariery między wyobraźnią a realizacją.
Wypróbuj samodzielnie
Pełny kod źródłowy jest dostępny na GitHubie. Aby uruchomić własną wersję:
- Sklonuj repozytorium
- Dodaj swój klucz API ElevenLabs
- Dodaj swój klucz API FAL.ai
- Otwórz vibe-draw-v2.html w nowoczesnej przeglądarce
- Kliknij mikrofon i zacznij tworzyć
Chcesz stworzyć własne rozwiązanie oparte na głosie? Poznaj ElevenLabs Conversational AI lub skontaktuj się z nami.
Ryan dołączył do ElevenLabs po ponad dwóch dekadach pracy w mediach i wydawnictwach, w tym w BBC i Future Plc. Skupia się na strategii treści i opowiadaniu historii, pomagając ElevenLabs kształtować i dzielić się swoją narracją.