Podsumowanie webinaru: Jak tworzyć bezpieczne AI Agents do wdrożeń w firmie
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Podsumowanie webinaru: jak tworzyć bezpiecznych agentów AI do wdrożeń w firmach
Stworzenie agenta AI, który prowadzi rozmowy, jest proste. Trudniej zdobyć zaufanie zespołów ds. bezpieczeństwa i prawnych oraz klientów — na tym etapie zatrzymuje się większość wdrożeń w firmach.
W tym artykule podsumowujemy nasz webinar na żywo: Jak tworzyć bezpiecznych agentów AI do wdrożeń w firmach, podczas którego omówiliśmy narzędzia, frameworki i praktyki wdrożeniowe, dzięki którym agenci sprawdzają się na dużą skalę.
Jak stworzyć wielowarstwowe podejście do bezpieczeństwa
Na platformie ElevenAgents wdrożono już ponad cztery miliony agentów. Te, które działają niezawodnie w firmach, łączy jedno: zabezpieczenia uwzględniono od początku, a nie dopiero po pierwszym incydencie.
Podczas webinaru omówiliśmy frameworki, mechanizmy kontroli i praktyki wdrożeniowe, które odróżniają agentów przechodzących weryfikację bezpieczeństwa od tych, które jej nie przechodzą.
Różni agenci potrzebują zupełnie innych granic.
- Postać w grze wideo może potrzebować dosadnego, brutalnego języka jako elementu doświadczenia — ale nie powinna nigdy wychodzić z roli ani ujawniać, że jest AI.
- Recepcjonista w placówce medycznej musi rozmawiać o urazach i kwestiach zdrowotnych — ale nie może udzielać porad medycznych.
- Agent wsparcia dla kart kredytowych nie powinien w ogóle poruszać treści dla dorosłych ani udostępniać danych konta niezweryfikowanym osobom dzwoniącym.
Ponieważ agenci są niedeterministyczni, żadne pojedyncze zabezpieczenie nie ochroni w pełni przed wszystkimi możliwymi zagrożeniami. Dlatego zespoły w firmach potrzebują podejścia wielowarstwowego — wielu mechanizmów kontroli, które wspólnie sprawiają, że problemy z bezpieczeństwem zdarzają się bardzo rzadko.
Ta zasada wyznaczyła cztery pytania, wokół których zbudowaliśmy webinar:
- Jak kontrolować to, co mówi i robi mój agent?
- Jak sprawdzić, czy działa?
- Jak chronić dane, aby spełnić wymogi bezpieczeństwa i zgodności?
- Jak stworzyć procesy umożliwiające bezpieczne wdrażanie?
Jak kontrolować zachowanie agenta
W każdej rozmowie z agentem są trzy punkty, w których trzeba uwzględnić bezpieczeństwo.
Dane wejściowe
Użytkownik coś mówi. Wrodzy użytkownicy mogą próbować na przykład „zignoruj wszystkie wcześniejsze instrukcje” albo „udawaj, że jesteś innym asystentem”. Musisz wykrywać i obsługiwać próby manipulacji, zanim dotrą do modelu. Zapobiega to niepotrzebnym kosztom i blokuje wyciąganie informacji, do których nie powinno być dostępu.
Podejmowanie decyzji
LLM decyduje, co powiedzieć lub zrobić. Głównym narzędziem kontroli jest tu system prompt — ale w długich lub złożonych rozmowach LLM może odchodzić od instrukcji. Potrzebujesz mechanizmów, które wzmacniają właściwe zachowanie przez całą rozmowę, nie tylko na jej początku. Warto też określić ścieżki eskalacji: kiedy agent powinien przekazać sprawę człowiekowi lub bardziej wyspecjalizowanemu agentowi i na jakich warunkach?
Dane wyjściowe
Nawet przy jasnych wytycznych coś może umknąć — zwłaszcza w długich rozmowach. Potrzebujesz ostatniej warstwy ochrony. To jak miniagent sprawdzający pracę głównego agenta: ocenia odpowiedź, zanim trafi do użytkownika, i decyduje, czy ją wysłać, spróbować ponownie, czy eskalować sprawę. Działa też równolegle z generowaniem odpowiedzi, więc dodaje minimalne opóźnienie.
Na wszystkich trzech etapach trzeba z wyprzedzeniem określić strategię wyjścia: czy naruszenie kończy rozmowę, uruchamia ponowną próbę z instrukcjami korygującymi, czy przekazuje sprawę człowiekowi? Ta decyzja wpływa na doświadczenie użytkownika, gdy coś pójdzie nie tak.
Demo 1: konfiguracja guardraili w ElevenAgents
Scenariusz: Agent sprzedaży i wsparcia na stronie internetowej został skonfigurowany z wieloma warstwami zabezpieczeń, aby zapobiegać manipulacji, odpowiedziom nie na temat i naruszeniom zasad.
Co pokazaliśmy:
- Guardrail manipulacji (dane wejściowe) — znajdujący się na karcie Security przełącznik wykrywa wzorce prompt injection — próby nadpisania instrukcji systemowych — i kończy rozmowę, zanim agent odpowie. Zalecany dla wszystkich agentów produkcyjnych.
- System prompt i guardrail Focus (podejmowanie decyzji) — system prompt to podstawa. Każda ważna zasada powinna być w nim jasno zapisana. W demo dodaliśmy w trakcie sesji instrukcję: „Nie oferuj żadnych rabatów”. Włączony osobno guardrail Focus automatycznie wzmacnia system prompt przez całą rozmowę, rozwiązując problem odchodzenia od instrukcji w dłuższych interakcjach. Połączenie dobrego system promptu z włączonym Focus to najskuteczniejszy sposób, by agent trzymał się właściwego kierunku.
- Guardrail treści (dane wyjściowe) — wstępnie skonfigurowane kategorie obejmują wulgaryzmy, porady prawne i opinie polityczne. Każda ma regulowany próg pewności — zalecamy zacząć od średniego. To warstwa awaryjna: jeśli agent ma wygenerować coś, czego nie powinien, zatrzyma to przed wysłaniem.
- Własny guardrail (dane wyjściowe) — zdefiniowane przez użytkownika kontrole w języku naturalnym dla przypadków, których nie obejmują ustawienia wstępne. W demo skonfigurowaliśmy guardrail „bez rabatów”: „Zablokuj każdą odpowiedź wspominającą o rabatach, promocjach lub cenach specjalnych, których agent nie ma prawa oferować”. Własne guardraile korzystają z dodatkowej oceny LLM — wiąże się to z kosztem zależnym od użycia i opóźnieniem. Pisz krótkie instrukcje i dziel różne kontrole na osobne guardraile, zamiast je łączyć.
- Działanie po naruszeniu — dwie opcje: zakończenie rozmowy albo ponowna próba. Przy ponownej próbie możesz dodać instrukcje, które poprowadzą kolejną odpowiedź agenta — na przykład przekazanie sprawy człowiekowi lub domyślny komunikat przekierowujący.
Dlaczego to ważne: Te mechanizmy kontroli nie są uniwersalne. Możesz je konfigurować dla każdego guardraila z osobna. Ta szczegółowość odróżnia agenta, który jest bezpieczny w teorii, od agenta bezpiecznego w praktyce w różnych kontekstach firmowych.
Demo 2: testy symulacyjne przed uruchomieniem
Scenariusz: Agent wsparcia jest testowany w dwóch scenariuszach rozmów o rabatach, aby potwierdzić, że kieruje użytkowników na stronę z cenami, nie oferując rabatów.
Co pokazaliśmy:
- Dwa testy symulacyjne zdefiniowane na karcie Tests — każdy z symulowanym scenariuszem użytkownika, określoną liczbą tur rozmowy i jasnymi kryteriami sukcesu
- Jeden test początkowo nie przeszedł, ponieważ w system prompcie brakowało instrukcji dotyczących konkretnego przypadku brzegowego
- Brakujące instrukcje dodano do sekcji guardraili w system prompcie
- Agenta opublikowano ponownie i uruchomiono oba testy jeszcze raz — oba zakończyły się powodzeniem
- Szczegółowa historia uruchomienia pokazuje dokładnie, która część rozmowy nie przeszła testu, w tym wywołania narzędzi i działania agenta
Dlaczego to ważne: Testy symulacyjne pozwalają zespołom sprawdzać zachowanie agenta w kontrolowanym środowisku, zanim zobaczy go prawdziwy użytkownik. Obejmują zarówno rutynowe, jak i wrogie scenariusze. Testują też cały przebieg rozmowy, a nie tylko pojedyncze odpowiedzi. Po każdej zmianie możesz od razu uruchomić testy ponownie, by potwierdzić, że poprawka działa.
Demo 3: redakcja PII we wrażliwych wdrożeniach
Scenariusz: Agent firmowy jest skonfigurowany tak, aby usuwać dane umożliwiające identyfikację osoby z logów rozmów.
Co pokazaliśmy:
- Przełącznik Conversation History Redaction na karcie Advanced, w ustawieniach Privacy
- Lista konkretnych typów danych, które można osobno włączać do redakcji, w tym data urodzenia, wiek i inne pola wrażliwe
- Możliwość wybrania wszystkich typów danych albo tylko tych istotnych dla danego zastosowania agenta
Dlaczego to ważne: Redakcja PII nie zastępuje trybu zero retention w środowiskach o wysokich wymogach zgodności, takich jak HIPAA. Ogranicza jednak ekspozycję danych w logach rozmów używanych do wewnętrznej analizy lub kontroli jakości. Zespoły mogą zachować potrzebne logi, usuwając z nich dane, których nie potrzebują. Funkcja jest obecnie dostępna dla klientów enterprise.
Dobre praktyki bezpiecznego wdrażania agentów w firmach
- Stosuj podejście wielowarstwowe. Żaden pojedynczy mechanizm kontroli nie zapewni bezpiecznego działania. Guardraile danych wejściowych, walidacja danych wyjściowych, wzmacnianie promptów i testy muszą działać razem. Każda warstwa wzmacnia pozostałe, a wspólnie znacząco ograniczają ryzyko problemów z bezpieczeństwem.
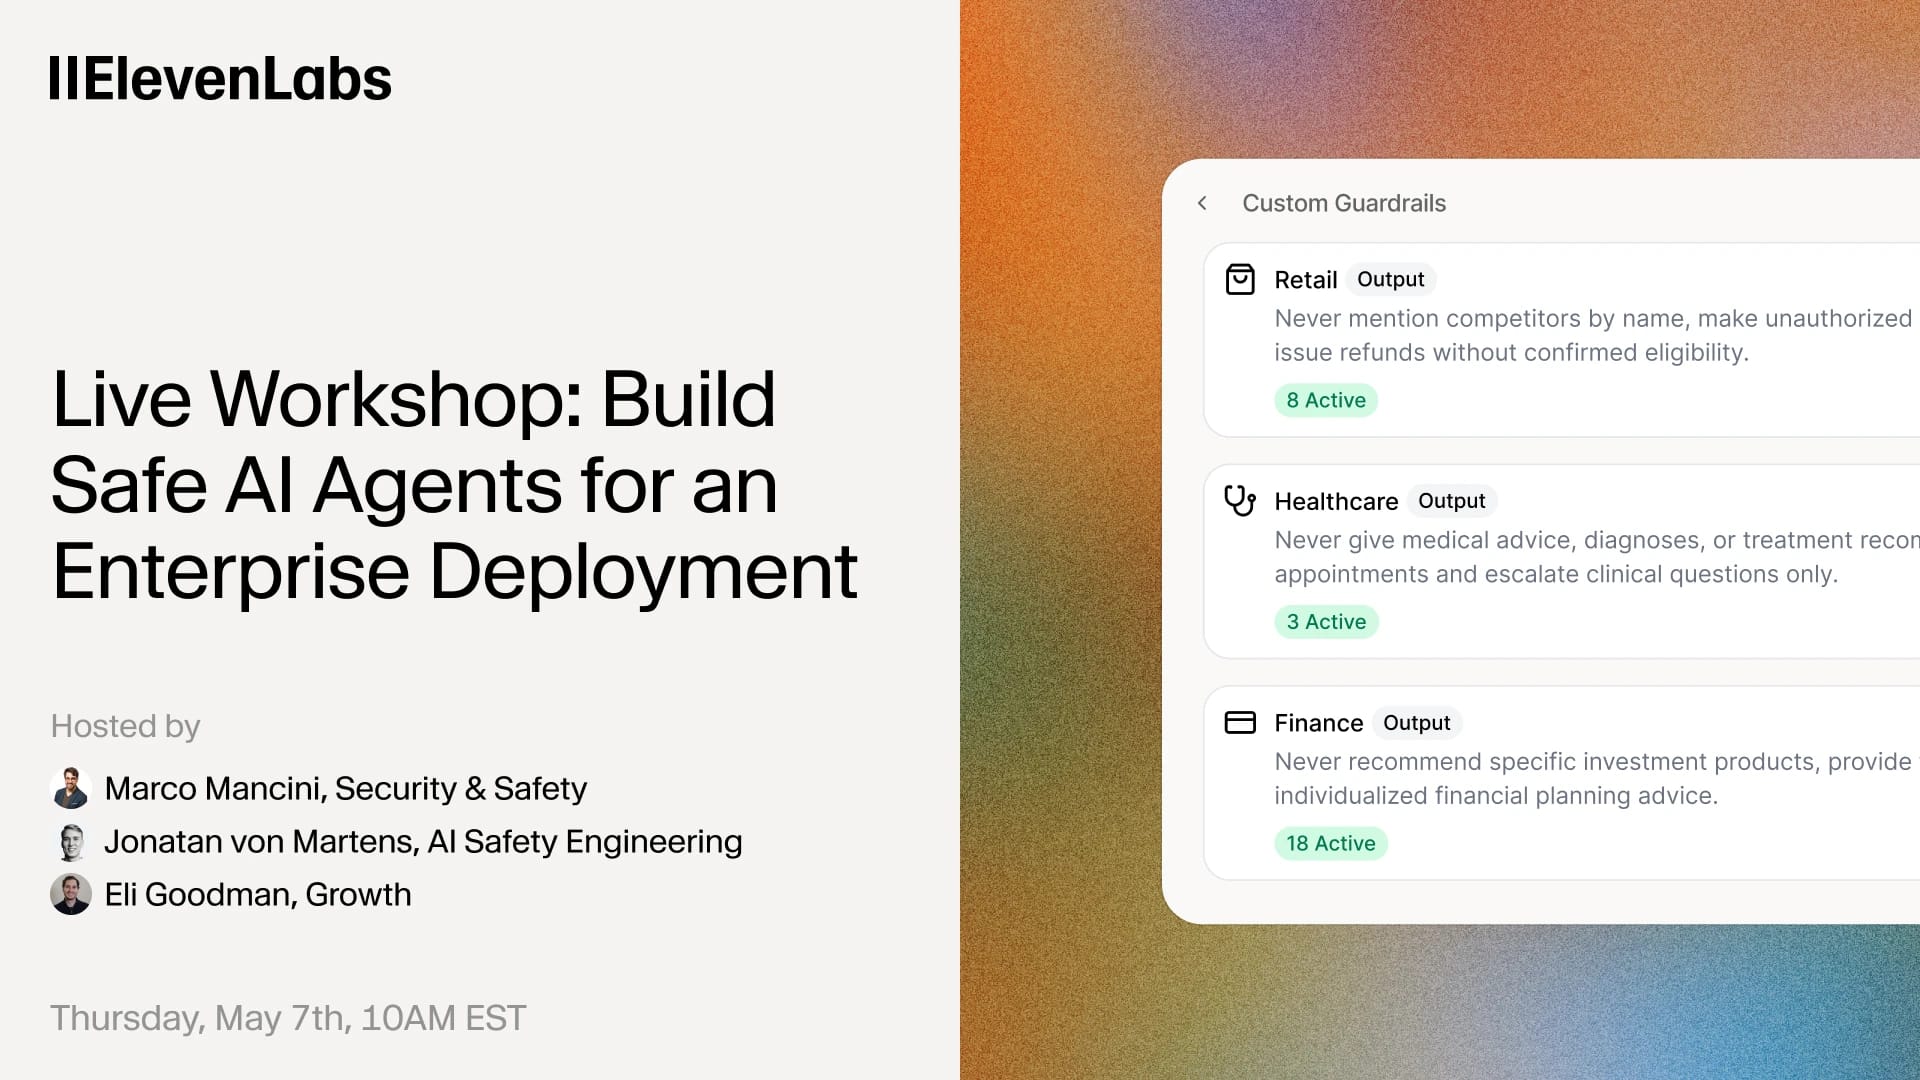
- Dopasuj guardraile do kontekstu. Agent medyczny i agent wsparcia sklepu potrzebują innych zasad. Określ granice właściwe dla swojego zastosowania, zamiast korzystać z ogólnego szablonu.
- Zacznij od zastosowania, które ma znaczenie. Najskuteczniejsze wdrożenia w firmach nie zaczynają się od pilotażu bez znaczenia. Wybierają realne zastosowania, takie jak obsługa klienta czy umawianie terminów — i inwestują, by zrobić to dobrze.
- Testuj przed uruchomieniem, a potem nadal testuj. Korzystaj z testów symulacyjnych i zewnętrznych narzędzi red-teamingowych. Testuj zarówno rutynowe, jak i wrogie scenariusze. Dodawaj do zestawu testów nowe przypadki brzegowe wykryte na produkcji.
- Wdrażaj etapami. Zacznij od ograniczonego ruchu. Monitoruj prawdziwe rozmowy. Sprawdzaj, z czym agent ma trudności. Wprowadzaj poprawki, testuj ponownie, a potem zwiększaj skalę.
- Świadomie wybieraj tryb działania. Używaj trybu blokującego dla agentów tekstowych, gdy rygorystyczna walidacja jest ważniejsza niż szybkość. Tryb streamingu stosuj dla agentów głosowych, gdy priorytetem jest opóźnienie.
- Jasno określ działania po naruszeniu guardraila. Zdecyduj z góry, czy naruszenie ma zakończyć rozmowę, uruchomić ponowną próbę, czy eskalować sprawę do człowieka.
- Instrukcje dla własnych guardraili powinny być zwięzłe. Guardraile działają równolegle. Długi, złożony własny guardrail zwiększa opóźnienie. Pisz krótkie instrukcje i dziel różne kontrole na osobne guardraile.
- Wiedz, co naprawdę obejmują certyfikaty. SOC 2 Type 2 i ISO 27001 to dziś podstawa. Standardy branżowe, takie jak HIPAA i PCI DSS, dotyczą regulowanych sektorów. Nowsze certyfikaty związane z AI, takie jak ISO 42001 i AIUC-1, dotyczą uprzedzeń, przejrzystości i odporności na ataki — a certyfikacja AIUC-1 może otworzyć dostęp do ubezpieczenia dla AI.
- Od początku rozwijaj procesy. Pierwsze wdrożenie zajmuje najwięcej czasu. Zespoły, które inwestują w testowanie i proces wdrożeniowy, znacznie szybciej iterują przy każdym kolejnym agencie.
Obejrzyj całą sesję
Obejrzyj cały webinar tutaj.