
Projektowanie Conversational AI: Jak tworzyć bardziej ludzkie doświadczenia użytkownika
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Projektowanie Conversational AI oznaczało kiedyś tworzenie drzewa decyzyjnego. Wczesne chatboty i menu IVR opierały się na sztywnych, wcześniej napisanych gałęziach: naciśnij 1 w sprawie płatności, powiedz „tak” lub „nie” i miej nadzieję, że pytanie klienta pasuje do jednej z przewidzianych ścieżek. Ten model działał tylko wtedy, gdy rozmowa nie wykraczała poza to, co już przygotowano.
Agenci AI znieśli to ograniczenie. Mogą teraz analizować rozmowę w czasie rzeczywistym, korzystać z bazy wiedzy, wywoływać narzędzia i pamiętać, co już zostało powiedziane, więc nie ogranicza ich już stały skrypt.
Ta zmiana nie wyeliminowała jednak potrzeby projektowania Conversational AI. Wręcz przeciwnie — podniosła poprzeczkę. Bez sztywnego skryptu, na którym można się oprzeć, persona agenta, workflow i punkty decyzyjne muszą być zdefiniowane na tyle dobrze, by sprawdzały się w otwartej rozmowie w czasie rzeczywistym, a nie tylko w z góry ustalonym scenariuszu.
Ten przewodnik wyjaśnia, czym w praktyce jest projektowanie Conversational AI dla czatu i agentów głosowych, dlaczego ma znaczenie dla wskaźników, z których jesteś rozliczany, oraz co optymalizować, aby rozmowa była bardziej naturalna. Zrób to dobrze, a wdrożysz agentów AI, którzy budują kontakt z klientami i zapewniają szybszą, lepszą obsługę.
Podsumowanie
- Projektowanie Conversational AI określa, jak komunikacja agenta AI jest zbudowana i optymalizowana, aby rozmowa brzmiała naturalnie.
- Voice AI wybacza mniej niż tekst, ponieważ problemy z głosem, opóźnieniami i timingiem, niezauważalne w interfejsie czatu, mogą sprawić, że rozmowa głosowa zabrzmi mechanicznie.
- ElevenAgents umożliwia tworzenie ludzkich agentów AI do rozmów głosowych i czatów dzięki funkcjom, które pozwalają kontrolować głos, personę i przebieg rozmowy oraz optymalizować opóźnienia w każdym kanale.
Czym jest projektowanie Conversational AI?
Projektowanie Conversational AI to praktyka UX polegająca na konfigurowaniu zachowania agenta AI. Obejmuje wszystko: od jego persony po zabezpieczenia, workflow i bazy wiedzy, z których korzysta. Wszystko to razem sprawia, że rozmowa jest równie dopracowana jak każda inna część doświadczenia z produktem.
Ta konfiguracja nie wszędzie wygląda tak samo. Agenci mogą działać w wielu kanałach, takich jak czat, głos czy SMS, z jednej konfiguracji. Każdy z nich ma własne ograniczenia, ale w głosie są one największe. Gdy głos jest jednym z kanałów agenta, musi on wybrać i generować głos, zarządzać tempem oraz zmianą tur w czasie rzeczywistym i odpowiedzieć, zanim cisza zacznie sugerować zerwane połączenie. W przeciwieństwie do czatu nie jest to opcjonalne, bo tam nieco wolniejsza lub niedoskonała odpowiedź rzadko zaburza interakcję.
Oto co warto uwzględnić podczas wdrażania projektu Conversational AI dla agenta czatowego oraz co dodatkowo wnosi głos.
Klienci nie oceniają świadomie każdego z tych czynników. Po prostu zauważają, gdy coś nie gra, a to wystarczy, by podważyć zaufanie do całego agenta i zagrozić celom, dla których został wdrożony.
Dlaczego projektowanie Conversational AI ma znaczenie dla dobrego doświadczenia użytkownika
Każdy z opisanych wyżej czynników — od zmiany tur po opóźnienia i personę — wpływa na to, jak klient postrzega twoją markę w kluczowym momencie. Może wtedy zostać jej zwolennikiem albo krytykiem. To postrzeganie wprost przekłada się na wskaźniki, z których rozliczane są zespoły.
- Wyższa satysfakcja i skuteczność rozwiązywania spraw: Klienci wyżej oceniają interakcję, gdy agent odpowiada szybko i nie przerywa niezręcznie.
- Mniej porzuconych rozmów: Klienci rezygnują z rozmowy nie tylko przez długie oczekiwanie. Odpowiedź, która nie spełnia oczekiwań — czy to niezręczna cisza w rozmowie, czy sztywna odpowiedź na czacie niepasująca do marki — może wywołać taką samą chęć zakończenia rozmowy.
- Szybsze rozwiązanie sprawy: Jasne ustawienia przebiegu rozmowy i dobrze rozpisane workflow oznaczają mniej ślepych zaułków, powtarzanych pytań i sytuacji typu „przełączę cię”.
- Mniej eskalacji do ludzkich agentów: Gdy agent naturalnie prowadzi rozmowę i trzyma się zdefiniowanego workflow, częściej rozwiązuje sprawę za pierwszym razem, zamiast zdezorientować klienta tak, że poprosi o człowieka.
Przykładem jest eDreams ODIGEO, jedna z największych na świecie platform turystycznych online. Firma wdrożyła agentów AI z ElevenAgents w pięciu głównych językach i odnotowała dwucyfrową poprawę szybkości rozwiązywania spraw oraz dwucyfrowy spadek liczby przekierowań połączeń, częściowo dzięki syntezie głosu o niskich opóźnieniach i trafniejszemu rozpoznawaniu intencji na początku każdego połączenia. Takie wyniki zależą od wielu czynników poza samym projektem rozmowy, ale pokazują, co umożliwia dobre projektowanie Conversational AI.
Jak działa projektowanie Conversational AI w ElevenAgents
W ElevenAgents możesz optymalizować personę, głos, zmianę tur, przekazywanie rozmów i opóźnienia — te same czynniki, które decydują, czy agent wydaje się ludzki. Oto jak skonfigurować i zoptymalizować każdy z nich, aby agent dobrze radził sobie w prawdziwej rozmowie.
Persona i wybór głosu
Persona kształtuje pierwsze wrażenie klienta, a niedopasowanie podważa zaufanie, zanim rozmowa na dobre się zacznie. Persona zbyt sztywna dla przyjaznej marki detalicznej sprawia, że klienci zaczynają wątpić w agenta, zanim powie coś przydatnego. Zacznij ją kształtować w system prompcie, w którym określasz rolę agenta, jego osobowość i zabezpieczenia przed wszystkim innym.
W przypadku agentów głosowych persona musi też wybrzmiewać w głosie. Głos zbyt swobodny dla rozmowy finansowej wysyła ten sam sygnał co niedopasowana persona w tekście, dlatego wybór głosu jest częścią tego samego zadania. Zacznij od tego:
- Wybór głosu: Dopasuj głos do marki, odbiorców i tematu. Akcent, płeć i ton pomagają budować zaufanie konkretnego rozmówcy oraz nadają ton rozmowie.
- Obsługa wielu języków: Wybierz głos dla każdego obsługiwanego języka, zamiast używać jednego głosu na wszystkich rynkach. Jeden głos stosowany w wielu językach zwykle brzmi obco przynajmniej w jednym z nich, co podważa zaufanie, które chcesz zbudować.
ElevenAgents daje dostęp do ponad 11 000 głosów w Voice Library, które możesz wyszukiwać według akcentu, charakteru i zastosowania, więc rzadko zaczynasz od zera. Jeśli żaden nie pasuje, masz jeszcze dwie opcje: sklonować istniejący głos z krótkiej próbki audio albo zaprojektować go od podstaw za pomocą promptu tekstowego opisującego oczekiwany wiek, akcent, ton i tempo.
Ustawienia przebiegu rozmowy
W rozmowie głosowej czas ma największe znaczenie. W odróżnieniu od czatu, gdzie pauza to tylko puste miejsce, przerwa w rytmie rozmowy od razu brzmi jak cisza w słuchawce lub zerwane połączenie. Właściwy rytm to najważniejszy czynnik, dzięki któremu agent głosowy staje się naturalnym uczestnikiem rozmowy, a zaczyna się od samego modelu zmiany tur.
Model zmiany tur ElevenLabs to oparty na badaniach system, który wykrywa, kiedy rozmówca naprawdę skończył mówić, a nie tylko zrobił przerwę. Dzięki temu określa, kiedy agent powinien odpowiedzieć, zamiast kierować się stałym opóźnieniem.
Ponadto możesz dostosować kilka ustawień, aby poprawić przebieg rozmowy:
- Limit czasu tury: Czas, przez jaki agent czeka w ciszy przed odpowiedzią, aby nie wtrącić się, gdy klient jeszcze myśli, ani nie zostawić go bez odpowiedzi po zakończeniu wypowiedzi.
- Miękki limit czasu: Krótka fraza wypełniająca, której agent używa podczas przetwarzania, np. „Chwileczkę” lub „Już sprawdzam”, aby klient nie pomyślał, że połączenie zostało zerwane. Unikaj zwrotów obiecujących konkretny czas, np. „jedną sekundę”, ponieważ rzeczywisty czas odpowiedzi bywa różny.
- Przerywanie: Określa, czy agent przestaje mówić, gdy klient zaczyna mówić równocześnie. Włącz tę opcję dla naturalnej rozmowy. Wyłącz ją, gdy ważne jest przekazanie pełnej treści — w przypadku zastrzeżeń prawnych, instrukcji bezpieczeństwa i wszystkiego, co trzeba usłyszeć w całości.
- Szybkość przejmowania tury: Jak szybko agent odpowiada, gdy klient przestanie mówić. „Szybka” sprawdza się w obsłudze klienta, gdzie liczą się błyskawiczne odpowiedzi. „Cierpliwa” jest najlepsza przy zbieraniu danych klienta, np. numeru telefonu lub adresu e-mail, aby agent nie przerwał klientowi w połowie cyfry. „Normalna” to dobre ustawienie domyślne dla zwykłej rozmowy.
Niewielkie zmiany w tych ustawieniach mogą wiele dać. Nawet drobna zmiana limitu czasu może decydować o tym, czy agent wydaje się uważny, czy sprawia wrażenie, że przerywa ludziom.
Workflow, projektowanie przekazań i skrypty
Workflow to obszar, w którym projektowanie Conversational AI jest realizowane w ElevenAgents. Określają, co i kiedy się dzieje: punkty decyzyjne, ścieżki eskalacji, przekazania rozmowy — wszystko, co w przeciwnym razie agent musiałby improwizować.
Workflow współpracują z dwoma innymi systemami, aby dopracować agenta. System prompt definiuje podstawowe zachowanie agenta — jego rolę, ton oraz to, co powie i czego nie powie — w kluczowych momentach, takich jak powitania czy przekazania rozmowy. Procedury to bardziej precyzyjna opcja dla pojedynczego, jasno określonego zadania, np. weryfikacji tożsamości klienta lub przeprowadzenia zwrotu. Zamiast rozgałęziać się zależnie od tego, co mówi klient, wykonują stałą sekwencję krok po kroku — od początku do końca, niezależnie od przebiegu rozmowy.
Najłatwiej zacząć budować agenta, korzystając z gotowych szablonów agentów, które zawierają punkt wyjścia zarówno dla workflow, jak i system promptów, więc zamiast budować wszystko od zera, możesz dopracować szczegóły. Oto zmiany, od których możesz zacząć, aby dostosować je do swoich potrzeb:
- Mapowanie decyzji: Dokładnie rozpisz, co agent robi w każdym punkcie decyzyjnym, aby cała rozmowa była określona od powitania po rozwiązanie sprawy. Węzły subagentów pozwalają dostosować system prompt, model, a nawet głos w konkretnych punktach przebiegu, dzięki czemu wrażliwy etap weryfikacji może działać pod bardziej rygorystycznymi zabezpieczeniami niż wcześniejsza luźna rozmowa.
- Wyzwalacze eskalacji: Zdefiniuj jasne wyzwalacze przekazania sprawy człowiekowi, wbudowane w workflow zamiast pozostawiać decyzję agentowi w danej chwili. Na przykład eskaluj sprawę, gdy nie zostanie rozwiązana po dwóch próbach, klient prosi o przełożonego albo transakcja jest na tyle wrażliwa lub wartościowa, że wymaga udziału człowieka.
- Kontekst przekazania: W system prompcie określ, co agent powinien zebrać przed przekazaniem sprawy, np. identyfikator zamówienia lub numer konta, oraz warunki wyzwalające przekazanie. Następnie przypisz zapisane dane do konfiguracji narzędzia przekazywania rozmów, aby zostały przekazane automatycznie, zamiast klient musiał powtarzać je przedstawicielowi.
- Gotowe sformułowania: Zdefiniuj w system prompcie dokładne brzmienie komunikatów na kluczowe momenty. Powitania, komunikaty o błędach, zastrzeżenia prawne i przekazania w ramach eskalacji nigdy nie powinny być improwizowane przez agenta. Dokładna formuła, np. „Mam teraz problem z dostępem do tych informacji”, jest pewniejsza niż pozostawienie agentowi decyzji, jak to ująć, gdy coś przestanie działać.
Sam workflow jest w ElevenAgents budowany jako wizualny graf, w którym każdy punkt decyzyjny i wyzwalacz eskalacji jest przedstawiony jako węzeł, który możesz bezpośrednio zobaczyć i edytować.
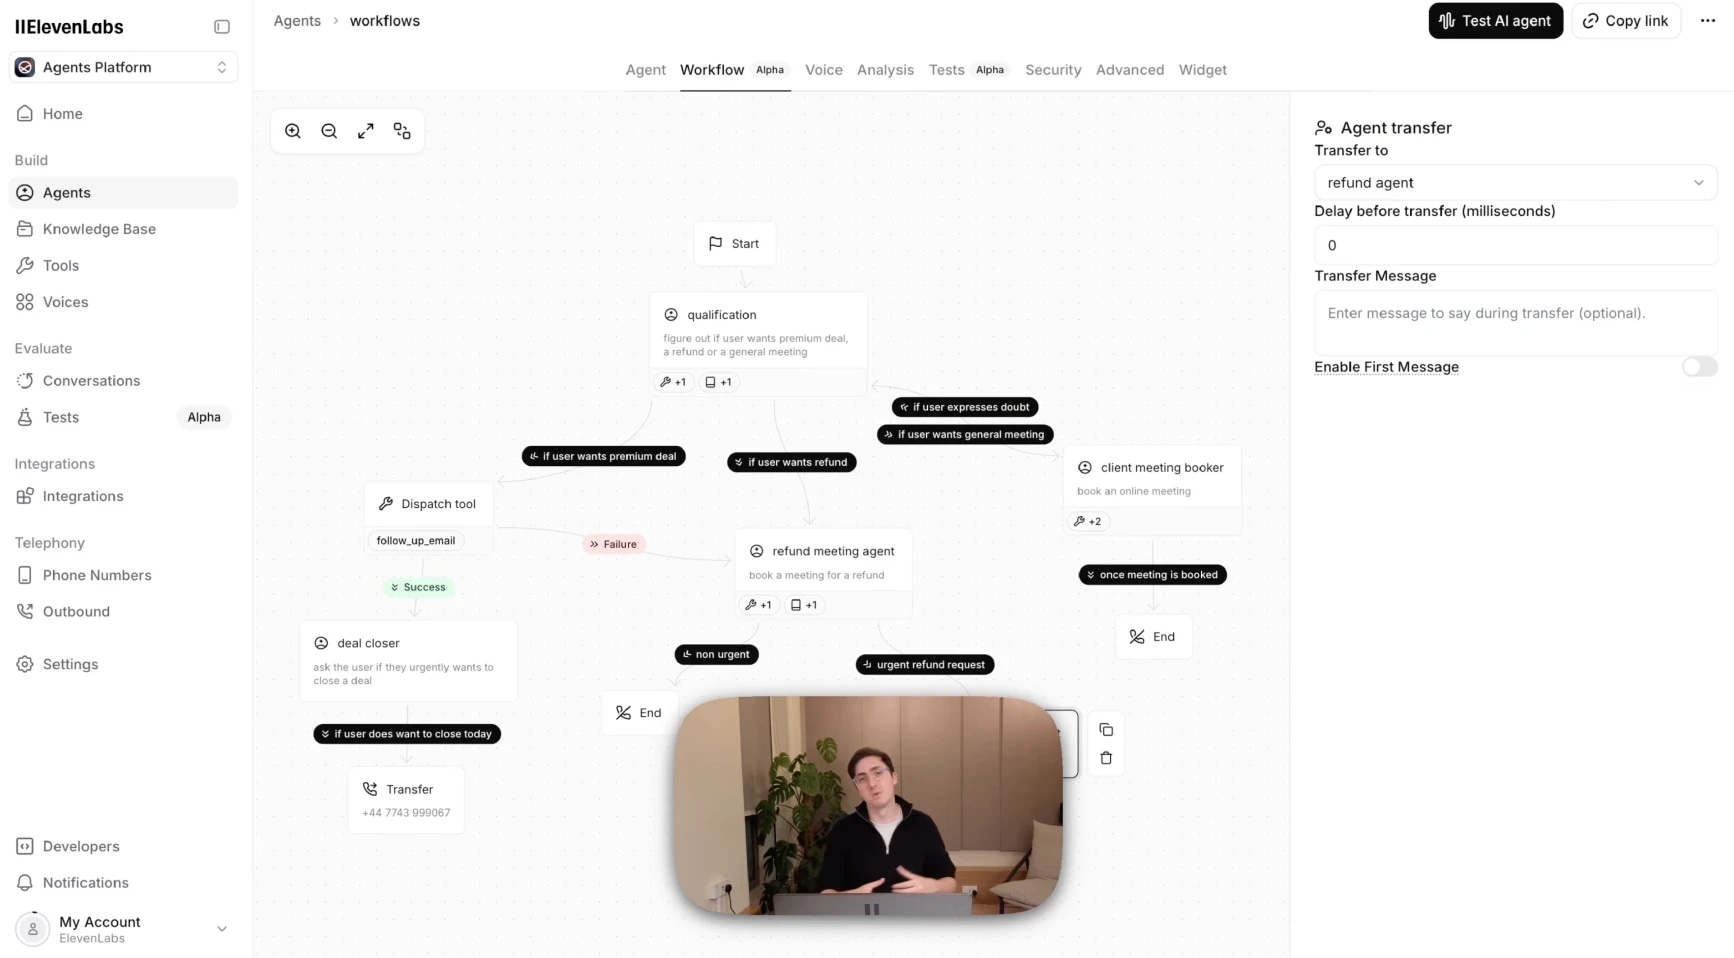
Po uruchomieniu analityka nakłada dane z rzeczywistych rozmów na ten sam graf, dzięki czemu dokładnie widzisz, gdzie klienci się blokują lub rezygnują, i możesz to poprawić bez zgadywania.
Opóźnienia i wydajność
Opóźnienie jest jednym z najważniejszych czynników decydujących o tym, czy interakcja wydaje się ludzka. Wolna odpowiedź to jeden z najszybszych sposobów, by przypomnieć klientowi, że rozmawia z maszyną — nawet jeśli wszystko inne przebiega dobrze.
Każdy etap procesu dodaje własne opóźnienie, niezależnie od tego, czy agent działa na czacie, czy głosowo. Niektóre dotyczą obu przypadków. Inne mają znaczenie tylko wtedy, gdy w grę wchodzi głos.
- LLM: Każdy wybór modelu to kompromis między kosztem, jakością rozumowania i szybkością, a właściwa równowaga zależy od rozmowy. Proste, częste interakcje, takie jak FAQ czy potwierdzenia wizyt, mogą działać na szybszym, lżejszym modelu bez pogorszenia doświadczenia. W bardziej złożonych zadaniach, np. doradztwie finansowym lub wieloetapowym rozwiązywaniu problemów, zwykle warto zapłacić za model o lepszym rozumowaniu, nawet jeśli odpowiada trochę wolniej.
- Baza wiedzy i RAG: Każde wyszukiwanie w bazie wiedzy dodaje kolejną rundę komunikacji, zanim agent odpowie, dlatego zwięzła, skupiona baza wiedzy reaguje szybciej niż taka, którą agent musi przeszukiwać szeroko.
- Integracje i wywołania narzędzi: Każde wywołanie zewnętrznego narzędzia, np. sprawdzenie zamówienia w Salesforce lub dostępności w kalendarzu, dodaje kolejną rundę komunikacji. Pisz jasne opisy narzędzi, aby agent nie wahał się, którego użyć, i wywołuj tylko te, których rozmowa rzeczywiście wymaga.
- Lokalizacja geograficzna i hosting danych: Dopasuj region ElevenAgents do miejsca hostowania danych, a przy wdrożeniach telefonicznych także do regionu dostawcy telefonii (Twilio, SIP lub innego). Jeśli region agenta i region bramki połączeń znajdują się po przeciwnych stronach świata, już ta odległość zwiększa opóźnienie, zanim rozmowa w ogóle się zacznie.
- Speech-to-text (tylko głos): Scribe transkrybuje wypowiedź klienta, zanim agent będzie mógł ją przeanalizować. Do rozmów na żywo używaj wersji czasu rzeczywistego (Scribe v2 Realtime), a nie wersji batchowej, która stawia na dokładność kosztem szybkości.
- Zmiana tur (tylko głos): Określa, kiedy agent w ogóle decyduje się odpowiedzieć; szczegółowo omówiliśmy to wyżej. Warto pamiętać, że to niezależny czynnik wpływający na opóźnienie, ponieważ model, który zwleka z wykryciem końca tury, dodaje opóźnienie, zanim ruszy reszta procesu.
- Text-to-speech i wybór głosu (tylko głos): Głosy domyślne i syntetyczne oraz Instant Voice Clones odpowiadają szybciej niż Professional Voice Clones. Używaj Professional Voice Clones tylko wtedy, gdy dodatkowa wierność brzmienia jest warta kompromisu w postaci opóźnienia.
Więcej informacji o opóźnieniach znajdziesz w najlepszych praktykach optymalizacji opóźnień oraz opisie sposobu mierzenia i raportowania opóźnień na całej ścieżce przetwarzania.
Zaprojektuj pierwszego agenta z ElevenAgents
Opisane tu elementy pokazują, czym w praktyce jest projektowanie Conversational AI dla agenta AI. Wszystko to jest dostępne natywnie w ElevenAgents i można to skonfigurować w konsoli no-code, aby stworzyć agenta, który prowadzi prawdziwą rozmowę, a nie tylko poprawnie odpowiada na pytania.
Dla zespołów, które chcą praktycznego wsparcia, ElevenLabs Forward Deployed Engineers współpracują bezpośrednio z twoim zespołem, aby określić zakres, stworzyć i uruchomić gotowego do produkcji agenta, a następnie dalej dostrajają jego wydajność po wdrożeniu.
Niezależnie od tego, czy tworzysz go samodzielnie, czy korzystasz ze wsparcia, najszybciej zobaczysz różnicę, gdy go wypróbujesz. Zacznij już dziś, tworząc agenta lub rozmawiając z naszym zespołem sprzedaży.
FAQ: projektowanie Conversational AI

Jack Limebear jest w zespole Growth, gdzie pisze teksty i tworzy strategie na bloga i stronę z insightami. Zanim dołączył do ElevenLabs, przez ponad dekadę prowadził strategie contentowe dla firm – od szybko rosnących startupów SaaS po spółki z listy Fortune 500. Ma tytuł magistra literatury angielskiej z Uniwersytetu Cambridge.



