
実践ガイド:オープンソースのエージェントフレームワークとElevenAgents
- 公開日
- 最終更新日
聴くこの記事を聴く
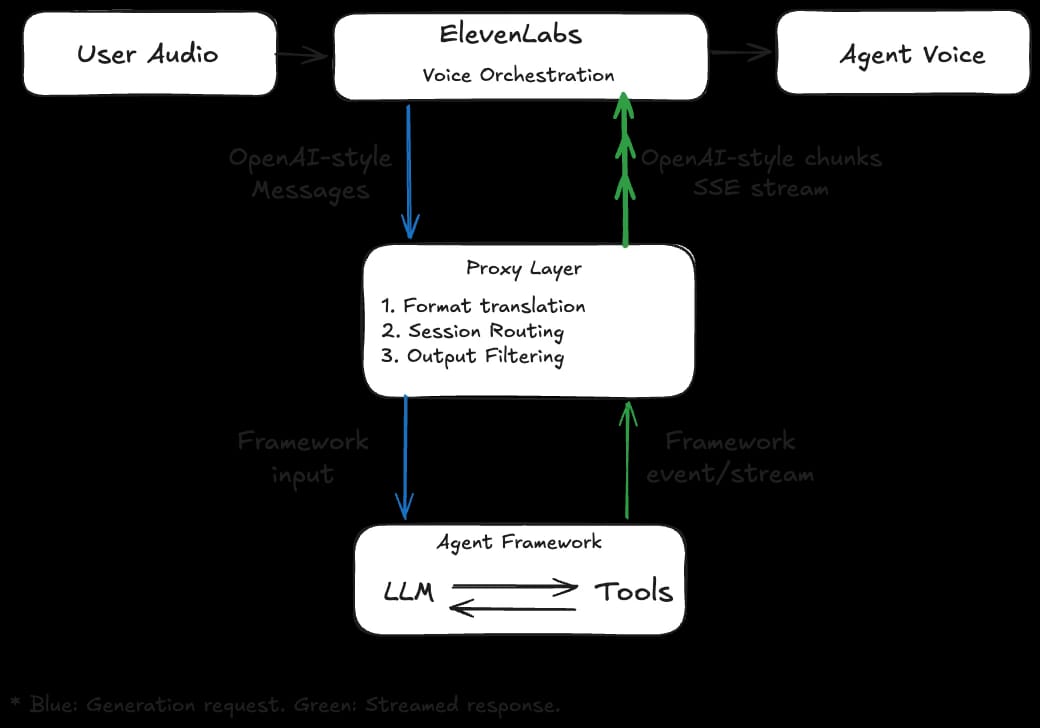
前回の投稿「ElevenLabs Voice Orchestrationへの外部エージェント統合」では、既存のテキストベースのエージェントオーケストレーションをCustom LLMを通じてElevenLabsに接続する方法を紹介しました。このガイドでは、その基盤をもとに、主要なオープンソースのエージェントフレームワークをCustom LLMインターフェースの背後で適応・デプロイする方法を解説します。その結果、状態管理、ツールオーケストレーション、アプリケーション固有の制御を損なうことなく、成熟したエージェントシステムに音声を重ねられる柔軟なアーキテクチャが実現します。フレームワークを問わず、手順は同じ3ステップです。生成リクエストを作成し、最終テキスト応答を抽出し、OpenAI互換のServer-Sent Events(SSE)形式に再フォーマットします。ElevenLabsはChat Completions とResponsesの両形式に対応しています。このガイドでは広く採用されている4つのフレームワークを扱いますが、ここで紹介するパターンは、OpenAI互換のストリーミング出力を生成できるあらゆるランタイムに応用できます。
共通セットアップ
このセクションの例ではPythonとFastAPIを使用しますが、HTTP POSTリクエストとストリーミングSSEレスポンスを処理できるスタックであれば利用できます。ElevenLabsの音声オーケストレーションがターン終了の可能性を検出すると、設定済みのCustom LLMエンドポイントに生成リクエストを送信します。このセクションでは、音声オーケストレーションとエージェントフレームワークを共通の言語でつなぐ、ブリッジまたはプロキシとなる変換レイヤーの主要コンポーネントを解説します。
各フレームワークは、使い慣れていることや特定の目的を満たせることから選ばれる場合があります。たとえばLlamaIndexは、Retrieval-Augmented Generation(RAG)のセットアップを簡単にするために開発され、CrewAIはエージェント時代における定義済みタスクの自動化を目的に作られました。設計目標が異なれば応答構造も異なり、それぞれに固有の処理が必要です。LLMが完全なターンを生成するまで待つのではなく、生成中にチャンクをストリーミングすることが重要です。これにより、テキスト読み上げ(TTS)モデルがより早く音声生成を始められ、体感レイテンシーを減らせます。ここでは主にLangGraph、Google ADK、CrewAI、LlamaIndexという4つの人気フレームワークに焦点を当てます。
共通コードについて
各フレームワークは、OpenAI互換のSSEチャンクとして応答をストリーミングする必要があります。ここでは、これらのチャンクを構築するために各例で使う小さなヘルパー関数を紹介します。
基盤が整ったところで、LangGraphから始めましょう。
LangGraph
LangGraphはエージェントをグラフとしてモデル化します。ノードは個別のステップを表し、エッジはノード間の制御フローを定義します。最小限のセットアップはシンプルです。チャットモデルを初期化し、エージェントツールを定義して、エージェントグラフのランタイムを作成します。
各生成リクエストで、LangGraph Agentは会話履歴全体を受け取り、必要な状態を内部で維持できます。LangGraphはCheckpointsによるサーバーサイドの永続化をサポートしていますが、実装を最小限に抑えるため、ここでは扱いません。
状態管理を済ませたら、次にLangGraph固有の判断ポイントとなるのがストリーミングモードです。LangGraphには、用途に応じた2つの選択肢があります。
- stream_mode="values"はグラフ状態のスナップショットを提供します。実装は簡単ですが、各応答により完全なメッセージ状態が含まれるため、リアルタイム会話フローではレイテンシーが増加します。
- stream_mode="messages"は、モデルから増分メッセージチャンクをストリーミングします。ElevenLabsのオーケストレーションレイヤーで最初の音声が生成されるまでの時間を短縮できるため、通常はリアルタイムの音声インタラクションに適しています。
さらに具体的には、エージェントループのmessages実装には、音声として読み上げるべきではないツール呼び出しの更新など、中間ステップが含まれます。プロキシはこれらを除外し、ユーザー向けの応答テキストだけをTTSレイヤーに渡します。ツールを利用するターンの例を見てみましょう。
[1] モデルがツールを呼び出すと判断する(tool_calls=["get_price"])[2] ツールが実行され、データを返す(result="$24.99") [3] モデルが結果を使って応答を生成する(content="価格は$24.99です")
当然ながら、SSEストリームで転送すべきなのはステップ3のチャンクだけです。実際には、ストリーミングループで2つのガードチェックを行います。1つはlanggraph_node == "model"イベントのみを保持し、もう1つは空のコンテンツをスキップします。この2つのチェックにより、ユーザー向けのアシスタントテキストだけがSSEとしてElevenLabsに転送されます。これらを組み合わせた、軽量なリクエストプロキシの実装を紹介します。
これにより、ユーザー向けのモデルチャンクだけがElevenLabsに転送されます。LangGraphでは内部ツールの実行が状態ストリームに現れるため、フィルタリングは明示的に行われ、プロキシによって制御されます。
次に、GoogleのAgent Development Kit(ADK)を扱う際のポイントを見ていきます。
Google ADK
GoogleのADKは、いくつかのコアプリミティブ、Agent、Runner、SessionServiceの背後にランタイムループを抽象化します。ADKのRunnerはHTTPレイヤーとエージェント定義の間に位置し、メッセージルーティング、ツールオーケストレーション、セッションライフサイクル、イベントストリーミングを処理します。
エージェント、セッションバックエンド、Runnerを初期化したら、プロキシは受信リクエストごとにADKセッションを取得または作成します。ADKでは、session_idがメモリの永続性を制御します。同じsession_idをターン間で再利用すると、履歴、ツール呼び出し、過去の応答が自動的に引き継がれます。会話IDはElevenLabsの上流にあるため、プロキシがこのマッピングを明示的に処理します。生成リクエストに正しい識別子を渡すことで、SDKは過去のコンテキストを内部的に処理できます。会話開始時には、リクエスト本文に渡す追加パラメーターを通じて任意の識別子を渡します。
メッセージとセッションを準備したら、Runnerを呼び出せます。ツール呼び出しとツール結果は実行中も内部ADKイベントとして現れますが、ユーザー向け出力ではなく中間的なオーケストレーションステップとして扱われます。これにより、ツール呼び出しがユーザーに見えるテキストとして表示されるフレームワークと異なり、手動フィルターが不要になります。
以下のハンドラーは、セッションの解決と取得または作成のロジックをインラインで含む簡略化された実装です。
次に、設計上よりタスク中心であるCrewAIを見ていきます。
CrewAI
CrewAIは、オープンエンドな対話ループではなく、構造化されたタスク(調査、執筆、要約)を中心にマルチエージェントワークフローをオーケストレーションするために設計されています。エージェントには、役割、目標、バックストーリーを定義します。実行は、明確な説明と期待される出力を持つTaskオブジェクトを中心に行われます。
LangGraphやADKで使われるエージェントループモデルとは異なり、CrewAIでは通常、会話のそのターンにおける作業単位を定義するため、リクエストごとにTaskとCrewを構築します。プレースホルダーを介して前のターンを次のタスクに挿入し、会話コンテキストを引き継ぎます。{crew_chat_messages}変数にはリクエストごとに継続中の会話履歴が設定され、実行時にタスクの説明へ補間されます。また、中間的なトレースパターン(Thought、Action、Action Input、Observation)を明示的に除外し、最終回答のテキストだけを出力することで、クリーンで音声出力に適したテキストを生成します。
以下のハンドラーは、リクエストごとのタスク構築、履歴の補間、Crewレベルのストリーミング、トレースのフィルタリング、出力フォーマットをまとめたものです。
次に、ネイティブのイベント駆動型ストリーミングモデルに焦点を当てる、異なるアプローチのLlamaIndexを見ていきます。
LlamaIndex
この投稿で扱う他のフレームワークとは異なり、LlamaIndexはLLMを外部データソース(ドキュメントストア、インデックス、検索パイプライン)に接続するために設計されています。そのエージェントレイヤーであるFunctionAgentはこの基盤の上にあり、オープンな対話やタスク実行ではなく、構造化されたコンテキストの検索と推論を行います。
会話の連続性を保つため、プロキシは受信メッセージをLlamaIndexのチャットメッセージに変換し、最新のユーザーターン(user_msg)と過去のターン(chat_history)に分割します。各AgentStreamイベントのevent.deltaフィールドには次のテキスト断片が含まれ、OpenAI形式のdelta.contentチャンクに直接対応します。空でないdeltaはそのまま転送できるため、このガイドで最もシンプルなストリーミングブリッジです。ストリームには、オーケストレーションイベント(ツール呼び出し、結果)と音声イベント(アシスタントテキストのdelta)の両方が含まれます。音声出力をクリーンに保つため、プロキシはAgentStreamイベントだけを保持し、空のdeltaをスキップします。
[1] AgentStream(delta='') ← 無視[2] ToolCall ← 無視[3] ToolCallResult ← 無視[4] AgentStream(delta='It') ← 転送 ✓[5] AgentStream(delta=' costs') ← 転送 ✓[6] AgentStream(delta=' $49.99')← 転送 ✓
この分離により、低レイテンシーの増分音声を維持しながら、中間的なツールの処理を読み上げ出力から除外できます。以下のそのまま使えるハンドラーは、これらのステップをまとめたものです。
LlamaIndexは、より強力な組み込みオーケストレーションレイヤーを備えたフレームワークと比べると、エンドツーエンドの会話ランタイムパターンをあまり規定しません。本番環境へのデプロイでは通常、セッション処理、応答ガードレール、ツールオーケストレーション、トレーシングを実装する必要があります。
まとめ
このガイドで紹介した各フレームワークは、同じ契約を通じてElevenLabsに接続します。OpenAI形式のCompletionsまたはResponsesリクエストを受け取り、SSEチャンクをストリーミングで返します。これにより、チームは最小限の変更で既存のエージェント実装に音声オーケストレーションを重ね、すでに構築したものを維持しながら、リアルタイムの会話型AIを実現できます。このモジュール性は、ElevenAgentsプラットフォームの中核となる考え方です。既存のエージェントを拡張する場合でも、最初から音声ネイティブに構築する場合でも、ElevenAgentsの音声オーケストレーションは、それぞれの状況に対応できるよう設計されています。
すでにオープンソースのフレームワークでエージェントを運用していて、音声を有効にしたい場合は、ぜひこのアプローチを試して、ご意見をお聞かせください。



