Presentazione di Eleven Realtime: un modo più semplice per creare agenti vocali naturali
- Scritto da
- Min Kim
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Oggi, creare un agente vocale che suoni naturale richiede molte decisioni. Devi scegliere singoli componenti come il riconoscimento vocale, il rilevamento dell'attività vocale, la gestione dei turni di parola, l'LLM sottostante e il Text to Speech. Creare questo stack è di per sé un progetto, e far funzionare bene insieme tutti i componenti richiede ulteriori test e ottimizzazioni.
Eleven Realtime è una nuova classe di modelli Speech to Speech che elimina questi ostacoli. Ogni modello è un agente vocale completo, ottimizzato per casi d'uso specifici. Entrambi supportano più di 90 lingue e possono usare una qualsiasi delle oltre 17.000 voci della libreria ElevenLabs:
Oggi lanciamo:
- Eleven Realtime v1 Mini per conversazioni naturali a basso costo. È la scelta migliore per assistenti IA, insegnanti e personaggi interattivi, ed è sufficiente per la maggior parte dei casi d'uso.
- Eleven Realtime v1 Max per attività complesse. È ideale per l'assistenza clienti, la qualificazione dei lead e workflow in più passaggi, in cui l'agente deve seguire un processo e ragionare attraverso i vari passaggi.
Perché abbiamo creato i modelli realtime
Non dovresti dover diventare un esperto di configurazione per creare un agente vocale che suoni naturale. Far sì che un agente dia l'impressione di essere naturale e suoni bene richiede piccole valutazioni che esigono sensibilità, come quanto aspettare dopo una pausa prima di rispondere, come reagire quando l'utente interrompe l'agente e come voce, prompt e modello interagiscono tra loro. In ElevenAgents, puoi modificare tutte queste impostazioni.
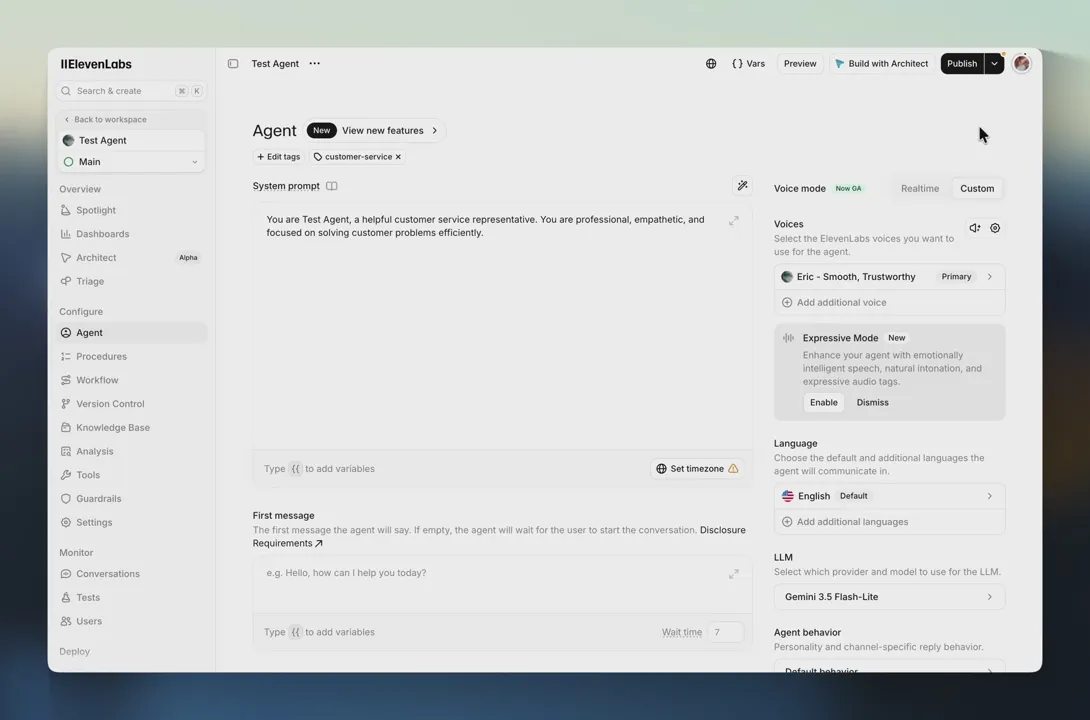
Lo stesso vale per gli sviluppatori che usano già una API realtime. La nostra è compatibile con la Realtime API di OpenAI, quindi per provare Eleven Realtime basta cambiare l'endpoint e il nome del modello nel codice che potresti già avere.
Basato su un'architettura a cascata
Eleven Realtime si basa su una architettura a cascata dei componenti descritti sopra, ottimizzati end-to-end. Li chiamiamo modelli Speech to Speech perché è ciò che ottieni: audio in ingresso, audio in uscita, un unico ID del modello e un sistema misurabile nelle stesse classifiche dei modelli fused e duplex.
I modelli fused hanno inizialmente stabilito lo standard per quanto naturale possa sembrare un agente vocale, mentre una configurazione a cascata comportava una maggiore latenza a ogni passaggio e componenti mai ottimizzati tra loro. Realtime elimina questo compromesso e l'ottimizzazione che prima era un tuo progetto è già fatta.
L'architettura a cascata offre anche vantaggi pratici in produzione, perché ogni passaggio produce testo. Puoi vedere cosa ha sentito l'agente e cosa ha deciso di dire, distinguendo così una parola capita male da una decisione errata. È questo stesso testo che permette a ElevenAgents di applicare guardrail e la rimozione dei PII a un agente Realtime.
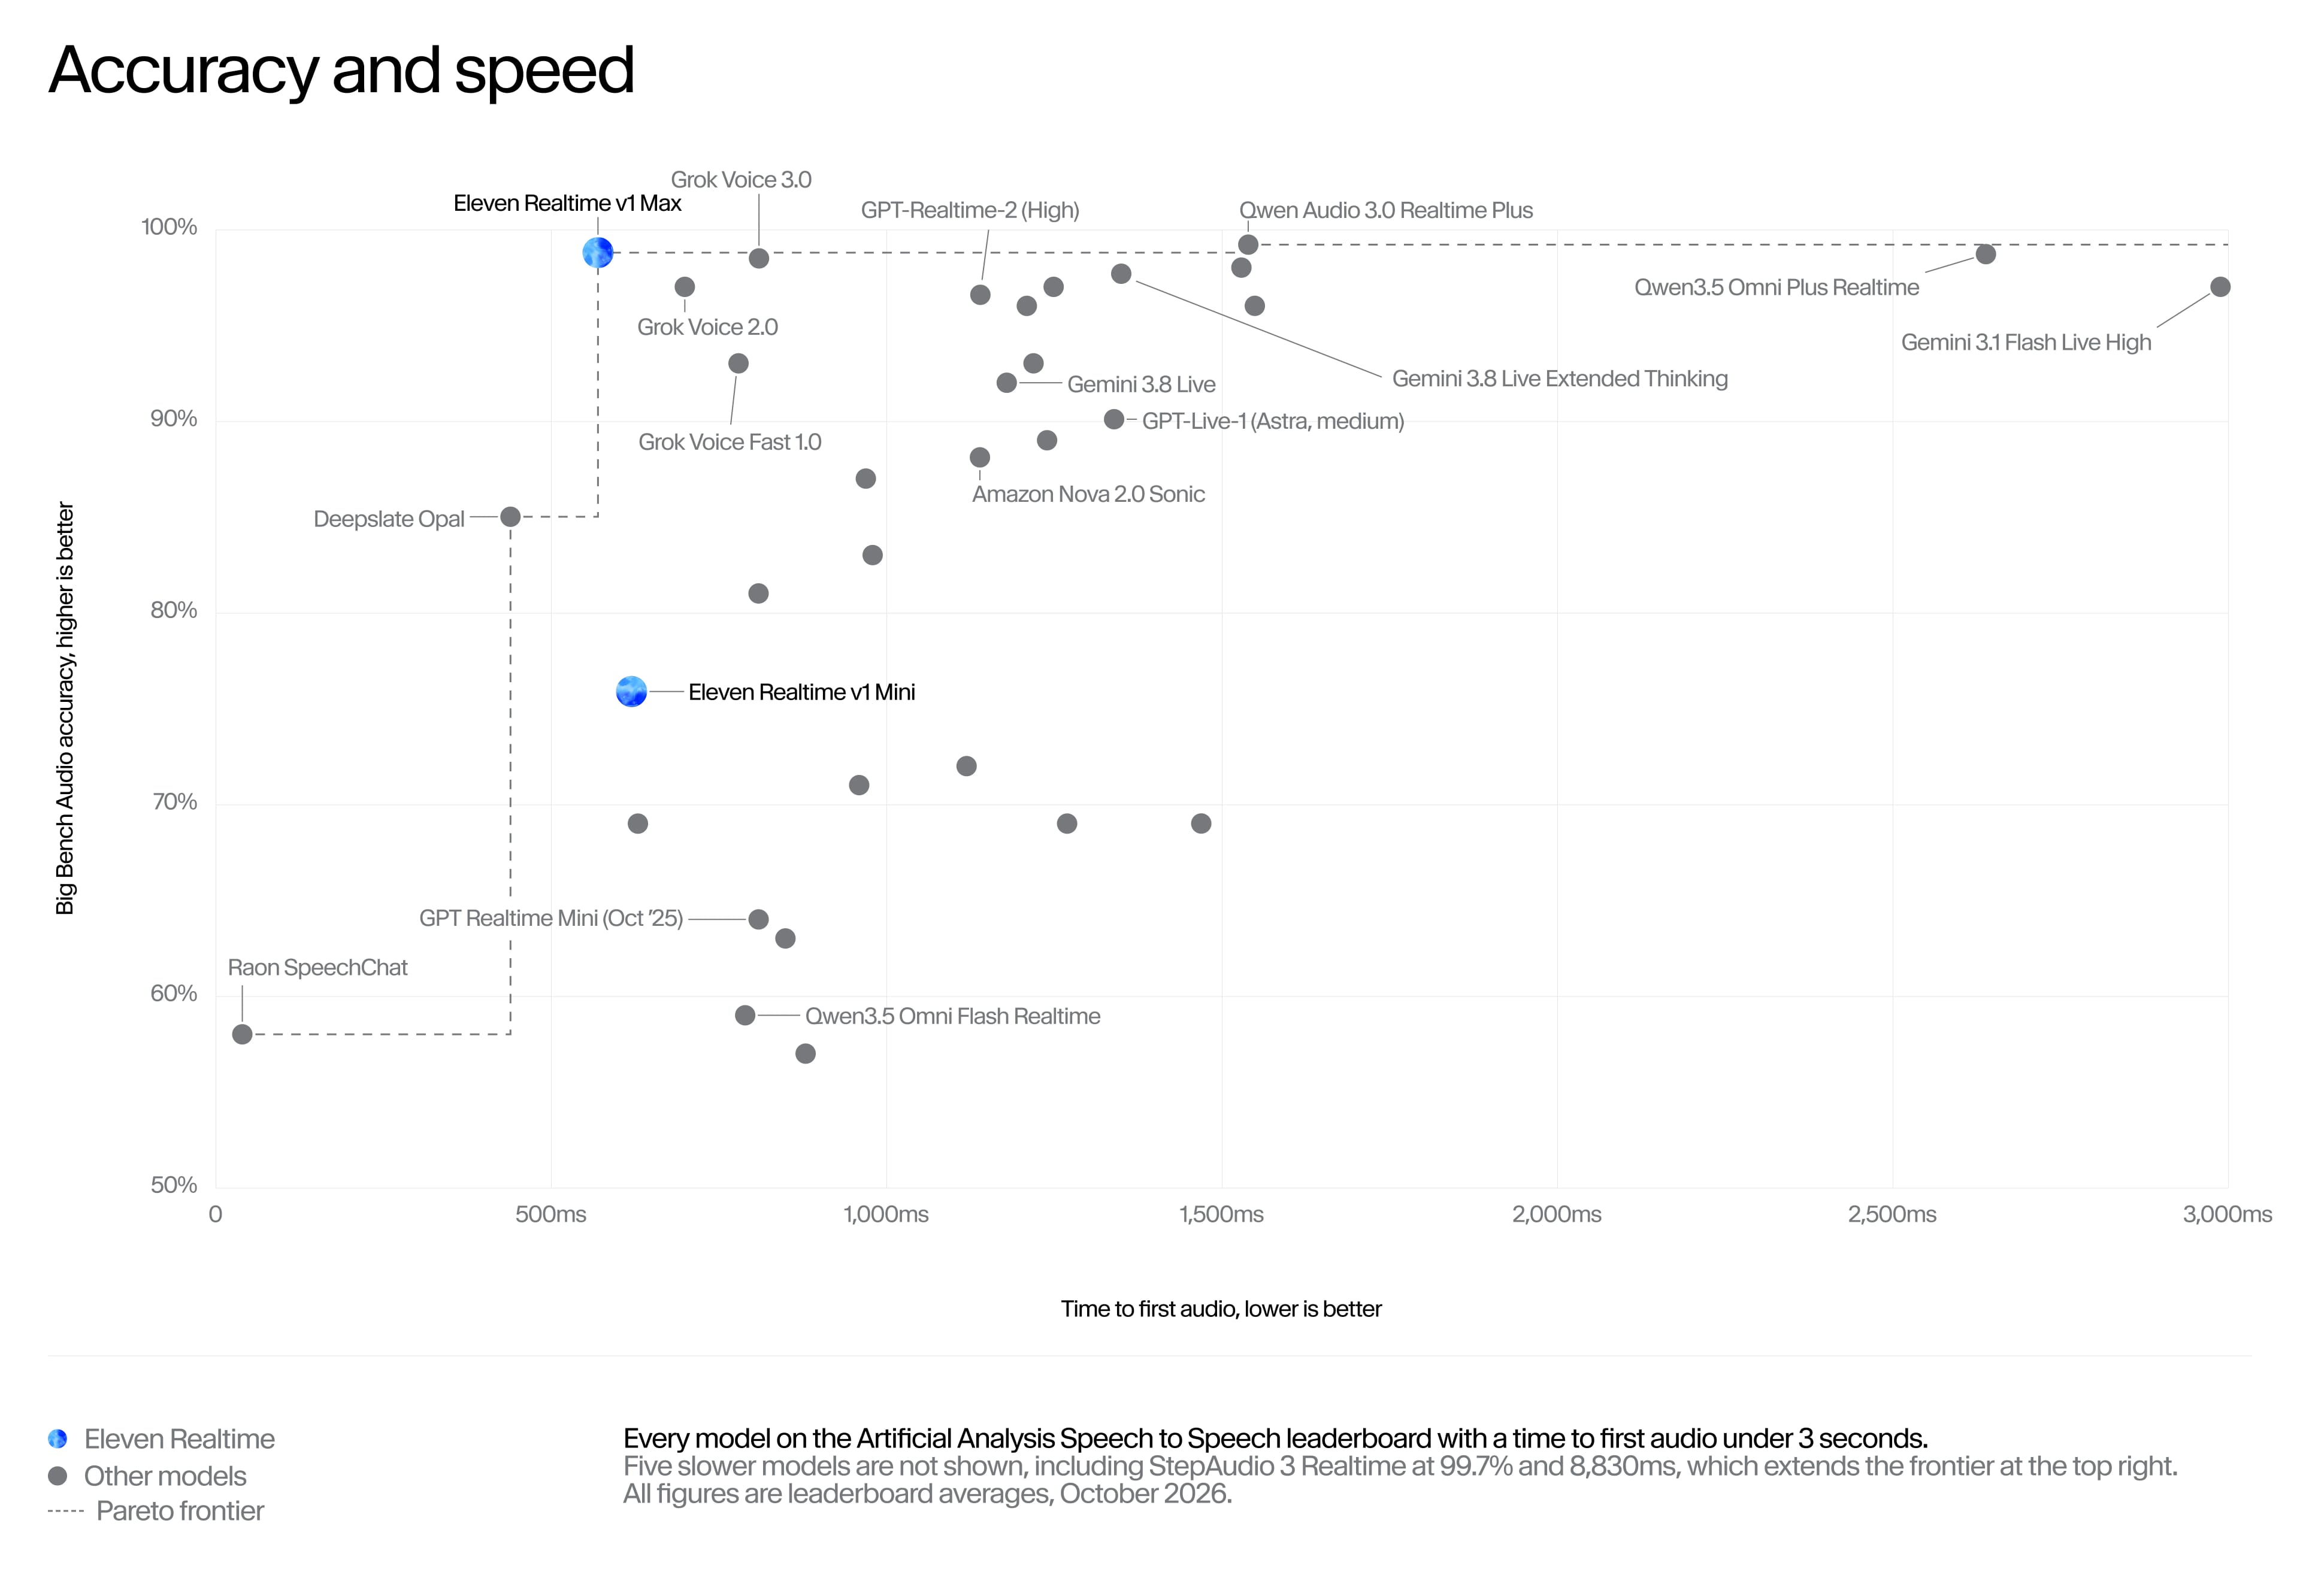
I benchmark seguenti verificano se questo compromesso è davvero scomparso. Nelle dinamiche conversazionali, entrambi i modelli ottengono risultati nella stessa fascia dei modelli fused. Considerando insieme accuratezza e velocità, nessun modello nella classifica di Artificial Analysis è al tempo stesso più veloce e accurato di v1 Max.
Prestazioni
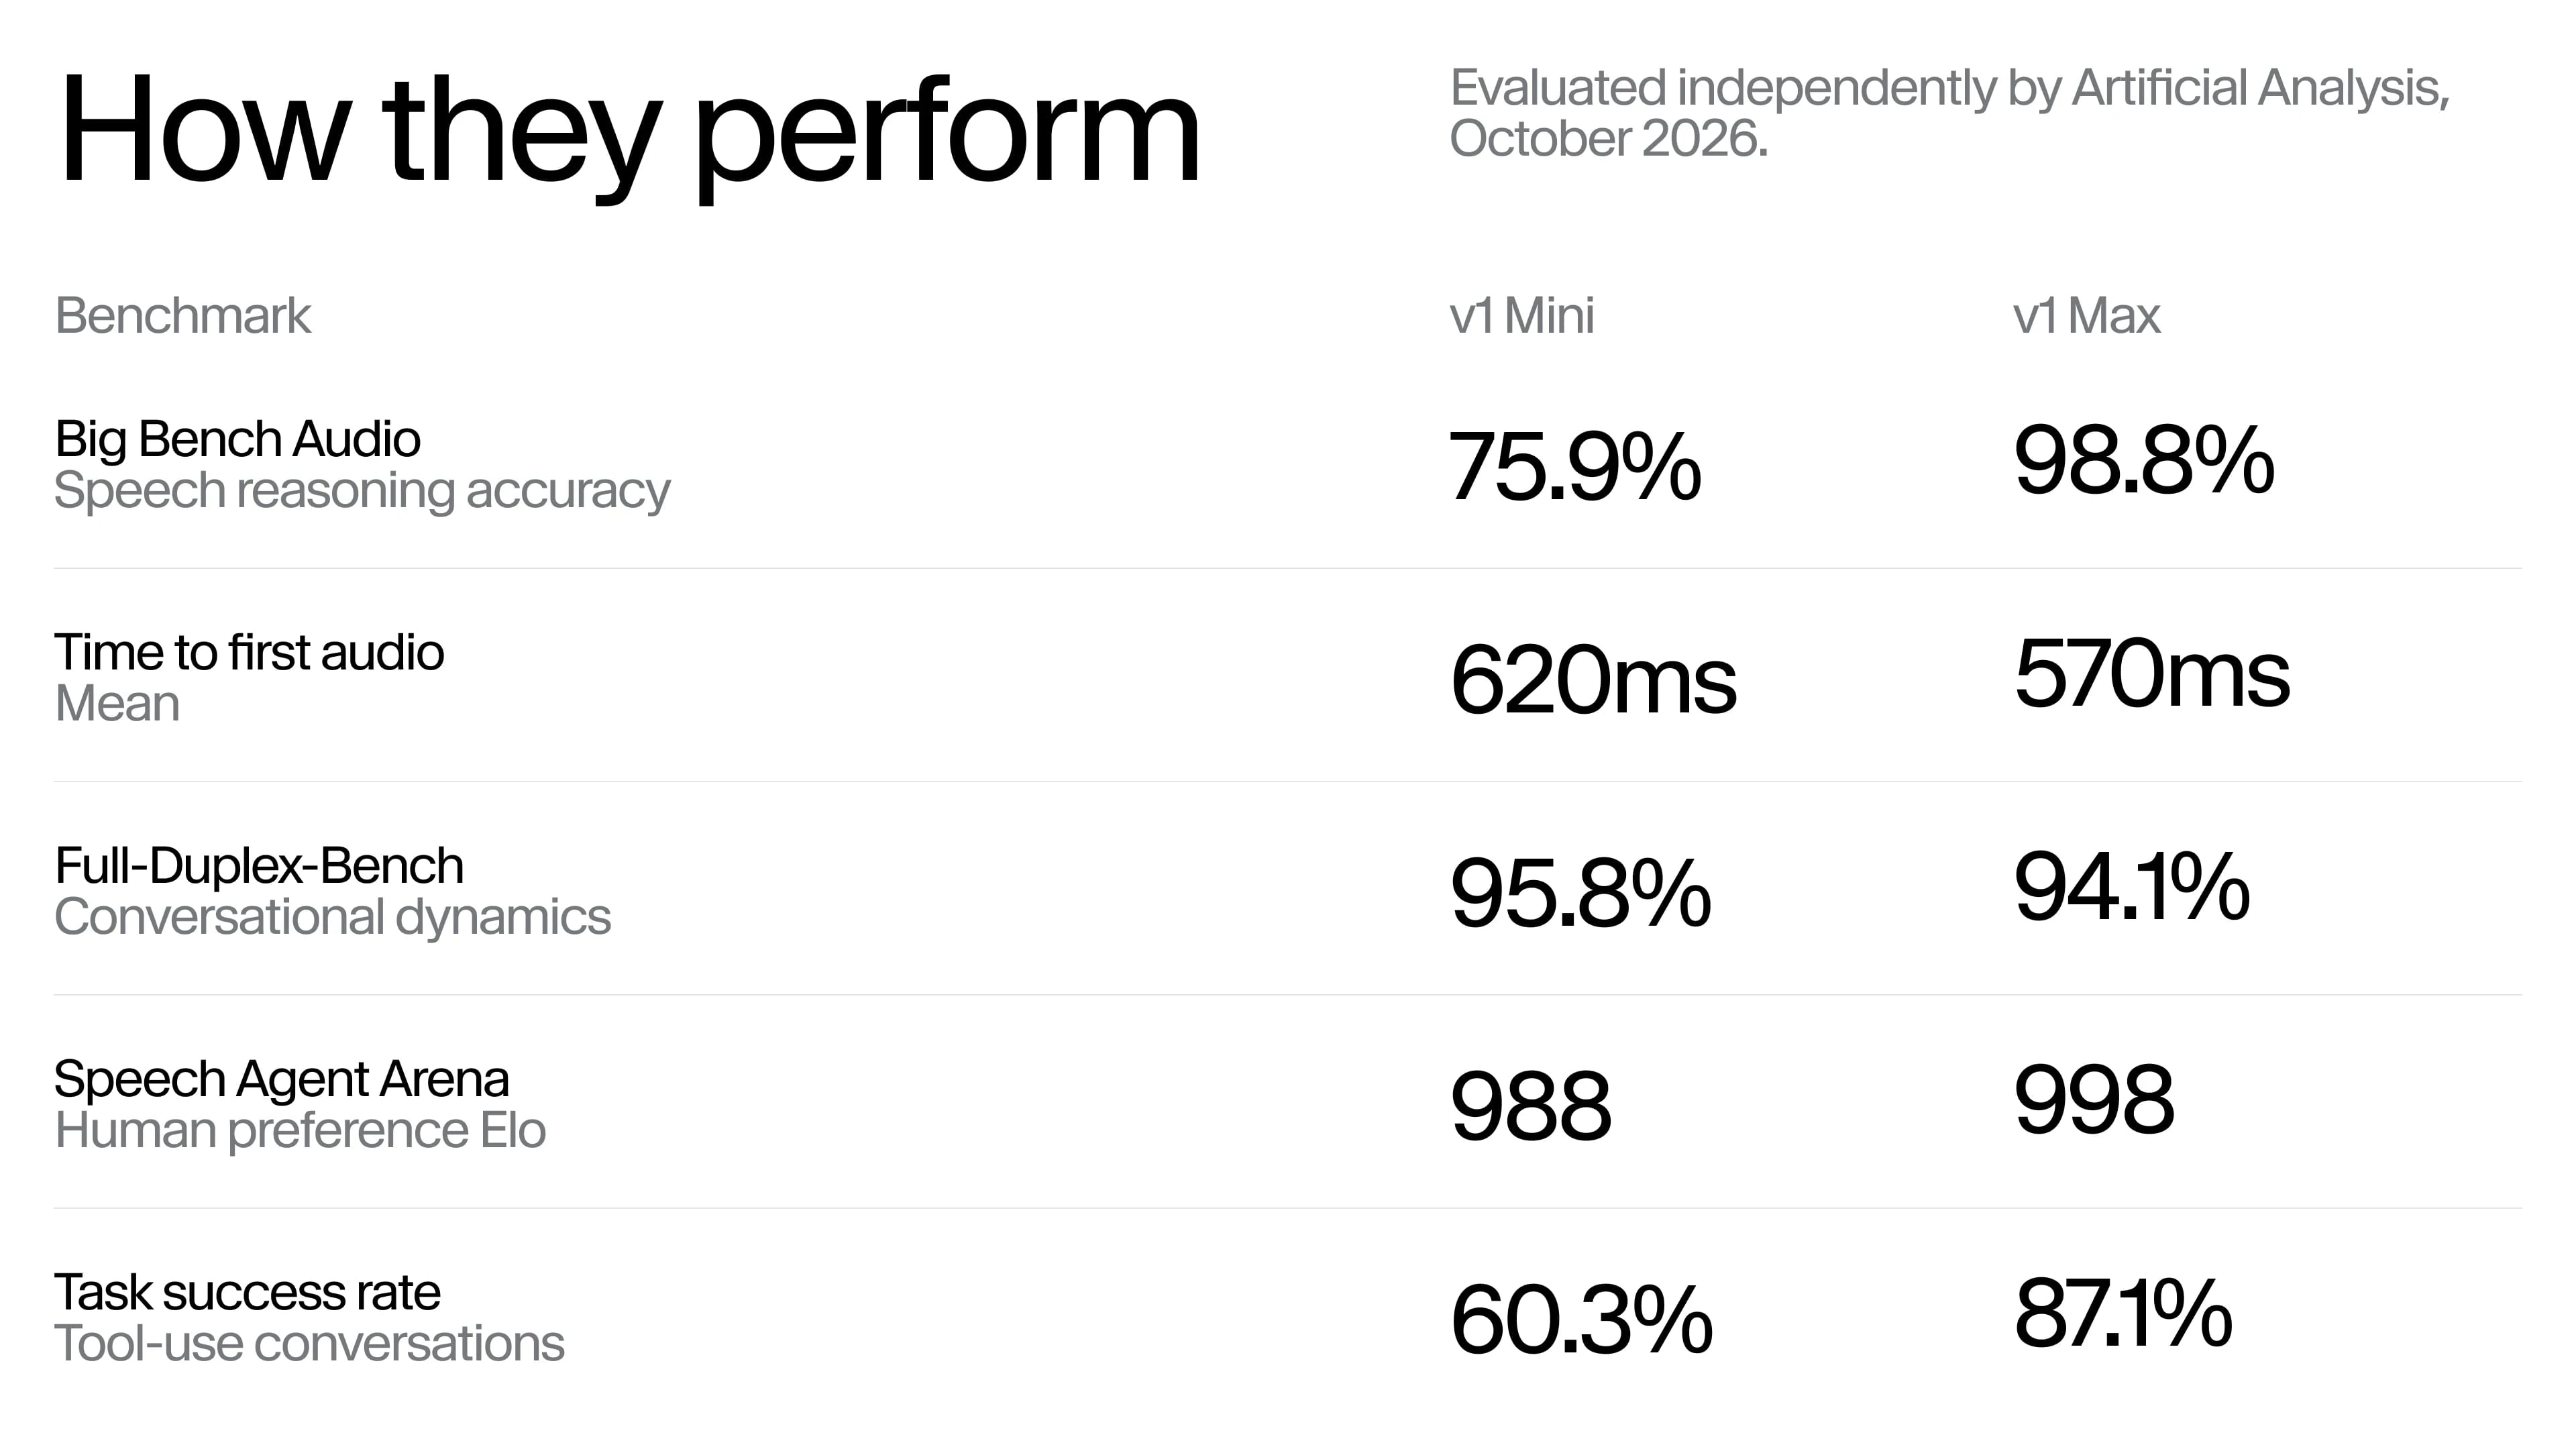
Artificial Analysis ha valutato entrambi i modelli in modo indipendente su tre benchmark pubblici: Big Bench Audio per il ragionamento vocale, Full-Duplex-Bench per le dinamiche conversazionali e Speech Agent Arena per la preferenza umana e il successo nelle attività.
Ragionamento vocale
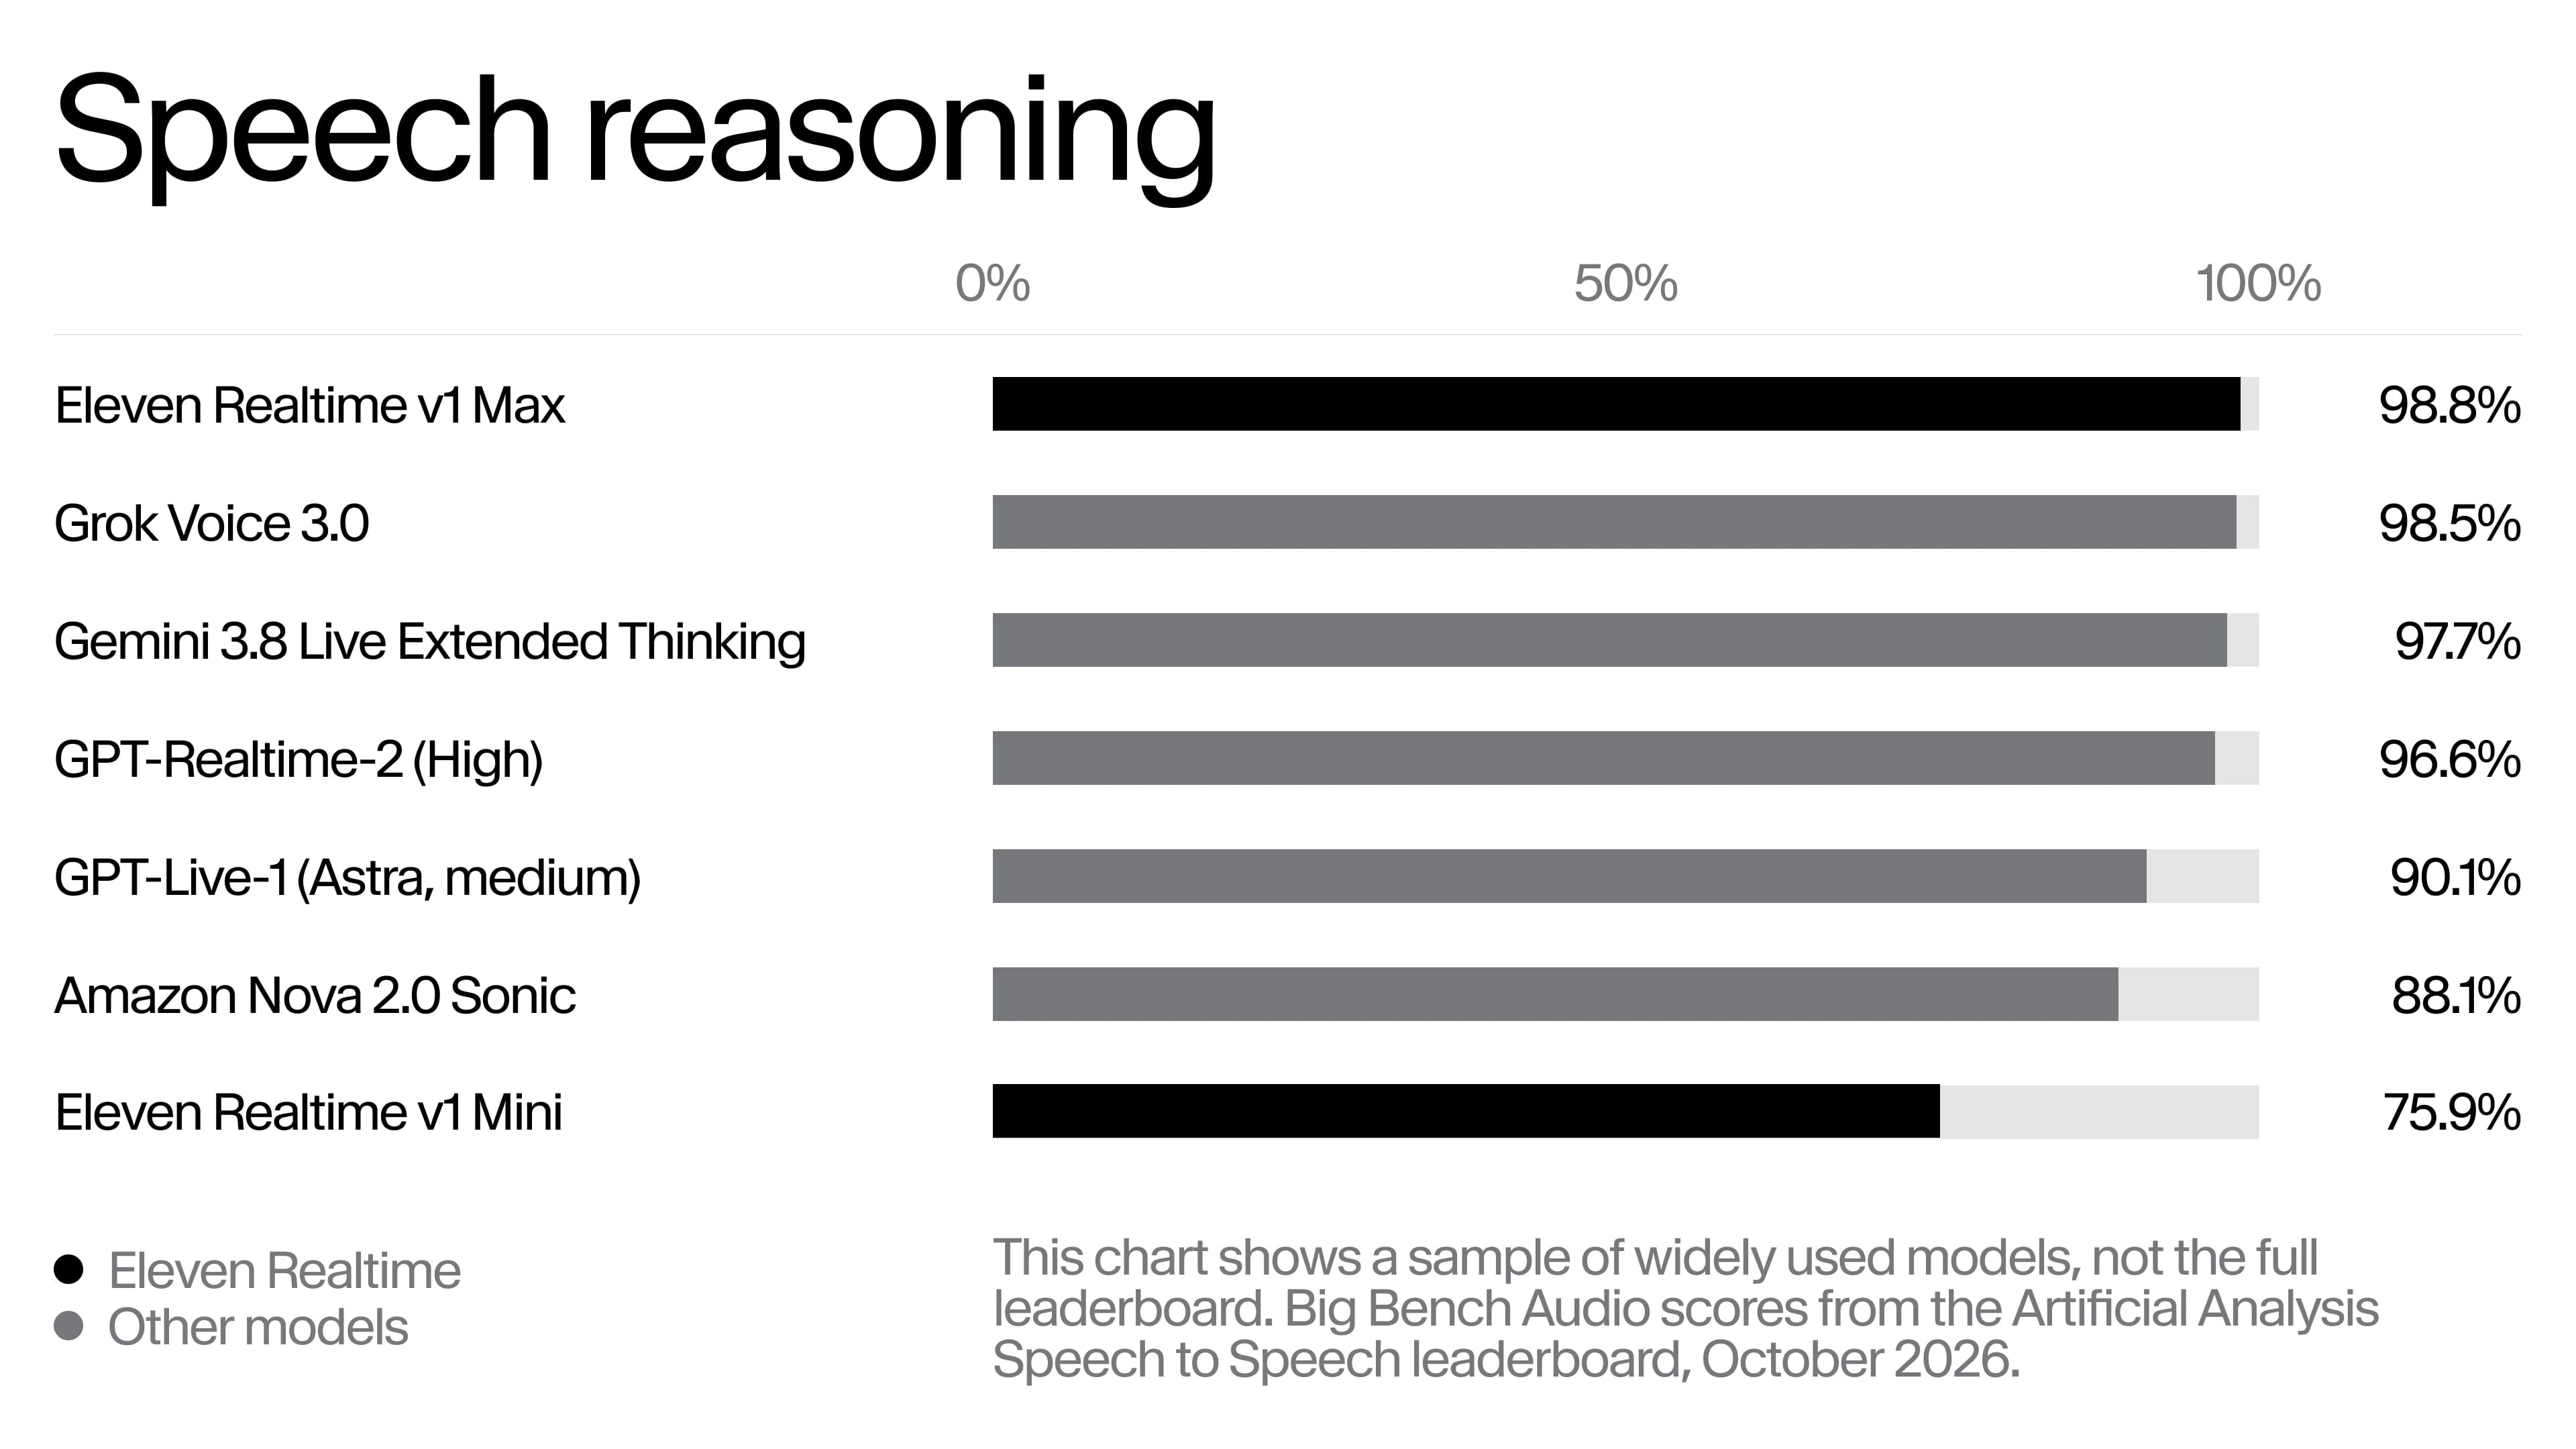
Big Bench Audio pone 1.000 domande di ragionamento a voce e valuta la risposta pronunciata. Realtime v1 Max ha risposto correttamente al 98,8% delle domande, mentre v1 Mini al 75,9%.
Velocità
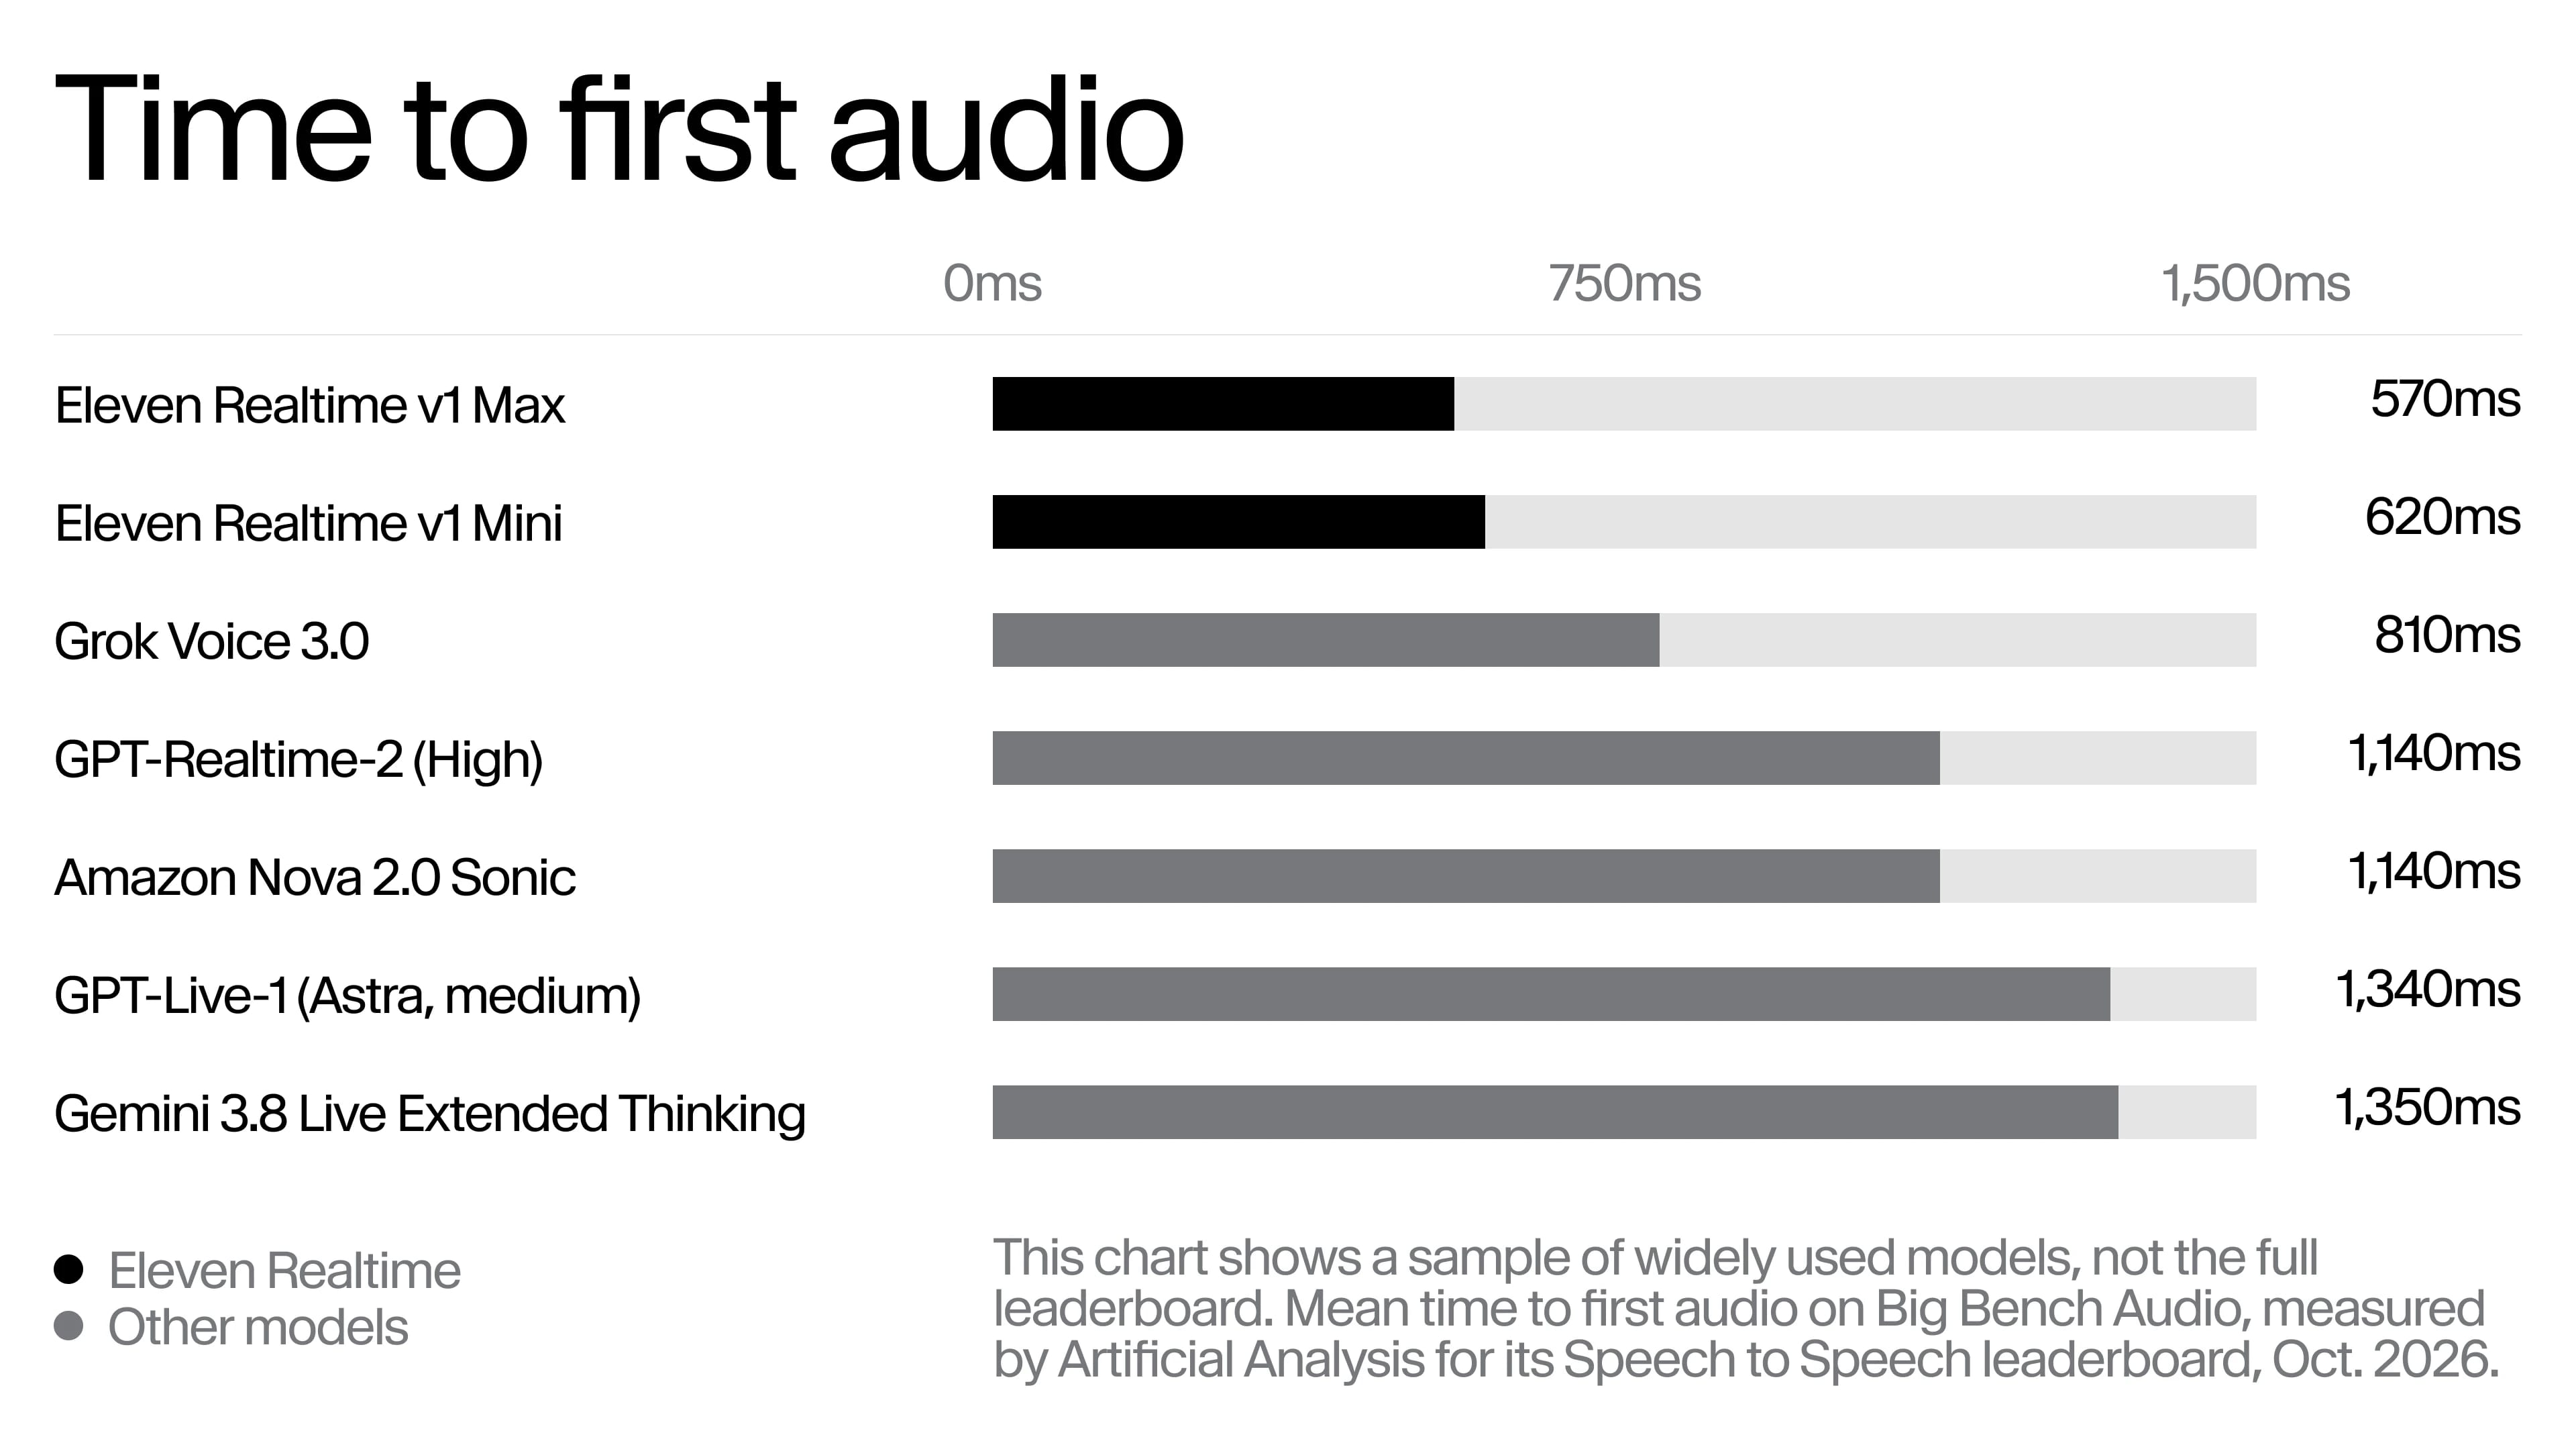
Big Bench Audio pone 1.000 domande di ragionamento a voce e valuta la risposta pronunciata. V1 Max inizia a parlare in media in 0,57 secondi, mentre v1 Mini in 0,62 secondi.
La frontiera di Pareto per accuratezza e velocità
Accuratezza e velocità sono di solito considerate in contrapposizione. I modelli con i punteggi più alti in Big Bench Audio impiegano più tempo a rispondere, mentre quelli più veloci sacrificano molta accuratezza. v1 Max eccelle in entrambe queste metriche.
Dinamiche conversazionali e preferenze umane
In Full-Duplex-Bench, che valuta pause, gestione dei turni di parola, interruzioni e segnali di ascolto, v1 Mini ottiene il 95,8% e v1 Max il 94,1%. Nella Speech Agent Arena, dove le persone confrontano due modelli in conversazioni dal vivo alla cieca, v1 Max ha ottenuto 998 punti e v1 Mini 988. Nelle attività che prevedono l'uso di tool, v1 Max ha completato l'87,1% e v1 Mini il 60,3%; per questo consigliamo Max per i casi d'uso con molte chiamate di tool.
Per iniziare
In ElevenAgents (consigliato)
Crea un agente, oppure aprine uno esistente, e seleziona un modello Realtime dal menu a discesa. Da lì hai a disposizione tutto ciò che ElevenAgents offre per eseguire agenti in produzione: canali telefonici, web, WhatsApp e CCaaS, workflow, una knowledge base, guardrail, test e monitoraggio.
Consulta la documentazione di ElevenAgents per maggiori dettagli.
Tramite la Realtime API
Se hai già un'integrazione con la Realtime API di OpenAI, il modo più veloce per provare Eleven Realtime è mantenere il tuo codice e cambiare la destinazione a cui punta. La Realtime API si connette tramite WebSocket e segue le specifiche Realtime di OpenAI, quindi l'SDK di OpenAI funziona così com'è.
La Realtime API si connette solo tramite WebSocket, quindi un'integrazione WebRTC deve prima passare a WebSocket. Inoltre, funziona separatamente da ElevenAgents: se ti servono canali, una knowledge base o altre funzionalità della piattaforma, crea tutto su ElevenAgents fin dall'inizio.
La guida alla migrazione illustra i passaggi e le differenze rispetto all'API di OpenAI.
Min fa parte del team Growth di ElevenLabs e si occupa di ElevenAPI e delle soluzioni On-Prem/On-Device. In precedenza, ha guidato il product marketing in Stainless come seconda assunzione GTM e, prima ancora, è stato tra i primi PMM di WorkOS, dove ha seguito lanci, enablement, contenuti e crescita.