
Crea un agente vocale in 20 minuti con ElevenLabs e Twilio
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Un agente vocale può rispondere alle chiamate in entrata, trascrivere gli interlocutori in tempo reale con Speech to Text (STT), generare una risposta con un modello linguistico di grandi dimensioni (LLM) e rispondere a voce tramite un modulo di Text to Speech (TTS). Con ElevenLabs e Twilio, puoi avere un agente funzionante su un vero numero di telefono in circa 20 minuti.
Per gli sviluppatori, lo stack completo che userai include ElevenLabs per la sintesi vocale (Flash v2.5) e la trascrizione (Scribe v2 Realtime), Twilio per la telefonia e OpenAI o Anthropic come LLM. Detto questo, tutti questi componenti sono sostituibili: puoi scegliere quelli che conosci meglio e usarli al loro posto.
Questo articolo mostra come creare un agente vocale in 20 minuti usando Node.js e Typescript. Se preferisci un'alternativa gestita che gestisca turn-taking, interruzioni e telefonia senza dover mantenere tu stesso la cascata, scopri ElevenAgents.
Come funziona l'architettura di un agente vocale
Prima di scrivere codice, è utile capire come si collegano i tre servizi del tuo stack tecnologico.
- Twilio: gestisce la chiamata telefonica e il trasporto audio.
- ElevenLabs: gestisce l'STT tramite Scribe v2 Realtime e il TTS tramite Flash v2.5.
- LLM: gestisce il tool calling e la creazione della risposta.
Ogni fase è un adapter leggero, quindi puoi sostituirne una con un altro servizio senza modificare il resto. Ad esempio, puoi sostituire l'LLM di OpenAI con Anthropic senza dover riscrivere gli altri componenti.
Una chiamata telefonica raggiunge il tuo server tramite Twilio. Twilio risponde alla chiamata PSTN, apre un WebSocket verso il tuo server e inoltra l'audio dell'interlocutore come flusso di frame mu-law codificati in base64. Il tuo server esegue la cascata e trasmette l'audio sintetizzato tramite lo stesso WebSocket, che Twilio riproduce all'interlocutore.
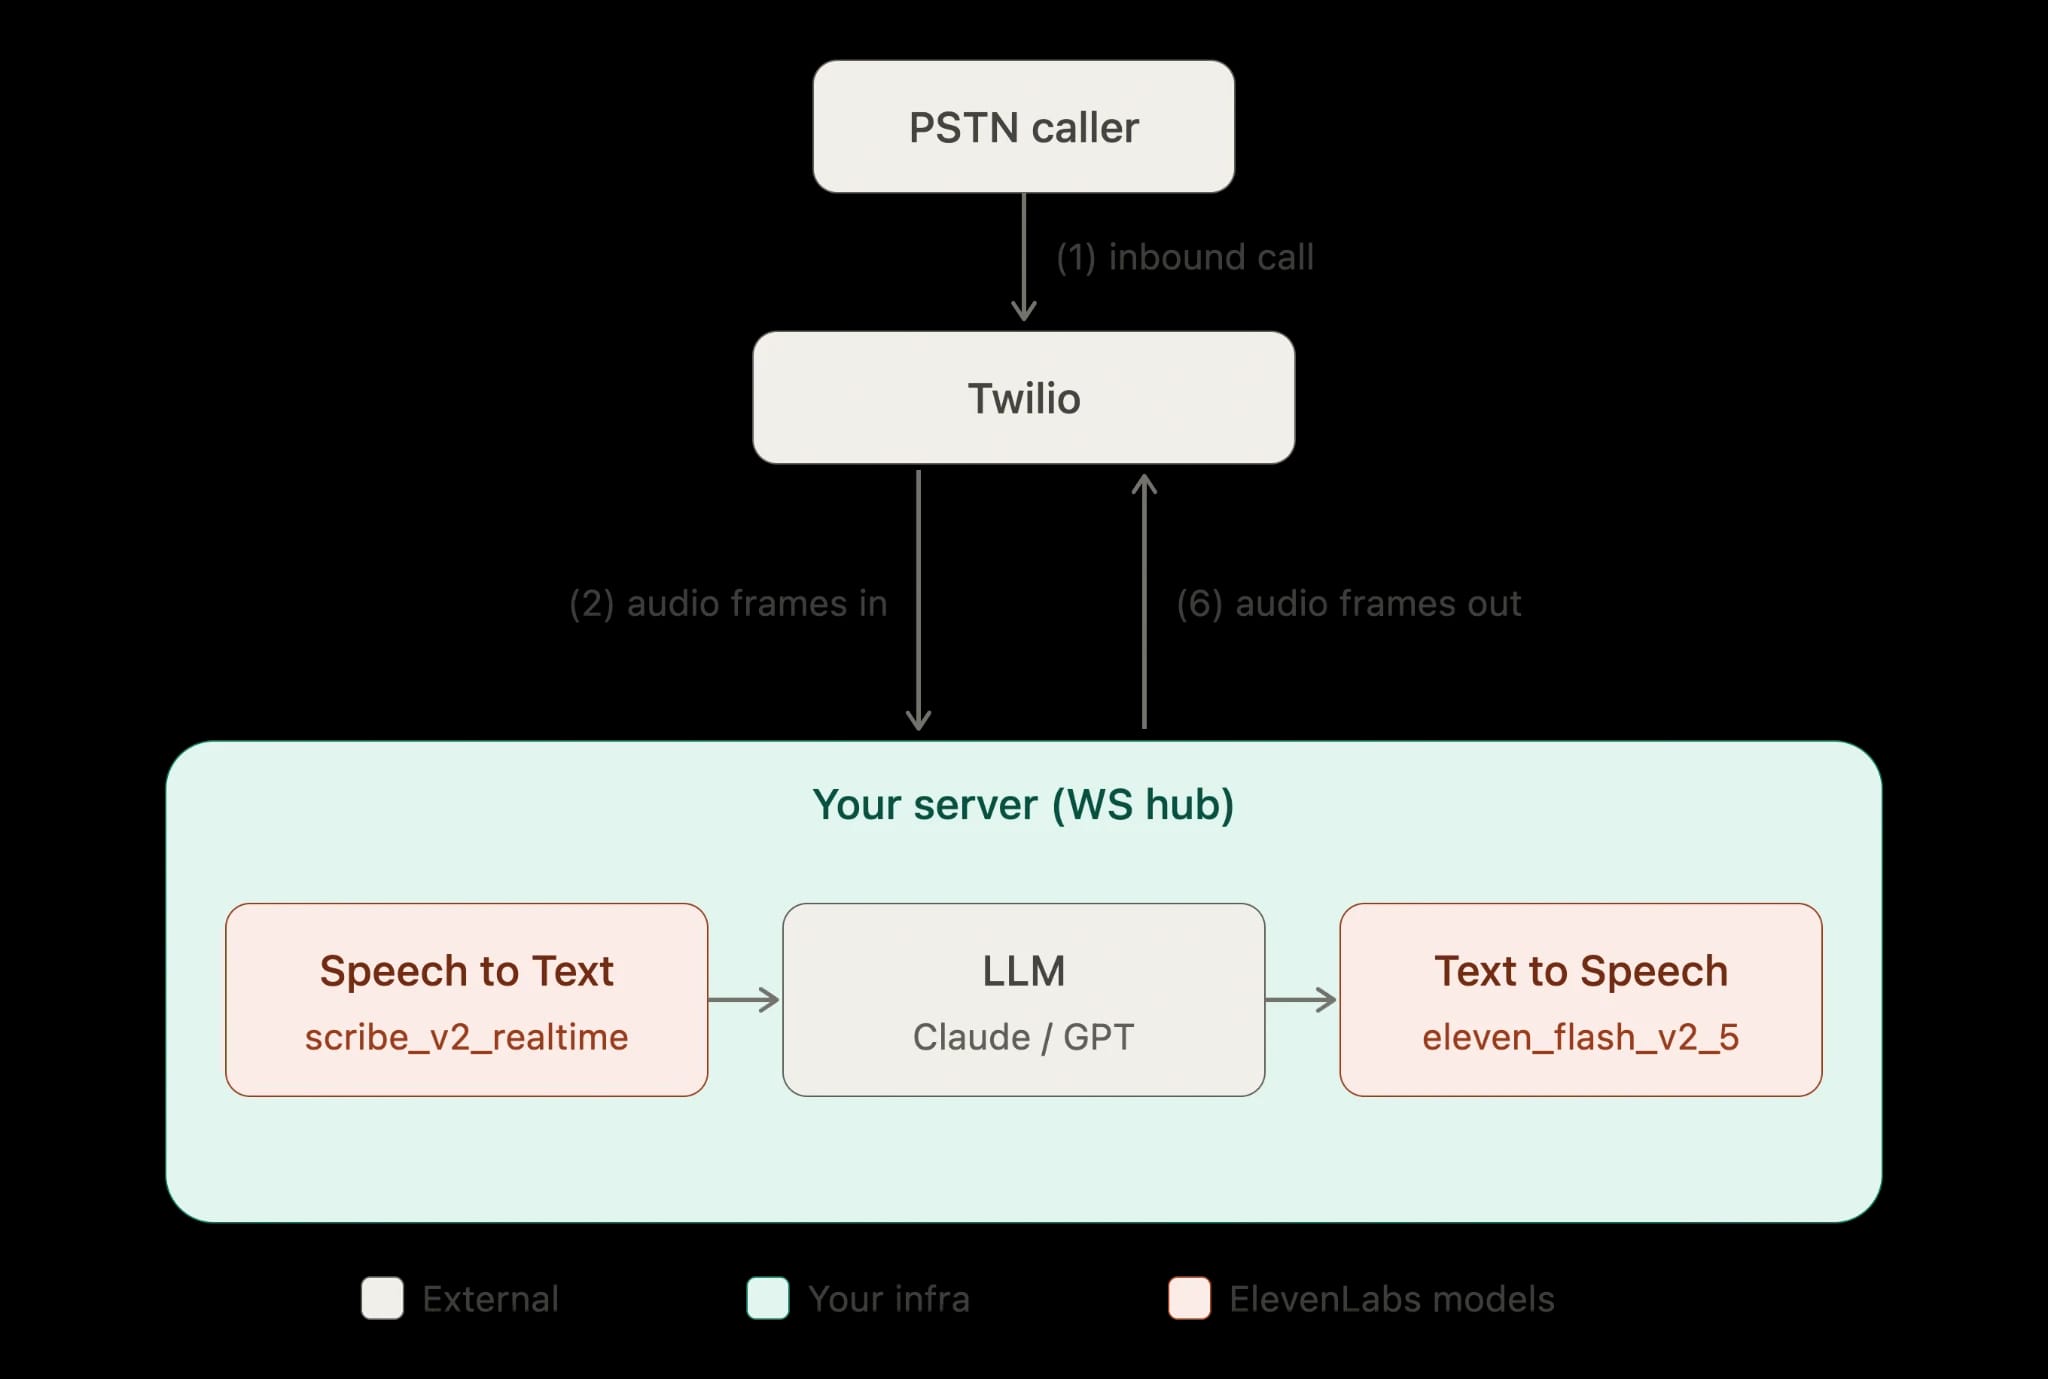
Ecco il flusso che userai per creare un agente vocale:
Un chiamante compone il tuo numero Twilio. Twilio recupera un documento TwiML dal tuo webhook. Il TwiML indica a Twilio di aprire un Media Stream verso il tuo endpoint WebSocket. Twilio trasmette l'audio in entrata come eventi JSON contenenti payload mu-law (ulaw_8000) in base64.
Il tuo server inoltra i chunk audio a Scribe v2 Realtime per la trascrizione in streaming. Quando termina il turno del chiamante, invii la trascrizione all'LLM e poi sintetizzi la risposta con Flash v2.5 in ulaw_8000. Invi quindi i frame mu-law sintetizzati a Twilio tramite il WebSocket, codificati in base64, e Twilio li riproduce al chiamante.
Scribe v2 Realtime genera trascrizioni parziali con una latenza di circa 150 ms e Flash v2.5 ha un'inferenza del modello di circa 75 ms, esclusa la latenza di rete e dell'applicazione. L'LLM è il contributore più rilevante e meno prevedibile al tempo del primo audio, ed è dove si concentra la maggior parte del budget di latenza. Per ridurre l'intervallo, trasmettiamo l'output dell'LLM token per token e iniziamo la sintesi prima che il modello abbia terminato la frase.
Per conoscere i compromessi tra i modelli alla base di queste scelte, consulta la panoramica dei modelli e la guida per comprendere la latenza.
Cosa ti serve prima di iniziare a creare un agente vocale
La guida presuppone che tu abbia quattro elementi pronti. Ciascuno è veloce da configurare, ma se ne manca anche uno il server non potrà avviarsi.
Ecco i prerequisiti da verificare:
- Un numero telefonico Twilio con funzionalità Voice: annota il numero insieme al tuo Account SID e Auth Token dalla console Twilio.
- Chiave API di ElevenLabs: creala nella dashboard di ElevenLabs. La chiave viene inviata nell'header xi-api-key ed è segreta, quindi conservala esclusivamente lato server. Consulta autenticazione API.
- Chiave API dell'LLM: questo tutorial considera Anthropic Claude e OpenAI come backend intercambiabili, quindi scegline uno.
- Ngrok (o qualsiasi tunnel) per lo sviluppo locale: Twilio deve raggiungere il tuo server tramite un URL HTTPS e WSS pubblico, e ngrok lo rende possibile senza distribuire nulla.
Imposta i segreti come variabili d'ambiente e non eseguirne mai il commit.
Quindi avvia un tunnel verso la porta che userà il tuo server:
Comprendere il protocollo Twilio Media Streams
Twilio non fornisce un socket audio raw. Incapsula invece tutto in un protocollo JSON strutturato tramite WebSocket. Capire i quattro tipi di evento e il formato di invio farà sì che l'handler WebSocket del Passaggio 2 sia del tutto chiaro prima di scriverlo.
Quando Twilio si connette al tuo WebSocket, invia una sequenza di messaggi di testo JSON, che possono avere quattro tipi di evento.
L'evento connected arriva per primo e conferma che il WebSocket è attivo. L'evento start viene inviato una volta all'avvio del media stream; contiene uno streamSid che devi memorizzare, perché ti serve per inviare l'audio di risposta, e include anche metadati della chiamata in start.customParameters e start.callSid.
L'evento media è ricorrente: media.payload è un chunk di audio mu-law a 8 kHz codificato in base64, di 20 ms per frame, e media.track è inbound per l'audio del chiamante. Infine, stop viene inviato alla fine dello stream, in genere perché la chiamata è stata chiusa.
Per riprodurre audio in risposta, invii un messaggio di tipo media con lo stesso streamSid e un payload mu-law in base64. Per interrompere l'audio che hai già messo in coda, invii un messaggio clear con lo streamSid, che svuota il buffer in uscita di Twilio.
Le codifiche in entrata e in uscita sono identiche (ulaw_8000). Richiediamo ulaw_8000 a ElevenLabs Text to Speech e inoltriamo i byte direttamente a Twilio senza alcun ricampionamento intermedio.
Passaggio 1: pubblica il webhook TwiML
Quando arriva una chiamata, Twilio invia una richiesta HTTP al tuo webhook e tu rispondi con un TwiML che collega la chiamata al tuo Media Stream. Il verbo <Connect><Stream> apre un WebSocket bidirezionale. Qui usa <Connect> anziché <Start>: mantiene attiva la chiamata per la durata dello stream e ti consente di inviare audio in risposta, che è lo scopo di questa configurazione.
Il TwiML restituito dal webhook è:
In Express, basta un singolo handler POST che inserisce l'host e restituisce il documento:
Nella console Twilio, imposta il webhook "A call comes in" del numero su https://your-subdomain.ngrok.app/incoming-call usando HTTP POST.
Passaggio 2: accetta il WebSocket Media Stream
L'handler WebSocket legge gli eventi Twilio, esegue la cascata e invia l'audio di risposta.
Manteniamo una piccola quantità di stato per chiamata: lo streamSid, una connessione STT e un flag che indica se l'agente sta parlando. L'handler decodifica ogni frame multimediale in entrata da base64 e inoltra i byte mu-law raw all'STT:
Passaggio 3: trascrivi con Scribe v2 Realtime
Scribe v2 Realtime accetta chunk audio in streaming e restituisce trascrizioni parziali e finali; supporta direttamente la codifica mu-law, quindi gli inviamo i frame di Twilio senza modificarli.
Offre anche Voice Activity Detection per la segmentazione basata sul silenzio e il controllo manuale del commit per finalizzare un segmento. Per un agente telefonico, la segmentazione basata sul VAD è in genere la scelta giusta perché una pausa naturale è il segnale più affidabile che il turno del chiamante sia terminato.
Ecco i passaggi: apri uno stream STT all'avvio della chiamata. Invia ogni chunk mu-law in entrata. Reagisci alle trascrizioni finalizzate richiamando l'LLM.
L'interfaccia del client STT realtime è ancora in evoluzione, quindi la struttura seguente è mantenuta dietro un piccolo adapter TypeScript (openRealtimeStt) che implementi rispetto all'API live, anziché a un insieme fisso di nomi dei campi. Considera onFinal come l'hook che passa un turno completo del chiamante alla fase successiva.
La latenza di riconoscimento realtime è di circa 150 ms per le trascrizioni parziali, riducendo il tempo percepito tra la fine del chiamante e l'inizio dell'agente. Per l'equivalente batch e tutte le funzionalità, consulta la documentazione Speech to Text e la pagina del prodotto Speech to Text realtime.
Passaggio 4: genera una risposta con un LLM
Questa è la fase che produce la risposta. L'LLM riceve la cronologia della conversazione e restituisce il testo dell'assistente. Trasmetti la risposta in streaming per poter iniziare la sintesi dalla prima frase.
Qui usiamo OpenAI come backend:
L'ID del modello precedente, gpt-4.1-mini, è un esempio di scelta a bassa latenza; claude-haiku-4-5 è un'opzione comparabile sul fronte Anthropic. Entrambi i provider possono supportare lo stesso contratto llmReply: sostituisci il body della funzione e il resto dell'agente rimane invariato.
Il system prompt limita la lunghezza delle risposte, un aspetto importante al telefono: le risposte lunghe sembrano lente e sono difficili da interrompere in modo naturale.
Passaggio 5: sintetizza con Flash TTS in ulaw_8000
Il testo ora deve diventare audio riproducibile da Twilio. Richiedi Flash v2.5 con outputFormat: "ulaw_8000" affinché i byte corrispondano alla codifica prevista da Twilio, quindi trasmetti l'audio in streaming e inoltra ogni chunk tramite il WebSocket come evento media.
Accumula i token dell'LLM in frammenti della lunghezza di una frase e sintetizza ogni frammento non appena è completato, anziché attendere l'intera risposta. Questo riduce il tempo del primo audio, perché il chiamante ascolta la prima frase mentre il modello sta ancora producendo la seconda. Per un controllo più approfondito della sintesi incrementale, la guida al WebSocket TTS realtime mostra come inserire testo in un unico socket di sintesi aperto; l'approccio HTTP streaming seguente è più semplice e adeguato per turni conversazionali brevi.
Rendere il tuo agente vocale IA adatto alla produzione
Dopo i cinque passaggi precedenti, hai un agente funzionante. Ma non equivale a una distribuzione in produzione.
Prima di mettere l'agente su una linea telefonica reale, devi considerare diverse questioni.
Convalida le firme dei webhook Twilio
Chiunque scopra l'URL del tuo webhook può inviare una richiesta POST, quindi il primo compito è confermare che la richiesta provenga davvero da Twilio. Twilio firma ogni richiesta con il tuo Auth Token nell'header X-Twilio-Signature e devi rifiutare tutto ciò che non supera la convalida. La firma viene calcolata sull'URL completo e sui parametri POST, quindi devi calcolarla nello stesso modo di Twilio.
L'helper di Twilio lo fa per te:
Gestisci correttamente i segreti
Conserva ELEVENLABS_API_KEY, la chiave dell'LLM e TWILIO_AUTH_TOKEN in un secrets manager, non nel codice sorgente né in file env in testo semplice sottoposti a commit in un repository. Limita la chiave di ElevenLabs ai soli endpoint necessari a questo servizio e assegnale una quota di crediti, così un'eventuale fuga di dati ha un impatto circoscritto anziché illimitato.
I piani Enterprise possono inoltre limitare una chiave a intervalli IP specifici tramite IP whitelisting. Questo server usa direttamente la chiave API perché non lascia mai il tuo backend; se parte della logica audio fosse spostata in un browser o in un client mobile, dovresti passare a token monouso affinché la chiave non venga mai esposta lato client.
Comprendi il limite di concorrenza
Ogni piano ha un limite di concorrenza diverso per famiglia di modelli, e il limite conta quante richieste stanno generando audio attivamente nello stesso momento.
Per un agente telefonico, questo conteggio è a tuo favore. La generazione audio è più veloce della riproduzione, quindi ogni chiamata usa la concorrenza TTS soltanto nelle brevi finestre in cui viene sintetizzata una risposta, non per l'intera durata della chiamata. Come stima approssimativa, un limite di concorrenza di circa cinque può supportare all'incirca 100 chiamate conversazionali simultanee, perché la generazione termina molto prima della riproduzione.
Tuttavia, monitora il margine disponibile invece di fare supposizioni. Le risposte di ElevenLabs espongono gli header current-concurrent-requests e maximum-concurrent-requests; registrali nei log e configura avvisi quando ti avvicini al massimo. Quando superi il limite, le richieste vengono accodate per priorità, aggiungendo in genere circa 50 ms, mentre un sovraccarico prolungato restituisce HTTP 429.
Gestisci le risposte HTTP 429 con un breve backoff. Se persistono, aumenta i limiti passando a un piano superiore dalla pagina dei prezzi oppure, per i clienti Enterprise, tramite il tuo account manager.
Gestisci barge-in e interruzioni
Un chiamante che inizia a parlare mentre l'agente sta parlando si aspetta che l'agente si fermi. Questo è il barge-in, e gestirlo correttamente è fondamentale per rendere un agente naturale anziché scriptato.
Rileva il parlato del chiamante durante la riproduzione dell'agente tramite il segnale VAD dell'STT. Quando lo rilevi, fai due cose. Prima, interrompi l'inoltro dei chunk TTS, operazione che il flag agentSpeaking in speak gestisce già interrompendo il loop. Poi invia a Twilio un messaggio clear per svuotare l'audio che hai già messo in coda dal suo lato.
Se ometti il clear, Twilio continua a riprodurre l'audio nel buffer dopo che hai smesso di inviarlo, e l'agente sembrerà parlare sopra il chiamante.
Registra, monitora e gestisci gli errori con continuità
Strumenta ogni fase per poter attribuire la latenza quando una chiamata sembra lenta. Misura l'intervallo dalla trascrizione finale al primo token dell'LLM, dal primo token dell'LLM al primo byte TTS e dal primo byte TTS al frame inviato a Twilio. Scoprirai che la maggior parte della latenza variabile è nella fase LLM; le fasi STT e TTS sono relativamente stabili.
Pianifica poi i fallimenti parziali. L'LLM può andare in timeout, lo stream STT può interrompersi e il round-trip di rete verso ElevenLabs varia approssimativamente da 20 a 200 ms sulla rete Internet pubblica, in base all'area geografica. Colloca il tuo server vicino ai chiamanti, non soltanto a ElevenLabs, dato che ElevenLabs instrada già verso il più vicino dei suoi cluster in Nord America, Europa e Sud-est asiatico.
Quando una fase fallisce, non lasciare il chiamante in silenzio: sintetizza una breve frase di fallback ("Mi dispiace, puoi ripeterlo?") e mantieni attiva la chiamata. Avvolgi ogni fase in un timeout e in un try/catch affinché un turno fallito non interrompa l'intero WebSocket.
Prima del rilascio, vale la pena impostare anche alcuni valori predefiniti:
- Limita la lunghezza della risposta nel system prompt, come mostrato, così i turni restano brevi e interrompibili.
- Limita la cronologia della conversazione affinché le chiamate lunghe non facciano crescere senza limiti il contesto dell'LLM.
- Imposta una durata massima della chiamata come protezione contro le sessioni bloccate che consumano silenziosamente concorrenza.
Per continuare a ottimizzare le parti che controlli, il documento sulla latenza spiega da dove proviene il tempo del primo audio, la panoramica dei modelli illustra i compromessi tra velocità e qualità, mentre la guida al WebSocket TTS realtime mostra come ridurre ulteriormente la latenza di sintesi con input di testo incrementale.
Crea agenti vocali pronti per la produzione con ElevenAPI
Ora che sono passati 20 minuti, hai tutti i livelli di un agente vocale pronto per la produzione. Twilio gestisce la telefonia, Scribe v2 Realtime trascrive, un LLM genera le risposte e Flash v2.5 risponde a voce tramite lo stesso WebSocket.
Se preferisci non gestire tu stesso la cascata, ElevenAgents offre turn-taking, gestione delle interruzioni e integrazione con la telefonia come servizio gestito, basato sugli stessi modelli che hai appena collegato manualmente.
Per continuare a ottimizzare uno stack che controlli, esplora la pagina del prodotto ElevenAPI per i piani, i limiti di concorrenza e la Voice Library. In alternativa, registrati e inizia oggi a effettuare la tua prima chiamata.
FAQ: creare un agente vocale con Twilio e ElevenLabs

Tadas Petra è Developer Relations Engineer e aiuta gli sviluppatori a creare con la suite di prodotti ElevenLabs. È anche il fondatore di Hungrimind, una piattaforma di formazione per sviluppatori. In passato è stato Lead Developer Advocate in Agora e docente presso Zero To Mastery.




