Creare Vibe Draw: combinare ElevenLabs con FLUX Kontext per creare immagini con la voce
- Scritto da
- Ryan Morrison
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Le interfacce vocali stanno cambiando il modo in cui comunichiamo con l'IA. E se creare un'immagine fosse facile come descriverla a voce?
È questa l'idea che mi ha portato a creare Vibe Draw come progetto del weekend. È uno strumento creativo incentrato sulla voce che combina la voce IA di ElevenLabs con FLUX Kontext di Black Forest Labs per trasformare i prompt vocali in immagini.
FLUX Kontext rappresenta una nuova classe di modelli per immagini. A differenza dei tradizionali sistemi text-to-image, Kontext gestisce sia la generazione sia la modifica. Può creare nuove immagini dai prompt, modificare quelle esistenti e persino unire più immagini di riferimento in un unico output.
Sebbene modelli come GPT-4o e Gemini 2 Flash offrano capacità multimodali, FLUX Kontext è progettato appositamente per la manipolazione visiva di alta qualità. Nei test, sono riuscito a modificare singole lettere in testi stilizzati o a riposizionare un oggetto, semplicemente descrivendo la modifica.
È allora che ho pensato: “Perché non farlo con la voce?” E quale base migliore della potente tecnologia vocale di ElevenLabs?

La sfida tecnica
Per creare un sistema di immagini guidato dalla voce è stato necessario risolvere cinque problemi chiave:
- Comprensione del linguaggio naturale — Distinguere tra nuove creazioni e modifiche
- Consapevolezza del contesto — Mantenere la continuità tra le interazioni
- Gestione dell'audio — Evitare risposte sovrapposte e gestire le code
- Generazione visiva — Passaggi fluidi tra generazione e modifica
- Esperienza utente — Rendere intuitive le interazioni avanzate con l'IA
Panoramica dell'architettura
Vibe Draw funziona interamente lato client e integra i seguenti componenti:
- Web Speech API per il riconoscimento vocale
- API TTS di ElevenLabs per le risposte vocali
- API FLUX Kontext per la generazione e la modifica delle immagini
- Rilevamento personalizzato dell'intento per comprendere l'input dell'utente
Questo approccio mantiene il prototipo leggero, ma per motivi di sicurezza le implementazioni in produzione dovrebbero inviare le richieste tramite un proxy lato server.
Implementare la voce con ElevenLabs
Vibe Draw usa l'API text-to-speech di ElevenLabs, ottimizzata per risposte conversazionali rapide:
Per creare varietà, le risposte vocali vengono selezionate casualmente da modelli predefiniti:
Gestire la riproduzione audio
Le risposte vocali sovrapposte interrompono l'illusione della conversazione. Vibe Draw risolve il problema con un sistema di coda audio:
Ogni messaggio viene riprodotto interamente prima di avviare il successivo.
Rilevamento dell'intento e gestione del contesto
Il sistema usa il rilevamento di parole chiave e del contesto per decidere se un prompt dell'utente è una richiesta di una nuova immagine o una modifica:
Questo approccio garantisce che le modifiche vengano applicate solo quando esiste già un'immagine e il contesto lo rende chiaro.
Generazione di immagini con FLUX Kontext
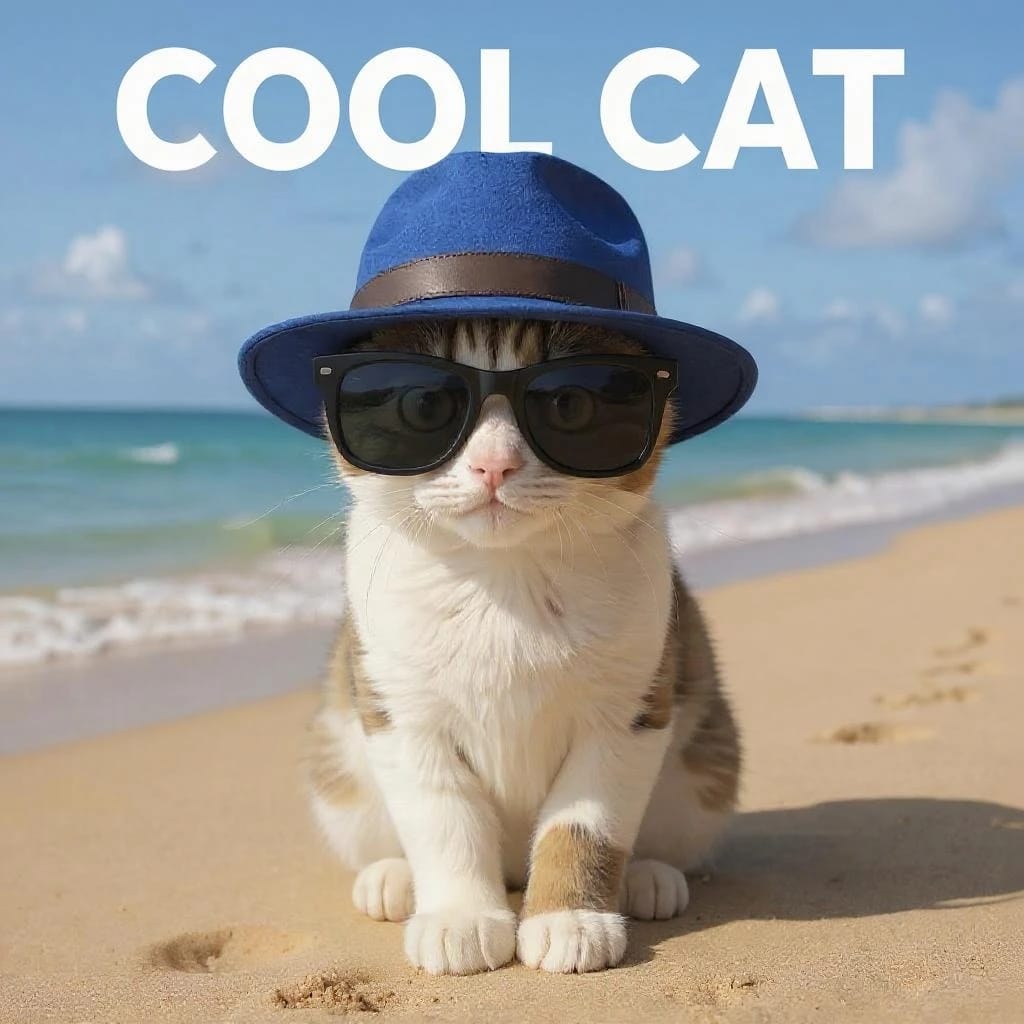
Kontext supporta due modalità: generazione e modifica.
Generazione (text to image)
Modifica (trasformazione contestuale)
Gestire trasformazioni complesse
Alcuni prompt implicano modifiche che superano i limiti dell'API di modifica. Quando le rileva, il sistema offre un'alternativa:
Ottimizzare l'esperienza
Feedback progressivo
Il feedback dell'interfaccia utente aiuta gli utenti a monitorare lo stato del sistema:
Tempistiche intelligenti
Una conversazione naturale richiede tempistiche naturali:
Stato della sessione
Per preservare il contesto, vengono memorizzati i dati della sessione:
Considerazioni sulle prestazioni
Per garantire la reattività:
- Caricamento differito — Inizializza le API solo quando necessario
- Debouncing — Limita le richieste API per interazione
- Gestione degli errori — Gestisci con eleganza timeout o errori
- Pulizia delle risorse — Elimina correttamente gli oggetti audio e gli event listener
I prossimi passi
Le UI conversazionali aprono la strada a nuove funzionalità:
- Input multimodale — “Fallo sembrare più simile a questa foto.”
- Sessioni collaborative — Più utenti contribuiscono a un unico design
- Memoria dello stile — Il sistema apprende la tua estetica nel tempo
- Streaming in tempo reale — Trasmetti gli aggiornamenti delle immagini mentre l'utente parla e integra l'IA conversazionale per abilitare il parlato in streaming.
Punti chiave
La creazione di Vibe Draw ha rivelato alcuni principi fondamentali per gli strumenti incentrati sulla voce:
- Il contesto è tutto — Monitorare lo stato rende le interazioni coerenti
- Le tempistiche danno personalità — Il ritmo delle risposte rende l'IA reattiva
- Le alternative mantengono lo slancio — Quando la generazione fallisce, offri delle alternative
- La varietà mantiene vivo l'interesse — Ripetere la stessa frase interrompe l'immersione
Conclusione
Vibe Draw mostra cosa succede quando l'IA vocale conversazionale incontra la creatività visiva. La sintesi vocale naturale di ElevenLabs e le API per immagini di FLUX Kontext si combinano per creare un nuovo modo di realizzare contenuti: niente clic, niente slider, solo voce.
Quando creare è facile quanto descrivere, eliminiamo le barriere tra immaginazione e realizzazione.
Provalo tu stesso
Il codice sorgente completo è disponibile su GitHub. Per eseguire la tua versione:
- Clona il repository
- Aggiungi la tua chiave API di ElevenLabs
- Aggiungi la tua chiave API di FAL.ai
- Apri vibe-draw-v2.html in un browser moderno
- Fai clic sul microfono e inizia a creare
Ti interessa creare la tua esperienza incentrata sulla voce? Esplora ElevenLabs Conversational AI o contattaci.
Ryan joined ElevenLabs after more than two decades in news and publishing, including roles at the BBC and Future Plc. He focuses on content strategy and storytelling, helping ElevenLabs shape and share its narrative.