

虚拟形象
虚拟形象
创建具有同步口型动作的持久视觉形象,用于制作人物口播视频。
概述
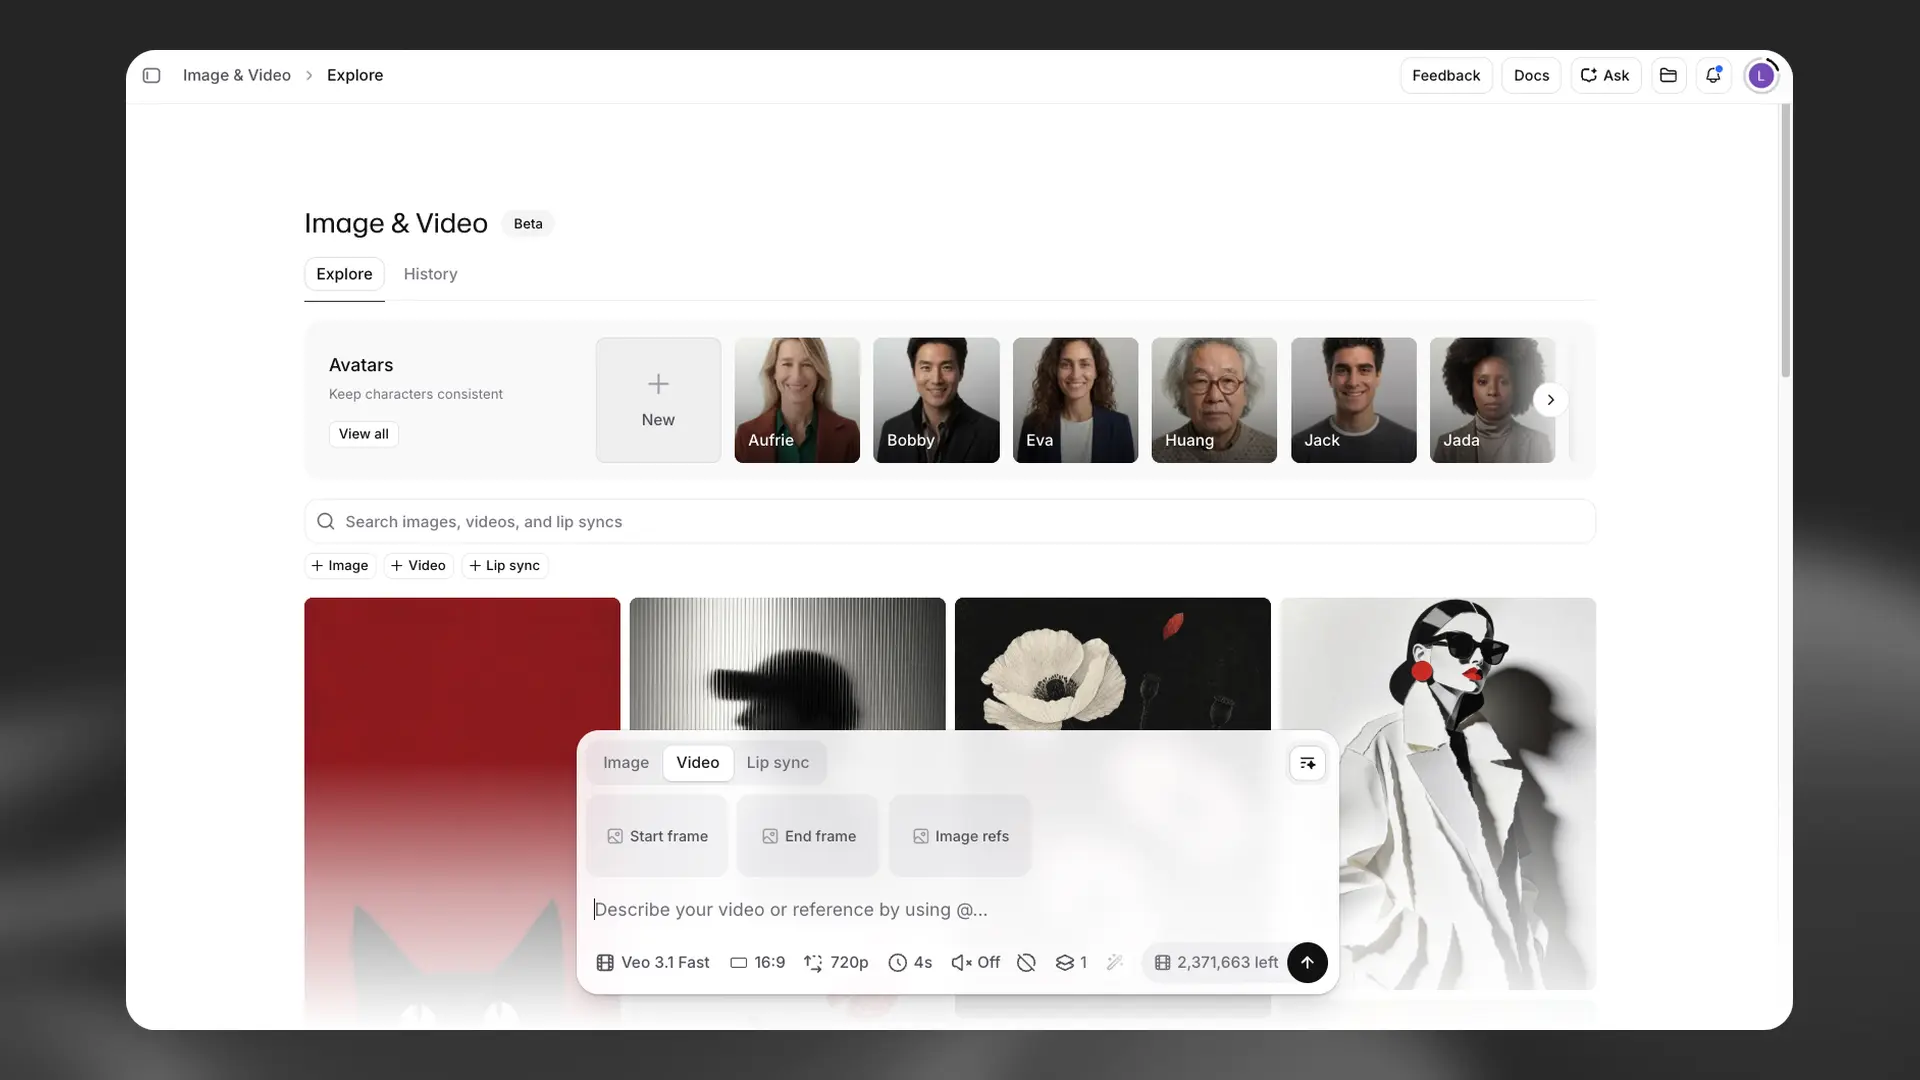
虚拟形象是持久的视觉身份,可将人物、角色或动物与任意 ElevenLabs 音色结合,生成口型同步的人物口播视频。一次创建可重复使用的身份,并将其与任意音色或脚本搭配,批量制作风格一致的视频内容。
所有付费套餐均可使用虚拟形象。
受监管或服务商要求影响,部分 Avatar 模型和参考图片上传功能在美国受到 限制。
主要功能
- 持久身份:一次创建虚拟形象,可在不限数量的视频中重复使用
- 灵活配音:任意虚拟形象均可搭配声音库中的任意音色,包括克隆音色
- 风格变体:基于单个虚拟形象生成多种风格,包括不同角度、服装、背景或光线
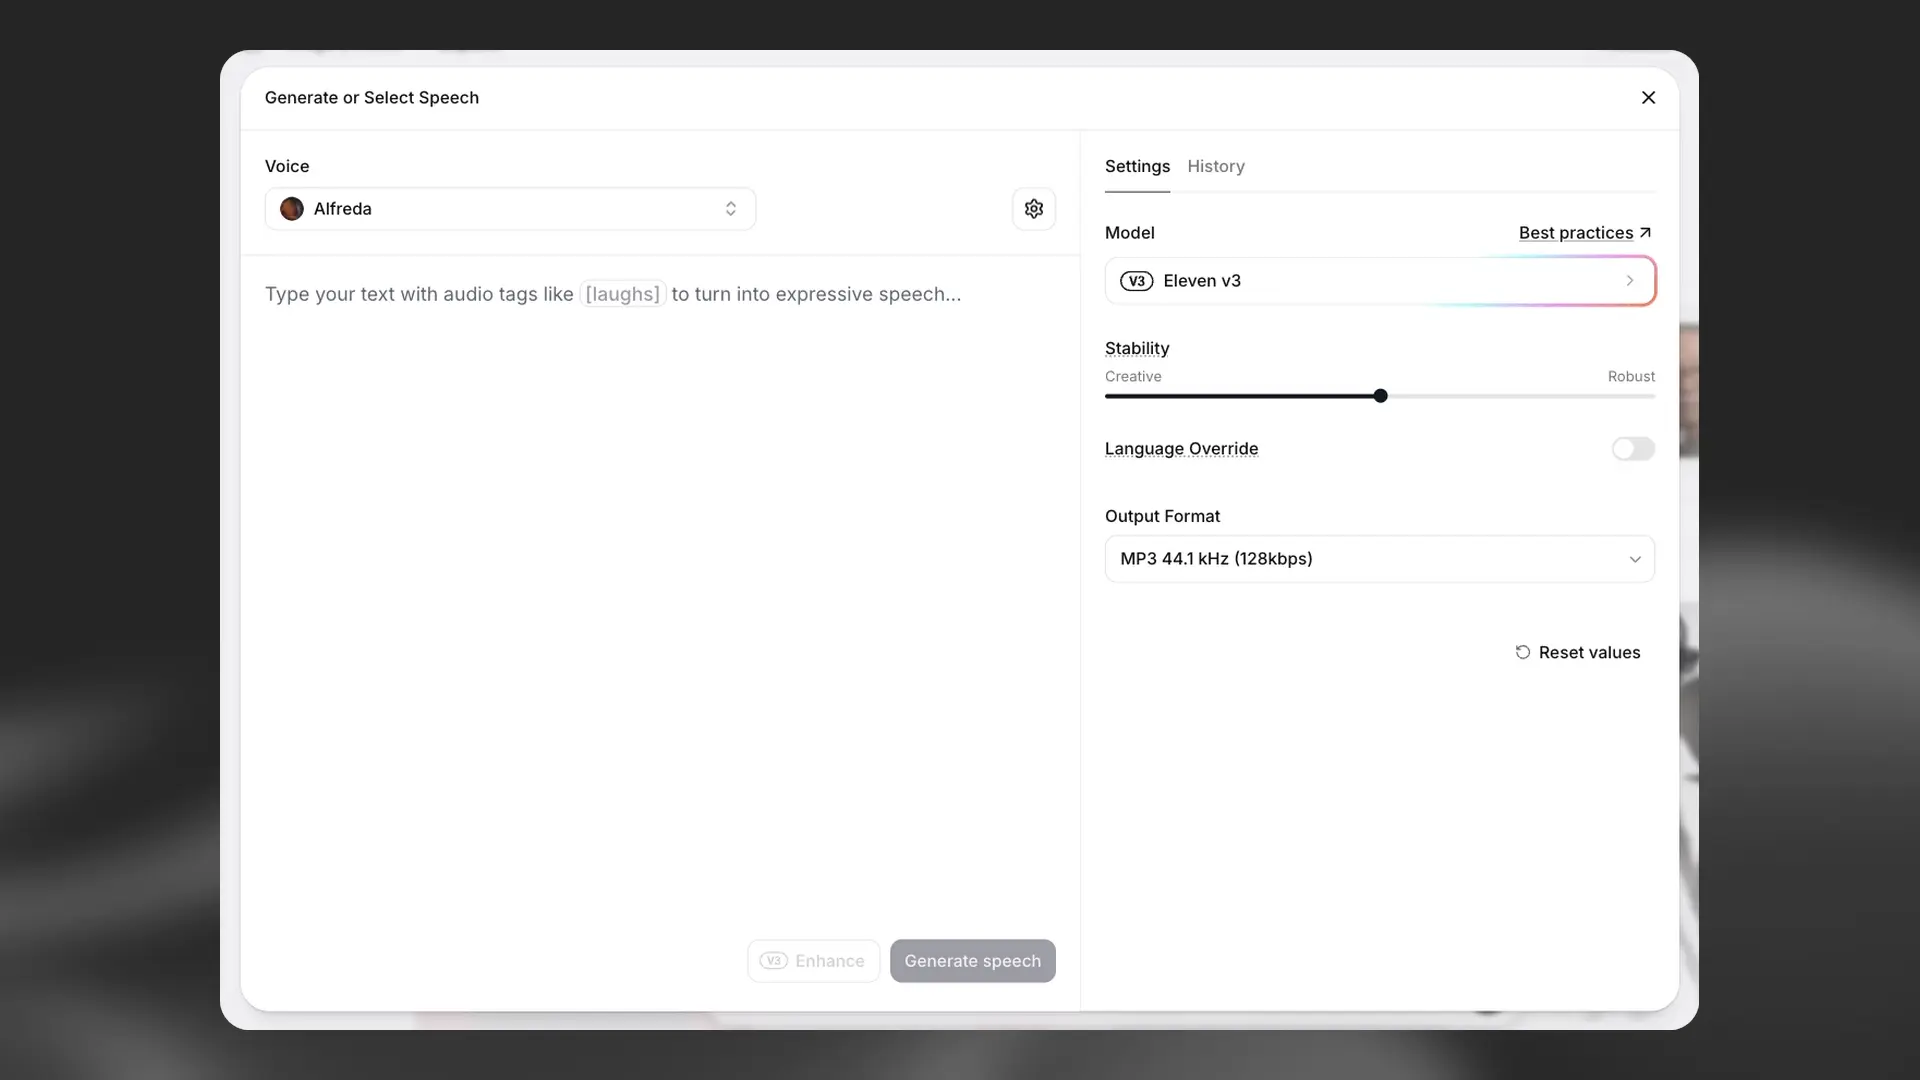
- 集成文本转语音:直接在虚拟形象界面中将文本转换为语音
- Flows 集成:通过 Avatar 节点自动批量生成虚拟形象视频
- 多种口型同步模型:平台会根据输入格式和质量要求自动选择最佳模型
创建虚拟形象
通过参考图片或文本提示词生成新的虚拟形象:
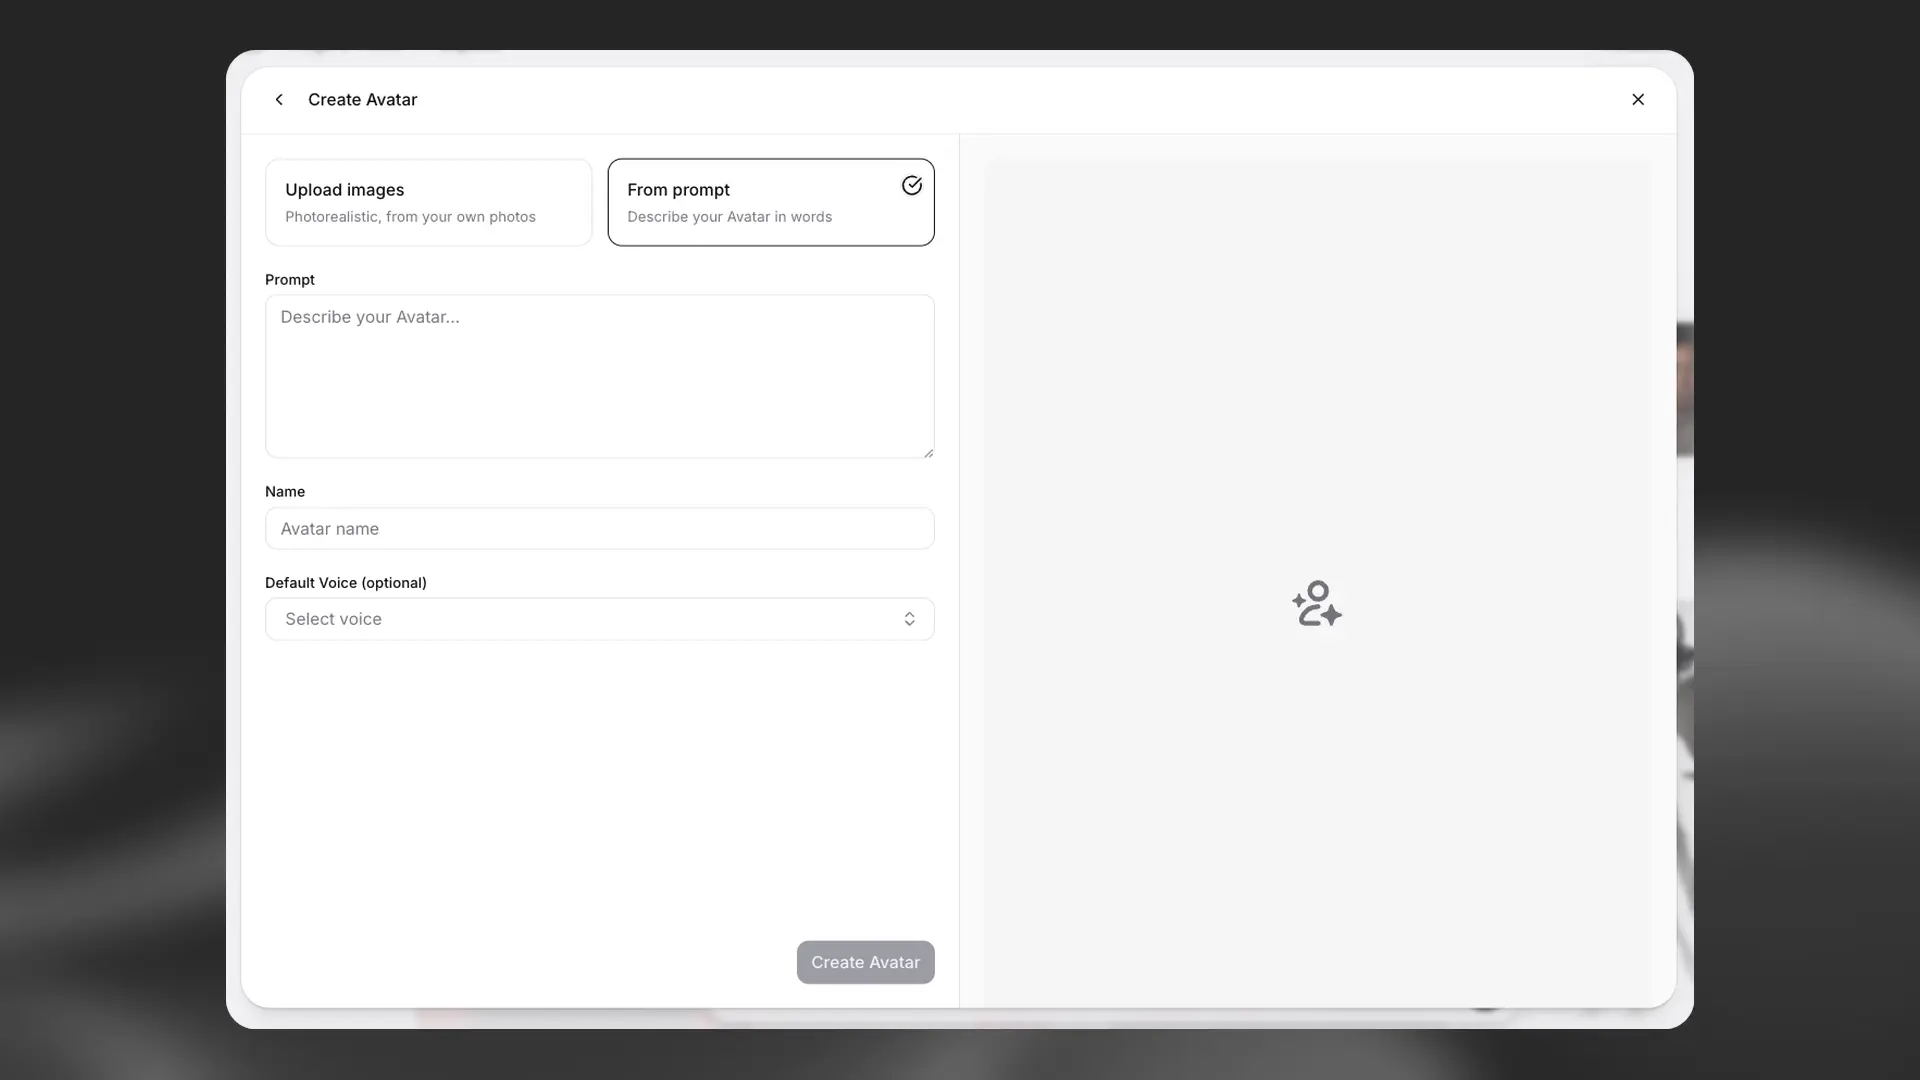
创建后,虚拟形象会显示在声音库中,可用于各个项目。
风格
风格是现有虚拟形象的变体,代表不同的视觉场景:
- 镜头角度和构图
- 服装和配饰
- 背景和环境
- 光照条件
创建风格
要为现有虚拟形象创建风格,请点击 查看虚拟形象,再点击“新建风格”。
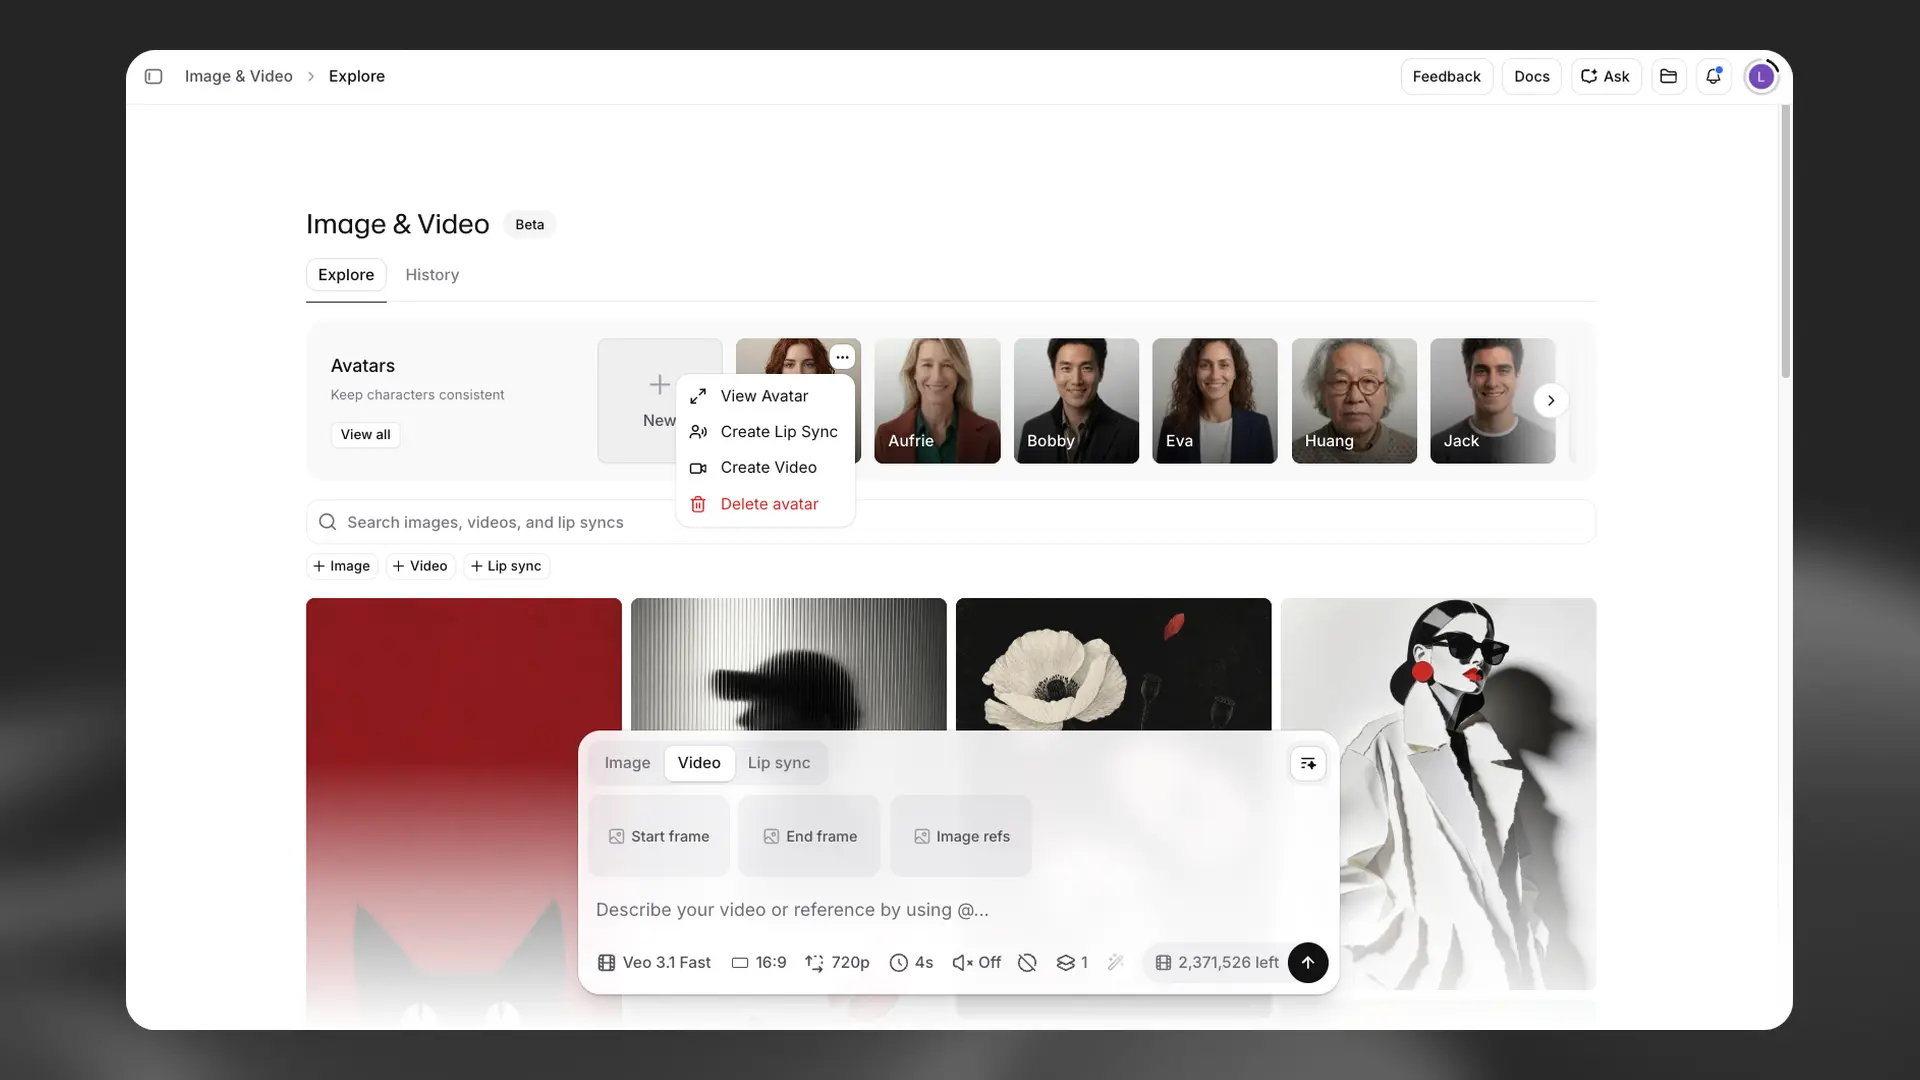
可通过两种方式创建风格:
提示词:使用文本提示词描述新风格。
上传:上传参考图片,在保持核心身份的同时引导新风格。
风格让你无需重新生成整个虚拟形象,即可在不同场景中保持品牌一致性。
生成视频
将任意虚拟形象与音色和脚本配对,生成口播视频:
Flows 集成
Flows 中的 Avatar 节点支持自动批量生成虚拟形象视频。
使用场景包括:
- 使用动态脚本的个性化视频活动
- 保持品牌一致性的批量视频生成
- 支持替换音色和视觉内容的自动化内容流程
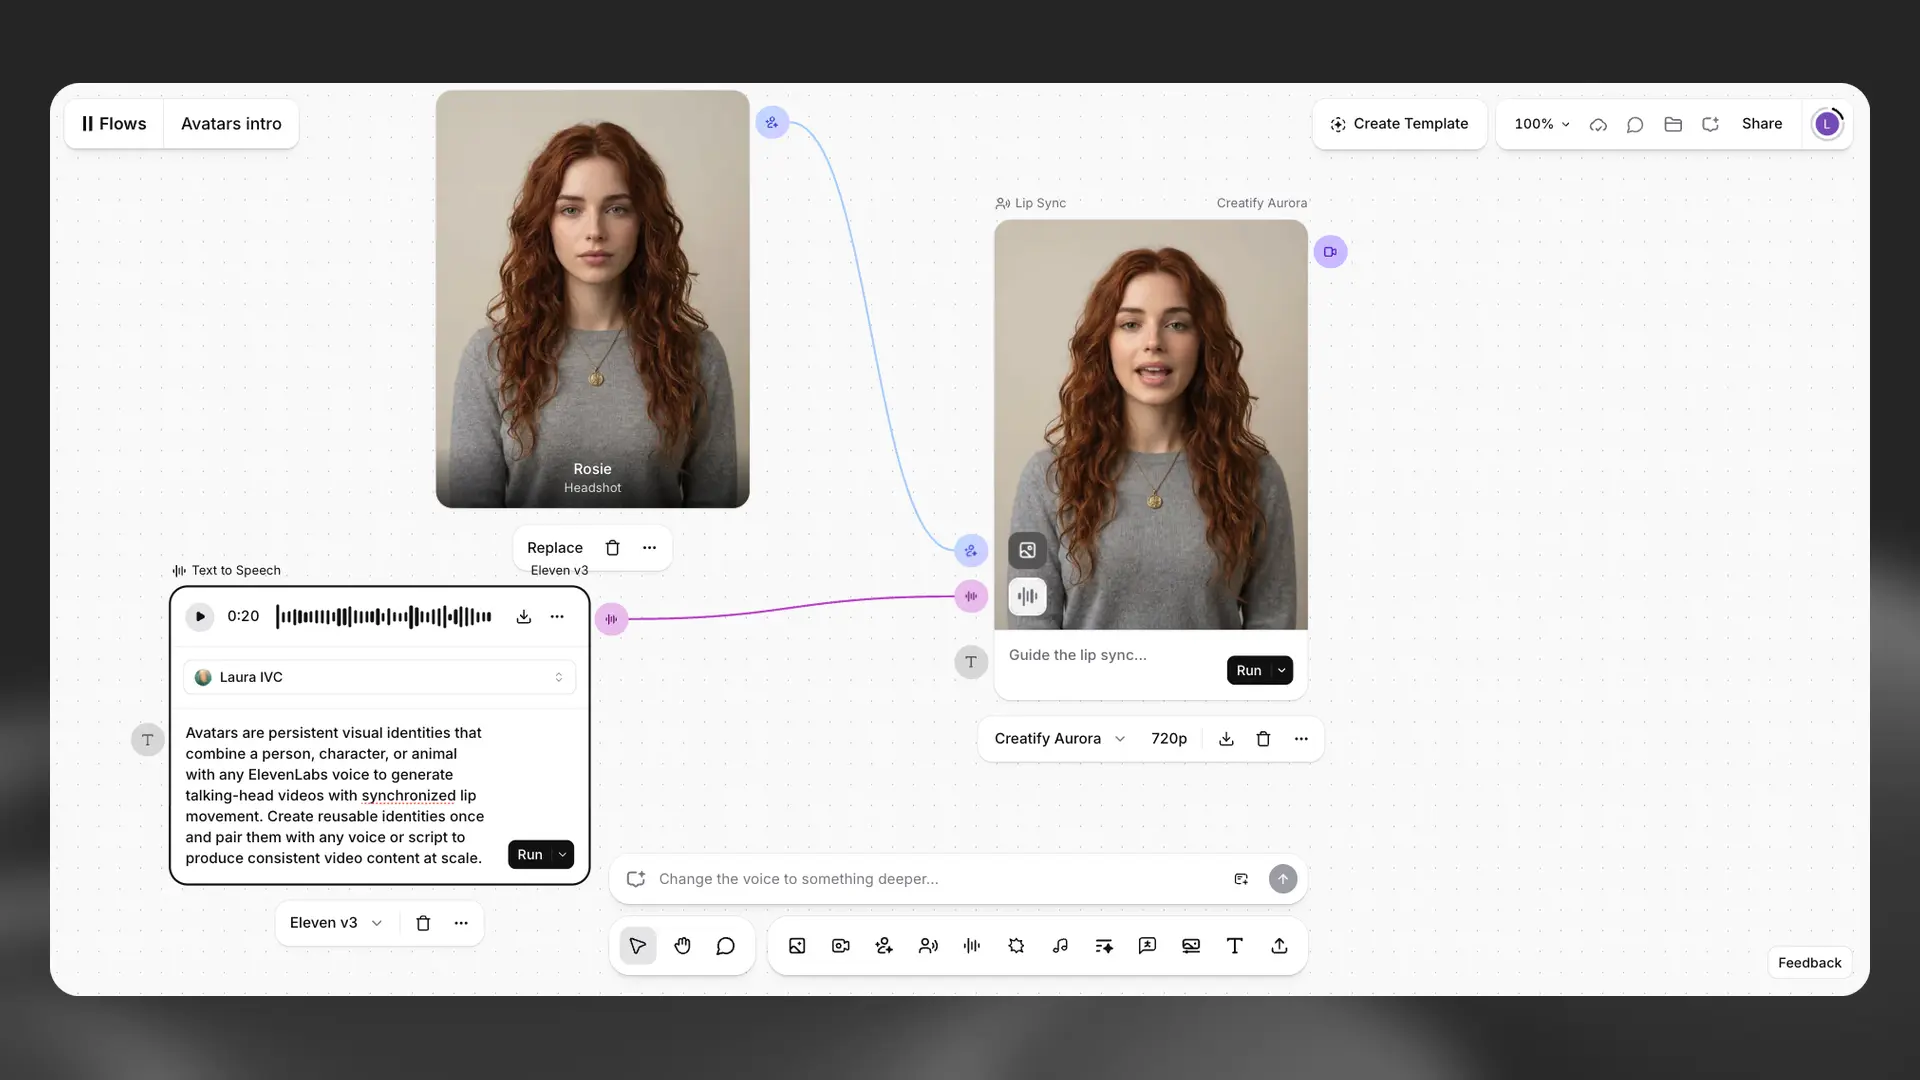
了解更多 Flows。
点数费用
虚拟形象生成遵循现有的 Image & Video 定价结构。费用因以下因素而异:
- 所选口型同步模型
- 输出分辨率
- 视频时长
每次生成都会扣除相应点数。可在 用量分析中查看用量。
关键信息
- 可用性:所有付费套餐
- 口型同步模型:平台自动选择最佳模型
- 音色兼容性:支持所有 ElevenLabs 音色,包括克隆音色
- 可重复使用:虚拟形象和风格可在不限次数的生成中持续使用
- Flows 支持:可作为 Avatar 节点用于自动化
- API 访问:上线时暂不提供,计划在未来发布