
Erstellen Sie in 20 Minuten einen Voice-Agenten mit ElevenLabs und Twilio
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Ein Sprachagent kann eingehende Anrufe annehmen, Anrufer mit Speech to Text (STT) in Echtzeit transkribieren, mit einem Large Language Model (LLM) eine Antwort generieren und über ein Text to Speech (TTS)-Modul antworten. Mit ElevenLabs und Twilio haben Sie in etwa 20 Minuten einen funktionsfähigen Agenten unter einer echten Telefonnummer.
Für Entwickler umfasst der verwendete Stack ElevenLabs für Sprachsynthese (Flash v2.5) und Transkription (Scribe v2 Realtime), Twilio für Telefonie sowie OpenAI oder Anthropic als LLM. Alle diese Komponenten sind austauschbar. Sie können also die Komponenten wählen, mit denen Sie am besten vertraut sind.
Dieser Artikel zeigt, wie Sie mit Node.js und TypeScript in 20 Minuten einen Sprachagenten erstellen. Wenn Sie eine verwaltete Alternative suchen, die Sprecherwechsel, Unterbrechungen und Telefonie ohne eigene Pflege der Kaskade übernimmt, besuchen Sie ElevenAgents.
So funktioniert die Architektur eines Sprachagenten
Bevor Sie Code schreiben, hilft es zu verstehen, wie die drei Dienste in Ihrem Tech-Stack verbunden sind.
- Twilio: Verwaltet den Anruf und den Audiotransport.
- ElevenLabs: Verwaltet STT über Scribe v2 Realtime und TTS über Flash v2.5.
- LLM: Verwaltet Tool Calling und erstellt die Antwort.
Jede Stufe ist ein schlanker Adapter. Deshalb können Sie einen Dienst durch einen anderen ersetzen, ohne den Rest anzupassen. Sie könnten beispielsweise das OpenAI-LLM gegen Anthropic austauschen, ohne Ihre anderen Komponenten neu schreiben zu müssen.
Ein Anruf erreicht Ihren Server über Twilio. Twilio nimmt den PSTN-Anruf an, öffnet einen WebSocket zu Ihrem Server und leitet die Anrufer-Audiodaten als Stream Base64-codierter Mu-Law-Frames weiter. Ihr Server führt die Kaskade aus und streamt synthetisierte Audiodaten über denselben WebSocket zurück. Twilio spielt sie dem Anrufer ab.
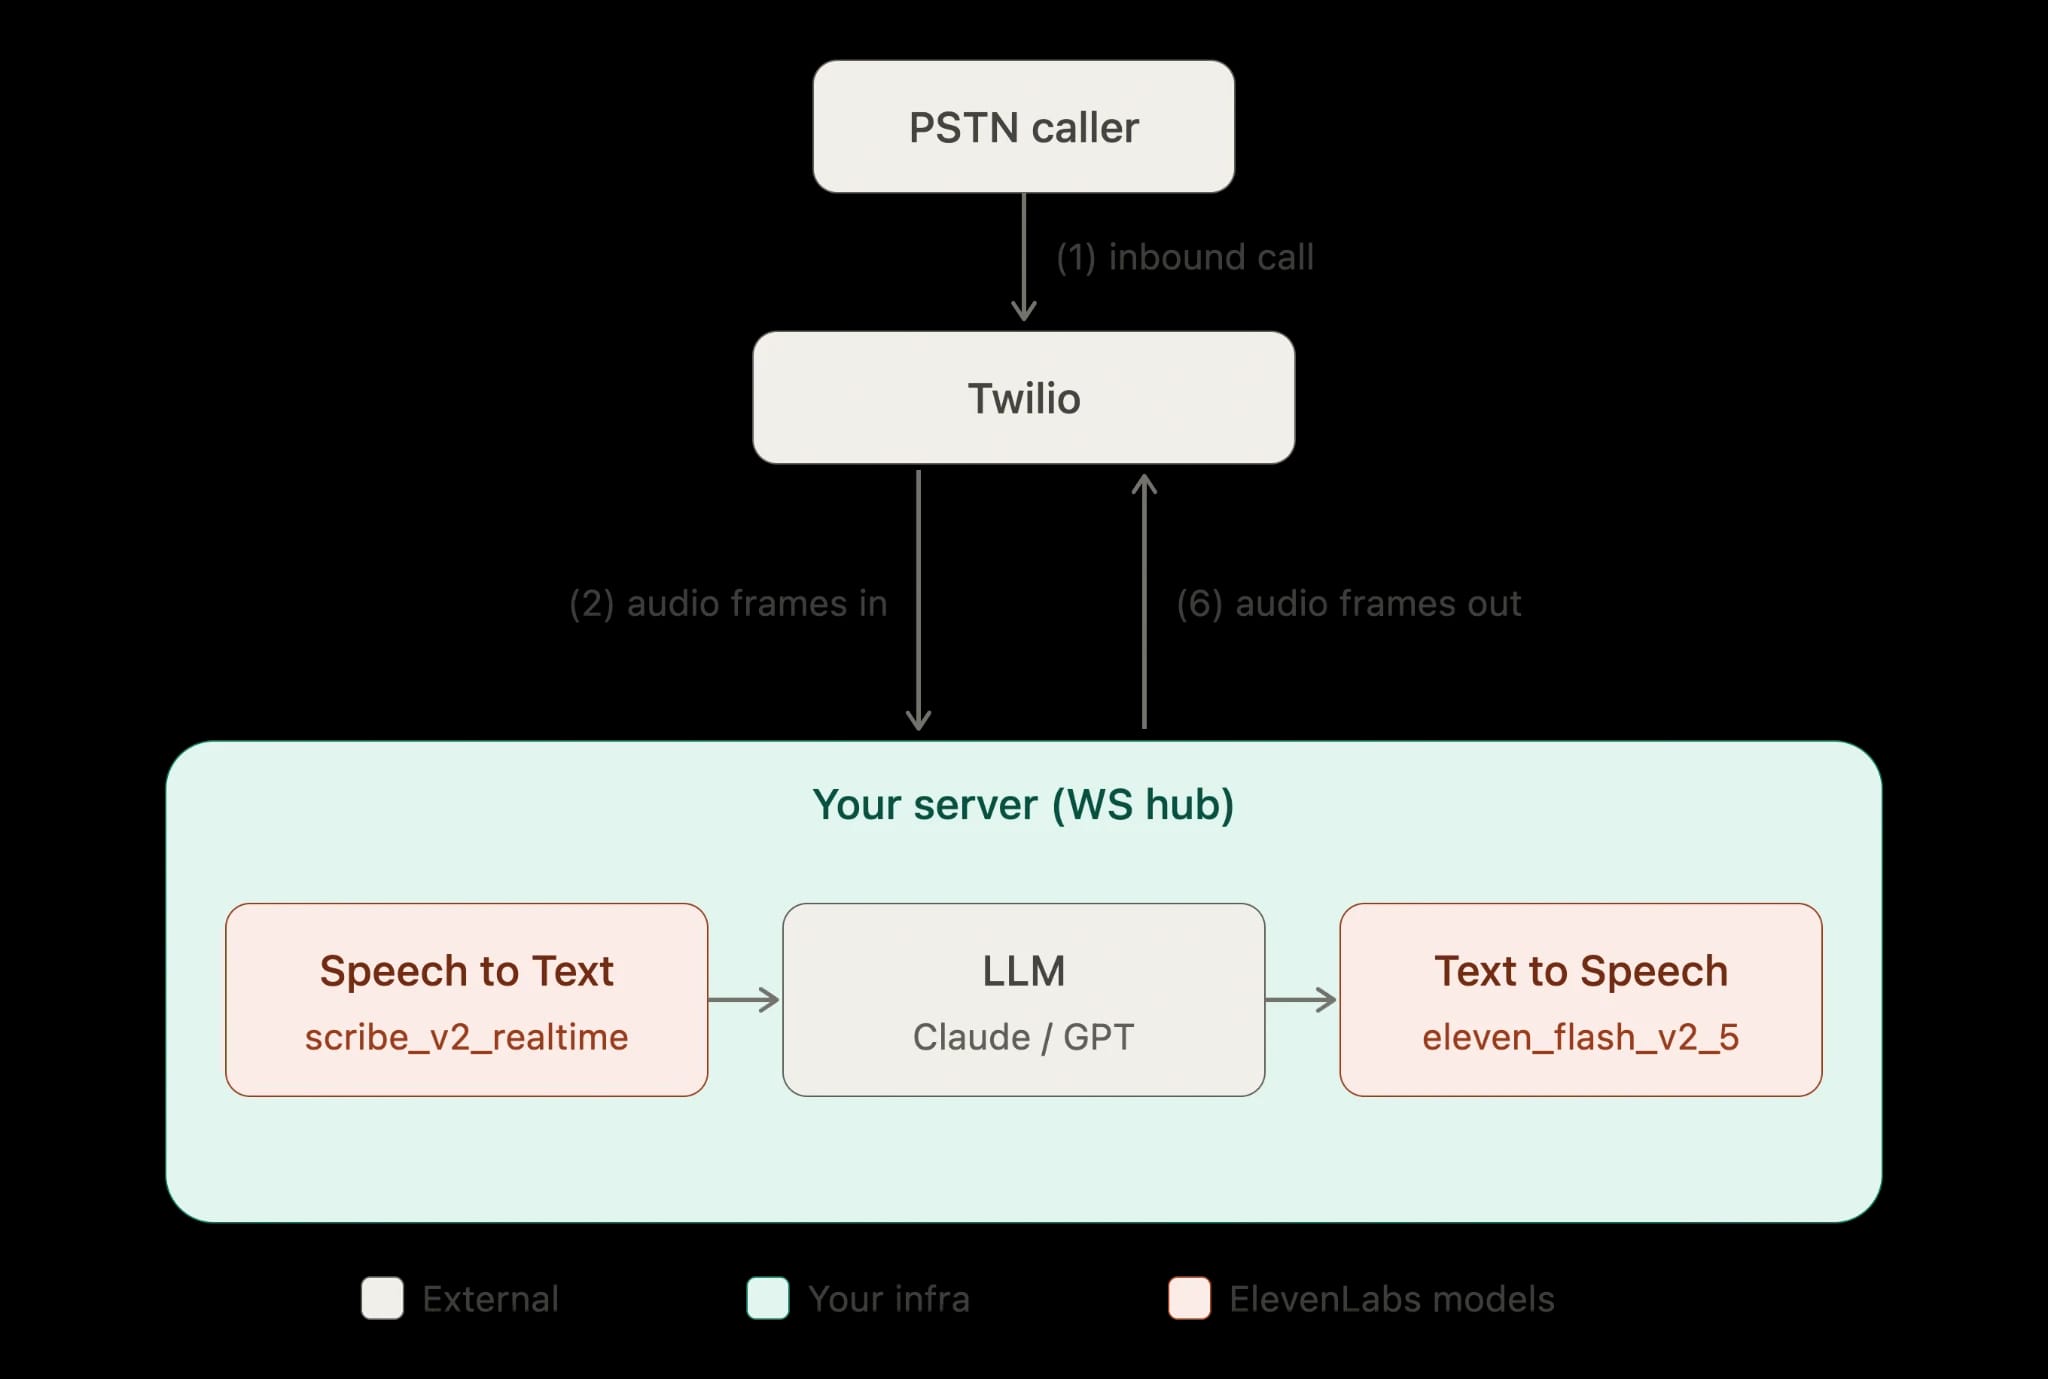
So sieht der Ablauf aus, mit dem Sie einen Sprachagenten erstellen:
Ein Anrufer wählt Ihre Twilio-Nummer. Twilio ruft ein TwiML-Dokument von Ihrem Webhook ab. Das TwiML weist Twilio an, einen Media Stream zu Ihrem WebSocket-Endpunkt zu öffnen. Twilio streamt eingehende Audiodaten als JSON-Ereignisse mit Base64-Mu-Law-Payloads (ulaw_8000).
Ihr Server leitet Audio-Chunks zur Streaming-Transkription an Scribe v2 Realtime weiter. Wenn ein Sprecherzug des Anrufers abgeschlossen ist, senden Sie das Transkript an das LLM und synthetisieren dann die Antwort mit Flash v2.5 in ulaw_8000. Sie senden die synthetisierten Mu-Law-Frames Base64-codiert über den WebSocket zurück an Twilio, das sie dem Anrufer abspielt.
Scribe v2 Realtime liefert Teiltranskriptionen mit etwa 150 ms Latenz, und Flash v2.5 benötigt ungefähr 75 ms Modellsinferenz, ohne Netzwerk- und Anwendungslatenz. Das LLM ist der größte und am wenigsten vorhersehbare Faktor für die Zeit bis zum ersten Audio und beansprucht den größten Teil des Latenzbudgets. Um die Verzögerung kurz zu halten, streamen wir die LLM-Ausgabe Token für Token und beginnen mit der Synthese, bevor das Modell seinen Satz beendet hat.
Mehr zu den Modellabwägungen hinter diesen Entscheidungen finden Sie in der Modellübersicht und im Beitrag zum Verständnis von Latenz.
Was Sie vor dem Erstellen eines Sprachagenten benötigen
Dieser Leitfaden setzt voraus, dass Sie vier Voraussetzungen erfüllen. Alle sind schnell eingerichtet, aber fehlt eine davon, kann der Server nicht ausgeführt werden.
Prüfen Sie diese Voraussetzungen:
- Eine Twilio-Telefonnummer mit Voice-Funktion: Notieren Sie die Nummer zusammen mit Ihrer Account SID und Ihrem Auth Token aus der Twilio-Konsole.
- ElevenLabs-API-Schlüssel: Er wird in Ihrem ElevenLabs-Dashboard erstellt. Der Schlüssel wird im Header xi-api-key übertragen und ist geheim. Bewahren Sie ihn daher ausschließlich serverseitig auf. Siehe API-Authentifizierung.
- LLM-API-Schlüssel: Dieses Tutorial behandelt Anthropic Claude und OpenAI als austauschbare Backends. Wählen Sie eines davon.
- Ngrok (oder ein anderer Tunnel) für die lokale Entwicklung: Twilio muss Ihren Server über eine öffentliche HTTPS- und WSS-URL erreichen, und ngrok ermöglicht das ohne Deployment.
Legen Sie Ihre Geheimnisse als Umgebungsvariablen fest und committen Sie sie niemals.
Starten Sie dann einen Tunnel zum Port, den Ihr Server verwendet:
Das Twilio-Media-Streams-Protokoll verstehen
Twilio stellt keinen unverarbeiteten Audio-Socket bereit. Stattdessen kapselt es alles in einem strukturierten JSON-Protokoll über WebSocket. Wenn Sie die vier Ereignistypen und das Sendeformat verstehen, ergibt der WebSocket-Handler in Schritt 2 bereits vor dem Schreiben Sinn.
Sobald Twilio sich mit Ihrem WebSocket verbindet, sendet es eine Folge von JSON-Textnachrichten mit vier möglichen Ereignistypen.
Das Ereignis connected trifft zuerst ein und bestätigt, dass der WebSocket aktiv ist. Das Ereignis start wird beim Beginn des Media Streams einmal gesendet. Es enthält eine streamSid, die Sie speichern müssen, um Audio zurückzusenden, sowie Anrufmetadaten unter start.customParameters und start.callSid.
Das Ereignis media tritt wiederholt auf: media.payload ist ein Base64-codierter Chunk mit 8-kHz-Mu-Law-Audio, 20 ms pro Frame, und media.track ist für Anrufer-Audio inbound. Abschließend wird stop gesendet, wenn der Stream endet, typischerweise weil der Anruf beendet wurde.
Um Audio zurückzuspielen, senden Sie eine Nachricht vom Typ media mit derselben streamSid und einer Base64-Mu-Law-Payload. Um bereits eingereihtes Audio zu unterbrechen, senden Sie eine clear-Nachricht mit der streamSid. Dadurch wird Twilios ausgehender Puffer geleert.
Die Ein- und Ausgangscodierung ist identisch (ulaw_8000). Wir fordern ulaw_8000 von ElevenLabs Text to Speech an und leiten die Bytes ohne Zwischenschritt zur erneuten Abtastung direkt an Twilio weiter.
Schritt 1: Den TwiML-Webhook bereitstellen
Bei einem eingehenden Anruf stellt Twilio eine HTTP-Anfrage an Ihren Webhook, und Sie antworten mit TwiML, das den Anruf mit Ihrem Media Stream verbindet. Das Verb <Connect><Stream> öffnet einen bidirektionalen WebSocket. Verwenden Sie hier <Connect> statt <Start>: Es hält den Anruf während des Streams aktiv und ermöglicht das Zurücksenden von Audio – genau dafür ist dieses Setup gedacht.
Der vom Webhook zurückgegebene TwiML-Code lautet:
In Express genügt dafür ein einzelner POST-Handler, der den Host einfügt und das Dokument zurückgibt:
Legen Sie in der Twilio-Konsole den Webhook „A call comes in“ der Nummer auf https://your-subdomain.ngrok.app/incoming-call mit HTTP POST fest.
Schritt 2: Den Media-Stream-WebSocket akzeptieren
Der WebSocket-Handler liest Twilio-Ereignisse, steuert die Kaskade und schreibt Audio zurück.
Wir speichern eine kleine Menge zustandsbezogener Daten pro Anruf: die streamSid, eine STT-Verbindung und ein Flag, das angibt, ob der Agent gerade spricht. Der Handler decodiert jeden eingehenden Media-Frame aus Base64 und leitet die rohen Mu-Law-Bytes an STT weiter:
Schritt 3: Mit Scribe v2 Realtime transkribieren
Scribe v2 Realtime akzeptiert Streaming-Audio-Chunks und liefert Teil- sowie finale Transkriptionen. Da Mu-Law-Codierung direkt unterstützt wird, übergeben wir Twilios Frames unverändert.
Es bietet außerdem Voice Activity Detection für Segmentierung anhand von Stille und manuelle Commit-Steuerung zum Abschließen eines Segments. Für einen Telefonagenten ist VAD-gesteuerte Segmentierung meist die richtige Wahl, da eine natürliche Pause das zuverlässigste Signal für das Ende eines Sprecherzugs ist.
Die Schritte: Öffnen Sie beim Anrufbeginn einen STT-Stream. Übermitteln Sie jeden eingehenden Mu-Law-Chunk. Reagieren Sie auf finale Transkripte, indem Sie das LLM aufrufen.
Die Schnittstelle des Echtzeit-STT-Clients entwickelt sich noch weiter. Daher liegt die untenstehende Form hinter einem kleinen TypeScript-Adapter (openRealtimeStt), den Sie gegen die Live-API statt gegen einen festen Satz von Feldnamen implementieren. Betrachten Sie onFinal als Hook, der einen abgeschlossenen Sprecherzug an die nächste Stufe übergibt.
Die Latenz der Echtzeiterkennung für Teiltranskripte beträgt etwa 150 ms. Dadurch bleibt die wahrgenommene Pause zwischen dem Ende des Anrufers und dem Start des Agenten kurz. Die Batch-Variante und den vollständigen Funktionsumfang finden Sie in der Speech-to-Text-Dokumentation und auf der Produktseite für Echtzeit-Speech-to-Text.
Schritt 4: Eine Antwort mit einem LLM generieren
In dieser Stufe wird die Antwort erzeugt. Das LLM verarbeitet den Gesprächsverlauf und gibt den Text des Assistenten zurück. Streamen Sie die Antwort, damit Sie mit der Synthese beim ersten Satz beginnen können.
Hier wird OpenAI als Backend verwendet:
Die obige Modell-ID gpt-4.1-mini ist ein Beispiel für eine latenzarme Wahl; claude-haiku-4-5 ist eine vergleichbare Option von Anthropic. Beide Anbieter können denselben llmReply-Vertrag erfüllen. Tauschen Sie den Funktionsrumpf aus, der Rest des Agenten bleibt unverändert.
Der System-Prompt begrenzt die Antwortlänge. Das ist beim Telefonieren wichtig: Lange Antworten wirken langsam und lassen sich nur schwer natürlich unterbrechen.
Schritt 5: Mit Flash TTS in ulaw_8000 synthetisieren
Der Text muss nun zu Audio werden, das Twilio abspielen kann. Fordern Sie Flash v2.5 mit outputFormat: „ulaw_8000“ an, damit die Bytes Twilios erwarteter Codierung entsprechen. Streamen Sie dann das Audio und leiten Sie jeden Chunk als media-Ereignis über den WebSocket zurück.
Sammeln Sie LLM-Token in satzgroßen Fragmenten und synthetisieren Sie jedes Fragment, sobald es fertig ist, statt auf die gesamte Antwort zu warten. Das verkürzt die Zeit bis zum ersten Audio, weil der Anrufer den ersten Satz hört, während das Modell noch den zweiten erzeugt. Für eine präzisere Steuerung der inkrementellen Synthese zeigt der Realtime-TTS-WebSocket-Leitfaden, wie Sie Text an einen einzelnen offenen Synthese-Socket übergeben. Der untenstehende HTTP-Streaming-Ansatz ist einfacher und für kurze Gesprächszüge ausreichend.
Ihren KI-Sprachagenten für die Produktion absichern
Nach den fünf Schritten oben haben Sie einen funktionierenden Agenten. Das ist nicht dasselbe wie ein Produktions-Deployment.
Bevor Sie den Agenten an eine echte Telefonleitung anschließen, müssen Sie mehrere Aspekte beachten.
Twilio-Webhook-Signaturen validieren
Jeder, der Ihre Webhook-URL kennt, kann eine POST-Anfrage dorthin senden. Deshalb müssen Sie zuerst bestätigen, dass die Anfrage tatsächlich von Twilio stammt. Twilio signiert jede Anfrage mit Ihrem Auth Token im Header X-Twilio-Signature, und Sie weisen alles zurück, was die Validierung nicht besteht. Die Signatur wird über die vollständige URL und die POST-Parameter berechnet. Sie müssen sie daher genauso berechnen wie Twilio.
Der Twilio-Helper übernimmt das für Sie:
Geheimnisse korrekt verwalten
Speichern Sie ELEVENLABS_API_KEY, den LLM-Schlüssel und TWILIO_AUTH_TOKEN in einem Secrets Manager, nicht im Quellcode und nicht in Klartext-Env-Dateien, die in ein Repository committet werden. Beschränken Sie den ElevenLabs-Schlüssel auf die Endpunkte, die dieser Dienst benötigt, und vergeben Sie ein Kreditlimit. So bleibt der Schaden bei einem Leak begrenzt, statt offen zu sein.
Enterprise-Pläne können einen Schlüssel zusätzlich per IP-Whitelist auf bestimmte IP-Bereiche beschränken. Dieser Server verwendet den API-Schlüssel direkt, da er Ihr Backend nie verlässt. Würde Audiologik in einen Browser oder mobilen Client verlagert, würden Sie auf Einmal-Tokens wechseln, damit der Schlüssel clientseitig nie offengelegt wird.
Das Parallelitätslimit verstehen
Jeder Plan hat ein Parallelitätslimit, das je nach Modellfamilie variiert. Es zählt, wie viele Anfragen gleichzeitig aktiv Audio generieren.
Für einen Telefonagenten ist diese Berechnung vorteilhaft. Die Audiogenerierung ist schneller als die Wiedergabe. Daher verbraucht jeder Anruf TTS-Parallelität nur in den kurzen Zeitfenstern, in denen eine Antwort synthetisiert wird, nicht während der gesamten Anrufdauer. Als grobe Faustregel kann ein Parallelitätslimit von etwa fünf ungefähr 100 gleichzeitige Konversationsanrufe unterstützen, weil die Generierung lange vor Ende der Wiedergabe abgeschlossen ist.
Überwachen Sie dennoch die Reserve, statt zu raten. ElevenLabs-Antworten enthalten die Header current-concurrent-requests und maximum-concurrent-requests. Protokollieren Sie sie und lösen Sie einen Alarm aus, wenn Sie sich dem Maximum nähern. Überschreiten Sie das Limit, werden Anfragen nach Priorität in die Warteschlange gestellt, was typischerweise etwa 50 ms hinzufügt. Bei anhaltender Überlastung wird HTTP 429 zurückgegeben.
Behandeln Sie HTTP-429-Antworten mit einem kurzen Backoff. Bleiben sie bestehen, erhöhen Sie die Limits über die Preisseite oder als Enterprise-Kunde über Ihren Account Manager.
Barge-in und Unterbrechungen behandeln
Ein Anrufer, der zu sprechen beginnt, während der Agent spricht, erwartet, dass der Agent stoppt. Das ist Barge-in. Es korrekt zu behandeln, ist entscheidend dafür, dass ein Agent natürlich statt skriptbasiert wirkt.
Erkennen Sie Anrufer-Sprache während der Agentenwiedergabe über das STT-VAD-Signal. Wenn Sie sie erkennen, tun Sie zwei Dinge: Stoppen Sie erstens die Weiterleitung von TTS-Chunks. Das Flag agentSpeaking in speak erledigt dies bereits durch Abbrechen der Schleife. Senden Sie zweitens eine clear-Nachricht an Twilio, um den bereits auf dessen Seite eingereihten Audio-Puffer zu leeren.
Wenn Sie clear auslassen, spielt Twilio gepuffertes Audio weiter ab, nachdem Sie das Senden gestoppt haben. Der Agent scheint dann über den Anrufer hinwegzusprechen.
Protokollieren, überwachen und kontrolliert ausfallen
Instrumentieren Sie jede Stufe, damit Sie Latenz zuordnen können, wenn sich ein Anruf langsam anfühlt. Messen Sie die Zeit vom finalen Transkript bis zum ersten LLM-Token, vom ersten LLM-Token bis zum ersten TTS-Byte und vom ersten TTS-Byte bis zum an Twilio gesendeten Frame. Der größte Teil der variablen Latenz liegt in der LLM-Stufe; STT und TTS sind vergleichsweise stabil.
Planen Sie außerdem für Teilausfälle. Das LLM kann ein Timeout haben, der STT-Stream kann abbrechen, und die Netzwerk-Roundtrip-Zeit zu ElevenLabs variiert im öffentlichen Internet je nach geografischer Lage zwischen etwa 20 und 200 ms. Platzieren Sie Ihren Server nahe bei Ihren Anrufern, nicht nur nahe bei ElevenLabs, da ElevenLabs bereits zum nächstgelegenen Cluster in Nordamerika, Europa oder Südostasien routet.
Wenn eine Stufe ausfällt, lassen Sie den Anrufer nicht in Stille zurück: Synthetisieren Sie eine kurze Fallback-Antwort („Entschuldigung, können Sie das noch einmal sagen?“) und halten Sie den Anruf aktiv. Umgeben Sie jede Stufe mit einem Timeout und try/catch, damit ein fehlgeschlagener Sprecherzug nicht den gesamten WebSocket beendet.
Vor dem Deployment sollten Sie noch einige Standardwerte festlegen:
- Begrenzen Sie die Antwortlänge im System-Prompt wie gezeigt, damit Sprecherzüge kurz und unterbrechbar bleiben.
- Begrenzen Sie den Gesprächsverlauf, damit bei langen Anrufen der LLM-Kontext nicht unbegrenzt wächst.
- Legen Sie eine maximale Anrufdauer als Absicherung gegen festhängende Sitzungen fest, die unbemerkt Parallelität verbrauchen.
Um die Komponenten, die Sie steuern, weiter zu optimieren, erklärt das Latenzdokument die Ursachen der Zeit bis zum ersten Audio, die Modellübersicht behandelt die Abwägungen zwischen Geschwindigkeit und Qualität, und der Realtime-TTS-WebSocket-Leitfaden zeigt, wie Sie die Syntheselatenz mit inkrementeller Texteingabe weiter senken.
Produktionsreife Sprachagenten mit ElevenAPI erstellen
Nach 20 Minuten verfügen Sie über alle Schichten eines produktionsreifen Sprachagenten. Twilio übernimmt die Telefonie, Scribe v2 Realtime transkribiert, ein LLM generiert Antworten und Flash v2.5 spricht über denselben WebSocket zurück.
Wenn Sie die Kaskade nicht selbst pflegen möchten, bietet ElevenAgents Sprecherwechsel, Unterbrechungsbehandlung und Telefonieintegration als verwalteten Dienst auf Basis derselben Modelle, die Sie gerade manuell verbunden haben.
Um einen Stack unter Ihrer Kontrolle weiter zu optimieren, besuchen Sie die ElevenAPI-Produktseite für Pläne, Parallelitätslimits und die Stimmbibliothek. Alternativ können Sie sich registrieren und noch heute Ihren ersten Anruf starten.
FAQ: Einen Sprachagenten mit Twilio und ElevenLabs erstellen

Tadas Petra ist Developer Relations Engineer und unterstützt Entwickler beim Einsatz der ElevenLabs-Produktpalette. Er ist außerdem Gründer von Hungrimind, einer Plattform für Entwicklerbildung. Zuvor war er Lead Developer Advocate bei Agora und Dozent bei Zero To Mastery.



