网络研讨会回顾:Urban Company 如何大规模自动化合作伙伴支持
- 发布时间
- 最近更新
收听收听本文
大多数支持团队在尝试扩展规模时都会遇到瓶颈:增加客服人员会推高成本,质量却难以保持一致,季节性高峰更可能让系统不堪重负。Urban Company 找到了另一条路。
在 《幕后智能体:Urban Company 如何大规模自动化合作伙伴支持》中,Urban Company 工程经理 Abhishek Thakur 介绍了他们如何在合作伙伴支持业务中部署语音 AI,以及部署后服务质量、成本和通话量的变化。
零工经济的支持难题
零工经济高度依赖平台与劳动者之间的信任,一旦这种信任被破坏,劳动者可能转向竞争对手。印度有超过 1500 万名零工劳动者,预计到 2030 年将达到 2300 万人,他们主要通过手机和语音与平台互动。受噪音、网络问题和多语言混用等工作环境影响,基于文本的支持往往难以奏效。
尽管如此,许多平台仍以聊天为默认支持方式,导致首次联系解决率低、升级率高。劳动者常觉得平台并未按其需求设计。语音 AI 提供了一种更契合这类劳动力工作方式的沟通方案。问题在于,它能否以零工经济运营所需的质量和规模实现这一目标。
为什么语音是零工劳动者的合适渠道
Urban Company 的业务覆盖印度 51 个城市,以及阿联酋、新加坡和沙特阿拉伯。他们管理着近 60,000 名活跃服务专业人员,包括水管工、美容师和家电维修技师,每天都在客户家中提供服务。
这些合作伙伴并不是典型的科技产品用户。许多人专门购买智能手机来加入平台。他们自然的沟通渠道是语音,而非文本。Urban Company 查看聊天支持记录后发现,合作伙伴会发送零散的印地英语混合消息、上传模糊截图,更明显的是,他们会在聊天中要求回电。
支持渠道与合作伙伴实际沟通方式之间的差距,在每个接触点都造成了阻碍。
如此规模的人工支持还会带来不断累积的问题:
- 10 名人工呼叫中心客服会用 10 种不同方式表达同一件事
- 更新 SOP 需要数周才能传达到整个团队
- 空调维修旺季一到,通话量会毫无预兆地激增
语音 AI 能同时解决这 3 个问题:每次都提供一致的解决方案,即时适应新信息,并可横向扩展以应对任何规模的通话量。
Urban Company 选择 ElevenLabs,是因为其 音色 最接近真人。这一决定来自一次匿名内部投票:员工聆听多家供应商的录音后进行投票。对于需要与平台建立信任的零工劳动者而言,语音质量不是偏好,而是前提条件。
Urban Company 智能体幕后解析
Urban Company 目前在 3 个主要细分领域部署了语音 AI:
合作伙伴支持:合作伙伴可在服务过程中的任何时候通过 App 致电,获得客户纠纷、付款问题、服务完成问题等各类帮助。
推荐拓展:主动致电现有合作伙伴,询问他们是否愿意向家人或朋友推荐平台。这类高通话量、对关系敏感的互动,能受益于一致的语气和零等待时间。
Instahelp:面向阅读或书写困难的合作伙伴、无需 App 的交互层。无需 UI,合作伙伴即可完全通过语音管理服务订单、订阅和咨询。
目前,Urban Company 已上线 30 多个使用场景,并正向 150 多个子智能体 迈进。最初只是 1 个人探索这件事是否可行,如今已发展为一支由 30 人组成的团队,在整个业务中构建和部署语音 AI 智能体。只要一个使用场景成功,每个团队都想拥有一个。
演示:多智能体实时解决问题
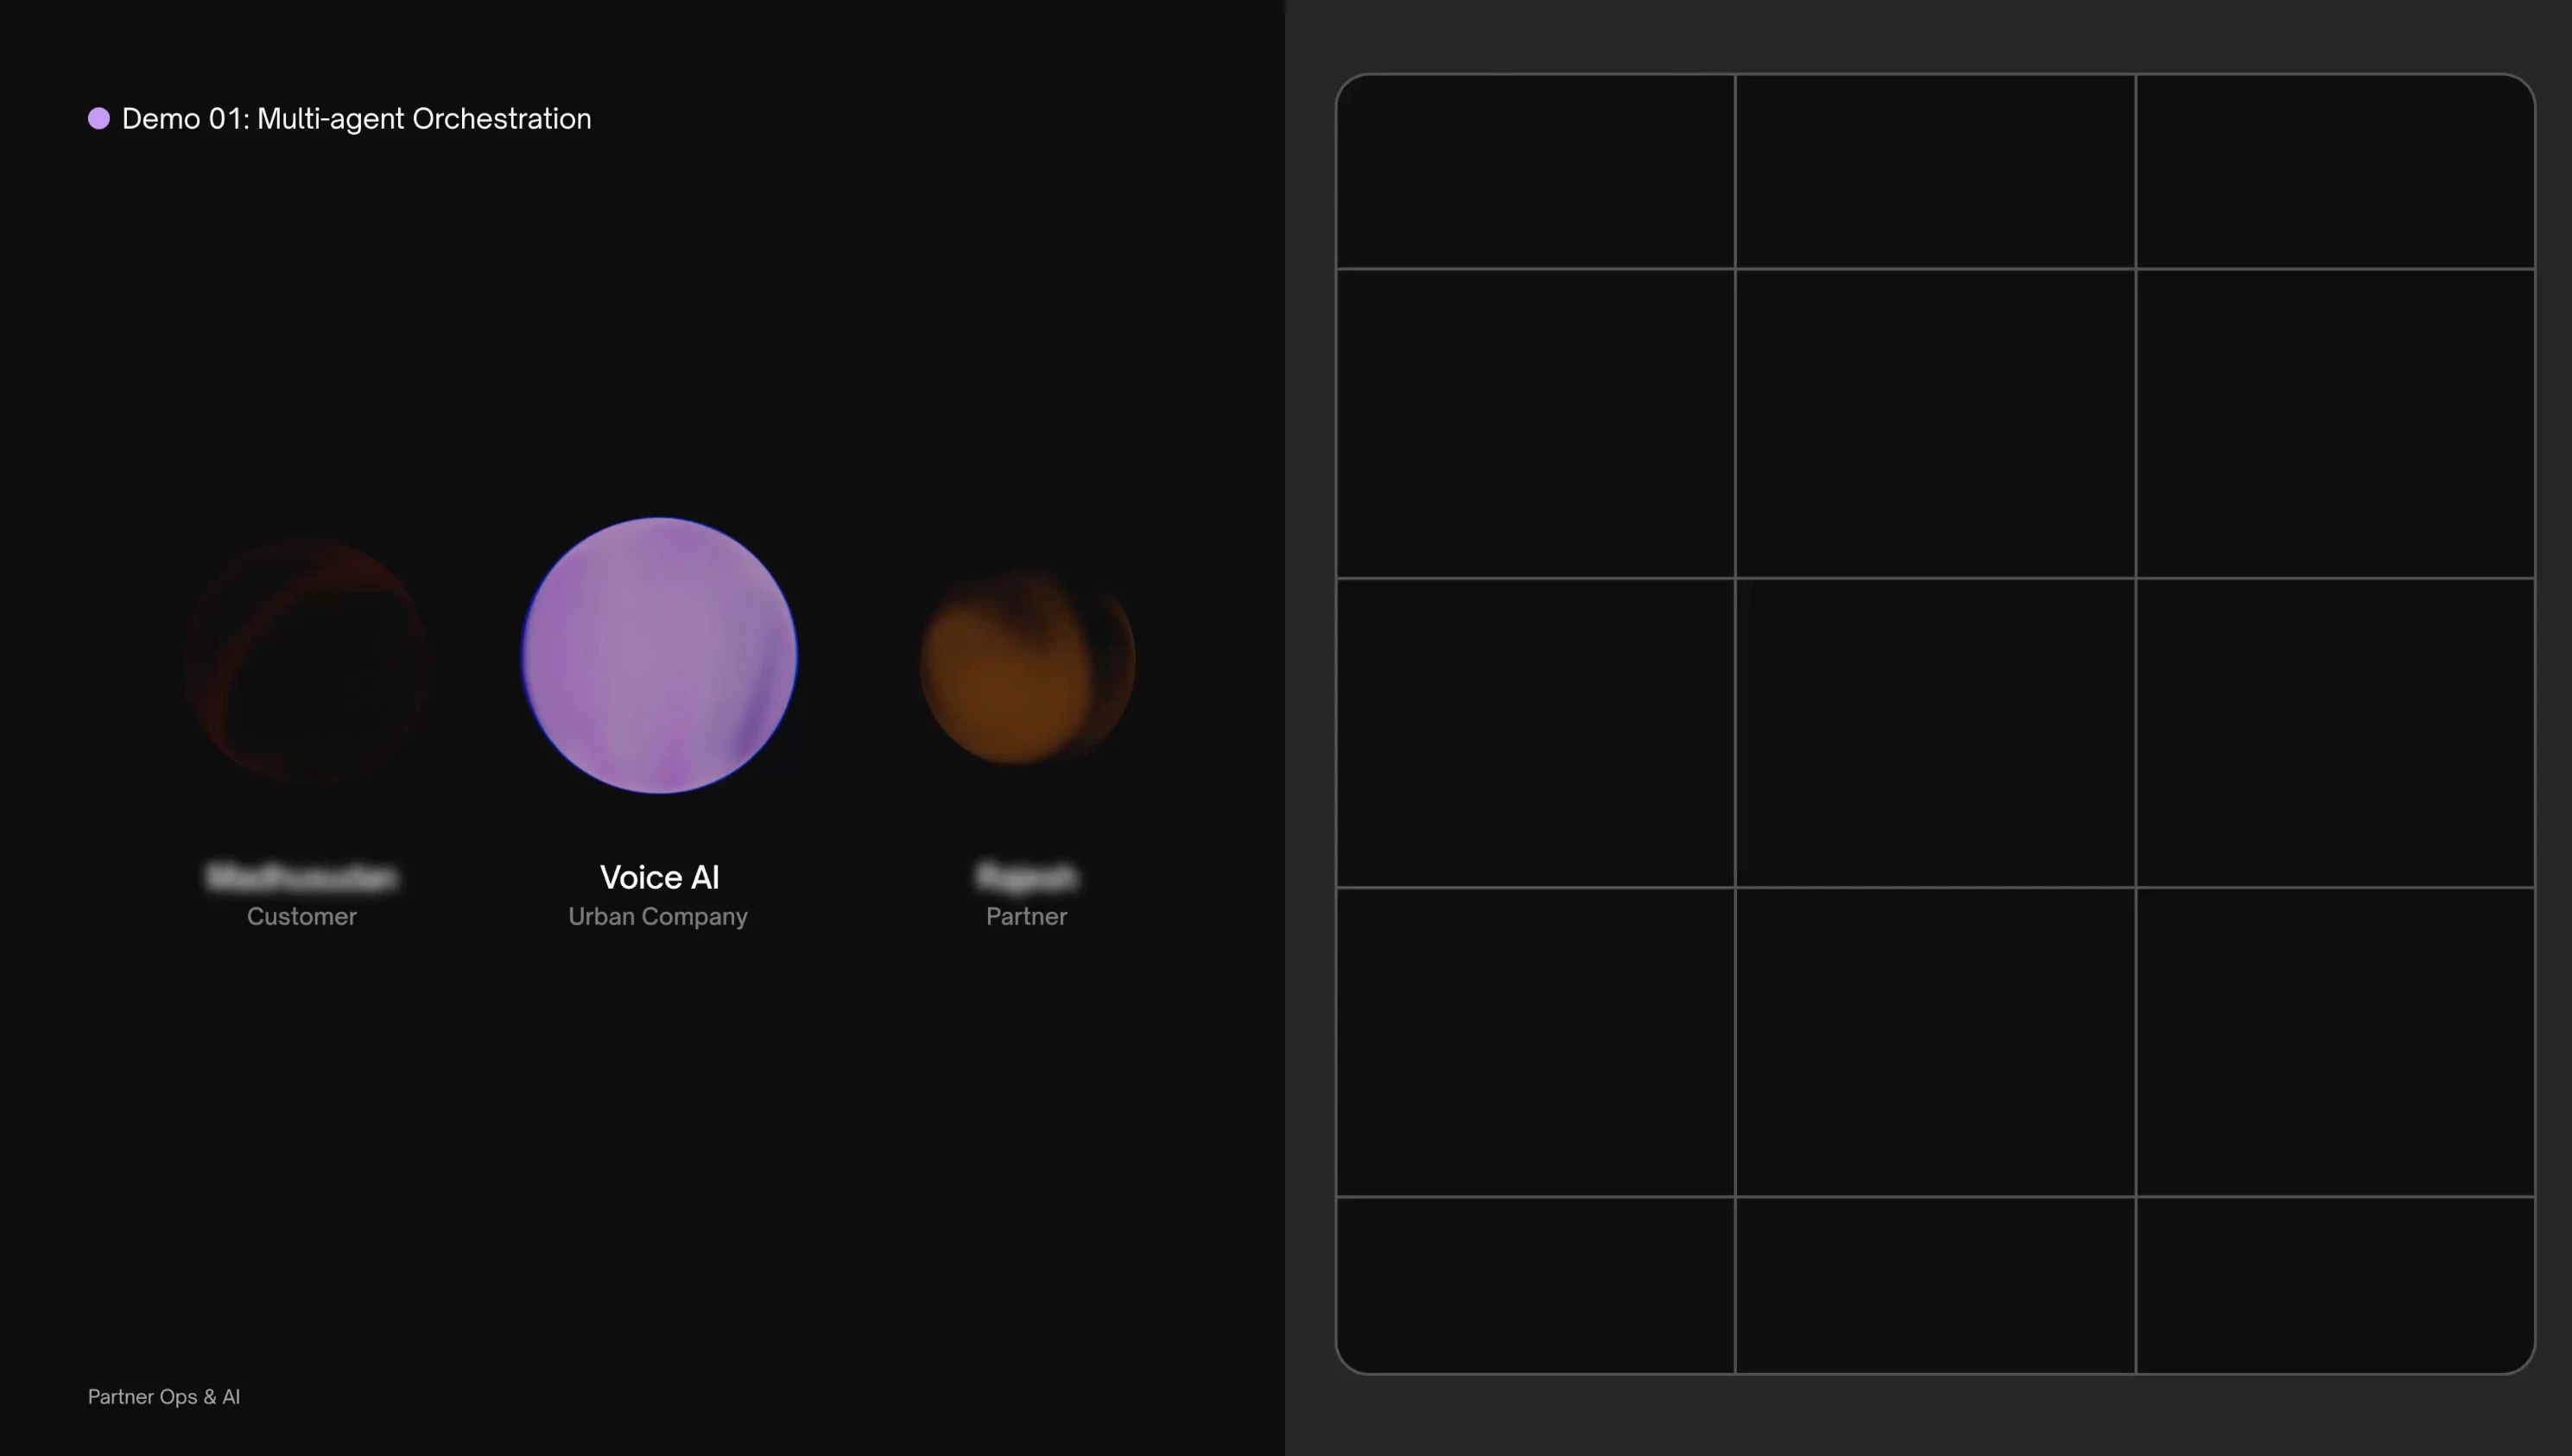
场景: 一名服务合作伙伴到达客户所在地。客户因停电拒绝接受服务,合作伙伴需要重新安排时间,同时不承担取消费用。
演示内容:
- 合作伙伴通过 App 致电 UC 支持,联系到 AI 智能体 Anjali
- Anjali 确认订单详情,并让合作伙伴稍候
- 同时,第二个智能体 Vidhi 直接致电客户
- Vidhi 确认取消原因,提议次日上午同一时间重新安排,并完成预约
- Anjali 向合作伙伴反馈解决方案:订单已重新安排,无需支付取消费用
- 合作伙伴感谢智能体快速解决了问题
重要之处:
这不是单个智能体按脚本执行任务,而是多个智能体并行运行:一个管理合作伙伴通话,另一个实时解决客户问题,协同产出任何一个智能体单独都无法实现的解决方案。Urban Company 在合作伙伴支持中运行 50 至 60 多种提示词变体,单次互动有时会涉及 7 至 10 个子智能体依次协作。
最佳实践
Urban Company 分享了语音 AI 实践中的关键经验:
- 初期优先确保功能可用。 随着 2 月和 3 月为智能体增加更多能力,Urban Company 的每分钟成本显著上升,之后又降至低于最初水平。重点是先让使用场景真正跑通。成本优化可以稍后再做;一旦了解低效环节在哪里,优化速度会比预期更快。
- 小改动能带来巨大影响。 对话式 AI 的关键在于细节。Urban Company 在提供信息前加入了一小段“正在查询……”的音频缓冲,即使 API 的响应速度以毫秒计。这个停顿让回复听起来像是智能体真的查询过信息。仅这一项改动,就让一项关键指标提升了 30%。要持续开展实验:Urban Company 目前在任意时刻都会以 1% 流量运行约 15 个 A/B 测试。
- 拆分提示词,而不是修补它。 提示词出现幻觉或偏离目标时,直觉做法是修补它。UC 的方法是将其拆解为更小、更聚焦的提示词,每个都有明确任务,并配置针对性的工具调用。他们的合作伙伴支持流程由 50 至 60 个提示词完成不同任务,而不是试图让一个提示词处理所有事情。
- 扩展前先建立完善的追踪体系。 Urban Company 严格监控输入指标:平均通话时长、智能体和用户各自的每分钟词数、每分钟对话轮次、白噪声占比和未接通率。他们的北极星指标是 解决率,即在通话结束时询问合作伙伴问题是否已解决。聆听通话录音仍是发现数据遗漏问题的方式。
- 处理语言识别,而非询问语言偏好。 询问用户“你更偏好哪种语言?”会打断对话流程。Urban Company 曾尝试根据合作伙伴姓氏识别语言,但误判过多。目前的方法是:合作伙伴在通话前 30 秒使用什么语言,之后所有通话便固定使用该语言。只允许在开场阶段切换语言。目前,Urban Company 有 20% 的通话使用本土语言,即非印地语、非英语。
- 像处理工程问题一样管理延迟。 分析每一毫秒。找出时间实际花在哪里——数据获取、模型推理、网络——并分别优化。可使用与上下文相关的填充语掩盖处理时间,但要根据提示词调整:问候智能体会说“很高兴收到你的消息”,运营智能体会说“我来查一下”。填充语应听起来自然。
观看完整内容
观看完整网络研讨会 点击这里。