网络研讨会回顾:让文本聊天机器人拥有自然人声
- 发布时间
- 最近更新
收听收听本文
聊天智能体已成为企业软件技术栈的标配。大多数公司已有或正在构建一个。更少团队想清楚的是:当用户更想直接说话时,该怎么办。
语音改变交互的意义不止于便利。用户会通过语气表达挫败感、紧迫感和困惑,而这些信息在文本中会完全丢失。输入“我的订单还没送到”的客户,与带着明显焦虑说出这句话的客户,传递的是不同信号——而只能阅读文本记录的智能体,只掌握了一半信息。
现在大多数团队关心的已不是是否要加入语音,而是如何在不重建现有可用系统的前提下实现它。
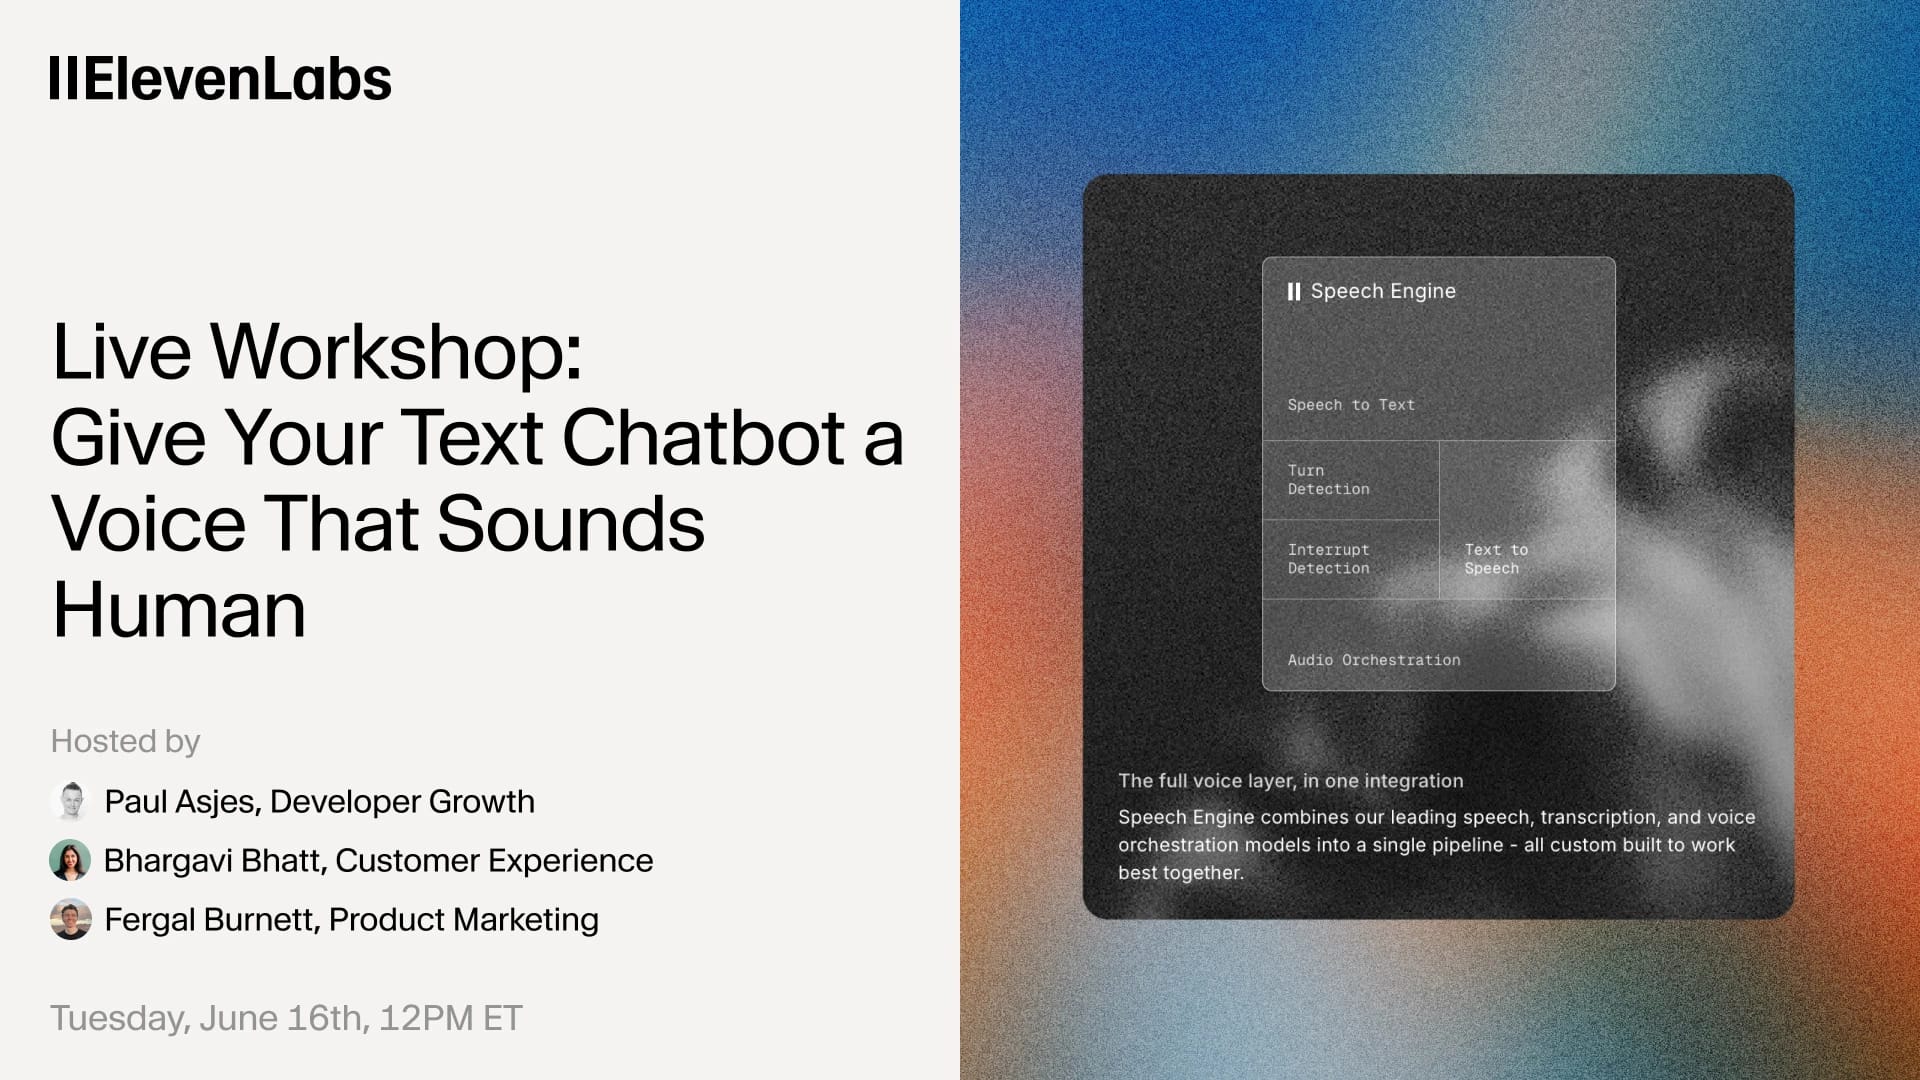
在直播研讨会:让文本聊天机器人拥有自然人声中,Paul Asjes(开发者体验)、Bhargavi Bhatt(客户体验)和 Fergal Burnett(产品营销,ElevenAPI)讲解了为现有智能体加入语音功能时的技术现实,以及实际可用的集成方案是什么样的。
用语音构建产品为何比看起来更难
核心挑战之一是轮次交接。人类能根据语调、节奏和上下文判断对方是否说完。然而,语音活动检测(标准方法)只能检测静音。
结果往往是,系统把每次停顿都当作该说话的信号:它会打断用户、在思路未完时截断,还会把自然的犹豫当成完整句子来回应。
从技术上看它能运行,但对话体验已经失效。
上下文是问题的另一半。每轮都将对话历史传给 LLM 虽有必要,但还不够。同样的话会因表达方式不同而有不同含义——如释重负地说“我没事”和带着挫败感说“我没事”,文本记录相同,交互却不同。忽略这一维度的语音系统,无论单个模型多强,听起来总会有些不自然。
此外还有工程开销。自行负责语音编排的团队,需要持续维护轮次交接逻辑、打断处理和延迟分析。这不是一次性开发。
如何为现有智能体加入语音
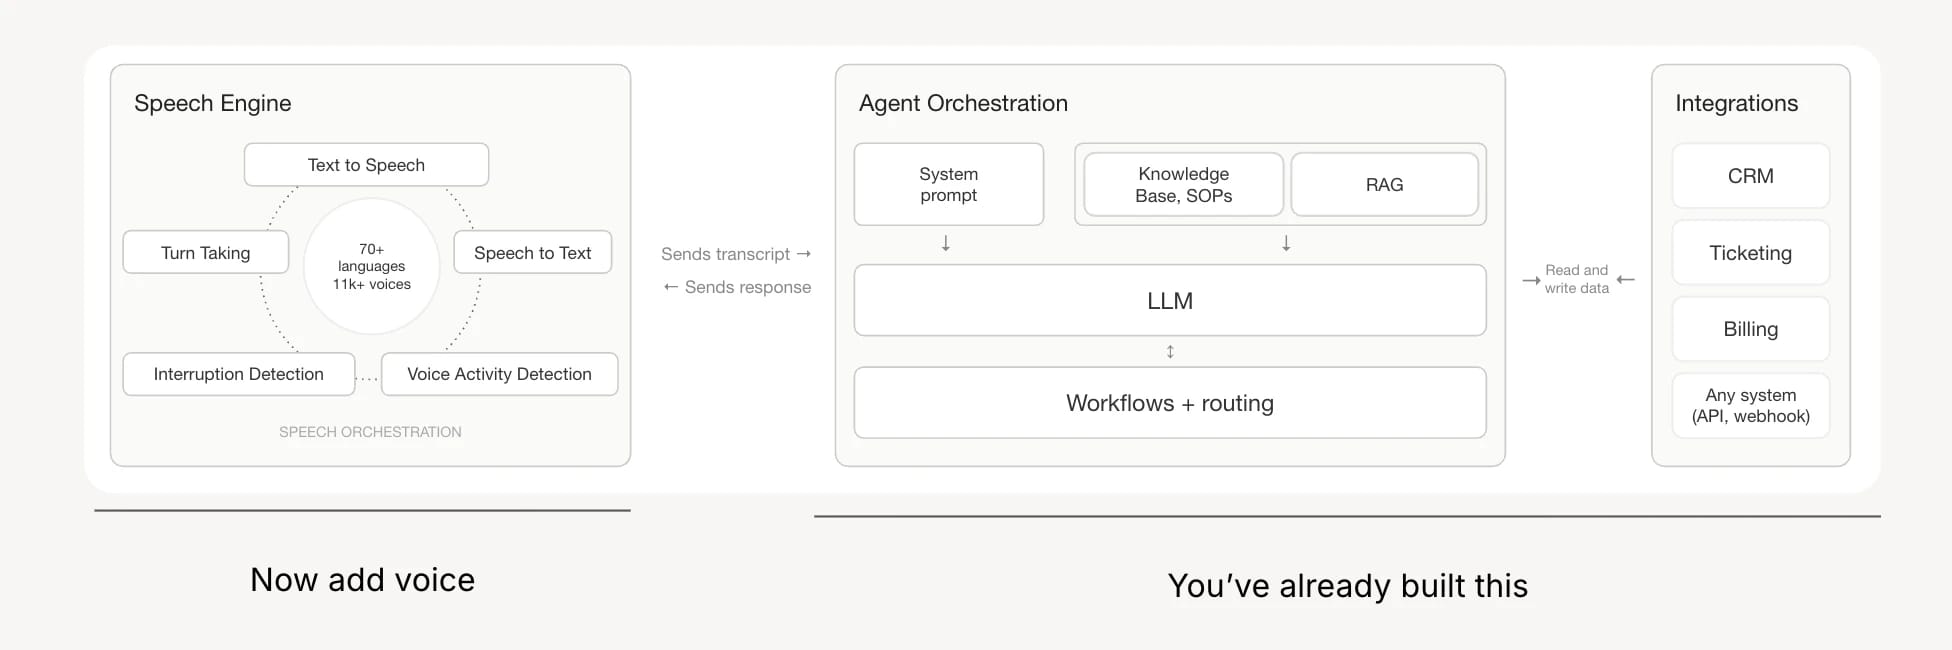
最简洁的方案是双 WebSocket 架构。
- 一个连接位于客户端与 ElevenLabs API 之间,另一个位于服务器与 ElevenLabs API 之间
- 用户对着麦克风说话,音频发送至 ElevenLabs API,在那里转录后发送到服务器
- 服务器将从 ElevenLabs API 获取的完整对话历史提供给 LLM,流式响应再返回用于语音合成
- 这可以在 LLM 完成生成前开始,从而保持较低的首字节延迟
关键集成点是onTranscript 方法,它会在每轮结束时触发,并将完整对话历史传给 LLM。
会话开始时的contextualUpdate 会保留用户切换到语音前在文本对话中的内容,因此同一个智能体可以跨两种交互方式工作而不丢失上下文。
构建时有几点值得注意:
- 相比聊天,LLM 的选择对语音更重要。 即使回答质量更高,深度推理模型带来的停顿在音频中也会显得像不自然的犹豫。对于实时语音,更快的模型在感知质量上几乎总是更胜一筹。
- 音频应使用 WebRTC,而非 WebSocket。 WebRTC 内置回声和降噪功能,在移动端或嘈杂环境中尤其重要。使用 WebSocket 传输音频意味着需要自行处理这些问题。
- 不要让用户选择语言。 这会打断对话流程。更好的模式是从最初几秒的语音中检测语言并锁定,同时支持自然切换,无需用户进行任何操作。
- 将轮次交接模型与 LLM 分开。 使用 LLM 判断用户是否说完,会在每一轮增加延迟和成本。专用的轮次交接模型处理得更快、更准确,值得将其视为架构中的独立组件。
应自行负责多少基础设施
正确答案取决于已有的系统。如果已有可用的聊天智能体,在其上加入语音层(保留 LLM、编排和业务逻辑)通常是最快、风险最低的路径。
无需重建任何东西。只是在已有可用系统上增加音频界面。
如果需求扩展到电话、部署渠道管理、内置测试和分析,将更多技术栈交给语音智能体平台会更合理。这两种方法并不冲突——团队可以先从轻量级语音层开始,随着应用场景成熟,再逐步加入平台能力。
演示:为现有聊天机器人加入语音
本演示展示了一名用户正在与基于文本的旅行规划聊天机器人对话,为日本之旅询问社区和美食推荐。
演示内容:
- 无需改动底层智能体,即可为聊天机器人扩展语音层。
- 用户在对话中途从打字切换为说话,智能体在两种交互方式间保留了完整上下文。
- 用户说荷兰语;智能体自动检测到语言变化
- 智能体被打断后,用户要求它在句子中途切回英语,它做到了——还在无人提示的情况下,带着轻微荷兰口音完成了回答。
- 整个对话中,打断检测让用户可以自然地插话,无需等待智能体说完。
重要性:
这个演示展示的不是专门构建的语音智能体,而是一个已经可用的文本智能体,上面直接加入了语音层。上下文处理、语言检测和打断行为都来自语音层——底层文本智能体没有改动。
观看完整活动
观看完整网络研讨会请点击此处。
Paul 现任 ElevenLabs 开发者增长团队成员,常驻西班牙瓦伦西亚,担任 Developer Experience Engineer,专注于平台推广和开发工具。加入 ElevenLabs 前,曾负责 Stripe 的开发者关系,在 WorkOS 从事开发者体验相关工作,并有多年全栈 Web 应用和开发工具开发经验。