Apresentamos o Eleven Realtime: uma maneira mais simples de criar agentes de voz naturais
- Escrito por
- Min Kim
- Publicado
- Última atualização
OuvirOuça este artigo
Hoje, criar um agente de voz que soe natural exige muitas decisões. Você precisa escolher componentes individuais, como reconhecimento de fala, detecção de atividade de voz, alternância de turnos, o LLM subjacente e Text to Speech. Montar essa pilha já é um projeto por si só, e fazer todos os componentes funcionarem bem juntos exige mais testes e ajustes.
Eleven Realtime é uma nova classe de modelos de Speech to Speech que elimina esses obstáculos. Cada modelo é um agente de voz completo, otimizado para casos de uso específicos. Ambos oferecem suporte a mais de 90 idiomas e podem usar qualquer uma das mais de 17.000 vozes da biblioteca da ElevenLabs:
Hoje, lançamos:
- Eleven Realtime v1 Mini para conversas naturais com baixo custo. É a melhor opção para assistentes de IA, professores e personagens interativos, e atende à maioria dos casos de uso.
- Eleven Realtime v1 Max para tarefas complexas. É ideal para atendimento ao cliente, qualificação de leads e workflows com várias etapas, nos quais o agente precisa seguir um processo e raciocinar em cada etapa.
Por que criamos modelos em tempo real
Você não deveria precisar se tornar especialista em configuração para criar um agente de voz que soe natural. Fazer um agente parecer e soar certo depende de pequenas decisões que exigem nuance, como quanto tempo esperar após uma pausa antes de responder, como se recuperar quando o usuário interrompe o agente e como voz, prompts e modelo funcionam juntos. No ElevenAgents, todas essas configurações podem ser ajustadas.
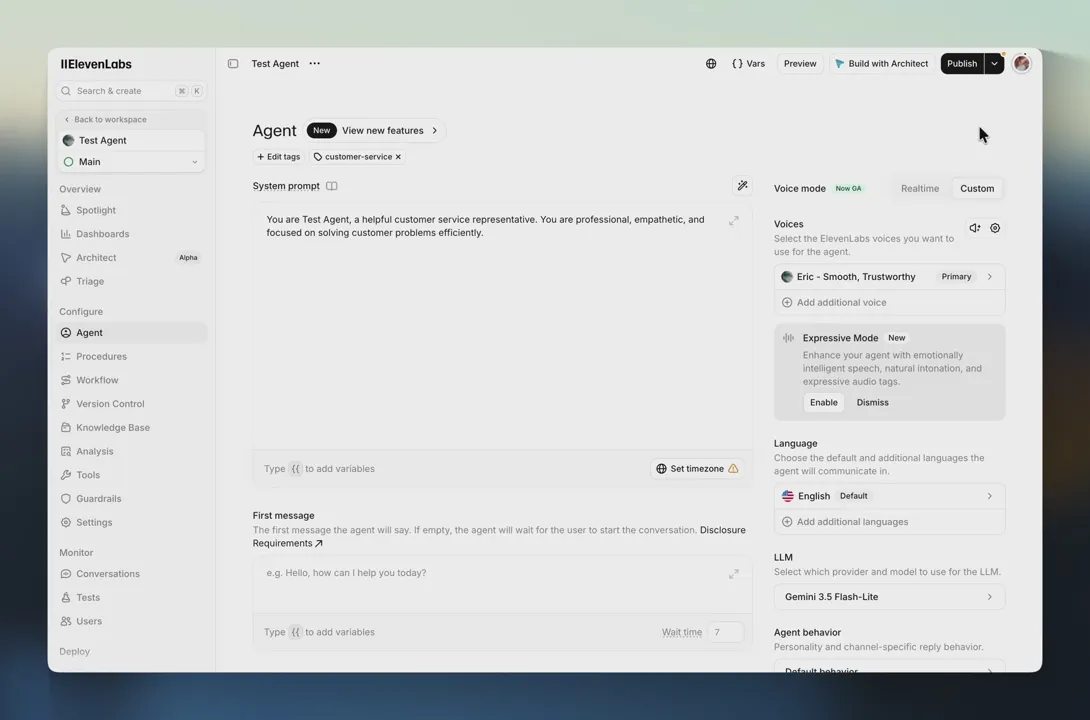
O mesmo vale para desenvolvedores que já usam uma API em tempo real. A nossa é compatível com a Realtime API da OpenAI, então testar o Eleven Realtime significa apenas mudar o endpoint e o nome do modelo no código que você talvez já tenha.
Baseado em arquitetura em cascata
O Eleven Realtime é baseado em uma arquitetura em cascata dos componentes descritos acima, ajustada de ponta a ponta. Chamamos esses modelos de Speech to Speech porque é isso que você obtém: áudio de entrada, áudio de saída, um ID de modelo e um sistema que pode ser avaliado nos mesmos rankings de modelos fusionados e duplex.
Os modelos fusionados inicialmente estabeleceram o padrão de quão natural um agente de voz poderia parecer, enquanto uma configuração em cascata aumentava a latência a cada transferência e usava componentes que nunca eram ajustados entre si. O Realtime elimina essa troca, e o ajuste que antes era seu projeto já vem pronto.
A arquitetura em cascata também traz vantagens práticas em produção, porque cada etapa gera texto. Você pode ver o que o agente ouviu e o que decidiu dizer, distinguindo uma palavra entendida incorretamente de uma decisão errada. É esse mesmo texto que permite ao ElevenAgents aplicar proteções e redação de PII a um agente Realtime.
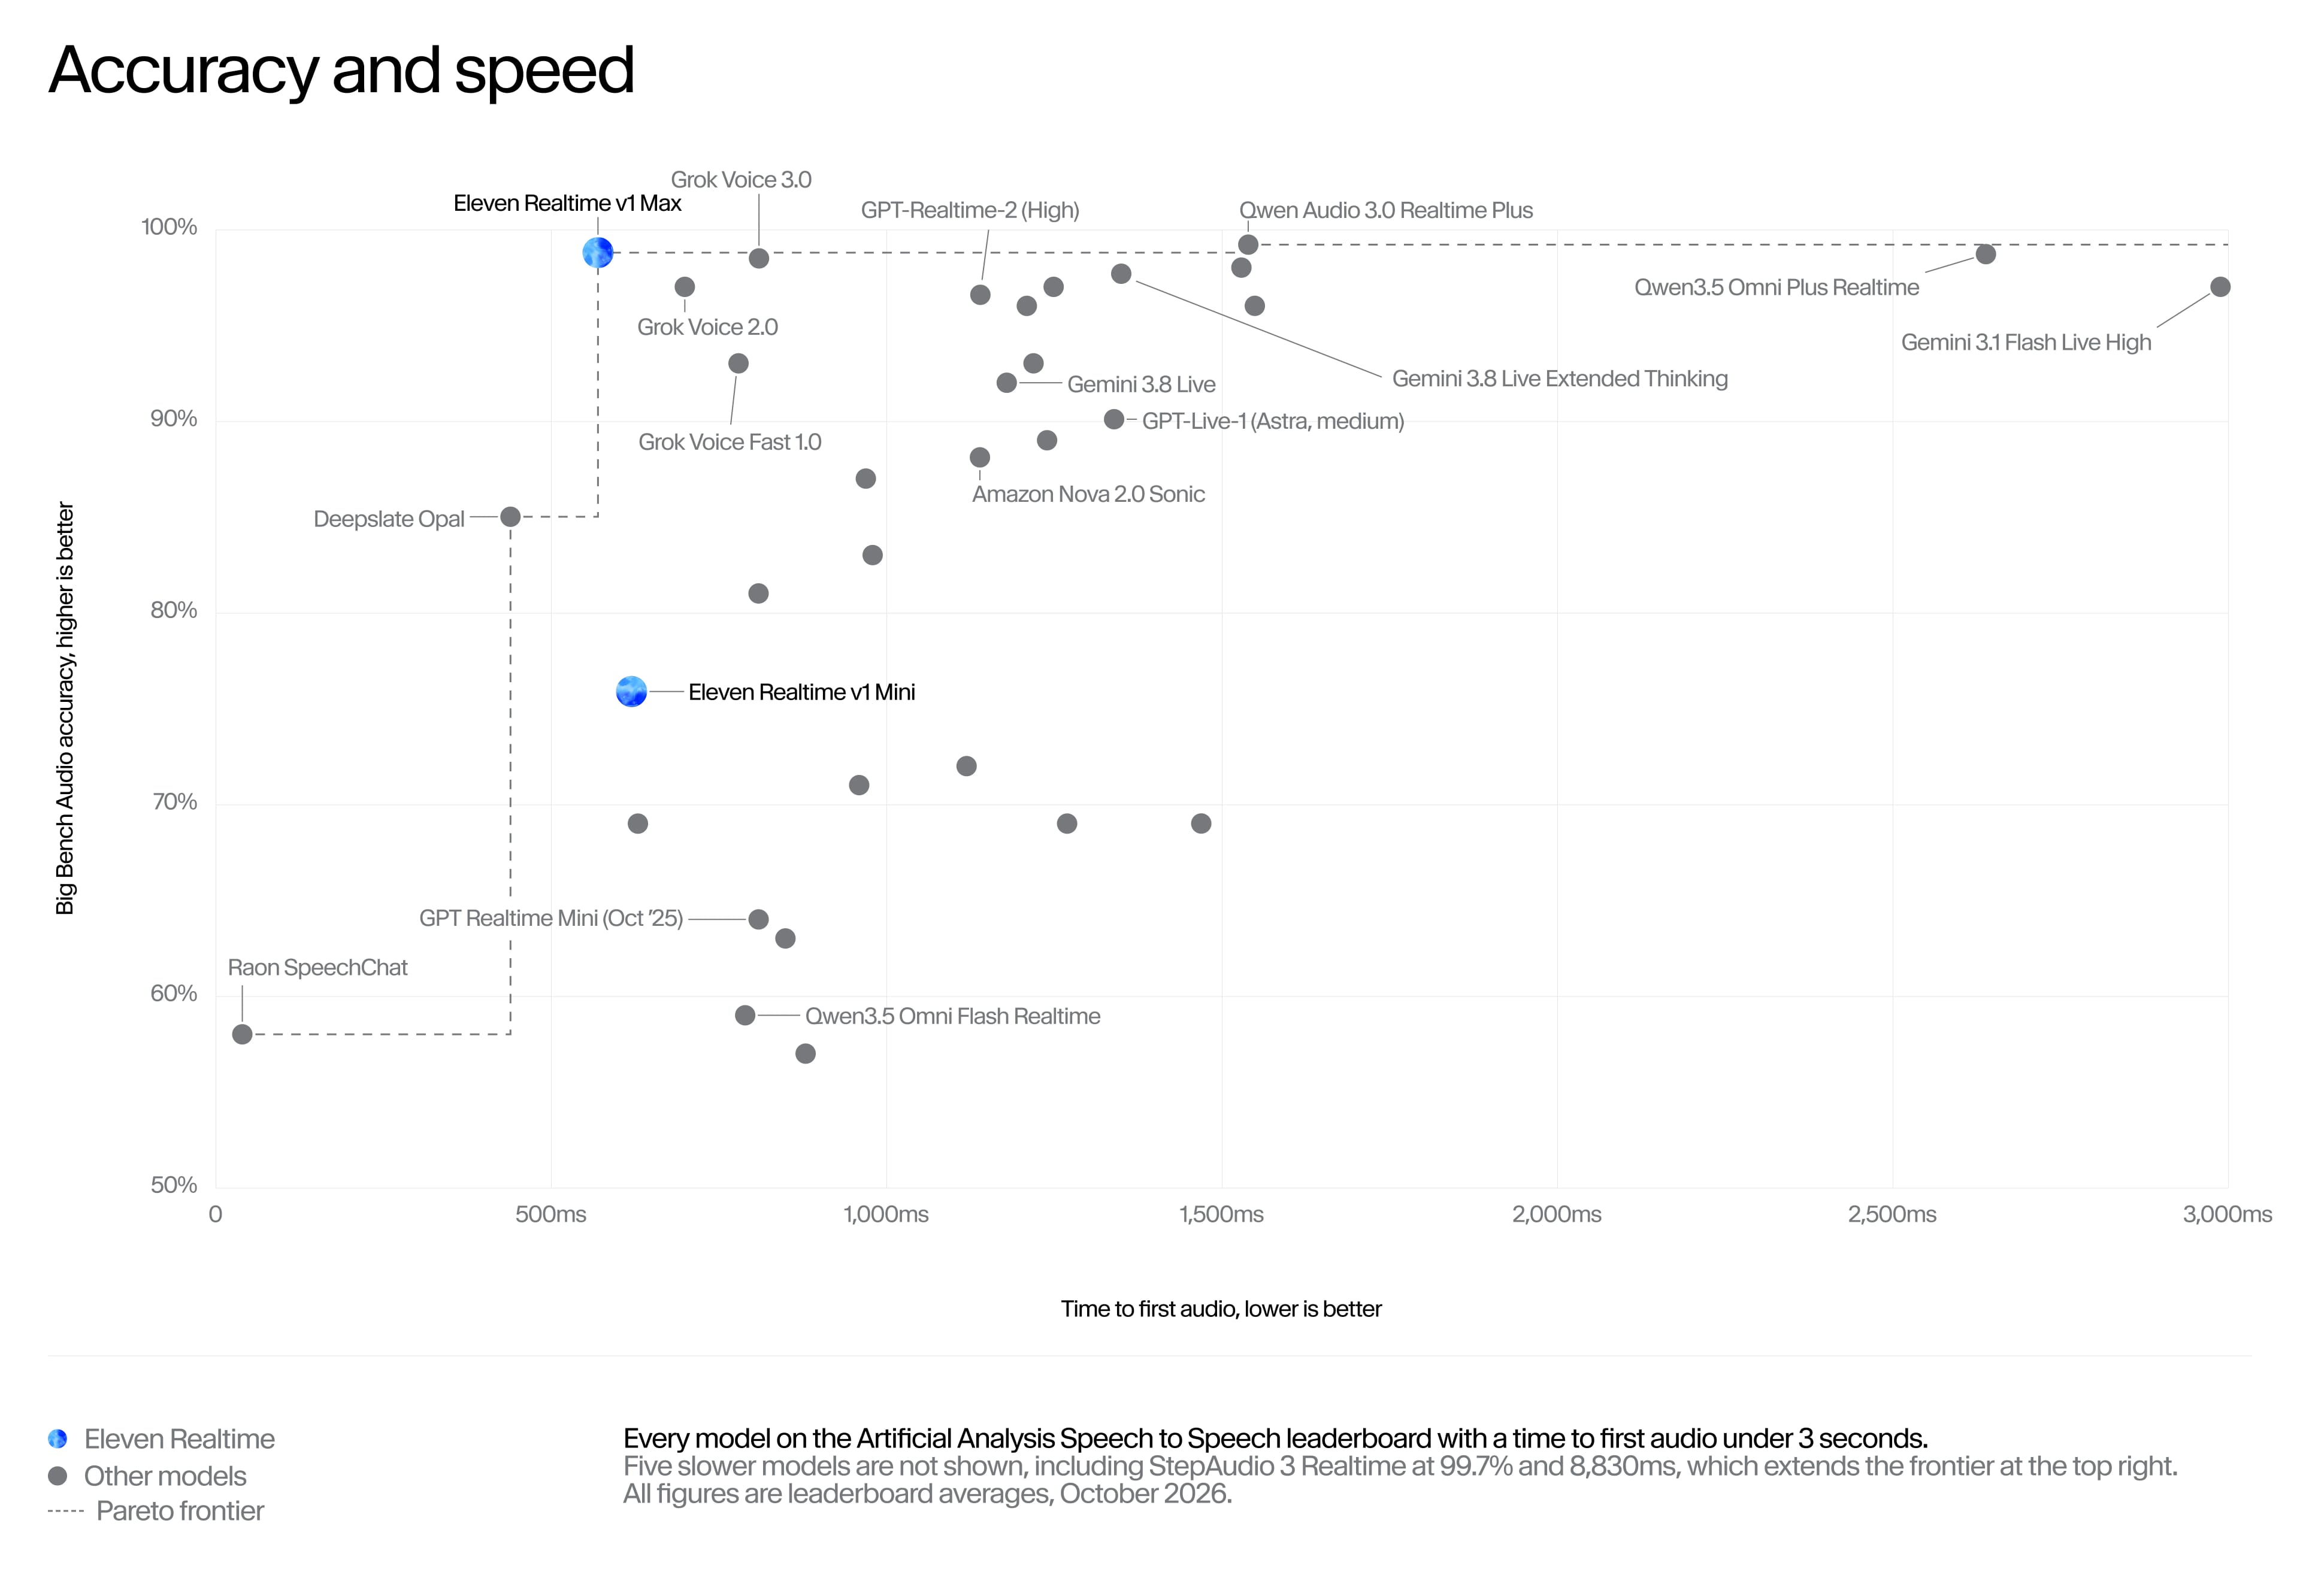
Os benchmarks abaixo verificam se essa troca realmente deixou de existir. Em dinâmica conversacional, ambos os modelos têm resultados na mesma faixa dos modelos fusionados. Considerando precisão e velocidade juntas, nenhum modelo no ranking da Artificial Analysis é ao mesmo tempo mais rápido e mais preciso que o v1 Max.
Desempenho dos modelos
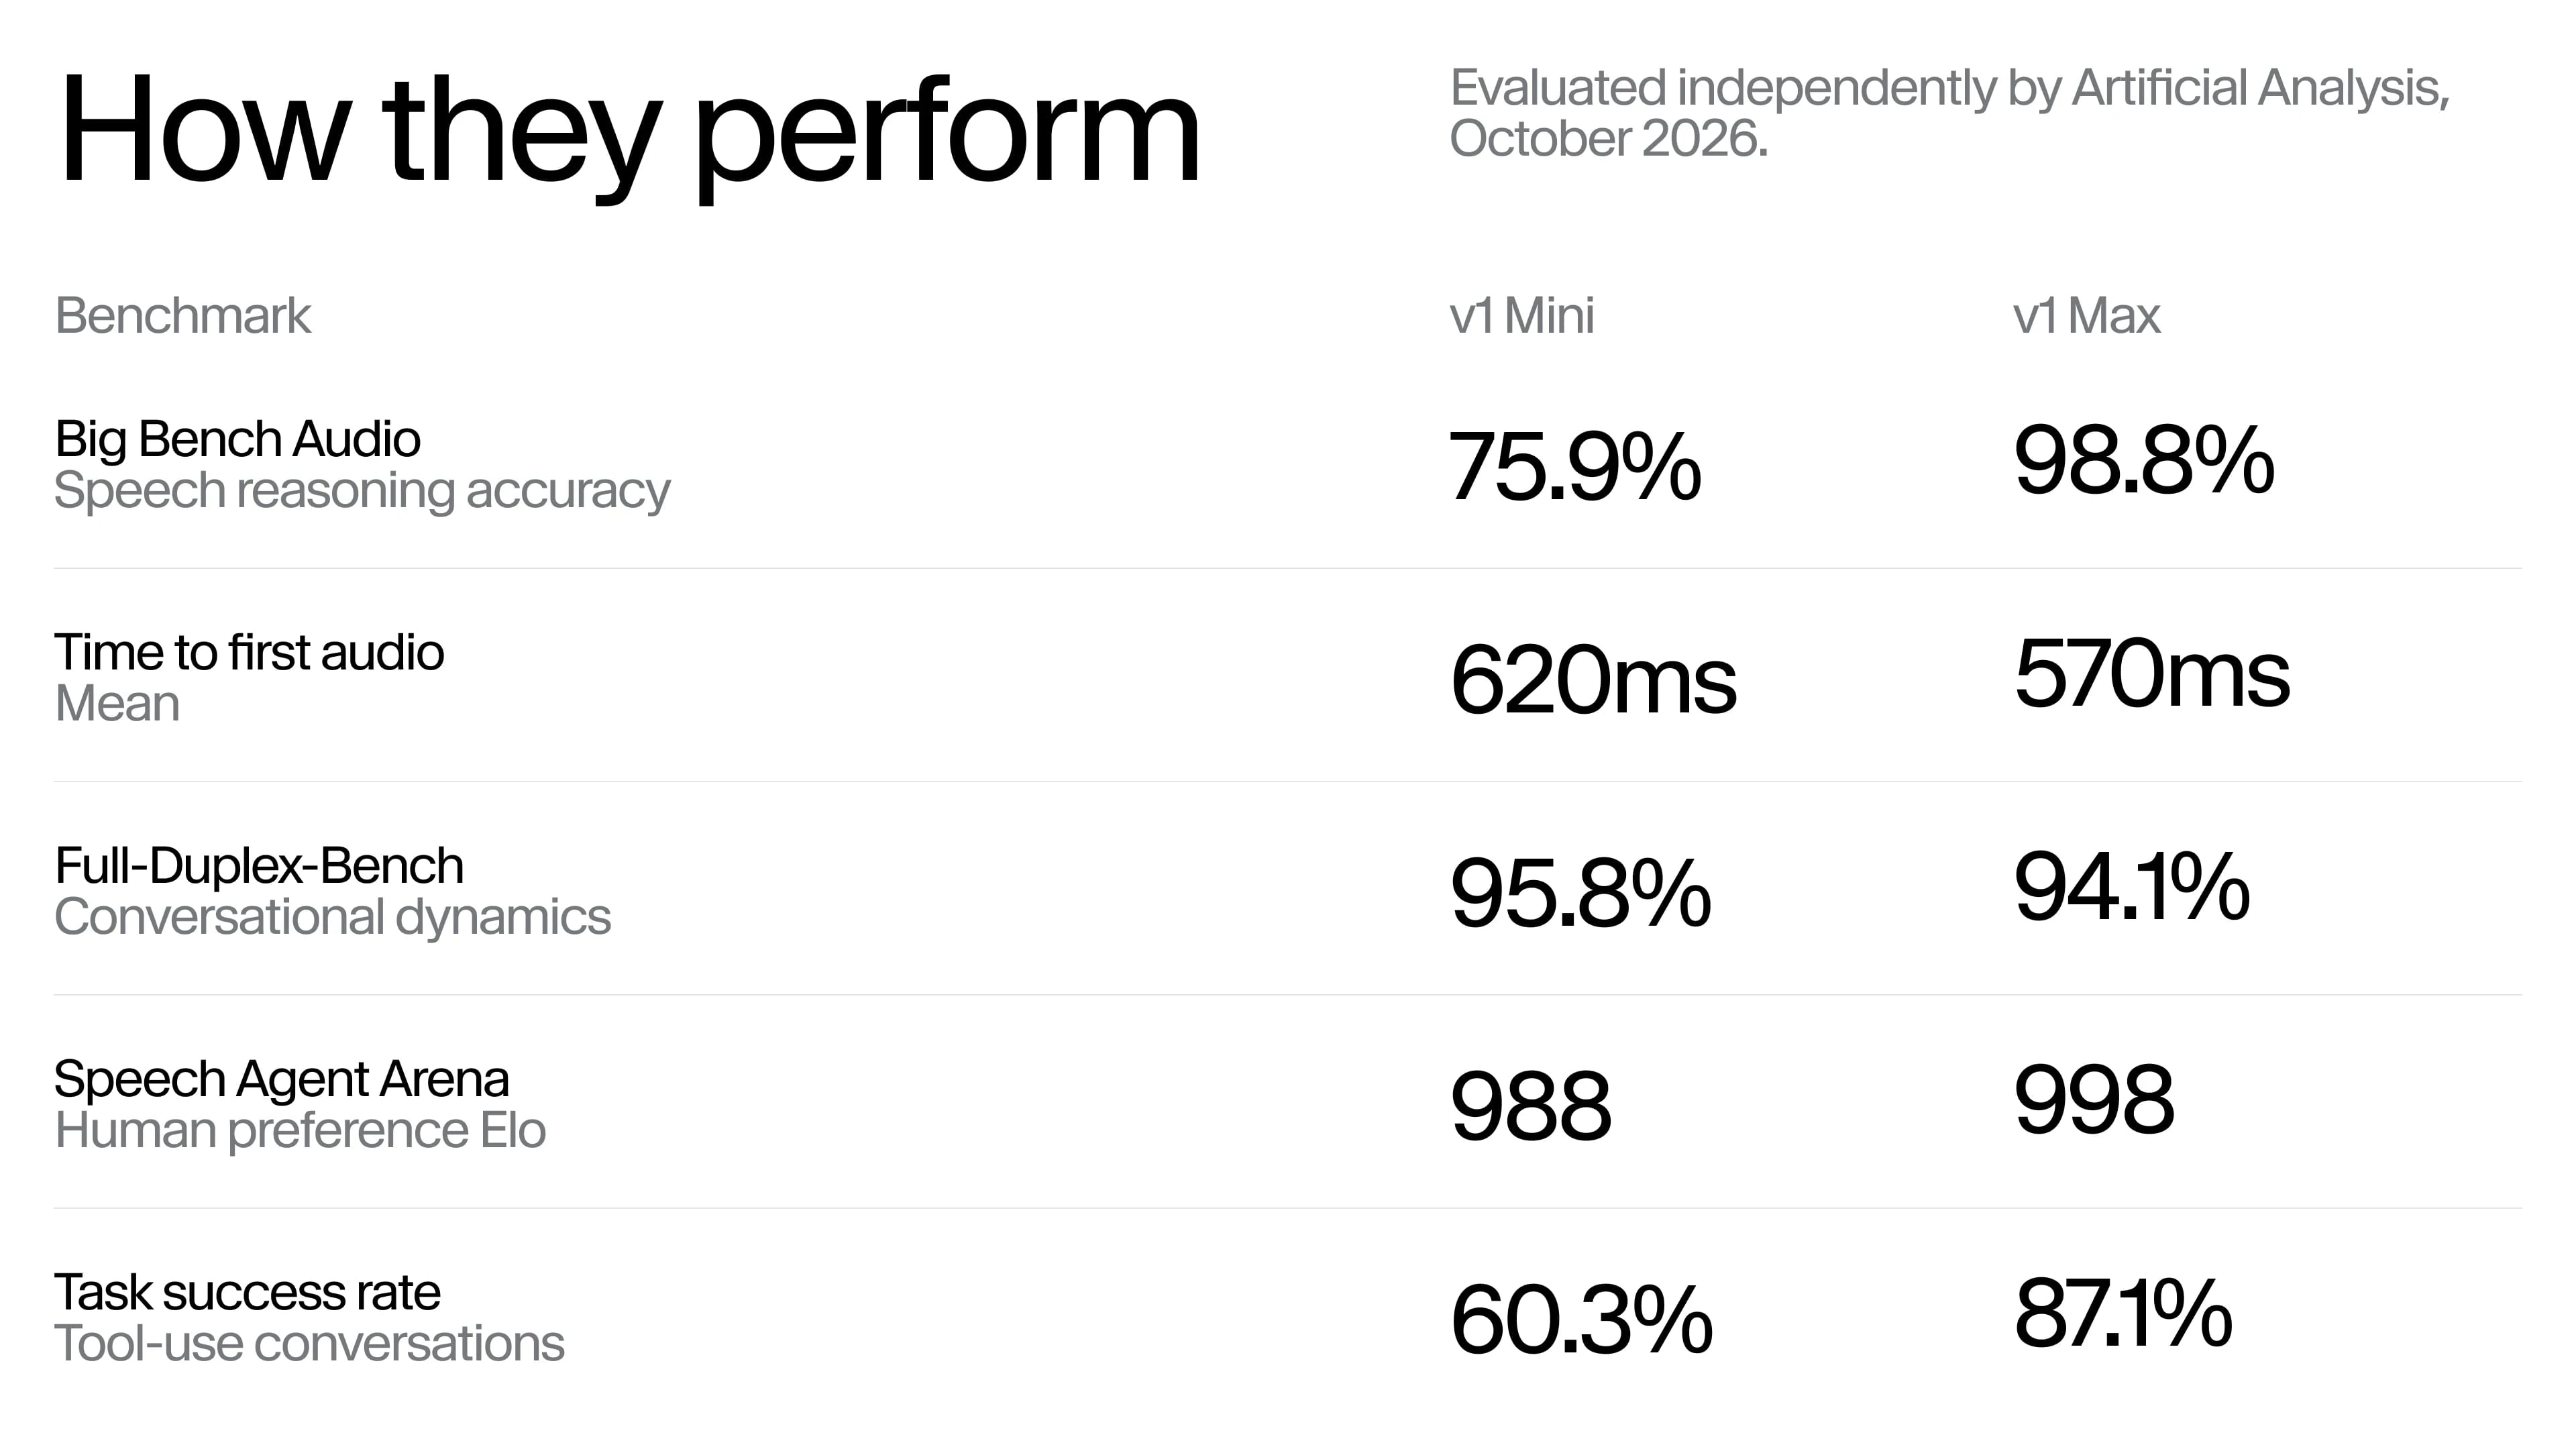
A Artificial Analysis avaliou os dois modelos de forma independente em três benchmarks públicos: Big Bench Audio, para raciocínio por fala; Full-Duplex-Bench, para dinâmica conversacional; e Speech Agent Arena, para preferência humana e sucesso nas tarefas.
Raciocínio por fala
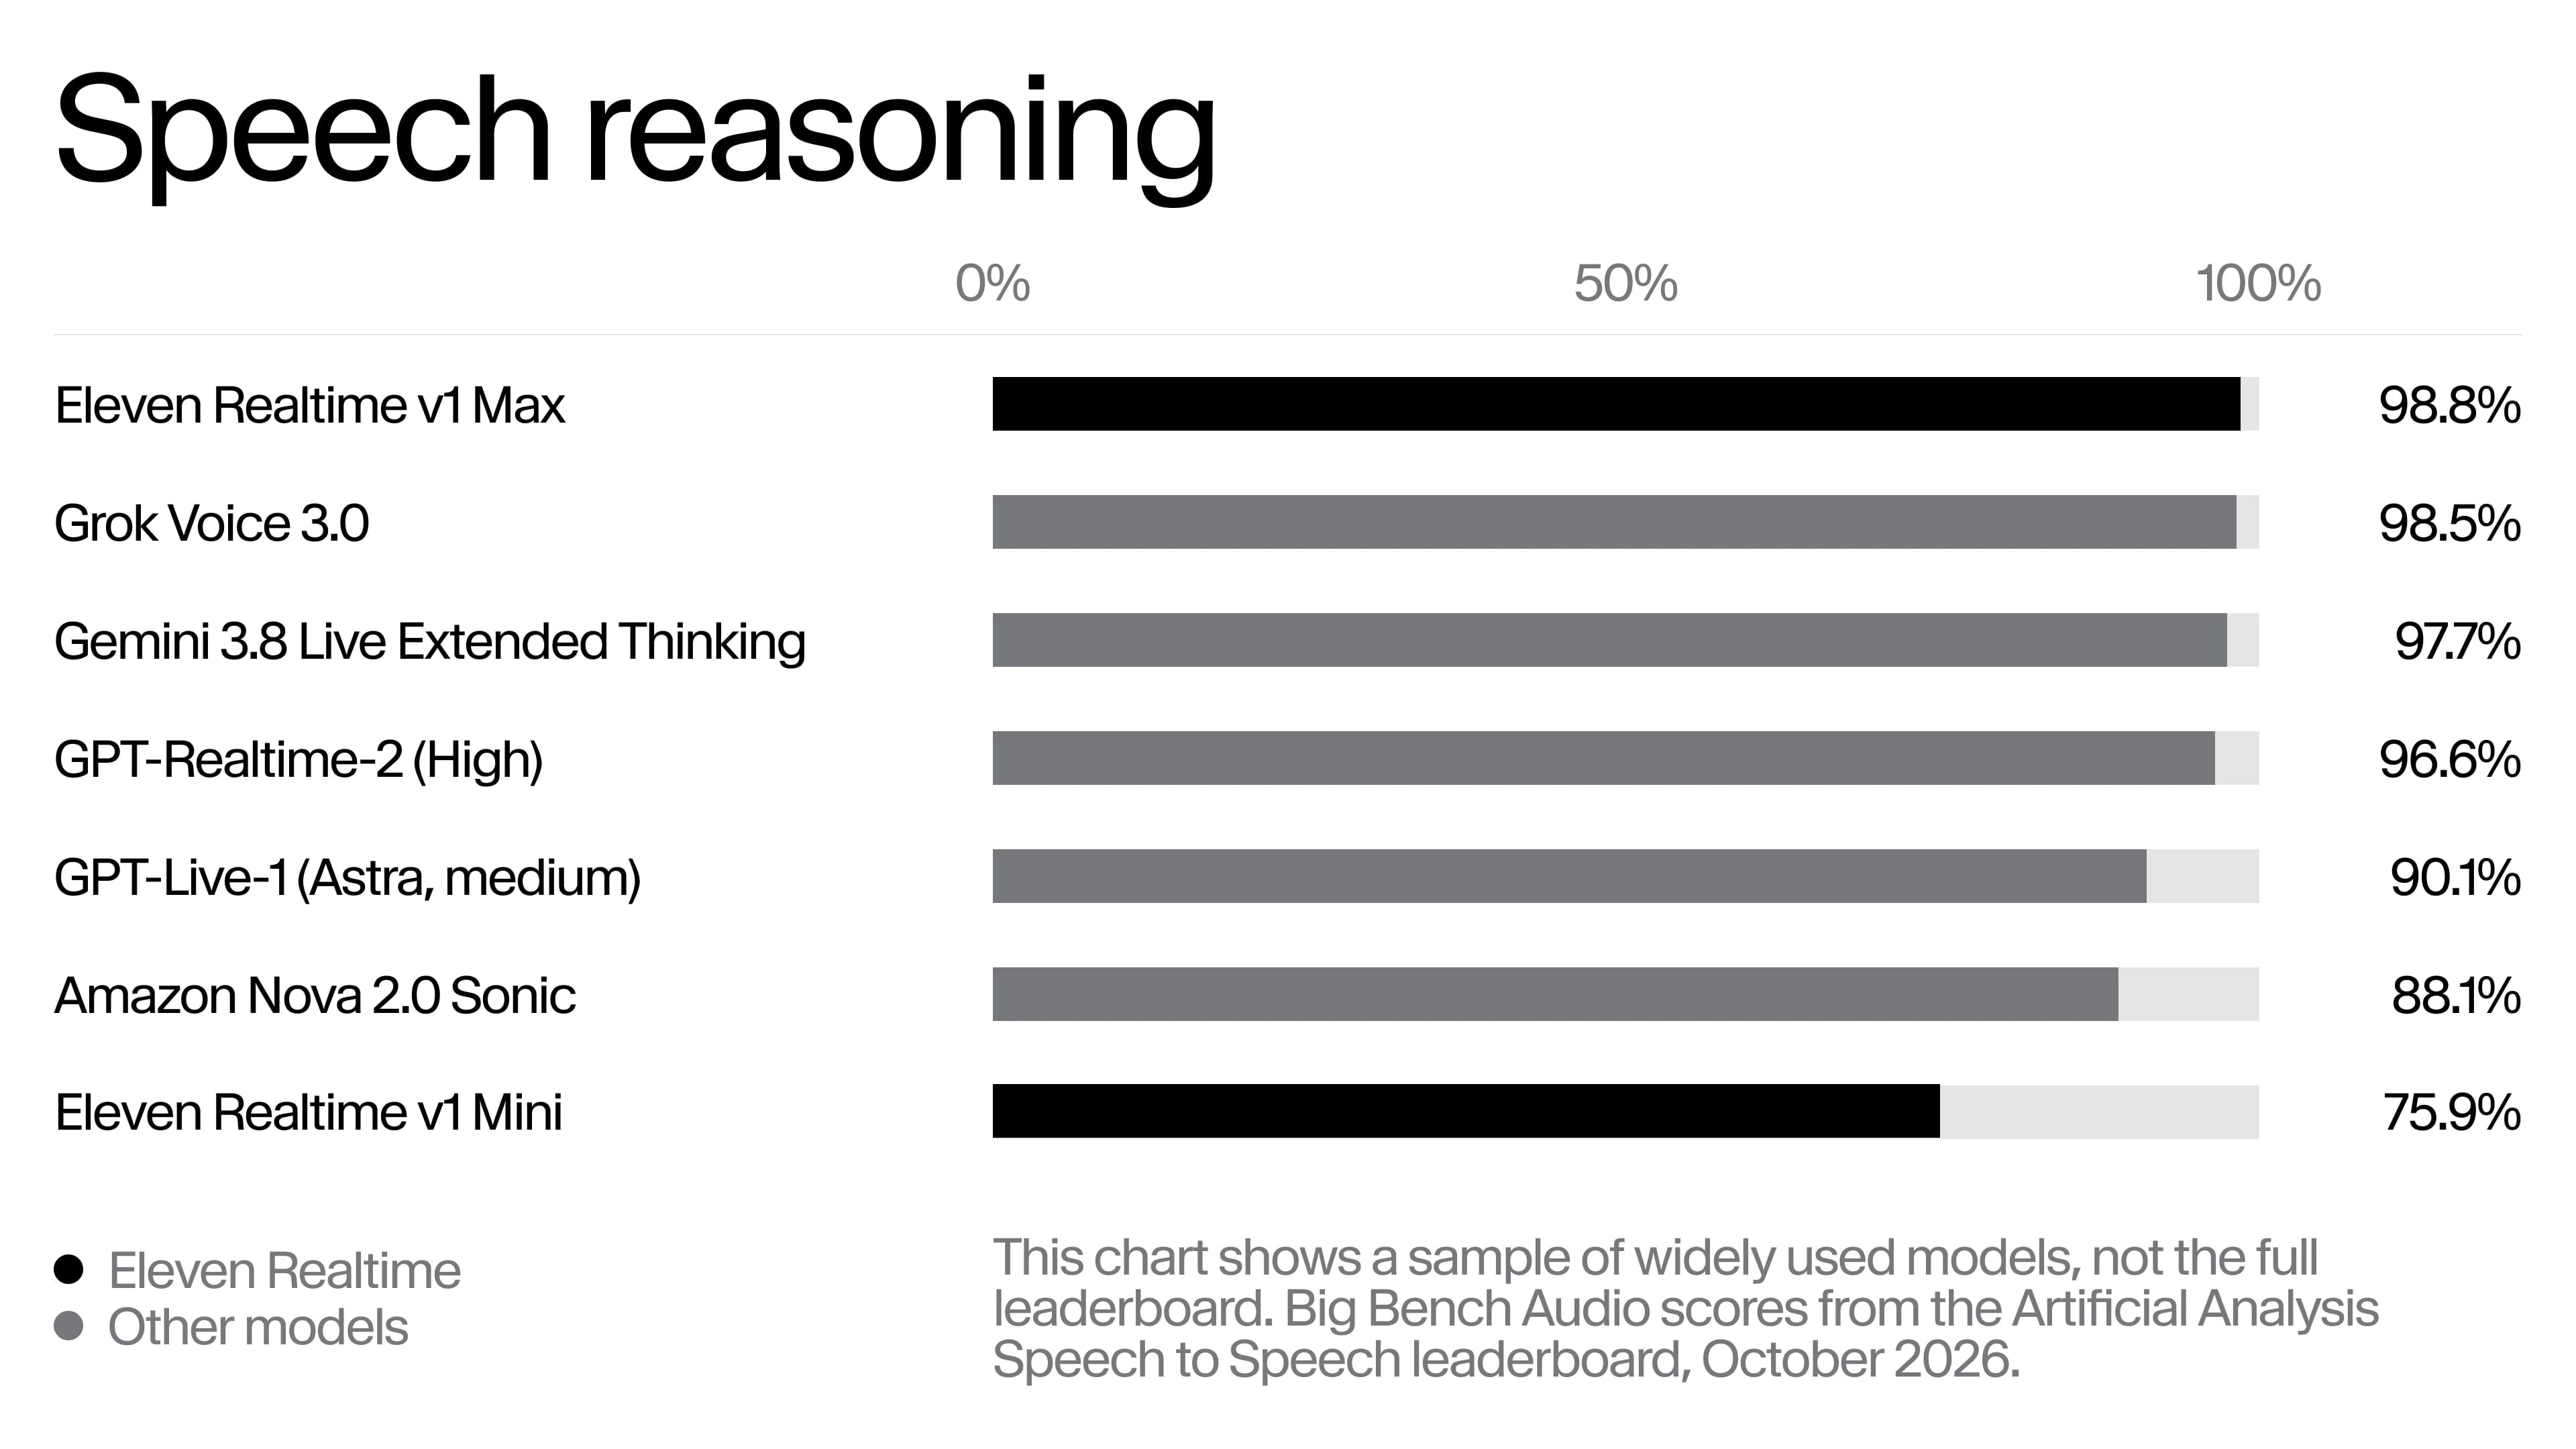
O Big Bench Audio faz 1.000 perguntas de raciocínio por voz e avalia a resposta falada. O Realtime v1 Max respondeu corretamente a 98,8% das perguntas, e o v1 Mini, a 75,9%.
Velocidade
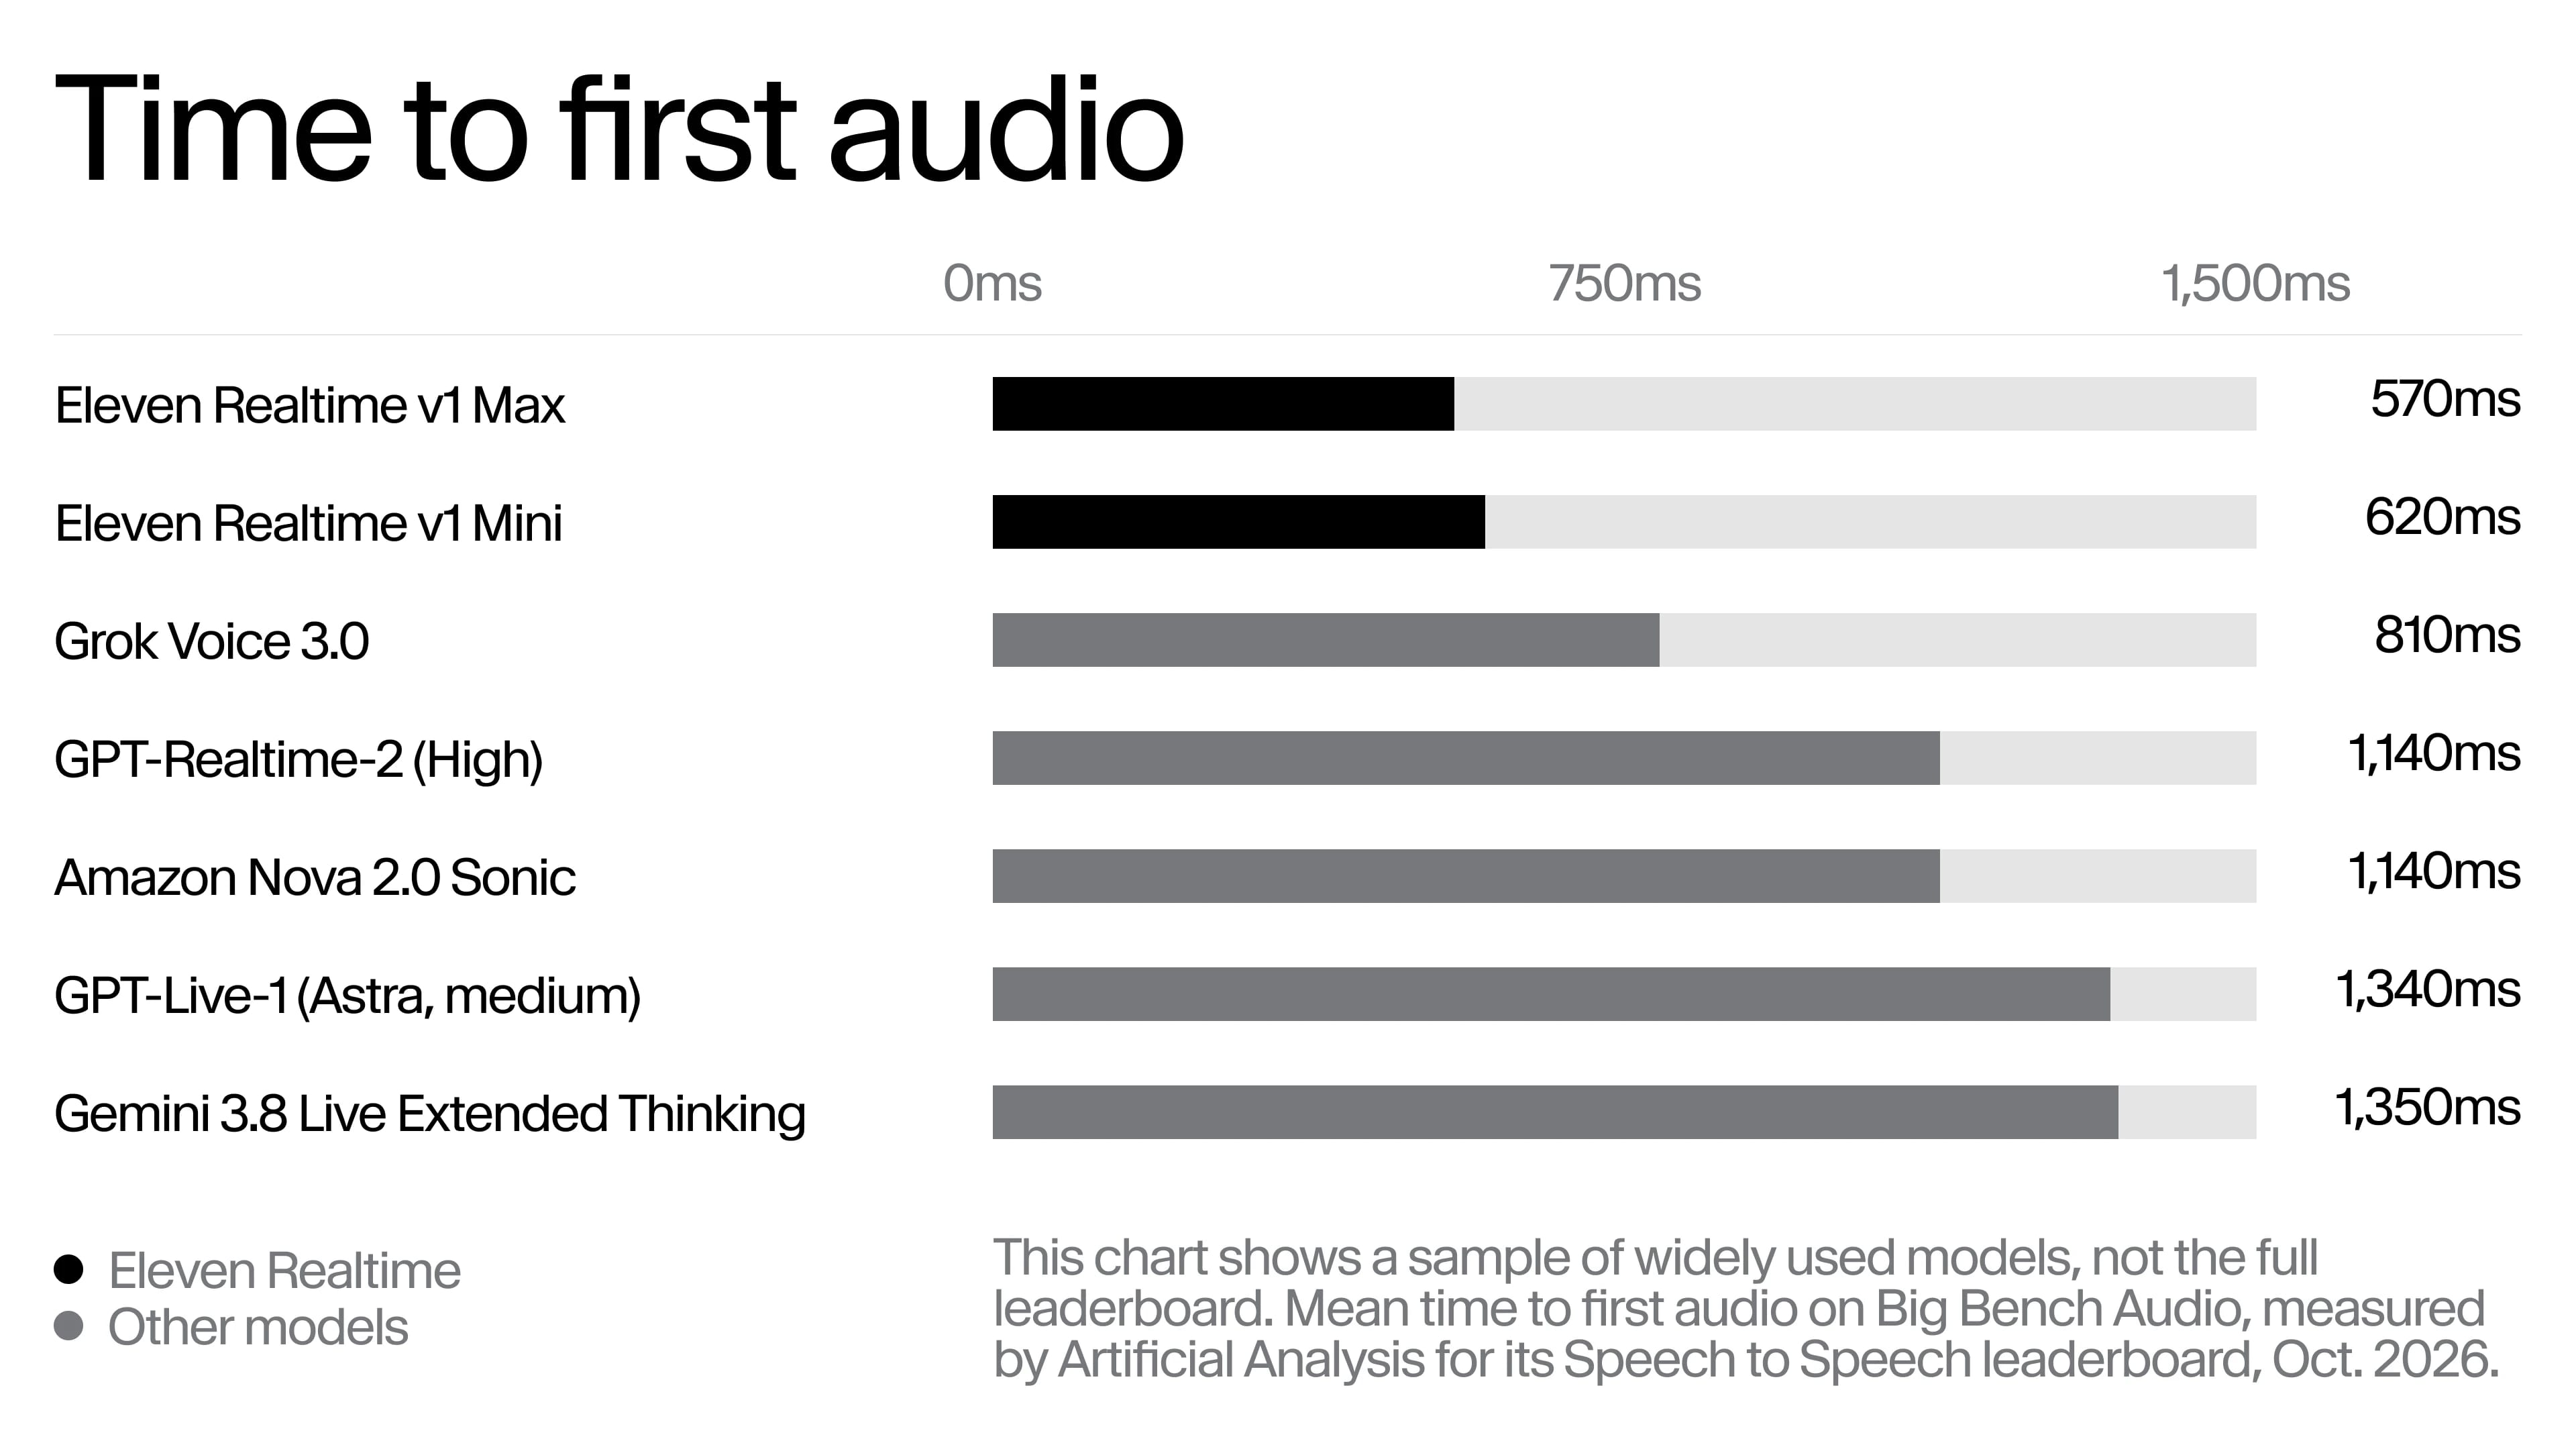
O Big Bench Audio faz 1.000 perguntas de raciocínio por voz e avalia a resposta falada. O v1 Max começa a falar em 0,57 segundo, em média, e o v1 Mini em 0,62 segundo.
A fronteira de Pareto entre precisão e velocidade
Precisão e velocidade geralmente são vistas como uma troca. Os modelos com as maiores pontuações no Big Bench Audio levam mais tempo para responder, enquanto os mais rápidos abrem mão de muita precisão. O v1 Max se destaca nas duas métricas.
Dinâmica conversacional e preferências humanas
No Full-Duplex-Bench, que testa pausas, alternância de turnos, interrupções e sinais de acompanhamento, o v1 Mini alcança 95,8% e o v1 Max, 94,1%. No Speech Agent Arena, em que pessoas comparam dois modelos em conversas ao vivo às cegas, o v1 Max marcou 998 pontos e o v1 Mini, 988. Em tarefas de uso de ferramentas, o v1 Max concluiu 87,1% e o v1 Mini, 60,3%, por isso recomendamos o Max para casos de uso com muitas chamadas de ferramentas.
Comece agora
No ElevenAgents (recomendado)
Crie um agente ou abra um já existente e selecione um modelo Realtime no menu suspenso. A partir daí, você tem tudo o que o ElevenAgents oferece para executar agentes em produção. Isso inclui canais de telefone, web, WhatsApp e CCaaS, workflows, uma base de conhecimento, proteções, testes e monitoramento.
Consulte a documentação do ElevenAgents para mais detalhes.
Pela Realtime API
Se você já tem uma integração com a Realtime API da OpenAI, a forma mais rápida de testar o Eleven Realtime é manter seu código e mudar para onde ele aponta. A Realtime API se conecta por WebSocket e segue as especificações do OpenAI Realtime, então o SDK da OpenAI funciona como está.
A Realtime API se conecta apenas por WebSocket, portanto uma integração com WebRTC precisa primeiro migrar para WebSocket. Ela também funciona separadamente do ElevenAgents, então, se você precisa de canais, uma base de conhecimento ou outros recursos da plataforma, desenvolva no ElevenAgents desde o início.
O guia de migração aborda as etapas e as diferenças em relação à API da OpenAI.
Min faz parte da equipe de Growth da ElevenLabs, responsável pela ElevenAPI e pelas soluções On-Prem/On-Device. Antes, liderou o marketing de produto na Stainless como a segunda contratação de GTM e, anteriormente, foi um dos primeiros PMMs da WorkOS, onde impulsionou lançamentos, capacitação, conteúdo e crescimento.