
Crie um agente de voz em 20 minutos com ElevenLabs e Twilio
- Publicado
- Última atualização
OuvirOuça este artigo
Um agente de voz pode atender chamadas telefônicas recebidas, transcrever quem liga em tempo real com o Speech to Text (STT), gerar uma resposta com um modelo de linguagem grande (LLM) e responder por voz com um módulo de Text to Speech (TTS). Com ElevenLabs e Twilio, você pode ter um agente funcional em um número de telefone real em cerca de 20 minutos.
Para desenvolvedores, a stack completa que você usará inclui a ElevenLabs para síntese de fala (Flash v2.5) e transcrição (Scribe v2 Realtime), a Twilio para telefonia e OpenAI ou Anthropic como LLM. Mas todos esses componentes podem ser trocados, então você pode escolher os que conhece melhor e usá-los no lugar.
Este artigo mostra como criar um agente de voz em 20 minutos usando Node.js e Typescript. Se você quiser uma alternativa gerenciada que cuide da alternância de turnos, das interrupções e da telefonia sem precisar manter a cascata por conta própria, conheça o ElevenAgents.
Como funciona a arquitetura de um agente de voz
Antes de escrever qualquer código, é útil entender como os três serviços da sua stack se conectam.
- Twilio: Gerencia a chamada telefônica e o transporte de áudio.
- ElevenLabs: Gerencia o STT pelo Scribe v2 Realtime e o TTS pelo Flash v2.5.
- LLM: Gerencia a chamada de ferramentas e a redação da resposta.
Cada etapa é um adaptador simples, por isso você pode trocar uma por outro serviço sem alterar o restante. Por exemplo, você pode trocar o LLM da OpenAI pelo Anthropic sem precisar reescrever os outros componentes.
Uma chamada telefônica chega ao seu servidor pela Twilio. A Twilio atende à chamada PSTN, abre um WebSocket de volta ao seu servidor e encaminha o áudio de quem liga como um fluxo de frames mu-law codificados em base64. Seu servidor executa a cascata e transmite o áudio sintetizado de volta pelo mesmo WebSocket, e a Twilio o reproduz para quem ligou.
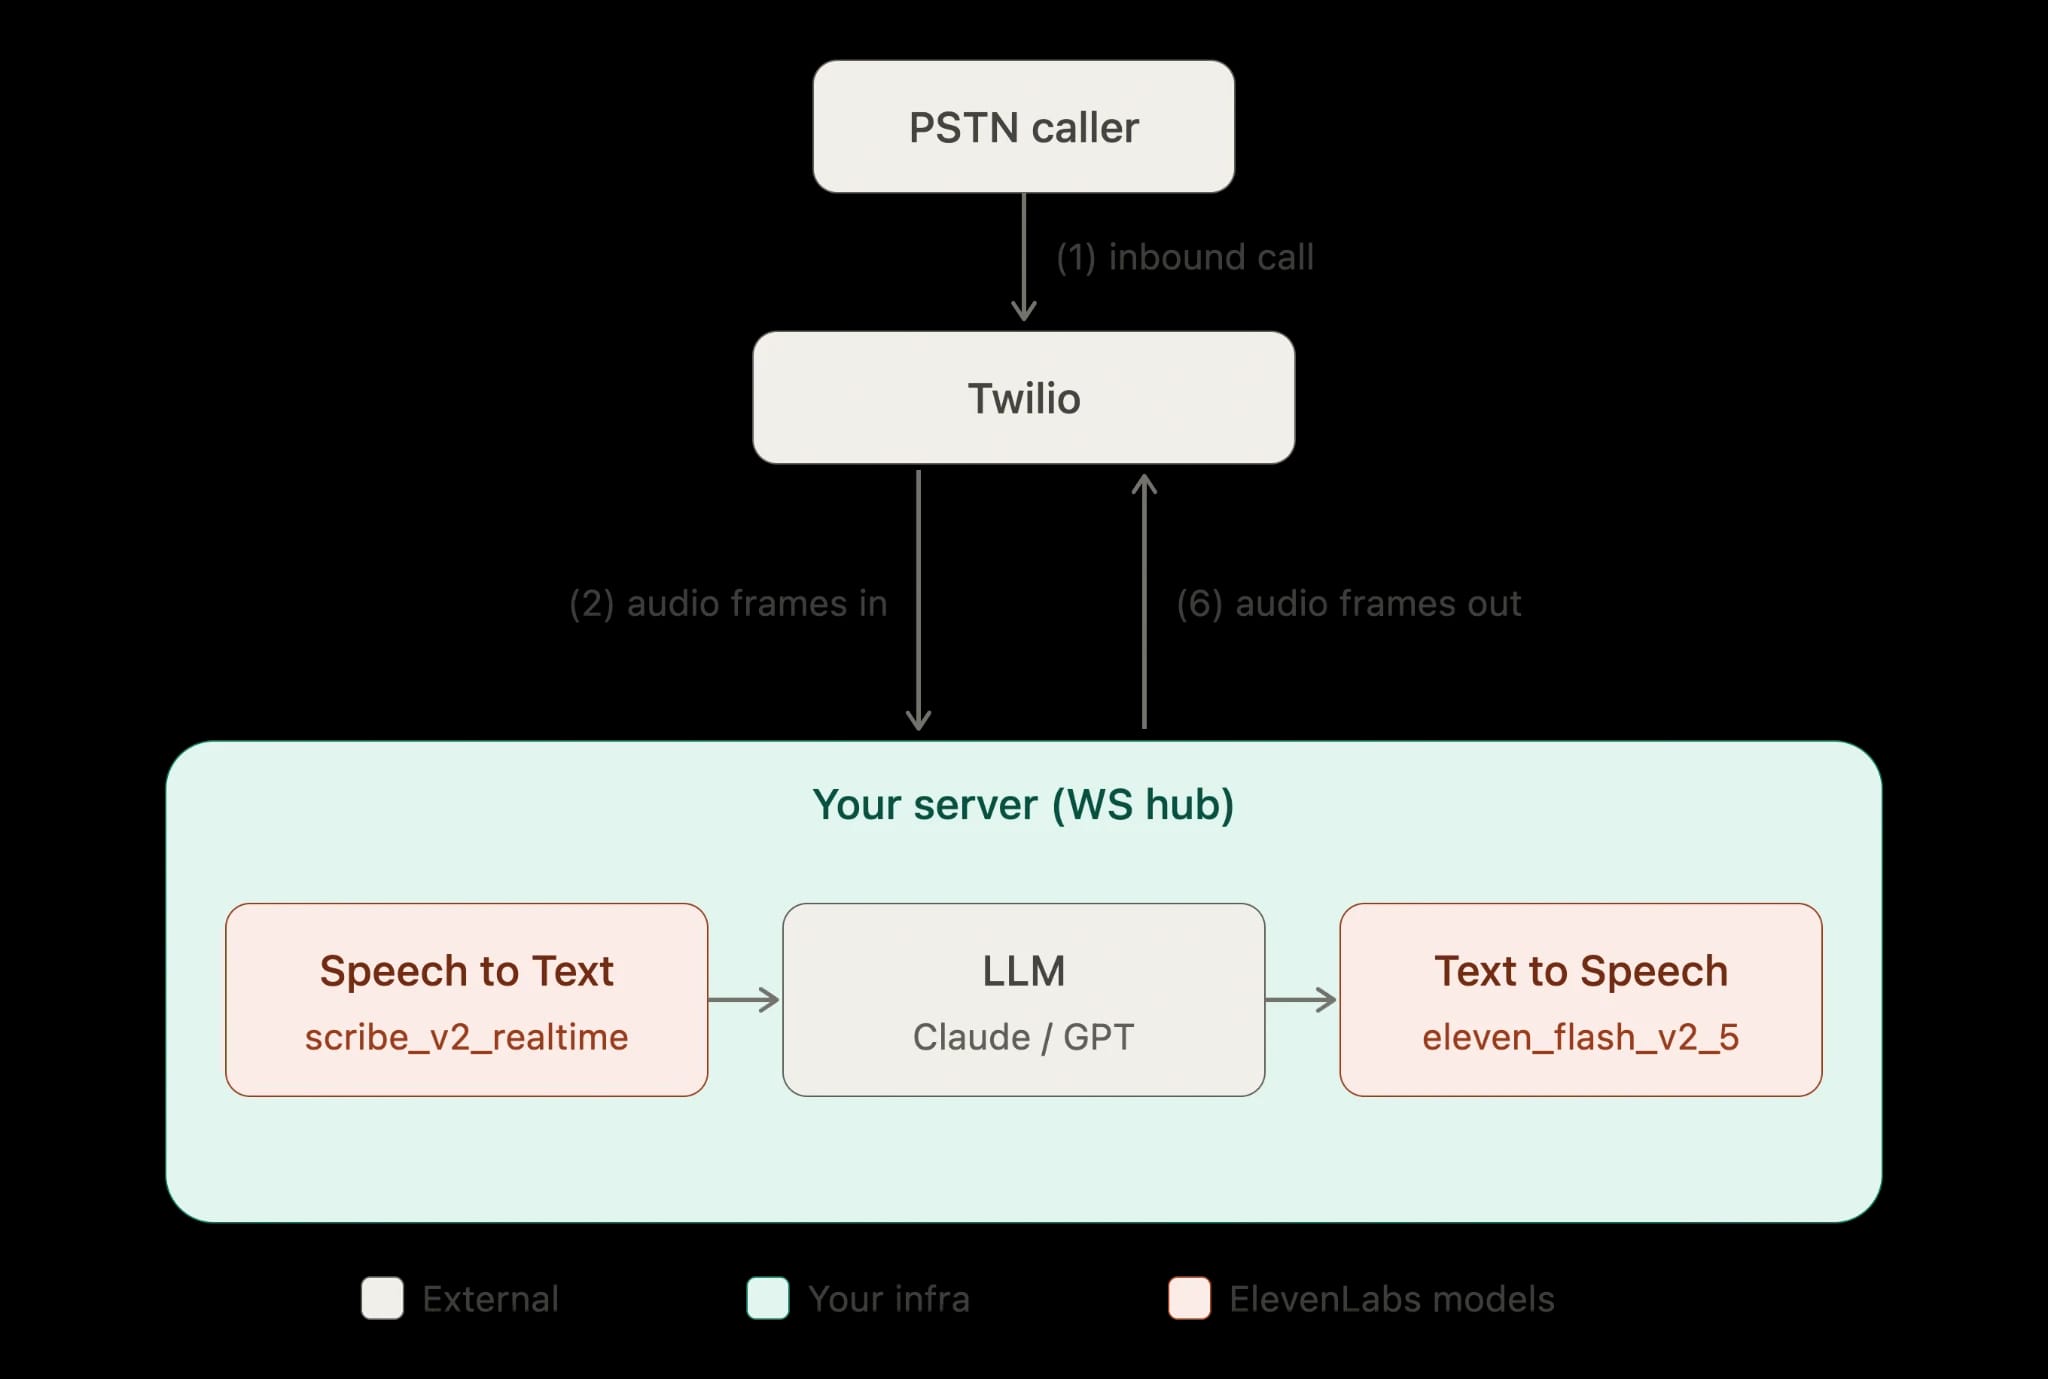
Este é o fluxo que você usará para criar um agente de voz:
Uma pessoa liga para seu número da Twilio. A Twilio obtém um documento TwiML do seu webhook. O TwiML instrui a Twilio a abrir um Media Stream para seu endpoint WebSocket. A Twilio transmite o áudio de entrada como eventos JSON que contêm payloads mu-law (ulaw_8000) em base64.
Seu servidor encaminha trechos de áudio para o Scribe v2 Realtime para transcrição em streaming. Quando o turno de quem ligou é finalizado, você envia a transcrição ao LLM e sintetiza a resposta com o Flash v2.5 em ulaw_8000. Você envia os frames mu-law sintetizados de volta à Twilio pelo WebSocket, codificados em base64, e a Twilio os reproduz para quem ligou.
O Scribe v2 Realtime emite transcrições parciais com cerca de 150 ms de latência, e o Flash v2.5 tem aproximadamente 75 ms de inferência do modelo, sem considerar a latência da rede e da aplicação. O LLM é o maior e menos previsível fator no tempo até o primeiro áudio e é para onde vai a maior parte do orçamento de latência. Para manter o intervalo curto, transmitimos a saída do LLM token por token e começamos a sintetizar antes que o modelo termine sua frase.
Para entender as escolhas e os trade-offs entre modelos, veja a visão geral dos modelos e a explicação sobre como entender a latência.
O que você precisa antes de começar a criar um agente de voz
Este guia pressupõe que você já tenha quatro itens prontos. Todos são rápidos de configurar, mas a falta de qualquer um deles impedirá o servidor de funcionar.
Confira estes pré-requisitos:
- Um número de telefone da Twilio com recurso de voz: anote o número, além do Account SID e Auth Token no console da Twilio.
- Chave de API da ElevenLabs: criada no painel da ElevenLabs. A chave é enviada no cabeçalho xi-api-key e é secreta, portanto mantenha-a apenas no servidor. Veja autenticação de API.
- Chave de API do LLM: este tutorial trata o Claude da Anthropic e a OpenAI como backends intercambiáveis, então escolha um deles.
- Ngrok (ou qualquer túnel) para desenvolvimento local: a Twilio precisa acessar seu servidor por um URL HTTPS e WSS público, e o ngrok oferece isso sem precisar fazer deploy.
Defina seus segredos como variáveis de ambiente e nunca faça commit deles.
Em seguida, inicie um túnel apontando para a porta que seu servidor usará:
Entendendo o protocolo Twilio Media Streams
A Twilio não fornece um socket de áudio bruto. Em vez disso, ela encapsula tudo em um protocolo JSON estruturado por WebSocket. Entender os quatro tipos de evento e o formato de envio fará com que o manipulador de WebSocket da Etapa 2 fique totalmente claro antes de você escrevê-lo.
Quando a Twilio se conecta ao seu WebSocket, ela envia uma sequência de mensagens de texto JSON, que podem ter quatro tipos de evento.
O evento connected chega primeiro e confirma que o WebSocket está ativo. O evento start é enviado uma vez quando o fluxo de mídia começa; ele traz um streamSid que você precisa armazenar, pois precisará dele para enviar áudio de volta, e também inclui metadados da chamada em start.customParameters e start.callSid.
O evento media é recorrente: media.payload é um trecho de áudio mu-law de 8 kHz codificado em base64, com 20 ms por frame, e media.track é inbound para o áudio de quem ligou. Por fim, stop é enviado quando o fluxo termina, geralmente porque a chamada foi encerrada.
Para reproduzir áudio de volta, envie uma mensagem do tipo media com o mesmo streamSid e um payload mu-law em base64. Para interromper um áudio que você já colocou na fila, envie uma mensagem clear com o streamSid, que limpa o buffer de saída da Twilio.
As codificações de entrada e saída são idênticas (ulaw_8000). Solicitamos ulaw_8000 do Text to Speech da ElevenLabs e encaminhamos os bytes diretamente à Twilio, sem fazer reamostragem no caminho.
Etapa 1: Servir o webhook TwiML
Quando uma chamada chega, a Twilio faz uma solicitação HTTP ao seu webhook, e você responde com um TwiML que conecta a chamada ao seu Media Stream. O verbo <Connect><Stream> abre um WebSocket bidirecional. Use <Connect> em vez de <Start> aqui: ele mantém a chamada ativa durante o fluxo e permite enviar áudio de volta, que é o objetivo desta configuração.
O TwiML retornado pelo webhook é:
No Express, basta um único manipulador POST que preenche o host e retorna o documento:
No console da Twilio, defina o webhook "A call comes in" do número como https://your-subdomain.ngrok.app/incoming-call usando HTTP POST.
Etapa 2: Aceitar o WebSocket do Media Stream
O manipulador de WebSocket lê os eventos da Twilio, executa a cascata e envia o áudio de volta.
Mantemos uma pequena quantidade de estado por chamada: o streamSid, uma conexão STT e uma flag que indica se o agente está falando no momento. O manipulador decodifica cada frame de mídia de entrada do base64 e encaminha os bytes mu-law brutos ao STT:
Etapa 3: Transcrever com o Scribe v2 Realtime
O Scribe v2 Realtime aceita trechos de áudio em streaming e retorna transcrições parciais e finais. Ele também oferece suporte direto à codificação mu-law, então enviamos os frames da Twilio sem alterações.
Ele também oferece Detecção de Atividade de Voz para segmentação baseada em silêncio e controle de commit manual para finalizar um segmento. Para um agente telefônico, a segmentação orientada por VAD geralmente é a escolha certa, porque uma pausa natural é o sinal mais confiável de que o turno de quem ligou terminou.
Estas são as etapas: abra um fluxo STT quando a chamada começar. Envie cada trecho mu-law de entrada. Reaja às transcrições finalizadas chamando o LLM.
A interface do cliente de STT em tempo real ainda está evoluindo, portanto o formato abaixo fica por trás de um pequeno adaptador TypeScript (openRealtimeStt), que você implementa com base na API ativa, em vez de um conjunto fixo de nomes de campos. Trate onFinal como o hook que entrega um turno concluído de quem ligou à próxima etapa.
A latência de reconhecimento em tempo real é de aproximadamente 150 ms para resultados parciais, o que mantém pequeno o intervalo percebido entre quem ligou terminar de falar e o agente começar. Para a opção em lote e o conjunto completo de recursos, consulte a documentação de Speech to Text e a página do produto Speech to Text em tempo real.
Etapa 4: Gerar uma resposta com um LLM
Esta é a etapa que produz a resposta. O LLM recebe o histórico da conversa e retorna o texto do assistente. Transmita a resposta para poder iniciar a síntese na primeira frase.
Aqui, usamos a OpenAI como backend:
O ID de modelo acima, gpt-4.1-mini, é um exemplo de escolha com baixa latência; claude-haiku-4-5 é uma opção comparável da Anthropic. Qualquer um dos provedores pode atender ao mesmo contrato llmReply; troque o corpo da função, e o restante do agente permanecerá inalterado.
O prompt de sistema limita o tamanho da resposta, o que é importante em chamadas: respostas longas parecem lentas e são difíceis de interromper naturalmente.
Etapa 5: Sintetizar com Flash TTS em ulaw_8000
Agora o texto precisa se transformar em áudio que a Twilio possa reproduzir. Solicite o Flash v2.5 com outputFormat: "ulaw_8000" para que os bytes correspondam à codificação esperada pela Twilio e, em seguida, transmita o áudio e encaminhe cada trecho de volta pelo WebSocket como um evento media.
Acumule tokens do LLM em fragmentos do tamanho de uma frase e sintetize cada fragmento assim que ele for concluído, em vez de esperar pela resposta inteira. Isso reduz o tempo até o primeiro áudio, porque quem ligou ouve a primeira frase enquanto o modelo ainda produz a segunda. Para ter um controle maior sobre a síntese incremental, o guia de WebSocket de TTS em tempo real mostra como enviar texto a um único socket de síntese aberto; a abordagem de streaming HTTP abaixo é mais simples e suficiente para turnos curtos de conversa.
Preparando seu agente de voz IA para produção
Depois das cinco etapas acima, você terá um agente funcional. Mas isso não é o mesmo que uma implantação em produção.
Há vários pontos que você precisa considerar antes de colocar o agente em uma linha telefônica real.
Validar assinaturas de webhook da Twilio
Qualquer pessoa que descubra o URL do seu webhook pode enviar um POST para ele, então a primeira tarefa é confirmar que a solicitação realmente veio da Twilio. A Twilio assina todas as solicitações com seu Auth Token no cabeçalho X-Twilio-Signature, e você deve rejeitar tudo que não passar na validação. A assinatura é calculada com base no URL completo e nos parâmetros POST, portanto você precisa calculá-la da mesma forma que a Twilio.
O helper da Twilio faz isso por você:
Gerencie os segredos corretamente
Mantenha ELEVENLABS_API_KEY, a chave do LLM e TWILIO_AUTH_TOKEN em um gerenciador de segredos, não no código-fonte nem em arquivos env de texto simples enviados a um repositório. Restrinja a chave da ElevenLabs apenas aos endpoints de que este serviço precisa e atribua a ela uma cota de créditos, para que um vazamento tenha impacto limitado, em vez de ilimitado.
Os planos Enterprise também podem restringir uma chave a faixas específicas de IP com uma lista de permissões de IP. Este servidor usa a chave de API diretamente porque ela nunca sai do seu backend; se alguma lógica de áudio fosse movida para um navegador ou cliente móvel, você usaria tokens de uso único para que a chave nunca ficasse exposta no cliente.
Entenda o limite de concorrência
Cada plano tem um limite de concorrência que varia conforme a família de modelos, e esse limite conta quantas solicitações estão gerando áudio ativamente ao mesmo tempo.
Para um agente telefônico, essa contagem joga a seu favor. A geração de áudio é mais rápida que a reprodução, então cada chamada só consome concorrência de TTS nas breves janelas em que uma resposta está sendo sintetizada, e não durante toda a chamada. Como estimativa geral, um limite de concorrência de cerca de cinco pode atender aproximadamente 100 conversas simultâneas, porque a geração termina bem antes da reprodução.
Mesmo assim, monitore a capacidade disponível em vez de adivinhar. As respostas da ElevenLabs expõem os cabeçalhos current-concurrent-requests e maximum-concurrent-requests; registre-os e crie alertas à medida que se aproximar do máximo. Quando você excede o limite, as solicitações entram na fila por prioridade, o que normalmente adiciona cerca de 50 ms, e uma sobrecarga contínua retorna HTTP 429.
Trate respostas HTTP 429 com um backoff curto. Se elas persistirem, aumente os limites fazendo upgrade na página de preços ou, para clientes Enterprise, com seu gerente de conta.
Lide com barge-in e interrupções
Uma pessoa que começa a falar enquanto o agente está falando espera que ele pare. Isso é chamado de barge-in, e lidar corretamente com isso é uma parte importante para que o agente pareça natural, e não roteirizado.
Detecte a fala de quem ligou durante a reprodução do agente usando o sinal VAD do STT. Ao detectá-la, faça duas coisas. Primeiro, pare de encaminhar trechos de TTS, o que a flag agentSpeaking em speak já faz ao interromper o loop. Segundo, envie à Twilio uma mensagem clear para limpar o áudio que você já colocou na fila do lado dela.
Se você não enviar clear, a Twilio continuará reproduzindo o áudio armazenado em buffer depois que você parar de enviar dados, então parecerá que o agente está falando por cima de quem ligou.
Registre, monitore e trate falhas de forma adequada
Instrumente cada etapa para poder atribuir a latência quando uma chamada parecer lenta. Meça o intervalo entre a transcrição final e o primeiro token do LLM, entre o primeiro token do LLM e o primeiro byte de TTS e entre o primeiro byte de TTS e o frame enviado à Twilio. Você verá que a maior parte da latência variável está na etapa do LLM; as etapas de STT e TTS são comparativamente estáveis.
Depois, planeje para falhas parciais. O LLM pode atingir o tempo limite, o fluxo STT pode cair, e o tempo de ida e volta na rede até a ElevenLabs varia de aproximadamente 20 a 200 ms na internet pública, dependendo da geografia. Mantenha seu servidor próximo de quem liga, não apenas da ElevenLabs, pois a ElevenLabs já direciona ao cluster mais próximo na América do Norte, Europa e Sudeste Asiático.
Quando uma etapa falhar, não deixe quem ligou em silêncio: sintetize uma frase curta de fallback ("Desculpe, pode repetir?") e mantenha a chamada ativa. Envolva cada etapa em um timeout e um try/catch para que um turno com falha não encerre todo o WebSocket.
Vale definir mais alguns padrões antes de lançar:
- Limite o tamanho da resposta no prompt de sistema, como mostrado, para que os turnos sejam curtos e interrompíveis.
- Limite o histórico da conversa para que chamadas longas não aumentem o contexto do LLM sem limite.
- Defina uma duração máxima de chamada como proteção contra sessões travadas consumindo concorrência silenciosamente.
Para continuar ajustando os componentes que você controla, o documento sobre latência explica de onde vem o tempo até o primeiro áudio, a visão geral dos modelos aborda os trade-offs entre velocidade e qualidade, e o guia de WebSocket de TTS em tempo real mostra como reduzir ainda mais a latência de síntese com entrada incremental de texto.
Crie agentes de voz prontos para produção com a ElevenAPI
Agora que os 20 minutos passaram, você tem todas as camadas de um agente de voz pronto para produção. A Twilio gerencia a telefonia, o Scribe v2 Realtime transcreve, um LLM gera respostas e o Flash v2.5 responde por voz pelo mesmo WebSocket.
Se preferir não manter a cascata por conta própria, o ElevenAgents oferece alternância de turnos, tratamento de interrupções e integração com telefonia como um serviço gerenciado, criado com os mesmos modelos que você acabou de conectar manualmente.
Para continuar ajustando uma stack sob seu controle, explore a página do produto ElevenAPI para ver planos, limites de concorrência e a Voice Library. Ou crie sua conta e comece hoje a fazer sua primeira chamada.
Perguntas frequentes sobre como criar um agente de voz com Twilio e ElevenLabs

Tadas Petra é engenheiro de Relações com Desenvolvedores e ajuda desenvolvedores a criar com a suíte de produtos da ElevenLabs. Ele também é fundador da Hungrimind, uma plataforma de educação para desenvolvedores. Antes disso, foi Líder de Advocacia para Desenvolvedores na Agora e instrutor na Zero To Mastery.




