Criando o Vibe Draw: combinando ElevenLabs e FLUX Kontext para criar imagens por voz
- Escrito por
- Ryan Morrison
- Publicado
- Última atualização
OuvirOuça este artigo
As interfaces de voz estão mudando a forma como nos comunicamos com a IA. E se criar uma imagem fosse tão fácil quanto descrevê-la em voz alta?
Foi essa ideia que me levou a criar o Vibe Draw como um projeto de fim de semana. É uma ferramenta criativa que prioriza a voz e combina a IA de voz da ElevenLabs com o FLUX Kontext, da Black Forest Labs, para transformar comandos falados em imagens.
O FLUX Kontext representa uma nova categoria de modelo de imagem. Diferentemente dos sistemas tradicionais de texto para imagem, o Kontext lida tanto com geração quanto com edição. Ele pode criar novas imagens a partir de comandos, modificar imagens existentes e até combinar várias imagens de referência em um único resultado.
Embora modelos como GPT-4o e Gemini 2 Flash ofereçam recursos multimodais, o FLUX Kontext foi desenvolvido especificamente para manipulação visual de alta qualidade. Em testes, consegui alterar letras individuais em textos estilizados ou reposicionar um objeto — apenas descrevendo a mudança.
Foi quando pensei: “Por que não fazer isso com voz?” E que base poderia ser melhor do que a poderosa tecnologia de voz da ElevenLabs?

O desafio técnico
Criar um sistema de imagens por voz exigiu resolver cinco problemas principais:
- Compreensão de linguagem natural — Diferenciar entre novas criações e edições
- Reconhecimento de contexto — Manter a continuidade entre as interações
- Gerenciamento de áudio — Evitar respostas sobrepostas e gerenciar filas
- Geração visual — Transições fluidas entre geração e edição
- Experiência do usuário — Fazer com que interações avançadas com IA pareçam intuitivas
Visão geral da arquitetura
O Vibe Draw funciona inteiramente no lado do cliente e integra os seguintes componentes:
- Web Speech API para reconhecimento de fala
- ElevenLabs TTS API para respostas por voz
- API do FLUX Kontext para geração e edição de imagens
- Detecção de intenção personalizada para compreender a entrada do usuário
Essa abordagem mantém o protótipo leve, mas as implementações em produção devem encaminhar as solicitações por um servidor para garantir a segurança.
Implementando voz com a ElevenLabs
O Vibe Draw usa a API de texto em fala da ElevenLabs, ajustada para respostas ágeis em conversas:
Para criar variedade, as respostas por voz são selecionadas aleatoriamente a partir de modelos predefinidos:
Gerenciando a reprodução de áudio
Respostas de voz sobrepostas quebram a ilusão de uma conversa. O Vibe Draw resolve isso com um sistema de fila de áudio:
Cada mensagem é reproduzida por completo antes de acionar a próxima.
Detecção de intenção e gerenciamento de contexto
O sistema usa a detecção de palavras-chave e de contexto para decidir se um comando do usuário é uma nova solicitação de imagem ou uma edição:
Essa abordagem garante que as edições sejam aplicadas apenas quando houver uma imagem existente e o contexto deixar isso claro.
Geração de imagens com o FLUX Kontext
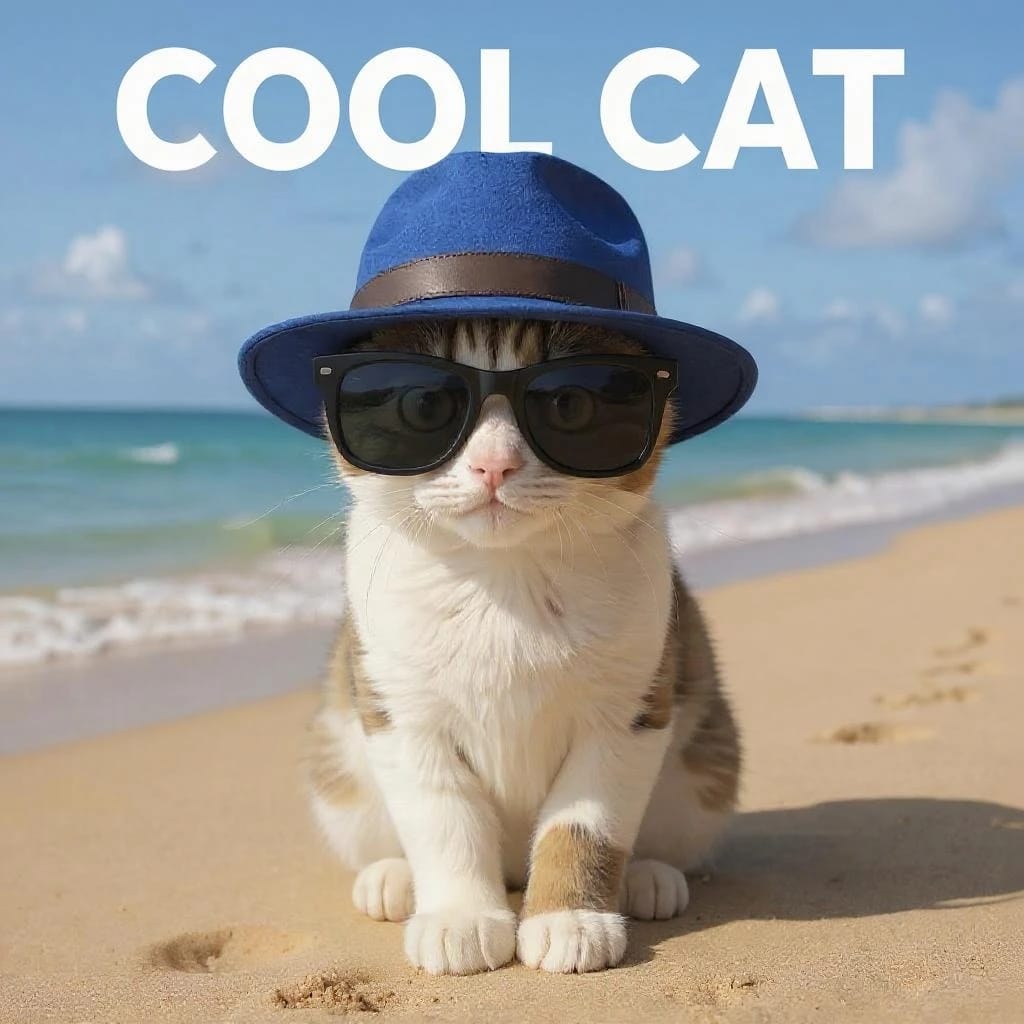
O Kontext oferece suporte a dois modos: geração e edição.
Geração (texto para imagem)
Edição (transformação contextual)
Como lidar com transformações complexas
Alguns comandos envolvem mudanças que excedem os limites da API de edição. Quando isso é detectado, o sistema oferece uma alternativa:
Otimizando a experiência
Feedback progressivo
O feedback da interface ajuda os usuários a acompanhar o estado do sistema:
Temporização inteligente
Uma conversa natural exige uma temporização natural:
Estado da sessão
Para preservar o contexto, os dados da sessão são armazenados:
Considerações de desempenho
Para garantir agilidade:
- Carregamento sob demanda — Inicializar APIs apenas quando necessário
- Debouncing — Limitar solicitações à API por interação
- Tratamento de erros — Recuperar-se adequadamente de tempos limite ou falhas
- Limpeza de recursos — Descartar corretamente objetos de áudio e listeners de eventos
Próximos passos
Interfaces conversacionais abrem caminho para novos recursos:
- Entrada multimodal — “Faça parecer mais com esta foto.”
- Sessões colaborativas — Vários usuários contribuindo para um único design
- Memória de estilo — O sistema aprende sua estética ao longo do tempo
- Streaming em tempo real — Transmita atualizações da imagem enquanto o usuário fala e integre a IA Conversacional da ElevenLabs para permitir fala transmitida em streaming.
Principais aprendizados
Criar o Vibe Draw revelou vários princípios fundamentais para ferramentas que priorizam a voz:
- Contexto é tudo — Acompanhar o estado torna as interações mais coerentes
- O tempo dá personalidade — Ritmar as respostas faz a IA parecer mais ágil
- Alternativas mantêm o ritmo — Quando a geração falha, ofereça outras opções
- A variedade mantém o interesse — Repetir a mesma frase quebra a imersão
Conclusão
O Vibe Draw mostra o que acontece quando a IA de voz conversacional encontra a criatividade visual. A síntese de fala natural da ElevenLabs e as APIs de imagem do FLUX Kontext se combinam para criar uma nova forma de criar — sem cliques, sem controles deslizantes, apenas voz.
Quando criar é tão fácil quanto descrever, removemos as barreiras entre a imaginação e a execução.
Experimente você mesmo
O código-fonte completo está disponível no GitHub. Para executar sua própria versão:
- Clone o repositório
- Adicione sua chave de API da ElevenLabs
- Adicione sua chave de API da FAL.ai
- Abra o arquivo vibe-draw-v2.html em um navegador moderno
- Clique no microfone e comece a criar
Quer criar sua própria experiência que prioriza a voz? Explore a IA Conversacional da ElevenLabs ou fale conosco.
Ryan se juntou à ElevenLabs após mais de duas décadas em notícias e publicações, incluindo cargos na BBC e Future Plc. Ele se concentra em estratégia de conteúdo e storytelling, ajudando a ElevenLabs a moldar e compartilhar sua narrativa.